


Einführung in Einbettungen und Vektorsuche
Dieses Dokument bietet eine Übersicht über Einbettungen und die Vektorsuche in BigQuery. Die Vektorsuche ist eine Technik zum Vergleichen ähnlicher Objekte mithilfe von Einbettungen. Sie wird in Google-Produkten wie der Google Suche, YouTube und Google Play verwendet. Mit der Vektorsuche können Sie semantische Suchen im großen Maßstab durchführen oder eine hybride Suche ausführen, die eine semantische Suche mit einer lexikalischen (Keyword-)Suche kombiniert. Wenn Sie Vektorindizes mit der Vektorsuche verwenden, können Sie von grundlegenden Technologien wie der umgekehrten Dateiindexierung (Inverted File Indexing, IVF) und dem ScaNN-Algorithmus profitieren.
Die Vektorsuche basiert auf Einbettungen. Einbettungen sind hochdimensionale numerische Vektoren, die eine bestimmte Entität darstellen, z. B. einen Text oder eine Audiodatei. Modelle für maschinelles Lernen (ML) verwenden Einbettungen, um semantische Informationen zu solchen Entitäten zu codieren, damit sie leichter verglichen und analysiert werden können. Eine häufige Operation in Clustering-, Klassifizierungs- und Empfehlungsmodellen ist beispielsweise das Messen des Abstands zwischen Vektoren in einem Einbettungsraum, um Elemente zu finden, die semantisch am ähnlichsten sind.
Dieses Konzept der semantischen Ähnlichkeit und Distanz in einem Einbettungsraum wird visuell veranschaulicht, wenn Sie sich ansehen, wie verschiedene Elemente dargestellt werden können. Beispielsweise werden Begriffe wie Katze, Hund und Löwe, die alle Arten von Tieren darstellen, aufgrund ihrer gemeinsamen semantischen Merkmale in diesem Raum nah beieinander gruppiert. Ähnlich würden Begriffe wie Auto, Lkw und der allgemeinere Begriff Fahrzeug ein weiteres Cluster bilden. Das ist in der folgenden Abbildung zu sehen:
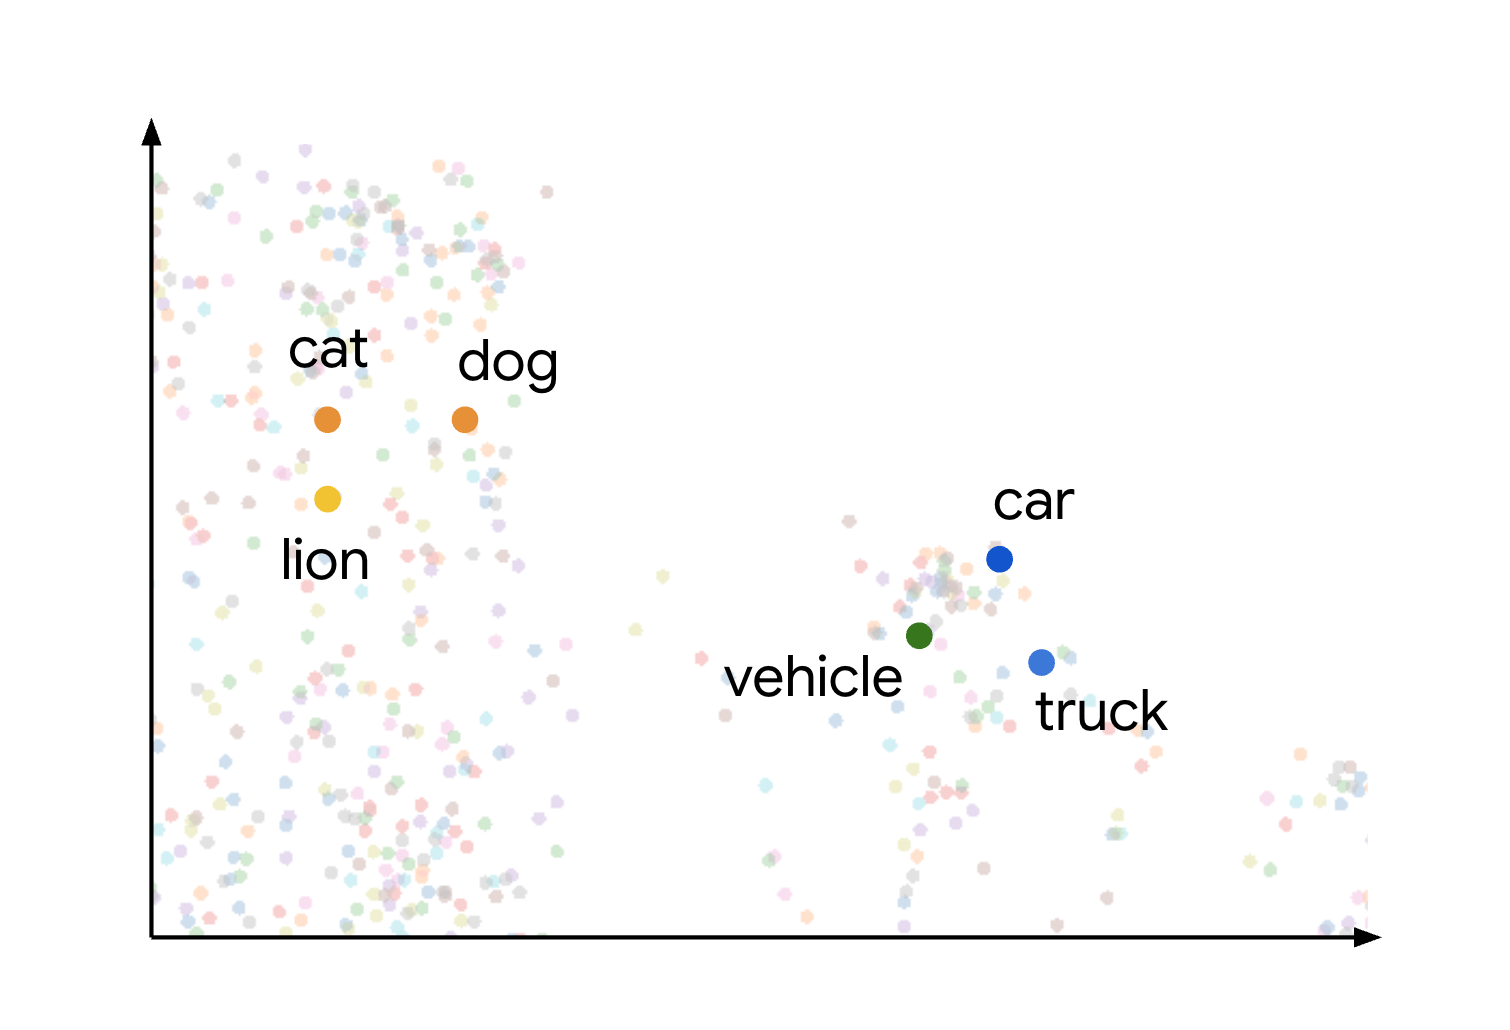
Die Cluster für Tiere und Fahrzeuge sind weit voneinander entfernt. Die Trennung zwischen den Gruppen veranschaulicht das Prinzip, dass Objekte umso semantisch ähnlicher sind, je näher sie im Einbettungsraum liegen. Größere Abstände deuten auf eine größere semantische Unähnlichkeit hin.
Anwendungsfälle
Die Kombination aus Einbettungserstellung und Vektorsuche ermöglicht viele interessante Anwendungsfälle. Einige mögliche Anwendungsfälle sind:
- Retrieval-Augmented Generation (RAG): Dokumente parsen, Vektorsuche für Inhalte durchführen und zusammengefasste Antworten auf Fragen in natürlicher Sprache mit Gemini-Modellen generieren – alles in BigQuery. Ein Notebook, das dieses Szenario veranschaulicht, finden Sie unter Vektorsuchanwendung mit BigQuery DataFrames erstellen.
- Produktalternativen empfehlen oder passende Produkte finden:E-Commerce-Anwendungen verbessern, indem Produktalternativen basierend auf dem Kundenverhalten und der Produktähnlichkeit vorgeschlagen werden.
- Log-Analysen:Teams helfen, Anomalien in Logs proaktiv zu priorisieren und Untersuchungen zu beschleunigen. Sie können diese Funktion auch verwenden, um den Kontext für LLMs zu erweitern und so die Bedrohungserkennung, die Forensik und die Fehlerbehebung zu verbessern. Ein Notebook, das dieses Szenario veranschaulicht, finden Sie unter Log-Anomalieerkennung und ‑untersuchung mit Texteinbettungen und BigQuery-Vektorsuche.
- Clustering und Targeting:Zielgruppen präzise segmentieren. Beispielsweise könnte eine Krankenhauskette Patienten mithilfe von Notizen in natürlicher Sprache und strukturierten Daten clustern oder ein Marketer Anzeigen mit Targeting basierend auf der Abfrageabsicht ausrichten. Ein Notebook, das dieses Szenario veranschaulicht, finden Sie unter Create-Campaign-Customer-Segmentation.
- Entitätsauflösung und Deduplizierung:Daten bereinigen und zusammenführen. Beispielsweise könnte ein Werbeunternehmen Datensätze mit personenbezogenen Daten deduplizieren oder ein Immobilienunternehmen passende Postadressen identifizieren.
Einbettungen generieren
In den folgenden Abschnitten werden die Funktionen beschrieben, die BigQuery bietet, um Einbettungen zu generieren oder damit zu arbeiten.
Einzelne Einbettungen generieren
Mit der
AI.EMBED Funktion
und den Einbettungsmodellen der Gemini Enterprise Agent Platform können Sie eine einzelne Einbettung
Ihrer Eingabe generieren.
Die Funktion AI.EMBED unterstützt die folgenden Eingabetypen:
- Textdaten
- Bilddaten, die durch
ObjectRefWerte dargestellt werden
Tabelle mit Einbettungen generieren
Mit der Funktion
AI.GENERATE_EMBEDDING
können Sie eine Tabelle mit Einbettungen für alle Daten in einer Spalte Ihrer
Eingabetabelle erstellen. Für alle Arten unterstützter Modelle funktioniert AI.GENERATE_EMBEDDING
mit strukturierten Daten in
Standardtabellen. Bei multimodalen
Einbettungsmodellen funktioniert AI.GENERATE_EMBEDDING auch mit visuellen Inhalten
aus Standardtabellen
spalten, die ObjectRef Werte enthalten,
oder aus Objekttabellen.
Bei Remote-Modellen erfolgt die gesamte Inferenz in der Agent Platform. Bei anderen Modelltypen erfolgt die gesamte Inferenz in BigQuery. Die Ergebnisse werden in BigQuery gespeichert.
In den folgenden Themen können Sie die Einbettungserstellung in BigQuery ML ausprobieren:
- Text, Bilder oder Videos mit der
AI.GENERATE_EMBEDDINGFunktion generieren - Multimodale Einbettungen generieren und suchen
- Semantische Suche und Retrieval Augmented Generation durchführen
Autonome Einbettungserstellung
Mit der autonomen Einbettungserstellung können Sie das Erstellen, Verwalten und Abfragen von Einbettungen vereinfachen. BigQuery verwaltet eine Spalte mit Einbettungen in Ihrer Tabelle basierend auf einer Quellspalte. Wenn Sie Daten in der Quellspalte hinzufügen oder ändern, generiert oder aktualisiert BigQuery die Einbettungsspalte für diese Daten automatisch mithilfe eines Einbettungsmodells der Agent Platform. Das ist hilfreich, wenn Sie BigQuery Ihre Einbettungen verwalten lassen möchten, wenn Ihre Quelldaten regelmäßig aktualisiert werden.
Suchen
Mit den folgenden Suchfunktionen können Sie eine semantische Vektorsuche oder eine hybride Suche durchführen, die eine semantische Suche mit einer lexikalischen Keyword-Suche kombiniert:
VECTOR_SEARCH: Semantische Vektorsuche oder hybride Suche mit SQL durchführen.AI.SEARCH: Semantische oder hybride Suche nach Ergebnissen durchführen, die einem von Ihnen angegebenen String ähneln. Sie können diese Funktion verwenden, wenn die autonome Einbettungserstellung für Ihre Tabelle aktiviert ist.AI.SIMILARITY: Zwei Eingaben vergleichen, indem die Kosinusähnlichkeit zwischen ihren Einbettungen berechnet wird. Diese Funktion eignet sich gut, wenn Sie nur wenige Vergleiche durchführen möchten und noch keine Einbettungen vorab berechnet haben. Sie solltenVECTOR_SEARCHverwenden, wenn die Leistung entscheidend ist und Sie mit einer großen Anzahl von Einbettungen arbeiten. Vergleichen Sie die Funktionen um die beste Funktion für Ihren Anwendungsfall auszuwählen.
Optional können Sie mit der
Anweisung
CREATE VECTOR INDEX einen Vektorindex erstellen.
Bei Verwendung eines Vektorindex nutzen die Funktionen VECTOR_SEARCH und AI.SEARCH die Suchmethode Annäherung an den nächsten Nachbarn, um die Leistung der Vektorsuche zu verbessern. Dabei wird die Trefferquote reduziert und es werden ungefähre Ergebnisse zurückgegeben. Ohne Vektorindex verwenden diese
Funktionen die
Brute-Force-Suche, um die
Distanz für jeden Datensatz zu messen. Sie können auch die Brute-Force-Suche verwenden, um genaue Ergebnisse zu erhalten, auch wenn ein Vektorindex verfügbar ist.
Preise
Für die Funktionen VECTOR_SEARCH und AI.SEARCH sowie die CREATE VECTOR INDEX
Anweisung gelten
die BigQuery-Preise für die Datenverarbeitung.
Funktionen
VECTOR_SEARCHundAI.SEARCH: Die Kosten für die Ähnlichkeitssuche werden nach dem On-Demand-Preis oder den Preisen für die Editionen berechnet.- On-Demand: Ihnen wird die Menge der Byte in Rechnung gestellt, die in der Basistabelle, im Index und in der Suchanfrage gescannt wurden.
Preise für Editionen: Ihnen werden die Slots in Rechnung gestellt, die erforderlich sind, um den Job innerhalb Ihrer Reservierungsedition abzuschließen. Größere und komplexere Ähnlichkeitsberechnungen verursachen höhere Kosten.
CREATE VECTOR INDEXAnweisung: Die für die Verarbeitung zum Aufbau und zur Aktualisierung Ihrer Vektorindizes erforderliche Verarbeitung ist kostenlos, solange die Gesamtgröße der indexierten Tabellendaten unter Ihrem Limit pro Organisation liegt. Wenn Sie die Indexierung über dieses Limit hinaus unterstützen möchten, müssen Sie eine eigene Reservierung für die Indexverwaltungsjobs bereitstellen.
Auch der Speicher ist ein wichtiger Faktor für Einbettungen und Indizes. Für die als Einbettungen und Indizes gespeicherte Datenmenge fallen Kosten für aktiven Speicher an.
- Für Vektorindizes fallen Speicherkosten an, wenn sie aktiv sind.
- Die Größe des Indexspeichers finden Sie in der
INFORMATION_SCHEMA.VECTOR_INDEXESAnsicht. Wenn der Vektorindex noch nicht zu 100% abgedeckt ist, wird Ihnen trotzdem alles in Rechnung gestellt, was indexiert wurde. Sie können die Indexabdeckung in der AnsichtINFORMATION_SCHEMA.VECTOR_INDEXESprüfen.
Kontingente und Limits
Weitere Informationen finden Sie unter Limits für Vektorindizes und Limits für generative KI-Funktionen.
Beschränkungen
- Abfragen, die die Funktion
VECTOR_SEARCHoderAI.SEARCHenthalten, werden von BigQuery BI Engine nicht beschleunigt. - Das Vorabfiltern von Daten in
VECTOR_SEARCHundAI.SEARCHAbfragen ist nur optimiert, wenn nach partitionierten Spalten oder gespeicherten Spalten gefiltert wird, nicht nach geclusterten Spalten. Wenn nicht gespeicherte geclusterte Spalten in einer Vorabfilter-Unterabfrage verwendet werden, wird eine vollständige Tabellenscan durchgeführt. Weitere Informationen finden Sie unter Einschränkungen beim Vorabfiltern.
Nächste Schritte
- Weitere Informationen zum Erstellen eines Vektorindex und zur Verwendung von Vektorindizes mit der hybriden Suche.
- Informationen zum Ausführen einer semantischen oder hybriden Suche mit der
VECTOR_SEARCHFunktion. - Informationen zum Ausführen einer semantischen oder hybriden Suche mit der
AI.SEARCHFunktion - Weitere Informationen zur autonomen Einbettungserstellung.
- Im Tutorial Nach Einbettungen mit Vektorsuche suchen erfahren Sie, wie Sie einen Vektorindex erstellen und dann eine Vektor suche nach Einbettungen durchführen, sowohl mit als auch ohne Index.
Im Tutorial Semantische Suche ausführen und Retrieval Augmented Generation erfahren Sie, wie Sie die folgenden Aufgaben ausführen:
- Texteinbettungen generieren
- Vektorindex für die Einbettungen erstellen
- Mit den Einbettungen eine Vektorsuche durchführen, um nach ähnlichem Text zu suchen
- Retrieval-Augmented Generation (RAG) durchführen, indem Sie Vektorsuchergebnisse verwenden, um die Prompt-Eingabe zu erweitern und die Ergebnisse zu verbessern
Im Tutorial PDFs in einer RAG-Pipeline (Retrieval-Augmented Generation) parsen erfahren Sie, wie Sie eine RAG-Pipeline basierend auf geparsten PDF-Inhalten erstellen.
Sie können Vektorsuchen auch mit BigQuery DataFrames in Python durchführen. Ein Notebook, das diesen Ansatz veranschaulicht, finden Sie unter Vektorsuchanwendung mit BigQuery DataFrames erstellen.