


Dans ce tutoriel, vous allez utiliser un modèle distant avec la fonction AI.GENERATE_EMBEDDING pour générer des représentations vectorielles continues de texte dans une table BigQuery. Vous créez ensuite un index vectoriel pour indexer les embeddings et améliorer les performances de recherche.
Vous utilisez la fonction VECTOR_SEARCH avec les embeddings pour rechercher du texte similaire. La recherche vectorielle est une technique permettant de comparer des objets similaires à l'aide d'embeddings, qui sont des vecteurs numériques de grande dimension représentant une entité donnée, comme un extrait de texte.
Enfin, vous effectuez une génération augmentée par récupération (RAG) en générant du texte avec la fonction AI.GENERATE_TEXT.
La RAG est un framework d'IA qui combine les points forts des systèmes de récupération d'informations (tels que la recherche et les bases de données) avec les capacités des grands modèles de langage (LLM) génératifs. En combinant vos données et vos connaissances du monde avec les compétences linguistiques des LLM, la génération ancrée est plus précise, à jour et adaptée à vos besoins spécifiques.
Ce tutoriel utilise les données de l'ensemble de données public Google Patents Research.
Objectifs
- Créer un modèle distant BigQuery ML sur un modèle de représentations vectorielles continues Gemini Enterprise Agent Platform.
- Utilisez le modèle distant avec la fonction
AI.GENERATE_EMBEDDINGpour générer des embeddings à partir de texte dans une table BigQuery. - Créez un index vectoriel pour indexer les embeddings afin d'améliorer les performances de recherche.
- Utilisez la fonction
VECTOR_SEARCHavec les embeddings pour rechercher du texte similaire. - Effectuer une génération augmentée de récupération (RAG) en générant du texte avec la fonction
AI.GENERATE_TEXTet en utilisant les résultats de recherche vectorielle pour augmenter la saisie de la requête et améliorer les résultats.
Coûts
Dans ce document, vous utilisez les composants facturables suivants de Google Cloud :
- BigQuery ML: You incur costs for the data that you process in BigQuery.
- Gemini Enterprise Agent Platform: You incur costs for calls to the Agent Platform service that's represented by the remote model.
Pour obtenir une estimation des coûts en fonction de votre utilisation prévue, utilisez le simulateur de coût.
Pour en savoir plus, consultez les pages suivantes sur les tarifs :
Avant de commencer
-
Dans la console Google Cloud , sur la page de sélection du projet, sélectionnez ou créez un projet Google Cloud .
Rôles requis pour sélectionner ou créer un projet
- Sélectionnez un projet : la sélection d'un projet ne nécessite pas de rôle IAM spécifique. Vous pouvez sélectionner n'importe quel projet pour lequel un rôle vous a été attribué.
-
Créer un projet : pour créer un projet, vous devez disposer du rôle Créateur de projet (
roles/resourcemanager.projectCreator), qui contient l'autorisationresourcemanager.projects.create. Découvrez comment attribuer des rôles.
-
Vérifiez que la facturation est activée pour votre projet Google Cloud .
-
Activez les API BigQuery, Cloud Storage et Gemini Enterprise Agent Platform, si ce n'est pas déjà fait.
Rôles requis pour activer les API
Pour activer les API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation grâce au rôle Propriétaire (roles/owner). Sinon, vous pouvez obtenir cette autorisation grâce au rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.
Rôles requis
Pour obtenir les autorisations nécessaires pour suivre ce tutoriel, demandez à votre administrateur de vous accorder les rôles IAM suivants :
-
Créer des ensembles de données, des tables et des modèles : Propriétaire des données BigQuery (
roles/bigquery.dataOwner) -
Pour exécuter des jobs BigQuery : Utilisateur de job BigQuery (
roles/bigquery.jobUser) -
Créer et gérer des connexions : Administrateur de connexion BigQuery (
roles/bigquery.connectionAdmin)
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Vous pouvez également obtenir les autorisations requises avec des rôles personnalisés ou d'autres rôles prédéfinis.
Créer un ensemble de données
Pour créer un ensemble de données BigQuery, sélectionnez l'une des options suivantes :
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
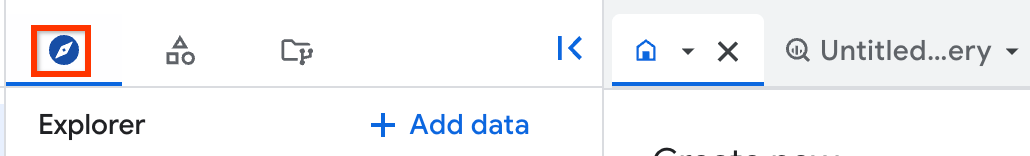
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans l'explorateur, développez votre projet, puis cliquez sur Ensembles de données.
Sur la page Ensembles de données, cliquez sur Créer un ensemble de données.
Dans le volet Créer un ensemble de données, procédez comme suit :
Dans le champ ID de l'ensemble de données, saisissez
bqml_tutorial.Pour Emplacement des données, sélectionnez US.
Ne modifiez pas les autres paramètres par défaut.
Cliquez sur Créer un ensemble de données.
bq
Pour créer un ensemble de données, utilisez la commande bq mk --dataset.
Créez un ensemble de données nommé
bqml_tutorialavec l'emplacement des données défini surUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Vérifiez que l'ensemble de données a été créé :
bq ls
API
Appelez la méthode datasets.insert avec une ressource d'ensemble de données définie :
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Créer le modèle distant pour la génération de représentations vectorielles continues de texte
Dans cette section, vous allez créer un modèle distant représentant un modèle de génération d'embeddings textuels hébergé sur Agent Platform.
Lorsque vous créez le modèle, vous utilisez la connexion DEFAULT pour appeler l'API Text Embeddings afin d'obtenir des embeddings de texte à l'aide du modèle text-embedding-005. Si vous n'avez pas de connexion par défaut, l'instruction CREATE MODEL en crée une pour vous.
Pour créer le modèle d'embedding textuel, procédez comme suit :
Dans la console Google Cloud , accédez à la page BigQuery.
Pour créer le modèle, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
CREATE OR REPLACE MODEL `bqml_tutorial.embedding_model`
  REMOTE WITH CONNECTION DEFAULT
  OPTIONS (ENDPOINT = 'text-embedding-005');
L'exécution de la requête prend plusieurs secondes, après quoi le modèle
embedding_modelest accessible dans le volet Explorateur.Vous recevez un message de confirmation semblable à celui-ci :
Successfully created
model named embedding_model.
Générer des embeddings textuels
Générer des représentations vectorielles continues de texte à partir d'extraits de brevets à l'aide de la fonction AI.GENERATE_EMBEDDING, puis les écrire dans une table BigQuery afin de pouvoir les rechercher.
La génération d'embeddings à l'aide de la fonction AI.GENERATE_EMBEDDING peut échouer en raison des quotas de LLM Agent Platform ou de l'indisponibilité du service. En cas d'échec, les détails de l'erreur sont renvoyés dans la colonne status des résultats de la requête.
Pour découvrir d'autres méthodes de génération d'embeddings textuels dans BigQuery, consultez le tutoriel Intégrer du texte avec des modèles TensorFlow pré-entraînés.
Pour générer des embeddings de texte, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
CREATE OR REPLACE TABLEbqml_tutorial.embeddingsAS SELECT * FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, ( SELECT *, abstract AS content FROMpatents-public-data.google_patents_research.publicationsWHERE LENGTH(abstract) > 0 AND LENGTH(title) > 0 AND country = 'Singapore' ) ) WHERE LENGTH(status) = 0;
L'exécution de cette requête prend plusieurs minutes. Vous recevez un message de confirmation semblable à celui-ci :This statement created a new table named
embeddings.
Créer un index vectoriel
Si vous créez un index vectoriel sur une colonne d'embedding, une recherche vectorielle effectuée sur cette colonne utilise la technique de recherche Approximate Nearest Neighbor. Cette technique améliore les performances de la recherche vectorielle et renvoie des résultats plus approximatifs, mais le rappel est réduit.
Pour créer un index vectoriel, utilisez l'instruction LDD (langage de définition de données) CREATE VECTOR INDEX. Pour vérifier que l'index est disponible, interrogez la vue INFORMATION_SCHEMA.VECTOR_INDEXES afin de vérifier que la valeur de la colonne coverage_percentage est supérieure à 0 et que la valeur de la colonne last_refresh_time n'est pas NULL.
Pour créer et valider l'index vectoriel, procédez comme suit :
Pour créer l'index vectoriel, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
CREATE OR REPLACE VECTOR INDEX my_index
ON `bqml_tutorial.embeddings`(embedding)
OPTIONS(index_type = 'IVF',
  distance_type = 'COSINE',
  ivf_options = '{"num_lists":500}');
Vous recevez un message de confirmation semblable à celui-ci :
The vector index
creation on table bqml_tutorial.embeddings was initiated. Please query
bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES to check the progress of the
index.
La création d'un index vectoriel ne prend généralement que quelques secondes. Le remplissage asynchrone de l'index vectoriel prend deux à trois minutes supplémentaires.
Pour vérifier que l'index est prêt à être utilisé, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
SELECT table_name, index_name, index_status,
coverage_percentage, last_refresh_time, disable_reason
FROM `PROJECT_ID.bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES`;
Remplacez
PROJECT_IDpar l'ID du projet.Une fois la requête exécutée, l'index est disponible si la colonne
index_statusdes résultats indique que l'index estACTIVEet si la valeurcoverage_percentageest100.
Effectuer une recherche de similarité textuelle à l'aide de l'index vectoriel
Utilisez la fonction VECTOR_SEARCH pour rechercher les brevets pertinents correspondant à des embeddings générés à partir d'une requête de texte.
L'argument top_k détermine le nombre de correspondances à renvoyer (cinq dans ce cas). L'option fraction_lists_to_search détermine le pourcentage de listes d'index vectoriels à rechercher.
L'index vectoriel que vous avez créé comporte 500 listes. La valeur fraction_lists_to_search de .01 indique donc que cette recherche vectorielle analyse cinq de ces listes. Une valeur fraction_lists_to_search plus faible, comme indiqué ici, offre un rappel plus faible et des performances plus rapides.
Pour en savoir plus sur les listes d'index vectoriels, consultez l'option d'index vectoriel num_lists.
Le modèle que vous utilisez pour générer les embeddings dans cette requête doit être le même que celui utilisé pour générer les embeddings dans la table à comparer, sinon les résultats de la recherche ne seront pas précis.
Pour effectuer une recherche de similarité textuelle, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
SELECT query.query, base.publication_number, base.title, base.abstract FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content)) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}');
Le résultat ressemble à ce qui suit :
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
|            query            | publication_number |                       title                     |                      abstract                   |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
| improving password security | SG-120868-A1       | Data storage device security method and a...    | Methods for improving security in data stora... |
| improving password security | SG-10201610585W-A  | Passsword management system and process...      | PASSSWORD MANAGEMENT SYSTEM AND PROCESS ...     |
| improving password security | SG-148888-A1       | Improved system and method for...               | IMPROVED SYSTEM AND METHOD FOR RANDOM...        |
| improving password security | SG-194267-A1       | Method and system for protecting a password...  | A system for providing security for a...        |
| improving password security | SG-120868-A1       | Data storage device security...                 | Methods for improving security in data...       |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
Créer le modèle distant pour la génération de texte
Pour créer un modèle distant représentant un modèle de génération de texte Agent Platform hébergé, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
  CREATE OR REPLACE MODEL bqml_tutorial.text_model
    REMOTE WITH CONNECTION DEFAULT
    OPTIONS (ENDPOINT = 'gemini-2.5-flash');
Vous recevez un message de confirmation semblable à celui-ci :
Successfully created model named text_model.
Générer du texte augmenté par les résultats de recherche vectorielle
Transmettez les résultats de recherche sous forme de requêtes pour générer du texte à l'aide de la fonction AI.GENERATE_TEXT.
Pour augmenter les résultats de la recherche vectorielle, collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
SELECT result AS generated, prompt FROM AI.GENERATE_TEXT( MODELbqml_tutorial.text_model, ( SELECT CONCAT( 'Propose some project ideas to improve user password security using the context below: ', STRING_AGG( FORMAT("patent title: %s, patent abstract: %s", base.title, base.abstract), ',\n') ) AS prompt, FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content) ) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}') ), STRUCT(600 AS max_output_tokens));
Le résultat ressemble à ce qui suit :
+------------------------------------------------+------------------------------------------------------------+
|            generated                           | prompt                                                     |
+------------------------------------------------+------------------------------------------------------------+
| These patents suggest several project ideas to | Propose some project ideas to improve user password        |
| improve user password security.  Here are      | security using the context below: patent title: Active     |
| some, categorized by the patent they build     | new password entry dialog with compact visual indication   |
| upon:                                          | of adherence to password policy, patent abstract:          |
|                                                | An active new password entry dialog provides a compact     |
| **I. Projects based on "Active new password    | visual indication of adherence to password policies. A     |
| entry dialog with compact visual indication of | visual indication of progress towards meeting all          |
| adherence to password policy":**               | applicable password policies is included in the display    |
|                                                | and updated as new password characters are being...        |
+------------------------------------------------+------------------------------------------------------------+
Effectuer un nettoyage
Pour éviter que les ressources utilisées lors de ce tutoriel soient facturées sur votre compte Google Cloud, supprimez le projet contenant les ressources, ou conservez le projet et supprimez les ressources individuelles.
- Dans la console Google Cloud , accédez à la page Gérer les ressources.
- Dans la liste des projets, sélectionnez le projet que vous souhaitez supprimer, puis cliquez sur Supprimer.
- Dans la boîte de dialogue, saisissez l'ID du projet, puis cliquez sur Arrêter pour supprimer le projet.
Vous pouvez également conserver le projet et supprimer les ressources utilisées dans ce tutoriel en procédant comme suit :
Accédez à la page BigQuery.
Dans le volet de gauche, développez votre projet, puis cliquez sur Ensembles de données.
Pour l'ensemble de données
bqml_tutorial, cliquez sur Ouvrir les actions > Supprimer.Dans la boîte de dialogue Supprimer l'ensemble de données, cliquez sur Supprimer pour confirmer l'opération.
Dans le volet de gauche, cliquez sur Connexions.
Pour la connexion
__default_cloudresource_connection__, cliquez sur Ouvrir les actions > Supprimer.Dans la boîte de dialogue Supprimer la connexion, saisissez
delete, puis cliquez sur Supprimer pour confirmer.
Étapes suivantes
- Pour savoir comment créer un pipeline RAG basé sur le contenu PDF analysé, consultez Analyser des PDF dans un pipeline de génération augmentée par récupération.