


Dalam tutorial ini, Anda akan menggunakan model jarak jauh
dengan fungsi AI.GENERATE_EMBEDDING
untuk membuat embedding teks
dalam tabel BigQuery. Kemudian, Anda membuat indeks vektor
untuk mengindeks embedding guna meningkatkan performa penelusuran.
Anda menggunakan fungsi VECTOR_SEARCH
dengan embedding untuk menelusuri teks serupa. Penelusuran vektor adalah teknik untuk
membandingkan objek serupa menggunakan embedding, yang merupakan vektor numerik
berdimensi tinggi yang merepresentasikan entity tertentu, seperti potongan teks.
Terakhir, Anda melakukan Retrieval-Augmented Generation (RAG)
dengan membuat teks menggunakan fungsi AI.GENERATE_TEXT.
RAG adalah framework AI yang menggabungkan kekuatan sistem pengambilan informasi (seperti penelusuran dan database) dengan kemampuan model bahasa besar (LLM) generatif. Dengan menggabungkan data dan pengetahuan dasar Anda beserta keterampilan bahasa LLM, grounding akan memberikan hasil yang lebih akurat, aktual, dan relevan dengan kebutuhan spesifik Anda.
Tutorial ini menggunakan data dari set data publik Google Patents Research.
Tujuan
- Membuat model jarak jauh BigQuery ML melalui model penyematan Gemini Enterprise Agent Platform.
- Gunakan model jarak jauh dengan fungsi
AI.GENERATE_EMBEDDINGuntuk membuat embedding dari teks dalam tabel BigQuery. - Buat indeks vektor untuk mengindeks embedding guna meningkatkan performa penelusuran.
- Gunakan fungsi
VECTOR_SEARCHdengan embedding untuk menelusuri teks serupa. - Lakukan RAG dengan membuat teks menggunakan fungsi
AI.GENERATE_TEXT, dan menggunakan hasil penelusuran vektor untuk meningkatkan input perintah dan memperbaiki hasil.
Biaya
Dalam dokumen ini, Anda akan menggunakan komponen Google Cloudyang dapat ditagih berikut:
- BigQuery ML: You incur costs for the data that you process in BigQuery.
- Gemini Enterprise Agent Platform: You incur costs for calls to the Agent Platform service that's represented by the remote model.
Untuk membuat perkiraan biaya berdasarkan proyeksi penggunaan Anda,
gunakan kalkulator harga.
Untuk mengetahui informasi selengkapnya, lihat halaman harga berikut:
Sebelum memulai
-
Di konsol Google Cloud , pada halaman pemilih project, pilih atau buat project Google Cloud .
Peran yang diperlukan untuk memilih atau membuat project
- Pilih project: Memilih project tidak memerlukan peran IAM tertentu—Anda dapat memilih project mana pun yang telah diberi peran.
-
Membuat project: Untuk membuat project, Anda memerlukan peran Project Creator
(
roles/resourcemanager.projectCreator), yang berisi izinresourcemanager.projects.create. Pelajari cara memberikan peran.
-
Verifikasi bahwa penagihan diaktifkan untuk project Google Cloud Anda.
-
Aktifkan BigQuery, Cloud Storage, dan Gemini Enterprise Agent Platform API, jika ada yang belum diaktifkan.
Peran yang diperlukan untuk mengaktifkan API
Untuk mengaktifkan API, Anda memerlukan izin
serviceusage.services.enable. Jika Anda membuat project, kemungkinan Anda sudah memiliki izin ini melalui peran Pemilik (roles/owner). Jika tidak, Anda bisa mendapatkan izin ini melalui peran Admin Penggunaan Layanan (roles/serviceusage.serviceUsageAdmin). Pelajari cara memberikan peran.
Peran yang diperlukan
Untuk mendapatkan izin yang Anda perlukan untuk menyelesaikan tutorial ini, minta administrator Anda untuk memberi Anda peran IAM berikut:
-
Membuat set data, tabel, dan model:
BigQuery Data Owner (
roles/bigquery.dataOwner) -
Menjalankan tugas BigQuery:
BigQuery Job User (
roles/bigquery.jobUser) -
Membuat dan mengelola koneksi:
BigQuery Connection Admin (
roles/bigquery.connectionAdmin)
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project, folder, dan organisasi.
Anda mungkin juga bisa mendapatkan izin yang diperlukan melalui peran khusus atau peran bawaan lainnya.
Membuat set data
Untuk membuat set data BigQuery, pilih salah satu opsi berikut:
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di panel kiri, klik Explorer:
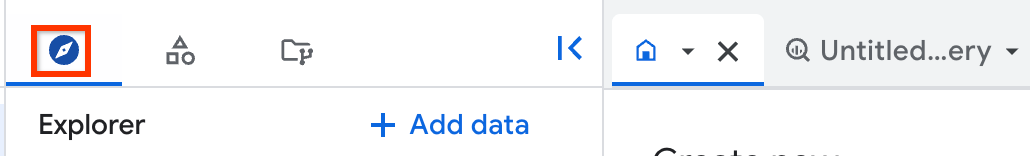
Jika Anda tidak melihat panel kiri, klik Luaskan panel kiri untuk membuka panel.
Di Explorer, luaskan project Anda, lalu klik Datasets.
Di halaman Set Data, klik Buat set data.
Di panel Create dataset, lakukan hal berikut:
Untuk Dataset ID, masukkan
bqml_tutorial.Untuk Lokasi data, pilih Amerika Serikat.
Jangan ubah setelan default yang tersisa.
Klik Create dataset.
bq
Untuk membuat set data baru, gunakan
perintah bq mk --dataset.
Buat set data bernama
bqml_tutorialdengan lokasi data yang ditetapkan keUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Pastikan set data telah dibuat:
bq ls
API
Panggil metode datasets.insert
dengan resource set data yang ditentukan:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Membuat model jarak jauh untuk pembuatan penyematan teks
Di bagian ini, Anda akan membuat model jarak jauh yang merepresentasikan model pembuatan embedding teks Agent Platform yang dihosting.
Saat membuat model, Anda menggunakan koneksi DEFAULT
untuk memanggil Text embeddings API
guna mendapatkan embedding teks menggunakan model text-embedding-005. Jika Anda tidak memiliki koneksi default, pernyataan CREATE MODEL akan membuatnya untuk Anda.
Untuk membuat model penyematan teks, ikuti langkah-langkah berikut:
Di konsol Google Cloud , buka halaman BigQuery.
Untuk membuat model, tempel perintah ini ke editor kueri, lalu klik Run:
CREATE OR REPLACE MODEL `bqml_tutorial.embedding_model`
  REMOTE WITH CONNECTION DEFAULT
  OPTIONS (ENDPOINT = 'text-embedding-005');
Kueri memerlukan waktu beberapa detik untuk diselesaikan, setelah itu model
embedding_modeldapat diakses melalui panel Explorer.Anda akan menerima pesan konfirmasi seperti berikut:
Successfully created
model named embedding_model.
Membuat embedding teks
Buat embedding teks dari abstrak paten menggunakan
fungsi AI.GENERATE_EMBEDDING,
lalu tulis ke tabel BigQuery agar dapat
dicari.
Pembuatan sematan menggunakan
fungsi AI.GENERATE_EMBEDDING
mungkin gagal karena kuota LLM Agent Platform
atau layanan tidak tersedia. Jika gagal, detail error akan ditampilkan di kolom status dalam hasil kueri.
Untuk metode pembuatan embedding teks alternatif di BigQuery, lihat tutorial Menyematkan teks dengan model TensorFlow yang telah dilatih sebelumnya.
Untuk membuat embedding teks, tempel perintah ini ke editor kueri, lalu klik Run:
CREATE OR REPLACE TABLEbqml_tutorial.embeddingsAS SELECT * FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, ( SELECT *, abstract AS content FROMpatents-public-data.google_patents_research.publicationsWHERE LENGTH(abstract) > 0 AND LENGTH(title) > 0 AND country = 'Singapore' ) ) WHERE LENGTH(status) = 0;
Kueri ini membutuhkan waktu beberapa menit hingga selesai. Anda akan menerima pesan konfirmasi seperti berikut:This statement created a new table named
embeddings.
Membuat indeks vektor
Jika Anda membuat indeks vektor pada kolom embedding, penelusuran vektor yang dilakukan pada kolom tersebut akan menggunakan teknik penelusuran Approximate Nearest Neighbor. Teknik ini meningkatkan performa penelusuran vektor dan menampilkan hasil yang lebih mendekati, tetapi perolehan berkurang.
Untuk membuat indeks vektor, Anda menggunakan pernyataan bahasa definisi data (DDL)
CREATE VECTOR INDEX. Untuk memverifikasi bahwa indeks tersedia,
Anda membuat kueri tampilan INFORMATION_SCHEMA.VECTOR_INDEXES
untuk memverifikasi bahwa nilai kolom coverage_percentage lebih besar daripada 0,
dan nilai kolom last_refresh_time bukan NULL.
Untuk membuat dan memverifikasi indeks vektor, ikuti langkah-langkah berikut:
Untuk membuat indeks vektor, tempel perintah ini ke editor kueri, lalu klik Run:
CREATE OR REPLACE VECTOR INDEX my_index
ON `bqml_tutorial.embeddings`(embedding)
OPTIONS(index_type = 'IVF',
  distance_type = 'COSINE',
  ivf_options = '{"num_lists":500}');
Anda akan menerima pesan konfirmasi seperti berikut:
The vector index
creation on table bqml_tutorial.embeddings was initiated. Please query
bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES to check the progress of the
index.
Membuat indeks vektor biasanya hanya memerlukan waktu beberapa detik. Diperlukan waktu dua hingga tiga menit lagi agar indeks vektor diisi secara asinkron.
Untuk memverifikasi bahwa indeks siap digunakan, tempel perintah ini ke editor kueri, lalu klik Run:
SELECT table_name, index_name, index_status,
coverage_percentage, last_refresh_time, disable_reason
FROM `PROJECT_ID.bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES`;
Ganti
PROJECT_IDdengan project ID Anda.Setelah Anda menjalankan kueri, indeks tersedia jika kolom
index_statusdalam hasil menunjukkan bahwa indeks adalahACTIVE, dan jika nilaicoverage_percentageadalah100.
Melakukan penelusuran kemiripan teks menggunakan indeks vektor
Gunakan
fungsi VECTOR_SEARCH
untuk menelusuri paten yang relevan dan cocok dengan embedding yang dihasilkan dari
kueri teks.
Argumen top_k menentukan jumlah kecocokan yang akan ditampilkan, dalam hal ini lima. Opsi fraction_lists_to_search menentukan persentase daftar indeks vektor yang akan ditelusuri.
Indeks vektor yang Anda buat memiliki 500 daftar, sehingga
nilai fraction_lists_to_search dari .01 menunjukkan bahwa penelusuran vektor ini
memindai lima daftar tersebut. Nilai fraction_lists_to_search yang lebih rendah seperti yang ditunjukkan di sini memberikan
recall yang lebih rendah dan performa yang lebih cepat.
Untuk mengetahui informasi selengkapnya tentang daftar indeks vektor, lihat num_lists
opsi indeks vektor.
Model yang Anda gunakan untuk membuat embedding dalam kueri ini harus sama dengan model yang Anda gunakan untuk membuat embedding dalam tabel yang Anda bandingkan, jika tidak, hasil penelusuran tidak akan akurat.
Untuk melakukan penelusuran kesamaan teks, tempel perintah ini ke editor kueri, lalu klik Run:
SELECT query.query, base.publication_number, base.title, base.abstract FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content)) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}');
Outputnya mirip dengan hal berikut ini:
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
|            query            | publication_number |                       title                     |                      abstract                   |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
| improving password security | SG-120868-A1       | Data storage device security method and a...    | Methods for improving security in data stora... |
| improving password security | SG-10201610585W-A  | Passsword management system and process...      | PASSSWORD MANAGEMENT SYSTEM AND PROCESS ...     |
| improving password security | SG-148888-A1       | Improved system and method for...               | IMPROVED SYSTEM AND METHOD FOR RANDOM...        |
| improving password security | SG-194267-A1       | Method and system for protecting a password...  | A system for providing security for a...        |
| improving password security | SG-120868-A1       | Data storage device security...                 | Methods for improving security in data...       |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
Membuat model jarak jauh untuk pembuatan teks
Untuk membuat model jarak jauh yang merepresentasikan model pembuatan teks Agent Platform yang dihosting, tempel perintah ini ke editor kueri, lalu klik Run:
  CREATE OR REPLACE MODEL bqml_tutorial.text_model
    REMOTE WITH CONNECTION DEFAULT
    OPTIONS (ENDPOINT = 'gemini-2.5-flash');
Anda akan menerima pesan konfirmasi yang mirip dengan berikut ini:
Successfully created model named text_model.
Membuat teks yang ditingkatkan dengan hasil penelusuran vektor
Berikan hasil penelusuran sebagai perintah untuk membuat teks dengan
fungsi AI.GENERATE_TEXT.
Untuk meningkatkan hasil penelusuran vektor, tempel perintah ini ke editor kueri, lalu klik Run:
SELECT result AS generated, prompt FROM AI.GENERATE_TEXT( MODELbqml_tutorial.text_model, ( SELECT CONCAT( 'Propose some project ideas to improve user password security using the context below: ', STRING_AGG( FORMAT("patent title: %s, patent abstract: %s", base.title, base.abstract), ',\n') ) AS prompt, FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content) ) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}') ), STRUCT(600 AS max_output_tokens));
Outputnya mirip dengan hal berikut ini:
+------------------------------------------------+------------------------------------------------------------+
|            generated                           | prompt                                                     |
+------------------------------------------------+------------------------------------------------------------+
| These patents suggest several project ideas to | Propose some project ideas to improve user password        |
| improve user password security.  Here are      | security using the context below: patent title: Active     |
| some, categorized by the patent they build     | new password entry dialog with compact visual indication   |
| upon:                                          | of adherence to password policy, patent abstract:          |
|                                                | An active new password entry dialog provides a compact     |
| **I. Projects based on "Active new password    | visual indication of adherence to password policies. A     |
| entry dialog with compact visual indication of | visual indication of progress towards meeting all          |
| adherence to password policy":**               | applicable password policies is included in the display    |
|                                                | and updated as new password characters are being...        |
+------------------------------------------------+------------------------------------------------------------+
Pembersihan
Agar tidak perlu membayar biaya pada akun Google Cloud Anda untuk resource yang digunakan dalam tutorial ini, hapus project yang berisi resource tersebut, atau simpan project dan hapus setiap resource.
- Di konsol Google Cloud , buka halaman Manage resources.
- Pada daftar project, pilih project yang ingin Anda hapus, lalu klik Delete.
- Pada dialog, ketik project ID, lalu klik Shut down untuk menghapus project.
Atau, untuk mempertahankan project dan menghapus resource yang digunakan dalam tutorial ini, ikuti langkah-langkah berikut:
Buka halaman BigQuery.
Di panel kiri, luaskan project Anda, lalu klik Set Data.
Untuk set data
bqml_tutorial, klik Open actions > Delete.Di dialog Hapus set data, klik Hapus untuk mengonfirmasi.
Di panel kiri, klik Connections.
Untuk koneksi
__default_cloudresource_connection__, klik Open actions > Delete.Di dialog Hapus koneksi, masukkan
delete, lalu klik Hapus untuk mengonfirmasi.
Langkah berikutnya
- Untuk mempelajari cara membuat pipeline RAG berdasarkan konten PDF yang diurai, lihat Mengurai PDF dalam pipeline retrieval-augmented generation.