


In questo tutorial, utilizzi un modello remoto
con la funzione AI.GENERATE_EMBEDDING
per generare embedding di testo
in una tabella BigQuery. Quindi, crea un indice vettoriale
per indicizzare gli incorporamenti e migliorare il rendimento della ricerca.
Utilizzi la funzione VECTOR_SEARCH
con gli embedding per cercare testo simile. La ricerca vettoriale è una tecnica per
confrontare oggetti simili utilizzando gli incorporamenti, che sono vettori numerici
ad alta dimensione che rappresentano una determinata entità, come un testo.
Infine, esegui la generazione Retrieval-Augmented Generation (RAG)
generando testo con la funzione AI.GENERATE_TEXT.
La RAG è un framework di AI che combina i punti di forza dei sistemi di recupero di informazioni (come i database e la ricerca) con le capacità dei modelli linguistici di grandi dimensioni (LLM) generativi. Grazie alla combinazione dei tuoi dati e delle tue conoscenze del mondo con le competenze linguistiche degli LLM, la generazione eseguita con grounding è più accurata, aggiornata e pertinente alle tue esigenze specifiche.
Questo tutorial utilizza i dati del set di dati pubblico Google Brevetti Research.
Obiettivi
- Crea un modello remoto BigQuery ML su un modello di incorporamento di Gemini Enterprise Agent Platform.
- Utilizza il modello remoto con la funzione
AI.GENERATE_EMBEDDINGper generare gli embedding dal testo in una tabella BigQuery. - Crea un indice vettoriale per indicizzare gli incorporamenti al fine di migliorare il rendimento della ricerca.
- Utilizza la funzione
VECTOR_SEARCHcon gli incorporamenti per cercare testo simile. - Esegui RAG generando testo con la funzione
AI.GENERATE_TEXTe utilizzando i risultati della ricerca vettoriale per aumentare l'input del prompt e migliorare i risultati.
Costi
In questo documento vengono utilizzati i seguenti componenti fatturabili di Google Cloud:
- BigQuery ML: You incur costs for the data that you process in BigQuery.
- Gemini Enterprise Agent Platform: You incur costs for calls to the Agent Platform service that's represented by the remote model.
Per generare una stima dei costi in base all'utilizzo previsto,
utilizza il calcolatore prezzi.
Per saperne di più, consulta le seguenti pagine dei prezzi:
Prima di iniziare
-
Nella console Google Cloud , nella pagina di selezione del progetto, seleziona o crea un progetto Google Cloud .
Ruoli richiesti per selezionare o creare un progetto
- Seleziona un progetto: la selezione di un progetto non richiede un ruolo IAM specifico. Puoi selezionare qualsiasi progetto per il quale ti è stato concesso un ruolo.
-
Crea un progetto: per creare un progetto, devi disporre del ruolo Autore progetto
(
roles/resourcemanager.projectCreator), che contiene l'autorizzazioneresourcemanager.projects.create. Scopri come concedere i ruoli.
-
Verifica che la fatturazione sia attivata per il tuo progetto Google Cloud .
-
Abilita le API BigQuery, Cloud Storage e Gemini Enterprise Agent Platform, se non sono già abilitate.
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione
serviceusage.services.enable. Se hai creato il progetto, probabilmente disponi già di questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore utilizzo dei servizi (roles/serviceusage.serviceUsageAdmin). Scopri come concedere i ruoli.
Ruoli obbligatori
Per ottenere le autorizzazioni necessarie per completare questo tutorial, chiedi all'amministratore di concederti i seguenti ruoli IAM:
-
Crea set di dati, tabelle e modelli:
Proprietario dati BigQuery (
roles/bigquery.dataOwner) -
Esegui job BigQuery:
Utente job BigQuery (
roles/bigquery.jobUser) -
Crea e gestisci connessioni:
Amministratore connessioni BigQuery (
roles/bigquery.connectionAdmin)
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Potresti anche riuscire a ottenere le autorizzazioni richieste tramite i ruoli personalizzati o altri ruoli predefiniti.
Crea un set di dati
Per creare un set di dati BigQuery, seleziona una delle seguenti opzioni:
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Explorer:
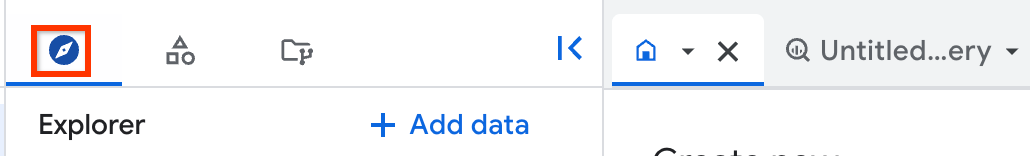
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro a sinistra per aprirlo.
In Explorer, espandi il progetto e fai clic su Set di dati.
Nella pagina Set di dati, fai clic su Crea set di dati.
Nel riquadro Crea set di dati, segui questi passaggi:
In ID set di dati, inserisci
bqml_tutorial.Per Località dei dati, seleziona USA.
Lascia invariate le altre impostazioni predefinite.
Fai clic su Crea set di dati.
bq
Per creare un nuovo set di dati, utilizza il
comando bq mk --dataset.
Crea un set di dati denominato
bqml_tutorialcon la località dei dati impostata suUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Verifica che il set di dati sia stato creato:
bq ls
API
Chiama il metodo datasets.insert con una risorsa dataset definita:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Crea il modello remoto per la generazione di text embedding
In questa sezione, crei un modello remoto che rappresenta un modello di generazione di text embedding di Agent Platform ospitato.
Quando crei il modello, utilizzi la connessione DEFAULT
per chiamare l'API Text Embeddings
per ottenere gli embedding di testo utilizzando il modello text-embedding-005. Se non hai una connessione predefinita, l'istruzione CREATE MODEL ne crea una per te.
Per creare il modello di text embedding, segui questi passaggi:
Nella console Google Cloud , vai alla pagina BigQuery.
Per creare il modello, incolla questo comando nell'editor di query e poi fai clic su Esegui:
CREATE OR REPLACE MODEL `bqml_tutorial.embedding_model`
  REMOTE WITH CONNECTION DEFAULT
  OPTIONS (ENDPOINT = 'text-embedding-005');
Il completamento della query richiede diversi secondi, dopodiché è possibile accedere al modello
embedding_modeltramite il riquadro Explorer.Ricevi un messaggio di conferma come il seguente:
Successfully created
model named embedding_model.
Generare incorporamenti di testo
Genera embedding di testo dagli abstract dei brevetti utilizzando la
funzione AI.GENERATE_EMBEDDING e poi scrivili in una tabella BigQuery in modo che possano essere
cercati.
La generazione di incorporamenti utilizzando la
funzione AI.GENERATE_EMBEDDING
potrebbe non riuscire a causa delle quote
del LLM di Agent Platform o dell'indisponibilità del servizio. In caso di errore, i dettagli vengono restituiti nella
colonna status nei risultati della query.
Per metodi alternativi di generazione di embedding di testo in BigQuery, consulta il tutorial Incorpora testo con modelli TensorFlow preaddestrati.
Per generare incorporamenti di testo, incolla questo comando nell'editor di query, quindi fai clic su Esegui:
CREATE OR REPLACE TABLEbqml_tutorial.embeddingsAS SELECT * FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, ( SELECT *, abstract AS content FROMpatents-public-data.google_patents_research.publicationsWHERE LENGTH(abstract) > 0 AND LENGTH(title) > 0 AND country = 'Singapore' ) ) WHERE LENGTH(status) = 0;
Il completamento di questa query richiede diversi minuti. Ricevi un messaggio di conferma
come il seguente:This statement created a new table named
embeddings.
Crea un indice vettoriale
Se crei un indice vettoriale su una colonna di embedding, una ricerca vettoriale eseguita su quella colonna utilizza la tecnica di ricerca del vicino più prossimo approssimato. Questa tecnica migliora le prestazioni della ricerca vettoriale e restituisce risultati più approssimativi, ma il richiamo viene ridotto.
Per creare un indice vettoriale, utilizza l'istruzione
CREATE VECTOR INDEX
DDL (Data Definition Language). Per verificare che l'indice sia disponibile,
esegui una query sulla visualizzazione INFORMATION_SCHEMA.VECTOR_INDEXES
per verificare che il valore della colonna coverage_percentage sia maggiore di 0
e che il valore della colonna last_refresh_time non sia NULL.
Per creare e verificare l'indice vettoriale:
Per creare l'indice vettoriale, incolla questo comando nell'editor di query e poi fai clic su Esegui:
CREATE OR REPLACE VECTOR INDEX my_index
ON `bqml_tutorial.embeddings`(embedding)
OPTIONS(index_type = 'IVF',
  distance_type = 'COSINE',
  ivf_options = '{"num_lists":500}');
Ricevi un messaggio di conferma come il seguente:
The vector index
creation on table bqml_tutorial.embeddings was initiated. Please query
bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES to check the progress of the
index.
In genere la creazione di un indice vettoriale richiede solo pochi secondi. L'indice vettoriale viene compilato in modo asincrono in altri due o tre minuti.
Per verificare che l'indice sia pronto per l'uso, incolla questo comando nell'editor di query e poi fai clic su Esegui:
SELECT table_name, index_name, index_status,
coverage_percentage, last_refresh_time, disable_reason
FROM `PROJECT_ID.bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES`;
Sostituisci
PROJECT_IDcon l'ID progetto.Dopo aver eseguito la query, l'indice è disponibile se la colonna
index_statusnei risultati mostra che l'indice èACTIVEe se il valorecoverage_percentageè100.
Esegui una ricerca di similarità del testo utilizzando l'indice vettoriale
Utilizza la
funzione VECTOR_SEARCH
per cercare brevetti pertinenti che corrispondono agli incorporamenti generati da una
query di testo.
L'argomento top_k determina il numero di corrispondenze da restituire,
in questo caso cinque. L'opzione fraction_lists_to_search determina la
percentuale di elenchi di indici vettoriali da cercare.
L'indice vettoriale che hai creato ha 500 elenchi, quindi
il valore fraction_lists_to_search di .01 indica che questa ricerca vettoriale
scansiona cinque di questi elenchi. Un valore fraction_lists_to_search inferiore, come mostrato
qui, fornisce un
richiamo
inferiore e un rendimento più rapido.
Per saperne di più sugli elenchi di indici vettoriali, consulta l'num_lists
opzione di indice vettoriale.
Il modello che utilizzi per generare gli embedding in questa query deve essere lo stesso che utilizzi per generare gli embedding nella tabella con cui esegui il confronto, altrimenti i risultati di ricerca non saranno accurati.
Per eseguire una ricerca di similarità del testo, incolla questo comando nell'editor di query, quindi fai clic su Esegui:
SELECT query.query, base.publication_number, base.title, base.abstract FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content)) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}');
L'output è simile al seguente:
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
|            query            | publication_number |                       title                     |                      abstract                   |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
| improving password security | SG-120868-A1       | Data storage device security method and a...    | Methods for improving security in data stora... |
| improving password security | SG-10201610585W-A  | Passsword management system and process...      | PASSSWORD MANAGEMENT SYSTEM AND PROCESS ...     |
| improving password security | SG-148888-A1       | Improved system and method for...               | IMPROVED SYSTEM AND METHOD FOR RANDOM...        |
| improving password security | SG-194267-A1       | Method and system for protecting a password...  | A system for providing security for a...        |
| improving password security | SG-120868-A1       | Data storage device security...                 | Methods for improving security in data...       |
+-----------------------------+--------------------+-------------------------------------------------+-------------------------------------------------+
Crea il modello remoto per la generazione di testo
Per creare un modello remoto che rappresenti un modello di generazione di testo di Agent Platform ospitato, incolla questo comando nell'editor di query e poi fai clic su Esegui:
  CREATE OR REPLACE MODEL bqml_tutorial.text_model
    REMOTE WITH CONNECTION DEFAULT
    OPTIONS (ENDPOINT = 'gemini-2.5-flash');
Ricevi un messaggio di conferma simile al seguente:
Successfully created model named text_model.
Generare testo arricchito dai risultati della ricerca vettoriale
Inserisci i risultati di ricerca come prompt per generare testo con la
funzione AI.GENERATE_TEXT.
Per migliorare i risultati della ricerca vettoriale, incolla questo comando nell'editor di query, quindi fai clic su Esegui:
SELECT result AS generated, prompt FROM AI.GENERATE_TEXT( MODELbqml_tutorial.text_model, ( SELECT CONCAT( 'Propose some project ideas to improve user password security using the context below: ', STRING_AGG( FORMAT("patent title: %s, patent abstract: %s", base.title, base.abstract), ',\n') ) AS prompt, FROM VECTOR_SEARCH( TABLEbqml_tutorial.embeddings, 'embedding', ( SELECT embedding, content AS query FROM AI.GENERATE_EMBEDDING( MODELbqml_tutorial.embedding_model, (SELECT 'improving password security' AS content) ) ), top_k => 5, options => '{"fraction_lists_to_search": 0.01}') ), STRUCT(600 AS max_output_tokens));
L'output è simile al seguente:
+------------------------------------------------+------------------------------------------------------------+
|            generated                           | prompt                                                     |
+------------------------------------------------+------------------------------------------------------------+
| These patents suggest several project ideas to | Propose some project ideas to improve user password        |
| improve user password security.  Here are      | security using the context below: patent title: Active     |
| some, categorized by the patent they build     | new password entry dialog with compact visual indication   |
| upon:                                          | of adherence to password policy, patent abstract:          |
|                                                | An active new password entry dialog provides a compact     |
| **I. Projects based on "Active new password    | visual indication of adherence to password policies. A     |
| entry dialog with compact visual indication of | visual indication of progress towards meeting all          |
| adherence to password policy":**               | applicable password policies is included in the display    |
|                                                | and updated as new password characters are being...        |
+------------------------------------------------+------------------------------------------------------------+
Esegui la pulizia
Per evitare che al tuo account Google Cloud vengano addebitati costi relativi alle risorse utilizzate in questo tutorial, elimina il progetto che contiene le risorse oppure mantieni il progetto ed elimina le singole risorse.
- Nella console Google Cloud , vai alla pagina Gestisci risorse.
- Nell'elenco dei progetti, seleziona quello che vuoi eliminare, quindi fai clic su Elimina.
- Nella finestra di dialogo, digita l'ID progetto, quindi fai clic su Chiudi per eliminare il progetto.
In alternativa, per conservare il progetto ed eliminare le risorse utilizzate in questo tutorial, segui questi passaggi:
Vai alla pagina BigQuery.
Nel riquadro a sinistra, espandi il progetto e fai clic su Set di dati.
Per il set di dati
bqml_tutorial, fai clic su Apri azioni > Elimina.Nella finestra di dialogo Elimina set di dati, fai clic su Elimina per confermare.
Nel riquadro a sinistra, fai clic su Connessioni.
Per la connessione
__default_cloudresource_connection__, fai clic su Apri azioni > Elimina.Nella finestra di dialogo Elimina connessione, inserisci
delete, quindi fai clic su Elimina per confermare.
Passaggi successivi
- Per scoprire come creare una pipeline RAG basata sui contenuti PDF analizzati, vedi Analizzare i PDF in una pipeline di Retrieval-Augmented Generation.