


In dieser Anleitung erfahren Sie, wie Sie ein Modell optimieren, das einen bestimmten Satz durch präzisere Formulierungen oder das Hinzufügen von Qualifizierern ergänzt, ohne die Gesamtbedeutung zu ändern. Sie erstellen ein Remote-Modell, das auf ein Gemini Enterprise Agent Platform-Modell verweist, verwenden überwachte Abstimmung und bewerten das abgestimmte Modell dann mit der Funktion ML.EVALUATE.
Mit der Abstimmung können Sie das gehostete Agent Platform-Modell anpassen, z. B. wenn das erwartete Verhalten schwierig in einem Prompt zu definieren ist oder wenn Prompts nicht konsistent die erwarteten Ergebnisse liefern. Die überwachte Abstimmung wirkt sich auch so auf das Modell aus:
- Leitet das Modell so, dass bestimmte Antwortstile zurückgegeben werden, z. B. mit prägnanteren oder ausführlicheren Antworten.
- Bringt dem Modell neue Verhaltensweisen bei, z. B. das Beantworten von Prompts als eine bestimmte Persona.
- Das Modell wird mit neuen Informationen aktualisiert.
In diesem Tutorial soll das Modell Text generieren, dessen Stil und Inhalt so genau wie möglich dem bereitgestellten Ground-Truth-Inhalt entsprechen.
Ziele
- Dataset erstellen
- Trainings- und Evaluationsdaten in Tabellen importieren
- Basismodell erstellen
- Leistung des Basismodells bewerten.
- Erstellen Sie ein abgestimmtes Modell.
- Leistung des abgestimmten Modells bewerten
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Google Cloud:
- BigQuery. You incur costs for the queries that you run in BigQuery.
- BigQuery ML. You incur costs for the model that you create and the processing that you perform in BigQuery ML.
- Gemini Enterprise Agent Platform. You incur costs for calls to and supervised tuning of the Gemini model.
Mit dem Preisrechner können Sie eine Kostenschätzung für Ihre voraussichtliche Nutzung vornehmen.
Weitere Informationen finden Sie in den folgenden Ressourcen:
Hinweis
Zum Ausführen dieses Tutorials benötigen Sie die folgenden IAM-Rollen (Identity and Access Management):
- BigQuery-Datasets, ‑Verbindungen und ‑Modelle erstellen und verwenden: BigQuery-Administrator (
roles/bigquery.admin). - Gewähren Sie dem Dienstkonto der Verbindung die Berechtigungen „Projekt-IAM-Administrator“ (
roles/resourcemanager.projectIamAdmin).
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Ausführen der Aufgaben in diesem Dokument erforderlich sind. Erweitern Sie den Abschnitt Erforderliche Berechtigungen, um die erforderlichen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
- Dataset erstellen:
bigquery.datasets.create - Tabelle erstellen:
bigquery.tables.create - Verbindung erstellen, delegieren und verwenden:
bigquery.connections.* - Standardverbindung festlegen:
bigquery.config.* - Dienstkontoberechtigungen festlegen:
resourcemanager.projects.getIamPolicyundresourcemanager.projects.setIamPolicy - Modell erstellen und Inferenz ausführen:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateDatabigquery.models.updateMetadata
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
-
Wählen Sie in der Google Cloud Console auf der Seite für die Projektauswahl ein Google Cloud -Projekt aus oder erstellen Sie eines.
Rollen, die zum Auswählen oder Erstellen eines Projekts erforderlich sind
- Projekt auswählen: Für die Auswahl eines Projekts ist keine bestimmte IAM-Rolle erforderlich. Sie können jedes Projekt auswählen, für das Ihnen eine Rolle zugewiesen wurde.
-
Projekt erstellen: Zum Erstellen eines Projekts benötigen Sie die Rolle „Projektersteller“ (
roles/resourcemanager.projectCreator), die die Berechtigungresourcemanager.projects.createenthält. Weitere Informationen zum Zuweisen von Rollen
-
Prüfen Sie, ob die Abrechnung für Ihr Google Cloud Projekt aktiviert ist.
-
Aktivieren Sie die BigQuery API, die BigQuery Connection API, die Agent Platform API und die Compute Engine API, falls sie noch nicht aktiviert sind.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Dataset erstellen
Wählen Sie eine der folgenden Optionen aus, um ein BigQuery-Dataset zu erstellen:
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
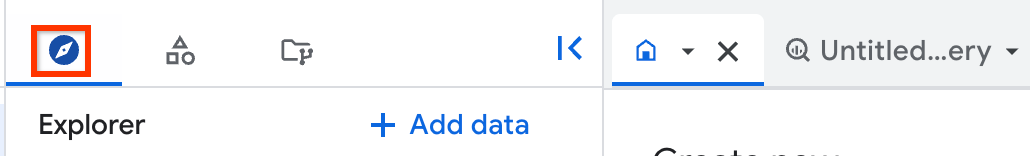
Wenn das linke Steuerfeld nicht angezeigt wird, klicken Sie auf Linkes Steuerfeld maximieren, um es zu öffnen.
Maximieren Sie im Explorer Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie auf der Seite Datasets auf Dataset erstellen.
Führen Sie im Bereich Dataset erstellen die folgenden Schritte aus:
Geben Sie unter Dataset-ID
bqml_tutorialein.Wählen Sie unter Speicherort der Daten die Option USA aus.
Übernehmen Sie die anderen Standardeinstellungen.
Klicken Sie auf Dataset erstellen.
bq
Verwenden Sie den Befehl bq mk --dataset, um ein neues Dataset zu erstellen.
Erstellen Sie ein Dataset mit dem Namen
bqml_tutorialund dem DatenspeicherortUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Prüfen Sie, ob das Dataset erstellt wurde:
bq ls
API
Rufen Sie die Methode datasets.insert mit einer definierten Dataset-Ressource auf:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Testtabellen erstellen
Erstellen Sie Tabellen mit Trainings- und Bewertungsdaten basierend auf dem öffentlichen task955_wiki_auto_style_transfer-Dataset von Hugging Face.
Öffnen Sie Cloud Shell.
Erstellen Sie in Cloud Shell Tabellen mit Test- und Auswertungsdaten:
python3 -m pip install pandas pyarrow fsspec huggingface_hub

python3 -c "import pandas as pd; df_train = pd.read_parquet('hf://datasets/Lots-of-LoRAs/task955_wiki_auto_style_transfer/data/train-00000-of-00001.parquet').drop('id', axis=1); df_train['output'] = [x[0] for x in df_train['output']]; df_train.to_json('wiki_auto_style_transfer_train.jsonl', orient='records', lines=True);"

python3 -c "import pandas as pd; df_valid = pd.read_parquet('hf://datasets/Lots-of-LoRAs/task955_wiki_auto_style_transfer/data/valid-00000-of-00001.parquet').drop('id', axis=1); df_valid['output'] = [x[0] for x in df_valid['output']]; df_valid.to_json('wiki_auto_style_transfer_valid.jsonl', orient='records', lines=True);"

bq load --replace=true --source_format=NEWLINE_DELIMITED_JSON bqml_tutorial.wiki_auto_style_transfer_train wiki_auto_style_transfer_train.jsonl input:STRING,output:STRING

bq load --replace=true --source_format=NEWLINE_DELIMITED_JSON bqml_tutorial.wiki_auto_style_transfer_valid wiki_auto_style_transfer_valid.jsonl input:STRING,output:STRING
Trainingsdaten ansehen
Die Eingabe-Trainingsdaten sind ein Prompt, in dem das Modell aufgefordert wird, einen Satz zu erweitern, ohne seine allgemeine Bedeutung zu ändern. Jeder Prompt enthält dieselben zwei positiven und zwei negativen Beispiele sowie einen Satz, der umgeschrieben werden soll. Die Ausgabe ist der detailliertere Satz, der vom Modell generiert wurde.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor die folgende Anweisung aus, um ein Beispiel für Ein- und Ausgabedaten aufzurufen:
SELECT * FROM bqml_tutorial.wiki_auto_style_transfer_train LIMIT 1;
Das Ergebnis sieht etwa so aus:
+-----------------------------------------------+-------------------------------------------------+
| input                                         | output                                          |
+-----------------------------------------------+-------------------------------------------------+
| Definition: In this task, we ask you to       | Merton College ( in full : The House or College |
| elaborate the sentence without changing its   | of Scholars of Merton in the University of      |
| general meaning. You can do so by explaining  | Oxford ) is one of the constituent colleges of  |
| further the input sentence, using more        | the University of Oxford in England .           |
| precise wording, adding qualifiers and        |                                                 |
| auxiliary information etc.                    |                                                 |
|                                               |                                                 |
| Positive Example 1 -                          |                                                 |
| Input: The Inheritance Cycle is a series of   |                                                 |
| fantasy books written by Christopher Paolini. |                                                 |
| Output: The Inheritance Cycle is a tetralogy  |                                                 |
| of young adult high fantasy novels written by |                                                 |
| American author Christopher Paolini.          |                                                 |
|                                               |                                                 |
| Positive Example 2 -                          |                                                 |
| Input: The Greco-Roman or Graeco-Roman world, |                                                 |
| refers to geographical regions and countries  |                                                 |
| who had the language , culture , government   |                                                 |
| or religion of the ancient Greeks and Romans. |                                                 |
| Output: The Greco-Roman world , Greco-Roman   |                                                 |
| culture , or the term Greco-Roman (spelled    |                                                 |
| Graeco-Roman in the United Kingdom and the    |                                                 |
| Commonwealth), when used as an adjective , as |                                                 |
| understood by modern scholars and writers ,   |                                                 |
| refers to those geographical regions and      |                                                 |
| countries that culturally ( and so            |                                                 |
|  historically ) were directly , long-term ,   |                                                 |
| and intimately influenced by the language ,   |                                                 |
| culture , government and religion of the      |                                                 |
| ancient Greeks and Romans.                    |                                                 |
|                                               |                                                 |
| Negative Example 1 -                          |                                                 |
| Input: Boryla, an American football           |                                                 |
| quarterback, did not participate in the 1952  |                                                 |
| playoffs.                                     |                                                 |
| Output: Boryla was not in the 1952 playoffs.  |                                                 |
|                                               |                                                 |
| Negative Example 2 -                          |                                                 |
| Input: The wild population in China decreased |                                                 |
| to around 2,000 in 2005.                      |                                                 |
| Output: By 2005, the wild population          |                                                 |
| decreased to about 2,000.                     |                                                 |
|                                               |                                                 |
| Now complete the following example -          |                                                 |
| Input: Merton College is one of the colleges  |                                                 |
| of the University of Oxford .                 |                                                 |
| Output:                                       |                                                 |
+-----------------------------------------------+-------------------------------------------------+
Basismodell erstellen
Remote-Modell über einem Gemini-Modell erstellen:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor die folgende Anweisung aus, um ein Remote-Modell zu erstellen:
CREATE OR REPLACE MODEL `bqml_tutorial.gemini_baseline`
REMOTE WITH CONNECTION DEFAULT
OPTIONS (ENDPOINT = 'gemini-2.5-pro');
Die Abfrage dauert mehrere Sekunden. Anschließend wird das Modell
gemini_baselineimbqml_tutorial-Dataset des Bereichs Explorer angezeigt. Da die Abfrage eineCREATE MODEL-Anweisung zum Erstellen eines Modells verwendet, gibt es keine Abfrageergebnisse.
Leistung des Basismodells prüfen
Um zu sehen, wie das Remote-Modell mit den Bewertungsdaten ohne Feinabstimmung funktioniert, führen Sie die AI.GENERATE_TEXT-Funktion aus:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor folgende Abfrage aus:
SELECT result, ground_truth
FROM
  AI.GENERATE_TEXT(
    MODEL `bqml_tutorial.gemini_baseline`,
    (
      SELECT
        input AS prompt, output AS ground_truth
      FROM `bqml_tutorial.wiki_auto_style_transfer_valid`
      LIMIT 10
    ));
Das Ergebnis sieht etwa so aus:
+-------------------------------------------------+-------------------------------------------------+
| result                                          | ground_truth                                    |
+-------------------------------------------------+-------------------------------------------------+
| In mathematics, and more specifically in graph  | In mathematics , and more specifically in graph |
| theory, a graph is an abstract structure that   | theory , a graph is a structure amounting to a  |
| is used to model pairwise relationships between | set of objects in which some pairs of the       |
| objects. A graph in this context is made up of  | objects are in some sense " related " .         |
| vertices (also called nodes or points) and      |                                                 |
| edges (also called links or lines) that connect |                                                 |
| pairs of vertices.                              |                                                 |
| ...                                             | ...                                             |
+-------------------------------------------------+-------------------------------------------------+
Das Baseline-Modell generiert zwar Text, der die Fakten aus den Referenzinhalten genau widerspiegelt, der Stil des Texts ist jedoch manchmal anders. Das Basismodell neigt dazu, längere Ausführungen als die gewünschte Grundwahrheit zu generieren.
Basismodell bewerten
Wenn Sie die Modellleistung genauer bewerten möchten, verwenden Sie die Funktion ML.EVALUATE.
Diese Funktion berechnet Modellmesswerte, mit denen die Genauigkeit und Qualität des generierten Texts gemessen werden, um die Antworten des Modells mit idealen Antworten zu vergleichen.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor folgende Abfrage aus:
SELECT *
FROM
  ML.EVALUATE(
    MODEL `bqml_tutorial.gemini_baseline`,
    (
      SELECT
        input AS input_text, output AS output_text
      FROM `bqml_tutorial.wiki_auto_style_transfer_valid`
    ),
    STRUCT('text_generation' AS task_type));
Das Ergebnis sieht etwa so aus:
+---------------------+---------------------+-------------------------------------------+--------------------------------------------+
| bleu4_score         | rouge-l_precision   | rouge-l_recall      | rouge-l_f1_score    | evaluation_status                          |
+---------------------+---------------------+---------------------+---------------------+--------------------------------------------+
| 0.32571814014498979 | 0.45752569962901607 | 0.557224161991254   | 0.49205029983307907 | {                                          |
|                     |                     |                     |                     |  "num_successful_rows": 176,               |
|                     |                     |                     |                     |  "num_total_rows": 176                     |
|                     |                     |                     |                     | }                                          |
+---------------------+---------------------+ --------------------+---------------------+--------------------------------------------+
Mithilfe dieser Werte lässt sich die Leistung quantitativ messen. In den nächsten Abschnitten erfahren Sie, wie Sie ein abgestimmtes Modell erstellen und seine Leistung mit dem Baseline-Modell vergleichen.
Abgestimmtes Modell erstellen
Erstellen Sie ein Remote-Modell, das dem ähnelt, das Sie unter Modell erstellen erstellt haben, aber geben Sie dieses Mal die AS SELECT-Klausel an, um die Trainingsdaten bereitzustellen, damit das Modell optimiert wird.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Query Editor die folgende Anweisung aus, um eine Remote-Modell zu erstellen:
CREATE OR REPLACE MODEL `bqml_tutorial.gemini_tuned`
  REMOTE
    WITH CONNECTION DEFAULT
  OPTIONS (
    endpoint = 'gemini-2.5-pro',
    max_iterations = 500,
    data_split_method = 'no_split')
AS
SELECT
  input AS prompt, output AS label
FROM `bqml_tutorial.wiki_auto_style_transfer_train`;
Die Abfrage dauert einige Minuten. Anschließend wird das Modell
gemini_tunedimbqml_tutorial-Dataset des Bereichs Explorer angezeigt. Da die Abfrage eineCREATE MODEL-Anweisung zum Erstellen eines Modells verwendet, gibt es keine Abfrageergebnisse.
Leistung des abgestimmten Modells prüfen
Führen Sie die Funktion AI.GENERATE_TEXT aus, um die Leistung des abgestimmten Modells für die Bewertungsdaten zu sehen:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor folgende Abfrage aus:
SELECT result, ground_truth
FROM
  AI.GENERATE_TEXT(
    MODEL `bqml_tutorial.gemini_tuned`,
    (
      SELECT
        input AS prompt, output AS ground_truth
      FROM `bqml_tutorial.wiki_auto_style_transfer_valid`
      LIMIT 10
    ));
Das abgestimmte Modell erzeugt Text, der im Stil dem Ground Truth-Inhalt viel ähnlicher ist.
Abgestimmtes Modell bewerten
Mit der Funktion ML.EVALUATE können Sie die Antworten des abgestimmten Modells mit den idealen Antworten vergleichen:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Führen Sie im Abfrageeditor folgende Abfrage aus:
SELECT *
FROM
  ML.EVALUATE(
    MODEL `bqml_tutorial.gemini_tuned`,
    (
      SELECT
        input AS prompt, output AS label
      FROM `bqml_tutorial.wiki_auto_style_transfer_valid`
    ),
    STRUCT('text_generation' AS task_type));
Das Ergebnis sieht etwa so aus:
+---------------------+---------------------+-------------------------------------------+--------------------------------------------+
| bleu4_score         | rouge-l_precision   | rouge-l_recall      | rouge-l_f1_score    | evaluation_status                          |
+---------------------+---------------------+---------------------+---------------------+--------------------------------------------+
| 0.44878025403825506 | 0.57236062510796448 | 0.638794269320597   | 0.59591519400141835 | {                                          |
|                     |                     |                     |                     |  "num_successful_rows": 176,               |
|                     |                     |                     |                     |  "num_total_rows": 176                     |
|                     |                     |                     |                     | }                                          |
+---------------------+---------------------+ --------------------+---------------------+--------------------------------------------+
Das optimierte Modell zeigt eine deutliche Leistungssteigerung und übertrifft das Baseline-Modell bei allen Bewertungs-Messwerten.
Bereinigen
Damit Ihrem Google Cloud-Konto die in dieser Anleitung verwendeten Ressourcen nicht in Rechnung gestellt werden, löschen Sie entweder das Projekt, das die Ressourcen enthält, oder Sie behalten das Projekt und löschen die einzelnen Ressourcen.
Projekt löschen
Google Cloud -Projekt löschen:
gcloud projects delete PROJECT_ID
Einzelne Ressourcen löschen
Wenn Sie das Projekt wiederverwenden möchten, löschen Sie die für diese Anleitung erstellten Ressourcen.
Rufen Sie die Seite BigQuery auf.
Löschen Sie das Dataset
bqml_tutorial. Wenn Sie das Dataset löschen, werden auch die Modelle und Tabellen gelöscht.Maximieren Sie im Bereich Explorer Ihr Projekt und klicken Sie auf Datasets.
Klicken Sie in der Liste Datasets auf das Dataset
bqml_tutorial.Klicken Sie im Detailbereich auf Löschen.
Klicken Sie im Dialogfeld Dataset löschen auf Löschen.