


Panoramica dello spazio di archiviazione di BigQuery
L'archiviazione di BigQuery è ottimizzata per eseguire query analitiche su set di dati di grandi dimensioni. Supporta inoltre l'importazione di flussi di dati con throughput elevato e le letture con throughput elevato. Comprendere lo spazio di archiviazione di BigQuery può aiutarti a ottimizzare i workload.
Panoramica
Una delle caratteristiche principali dell'architettura di BigQuery è la separazione tra archiviazione e computing. Ciò consente a BigQuery di scalare sia l'archiviazione che il computing in modo indipendente, in base alla domanda.
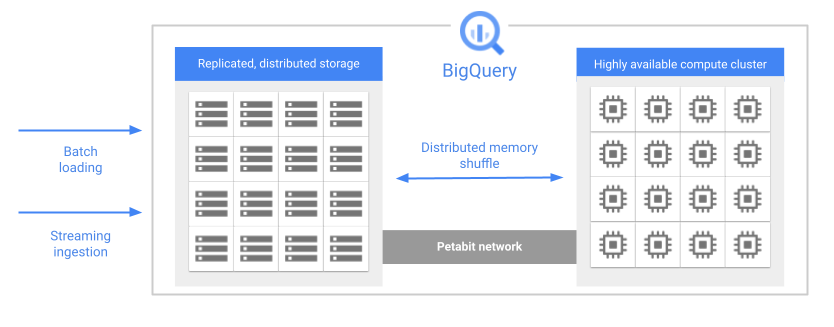
Quando esegui una query, il motore di query distribuisce il lavoro in parallelo tra più worker, che scansionano le tabelle pertinenti nello spazio di archiviazione, elaborano la query e quindi raccolgono i risultati. BigQuery esegue le query completamente in memoria, utilizzando una rete a livello di petabit per garantire che i dati vengano spostati molto rapidamente ai nodi worker.
Ecco alcune delle funzionalità principali dello spazio di archiviazione di BigQuery:
Gestito. Lo spazio di archiviazione di BigQuery è un servizio completamente gestito. Non è necessario eseguire il provisioning delle risorse di archiviazione o prenotare unità di archiviazione. BigQuery alloca automaticamente lo spazio di archiviazione quando carichi i dati nel sistema. Paghi solo per la quantità di spazio di archiviazione che utilizzi. Il modello di prezzi di BigQuery addebita separatamente i costi di computing e archiviazione. Per i dettagli sui prezzi, consulta Prezzi di BigQuery.
Durevole. Lo spazio di archiviazione di BigQuery è progettato per garantire una durabilità annuale del 99,999999999% (11 nove). BigQuery replica i dati in più zone di disponibilità per proteggerli dalla perdita di dati dovuta a errori a livello di macchina o di zona. Per saperne di più, consulta Affidabilità: pianificazione del disaster recovery.
Crittografati. BigQuery cripta automaticamente tutti i dati prima che siano scritti su disco. Puoi fornire la tua chiave di crittografia o lasciare che sia Google a gestirla. Per saperne di più, consulta Crittografia at-rest.
Efficiente. L'archiviazione di BigQuery utilizza un formato di codifica efficiente ottimizzato per i workload di analisi. Per scoprire di più sul formato di archiviazione di BigQuery, consulta il blog post Inside Capacitor, BigQuery's next-generation columnar storage format.
Dati tabella
La maggior parte dei dati archiviati in BigQuery è costituita da dati delle tabelle. I dati delle tabelle includono tabelle standard, cloni di tabelle, snapshot di tabelle e viste materializzate. Ti viene addebitato lo spazio di archiviazione che utilizzi per queste risorse. Per saperne di più, consulta Prezzi di Storage.
Le tabelle standard contengono dati strutturati. Ogni tabella ha uno schema e ogni colonna dello schema ha un tipo di dati. BigQuery archivia i dati in formato colonnare. Consulta Layout di archiviazione in questo documento.
I cloni di tabella sono copie scrivibili e leggere di tabelle standard. BigQuery archivia solo il delta tra un clone di tabella e la relativa tabella di base.
Gli snapshot delle tabelle sono copie point-in-time delle tabelle. Gli snapshot delle tabelle sono di sola lettura, ma puoi ripristinare una tabella da uno snapshot. BigQuery archivia solo il delta tra uno snapshot della tabella e la relativa tabella di base.
Le viste materializzate sono viste precalcolate che memorizzano periodicamente nella cache i risultati della query della vista. I risultati memorizzati nella cache vengono archiviati nello spazio di archiviazione di BigQuery.
Inoltre, i risultati delle query memorizzati nella cache vengono archiviati come tabelle temporanee. Non ti vengono addebitati costi per i risultati delle query memorizzati nella cache e archiviati in tabelle temporanee.
Le tabelle esterne sono un tipo speciale di tabella in cui i dati risiedono in un datastore esterno a BigQuery, ad esempio Cloud Storage. Una tabella esterna ha uno schema di tabella, proprio come una tabella standard, ma la definizione della tabella rimanda al datastore esterno. In questo caso, solo i metadati della tabella vengono conservati nello spazio di archiviazione di BigQuery. BigQuery non addebita costi per l'archiviazione di tabelle esterne, anche se il datastore esterno potrebbe addebitare costi per l'archiviazione.
BigQuery organizza le tabelle e altre risorse in container logici chiamati set di dati. Il modo in cui raggruppi le risorse BigQuery influisce su autorizzazioni, quote, fatturazione e altri aspetti dei workload BigQuery. Per ulteriori informazioni e best practice, consulta Introduzione alla gerarchia delle risorse.
La policy sulla conservazione dei dati utilizzata per una tabella è determinata dalla configurazione del set di dati che contiene la tabella. Per saperne di più, consulta Conservazione dei dati con l'itinerario cronologico e il fail-safe.
Metadati
Lo spazio di archiviazione di BigQuery contiene anche i metadati relativi alle tue risorse BigQuery. Non ti viene addebitato alcun costo per l'archiviazione dei metadati.
Quando crei un'entità permanente in BigQuery, ad esempio una tabella, una vista o una funzione definita dall'utente (UDF), BigQuery archivia i metadati relativi all'entità. Questo vale anche per le risorse che non contengono dati di tabella, come le funzioni definite dall'utente e le viste logiche.
I metadati includono informazioni come lo schema della tabella, le specifiche di partizionamento e clustering, le date di scadenza della tabella e altre informazioni. Questo tipo di metadati è visibile all'utente e può essere configurato durante la creazione della risorsa. Inoltre, BigQuery archivia i metadati che utilizza internamente per ottimizzare le query. Questi metadati non sono direttamente visibili agli utenti.
Layout dello spazio di archiviazione
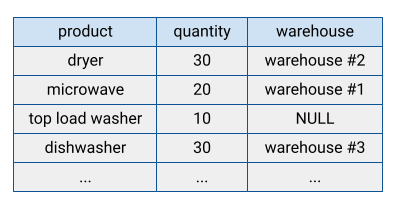
Molti sistemi di database tradizionali archiviano i dati in un formato orientato alle righe, il che significa che le righe vengono archiviate insieme, con i campi di ogni riga che appaiono in sequenza sul disco. I database orientati alle righe sono efficienti nella ricerca di singoli record. Tuttavia, possono essere meno efficienti nell'esecuzione di funzioni analitiche su molti record, perché il sistema deve leggere ogni campo quando accede a un record.
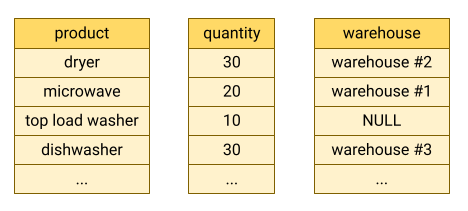
BigQuery archivia i dati delle tabelle in formato colonnare, ovvero archivia ogni colonna separatamente. I database orientati alle colonne sono particolarmente efficienti nell'analisi di singole colonne su un intero set di dati.
I database orientati alle colonne sono ottimizzati per i workload di analisi che aggregano dati su un numero molto elevato di record. Spesso, una query di analisi deve leggere solo alcune colonne di una tabella. Ad esempio, se vuoi calcolare la somma di una colonna su milioni di righe, BigQuery può leggere i dati di quella colonna senza leggere ogni campo di ogni riga.
Un altro vantaggio dei database orientati alle colonne è che i dati all'interno di una colonna in genere presentano una ridondanza maggiore rispetto ai dati di una riga. Questa caratteristica consente una maggiore compressione dei dati utilizzando tecniche come la codifica run-length, che può migliorare le prestazioni di lettura.
Modelli di fatturazione dello spazio di archiviazione
BigQuery offre due modelli di fatturazione dello spazio di archiviazione: logico (non compresso) e fisico (compresso).
La modifica del modello di fatturazione dello spazio di archiviazione cambia solo la configurazione della misurazione. Non comporta la migrazione dei dati, la conversione del formato file o modifiche all'infrastruttura. I tuoi dati vengono sempre archiviati nello stesso formato fisico compresso. La modifica di questa impostazione non influisce sulle prestazioni delle query, sulla latenza o sull'integrazione con altre applicazioni, come Looker.
Il modello selezionato determina solo il modo in cui i byte archiviati vengono misurati e prezzati in base ai prezzi di archiviazione:
- Fatturazione logica: la fatturazione si basa sulle dimensioni dei dati non compressi. Questo è il modello predefinito.
- Fatturazione fisica: la fatturazione si basa sulle dimensioni compresse dei dati su disco.
Indipendentemente dal modello di fatturazione scelto, i dati vengono archiviati come byte fisici.
Il modello di fatturazione dello spazio di archiviazione viene impostato a livello di set di dati. Se non specifichi un modello di fatturazione dello spazio di archiviazione quando crei un set di dati, per impostazione predefinita viene utilizzata la fatturazione dello spazio di archiviazione logico. Tuttavia, puoi modificare il modello di fatturazione dello spazio di archiviazione di un set di dati dopo averlo creato. Se modifichi il modello di fatturazione dello spazio di archiviazione di un set di dati, devi attendere 14 giorni prima di poterlo modificare di nuovo.
Quando modifichi il modello di fatturazione di un set di dati, l'applicazione della modifica richiede 24 ore. Le tabelle o le partizioni delle tabelle nello spazio di archiviazione a lungo termine non vengono reimpostate sullo spazio di archiviazione attivo quando modifichi il modello di fatturazione di un set di dati. Le prestazioni e la latenza delle query non sono influenzate dalla modifica del modello di fatturazione di un set di dati.
I set di dati utilizzano lo spazio di archiviazione di viaggio nel tempo e failsafe per la conservazione dei dati. L'archiviazione di tipo fail-safe e con l'uso di un intervallo temporale viene addebitata separatamente alle tariffe di archiviazione attiva quando utilizzi la fatturazione dello spazio di archiviazione fisico, ma è inclusa nella tariffa base che ti viene addebitata quando utilizzi la fatturazione dello spazio di archiviazione logico. Puoi modificare la finestra temporale di viaggio nel tempo che utilizzi per un set di dati per bilanciare i costi di archiviazione fisica con la conservazione dei dati. Non puoi modificare la finestra di sicurezza. Per saperne di più sulla conservazione dei dati dei set di dati, consulta Conservazione dei dati con l'itinerario cronologico e il fail-safe. Per ulteriori informazioni sulla previsione dei costi di archiviazione, consulta Previsione della fatturazione dello spazio di archiviazione.
Non puoi registrare un set di dati nella fatturazione dello spazio di archiviazione fisico se la tua organizzazione ha impegni slot con tariffa fissa legacy esistenti situati nella stessa regione del set di dati. Questo non si applica agli impegni acquistati con una versione di BigQuery.Ottimizza lo spazio di archiviazione
L'ottimizzazione dello spazio di archiviazione di BigQuery migliora le prestazioni delle query e controlla i costi. Per visualizzare i metadati di archiviazione della tabella, esegui una query sulle seguenti viste INFORMATION_SCHEMA:
Per informazioni sull'ottimizzazione dello spazio di archiviazione, consulta Ottimizza lo spazio di archiviazione in BigQuery.
Carica dati
Esistono diversi pattern di base per l'importazione dei dati in BigQuery.
Caricamento in batch: carica i dati di origine in una tabella BigQuery in un'unica operazione batch. Può essere un'operazione una tantum o puoi automatizzarla in modo che venga eseguita in base a una pianificazione. Un'operazione di caricamento in batch può creare una nuova tabella o aggiungere dati a una tabella esistente.
Flusso di dati: trasmetti in flusso continuo batch di dati più piccoli in modo che i dati siano disponibili per l'esecuzione di query quasi in tempo reale.
Dati generati: utilizza le istruzioni SQL per inserire righe in una tabella esistente o scrivere i risultati di una query in una tabella.
Per saperne di più su quando scegliere ciascuno di questi metodi di importazione, consulta Introduzione al caricamento dei dati. Per informazioni sui prezzi, consulta Prezzi per l'acquisizione dei dati.
Leggi i dati dallo spazio di archiviazione di BigQuery
La maggior parte delle volte, i dati vengono archiviati in BigQuery per eseguire query analitiche su questi dati. Tuttavia, a volte potresti voler leggere i record direttamente da una tabella. BigQuery offre diversi modi per leggere i dati delle tabelle:
API BigQuery: accesso impaginato sincrono con il metodo
tabledata.list. I dati vengono letti in modo seriale, una pagina per chiamata. Per saperne di più, consulta Sfoglia i dati della tabella.API BigQuery Storage: accesso in streaming con throughput elevato che supporta anche la proiezione e il filtro delle colonne lato server. Le letture possono essere parallelizzate tra molti lettori segmentandole in più stream disgiunti.
Esportazione: copia asincrona con throughput elevato in Google Cloud Storage, con job di estrazione o l'istruzione
EXPORT DATA. Se devi copiare i dati in Cloud Storage, esportali con un job di estrazione o un'istruzioneEXPORT DATA.Copia: copia asincrona dei set di dati all'interno di BigQuery. La copia viene eseguita logicamente quando la località di origine e quella di destinazione sono le stesse.
Per informazioni sui prezzi, consulta Prezzi dell'estrazione dati.
In base ai requisiti dell'applicazione, puoi leggere i dati della tabella:
- Lettura e copia: se hai bisogno di una copia at-rest in Cloud Storage, esporta i dati con un job di estrazione o un'istruzione
EXPORT DATA. Se vuoi solo leggere i dati, utilizza l'API BigQuery Storage. Se vuoi creare una copia all'interno di BigQuery, utilizza un job di copia. - Scalabilità: l'API BigQuery è il metodo meno efficiente e non deve essere utilizzato per letture di volumi elevati. Se devi esportare più di 50 TB di dati al giorno, utilizza l'istruzione
EXPORT DATAo l'API BigQuery Storage. - Tempo per restituire la prima riga: l'API BigQuery è il metodo più rapido per restituire la prima riga, ma deve essere utilizzata solo per leggere piccole quantità di dati. L'API BigQuery Storage è più lenta nel restituire la prima riga, ma ha un throughput molto più elevato. Le esportazioni e le copie devono essere completate prima che sia possibile leggere le righe, pertanto il tempo necessario per la prima riga per questi tipi di job può essere nell'ordine di minuti.
Eliminazione
Quando elimini una tabella, i dati vengono conservati almeno per la durata della
finestra di spostamento cronologico.
Successivamente, i dati vengono eliminati dal disco entro la cronologia di eliminazione diGoogle Cloud .
Alcune operazioni di eliminazione, come l'istruzione DROP COLUMN, sono operazioni solo sui metadati. In questo caso, lo spazio di archiviazione viene liberato la volta successiva che modifichi le righe interessate. Se non modifichi la tabella, non è garantito un tempo entro il quale lo spazio di archiviazione viene liberato.
Per saperne di più, consulta
Eliminazione dei dati su Google Cloud.
Passaggi successivi
- Scopri di più sull'utilizzo delle tabelle.
- Scopri come ottimizzare lo spazio di archiviazione.
- Scopri come eseguire query sui dati in BigQuery.
- Scopri di più sulla sicurezza e la governance dei dati.