


使用 Apache Spark 預存程序
您可以在 BigQuery 中使用 Spark 預存程序,直接在資料倉儲中執行以 Python、Java 和 Scala 編寫的複雜資料處理工作負載。使用標準 GoogleSQL 查詢執行這些程序,即可將進階資料科學和工程工作整合至現有的 SQL 管道,原理類似執行 SQL 儲存程序。
事前準備
如要建立 Spark 預存程序,請要求管理員建立 Spark 連線並與您共用。管理員也必須為與連線相關聯的服務帳戶授予必要的 Identity and Access Management (IAM) 權限。
必要的角色
如要取得執行本文件所述工作所需的權限,請要求管理員授予您下列 IAM 角色:
-
建立 Spark 預存程序:
- 在您建立預存程序的資料集,具備 BigQuery 資料編輯者 (
roles/bigquery.dataEditor) 角色 - 預存程序所用連線的 BigQuery 連線管理員 (
roles/bigquery.connectionAdmin) 角色 - 專案的 BigQuery 工作使用者 (
roles/bigquery.jobUser)
- 在您建立預存程序的資料集,具備 BigQuery 資料編輯者 (
-
呼叫 Spark 預存程序:
- 儲存預存程序的資料集具備 BigQuery 中繼資料檢視者 (
roles/bigquery.metadataViewer) 角色 - 連線的 BigQuery 連線使用者 (
roles/bigquery.connectionUser) - 專案的 BigQuery 工作使用者 (
roles/bigquery.jobUser)
- 儲存預存程序的資料集具備 BigQuery 中繼資料檢視者 (
如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這些預先定義的角色具備執行本文件所述工作所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能執行本文件中的工作:
-
建立連線:
-
bigquery.connections.create -
bigquery.connections.list
-
-
建立 Spark 預存程序:
-
bigquery.routines.create -
bigquery.connections.delegate -
bigquery.jobs.create
-
-
呼叫 Spark 預存程序:
-
bigquery.routines.get -
bigquery.connections.use -
bigquery.jobs.create
-
位置考量
您必須在連線所在位置建立 Spark 預存程序,因為預存程序會在連線所在位置執行。舉例來說,如要在美國多區域建立預存程序,請使用位於美國多區域的連線。
定價
在 BigQuery 執行 Spark 程序的費用,與在 Managed Service for Apache Spark 執行 Spark 程序的費用類似。詳情請參閱「Managed Service for Apache Spark 定價」。
Spark 預存程序可與隨選計價模式搭配使用,也適用於任何 BigQuery 版本。無論專案採用何種運算定價模式,Spark 程序一律依 BigQuery Enterprise 版即付即用模式計費。
BigQuery 的 Spark 預存程序不支援使用預留項目或承諾使用合約。現有的預留項目和承諾使用合約會繼續用於其他支援的查詢和程序。使用 Spark 預存程序產生的費用,會以 Enterprise 版即付即用費率計入帳單。系統會套用貴組織的折扣 (如適用)。
雖然 Spark 預存程序使用 Spark 執行引擎,但您不會看到 Spark 執行的個別費用。如前所述,相關費用會列為 BigQuery Enterprise 版本即付即用 SKU。
使用 Spark 預存程序從 BigQuery 資料表讀取資料,不會產生 Storage Read API 費用。串流讀取作業包含在預存程序執行作業中,不另收費。如果跨區域讀取資料,則須支付標準網路輸出費用。
Spark 預存程序不提供免費方案。
建立 Spark 預存程序
建立預存程序時,必須與所用連線位於相同位置。
如果預存程序的主體超過 1 MB,建議您將預存程序放在 Cloud Storage bucket 的檔案中,而非使用內嵌程式碼。BigQuery 提供兩種方法,可使用 Python 建立 Spark 預存程序:
- 如要使用
CREATE PROCEDURE陳述式,請使用 SQL 查詢編輯器。 - 如要直接輸入 Python 程式碼,請使用 PySpark 編輯器。您可以將程式碼儲存為預存程序。
使用 SQL 查詢編輯器
如要在 SQL 查詢編輯器中建立 Spark 預存程序,請按照下列步驟操作:
前往「BigQuery」頁面
在查詢編輯器中,新增
CREATE PROCEDURE陳述式的程式碼範例。或者,在「Explorer」窗格中,點選用於建立連線資源的專案中的連線。接著,如要建立 Spark 預存程序,請按一下「 建立預存程序」。
Python
如要使用 Python 建立 Spark 預存程序,請使用下列程式碼範例:
CREATE OR REPLACE PROCEDURE `PROJECT_ID`.DATASET.PROCEDURE_NAME(PROCEDURE_ARGUMENT)
 WITH CONNECTION `CONNECTION_PROJECT_ID.CONNECTION_REGION.CONNECTION_ID`
 OPTIONS (
     engine="SPARK", runtime_version="RUNTIME_VERSION",
     main_file_uri=["MAIN_PYTHON_FILE_URI"]);
 LANGUAGE PYTHON [AS PYSPARK_CODE]
Java 或 Scala
如要使用
main_file_uri選項,在 Java 或 Scala 中建立 Spark 預存程序,請使用下列程式碼範例:CREATE [OR REPLACE] PROCEDURE `PROJECT_ID`.DATASET.PROCEDURE_NAME(PROCEDURE_ARGUMENT) WITH CONNECTION `CONNECTION_PROJECT_ID.CONNECTION_REGION.CONNECTION_ID` OPTIONS ( engine="SPARK", runtime_version="RUNTIME_VERSION", main_file_uri=["MAIN_JAR_URI"]); LANGUAGE JAVA|SCALA
如要使用
main_class和jar_uris選項,在 Java 或 Scala 中為 Spark 建立預存程序,請使用下列程式碼範例:CREATE [OR REPLACE] PROCEDURE `PROJECT_ID`.DATASET.PROCEDURE_NAME(PROCEDURE_ARGUMENT) WITH CONNECTION `CONNECTION_PROJECT_ID.CONNECTION_REGION.CONNECTION_ID` OPTIONS ( engine="SPARK", runtime_version="RUNTIME_VERSION", main_class=["CLASS_NAME"], jar_uris=["URI"]); LANGUAGE JAVA|SCALA
替換下列內容:
PROJECT_ID:要建立預存程序的專案,例如myproject。DATASET:要建立預存程序的資料集,例如mydataset。PROCEDURE_NAME:要在 BigQuery 中執行的預存程序名稱,例如mysparkprocedure。PROCEDURE_ARGUMENT:用於輸入引數的參數。在這個參數中,指定下列欄位:
ARGUMENT_MODE:引數的模式。有效值包括
IN、OUT和INOUT。預設值為IN。ARGUMENT_NAME:引數名稱。ARGUMENT_TYPE:引數類型。
例如:
myproject.mydataset.mysparkproc(num INT64)。詳情請參閱本文中的「傳遞值做為
IN參數」或「OUT和INOUT參數」。CONNECTION_PROJECT_ID:包含執行 Spark 程序所需連線的專案。CONNECTION_REGION:連線所在的區域,用於執行 Spark 程序,例如us。CONNECTION_ID:連線 ID,例如myconnection。在 Google Cloud 控制台查看連線詳細資料時,連線 ID 是「Connection ID」(連線 ID) 中顯示的完整連線 ID 最後一個部分的值,例如
projects/myproject/locations/connection_location/connections/myconnection。RUNTIME_VERSION:Spark 的執行階段版本,例如2.2。MAIN_PYTHON_FILE_URI:PySpark 檔案的路徑,例如gs://mybucket/mypysparkmain.py。或者,如要在
CREATE PROCEDURE陳述式中新增預存程序的內文,請在LANGUAGE PYTHON AS後方新增PYSPARK_CODE,如本文件「使用內嵌程式碼」一節的範例所示。PYSPARK_CODE:如要內嵌傳遞程序主體,請在CREATE PROCEDURE陳述式中定義 PySpark 應用程式。值為字串常值。如果程式碼包含引號和反斜線,則必須逸出或以原始字串表示。舉例來說,程式碼傳回
"\n";可以表示為下列其中一項:- 引號字串:
"return \"\\n\";"。引號和反斜線都會逸出。 - 三引號字串:
"""return "\\n";"""。反斜線會逸出,但引號不會。 - 原始字串:
r"""return "\n";"""。不需要逸出。
- 引號字串:
MAIN_JAR_URI:包含main類別的 JAR 檔案路徑,例如gs://mybucket/my_main.jar。CLASS_NAME:使用jar_uris選項設定的 JAR 中類別的完整名稱,例如com.example.wordcount。URI:JAR 檔案的路徑,其中包含main類別中指定的類別,例如gs://mybucket/mypysparkmain.jar。
如要瞭解可在
OPTIONS中指定的其他選項,請參閱程序選項清單。
使用 PySpark 編輯器
使用 PySpark 編輯器建立程序時,不需要使用 CREATE PROCEDURE 陳述式。請直接在 PySpark 編輯器中新增 Python 程式碼,然後儲存或執行程式碼。
如要在 PySpark 編輯器中建立 Spark 預存程序,請按照下列步驟操作:
前往「BigQuery」頁面
如要直接輸入 PySpark 程式碼,請開啟 PySpark 編輯器。如要開啟 PySpark 編輯器,請依序點選「Tools」(工具) >「Create PySpark stored procedure」(建立 PySpark 預存程序)。
如要設定選項,請依序按一下「More」(更多) >「PySpark Options」(PySpark 選項),然後執行 下列操作:
指定要執行 PySpark 程式碼的位置。
在「Connection」(連線) 欄位中,指定 Spark 連線。
在「Stored procedure invocation」(預存程序叫用) 部分,指定要儲存產生的暫時預存程序的資料集。您可以設定特定資料集,或允許使用臨時資料集叫用 PySpark 程式碼。
系統會根據上一步指定的位置,產生臨時資料集。如果指定資料集名稱,請確保資料集和 Spark 連線位於相同位置。
在「Parameters」(參數) 區段中,定義預存程序的參數。參數值僅在 PySpark 程式碼的工作階段執行期間使用,但宣告本身會儲存在程序中。
在「Advanced options」(進階選項) 部分,指定程序選項。如需程序選項的詳細清單,請參閱程序選項清單。
1. 在「Properties」(屬性) 區段中,新增鍵/值組合來設定工作。您可以使用 Managed Service for Apache Spark 支援的 Spark 屬性中的任何鍵/值組合。
在「Service account settings」(服務帳戶設定) 中,指定在 PySpark 程式碼工作階段執行期間,要使用的自訂服務帳戶、CMEK、暫存資料集和暫存 Cloud Storage 資料夾。
按一下 [儲存]。
儲存 Spark 預存程序
使用 PySpark 編輯器建立預存程序後,即可儲存預存程序。步驟如下:
前往 Google Cloud 控制台的「BigQuery」頁面。
在查詢編輯器中,使用 Python 搭配 PySpark 編輯器建立 Spark 預存程序。
依序點選「
 儲存」 > 「儲存程序」。
在「Save stored procedure」(儲存預存程序) 對話方塊中,指定要儲存預存程序的資料集名稱,以及預存程序的名稱。
按一下 [儲存]。
如果只想執行 PySpark 程式碼,而不儲存為預存程序,請點選「執行」,而非「儲存」。
使用自訂容器
自訂容器會為工作負載的驅動程式和執行器程序提供執行階段環境。如要使用自訂容器,請參考下列程式碼範例:
CREATE OR REPLACE PROCEDURE `PROJECT_ID`.DATASET.PROCEDURE_NAME(PROCEDURE_ARGUMENT)
  WITH CONNECTION `CONNECTION_PROJECT_ID.CONNECTION_REGION.CONNECTION_ID`
  OPTIONS (
      engine="SPARK", runtime_version="RUNTIME_VERSION",
      container_image="CONTAINER_IMAGE", main_file_uri=["MAIN_PYTHON_FILE_URI"]);
  LANGUAGE PYTHON [AS PYSPARK_CODE]
替換下列內容:
PROJECT_ID:要建立預存程序的專案,例如myproject。DATASET:要建立預存程序的資料集,例如mydataset。PROCEDURE_NAME:要在 BigQuery 執行的預存程序名稱,例如mysparkprocedure。PROCEDURE_ARGUMENT:輸入引數的參數。在這個參數中,指定下列欄位:
ARGUMENT_MODE:引數的模式。有效值包括
IN、OUT和INOUT。預設值為IN。ARGUMENT_NAME:引數名稱。ARGUMENT_TYPE:引數類型。
例如:
myproject.mydataset.mysparkproc(num INT64)。詳情請參閱本文中的「傳遞值做為
IN參數」或「OUT和INOUT參數」。CONNECTION_PROJECT_ID:包含連線的專案,用於執行 Spark 程序。CONNECTION_REGION:執行 Spark 程序所需連線所在的區域,例如us。CONNECTION_ID:連線 ID,例如myconnection。在 Google Cloud 控制台查看連線詳細資料時,連線 ID 是「Connection ID」(連線 ID) 中顯示的完整連線 ID 最後一個部分的值,例如
projects/myproject/locations/connection_location/connections/myconnection。RUNTIME_VERSION:Spark 的執行階段版本,例如2.2。MAIN_PYTHON_FILE_URI:PySpark 檔案的路徑,例如gs://mybucket/mypysparkmain.py。或者,如要在
CREATE PROCEDURE陳述式中新增預存程序的內文,請在LANGUAGE PYTHON AS後方加入PYSPARK_CODE,如本文件「使用內嵌程式碼」一節的範例所示。PYSPARK_CODE:如要內嵌傳遞程序主體,請在CREATE PROCEDURE陳述式中定義 PySpark 應用程式。值為字串常值。如果程式碼包含引號和反斜線,則必須逸出或以原始字串表示。舉例來說,程式碼傳回
"\n";可表示為下列其中一項:- 引號字串:
"return \"\\n\";"。引號和反斜線都會逸出。 - 三引號字串:
"""return "\\n";"""。反斜線會逸出,引號則不會。 - 原始字串:
r"""return "\n";"""。不需要逸出。
- 引號字串:
CONTAINER_IMAGE:Artifact Registry 中的映像檔路徑。其中只能包含程序中要使用的程式庫。如未指定,系統會使用與執行階段版本相關聯的系統預設容器映像檔。
如要進一步瞭解如何使用 Spark 建構自訂容器映像檔,請參閱「建構自訂容器映像檔」。
呼叫 Spark 預存程序
建立預存程序後,您可以使用下列任一選項呼叫預存程序:
控制台
前往「BigQuery」頁面。
在左側窗格中,點選「類別」底下的「傳統版 Explorer」:
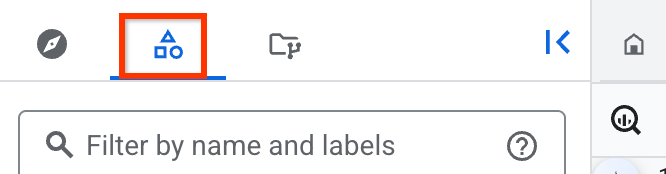
如果沒有看到左側窗格,請按一下 「Expand left pane」(展開左側窗格),開啟窗格。
在「傳統版 Explorer」窗格中展開專案,然後選取要執行的 Spark 預存程序。
在「Stored procedure info」(預存程序資訊) 視窗中,按一下「Invoke stored procedure」(叫用預存程序)。或者,您也可以展開「View actions」(查看動作) 選項,然後按一下「Invoke」(叫用)。
按一下「執行」。
在「所有結果」部分,按一下「查看結果」。
選用步驟:在「Query results」(查詢結果) 專區,執行下列操作:
如要查看 Spark 驅動程式記錄,請按一下「Execution details」(執行作業詳細資料)。
如要在 Cloud Logging 中查看記錄,請按一下「Job information」(工作資訊),然後在「Log」(記錄) 欄位中按一下「log」(記錄)。
如要取得 Spark 記錄伺服器端點,請依序點選「Job information」(工作資訊) 和「Spark history server」(Spark 記錄伺服器)。
SQL
如要呼叫預存程序,請使用 CALL PROCEDURE 陳述式:
前往 Google Cloud 控制台的「BigQuery」頁面。
在查詢編輯器中輸入下列陳述式:
CALL `PROJECT_ID`.DATASET.PROCEDURE_NAME()
按一下「 執行」。
如要進一步瞭解如何執行查詢,請參閱「執行互動式查詢」。
使用自訂服務帳戶
您可以使用自訂服務帳戶存取 Spark 程式碼中的資料,而非使用 Spark 連線的服務身分存取資料。
如要使用自訂服務帳戶,請在建立 Spark 預存程序時指定 INVOKER 安全性模式 (使用 EXTERNAL SECURITY INVOKER 陳述式),並在叫用預存程序時指定服務帳戶。
首次使用自訂服務帳戶執行 Spark 預存程序時,BigQuery 會建立 Spark 服務代理,並授予必要的權限。叫用 Spark 預存程序前,請勿修改這項授權。詳情請參閱「BigQuery Spark 服務代理」。
如要存取及使用 Cloud Storage 中的 Spark 程式碼,請務必將必要權限授予 Spark 連線的服務身分。您必須將 storage.objects.get IAM 權限或 storage.objectViewer IAM 角色授予連線的服務帳戶。
您也可以選擇將連線的服務帳戶存取權授予 Dataproc Metastore 和 Managed Service for Apache Spark Persistent History Server (如果您已在連線中指定這些服務)。詳情請參閱「授予服務帳戶存取權」。
CREATE OR REPLACE PROCEDURE `PROJECT_ID`.DATASET.PROCEDURE_NAME(PROCEDURE_ARGUMENT)
  EXTERNAL SECURITY INVOKER
  WITH CONNECTION `CONNECTION_PROJECT_ID.CONNECTION_REGION.CONNECTION_ID`
  OPTIONS (
      engine="SPARK", runtime_version="RUNTIME_VERSION",
      main_file_uri=["MAIN_PYTHON_FILE_URI"]);
  LANGUAGE PYTHON [AS PYSPARK_CODE]

SET @@spark_proc_properties.service_account='CUSTOM_SERVICE_ACCOUNT';
CALL PROJECT_ID.DATASET_ID.PROCEDURE_NAME();
您也可以視需要將下列引數新增至上述程式碼:
SET @@spark_proc_properties.staging_bucket='BUCKET_NAME';
SET @@spark_proc_properties.staging_dataset_id='DATASET';
更改下列內容:
CUSTOM_SERVICE_ACCOUNT:必填,您提供的自訂服務帳戶。BUCKET_NAME:選用。做為預設 Spark 應用程式檔案系統的 Cloud Storage bucket。如未提供,系統會在專案中建立預設 Cloud Storage bucket,並由在相同專案下執行的所有工作共用。DATASET:選用。這個資料集用於儲存叫用程序時產生的暫存資料。工作完成後,資料就會清除。如未提供,系統會為工作建立預設的暫時資料集。
自訂服務帳戶必須具備下列權限:
如要讀取及寫入做為預設 Spark 應用程式檔案系統的暫存 bucket,請執行下列操作:
- 您指定的暫存值區具備
storage.objects.*權限或roles/storage.objectAdminIAM 角色。 - 此外,如果未指定暫存 bucket,則需要專案的
storage.buckets.*權限或roles/storage.AdminIAM 角色。
- 您指定的暫存值區具備
(選用) 如要從 BigQuery 讀取資料,以及將資料寫入 BigQuery:
- 對 BigQuery 資料表執行
bigquery.tables.*。 - 專案的
bigquery.readsessions.*。 roles/bigquery.adminIAM 角色包含上述權限。
- 對 BigQuery 資料表執行
(選用) 如要讀取及寫入 Cloud Storage 的資料,請按照下列步驟操作:
- Cloud Storage 物件的
storage.objects.*權限或roles/storage.objectAdminIAM 角色。
- Cloud Storage 物件的
(選用) 如要讀取及寫入用於
INOUT/OUT參數的暫存資料集,請按照下列步驟操作:- 您指定的暫存資料集具備
bigquery.tables.*或roles/bigquery.dataEditorIAM 角色。 - 此外,如果未指定暫存資料集,則需要專案的
bigquery.datasets.create權限或roles/bigquery.dataEditorIAM 角色。
- 您指定的暫存資料集具備
Spark 預存程序範例
本節提供範例,說明如何建立 Apache Spark 預存程序。
使用 Cloud Storage 中的 PySpark 或 JAR 檔案
下列範例說明如何使用 my-project-id.us.my-connection 連線和儲存在 Cloud Storage bucket 中的 PySpark 或 JAR 檔案,建立 Spark 預存程序:
Python
CREATE PROCEDURE my_bq_project.my_dataset.spark_proc()
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2", main_file_uri="gs://my-bucket/my-pyspark-main.py")
LANGUAGE PYTHON
Java 或 Scala
使用 main_file_uri 建立預存程序:
CREATE PROCEDURE my_bq_project.my_dataset.scala_proc_wtih_main_jar()
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2", main_file_uri="gs://my-bucket/my-scala-main.jar")
LANGUAGE SCALA
使用 main_class 建立預存程序:
CREATE PROCEDURE my_bq_project.my_dataset.scala_proc_with_main_class()
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2",
main_class="com.example.wordcount", jar_uris=["gs://my-bucket/wordcount.jar"])
LANGUAGE SCALA
使用內嵌程式碼
以下範例說明如何使用連線 my-project-id.us.my-connection 和內嵌 PySpark 程式碼,為 Spark 建立預存程序:
CREATE OR REPLACE PROCEDURE my_bq_project.my_dataset.spark_proc()
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2")
LANGUAGE PYTHON AS R"""
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("spark-bigquery-demo").getOrCreate()

# Load data from BigQuery.
words = spark.read.format("bigquery") \
  .option("table", "bigquery-public-data:samples.shakespeare") \
  .load()
words.createOrReplaceTempView("words")

# Perform word count.
word_count = words.select('word', 'word_count').groupBy('word').sum('word_count').withColumnRenamed("sum(word_count)", "sum_word_count")
word_count.show()
word_count.printSchema()

# Saving the data to BigQuery
word_count.write.format("bigquery") \
  .option("writeMethod", "direct") \
  .save("wordcount_dataset.wordcount_output")
"""
傳遞值做為輸入參數
以下範例說明在 Python 中,將值做為輸入參數傳遞的兩種方法:
方法 1:使用環境變數
在 PySpark 程式碼中,您可以透過 Spark 驅動程式和執行器中的環境變數,取得 Spark 預存程序的輸入參數。環境變數名稱的格式為 BIGQUERY_PROC_PARAM.PARAMETER_NAME,其中 PARAMETER_NAME 是輸入參數的名稱。舉例來說,如果輸入參數的名稱是 var,對應的環境變數名稱就是 BIGQUERY_PROC_PARAM.var。輸入參數會以 JSON 編碼。在 PySpark 程式碼中,您可以從環境變數取得 JSON 字串中的輸入參數值,並將其解碼為 Python 變數。
以下範例說明如何將 INT64 類型的輸入參數值,傳入 PySpark 程式碼:
CREATE OR REPLACE PROCEDURE my_bq_project.my_dataset.spark_proc(num INT64)
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2")
LANGUAGE PYTHON AS R"""
from pyspark.sql import SparkSession
import os
import json

spark = SparkSession.builder.appName("spark-bigquery-demo").getOrCreate()
sc = spark.sparkContext

# Get the input parameter num in JSON string and convert to a Python variable
num = int(json.loads(os.environ["BIGQUERY_PROC_PARAM.num"]))

"""
方法 2:使用內建程式庫
在 PySpark 程式碼中,您只要匯入內建程式庫,就能用來填入所有類型的參數。如要將參數傳遞至執行器,請在 Spark 驅動程式中將參數填入為 Python 變數,並將值傳遞至執行器。內建程式庫支援大部分 BigQuery 資料類型,但不支援 INTERVAL、GEOGRAPHY、NUMERIC 和 BIGNUMERIC。
| BigQuery 資料類型 | Python 資料類型 |
|---|---|
BOOL
|
bool
|
STRING
|
str
|
FLOAT64
|
float
|
INT64
|
int
|
BYTES
|
bytes
|
DATE
|
datetime.date
|
TIMESTAMP
|
datetime.datetime
|
TIME
|
datetime.time
|
DATETIME
|
datetime.datetime
|
Array
|
Array
|
Struct
|
Struct
|
JSON
|
Object
|
NUMERIC
|
不支援 |
BIGNUMERIC
|
不支援 |
INTERVAL
|
不支援 |
GEOGRAPHY
|
不支援 |
以下範例說明如何匯入內建程式庫,並使用該程式庫將 INT64 類型的輸入參數和 ARRAY<STRUCT<a INT64, b STRING>> 類型的輸入參數填入 PySpark 程式碼:
CREATE OR REPLACE PROCEDURE my_bq_project.my_dataset.spark_proc(num INT64, info ARRAY<STRUCT<a INT64, b STRING>>)
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2")
LANGUAGE PYTHON AS R"""
from pyspark.sql import SparkSession
from bigquery.spark.procedure import SparkProcParamContext

def check_in_param(x, num):
  return x['a'] + num

def main():
  spark = SparkSession.builder.appName("spark-bigquery-demo").getOrCreate()
  sc=spark.sparkContext
  spark_proc_param_context = SparkProcParamContext.getOrCreate(spark)

  # Get the input parameter num of type INT64
  num = spark_proc_param_context.num

  # Get the input parameter info of type ARRAY<STRUCT<a INT64, b STRING>>
  info = spark_proc_param_context.info

  # Pass the parameter to executors
  df = sc.parallelize(info)
  value = df.map(lambda x : check_in_param(x, num)).sum()

main()
"""
在 Java 或 Scala 程式碼中,您可以透過 Spark 驅動程式和執行器中的環境變數,取得 Spark 預存程序的輸入參數。環境變數名稱的格式為 BIGQUERY_PROC_PARAM.PARAMETER_NAME,其中 PARAMETER_NAME 是輸入參數的名稱。舉例來說,如果輸入參數的名稱是 var,則對應的環境變數名稱為 BIGQUERY_PROC_PARAM.var。在 Java 或 Scala 程式碼中,您可以從環境變數取得輸入參數值。
以下範例說明如何將環境變數中的輸入參數值,傳入 Scala 程式碼:
val input_param = sys.env.get("BIGQUERY_PROC_PARAM.input_param").get
以下範例說明如何將環境變數中的輸入參數,傳入 Java 程式碼:
String input_param = System.getenv("BIGQUERY_PROC_PARAM.input_param");
將值做為 OUT 和 INOUT 參數傳遞
輸出參數會傳回 Spark 程序的值,而 INOUT 參數則會接受程序的值,並傳回程序的值。如要使用 OUT 和 INOUT 參數,請在建立 Spark 程序時,於參數名稱前加上 OUT 或 INOUT 關鍵字。在 PySpark 程式碼中,您可以使用內建程式庫,將值做為 OUT 或 INOUT 參數傳回。與輸入參數相同,內建程式庫支援大多數 BigQuery 資料類型,但 INTERVAL、GEOGRAPHY、NUMERIC 和 BIGNUMERIC 除外。TIME 和 DATETIME 類型值在以 OUT 或 INOUT 參數傳回時,會轉換為世界標準時間時區。
CREATE OR REPLACE PROCEDURE my_bq_project.my_dataset.pyspark_proc(IN int INT64, INOUT datetime DATETIME,OUT b BOOL, OUT info ARRAY<STRUCT<a INT64, b STRING>>, OUT time TIME, OUT f FLOAT64, OUT bs BYTES, OUT date DATE, OUT ts TIMESTAMP, OUT js JSON)
WITH CONNECTION `my_bq_project.my_dataset.my_connection`
OPTIONS(engine="SPARK", runtime_version="2.2") LANGUAGE PYTHON AS
R"""
from pyspark.sql.session import SparkSession
import datetime
from bigquery.spark.procedure import SparkProcParamContext

spark = SparkSession.builder.appName("bigquery-pyspark-demo").getOrCreate()
spark_proc_param_context = SparkProcParamContext.getOrCreate(spark)

# Reading the IN and INOUT parameter values.
int = spark_proc_param_context.int
dt = spark_proc_param_context.datetime
print("IN parameter value: ", int, ", INOUT parameter value: ", dt)

# Returning the value of the OUT and INOUT parameters.
spark_proc_param_context.datetime = datetime.datetime(1970, 1, 1, 0, 20, 0, 2, tzinfo=datetime.timezone.utc)
spark_proc_param_context.b = True
spark_proc_param_context.info = [{"a":2, "b":"dd"}, {"a":2, "b":"dd"}]
spark_proc_param_context.time = datetime.time(23, 20, 50, 520000)
spark_proc_param_context.f = 20.23
spark_proc_param_context.bs = b"hello"
spark_proc_param_context.date = datetime.date(1985, 4, 12)
spark_proc_param_context.ts = datetime.datetime(1970, 1, 1, 0, 20, 0, 2, tzinfo=datetime.timezone.utc)
spark_proc_param_context.js = {"name": "Alice", "age": 30}
""";
從 Hive Metastore 資料表讀取資料,並將結果寫入 BigQuery
以下範例說明如何轉換 Hive Metastore 資料表,並將結果寫入 BigQuery:
CREATE OR REPLACE PROCEDURE my_bq_project.my_dataset.spark_proc()
WITH CONNECTION `my-project-id.us.my-connection`
OPTIONS(engine="SPARK", runtime_version="2.2")
LANGUAGE PYTHON AS R"""
from pyspark.sql import SparkSession

spark = SparkSession \
   .builder \
   .appName("Python Spark SQL Managed Service for Apache Spark Hive Metastore integration test example") \
   .enableHiveSupport() \
   .getOrCreate()

spark.sql("CREATE DATABASE IF NOT EXISTS records")

spark.sql("CREATE TABLE IF NOT EXISTS records.student (eid int, name String, score int)")

spark.sql("INSERT INTO records.student VALUES (1000000, 'AlicesChen', 10000)")

df = spark.sql("SELECT * FROM records.student")

df.write.format("bigquery") \
  .option("writeMethod", "direct") \
  .save("records_dataset.student")
"""
查看記錄檔篩選器
呼叫 Spark 預存程序後,即可查看記錄資訊。如要取得 Cloud Logging 篩選器資訊和 Spark 記錄叢集端點,請使用 bq
show 指令。篩選器資訊位於子工作的 SparkStatistics 欄位下方。如要取得記錄檔篩選器,請按照下列步驟操作:
前往「BigQuery」頁面
在查詢編輯器中,列出預存程序指令碼工作的子項工作:
bq ls -j --parent_job_id=$parent_job_id
如要瞭解如何取得工作 ID,請參閱「查看工作詳細資料」。
輸出結果會與下列內容相似:
                jobId                         Job Type     State       Start Time         Duration
---------------------------------------------- ---------   ---------  ---------------  ----------------
script_job_90fb26c32329679c139befcc638a7e71_0   query      SUCCESS   07 Sep 18:00:27   0:05:15.052000
找出預存程序的
jobId,並使用bq show指令查看工作詳細資料:bq show --format=prettyjson --job $child_job_id
複製
sparkStatistics欄位,因為後續步驟會用到。輸出內容大致如下:
{
"configuration": {...}
…
"statistics": {
 …
  "query": {
    "sparkStatistics": {
      "loggingInfo": {
        "projectId": "myproject",
        "resourceType": "myresource"
      },
      "sparkJobId": "script-job-90f0",
      "sparkJobLocation": "us-central1"
    },
    …
  }
}
}
如果是 Logging,請使用
SparkStatistics欄位產生記錄檔篩選器:resource.type = sparkStatistics.loggingInfo.resourceType resource.labels.resource_container=sparkStatistics.loggingInfo.projectId resource.labels.spark_job_id=sparkStatistics.sparkJobId resource.labels.location=sparkStatistics.sparkJobLocation
記錄會寫入
bigquery.googleapis.com/SparkJob受監控資源。記錄會由INFO、DRIVER和EXECUTOR元件加上標籤。如要篩選 Spark 驅動程式的記錄,請將labels.component = "DRIVER"元件新增至記錄篩選器。如要篩選 Spark 執行器的記錄,請在記錄篩選器中新增labels.component = "EXECUTOR"元件。
使用客戶自行管理的加密金鑰
BigQuery Spark 程序會使用客戶自行管理的加密金鑰 (CMEK) 保護內容,並採用 BigQuery 提供的預設加密機制。如要在 Spark 程序中使用 CMEK,請先觸發建立 BigQuery 加密服務帳戶,並授予必要權限。如果專案套用了 CMEK 組織政策,Spark 程序也支援這些政策。
如果預存程序使用 INVOKER 安全性模式,則呼叫程序時,應透過 SQL 系統變數指定 CMEK。否則,您可以透過與預存程序相關聯的連線指定 CMEK。
如要在建立 Spark 預存程序時,透過連線指定 CMEK,請使用下列程式碼範例:
bq mk --connection --connection_type='SPARK' \
 --properties='{"kms_key_name"="projects/PROJECT_ID/locations/LOCATION/keyRings/KEY_RING_NAME/cryptoKeys/KMS_KEY_NAME"}' \
 --project_id=PROJECT_ID \
 --location=LOCATION \
 CONNECTION_NAME
如要在呼叫程序時,透過 SQL 系統變數指定 CMEK,請使用下列程式碼範例:
SET @@spark_proc_properties.service_account='CUSTOM_SERVICE_ACCOUNT';
SET @@spark_proc_properties.kms_key_name='projects/PROJECT_ID/locations/LOCATION/keyRings/KEY_RING_NAME/cryptoKeys/KMS_KEY_NAME;
CALL PROJECT_ID.DATASET_ID.PROCEDURE_NAME();
使用 VPC Service Controls
VPC Service Controls 可讓您設定安全 perimeter,防範資料竊取。如要搭配使用 VPC Service Controls 和 Spark 程序,進一步提升安全性,請先建立 service perimeter。
如要全面保護 Spark 程序工作,請將下列 API 新增至 service perimeter:
- BigQuery API (
bigquery.googleapis.com) - Cloud Logging API (
logging.googleapis.com) - Cloud Storage API (
storage.googleapis.com),如果您使用 Cloud Storage - Artifact Registry API (
artifactregistry.googleapis.com) 或 Container Registry API (containerregistry.googleapis.com) (如果使用自訂容器) - Dataproc Metastore API (
metastore.googleapis.com) 和 Cloud Run Admin API (run.googleapis.com) (如果您使用 Dataproc Metastore)
將 Spark 程序的查詢專案新增至 perimeter。將託管 Spark 程式碼或資料的其他專案新增至範圍。
最佳做法
首次在專案中使用連線時,系統需要額外花費約一分鐘的時間進行佈建。為節省時間,建立 Spark 預存程序時,可以重複使用現有的 Spark 連線。
建立用於正式環境的 Spark 程序時,Google 建議指定執行階段版本。如需支援的執行階段版本清單,請參閱「Managed Service for Apache Spark 執行階段版本」。建議使用長期支援 (LTS) 版本。
在 Spark 程序中指定自訂容器時,建議使用 Artifact Registry 和映像檔串流。
如要提升效能,您可以在 Spark 程序中指定資源分配屬性。Spark 預存程序支援的資源分配屬性清單,與 Managed Service for Apache Spark 相同。
限制
- 您只能使用 gRPC 端點通訊協定連線至 Dataproc Metastore。不支援其他類型的 Hive Metastore。
- 客戶自行管理的加密金鑰 (CMEK) 僅適用於客戶建立單一區域 Spark 程序時。不支援全域區域 CMEK 金鑰和多區域 CMEK 金鑰,例如
EU或US。 - 只有 PySpark 支援傳遞輸出參數。
- 如果與 Spark 預存程序相關聯的資料集,透過跨區域資料集複製功能複製到目的地區域,則只能在建立預存程序的區域查詢該預存程序。
- Spark 不支援存取私人 VPC Service Controls 網路中的 HTTP 端點。
配額與限制
如要瞭解配額和限制,請參閱「Spark 預存程序的配額和限制」。
後續步驟
- 瞭解如何查看預存程序。
- 瞭解如何刪除預存程序。
- 瞭解如何使用 SQL 預存程序。