


Utilizzo del rilevamento automatico dello schema
Rilevamento automatico dello schema
Il rilevamento automatico dello schema consente a BigQuery di dedurre lo schema per i dati CSV, JSON o Fogli Google. Il rilevamento automatico dello schema è disponibile quando carichi i dati in BigQuery e quando esegui query su un'origine dati esterna.
Quando il rilevamento automatico è abilitato, BigQuery deduce il tipo di dati per ogni colonna. BigQuery seleziona un file casuale nell'origine dati ed esegue la scansione delle prime 500 righe di dati da utilizzare come campione rappresentativo.
BigQuery esamina quindi ogni campo e tenta di assegnare un tipo di dati a quel campo in base ai valori nell'esempio. Se tutte le righe di una colonna sono vuote, il rilevamento automatico utilizzerà per impostazione predefinita il tipo di dati STRING per la colonna.
Se non attivi il rilevamento automatico dello schema per i dati CSV, JSON o Fogli Google, devi fornire lo schema manualmente durante la creazione della tabella.
Non è necessario attivare il rilevamento automatico dello schema per i file di esportazione Avro, Parquet, ORC, Firestore o Datastore. Questi formati file sono autodescrittivi, quindi BigQuery deduce automaticamente lo schema della tabella dai dati di origine. Per i file Parquet, Avro e ORC, puoi facoltativamente fornire uno schema esplicito per eseguire l'override dello schema dedotto.
Puoi visualizzare lo schema rilevato per una tabella nei seguenti modi:
- Utilizza la console Google Cloud .
- Utilizza il comando
bq showdello strumento a riga di comando bq.
Quando BigQuery rileva gli schemi, in rari casi potrebbe modificare il nome di un campo per renderlo compatibile con la sintassi GoogleSQL.
Per informazioni sulle conversioni dei tipi di dati, consulta quanto segue:
- Conversione dei tipi di dati durante il caricamento dei dati da Datastore
- Conversione dei tipi di dati durante il caricamento dei dati da Firestore
- Conversioni Avro
- Conversioni Parquet
- Conversioni ORC
Caricamento dei dati utilizzando il rilevamento automatico dello schema
Per attivare il rilevamento automatico dello schema durante il caricamento dei dati, utilizza uno dei seguenti approcci:
- Nella console Google Cloud , nella sezione Schema, per Rilevamento automatico, seleziona l'opzione Schema e parametri di input.
- Nello strumento a riga di comando bq, utilizza il comando
bq loadcon il parametro--autodetect.
Quando il rilevamento automatico dello schema è abilitato, BigQuery fa del suo meglio per dedurre automaticamente lo schema per i file CSV e JSON.
La logica di rilevamento automatico deduce i tipi di campi dello schema leggendo fino alle prime 500 righe di dati. Le righe iniziali vengono ignorate se è presente il flag --skip_leading_rows. I tipi di campo si basano sulle righe con il maggior numero di campi.
Pertanto, il rilevamento automatico dovrebbe funzionare come previsto, a condizione che esista almeno una riga di dati con valori in ogni colonna/campo.
Il rilevamento automatico dello schema non viene utilizzato con i file Avro, Parquet, ORC, di esportazione di Firestore o di esportazione di Datastore. Quando carichi questi file in BigQuery, lo schema della tabella viene recuperato automaticamente dai dati di origine autodescrittivi.
Per utilizzare il rilevamento automatico dello schema quando carichi dati JSON o CSV:
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
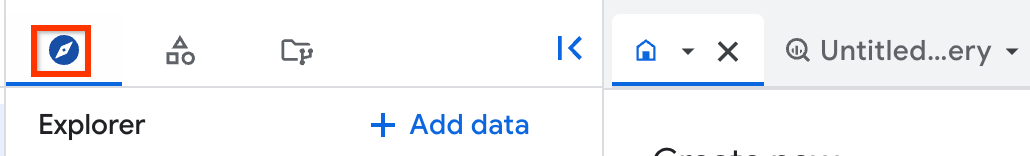
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi sul set di dati.
Nel riquadro dei dettagli, fai clic su Crea tabella.
Nella pagina Crea tabella, nella sezione Origine:
- In Crea tabella da, seleziona il tipo di origine.
Nel campo di origine, cerca il bucket Cloud Storage File/Cloud Storage o inserisci l'URI Cloud Storage. Tieni presente che non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che stai creando.
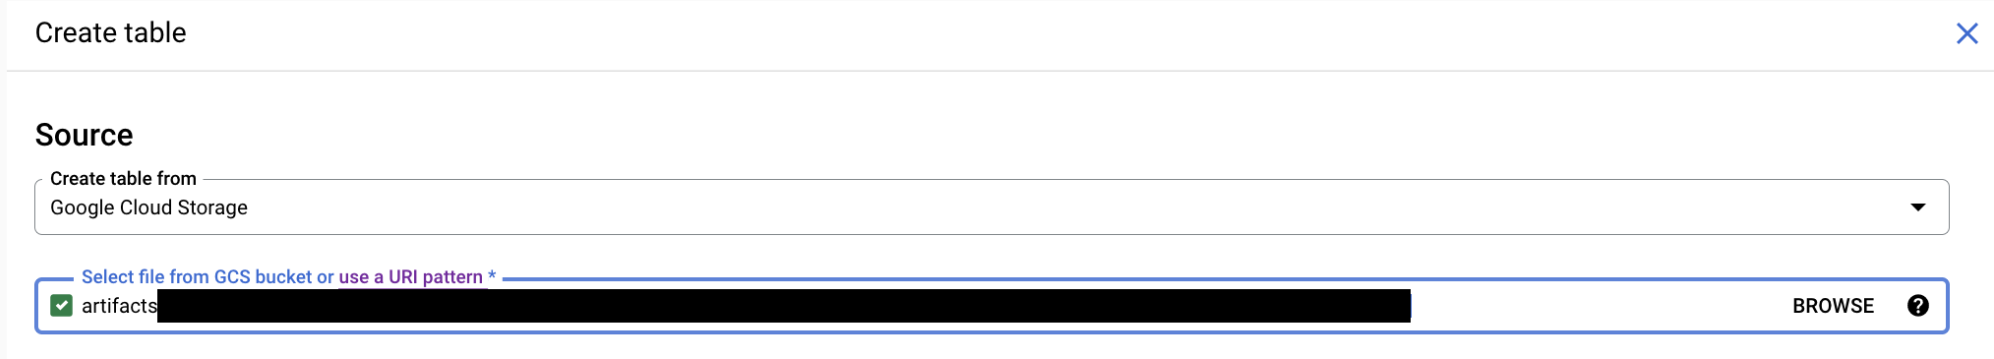
In Formato file, seleziona CSV o JSON.
Nella pagina Crea tabella, nella sezione Destinazione:
In Nome set di dati, scegli il set di dati appropriato.
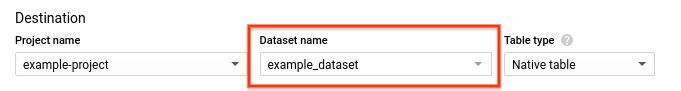
Nel campo Nome tabella, inserisci il nome della tabella che stai creando.
Verifica che Tipo di tabella sia impostato su Tabella nativa.
Fai clic su Crea tabella.
bq
Esegui il comando bq load con il parametro --autodetect.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Il seguente comando carica un file utilizzando il rilevamento automatico dello schema:
bq --location=LOCATION load \
--autodetect \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
Sostituisci quanto segue:
LOCATION: il nome della località. Il flag--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, imposta il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.FORMAT:NEWLINE_DELIMITED_JSONoCSV.DATASET: il set di dati contenente la tabella in cui stai caricando i dati.TABLE: il nome della tabella in cui stai caricando i dati.PATH_TO_SOURCE: la posizione del file CSV o JSON.
Esempi:
Inserisci il seguente comando per caricare myfile.csv dalla tua macchina locale in una tabella denominata mytable archiviata in un set di dati denominato mydataset.
bq load --autodetect --source_format=CSV mydataset.mytable ./myfile.csv
Inserisci il seguente comando per caricare myfile.json dalla tua macchina locale in una tabella denominata mytable archiviata in un set di dati denominato mydataset.
bq load --autodetect --source_format=NEWLINE_DELIMITED_JSON \
mydataset.mytable ./myfile.json
API
Crea un job
loadche rimandi ai dati di origine. Per informazioni sulla creazione di job, consulta Esecuzione di job BigQuery in modo programmatico. Specifica la tua località nella proprietàlocationnella sezionejobReference.Specifica il formato dei dati impostando la proprietà
sourceFormat. Per utilizzare il rilevamento automatico dello schema, questo valore deve essere impostato suNEWLINE_DELIMITED_JSONoCSV.Utilizza la proprietà
autodetectper impostare il rilevamento automatico dello schema sutrue.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
PHP
Prima di provare questo esempio, segui le istruzioni di configurazione di PHP nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery PHP.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Python
Per attivare il rilevamento automatico dello schema, imposta la proprietà LoadJobConfig.autodetect su True.
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Ruby
Prima di provare questo esempio, segui le istruzioni di configurazione di Ruby nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Ruby.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Rilevamento automatico dello schema per le origini dati esterne
Il rilevamento automatico dello schema può essere utilizzato con origini dati esterne CSV, JSON e Fogli Google. Quando il rilevamento automatico dello schema è abilitato, BigQuery tenta di dedurre automaticamente lo schema dai dati di origine. Se non attivi il rilevamento automatico dello schema per queste origini, devi fornire uno schema esplicito.
Non è necessario attivare il rilevamento automatico dello schema quando esegui query su file Avro, Parquet, ORC, di esportazione di Firestore o di esportazione di Datastore esterni. Questi formati file sono autodescrittivi, quindi BigQuery deduce automaticamente lo schema della tabella dai dati di origine. Per i file Parquet, Avro e ORC, puoi facoltativamente fornire uno schema esplicito per eseguire l'override dello schema dedotto.
Utilizzando la console Google Cloud , puoi attivare il rilevamento automatico dello schema selezionando l'opzione Schema e parametri di input per Rilevamento automatico.
Utilizzando lo strumento a riga di comando bq, puoi attivare il rilevamento automatico dello schema quando crei un file di definizione della tabella per i dati CSV, JSON o Fogli Google. Quando utilizzi lo strumento bq per creare un file di definizione della tabella, passa il flag --autodetect al comando mkdef per abilitare il rilevamento automatico dello schema o passa il flag --noautodetect per disabilitare il rilevamento automatico.
Quando utilizzi il flag --autodetect, l'impostazione autodetect viene impostata su true nel file di definizione della tabella. Quando utilizzi il flag --noautodetect, l'impostazione autodetect viene impostata su false. Se non fornisci una definizione dello schema per l'origine dati esterna quando crei una definizione di tabella e non utilizzi il flag --noautodetect o --autodetect, l'impostazione autodetect viene impostata su true per impostazione predefinita.
Quando crei un file di definizione della tabella utilizzando l'API, imposta il valore della proprietà autodetect su true o false. Se imposti autodetect su true,
attivi il rilevamento automatico. Se imposti autodetect su false, il rilevamento automatico viene disattivato.
Dettagli del rilevamento automatico
Oltre a rilevare i dettagli dello schema, il rilevamento automatico riconosce quanto segue:
Compressione
BigQuery riconosce la compressione dei file compatibile con gzip quando apre un file.
Valori di data e ora
BigQuery rileva i valori di data e ora in base alla formattazione dei dati di origine.
I valori nelle colonne DATE devono essere nel seguente formato: YYYY-MM-DD.
I valori nelle colonne TIME devono essere nel seguente formato: HH:MM:SS[.SSSSSS]
(la componente dei secondi frazionari è facoltativa).
Per le colonne TIMESTAMP, BigQuery rileva un'ampia gamma di formati di timestamp, inclusi, a titolo esemplificativo:
YYYY-MM-DD HH:MMYYYY-MM-DD HH:MM:SSYYYY-MM-DD HH:MM:SS.SSSSSSYYYY/MM/DD HH:MM
Un timestamp può anche contenere un offset UTC o l'indicatore di fuso orario UTC ("Z").
Ecco alcuni esempi di valori che BigQuery rileverà automaticamente come valori di timestamp:
- 2018-08-19 12:11
- 2018-08-19 12:11:35.22
- 19/08/2018 12:11
- 2018-08-19 07:11:35.220 -05:00
Se il rilevamento automatico non è abilitato e il valore è in un formato non presente negli esempi precedenti, BigQuery può caricare la colonna solo come tipo di dati STRING. Puoi attivare il rilevamento automatico per consentire a BigQuery di riconoscere queste colonne come timestamp. Ad esempio, BigQuery caricherà 2025-06-16T16:55:22Z come timestamp solo se attivi il rilevamento automatico.
In alternativa, puoi pre-elaborare i dati di origine prima di caricarli. Ad esempio, se esporti dati CSV da un foglio di lavoro, imposta il formato della data in modo che corrisponda a uno degli esempi mostrati qui. Puoi anche trasformare i dati dopo averli caricati in BigQuery.
Rilevamento automatico dello schema per i dati CSV
Delimitatore CSV
BigQuery rileva i seguenti delimitatori:
- virgola ( , )
- barra verticale ( | )
- tabulazione ( \t )
Intestazione CSV
BigQuery deduce le intestazioni confrontando la prima riga del file con le altre righe del file. Se la prima riga contiene solo stringhe e le altre righe contengono altri tipi di dati, BigQuery presuppone che la prima riga sia una riga di intestazione. BigQuery assegna i nomi delle colonne in base ai nomi dei campi nella riga di intestazione. I nomi potrebbero essere modificati per soddisfare le regole di denominazione per le colonne in BigQuery. Ad esempio, gli spazi vengono sostituiti con trattini bassi.
In caso contrario, BigQuery presuppone che la prima riga sia una riga di dati e assegna nomi di colonna generici come string_field_1. Tieni presente che, dopo la creazione di una tabella, i nomi delle colonne non possono essere aggiornati nello schema, anche se puoi modificarli manualmente dopo la creazione della tabella. Un'altra opzione è fornire uno schema esplicito anziché utilizzare il rilevamento automatico.
Potresti avere un file CSV con una riga di intestazione, in cui tutti i campi di dati sono stringhe. In questo caso, BigQuery non rileverà automaticamente che la prima riga è un'intestazione. Utilizza l'opzione --skip_leading_rows per saltare la riga di intestazione. In caso contrario, l'intestazione viene importata come dati. In questo caso, valuta anche la possibilità di fornire uno schema esplicito, in modo da poter assegnare i nomi delle colonne.
Nuove righe tra virgolette CSV
BigQuery rileva i caratteri di nuova riga tra virgolette all'interno di un campo CSV e non li interpreta come un limite di riga.
Risoluzione dei problemi
Quando rilevi automaticamente lo schema per i file CSV, potresti riscontrare il seguente errore:
Errore: Error while reading data, error message: CSV processing encountered
too many errors, giving up.
Questo errore può verificarsi quando il file CSV ha una riga di intestazione con valori di stringa e BigQuery non l'ha rilevata come intestazione. Puoi utilizzare l'opzione --skip_leading_rows per saltare la riga di intestazione.
Rilevamento automatico dello schema per i dati JSON
Campi JSON nidificati e ripetuti
BigQuery deduce i campi nidificati e ripetuti nei file JSON. Se il valore di un campo è un oggetto JSON, BigQuery carica la colonna come tipo RECORD. Se il valore di un campo è un array, BigQuery carica la colonna come colonna ripetuta. Per un esempio di dati JSON con dati nidificati e ripetuti, consulta Caricamento di dati JSON nidificati e ripetuti.
Conversione di stringhe
Se attivi il rilevamento automatico dello schema, BigQuery converte le stringhe in tipi booleani, numerici o di data/ora, se possibile. Ad esempio, utilizzando i seguenti dati JSON, il rilevamento automatico dello schema converte il campo id in una colonna INTEGER:
{ "name":"Alice","id":"12"}
{ "name":"Bob","id":"34"}
{ "name":"Charles","id":"45"}
Per saperne di più, consulta Caricamento di dati JSON da Cloud Storage.
Rilevamento automatico dello schema per Fogli Google
Per Fogli, BigQuery rileva automaticamente se la prima riga è una riga di intestazione, in modo simile al rilevamento automatico per i file CSV. Se la prima riga viene identificata come intestazione, BigQuery assegna i nomi delle colonne in base ai nomi dei campi nella riga di intestazione e salta la riga. I nomi potrebbero essere modificati per soddisfare le regole di denominazione per le colonne in BigQuery. Ad esempio, gli spazi verranno sostituiti con trattini bassi.
Sicurezza delle tabelle
Per controllare l'accesso alle tabelle in BigQuery, consulta Controlla l'accesso alle risorse con IAM.