


BigQuery include informazioni sul piano di query diagnostico e sui tempi di esecuzione, incorporate nei job di query. Questo è simile alle informazioni fornite da istruzioni come EXPLAIN in altri database e sistemi di analisi. Queste informazioni possono essere recuperate dalle risposte dell'API di metodi come jobs.get.
Per le query a lunga esecuzione, BigQuery aggiornerà periodicamente queste statistiche. Questi aggiornamenti avvengono indipendentemente dalla frequenza con cui viene eseguito il polling dello stato del job, ma in genere non avvengono più di una volta ogni 30 secondi. Inoltre, i job di query che non utilizzano risorse di esecuzione, come le richieste di dry run o i risultati che possono essere forniti dai risultati memorizzati nella cache, non includeranno le informazioni diagnostiche aggiuntive, anche se potrebbero essere presenti altre statistiche.
Sfondo
Quando BigQuery esegue una query, converte l'SQL in un grafico di esecuzione composto da fasi. Le fasi sono composte da passaggi, le operazioni elementari che eseguono la logica della query. BigQuery sfrutta un'architettura parallela altamente distribuita che esegue le fasi in parallelo per ridurre la latenza. Le fasi comunicano tra loro utilizzando lo shuffling, un'architettura di memoria distribuita veloce.
Il piano di query utilizza i termini unità di lavoro e worker per descrivere il parallelismo delle fasi. In altre parti di BigQuery, potresti incontrare il termine slot, che è una rappresentazione astratta di più aspetti dell'esecuzione delle query, tra cui risorse di computing, memoria e I/O. Gli slot eseguono in parallelo le singole unità di lavoro di una fase. Le statistiche dei job di primo livello forniscono il costo delle singole query utilizzando totalSlotMs in base a questa contabilità astratta.
Un'altra proprietà importante dell'esecuzione delle query è che BigQuery può modificare il piano di query mentre una query è in esecuzione. Ad esempio, BigQuery introduce fasi di ripartizione per migliorare la distribuzione dei dati tra i worker di query, il che migliora il parallelismo e riduce la latenza delle query.
Oltre al piano di query, i job di query espongono anche una cronologia di esecuzione, che fornisce un resoconto delle unità di lavoro completate, in attesa e attive. Una query può avere più fasi con worker attivi contemporaneamente e la cronologia ha lo scopo di mostrare l'avanzamento complessivo della query.
Visualizza il grafico di esecuzione con la console Google Cloud
Nella consoleGoogle Cloud , puoi visualizzare i dettagli del piano di query per una query completata facendo clic sul pulsante Dettagli esecuzione.
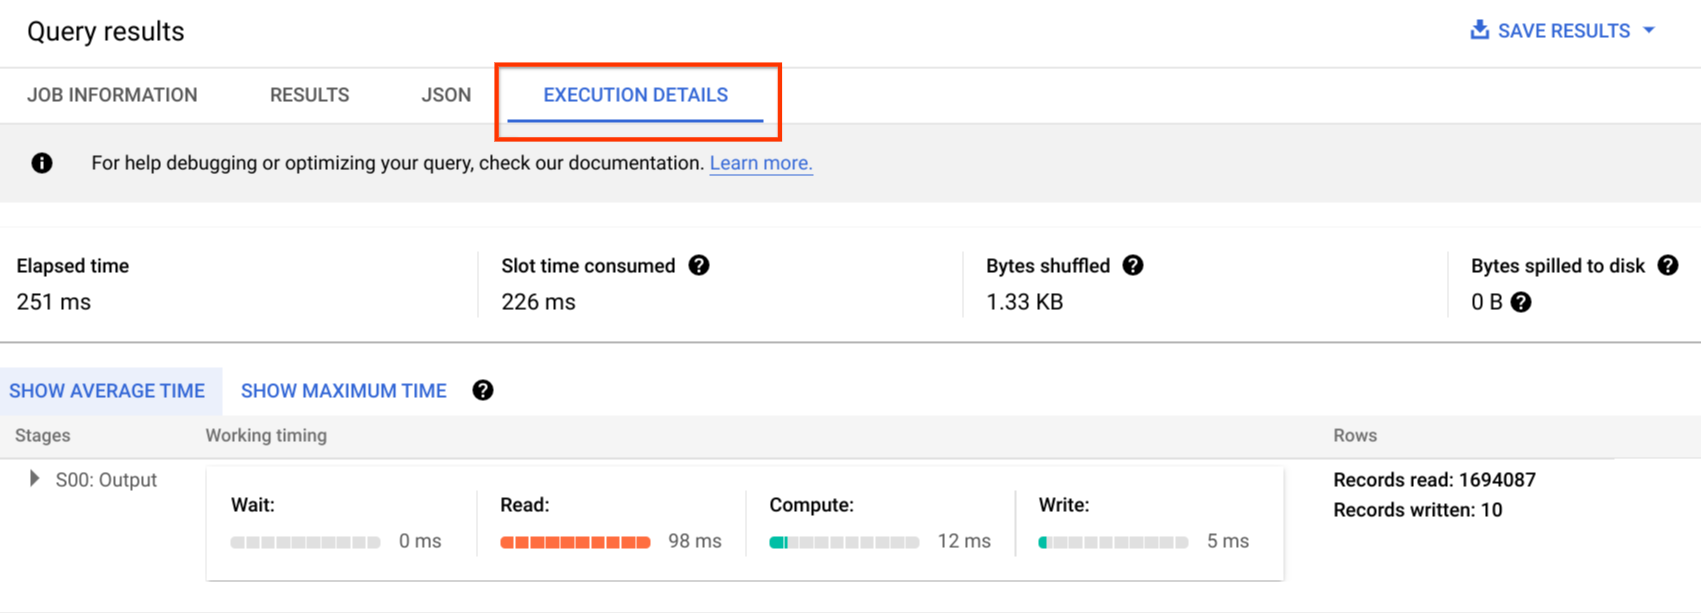
Informazioni sul piano di query
All'interno della risposta dell'API, i piani di query sono rappresentati come un elenco di fasi della query. Ogni elemento dell'elenco mostra le statistiche di panoramica per fase, le informazioni dettagliate sui passaggi e le classificazioni delle tempistiche delle fasi. Non tutti i dettagli vengono visualizzati nella console Google Cloud , ma possono essere tutti presenti nelle risposte dell'API.
Comprendi il grafico di esecuzione
Nella console Google Cloud , puoi visualizzare i dettagli del piano di query facendo clic sulla scheda Grafico di esecuzione.
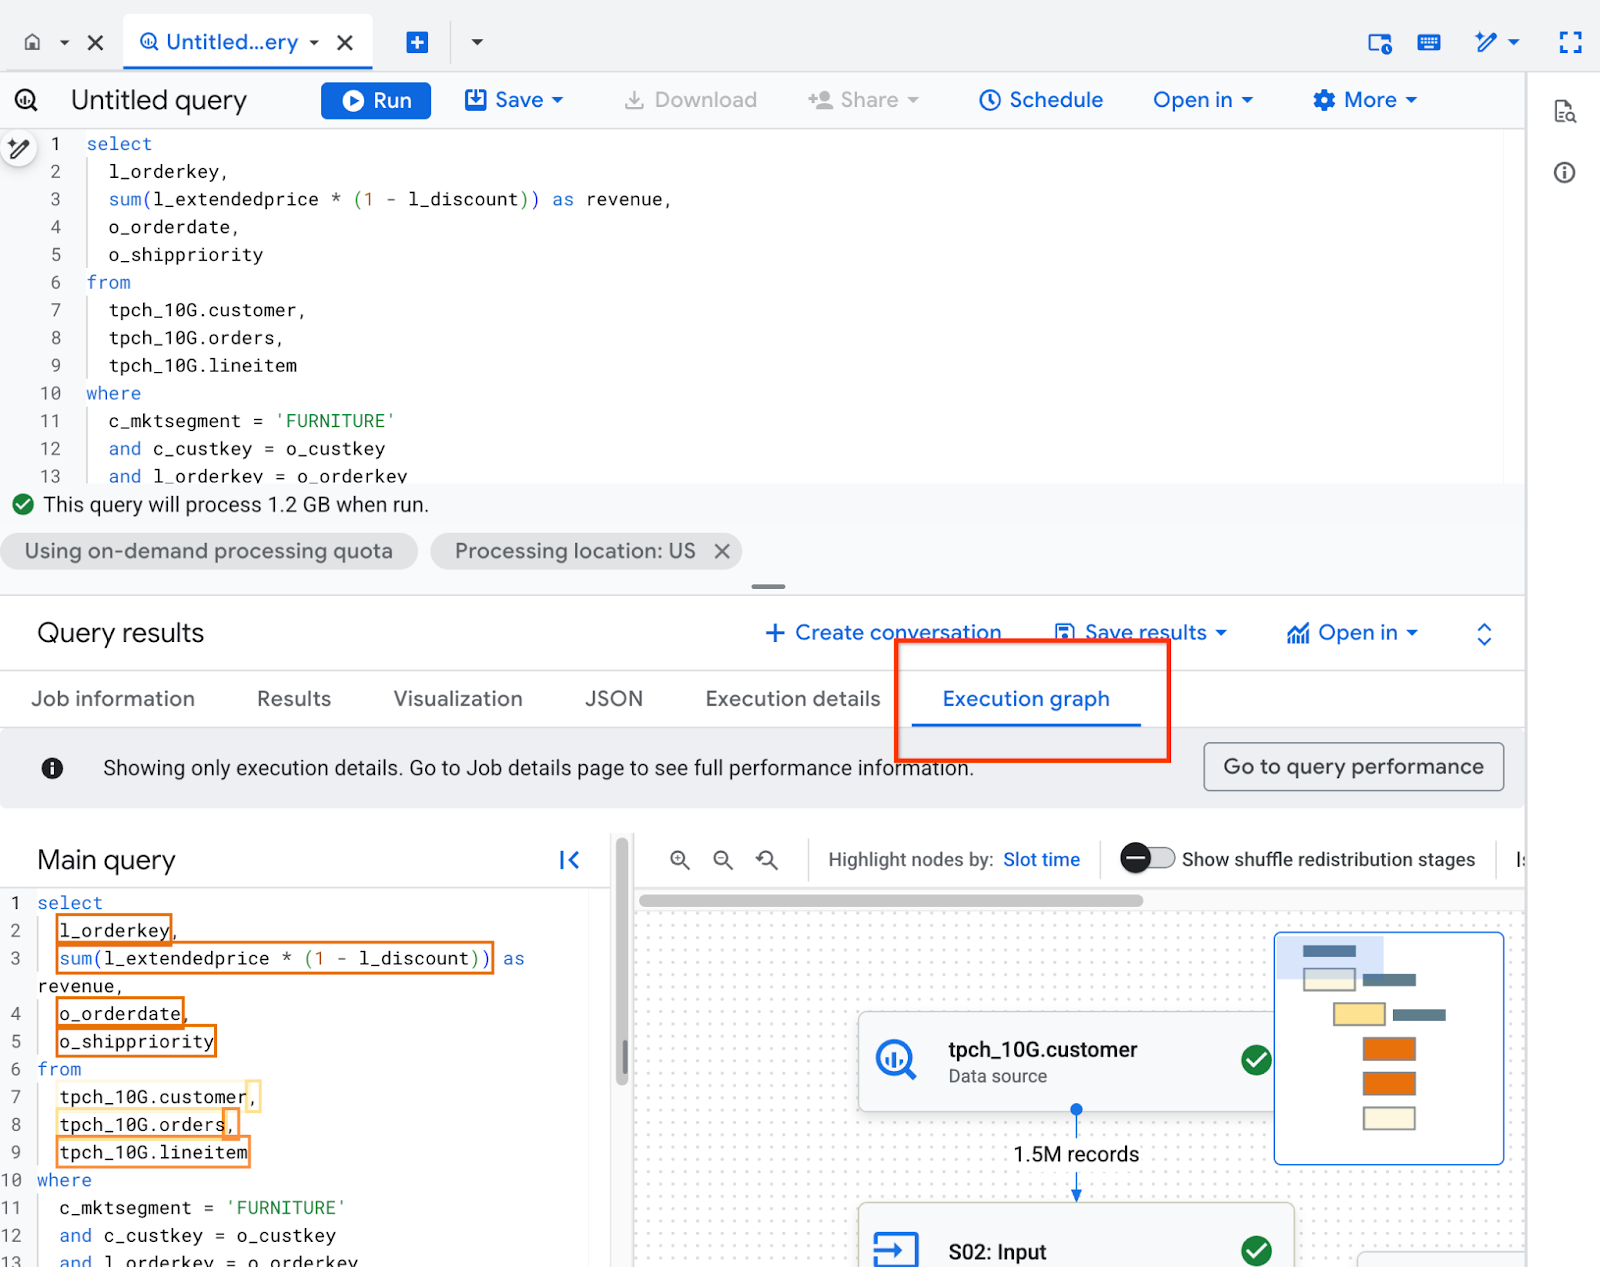
Il riquadro Grafico di esecuzione è organizzato come segue:
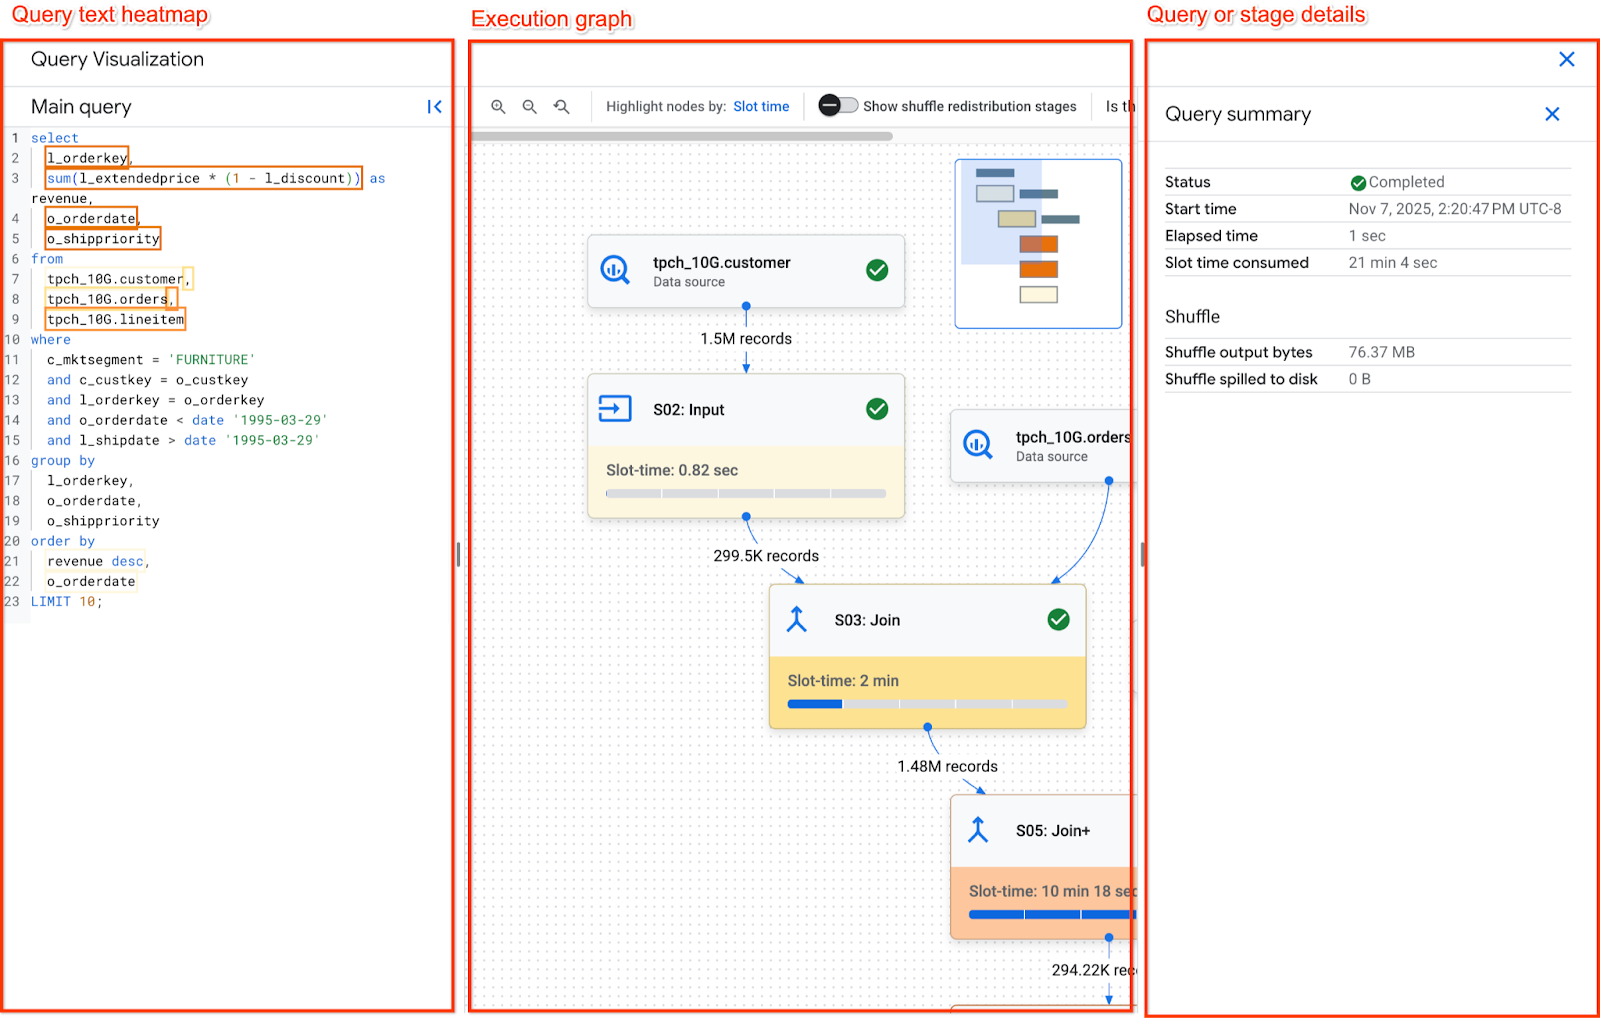
- Al centro si trova il grafico di esecuzione. Mostra le fasi come nodi e la memoria di shuffle scambiata tra le fasi come archi.
- Il riquadro a sinistra contiene la mappa termica del testo della query. Mostra il testo della query principale eseguita insieme alle visualizzazioni di riferimento.
- Il riquadro a destra contiene i dettagli della query o della fase.
Navigazione nel grafico di esecuzione
Il grafico di esecuzione applica una combinazione di colori ai nodi del grafico in base al tempo di slot, in cui i nodi con un rosso più scuro richiedono più tempo di slot rispetto alle altre fasi del grafico.
Per navigare nel grafico di esecuzione, puoi:
- Fai clic e tieni premuto sullo sfondo del grafico per spostarti in diverse aree del grafico.
- Utilizza la rotellina di scorrimento del mouse per aumentare e diminuire lo zoom del grafico.
- Fai clic e tieni premuto sulla minimappa in alto a destra per spostarti in diverse aree del grafico.
Se fai clic su una fase nel grafico, vengono visualizzati i dettagli della fase selezionata. I dettagli della fase includono:
- Statistiche. Per informazioni dettagliate sulle statistiche, consulta Panoramica delle fasi.
- Dettagli del passaggio. I passaggi descrivono le singole operazioni che eseguono la logica della query.
Dettagli del passaggio
Le fasi sono costituite da passaggi, ovvero le singole operazioni che eseguono la logica della query. I passaggi hanno passaggi secondari che descrivono cosa ha fatto il passaggio in pseudocodice. I passaggi secondari utilizzano le variabili per descrivere le relazioni tra i passaggi. Le variabili iniziano con un segno di dollaro seguito da un numero univoco. I numeri delle variabili non sono condivisi tra le fasi.
L'immagine seguente mostra i passaggi di una fase:
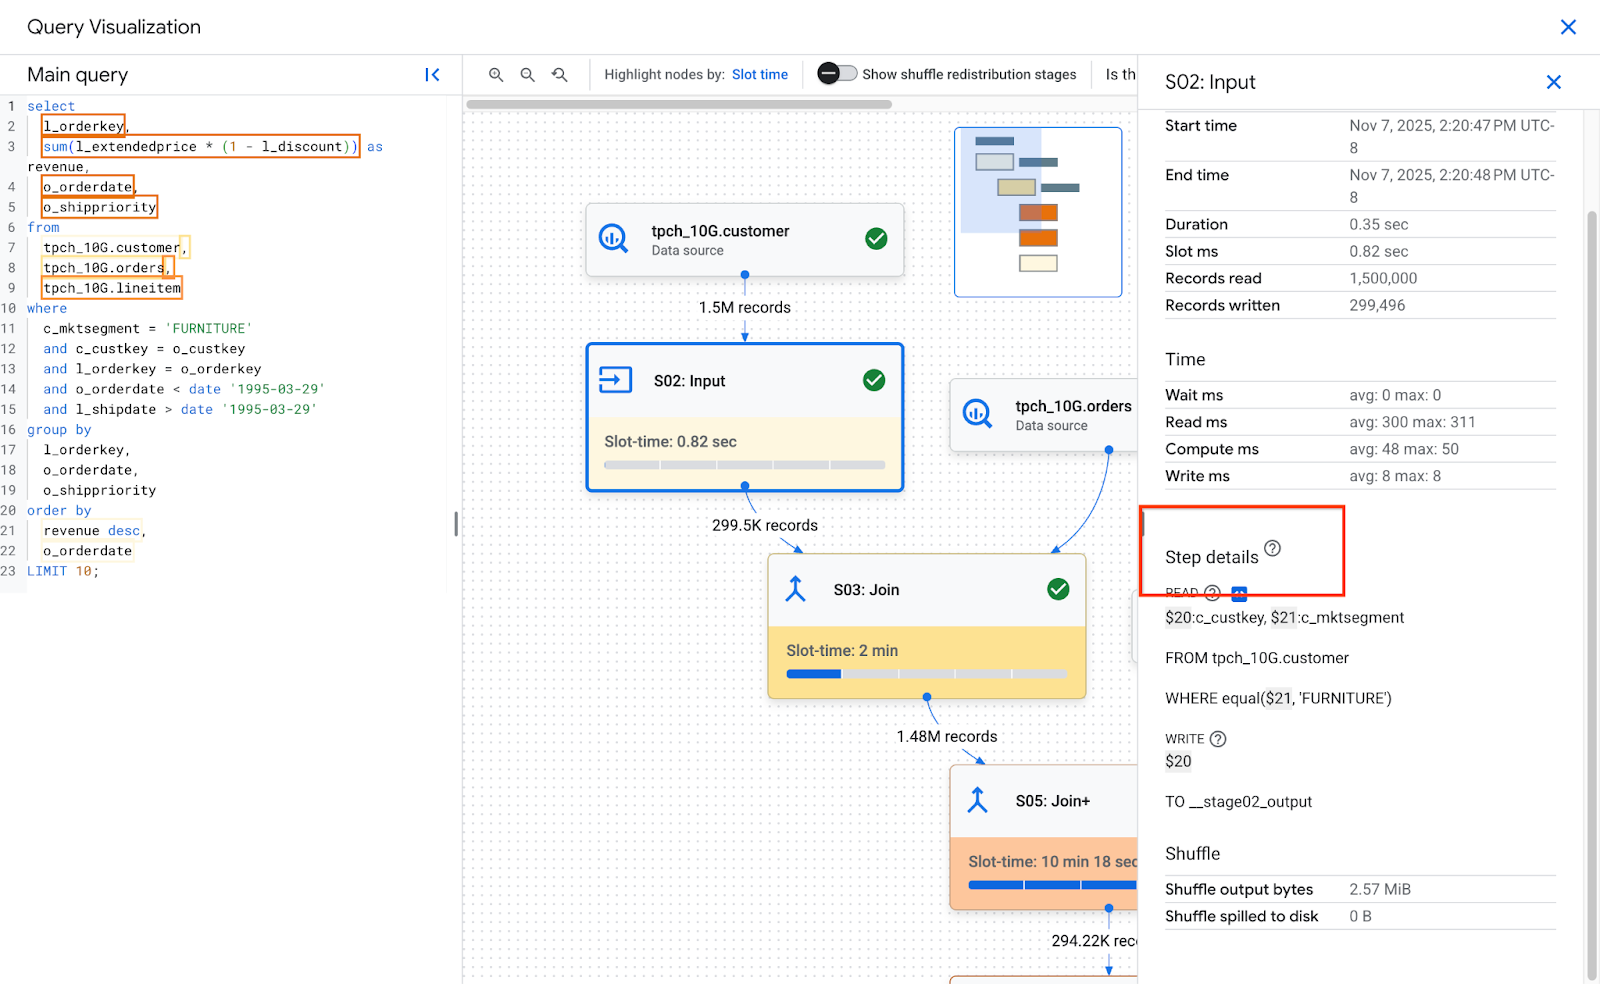
Ecco un esempio dei passaggi di una fase:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
I passaggi dell'esempio descrivono quanto segue:
- La fase ha letto le colonne l_orderkey e l_quantity dalla tabella lineitem e ha memorizzato i valori rispettivamente nelle variabili $30 e $31.
- La fase ha aggregato le variabili $30 e $31, memorizzando le aggregazioni rispettivamente nelle variabili $100 e $70.
- La fase ha scritto i risultati delle variabili $100 e $70 per lo shuffling. La fase ha ordinato i risultati nella memoria di shuffle in base a $100.
Per informazioni dettagliate sul tipo di passaggi e su come ottimizzarli, consulta Interpreta e ottimizza i passaggi.
BigQuery potrebbe troncare i passaggi secondari quando il grafico di esecuzione della query è abbastanza complesso da causare problemi di dimensioni del payload durante il recupero delle informazioni sulla query se vengono forniti passaggi secondari completi.
Mappa termica del testo della query
BigQuery può mappare alcuni passaggi della fase a parti del testo della query. La mappa termica del testo della query mostra tutto il testo della query corrispondente con i passaggi della fase. Evidenzia il testo della query in base al tempo di slot totale delle fasi i cui passaggi hanno un testo della query mappato.
L'immagine seguente mostra il testo della query evidenziato:
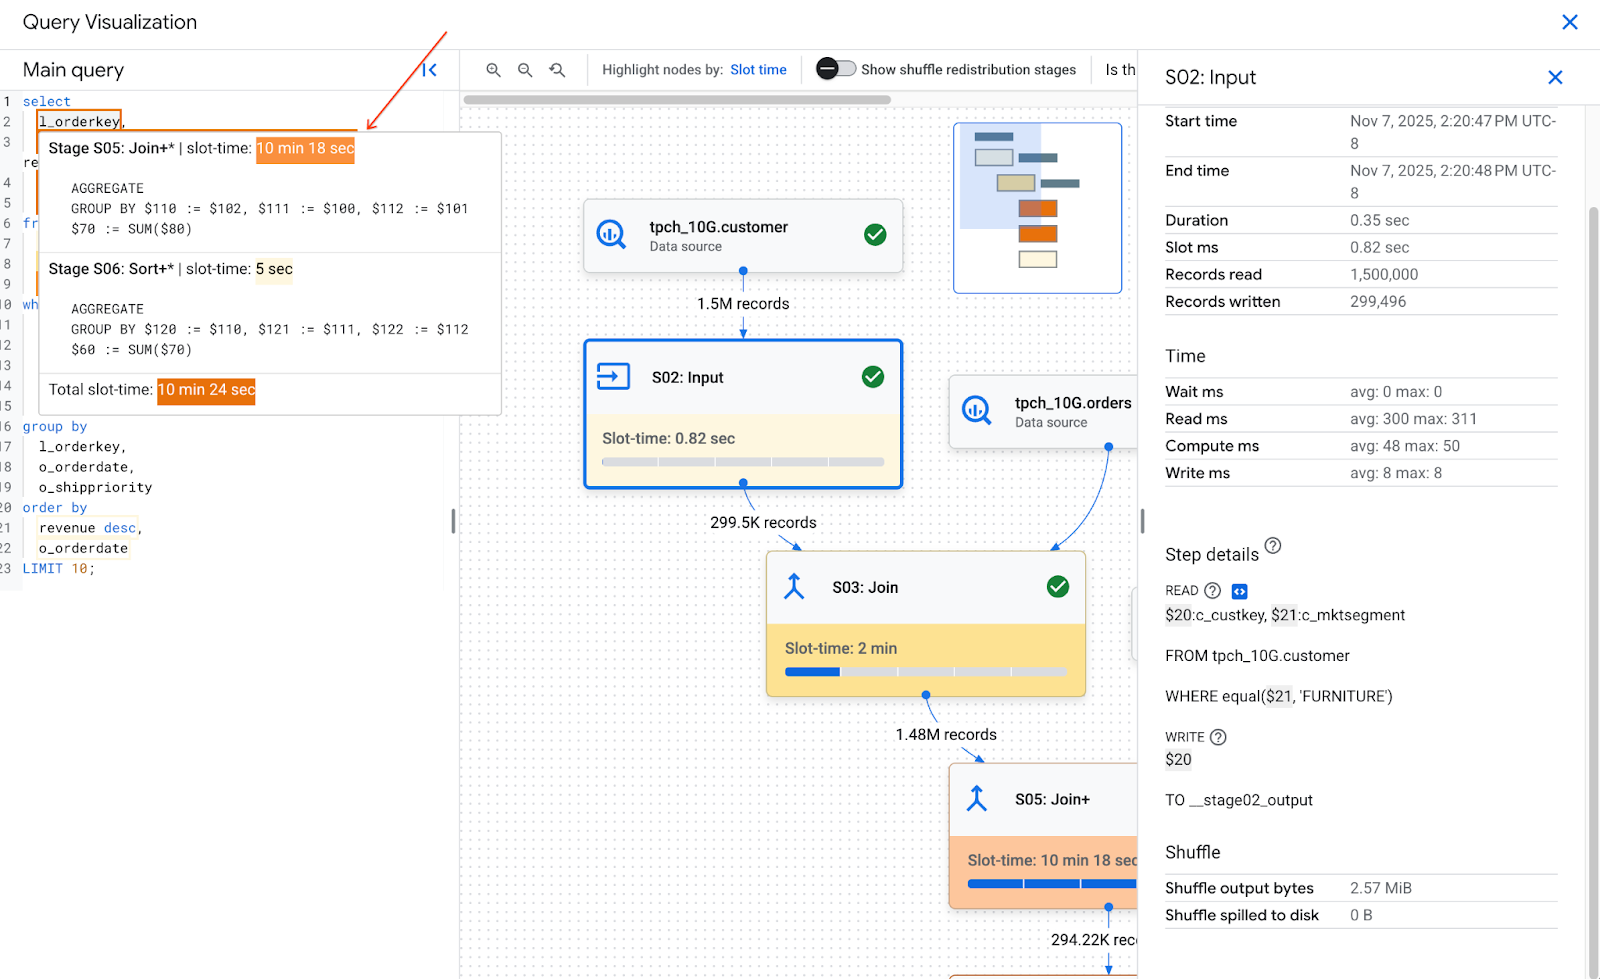
Se tieni il puntatore su una parte mappata del testo della query, viene visualizzato un tooltip che elenca tutti i passaggi della fase mappati al testo della query insieme allo slot-time della fase. Se fai clic sul testo di una query mappata, viene selezionata la fase nel grafico di esecuzione e vengono aperti i dettagli della fase nel riquadro a destra.
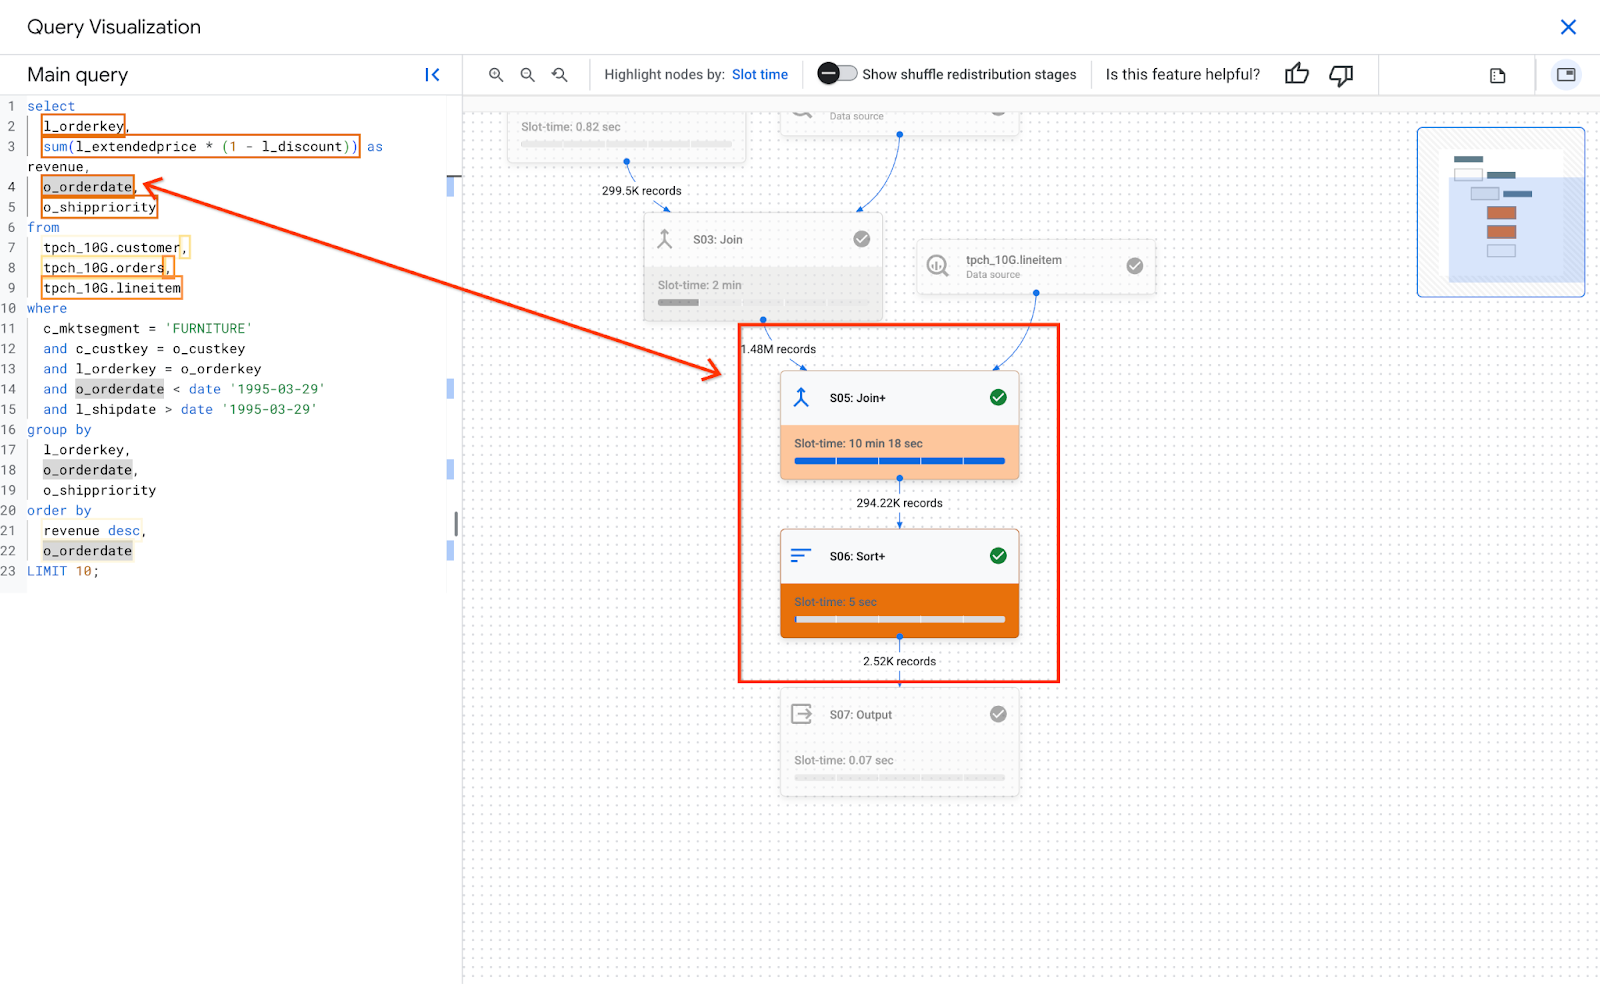
Una singola parte del testo della query può essere mappata a più fasi. La descrizione comando elenca ogni fase mappata e il relativo tempo di slot. Se fai clic sul testo della query, vengono evidenziate le fasi corrispondenti e il resto del grafico viene disattivato. Se poi fai clic su una fase specifica, ne vengono visualizzati i dettagli.
L'immagine seguente mostra la relazione tra il testo della query e i dettagli del passaggio:
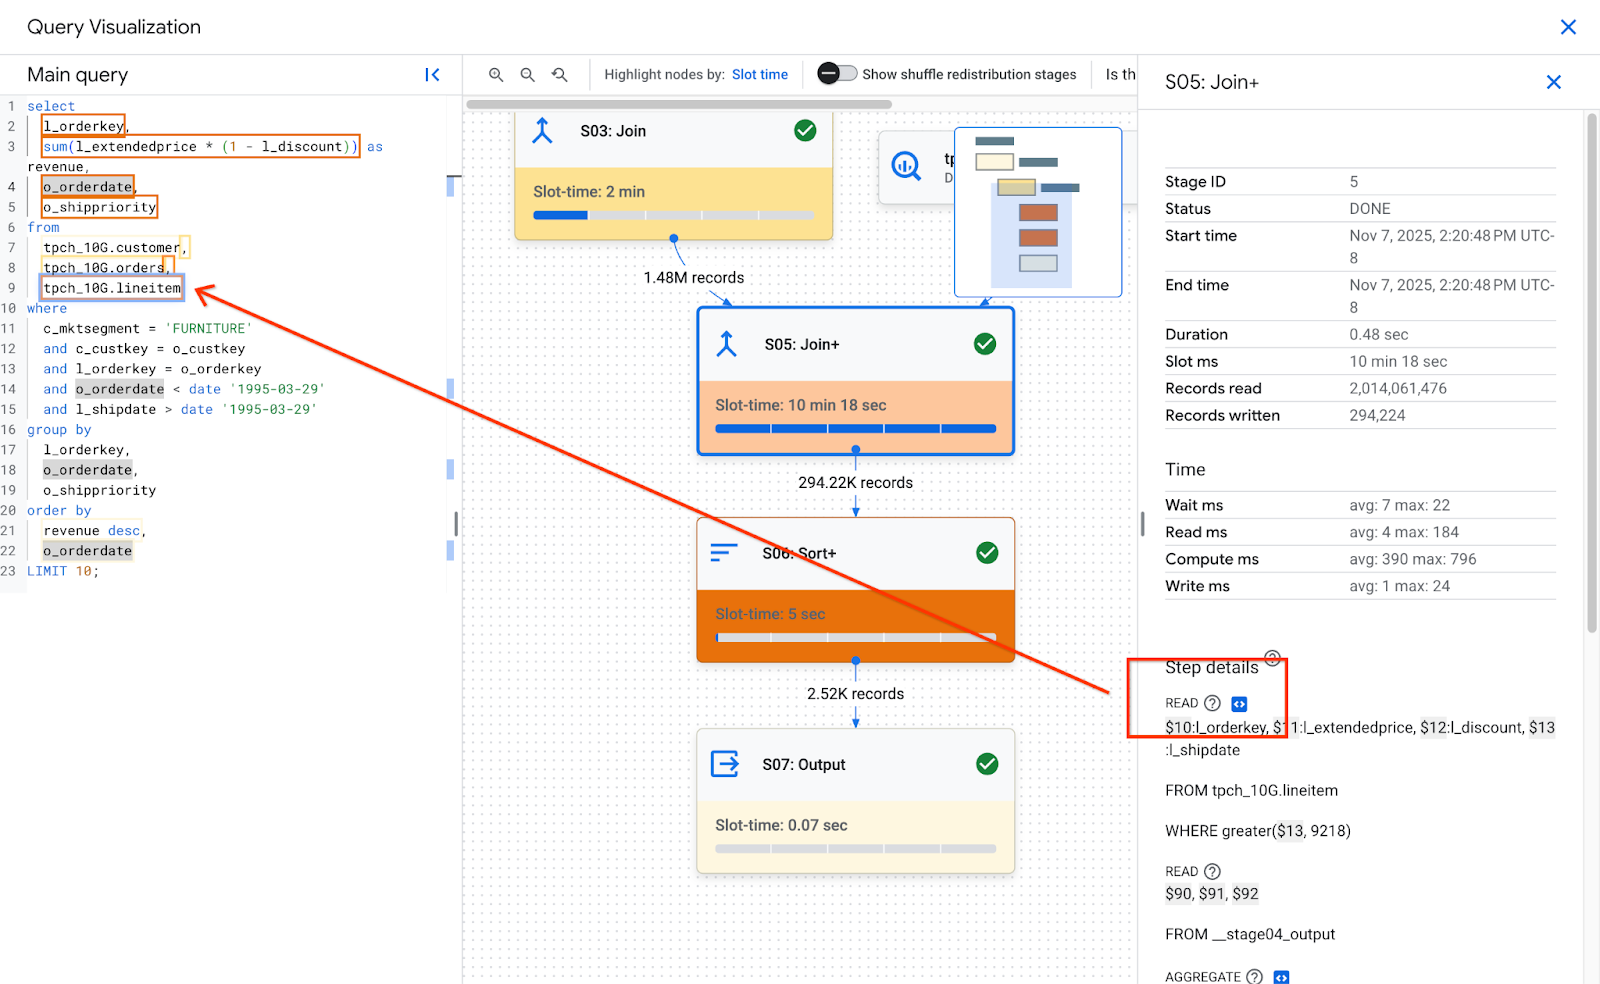
Nella sezione Dettagli passaggio di una fase, se un passaggio è mappato al testo della query, il passaggio ha un'icona di codice. Se fai clic sull'icona del codice, viene evidenziata la parte mappata del testo della query a sinistra.
È importante tenere presente che il colore della mappa termica si basa sul tempo di slot dell'intera fase. Poiché BigQuery non misura il tempo di slot dei passaggi, la mappa termica non rappresenta il tempo di slot effettivo per quella parte specifica del testo della query mappato. Nella maggior parte dei casi, una fase esegue un solo passaggio complesso, come un join o un'aggregazione. Pertanto, il colore della mappa termica è appropriato. Tuttavia, quando una fase è composta da passaggi che eseguono più operazioni complesse, il colore della mappa termica potrebbe rappresentare in modo eccessivo il tempo di slot effettivo nella mappa termica. In questi casi, è importante comprendere gli altri passaggi che compongono la fase per avere una comprensione più completa delle prestazioni della query.
Se una query utilizza viste e i passaggi della fase hanno mappature al testo della query di una vista, la mappa termica del testo della query mostra il nome della vista e il testo della query della vista con le relative mappature. Tuttavia, se la vista viene eliminata o se perdi l'bigquery.tables.get autorizzazione IAM sulla vista, la mappa termica del testo della query non mostra le mappature dei passaggi della fase per la vista.
Panoramica della fase
I campi della panoramica per ogni fase possono includere quanto segue:
| Campo API | Descrizione |
|---|---|
id |
ID numerico univoco della fase. |
name |
Nome di riepilogo semplice per la fase. I steps all'interno della fase forniscono ulteriori dettagli sui passaggi di esecuzione. |
status |
Stato di esecuzione della fase. Gli stati possibili sono PENDING, RUNNING, COMPLETE, FAILED e CANCELLED. |
inputStages |
Un elenco degli ID che formano il grafico delle dipendenze della fase. Ad esempio, una fase JOIN spesso richiede due fasi dipendenti che preparano i dati sul lato sinistro e destro della relazione JOIN. |
startMs |
Timestamp, in millisecondi dell'epoca, che rappresenta il momento in cui il primo worker della fase ha iniziato l'esecuzione. |
endMs |
Timestamp, in millisecondi epoch, che rappresenta il momento in cui l'ultimo worker ha completato l'esecuzione. |
steps |
Elenco più dettagliato dei passaggi di esecuzione all'interno della fase. Per saperne di più, consulta la prossima sezione. |
recordsRead |
Dimensione di input della fase come numero di record, in tutti i worker della fase. |
recordsWritten |
Dimensioni di output della fase come numero di record, in tutti i worker della fase. |
parallelInputs |
Numero di unità di lavoro parallelizzabili per la fase. A seconda della fase e della query, questo può rappresentare il numero di segmenti colonnari all'interno di una tabella o il numero di partizioni all'interno di uno shuffle intermedio. |
completedParallelInputs |
Numero di unità di lavoro completate all'interno della fase. Per alcune query, non è necessario completare tutti gli input di una fase per completare la fase. |
shuffleOutputBytes |
Rappresenta i byte totali scritti in tutti i worker all'interno di una fase della query. |
shuffleOutputBytesSpilled |
Le query che trasmettono dati significativi tra le fasi potrebbero dover ricorrere alla trasmissione basata su disco. La statistica dei byte con overflow indica la quantità di dati con overflow su disco. Dipende da un algoritmo di ottimizzazione, pertanto non è deterministico per una determinata query. |
Classificazione dei tempi per fase
Le fasi della query forniscono classificazioni delle tempistiche delle fasi, sia in forma relativa che assoluta. Poiché ogni fase di esecuzione rappresenta il lavoro svolto da uno o più worker indipendenti, le informazioni vengono fornite sia in termini di tempi medi che di tempi peggiori. Questi tempi rappresentano le prestazioni medie di tutti i worker in una fase, nonché le prestazioni del worker più lento della coda long-tail per una determinata classificazione. I tempi medi e massimi sono inoltre suddivisi in rappresentazioni assolute e relative. Per le statistiche basate su rapporti, i dati vengono forniti come frazione del tempo più lungo trascorso da un worker in un segmento.
La console Google Cloud presenta le tempistiche delle fasi utilizzando le rappresentazioni delle tempistiche relative.
Le informazioni sulla tempistica delle fasi vengono riportate come segue:
| Tempi relativi | Tempistica assoluta | Numeratore del rapporto |
|---|---|---|
waitRatioAvg |
waitMsAvg |
Tempo trascorso dal worker medio in attesa di essere pianificato. |
waitRatioMax |
waitMsMax |
Tempo trascorso dal worker più lento in attesa della pianificazione. |
readRatioAvg |
readMsAvg |
Tempo impiegato dal worker medio per leggere i dati di input. |
readRatioMax |
readMsMax |
Tempo impiegato dal worker più lento per leggere i dati di input. |
computeRatioAvg |
computeMsAvg |
Tempo trascorso dal worker medio con vincolo di CPU. |
computeRatioMax |
computeMsMax |
Tempo trascorso dal worker più lento con limitazioni della CPU. |
writeRatioAvg |
writeMsAvg |
Tempo impiegato dal worker medio per scrivere i dati di output. |
writeRatioMax |
writeMsMax |
Tempo impiegato dal worker più lento per scrivere i dati di output. |
Panoramica dei passaggi
I passaggi contengono le operazioni eseguite da ogni worker all'interno di una fase, presentate come un elenco ordinato di operazioni. Ogni operazione di passaggio ha una categoria e alcune operazioni forniscono informazioni più dettagliate. Le categorie di operazioni presenti nel piano di query includono:
| Categoria di passaggio | Descrizione |
|---|---|
READ |
Una lettura di una o più colonne da una tabella di input o da uno shuffling intermedio. Nei dettagli del passaggio vengono restituite solo le prime sedici colonne lette. |
WRITE |
Una scrittura di una o più colonne in una tabella di output o in uno shuffling intermedio. Per gli output partizionati HASH di una fase, sono incluse anche le colonne utilizzate come chiave di partizione. |
COMPUTE |
Valutazione delle espressioni e funzioni SQL. |
FILTER |
Utilizzato dalle clausole WHERE, OMIT IF e HAVING. |
SORT |
Operazione ORDER BY che include le chiavi di colonna e l'ordinamento. |
AGGREGATE |
Implementa le aggregazioni per clausole come GROUP BY o COUNT, tra le altre. |
LIMIT |
Implementa la clausola LIMIT. |
JOIN |
Implementa i join per clausole come JOIN, tra le altre; include il tipo di join ed eventualmente le condizioni di join. |
ANALYTIC_FUNCTION |
Una chiamata di una funzione finestra (detta anche "funzione analitica"). |
USER_DEFINED_FUNCTION |
Una chiamata a una funzione definita dall'utente'utente. |
UPDATE |
Modifica le righe esistenti in una tabella di destinazione per un'istruzione UPDATE; include le colonne modificate e la tabella di destinazione. |
DELETE |
Rimuove le righe da una tabella di destinazione per un'istruzione DELETE; include le colonne di riferimento e la tabella di destinazione. |
MERGE |
Modifica le righe in una tabella di destinazione per un'istruzione MERGE; include le colonne modificate e la tabella di destinazione. |
EXPORT |
Scrive le colonne di output in una tabella di destinazione per le istruzioni DML (Data Manipulation Language) o le esportazioni dei risultati delle query. |
Interpreta e ottimizza i passaggi
Le sezioni seguenti spiegano come interpretare i passaggi di un piano di query e forniscono modi per ottimizzare le query.
READ passaggio
Il passaggio READ indica che una fase sta accedendo ai dati per l'elaborazione. I dati possono essere letti direttamente dalle tabelle a cui fa riferimento una query o dalla memoria di shuffle.
Quando i dati di una fase precedente vengono letti, BigQuery li legge dalla memoria di shuffle. La quantità di dati scansionati influisce sui costi quando utilizzi slot on demand e sulle prestazioni quando utilizzi le prenotazioni.
Potenziali problemi di prestazioni
- Scansione di grandi dimensioni di una tabella non partizionata: se la query richiede solo una piccola parte dei dati, ciò potrebbe indicare che la scansione della tabella è inefficiente. Il partizionamento potrebbe essere una buona strategia di ottimizzazione.
- Scansione di una tabella di grandi dimensioni con un rapporto di filtro ridotto: questo suggerisce che il filtro non riduce in modo efficace i dati scansionati. Valuta la possibilità di rivedere le condizioni di filtro.
- Byte di shuffle trasferiti su disco: questo suggerisce che i dati non vengono archiviati in modo efficace utilizzando tecniche di ottimizzazione come il clustering, che potrebbe mantenere dati simili in cluster.
Ottimizza
- Filtro mirato: utilizza le clausole
WHEREin modo strategico per filtrare i dati non pertinenti il prima possibile nella query. In questo modo si riduce la quantità di dati che devono essere elaborati dalla query. - Partizionamento e clustering: BigQuery utilizza il partizionamento e il clustering delle tabelle per individuare in modo efficiente segmenti di dati specifici.
Assicurati che le tabelle siano partizionate e raggruppate in cluster in base ai pattern di query tipici per ridurre al minimo i dati scansionati durante i passaggi di
READ. - Seleziona le colonne pertinenti: evita di utilizzare istruzioni
SELECT *. Seleziona invece colonne specifiche o utilizzaSELECT * EXCEPTper evitare di leggere dati non necessari. - Viste materializzate: le viste materializzate possono precalcolare e archiviare le aggregazioni utilizzate di frequente, riducendo potenzialmente la necessità di leggere le tabelle di base durante i passaggi
READper le query che utilizzano queste viste.
COMPUTE passaggio
Nel passaggio COMPUTE, BigQuery esegue le seguenti azioni sui tuoi dati:
- Valuta le espressioni nelle clausole
SELECT,WHERE,HAVINGe altre clausole della query, inclusi calcoli, confronti e operazioni logiche. - Esegue funzioni SQL integrate e funzioni definite dall'utente.
- Filtra le righe di dati in base alle condizioni della query.
Ottimizza
Il piano di query può rivelare colli di bottiglia nel passaggio COMPUTE. Cerca fasi con calcoli estesi o un numero elevato di righe elaborate.
- Correlare il passaggio
COMPUTEcon il volume di dati: se una fase mostra un calcolo significativo ed elabora un volume di dati elevato, potrebbe essere un buon candidato per l'ottimizzazione. - Dati asimmetrici: per le fasi in cui il valore massimo di calcolo è significativamente superiore alla media di calcolo, ciò indica che la fase ha impiegato una quantità di tempo sproporzionata per l'elaborazione di alcune sezioni di dati. Valuta la possibilità di esaminare la distribuzione dei dati per verificare se è presente una distorsione dei dati.
- Considera i tipi di dati:utilizza tipi di dati appropriati per le colonne. Ad esempio, l'utilizzo di numeri interi, date/ore e timestamp anziché di stringhe può migliorare le prestazioni.
WRITE passaggio
I passaggi WRITE si verificano per i dati intermedi e l'output finale.
- Scrittura nella memoria di shuffling: in una query multifase, il passaggio
WRITEspesso prevede l'invio dei dati elaborati a un'altra fase per un'ulteriore elaborazione. Questo è tipico della memoria di shuffling, che combina o aggrega i dati provenienti da più origini. I dati scritti durante questa fase sono in genere un risultato intermedio, non l'output finale. - Output finale: il risultato della query viene scritto nella tabella di destinazione o in una tabella temporanea.
Partizionamento hash
Quando una fase del piano di query scrive i dati in un output partizionato con hash, BigQuery scrive le colonne incluse nell'output e la colonna scelta come chiave di partizione.
Ottimizza
Anche se il passaggio WRITE potrebbe non essere ottimizzato direttamente, comprenderne il ruolo può aiutarti a identificare potenziali colli di bottiglia nelle fasi precedenti:
- Riduci al minimo i dati scritti: concentrati sull'ottimizzazione delle fasi precedenti con filtri e aggregazioni per ridurre la quantità di dati scritti durante questo passaggio.
Partizionamento: la scrittura trae grandi vantaggi dal partizionamento delle tabelle. Se i dati che scrivi sono limitati a partizioni specifiche, BigQuery può eseguire scritture più rapide.
Se l'istruzione DML ha una clausola
WHEREcon una condizione statica rispetto a una colonna di partizione della tabella, BigQuery modifica solo le partizioni della tabella pertinenti.Compromessi della denormalizzazione: la denormalizzazione a volte può portare a set di risultati più piccoli nel passaggio intermedio
WRITE. Tuttavia, esistono svantaggi come l'aumento dell'utilizzo dello spazio di archiviazione e le sfide relative alla coerenza dei dati.
JOIN passaggio
Nel passaggio JOIN, BigQuery combina i dati di due origini dati.
I join possono includere condizioni di join. I join richiedono molte risorse. Quando si uniscono dati di grandi dimensioni in BigQuery, le chiavi di join vengono sottoposte a shuffling in modo indipendente per allinearsi sullo stesso slot, in modo che il join venga eseguito localmente su ogni slot.
Il piano di query per il passaggio JOIN in genere rivela i seguenti dettagli:
- Join pattern:indica il tipo di join utilizzato. Ogni tipo definisce il numero di righe delle tabelle unite incluse nel set di risultati.
- Colonne di unione:sono le colonne utilizzate per abbinare le righe tra le origini dati. La scelta delle colonne è fondamentale per le prestazioni di unione.
Pattern di join
- Join di trasmissione: quando una tabella, in genere quella più piccola, può essere inserita nella memoria di un singolo nodo worker o slot, BigQuery può trasmetterla a tutti gli altri nodi per eseguire il join in modo efficiente. Cerca
JOIN EACH WITH ALLnei dettagli del passaggio. - Hash join: quando le tabelle sono di grandi dimensioni o un broadcast join non è adatto, è possibile utilizzare un hash join. BigQuery utilizza le operazioni di hash e shuffle per eseguire lo shuffling delle tabelle di sinistra e di destra in modo che le chiavi corrispondenti finiscano nello stesso slot per eseguire un join locale. I join hash sono un'operazione costosa, poiché i dati devono essere spostati, ma consentono una corrispondenza efficiente delle righe tra gli hash. Cerca
JOIN EACH WITH EACHnei dettagli del passaggio. - Self-join: un anti-pattern SQL in cui una tabella viene unita a se stessa.
- Cross join: un antipattern SQL che può causare problemi di prestazioni significativi perché genera dati di output più grandi degli input.
- Join asimmetrico: la distribuzione dei dati nella chiave di join in una tabella è molto asimmetrica e può causare problemi di prestazioni. Cerca i casi in cui il tempo di calcolo massimo è molto maggiore del tempo di calcolo medio nel piano di query. Per ulteriori informazioni, consulta Join con cardinalità elevata e Asimmetria della partizione.
Debug
- Volume di dati elevato: se il piano di query mostra una quantità significativa di dati elaborati durante il passaggio
JOIN, esamina la condizione di join e le chiavi di join. Valuta la possibilità di filtrare o utilizzare chiavi di join più selettive. - Distribuzione dei dati asimmetrica: analizza la distribuzione dei dati delle chiavi di join. Se una tabella è molto asimmetrica, esplora strategie come la suddivisione della query o il pre-filtraggio.
- Join con cardinalità elevata: i join che producono un numero di righe significativamente superiore al numero di righe di input di sinistra e di destra possono ridurre drasticamente le prestazioni delle query. Evita i join che producono un numero molto elevato di righe.
- Ordinamento errato della tabella: assicurati di aver scelto il tipo di join appropriato, ad esempio
INNERoLEFT, e di aver ordinato le tabelle dalla più grande alla più piccola in base ai requisiti della query.
Ottimizza
- Chiavi di join selettive: per le chiavi di join, utilizza
INT64anzichéSTRINGquando possibile. I confrontiSTRINGsono più lenti dei confrontiINT64perché confrontano ogni carattere di una stringa. I numeri interi richiedono un solo confronto. - Filtra prima dell'unione: applica i filtri della clausola
WHEREalle singole tabelle prima dell'unione. In questo modo si riduce la quantità di dati coinvolti nell'operazione di join. - Evita le funzioni nelle colonne di join: evita di chiamare funzioni nelle colonne di join. Standardizza invece i dati della tabella durante il processo di importazione o post-importazione utilizzando le pipeline SQL ELT. Questo approccio elimina la necessità di modificare dinamicamente le colonne di join, consentendo join più efficienti senza compromettere l'integrità dei dati.
- Evita i self-join: i self-join vengono di uso comune per calcolare relazioni dipendenti dalle righe. Tuttavia, le self-join possono potenzialmente quadruplicare il numero di righe di output, causando problemi di prestazioni. Anziché fare affidamento sui self-join, valuta la possibilità di utilizzare le funzioni finestra (analitiche).
- Tabelle grandi per prime: anche se l'ottimizzatore delle query SQL può determinare quale tabella deve trovarsi su quale lato del join, ordina le tabelle unite in modo appropriato. La best practice consiste nel posizionare prima la tabella più grande, seguita da quella più piccola e poi in ordine decrescente.
- Denormalizzazione: in alcuni casi, la denormalizzazione strategica delle tabelle (aggiunta di dati ridondanti) può eliminare del tutto i join. Tuttavia, questo approccio comporta dei compromessi in termini di archiviazione e coerenza dei dati.
- Partizionamento e clustering: il partizionamento delle tabelle partizionate in base alle chiavi di join e il clustering dei dati collocati possono velocizzare notevolmente i join consentendo a BigQuery di scegliere come target le partizioni di dati pertinenti.
- Ottimizzazione dei join asimmetrici: per evitare problemi di prestazioni associati ai join asimmetrici, prefiltra i dati della tabella il prima possibile o suddividi la query in due o più query.
AGGREGATE passaggio
Nella fase AGGREGATE, BigQuery aggrega e raggruppa i dati.
Debug
- Dettagli della fase: controlla il numero di righe di input e di output dell'aggregazione e la dimensione dello shuffling per determinare la riduzione dei dati ottenuta dal passaggio di aggregazione e se è stato coinvolto lo data shuffling.
- Dimensione di shuffle: una dimensione di shuffle elevata potrebbe indicare che una quantità significativa di dati è stata spostata tra i nodi worker durante l'aggregazione.
- Controlla la distribuzione dei dati:assicurati che i dati siano distribuiti in modo uniforme tra le partizioni. Una distribuzione dei dati asimmetrica può portare a workload sbilanciati nella fase di aggregazione.
- Esamina le aggregazioni: analizza le clausole di aggregazione per verificare che siano necessarie ed efficienti.
Ottimizza
- Clustering: raggruppa le tabelle in cluster in base alle colonne utilizzate di frequente nelle clausole
GROUP BY,COUNTo in altre clausole di aggregazione. - Partizionamento: scegli una strategia di partizionamento in linea con i tuoi pattern di query. Valuta la possibilità di utilizzare tabelle partizionate per data di acquisizione per ridurre la quantità di dati scansionati durante l'aggregazione.
- Aggrega prima: se possibile, esegui le aggregazioni prima nella pipeline delle query. In questo modo, è possibile ridurre la quantità di dati da elaborare durante l'aggregazione.
- Ottimizzazione dello shuffling: se lo shuffling è un collo di bottiglia, esplora i modi per ridurlo al minimo. Ad esempio, denormalizza le tabelle o utilizza il clustering per collocare i dati pertinenti.
Casi limite
- Aggregati DISTINCT: le query con aggregati
DISTINCTpossono essere costose dal punto di vista computazionale, soprattutto su set di dati di grandi dimensioni. Prendi in considerazione alternative comeAPPROX_COUNT_DISTINCTper risultati approssimativi. - Numero elevato di gruppi: se la query produce un numero elevato di gruppi, potrebbe consumare una quantità significativa di memoria. In questi casi, valuta la possibilità di limitare il numero di gruppi o di utilizzare una strategia di aggregazione diversa.
REPARTITION passaggio
Sia REPARTITION che COALESCE sono tecniche di ottimizzazione che BigQuery applica direttamente ai dati sottoposti a shuffling nella query.
REPARTITION: questa operazione mira a riequilibrare la distribuzione dei dati tra i nodi worker. Supponiamo che, dopo lo shuffling, un nodo worker finisca con una quantità di dati sproporzionatamente elevata. Il passaggioREPARTITIONridistribuisce i dati in modo più uniforme, impedendo che un singolo worker diventi un collo di bottiglia. Questo è particolarmente importante per le operazioni ad alta intensità di calcolo come i join.COALESCE: questo passaggio si verifica quando hai molti piccoli bucket di dati dopo lo shuffling. Il passaggioCOALESCEcombina questi bucket in bucket più grandi, riducendo l'overhead associato alla gestione di numerosi piccoli dati. Questo può essere particolarmente utile quando si gestiscono set di risultati intermedi molto piccoli.
Se nel piano di query vedi i passaggi REPARTITION o COALESCE, non significa necessariamente che ci sia un problema con la query. Spesso è un segno che BigQuery sta ottimizzando in modo proattivo la distribuzione dei dati per migliorare le prestazioni. Tuttavia, se queste operazioni si verificano ripetutamente, potrebbe indicare che i dati sono intrinsecamente asimmetrici o che la query sta causando un rimescolamento eccessivo dei dati.
Ottimizza
Per ridurre il numero di passaggi di REPARTITION, prova i seguenti suggerimenti:
- Distribuzione dei dati: assicurati che le tabelle siano partizionate e raggruppate in cluster in modo efficace. Dati ben distribuiti riducono la probabilità di squilibri significativi dopo il rimescolamento.
- Struttura della query: analizza la query per individuare potenziali fonti di distorsione dei dati. Ad esempio, sono presenti filtri o join altamente selettivi che comportano l'elaborazione di un piccolo sottoinsieme di dati su un singolo worker?
- Strategie di join: sperimenta diverse strategie di join per vedere se portano a una distribuzione dei dati più equilibrata.
Per ridurre il numero di passaggi di COALESCE, prova i seguenti suggerimenti:
- Strategie di aggregazione: valuta la possibilità di eseguire le aggregazioni in una fase precedente della pipeline di query. In questo modo, puoi ridurre il numero di piccoli set di risultati intermedi che potrebbero causare passaggi
COALESCE. - Volume di dati: se utilizzi set di dati molto piccoli,
COALESCEpotrebbe non essere un problema significativo.
Non ottimizzare eccessivamente. Un'ottimizzazione prematura potrebbe rendere le query più complesse senza produrre vantaggi significativi.
UPDATE, DELETE e MERGE passaggi
I passaggi UPDATE, DELETE e MERGE vengono visualizzati nelle fasi che eseguono istruzioni DML (Data Manipulation Language) su una tabella di destinazione.
I dettagli del passaggio in genere includono i seguenti passaggi secondari:
- Colonne:le colonne lette o scritte nella tabella di destinazione.
- Tabella di destinazione (
FROMoINTO): la tabella di destinazione modificata dall'istruzione, utilizzandoFROMper i passaggiUPDATEeDELETEeINTOper i passaggiMERGE.
EXPORT passaggio
Il passaggio EXPORT scrive i dati di output in una tabella di destinazione. Questo passaggio viene visualizzato comunemente nelle fasi finali delle istruzioni DML, come le istruzioni INSERT, UPDATE, DELETE e MERGE, e nelle query che materializzano i risultati in una tabella di destinazione.
I dettagli del passaggio in genere includono i seguenti passaggi secondari:
- Colonne di output: l'elenco delle variabili scritte nella tabella di destinazione.
- Tabella di destinazione (
TO): la tabella di destinazione che riceve le righe esportate.
Spiegazione delle query federate
Le query federate consentono di inviare un'istruzione di query a un'origine dati esterna utilizzando la funzione EXTERNAL_QUERY.
Le query federate sono soggette alla tecnica di ottimizzazione nota come pushdown SQL e il piano di query mostra le operazioni di pushdown nell'origine dati esterna, se presenti. Ad esempio, se esegui la seguente query:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
Il piano di query mostrerà i seguenti passaggi della fase:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
In questo piano, table_for_external_query_$_0(...) rappresenta la funzione EXTERNAL_QUERY. Tra parentesi puoi vedere la query eseguita dall'origine dati esterna. In base a questo, puoi notare che:
- Un'origine dati esterna restituisce solo tre colonne selezionate.
- Un'origine dati esterna restituisce solo le righe per le quali
country_codeè'ee'o'hu'. - L'operatore
LIKEnon è pushdown e viene valutato da BigQuery.
Per fare un confronto, se non sono presenti pushdown, il piano di query mostrerà i seguenti passaggi della fase:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
Questa volta un'origine dati esterna restituisce tutte le colonne e tutte le righe della tabella company e BigQuery esegue il filtro.
Metadati Timeline
La cronologia delle query segnala l'avanzamento in momenti specifici, fornendo viste istantanee dell'avanzamento complessivo delle query. La cronologia è rappresentata come una serie di campioni che riportano i seguenti dettagli:
| Campo | Descrizione |
|---|---|
elapsedMs |
Millisecondi trascorsi dall'inizio dell'esecuzione della query. |
totalSlotMs |
Una rappresentazione cumulativa dei millisecondi di slot utilizzati dalla query. |
pendingUnits |
Unità di lavoro totali pianificate e in attesa di esecuzione. |
activeUnits |
Numero totale di unità di lavoro attive elaborate dai worker. |
completedUnits |
Unità di lavoro totali completate durante l'esecuzione di questa query. |
Esempio di query
La seguente query conta il numero di righe nel set di dati pubblico di Shakespeare e ha un secondo conteggio condizionale che limita i risultati alle righe che fanno riferimento ad "Amleto":
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
Fai clic su Dettagli esecuzione per visualizzare il piano di query:

Gli indicatori di colore mostrano le tempistiche relative di tutti i passaggi in tutte le fasi.
Per scoprire di più sui passaggi delle fasi di esecuzione, fai clic su per espandere i dettagli della fase:
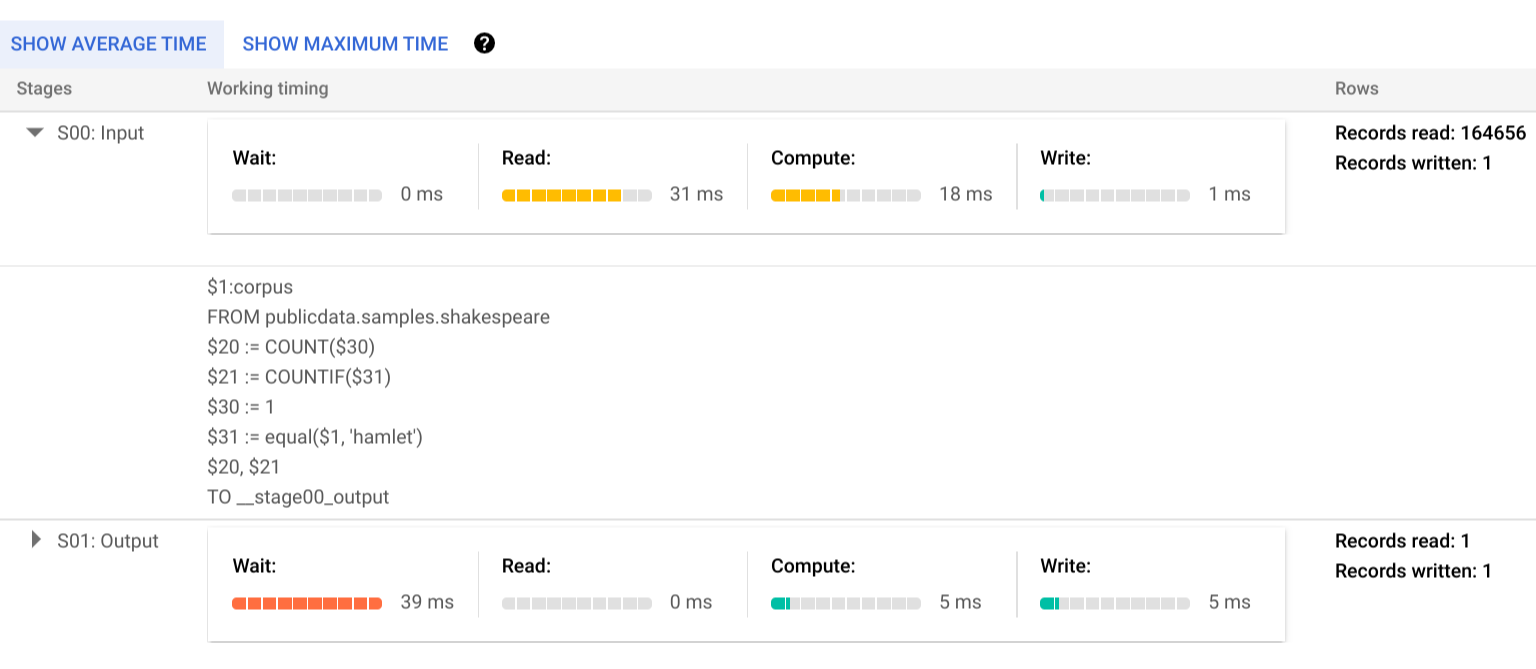
In questo esempio, il tempo più lungo in qualsiasi segmento è stato il tempo trascorso dal singolo worker nella Fase 01 in attesa del completamento della Fase 00. Questo perché la fase 01 dipendeva dall'input della fase 00 e non poteva iniziare finché la prima fase non scriveva il suo output nello shuffle intermedio.
Error Reporting
È possibile che i job di query non vadano a buon fine durante l'esecuzione. Poiché le informazioni sul piano vengono aggiornate periodicamente, puoi osservare dove si è verificato l'errore all'interno del grafico di esecuzione. All'interno della console Google Cloud , le fasi riuscite o non riuscite sono contrassegnate da un segno di spunta o da un punto esclamativo accanto al nome della fase.
Per saperne di più sull'interpretazione e sulla risoluzione degli errori, consulta la guida alla risoluzione dei problemi.
Rappresentazione di esempio dell'API
Le informazioni sul piano di query sono incorporate nelle informazioni sulla risposta del job e puoi recuperarle chiamando jobs.get.
Ad esempio, il seguente estratto di una risposta JSON per un job che restituisce la query di esempio su Amleto mostra sia il piano di query sia le informazioni sulla cronologia.
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
Utilizzo delle informazioni sull'esecuzione
I piani di query di BigQuery forniscono informazioni su come il servizio esegue le query, ma la natura gestita del servizio limita la possibilità di intervenire direttamente su alcuni dettagli. Molte ottimizzazioni avvengono automaticamente utilizzando il servizio, il che può differire da altri ambienti in cui l'ottimizzazione, il provisioning e il monitoraggio possono richiedere personale dedicato e competente.
Per tecniche specifiche che possono migliorare l'esecuzione e le prestazioni delle query, consulta la documentazione sulle best practice. Le statistiche del piano di query e della cronologia possono aiutarti a capire se determinate fasi dominano l'utilizzo delle risorse. Ad esempio, una fase JOIN che genera molte più righe di output rispetto alle righe di input può indicare un'opportunità di filtrare prima nella query.
Inoltre, le informazioni sulla cronologia possono aiutare a identificare se una determinata query è lenta in modo isolato o a causa degli effetti di altre query che competono per le stesse risorse. Se noti che il numero di unità attive rimane limitato per tutta la durata della query, ma la quantità di unità di lavoro in coda rimane elevata, questo può rappresentare un caso in cui la riduzione del numero di query simultanee può migliorare significativamente il tempo di esecuzione complessivo di determinate query.