


BigQuery 內嵌於查詢工作,包含診斷查詢計畫和時間資訊。這與其他資料庫和分析系統中 EXPLAIN 等陳述式提供的資訊類似。這項資訊可從 jobs.get 等方法的 API 回應中擷取。
如果是長時間執行的查詢,BigQuery 會定期更新這些統計資料。這些更新與工作狀態輪詢頻率無關,但通常不會超過每 30 秒一次。此外,不使用執行資源的查詢工作 (例如模擬測試要求或可從快取結果提供的結果) 不會包含額外的診斷資訊,但可能會顯示其他統計資料。
背景
BigQuery 執行查詢時,會將 SQL 轉換為由「階段」組成的執行圖。階段由步驟組成,這些步驟是執行查詢邏輯的基本作業。BigQuery 採用高度分散的平行架構,可平行執行各階段,縮短延遲時間。階段之間會使用重組 (一種快速的分散式記憶體架構) 相互通訊。
查詢計畫會使用「工作單位」和「worker」等詞彙來描述階段平行處理。在 BigQuery 的其他地方,您可能會看到「運算單元」一詞,這是查詢執行多個面向的抽象表示法,包括運算、記憶體和 I/O 資源。運算單元會平行執行階段的個別工作單元。頂層工作統計資料會根據這個抽象會計,使用 totalSlotMs 提供個別查詢費用。
查詢執行的另一項重要屬性是,BigQuery 可以在查詢執行期間修改查詢計畫。舉例來說,BigQuery 會導入重新分區階段,改善查詢 worker 之間的資料分布,進而提高平行處理能力並縮短查詢延遲時間。
除了查詢計畫外,查詢工作也會顯示執行時間軸,提供已完成、待處理和進行中的工作單位。一項查詢可以有多個階段,且同時有執行中的 worker,時間軸則會顯示查詢的整體進度。
使用 Google Cloud 控制台查看執行圖
在Google Cloud 控制台中,按一下「Execution Details」(執行作業詳細資料) 按鈕,即可查看已完成查詢的查詢計畫詳細資料。
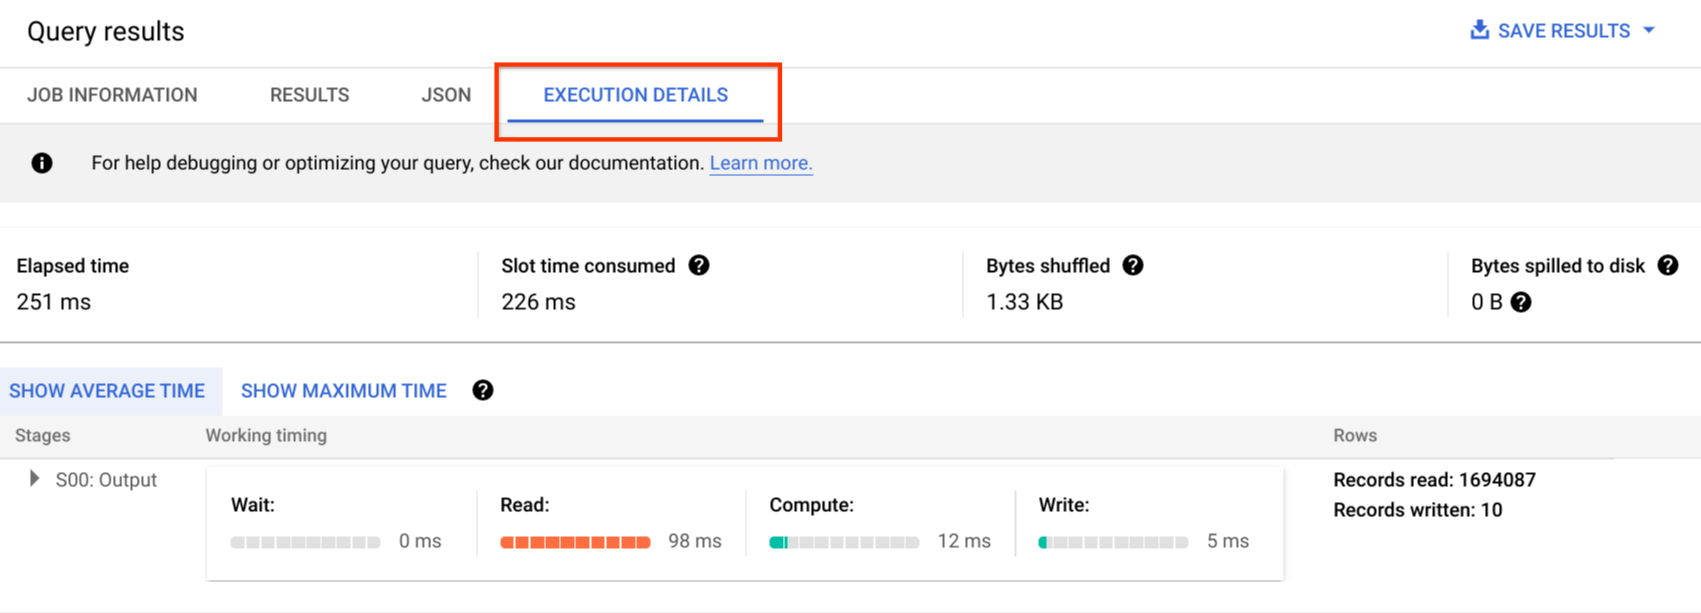
查詢計畫資訊
在 API 回應中,查詢計畫會以查詢階段清單的形式呈現。清單中的每個項目都會顯示各階段的總覽統計資料、詳細步驟資訊和階段時間分類。 Google Cloud 控制台不會顯示所有詳細資料,但 API 回應中會顯示所有詳細資料。
瞭解執行圖
在 Google Cloud 控制台中,按一下「Execution graph」(執行圖) 分頁標籤,即可查看查詢計畫詳細資料。
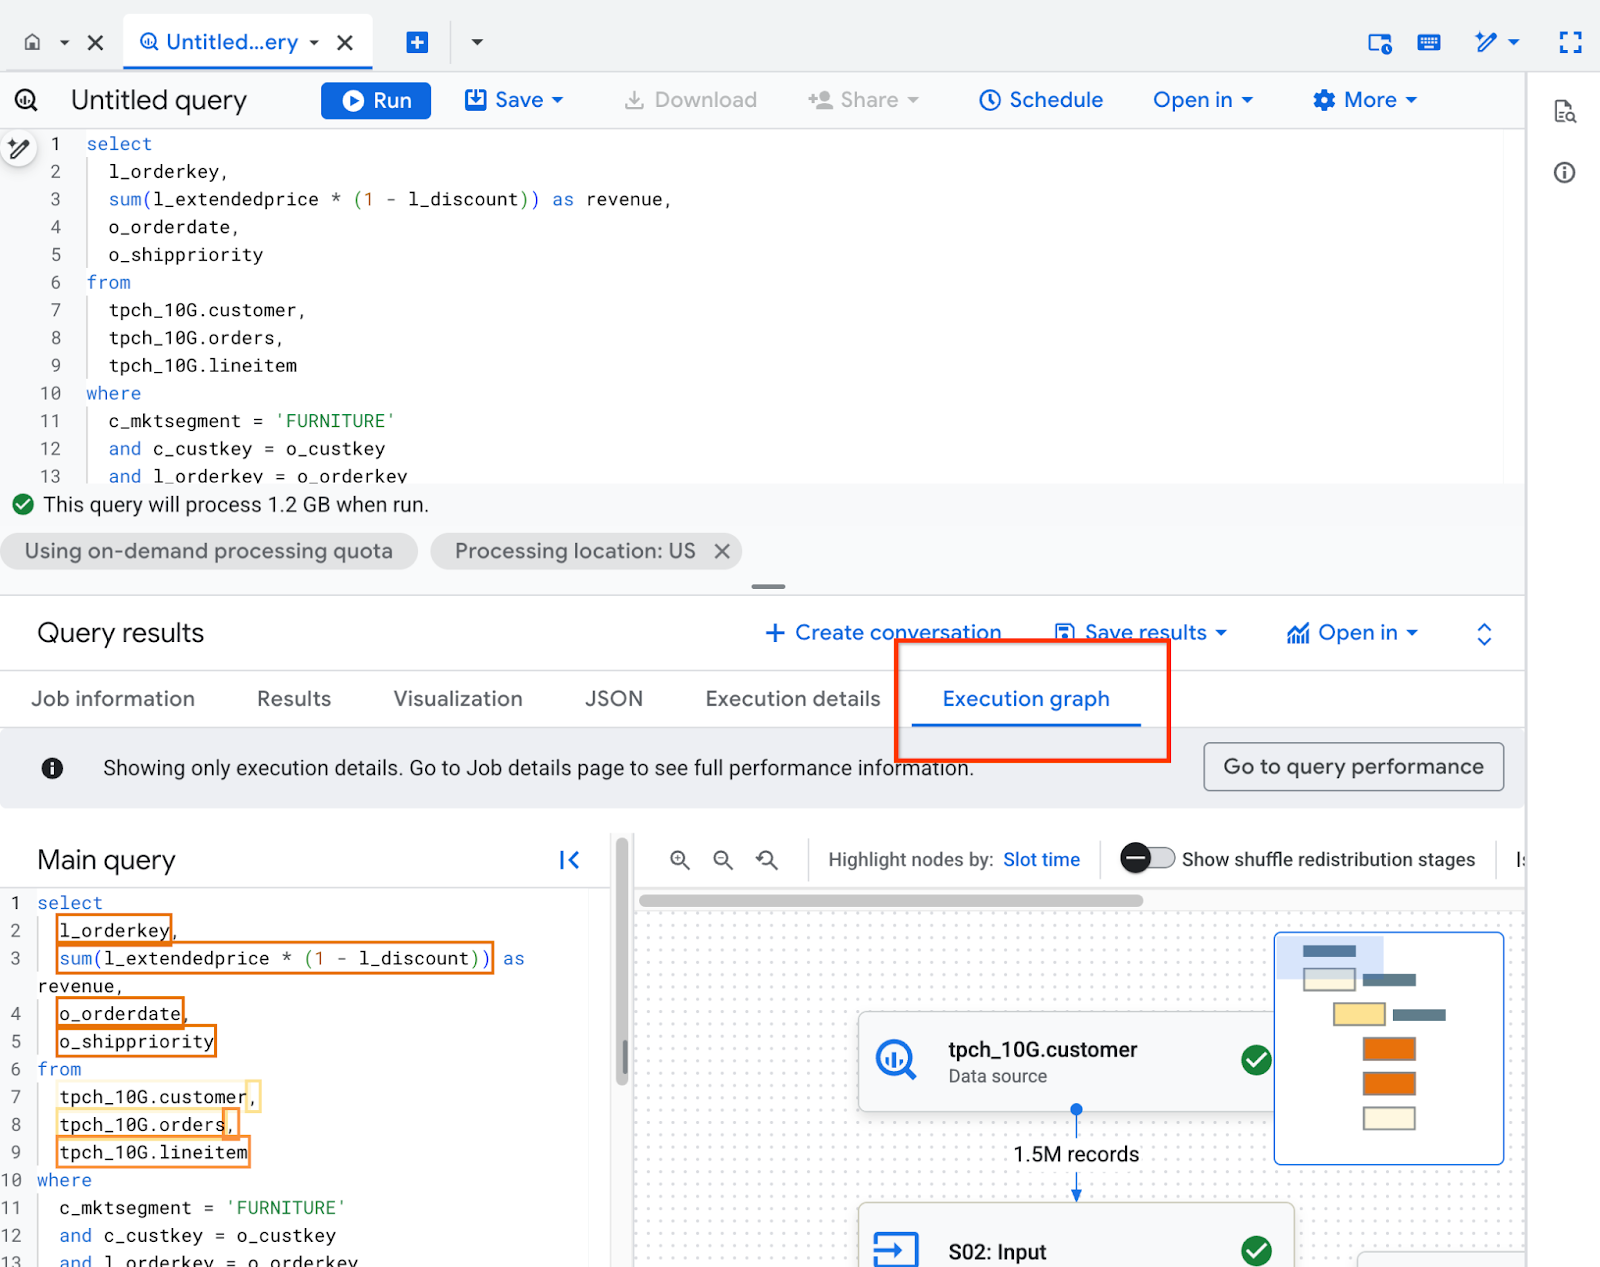
「Execution graph」(執行圖) 面板的結構如下:
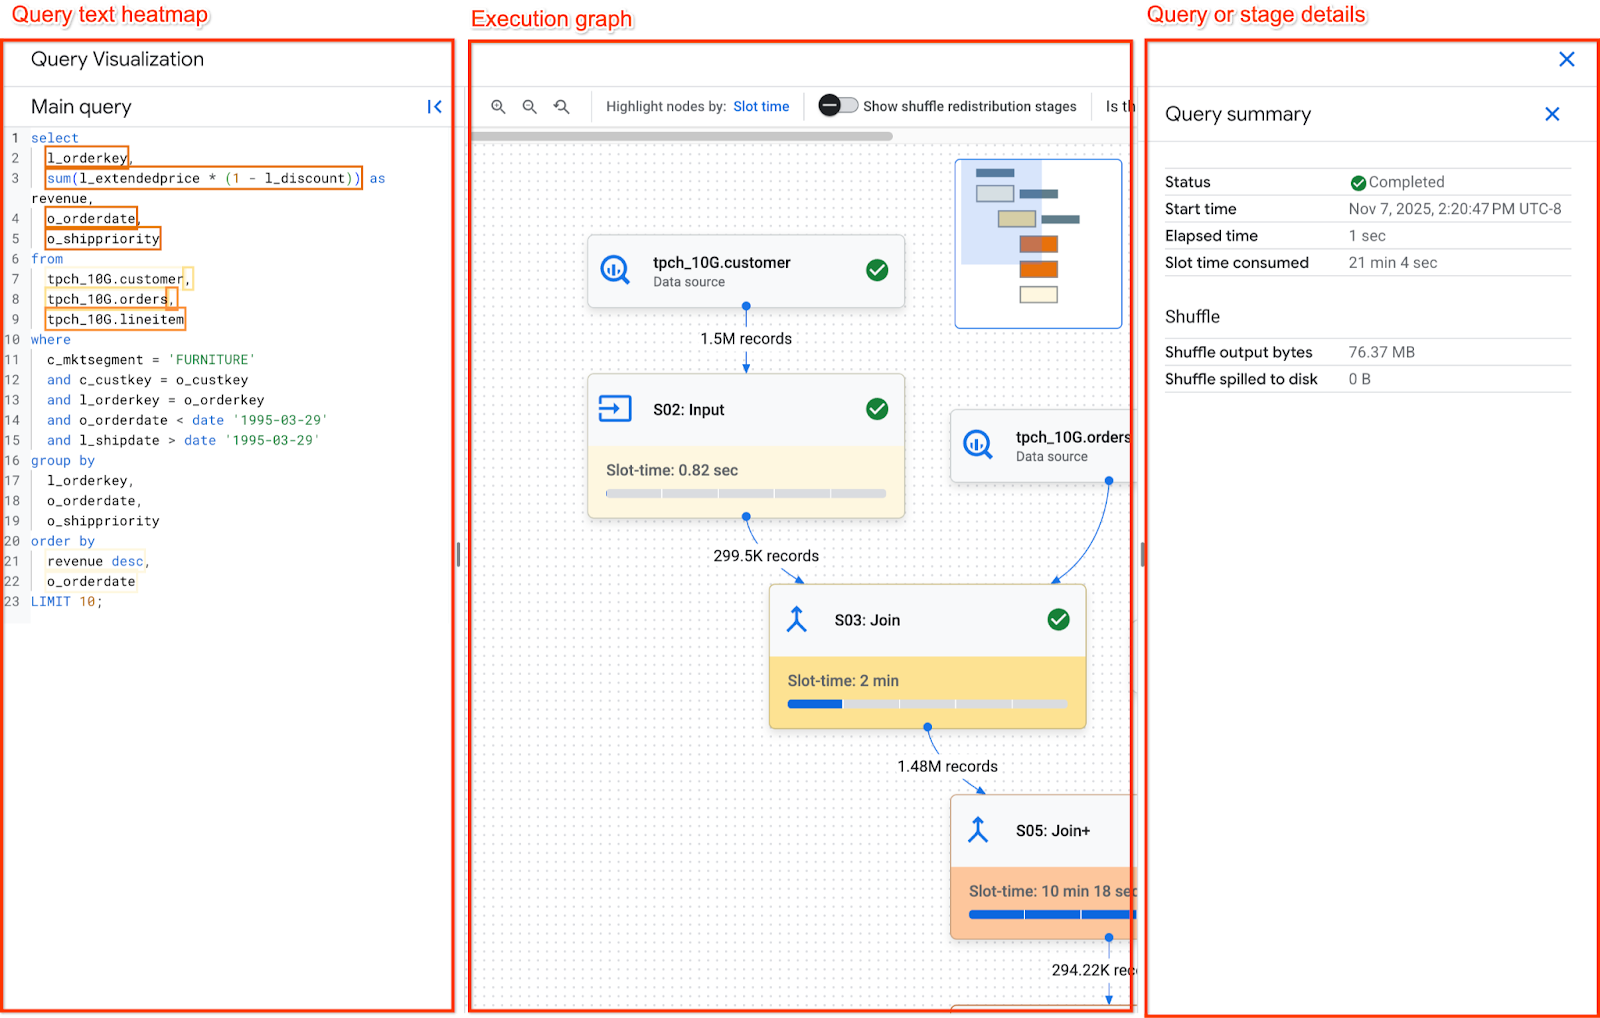
- 中間是執行圖。其中階段會顯示為節點,階段之間交換的重組記憶體則顯示為邊緣。
- 左側面板會顯示查詢文字熱視圖。其中會顯示查詢執行的主要查詢文字,以及任何參照的檢視表。
- 右側面板會顯示查詢或階段詳細資料。
瀏覽執行圖
執行圖會根據運算單元時間,為圖中的節點套用色彩配置,其中深紅色的節點相較於圖中的其他階段,會占用較多運算單元時間。
如要瀏覽執行圖表,您可以:
- 點選並按住圖表背景,即可平移至圖表的不同區域。
- 使用滑鼠滾輪放大及縮小圖表。
- 點選並按住右上方的迷你地圖,即可平移至圖表的不同區域。
點選圖表中的階段,即可查看該階段的詳細資料。階段詳細資料包含:
- 統計資料。如要進一步瞭解統計資料,請參閱「階段總覽」。
- 步驟詳細資料。步驟說明執行查詢邏輯的個別作業。
步驟詳細資料
階段是由步驟組成,也就是執行查詢邏輯的個別作業。步驟包含子步驟,以虛擬程式碼說明步驟執行的操作。子步驟會使用變數來說明步驟之間的關係。變數開頭為錢幣符號,後面接著不重複的數字。變數編號不會在各階段之間共用。
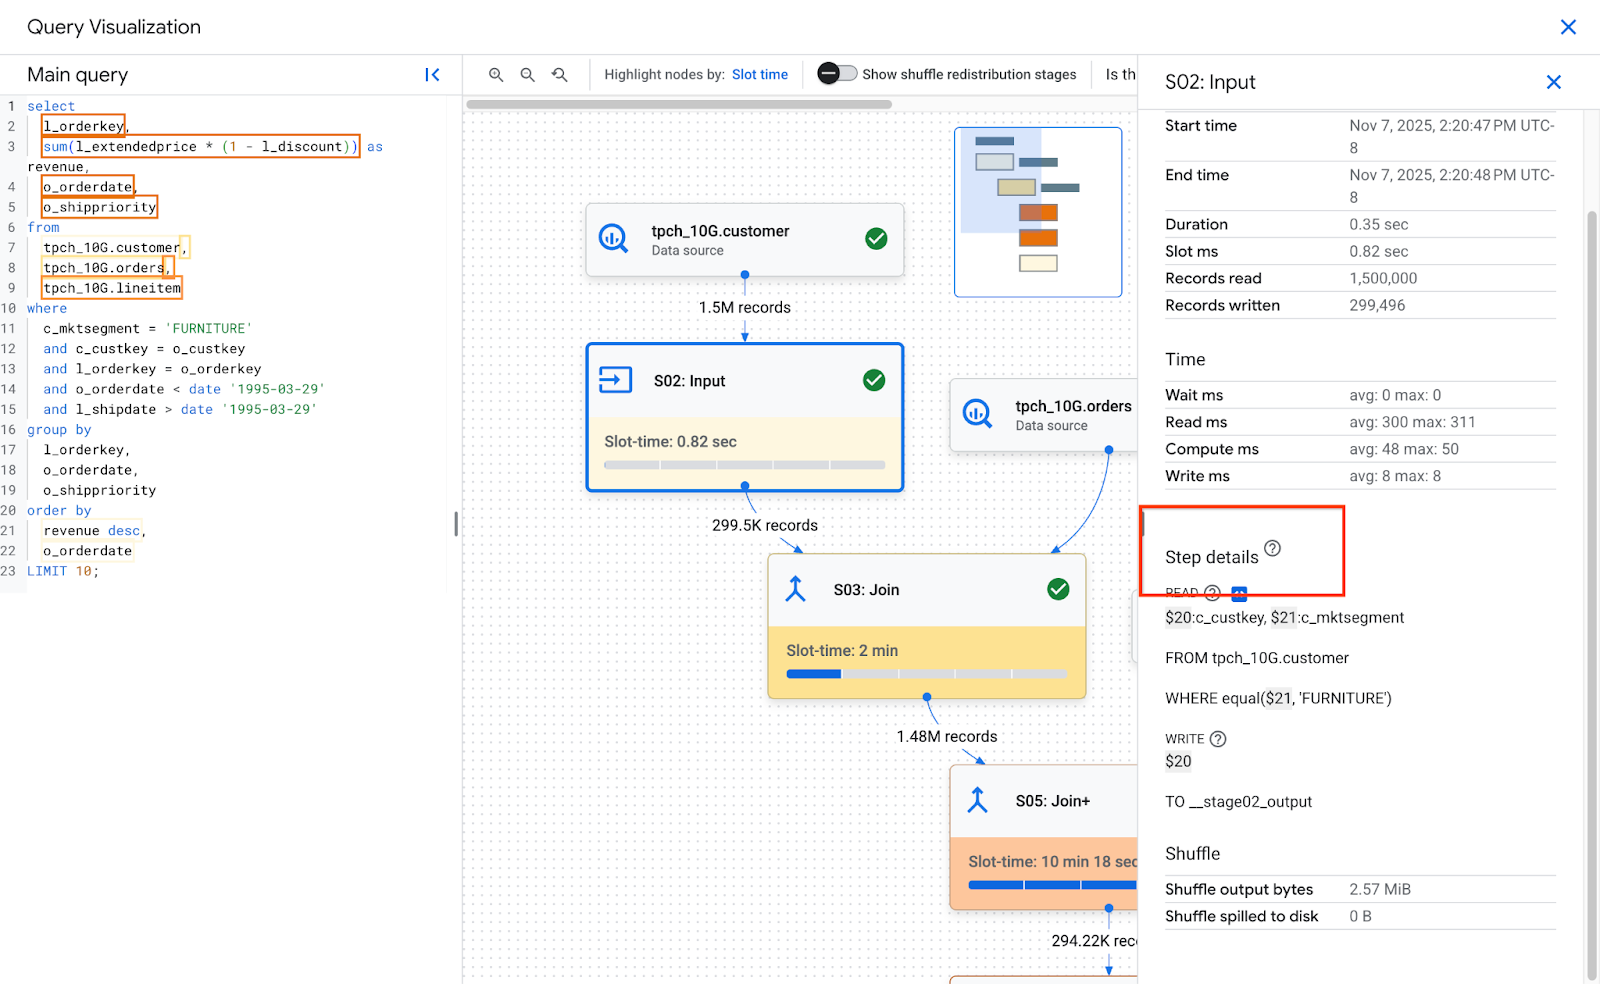
下圖顯示階段的步驟:
以下是階段步驟的範例:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
範例步驟說明如下:
- 這個階段從資料表 lineitem 讀取資料欄 l_orderkey 和 l_quantity,並分別將值儲存在變數 $30 和 $31。
- 這個階段會匯總變數 $30 和 $31,並分別將匯總結果儲存至變數 $100 和 $70。
- 這個階段將變數 $100 和 $70 的結果寫入重組。階段會根據 $100,在重組記憶體中排序結果。
如要進一步瞭解步驟類型和最佳化方式,請參閱「解讀及最佳化步驟」。
如果查詢的執行圖表過於複雜,提供完整的子步驟會導致擷取查詢資訊時發生酬載大小問題,BigQuery 可能會截斷子步驟。
查詢文字熱視圖
BigQuery 可將部分階段步驟對應至查詢文字。查詢文字熱視圖會顯示所有對應的查詢文字和階段步驟。系統會根據步驟對應查詢文字的階段總運算單元時間,醒目顯示查詢文字。
下圖顯示醒目顯示的查詢文字:
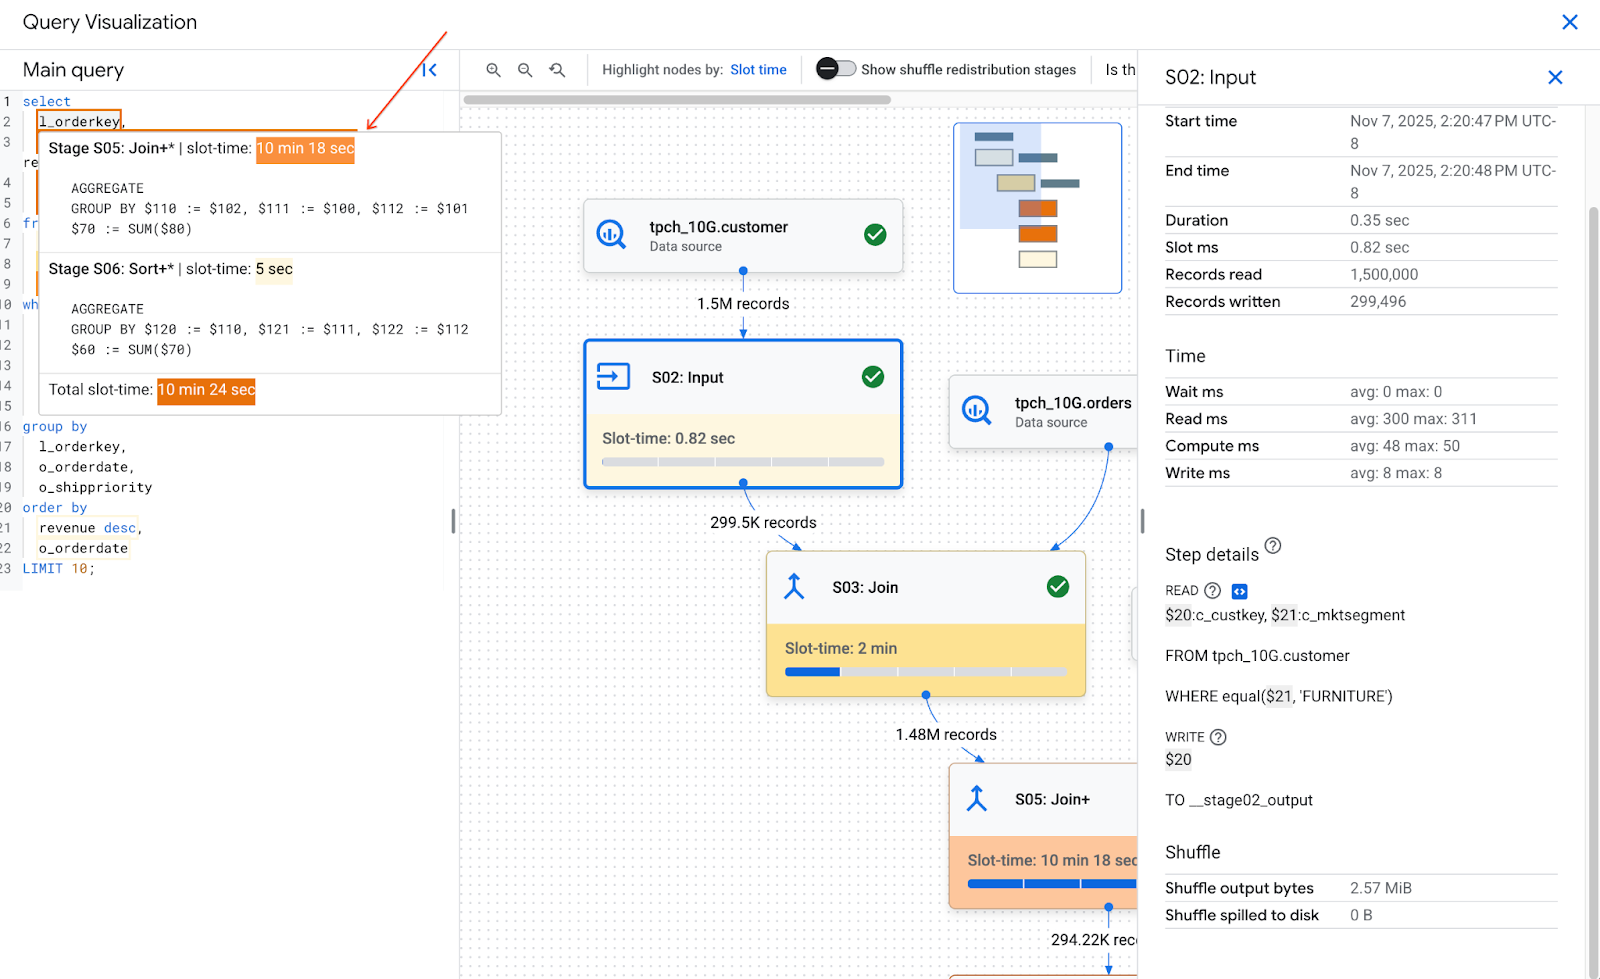
將指標懸停在查詢文字的對應部分,畫面上會顯示工具提示,列出對應至查詢文字的所有階段步驟,以及階段運算單元時間。點選對應的查詢文字,即可選取執行圖中的階段,並在右側面板中開啟階段詳細資料。

單一查詢文字可以對應到多個階段。工具提示會列出每個對應階段及其運算單元時間。點選查詢文字後,系統會醒目顯示對應的階段,並將圖表的其餘部分設為灰色。接著,點選特定階段即可查看詳細資料。
下圖顯示查詢文字與步驟詳細資料的關係:
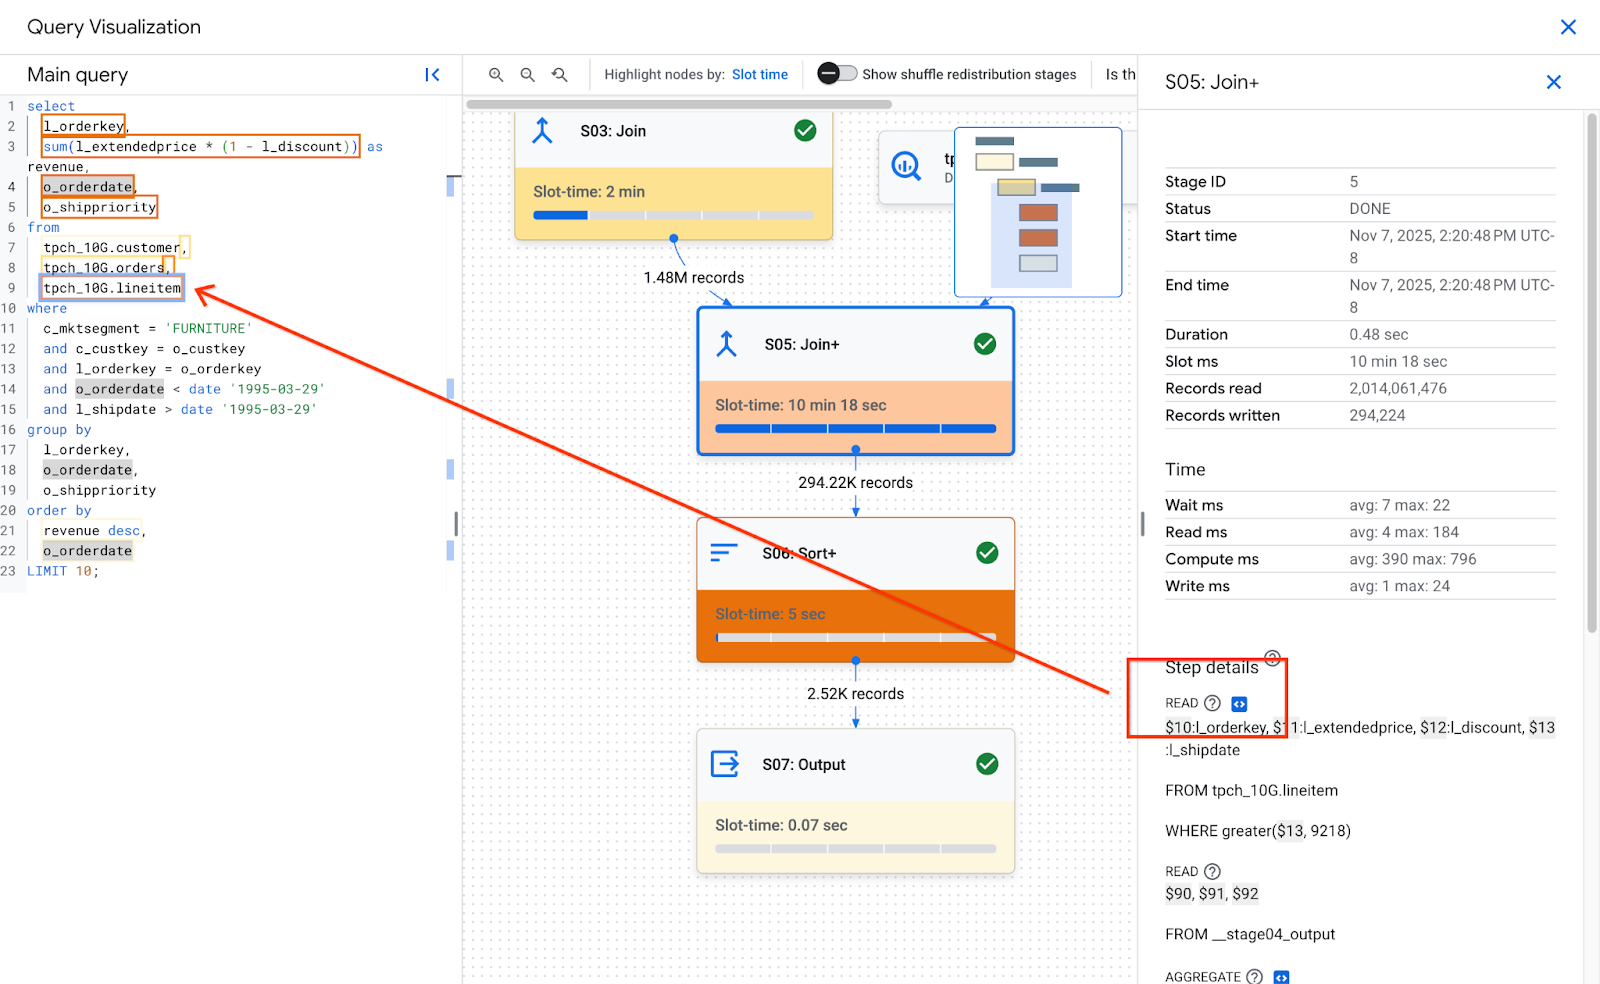
在階段的「Step details」(步驟詳細資料) 部分中,如果步驟對應至查詢文字,該步驟會顯示程式碼圖示。按一下程式碼圖示,左側對應的查詢文字部分就會醒目顯示。
請注意,熱視圖顏色是根據整個階段的運算單元時間而定。由於 BigQuery 不會測量步驟的運算單元時間,因此熱視圖不會呈現對應查詢文字特定部分的實際運算單元時間。在大多數情況下,階段只會執行單一複雜步驟,例如彙整或匯總。因此,熱視圖顏色是合適的。不過,如果階段是由執行多項複雜作業的步驟組成,熱視圖顏色可能會過度呈現熱視圖中的實際運算單元時間。在這種情況下,請務必瞭解構成階段的其他步驟,才能更全面地瞭解查詢效能。
如果查詢使用檢視表,且階段的步驟與檢視表的查詢文字有對應關係,則查詢文字熱視圖會顯示檢視表的名稱和檢視表的查詢文字,以及其對應關係。不過,如果檢視表遭到刪除,或您失去檢視表的 bigquery.tables.get IAM 權限,查詢文字熱視圖就不會顯示檢視表的階段步驟對應關係。
階段總覽
每個階段的總覽欄位可能包含下列項目:
| API 欄位 | 說明 |
|---|---|
id |
階段的專屬數字 ID。 |
name |
階段的簡式摘要名稱。階段中的 steps 會提供執行步驟的其他詳細資料。 |
status |
階段的執行狀態。可能的狀態包括「待處理」、「執行中」、「已完成」、「失敗」及「已取消」。 |
inputStages |
構成階段相依關係圖的 ID 清單。例如,JOIN 階段通常需要兩個相依階段,用來準備 JOIN 關係左右兩側的資料。 |
startMs |
時間戳記 (以 UNIX 時間為單位),顯示階段中第一個工作站開始執行的時間。 |
endMs |
時間戳記 (以 UNIX 時間為單位),顯示最後一個工作站執行完成的時間。 |
steps |
階段中執行步驟的詳細清單。詳情請參閱下一節。 |
recordsRead |
所有階段工作站中階段的輸入大小,以記錄數表示。 |
recordsWritten |
所有階段工作站中階段的輸出大小,以記錄數表示。 |
parallelInputs |
階段中可平行執行的工作單元數。視階段和查詢而定,這可能代表資料表中的資料欄區隔數量,或中繼重組中的分區數量。 |
completedParallelInputs |
階段中已完成的工作單元數。在某些查詢中,不一定要完成階段中的所有輸入後,該階段才能完成。 |
shuffleOutputBytes |
代表某一查詢階段中所有工作站上的寫入位元組總數。 |
shuffleOutputBytesSpilled |
在階段之間傳輸大量資料的查詢,可能需要以磁碟型傳輸為備用方法。溢出位元組統計資料會顯示溢出至磁碟的資料量。取決於最佳化演算法,因此不適用於任何特定查詢。 |
每階段時間分類
查詢階段會提供階段時間分類,包括相對和絕對形式。由於每個執行階段都代表一或多個獨立 worker 執行的工作,因此系統會提供平均時間和最差情況時間。這些時間代表階段中所有 worker 的平均效能,以及特定分類中長尾最慢 worker 的效能。平均和最大時間會進一步細分為絕對和相對表示法。如果是以比率為基礎的統計資料,系統會以任何 worker 在任何區隔中花費的最長時間為基準,提供資料。
Google Cloud 控制台會使用相對時間表示法呈現階段時間。
階段時間資訊的報告如下所示:
| 相對時間 | 絕對時間 | 比率分子 |
|---|---|---|
waitRatioAvg |
waitMsAvg |
一般工作站在等待排程上花費的時間。 |
waitRatioMax |
waitMsMax |
最慢的工作站在等待排程上花費的時間。 |
readRatioAvg |
readMsAvg |
一般工作站在讀取輸入資料上花費的時間。 |
readRatioMax |
readMsMax |
最慢的工作站在讀取輸入資料上花費的時間。 |
computeRatioAvg |
computeMsAvg |
平均工作站受 CPU 限制的時間。 |
computeRatioMax |
computeMsMax |
最慢 worker 耗費的 CPU 繫結時間。 |
writeRatioAvg |
writeMsAvg |
一般工作站在寫入輸出資料上花費的時間。 |
writeRatioMax |
writeMsMax |
最慢的工作站在寫入輸出資料上花費的時間。 |
步驟總覽
步驟包含階段中每個 worker 執行的作業,以已排序的清單呈現。每個步驟作業都有一個類別,部分作業會提供更詳細的資訊。查詢計畫中的作業類別包括:
| 步驟類別 | 說明 |
|---|---|
READ |
從輸入資料表或中繼重組中讀取一或多個資料欄。步驟詳細資料只會傳回前 16 個讀取的資料欄。 |
WRITE |
將一或多個資料欄寫入輸出資料表或中繼重組。若是階段的 HASH 分區輸出,這也包含做為分區索引鍵使用的資料欄。 |
COMPUTE |
運算式評估和 SQL 函式。 |
FILTER |
由 WHERE、OMIT IF 和 HAVING 子句使用。 |
SORT |
ORDER BY 作業,包括資料欄索引鍵和排列順序。 |
AGGREGATE |
為 GROUP BY 或 COUNT 等子句實作匯總。 |
LIMIT |
實作 LIMIT 子句。 |
JOIN |
為 JOIN 等子句實作彙整,包括彙整類型和可能的彙整條件。 |
ANALYTIC_FUNCTION |
叫用視窗函式 (又稱「分析函式」)。 |
USER_DEFINED_FUNCTION |
叫用 user-defined function。 |
UPDATE |
修改 UPDATE 陳述式目標資料表中的現有資料列,包括修改後的資料欄和目標資料表。 |
DELETE |
從目標資料表中移除 DELETE 陳述式的資料列,包括參照的資料欄和目標資料表。 |
MERGE |
修改 MERGE 陳述式目標資料表中的資料列,包括修改過的資料欄和目標資料表。 |
EXPORT |
將輸出資料欄寫入目的地資料表,用於 data manipulation language (DML) 陳述式或查詢結果匯出。 |
解讀及最佳化步驟
以下各節說明如何解讀查詢計畫中的步驟,並提供最佳化查詢的方法。
READ 步
READ 步驟表示階段正在存取資料進行處理。資料可以直接從查詢中參照的資料表讀取,也可以從重組記憶體讀取。讀取前一個階段的資料時,BigQuery 會從重組記憶體讀取資料。使用隨選運算單元時,掃描的資料量會影響費用;使用預留項目時,則會影響效能。
潛在效能問題
- 未分區資料表的大型掃描:如果查詢只需要一小部分資料,這可能表示資料表掃描效率不彰。分區可能是理想的最佳化策略。
- 掃描大型資料表,但篩選比例偏低:這表示篩選器無法有效減少掃描的資料量。建議您修改篩選條件。
- 溢出至磁碟的重組位元組:這表示資料未透過分群等最佳化技術有效儲存,這類技術可將類似資料保留在群集中。
最佳化
- 指定篩選:策略性地使用
WHERE子句,在查詢中盡早篩除不相關的資料。進而減少查詢需要處理的資料量。 - 分區和分群:BigQuery 會使用資料表分區和分群,有效找出特定資料區隔。請務必根據一般查詢模式,對資料表進行分區和分群,盡量減少
READ步驟期間掃描的資料量。 - 選取相關資料欄:避免使用
SELECT *陳述式。請改為選取特定資料欄或使用SELECT * EXCEPT,避免讀取不必要的資料。 - materialized view:materialized view 可預先運算及儲存常用的匯總資料,對於使用這些檢視表的查詢,在
READ步驟中可能就不需要讀取基礎資料表。
COMPUTE 步
在 COMPUTE 步驟中,BigQuery 會對資料執行下列動作:
- 評估查詢
SELECT、WHERE、HAVING和其他子句中的運算式,包括計算、比較和邏輯運算。 - 執行內建 SQL 函式和 user-defined function。
- 根據查詢中的條件篩選資料列。
最佳化
查詢計畫可找出 COMPUTE 步驟中的瓶頸。找出需要大量運算或處理大量資料列的階段。
- 將
COMPUTE步驟與資料量建立關聯:如果某個階段顯示大量運算並處理大量資料,則可能是最佳化作業的理想候選項目。 - 資料偏斜:如果階段的運算最大值明顯高於運算平均值,表示該階段花費了不成比例的時間處理少數資料片段。建議您查看資料分布情形,確認是否有資料偏斜。
- 考量資料類型:為資料欄使用適當的資料類型。舉例來說,使用整數、日期時間和時間戳記,而非字串,可以提升效能。
WRITE 步
中繼資料和最終輸出內容會經過 WRITE 個步驟。
- 寫入重組記憶體:在多階段查詢中,
WRITE步驟通常會將處理過的資料傳送至另一個階段,以便進一步處理。這在重組記憶體中很常見,因為這類記憶體會結合或匯總多個來源的資料。這個階段寫入的資料通常是中繼結果,而非最終輸出內容。 - 最終輸出:查詢結果會寫入目的地或暫存資料表。
雜湊分區
當查詢計畫中的階段將資料寫入雜湊分區輸出時,BigQuery 會寫入輸出中包含的資料欄,以及選擇做為分區索引鍵的資料欄。
最佳化
雖然 WRITE 步驟本身可能無法直接最佳化,但瞭解其角色有助於找出早期階段的潛在瓶頸:
- 盡可能減少寫入的資料:著重於透過篩選和匯總功能最佳化前置階段,減少這個步驟中寫入的資料量。
分區:資料表分區可大幅提升寫入作業的效率。如果寫入的資料僅限於特定分區,BigQuery 就能加快寫入速度。
如果 DML 陳述式含有
WHERE子句,且該子句對資料表分區資料欄有靜態條件,則 BigQuery 只會修改相關的資料表分區。反正規化權衡:反正規化有時會導致中繼
WRITE步驟的結果集較小。不過,這種做法也有缺點,例如儲存空間用量增加,以及資料一致性問題。
JOIN 步
在 JOIN 步驟中,BigQuery 會合併兩個資料來源的資料。彙整作業可包含彙整條件。彙整作業會耗用大量資源。在 BigQuery 中彙整大量資料時,彙整索引鍵會獨立重組,並在同一個運算單元中排列,以便在每個運算單元中本機執行彙整。
JOIN 步驟的查詢計畫通常會顯示下列詳細資料:
- 彙整模式:表示使用的彙整類型。每種類型都會定義結果集中包含彙整資料表的資料列數量。
- 彙整資料欄:這些資料欄用於比對資料來源之間的資料列。選擇資料欄對彙整效能至關重要。
彙整模式
- 廣播 join:如果其中一個資料表 (通常是較小的資料表) 可以放入單一 worker 節點或運算單元的記憶體,BigQuery 就能將該資料表廣播至所有其他節點,有效率地執行 join 作業。在步驟詳細資料中尋找
JOIN EACH WITH ALL。 - 雜湊彙整:如果資料表很大或不適合廣播彙整,則可能使用雜湊彙整。BigQuery 會使用雜湊和重組作業,重組左側和右側資料表,讓相符的索引鍵最終位於同一個運算單元,以便執行本機彙整。雜湊彙整需要移動資料,因此是高成本作業,但可有效比對雜湊中的資料列。在步驟詳細資料中尋找
JOIN EACH WITH EACH。 - self-join:一種 SQL 反模式,會將資料表與自身彙整。
- Cross join:一種 SQL 反模式,會產生比輸入資料更大的輸出資料,因此可能導致嚴重的效能問題。
- 偏斜 join:資料表中 join 鍵的資料分布非常偏斜,可能導致效能問題。找出查詢計畫中,最長運算時間遠大於平均運算時間的情況。詳情請參閱「高基數彙整」和「分區偏斜」。
偵錯
- 資料量龐大:如果查詢計畫顯示
JOIN步驟處理的資料量很大,請調查彙整條件和彙整鍵。建議您篩選或使用更精確的彙整鍵。 - 資料分布不均:分析 join 鍵的資料分布情形。如果某個資料表嚴重偏斜,請嘗試分割查詢或預先篩選等策略。
- 高基數彙整:彙整產生的資料列數量遠多於左側和右側輸入資料列數量,可能會大幅降低查詢效能。避免會產生大量資料列的彙整作業。
- 資料表排序不正確:請務必選擇適當的彙整類型 (例如
INNER或LEFT),並根據查詢需求,由大到小排序資料表。
最佳化
- 選擇性 join 鍵:盡可能使用
INT64做為 join 鍵,而非STRING。STRING比較作業會比較字串中的每個字元,因此比INT64比較作業慢。整數只需要一次比較。 - 在彙整前篩選:在彙整前,對個別資料表套用
WHERE子句篩選器。這可減少彙整作業涉及的資料量。 - 避免在彙整欄上使用函式:避免在彙整欄上呼叫函式。請改用 ELT SQL 管道,在擷取或擷取後程序中標準化資料表資料。這種做法不需要動態修改彙整資料欄,因此能更有效率地彙整資料,同時確保資料完整性。
- 避免 self-join:self-join 常用於計算資料列相關關係。不過,self-join 可能會使輸出資料列數量增加四倍,導致效能問題。建議您使用視窗 (分析) 函式,而非依賴 self-join。
- 大型資料表優先:雖然 SQL 查詢最佳化工具可以判斷資料表應位於 join 的哪一側,但請適當排序 join 資料表。最佳做法是先放置最大的資料表,接著是最小的資料表,然後依大小遞減。
- 去正規化:在某些情況下,策略性地將資料表去正規化 (新增多餘資料),可完全消除 JOIN。不過,這種做法在儲存空間和資料一致性方面需要做出取捨。
- 分區和分群:根據 join 鍵對資料表進行分區,並將共置資料分群,可讓 BigQuery 指定相關資料分區,大幅加快 join 速度。
- 最佳化偏斜彙整:為避免偏斜彙整相關的效能問題,請盡早預先篩選資料表中的資料,或將查詢拆分為兩個以上的查詢。
AGGREGATE 步
在 AGGREGATE 步驟中,BigQuery 會彙整及分組資料。
偵錯
- 階段詳細資料:查看匯總作業的輸入和輸出資料列數量,以及重組大小,判斷匯總步驟減少了多少資料,以及是否涉及資料重組。
- 重組大小:如果重組大小很大,可能表示在匯總期間,有大量資料在 worker 節點之間移動。
- 檢查資料分布:確保資料平均分布在各分區。資料分布不均可能導致匯總步驟中的工作負載不平衡。
- 評論集結網站:分析匯總子句,確認是否必要且有效率。
最佳化
- 分群:根據
GROUP BY、COUNT或其他匯總子句中常用的資料欄,對資料表進行分群。 - 分區:選擇符合查詢模式的分區策略。建議使用擷取時間分區資料表,減少匯總期間掃描的資料量。
- 提早匯總:如果可以,請在查詢管道中提早執行匯總。這可減少匯總期間需要處理的資料量。
- 重組最佳化:如果重組是瓶頸,請設法盡量減少重組。例如,反正規化資料表或使用分群法,將相關資料歸入同一個位置。
極端案例
- DISTINCT 匯總:使用
DISTINCT匯總的查詢可能需要大量運算資源,尤其是大型資料集。如需近似結果,請考慮使用APPROX_COUNT_DISTINCT等替代方案。 - 大量群組:如果查詢產生大量群組,可能會耗用大量記憶體。在這種情況下,請考慮限制群組數量,或使用其他匯總策略。
REPARTITION 步
REPARTITION 和 COALESCE 都是 BigQuery 直接套用至查詢中重組資料的最佳化技術。
REPARTITION:這項作業旨在重新平衡 worker 節點之間的資料分布。假設重組後,某個 worker 節點最終獲得的資料量過大,REPARTITION步驟會更平均地重新分配資料,避免任何單一 worker 成為瓶頸。這對於運算密集型作業 (例如 join) 尤其重要。COALESCE:如果重組後有許多小型資料 bucket,就會執行這個步驟。COALESCE步驟會將這些值區合併成較大的值區,減少管理大量小型資料片段的負擔。處理非常小的中繼結果集時,這種做法特別有幫助。
如果查詢計畫中出現 REPARTITION 或 COALESCE 步驟,不一定代表查詢有問題。這通常表示 BigQuery 正在主動最佳化資料分布,以提升效能。不過,如果重複看到這些作業,可能表示資料本身有偏誤,或查詢導致過多資料重組。
最佳化
如要減少 REPARTITION 步驟數量,請嘗試下列做法:
- 資料分布:確保資料表已有效分區和分群。資料分布良好,可降低重組後出現嚴重不平衡的可能性。
- 查詢結構:分析查詢,找出可能導致資料偏斜的來源。例如,是否有高度選擇性的篩選器或彙整,導致單一 worker 處理一小部分資料?
- 彙整策略:嘗試不同的彙整策略,看看是否能讓資料分布更均衡。
如要減少 COALESCE 步驟數量,請嘗試下列做法:
- 匯總策略:考慮在查詢管道中提早執行匯總。這有助於減少可能導致
COALESCE步驟的小型中繼結果集數量。 - 資料量:如果處理的資料集非常小,
COALESCE可能不是主要考量。
不要過度最佳化。過早最佳化可能會使查詢更複雜,卻無法帶來顯著效益。
UPDATE、DELETE和MERGE個步驟
UPDATE、DELETE 和 MERGE 步驟會出現在對目標資料表執行 data manipulation language (DML) 陳述式的階段。
步驟詳細資料通常包含下列子步驟:
- 資料欄:從目標資料表讀取或寫入目標資料表的資料欄。
- 目標資料表 (
FROM或INTO):由陳述式修改的目標資料表,其中UPDATE和DELETE步驟使用FROM,MERGE步驟使用INTO。
EXPORT 步
EXPORT 步驟會將輸出資料寫入目的地資料表。這個步驟通常會出現在 DML 陳述式的最後階段 (例如 INSERT、UPDATE、DELETE 和 MERGE 陳述式),以及將結果具體化至目的地資料表的查詢中。
步驟詳細資料通常包含下列子步驟:
- 輸出欄:寫入目的地資料表的變數清單。
- 目的地資料表 (
TO):接收匯出資料列的目的地資料表。
聯合查詢說明
聯合查詢可讓您使用 EXTERNAL_QUERY 函式,將查詢陳述式傳送至外部資料來源。聯合查詢會採用稱為 SQL 下推的最佳化技術,查詢計畫會顯示下推至外部資料來源的作業 (如有)。舉例來說,如果您執行下列查詢:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
查詢計畫會顯示下列階段步驟:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
在這個計畫中,table_for_external_query_$_0(...) 代表 EXTERNAL_QUERY 函式。括號內是外部資料來源執行的查詢。根據上述步驟,我們可以得知:
- 外部資料來源只會傳回 3 個所選資料欄。
- 外部資料來源只會傳回
country_code為'ee'或'hu'的資料列。 LIKE運算子不會下推,而是由 BigQuery 評估。
相較之下,如果沒有下推,查詢計畫會顯示下列階段步驟:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
這次,外部資料來源會傳回 company 資料表中的所有資料欄和資料列,並由 BigQuery 執行篩選。
時程中繼資料
查詢時間軸會回報特定時間點的進度,提供整體查詢進度的數據匯報。時間軸會以一系列樣本呈現,並回報下列詳細資料:
| 欄位 | 說明 |
|---|---|
elapsedMs |
查詢開始執行後經歷的毫秒數。 |
totalSlotMs |
查詢使用的運算單元毫秒數累計表示法。 |
pendingUnits |
已排定和等待執行的工作單元總數。 |
activeUnits |
worker 正在處理的有效工作單元總數。 |
completedUnits |
執行這項查詢時已完成的工作單元總數。 |
查詢範例
下列查詢會計算莎士比亞公開資料集中的資料列數量,並加入第二個條件式計數,將結果限制為參照「hamlet」的資料列:
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
按一下「執行作業詳細資料」,查看查詢計畫:

顏色指標會顯示所有階段中各步驟的相對時間。
如要進一步瞭解執行階段的步驟,請按一下 展開階段詳細資料:
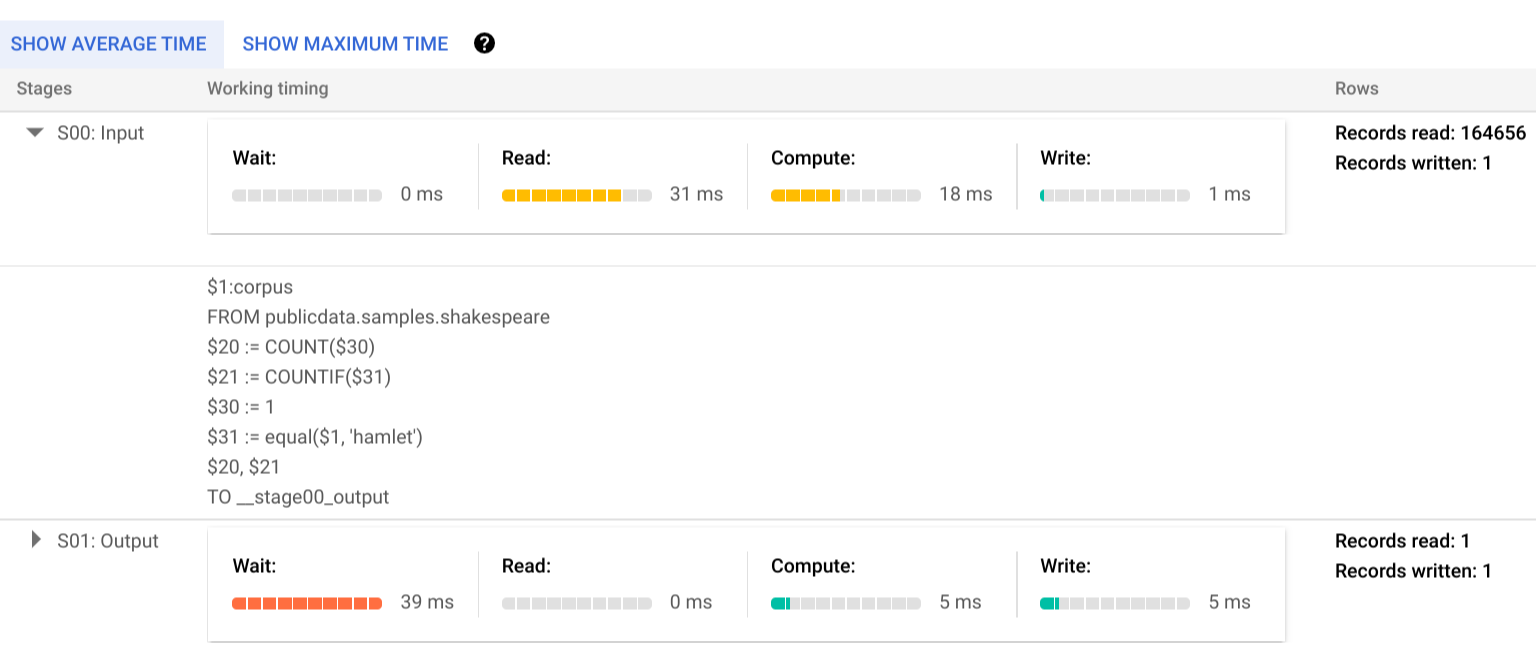
在本例中,任何區隔中最長的時間,是階段 01 中單一 worker 等待階段 00 完成的時間。這是因為階段 01 依賴階段 00 的輸入,必須等到第一階段將輸出寫入中繼重組後才能開始。
Error Reporting
查詢工作可能會在執行中失敗。由於計畫資訊會定期更新,因此您可以觀察執行圖中發生失敗的位置。在 Google Cloud 控制台中,成功或失敗的階段會在階段名稱旁標示勾號或驚嘆號。
如要進一步瞭解如何解讀及解決錯誤,請參閱疑難排解指南。
API 表示法範例
查詢計畫資訊會嵌入工作回應資訊中,您可以呼叫 jobs.get 來擷取。舉例來說,下列 JSON 回應摘錄顯示了傳回範例 hamlet 查詢的工作,其中包含查詢計畫和時間軸資訊。
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
使用執行資訊
BigQuery 查詢計畫會提供服務如何執行查詢的相關資訊,但由於服務屬於代管性質,因此某些詳細資料可能無法直接執行。使用這項服務時,許多最佳化作業會自動執行,這與其他環境不同,在其他環境中,調整、佈建和監控可能需要專門、知識豐富的人員。
如需可改善查詢執行和效能的特定技術,請參閱最佳做法說明文件。查詢計畫和時間軸統計資料可協助您瞭解特定階段是否占據大部分資源。舉例來說,如果 JOIN 階段產生的輸出資料列遠多於輸入資料列,可能表示您可以在查詢中提早篩選。
此外,時間軸資訊也有助於判斷特定查詢速度緩慢的原因,究竟是查詢本身的問題,還是其他查詢爭用相同資源所致。如果您發現,在查詢的整個生命週期中,運作中的單位數量仍有限,但排入佇列的工作單位數量仍很高,這可能代表減少並行查詢數量,可大幅改善特定查詢的整體執行時間。