


Tersemat dalam tugas kueri, BigQuery menyertakan informasi rencana kueri dan waktu diagnostik. Hal ini mirip dengan informasi yang diberikan oleh pernyataan seperti EXPLAIN dalam sistem analisis dan database lain. Informasi ini dapat diambil dari respons API metode seperti jobs.get.
Untuk kueri yang berjalan lama, BigQuery akan memperbarui statistik ini secara berkala. Update ini terjadi secara mandiri pada tingkat polling status tugas, tetapi biasanya tidak akan terjadi lebih sering dari setiap 30 detik. Selain itu, tugas kueri yang tidak menggunakan resource eksekusi, seperti permintaan uji coba atau hasil yang dapat disajikan dari hasil yang di-cache, tidak akan menyertakan informasi diagnostik tambahan, meskipun mungkin ada statistik lain.
Latar belakang
Saat menjalankan kueri, BigQuery mengonversi SQL menjadi grafik eksekusi yang terdiri dari tahapan. Tahapan terdiri dari langkah, operasi elemen yang menjalankan logika kueri. BigQuery memanfaatkan arsitektur paralel yang sangat terdistribusi yang menjalankan tahapan secara paralel untuk mengurangi latensi. Tahapan berkomunikasi satu sama lain menggunakan shuffle, arsitektur memori terdistribusi yang cepat.
Rencana kueri menggunakan istilah unit tugas dan worker untuk mendeskripsikan paralelisme
tahap. Di bagian lain dalam BigQuery, Anda mungkin menemukan istilah slot, yaitu representasi abstrak dari beberapa faset eksekusi kueri, termasuk komputasi, memori, dan resource I/O. Slot menjalankan setiap unit tugas dari suatu tahap secara paralel. Statistik tugas tingkat teratas memberikan biaya kueri tertentu menggunakan totalSlotMs berdasarkan penghitungan terpisah ini.
Properti penting lainnya dari eksekusi kueri adalah BigQuery dapat mengubah rencana kueri saat kueri sedang berjalan. Misalnya, BigQuery memperkenalkan tahap partisi ulang untuk meningkatkan distribusi data di antara pekerja kueri, yang meningkatkan paralelisme dan mengurangi latensi kueri.
Selain rencana kueri, tugas kueri juga mengekspos linimasa eksekusi, yang menyediakan pencatatan unit tugas yang telah selesai, tertunda, dan aktif. Kueri dapat memiliki beberapa stage dengan worker aktif secara bersamaan, dan linimasa dimaksudkan untuk menampilkan progres kueri secara keseluruhan.
Melihat grafik eksekusi dengan konsol Google Cloud
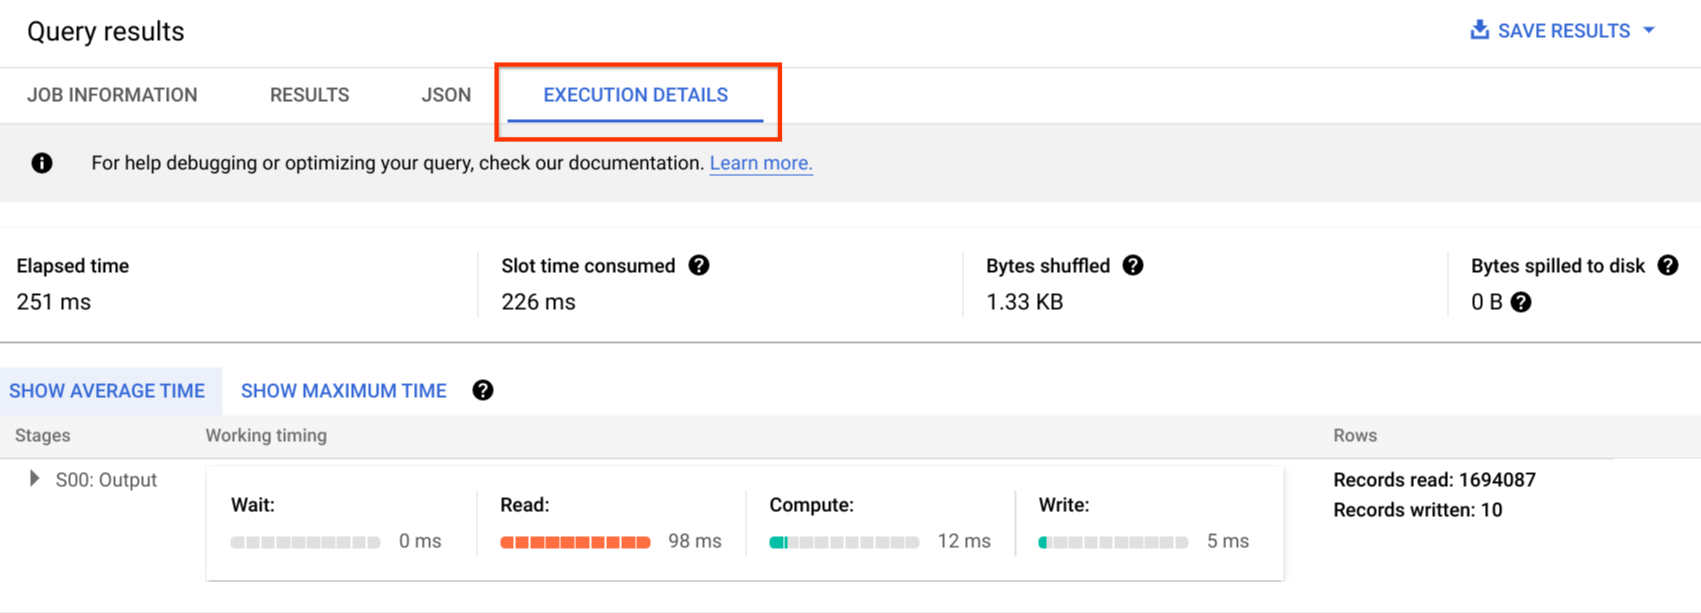
Di konsolGoogle Cloud , Anda dapat melihat detail rencana kueri untuk kueri yang telah selesai dengan mengklik tombol Execution Details.
Informasi rencana kueri
Dalam respons API, rencana kueri direpresentasikan sebagai daftar stage kueri. Setiap item dalam daftar menunjukkan statistik ringkasan per stage, informasi langkah yang mendetail, dan klasifikasi pengaturan waktu stage. Tidak semua detail dirender dalam konsol Google Cloud , tetapi semuanya dapat tersedia dalam respons API.
Memahami grafik eksekusi
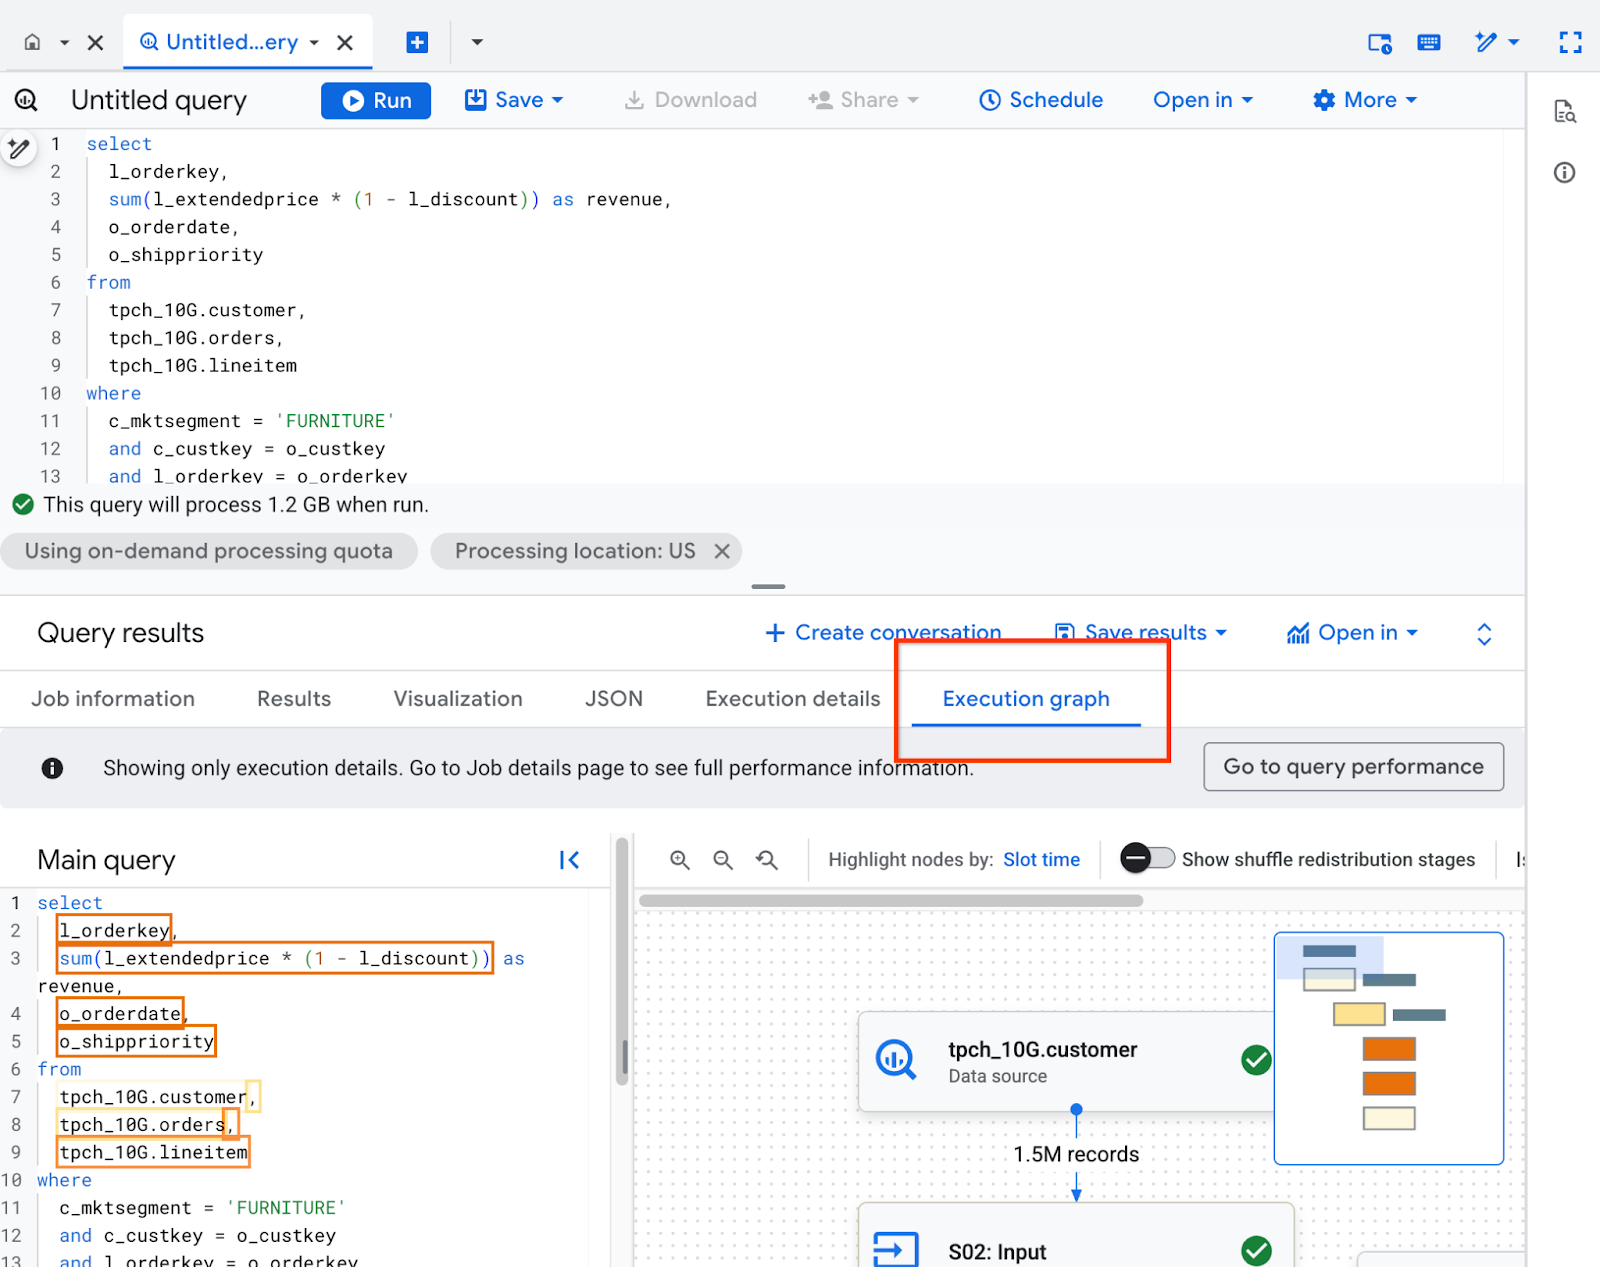
Di konsol Google Cloud , Anda dapat melihat detail rencana kueri dengan mengklik tab Execution graph.
Panel Execution graph diatur sebagai berikut:
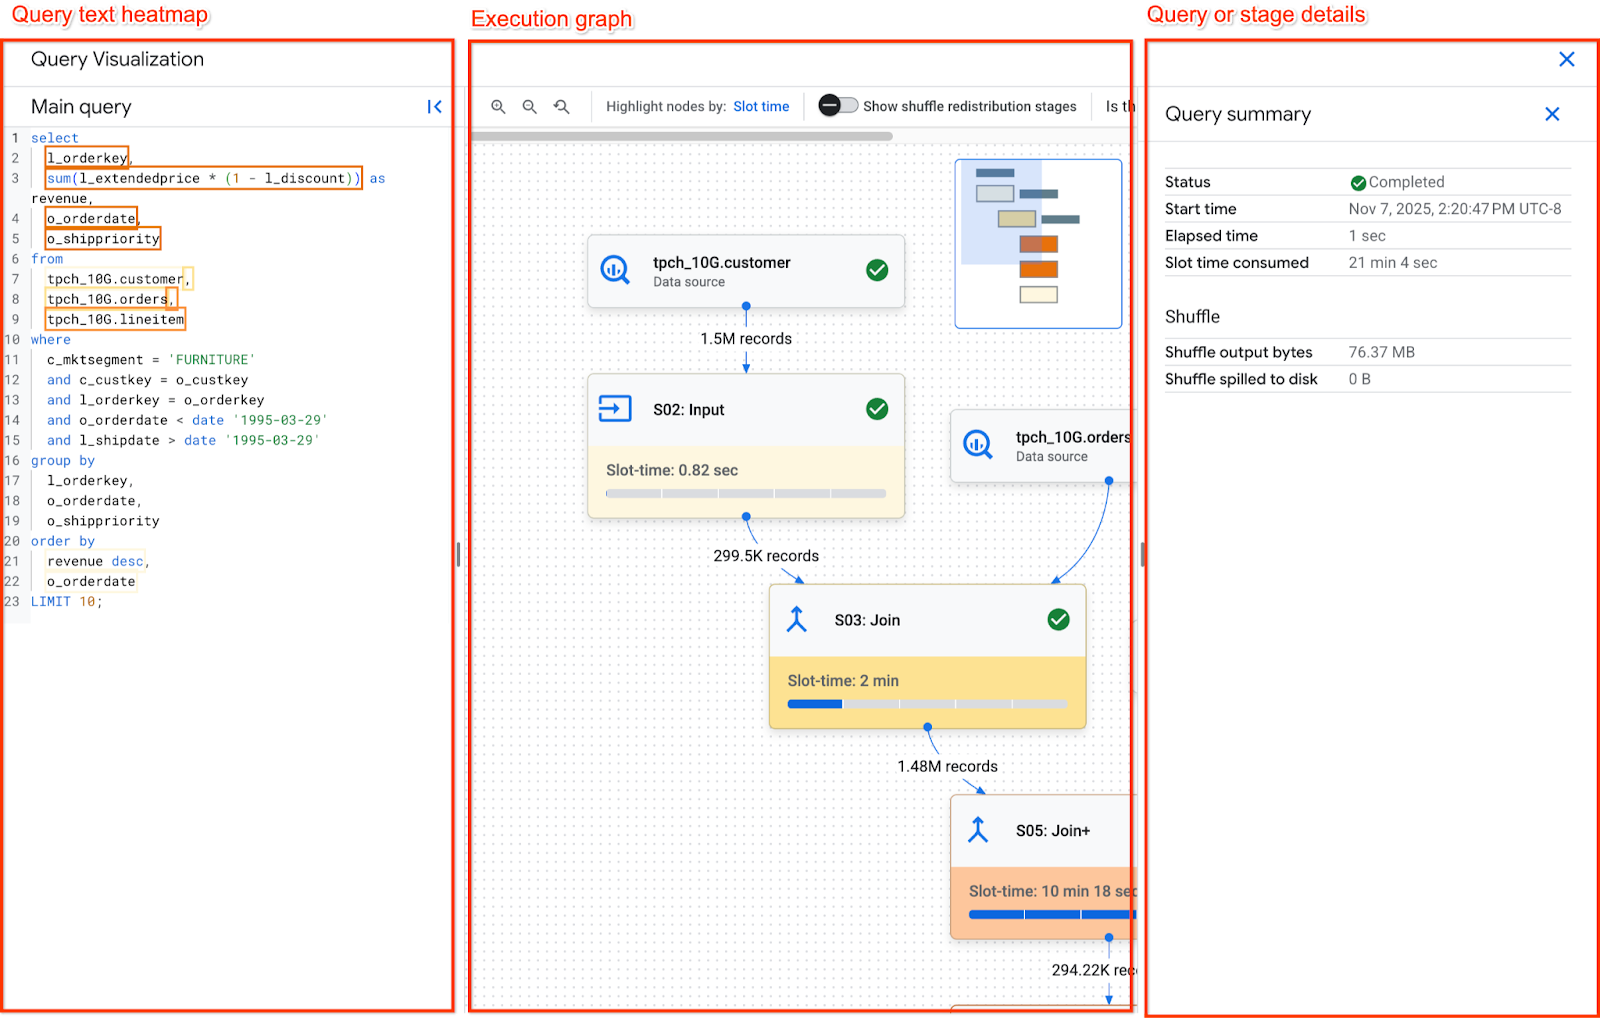
- Di bagian tengah adalah grafik eksekusi. Grafik ini menampilkan tahap sebagai node dan memori shuffle yang dipertukarkan antar-tahap sebagai edge.
- Panel kiri memiliki heatmap teks kueri. Teks ini menampilkan teks kueri utama yang dijalankan kueri beserta tampilan yang direferensikan.
- Panel kanan berisi detail kueri atau tahap.
Menjelajahi grafik eksekusi
Grafik eksekusi menerapkan skema warna ke node dalam grafik berdasarkan waktu slot, dengan node yang berwarna merah lebih gelap memerlukan lebih banyak waktu slot dibandingkan dengan tahapan lainnya dalam grafik.
Untuk menjelajahi grafik eksekusi, Anda dapat:
- Klik lama pada latar belakang grafik untuk menggeser ke berbagai area grafik.
- Gunakan roda scroll mouse untuk memperbesar dan memperkecil grafik.
- Klik lama minimap di kanan atas untuk menggeser ke berbagai area grafik.
Mengklik tahap dalam grafik akan menampilkan detail tahap yang dipilih. Detail tahap memiliki:
- Statistik. Lihat Ringkasan tahap untuk mengetahui detail tentang statistik.
- Detail langkah. Langkah-langkah menjelaskan setiap operasi yang menjalankan logika kueri.
Detail langkah
Tahapan terdiri dari langkah-langkah, yaitu operasi individual yang menjalankan logika kueri. Langkah-langkah memiliki sublangkah yang menjelaskan apa yang dilakukan langkah tersebut dalam pseudocode. Sublangkah menggunakan variabel untuk menjelaskan hubungan antar-langkah. Variabel dimulai dengan tanda dolar yang diikuti dengan angka unik. Nomor variabel tidak dibagikan di seluruh tahap.
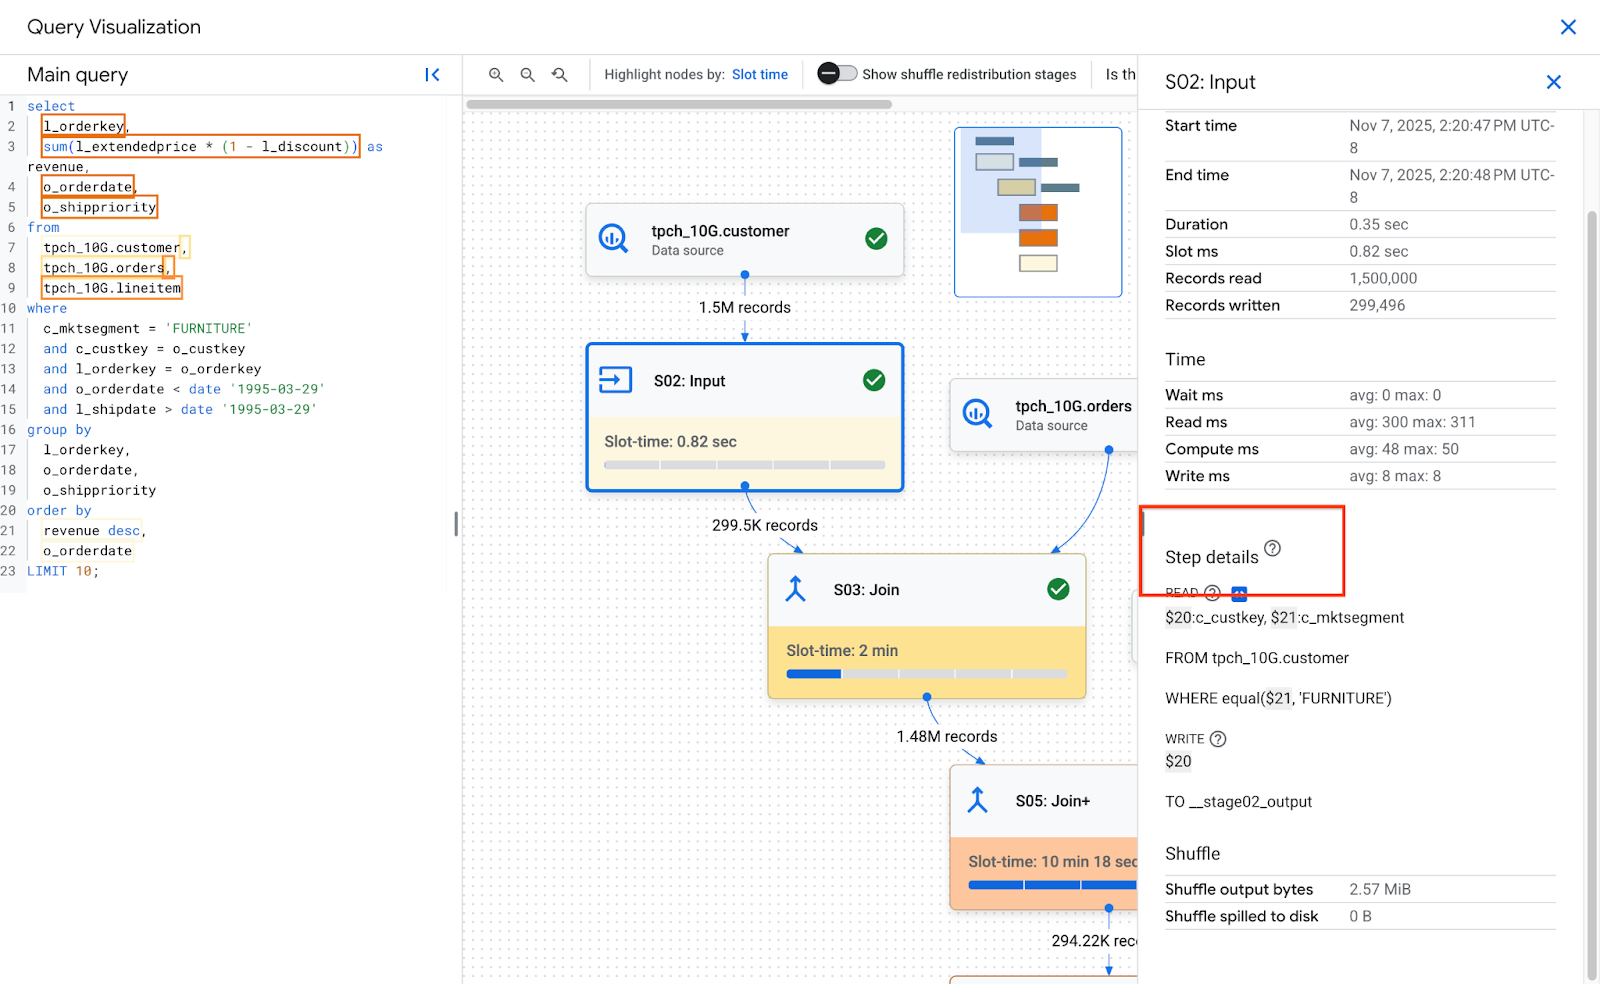
Gambar berikut menunjukkan langkah-langkah tahapan:
Berikut adalah contoh langkah-langkah dalam suatu tahap:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
Langkah-langkah contoh ini menjelaskan hal berikut:
- Tahap ini membaca kolom l_orderkey dan l_quantity dari tabel lineitem dan menyimpan nilainya dalam variabel $30 dan $31.
- Tahap ini menggabungkan variabel $30 dan $31, menyimpan agregasi ke dalam variabel $100 dan $70.
- Tahap ini menulis hasil variabel $100 dan $70 ke shuffle. Tahap mengurutkan hasil dalam memori shuffle berdasarkan $100.
Lihat Menafsirkan dan mengoptimalkan langkah untuk mengetahui detail lengkap tentang jenis langkah dan cara mengoptimalkannya.
BigQuery dapat memangkas sublangkah jika grafik eksekusi kueri cukup kompleks sehingga memberikan sublangkah lengkap akan menyebabkan masalah ukuran payload saat mengambil informasi kueri.
Peta panas teks kueri
BigQuery dapat memetakan beberapa langkah tahap ke bagian teks kueri. Peta panas teks kueri menampilkan semua teks kueri yang sesuai dengan langkah-langkah tahap. Tabel ini menandai teks kueri berdasarkan total waktu slot dari tahap yang langkahnya telah memetakan teks kueri.
Gambar berikut menampilkan teks kueri yang ditandai:
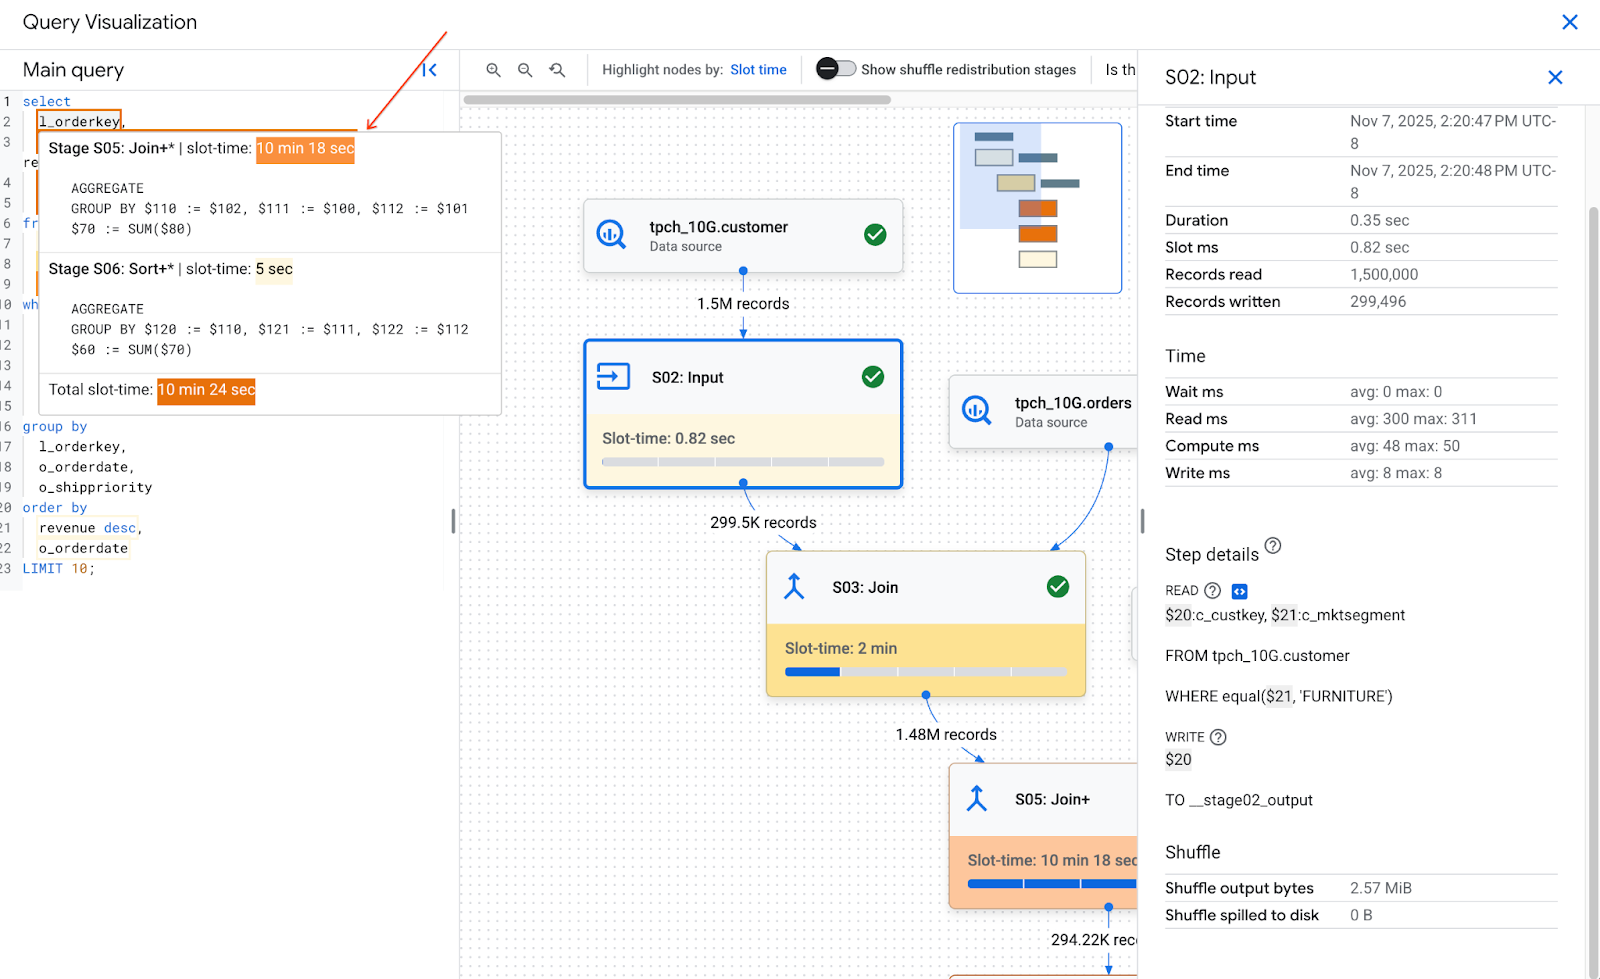
Menahan kursor di atas bagian teks kueri yang dipetakan akan menampilkan tooltip yang mencantumkan semua langkah stage yang dipetakan ke teks kueri beserta waktu slot stage. Mengklik teks kueri yang dipetakan akan memilih tahap dalam grafik eksekusi dan membuka detail tahap di panel kanan.
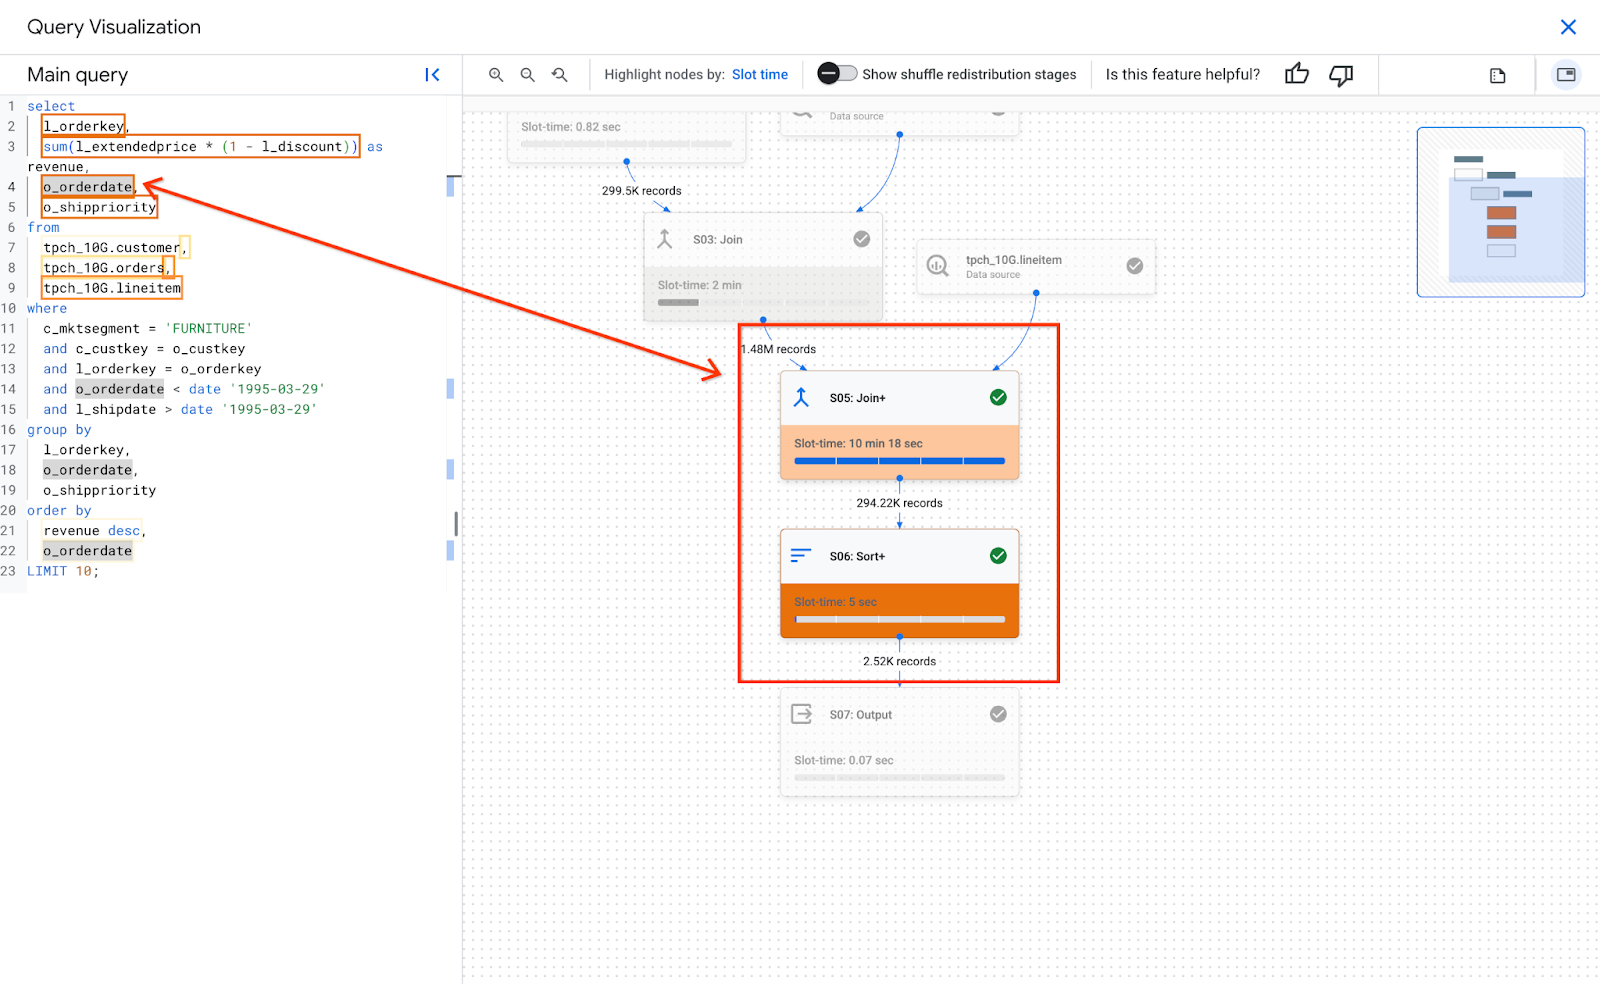
Satu bagian teks kueri dapat dipetakan ke beberapa tahap. Tooltip mencantumkan setiap tahap yang dipetakan dan waktu slotnya. Mengklik teks kueri akan menandai tahapan yang sesuai dan membuat bagian grafik lainnya menjadi berwarna abu-abu. Selanjutnya, mengklik tahap tertentu akan menampilkan detailnya.
Gambar berikut menunjukkan hubungan teks kueri dengan detail langkah:
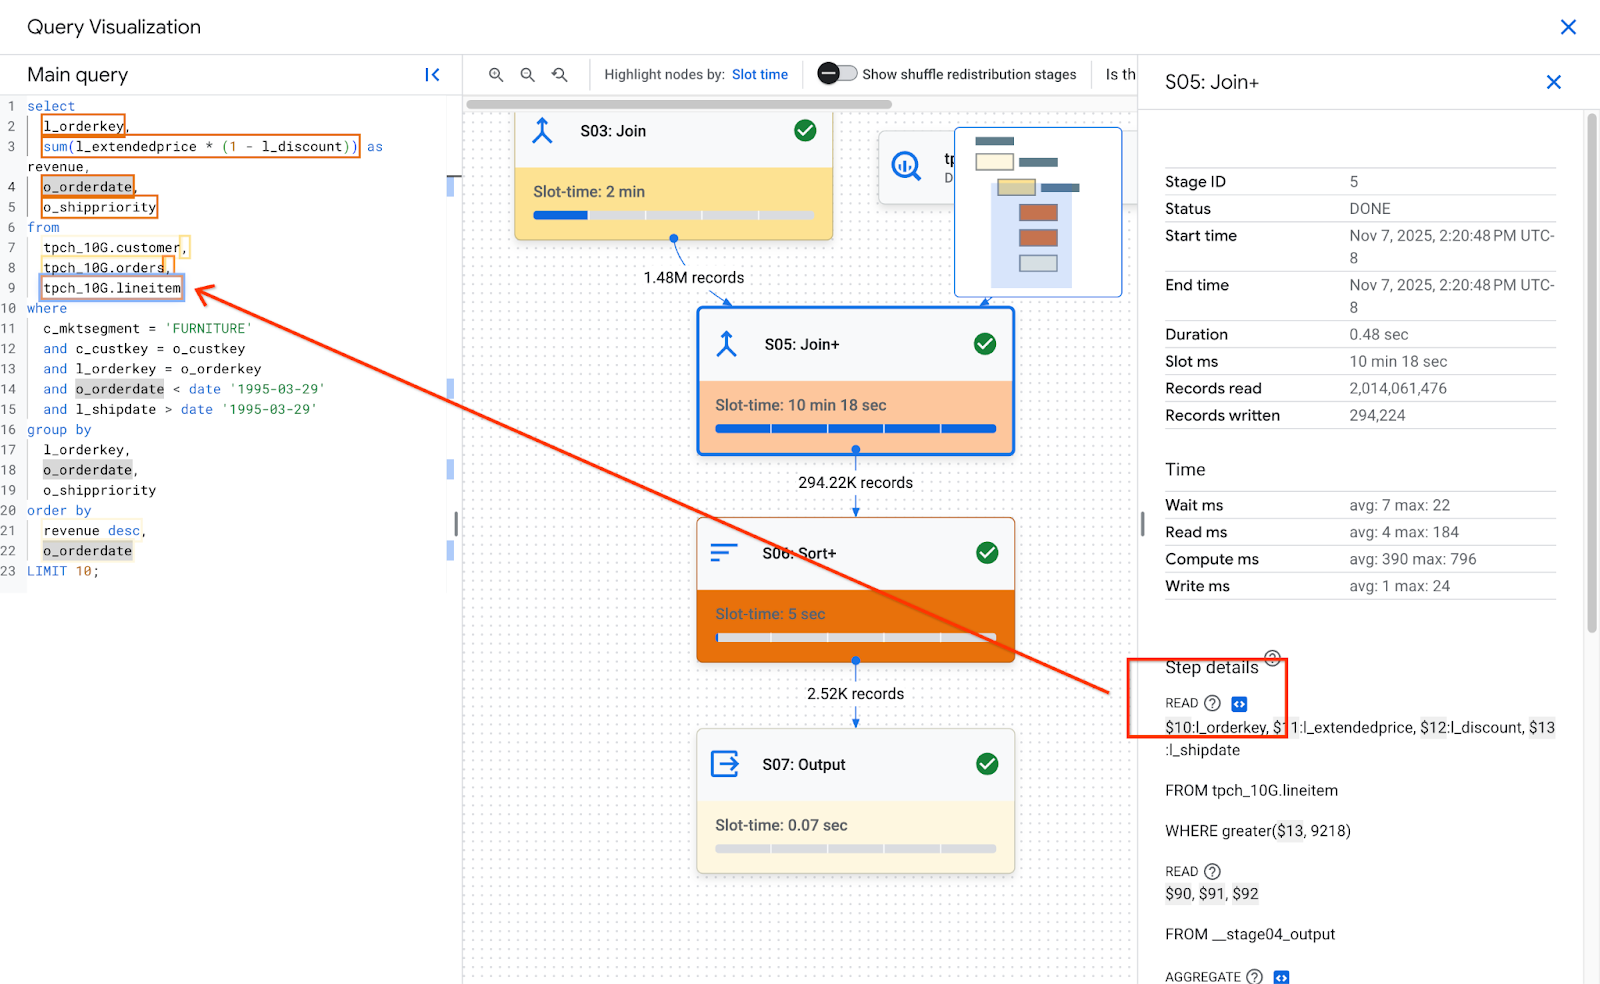
Di bagian Step details pada suatu tahap, jika langkah dipetakan ke teks kueri, langkah tersebut memiliki ikon kode. Mengklik ikon kode akan menandai bagian teks kueri yang dipetakan di sebelah kiri.
Penting untuk diingat bahwa warna peta panas didasarkan pada slot-time seluruh tahap. Karena BigQuery tidak mengukur waktu slot langkah, peta panas tidak mewakili waktu slot sebenarnya untuk bagian tertentu dari teks kueri yang dipetakan. Pada umumnya, sebuah tahap hanya melakukan satu langkah kompleks, seperti join atau agregat. Dengan demikian, warna peta panas sudah sesuai. Namun, jika suatu tahap terdiri dari langkah-langkah yang melakukan beberapa operasi kompleks, warna peta panas dapat terlalu mewakili waktu slot yang sebenarnya dalam peta panas. Dalam kasus tersebut, penting untuk memahami langkah-langkah lain yang membentuk tahap tersebut untuk mendapatkan pemahaman yang lebih lengkap tentang performa kueri.
Jika kueri menggunakan tampilan, dan langkah-langkah tahap memiliki pemetaan ke teks kueri tampilan, peta panas teks kueri akan menampilkan nama tampilan dan teks kueri tampilan beserta pemetaannya. Namun, jika tampilan dihapus, atau jika Anda kehilangan
izin IAM bigquery.tables.get pada
tampilan, heatmap teks kueri tidak akan menampilkan pemetaan langkah-langkah tahap untuk
tampilan tersebut.
Ringkasan stage
Kolom ringkasan untuk setiap stage dapat mencakup hal berikut:
| Kolom API | Deskripsi |
|---|---|
id |
ID numerik unik untuk stage. |
name |
Nama ringkasan sederhana untuk stage. steps dalam stage memberikan detail tambahan tentang langkah-langkah eksekusi. |
status |
Status eksekusi stage. Status yang mungkin termasuk PENDING, RUNNING, COMPLETE, FAILED, dan CANCELLED. |
inputStages |
Daftar ID yang membentuk grafik dependensi stage. Misalnya, stage JOIN sering memerlukan dua stage dependen yang menyiapkan data di sisi kiri dan kanan hubungan JOIN. |
startMs |
Stempel waktu, dalam epoch milidetik, yang merepresentasikan kapan worker pertama dalam stage memulai eksekusi. |
endMs |
Stempel waktu, dalam epoch milidetik, yang merepresentasikan kapan worker terakhir menyelesaikan eksekusi. |
steps |
Daftar langkah-langkah eksekusi yang lebih mendetail dalam stage. Lihat bagian berikutnya untuk mengetahui informasi selengkapnya. |
recordsRead |
Ukuran input stage sebagai jumlah catatan, di semua worker stage. |
recordsWritten |
Ukuran output stage sebagai jumlah catatan, di semua worker stage. |
parallelInputs |
Jumlah unit tugas yang dapat diparalelkan untuk stage. Bergantung pada stage dan kueri, jumlah ini dapat mewakili jumlah segmen kolom dalam tabel, atau jumlah partisi dalam shuffle perantara. |
completedParallelInputs |
Jumlah unit tugas dalam stage yang telah diselesaikan. Untuk sebagian kueri, tidak semua input dalam satu stage harus diselesaikan agar stage tersebut dapat diselesaikan. |
shuffleOutputBytes |
Merepresentasikan total byte yang ditulis di semua worker dalam stage kueri. |
shuffleOutputBytesSpilled |
Kueri yang mengirimkan data signifikan antar-stage mungkin perlu kembali ke transmisi berbasis disk. Statistik byte yang dialihkan menunjukkan berapa banyak data yang dialihkan ke disk. Bergantung pada algoritma pengoptimalan sehingga tidak bersifat deterministik untuk kueri tertentu. |
Klasifikasi pengaturan waktu per stage
Tahap kueri menyediakan klasifikasi pengaturan waktu tahap, baik dalam bentuk relatif maupun absolut. Karena setiap stage eksekusi merepresentasikan tugas yang dilakukan oleh satu atau beberapa worker independen, informasi diberikan dalam waktu rata-rata dan kasus terburuk. Waktu ini menunjukkan performa rata-rata untuk semua worker dalam satu stage serta performa worker paling lambat longtail untuk klasifikasi tertentu. Waktu rata-rata dan waktu maksimum selanjutnya dibagi menjadi representasi absolut dan relatif. Untuk statistik berbasis rasio, data diberikan sebagai hasil bagi dari waktu terlama yang dihabiskan oleh worker mana pun di segmen mana pun.
Konsol Google Cloud menampilkan pengaturan waktu stage menggunakan representasi pengaturan waktu relatif.
Informasi pengaturan waktu stage dilaporkan sebagai berikut:
| Pengaturan waktu relatif | Pengaturan waktu absolut | Numerator rasio |
|---|---|---|
waitRatioAvg |
waitMsAvg |
Waktu yang dihabiskan oleh worker rata-rata yang menunggu dijadwalkan. |
waitRatioMax |
waitMsMax |
Waktu yang dihabiskan oleh worker paling lambat yang menunggu dijadwalkan. |
readRatioAvg |
readMsAvg |
Waktu yang dihabiskan rata-rata worker untuk membaca data input. |
readRatioMax |
readMsMax |
Waktu yang dihabiskan worker paling lambat untuk membaca data input. |
computeRatioAvg |
computeMsAvg |
Waktu yang dihabiskan oleh rata-rata worker yang terikat ke CPU. |
computeRatioMax |
computeMsMax |
Waktu yang dihabiskan oleh worker paling lambat yang terikat oleh CPU. |
writeRatioAvg |
writeMsAvg |
Waktu yang dihabiskan oleh worker rata-rata untuk menulis data output. |
writeRatioMax |
writeMsMax |
Waktu yang dihabiskan worker paling lambat untuk menulis data output. |
Ringkasan langkah
Langkah-langkah berisi operasi yang dijalankan oleh setiap worker dalam satu stage, yang ditampilkan sebagai daftar operasi yang diurutkan. Setiap operasi langkah memiliki kategori, dengan beberapa operasi yang memberikan informasi yang lebih mendetail. Kategori operasi yang ada dalam rencana kueri mencakup hal berikut:
| Kategori langkah | Deskripsi |
|---|---|
READ |
Pembacaan satu atau beberapa kolom dari tabel input atau dari shuffle tingkat menengah. Hanya enam belas kolom pertama yang dibaca yang ditampilkan dalam detail-detail langkah. |
WRITE |
Penulisan satu atau beberapa kolom ke tabel output atau ke shuffle tingkat menengah. Untuk output yang dipartisi HASH dari suatu stage, ini juga mencakup kolom yang digunakan sebagai kunci partisi. |
COMPUTE |
Evaluasi ekspresi dan fungsi SQL. |
FILTER |
Digunakan oleh klausa WHERE, OMIT IF, dan HAVING. |
SORT |
Operasi ORDER BY yang mencakup kunci kolom dan tata urutan. |
AGGREGATE |
Menerapkan agregasi untuk klausa seperti GROUP BY atau COUNT, antara lain. |
LIMIT |
Mengimplementasikan klausa LIMIT. |
JOIN |
Menerapkan gabungan untuk klausa seperti JOIN, antara lain; mencakup jenis gabungan dan kemungkinan kondisi gabungan. |
ANALYTIC_FUNCTION |
Pemanggilan fungsi jendela (juga dikenal sebagai "fungsi analisis"). |
USER_DEFINED_FUNCTION |
Pemanggilan ke fungsi yang ditentukan pengguna (UDF). |
UPDATE |
Mengubah baris yang ada dalam tabel target untuk pernyataan UPDATE; mencakup kolom yang diubah dan tabel target. |
DELETE |
Menghapus baris dari tabel target untuk pernyataan DELETE; mencakup kolom yang direferensikan dan tabel target. |
MERGE |
Mengubah baris dalam tabel target untuk pernyataan MERGE; mencakup kolom yang diubah dan tabel target. |
EXPORT |
Menulis kolom output ke tabel tujuan untuk pernyataan bahasa pengolahan data (DML) atau ekspor hasil kueri. |
Langkah-langkah penafsiran dan pengoptimalan
Bagian berikut menjelaskan cara menafsirkan langkah-langkah dalam rencana kueri dan memberikan cara untuk mengoptimalkan kueri Anda.
READ langkah
Langkah READ berarti bahwa suatu tahap sedang mengakses data untuk diproses. Data dapat dibaca langsung dari tabel yang dirujuk dalam kueri, atau dari memori shuffle.
Saat data dari tahap sebelumnya dibaca, BigQuery membaca data dari memori shuffle. Jumlah data yang dipindai memengaruhi biaya saat menggunakan slot on-demand dan memengaruhi performa saat menggunakan pemesanan.
Potensi masalah performa
- Pemindaian besar pada tabel yang tidak dipartisi: jika kueri hanya memerlukan sebagian kecil data, hal ini mungkin menunjukkan bahwa pemindaian tabel tidak efisien. Partisi dapat menjadi strategi pengoptimalan yang baik.
- Pemindaian tabel besar dengan rasio filter kecil: hal ini menunjukkan bahwa filter tidak efektif mengurangi data yang dipindai. Pertimbangkan untuk merevisi kondisi filter.
- Shuffle bytes spilled over to disk: ini menunjukkan bahwa data tidak disimpan secara efektif menggunakan teknik pengoptimalan seperti pengelompokan, yang dapat mempertahankan data serupa dalam cluster.
Optimalkan
- Pemfilteran yang ditargetkan: gunakan klausa
WHEREsecara strategis untuk memfilter data yang tidak relevan sedini mungkin dalam kueri. Hal ini mengurangi jumlah data yang perlu diproses oleh kueri. - Partisi dan pengelompokan: BigQuery menggunakan partisi dan pengelompokan tabel untuk menemukan segmen data tertentu secara efisien.
Pastikan tabel Anda dipartisi dan dikelompokkan berdasarkan pola kueri umum Anda untuk meminimalkan data yang dipindai selama langkah-langkah
READ. - Pilih kolom yang relevan: hindari penggunaan pernyataan
SELECT *. Sebagai gantinya, pilih kolom tertentu atau gunakanSELECT * EXCEPTuntuk menghindari pembacaan data yang tidak diperlukan. - Tampilan terwujud: tampilan terwujud dapat melakukan pra-komputasi dan menyimpan
agregasi yang sering digunakan, sehingga berpotensi mengurangi kebutuhan untuk membaca tabel
dasar selama langkah
READuntuk kueri yang menggunakan tampilan tersebut.
COMPUTE langkah
Pada langkah COMPUTE, BigQuery melakukan tindakan berikut pada data Anda:
- Mengevaluasi ekspresi dalam
SELECT,WHERE,HAVING, dan klausa lainnya dalam kueri, termasuk penghitungan, perbandingan, dan operasi logika. - Menjalankan fungsi SQL bawaan dan fungsi yang ditentukan pengguna (UDF).
- Memfilter baris data berdasarkan kondisi dalam kueri.
Optimalkan
Rencana kueri dapat mengungkapkan bottleneck dalam langkah COMPUTE. Cari tahap
dengan komputasi ekstensif atau jumlah baris yang diproses tinggi.
- Korelasikan langkah
COMPUTEdengan volume data: jika suatu tahap menunjukkan komputasi yang signifikan dan memproses volume data yang besar, tahap tersebut mungkin merupakan kandidat yang baik untuk pengoptimalan. - Data miring: untuk tahap di mana komputasi maksimum jauh lebih tinggi daripada rata-rata komputasi, hal ini menunjukkan bahwa tahap tersebut menghabiskan jumlah waktu yang tidak proporsional untuk memproses beberapa bagian data. Pertimbangkan untuk melihat distribusi data guna mengetahui apakah ada kecondongan data.
- Pertimbangkan jenis data: gunakan jenis data yang sesuai untuk kolom Anda. Misalnya, menggunakan bilangan bulat, datetime, dan stempel waktu, bukan string, dapat meningkatkan performa.
WRITE langkah
Langkah WRITE terjadi untuk data perantara dan output akhir.
- Menulis ke memori shuffle: dalam kueri multi-tahap, langkah
WRITEsering kali melibatkan pengiriman data yang diproses ke tahap lain untuk pemrosesan lebih lanjut. Hal ini biasa terjadi pada memori shuffle, yang menggabungkan atau mengagregasi data dari beberapa sumber. Data yang ditulis selama tahap ini biasanya merupakan hasil perantara, bukan output akhir. - Output akhir: hasil kueri ditulis ke tabel tujuan atau tabel sementara.
Partisi Hash
Saat sebuah tahap dalam rencana kueri menulis data ke output yang dipartisi hash, BigQuery akan menulis kolom yang disertakan dalam output dan kolom yang dipilih sebagai kunci partisi.
Optimalkan
Meskipun langkah WRITE itu sendiri mungkin tidak dioptimalkan secara langsung, memahami perannya dapat membantu Anda mengidentifikasi potensi bottleneck pada tahap awal:
- Minimalkan data yang ditulis: fokus pada pengoptimalan tahap sebelumnya dengan pemfilteran dan agregasi untuk mengurangi jumlah data yang ditulis selama langkah ini.
Partisi: penulisan sangat diuntungkan dari partisi tabel. Jika data yang Anda tulis dibatasi pada partisi tertentu, BigQuery dapat melakukan penulisan lebih cepat.
Jika pernyataan DML memiliki klausa
WHEREdengan kondisi statis terhadap kolom partisi tabel, BigQuery hanya akan mengubah partisi tabel yang relevan.Kompromi denormalisasi: denormalisasi terkadang dapat menyebabkan set hasil yang lebih kecil di langkah
WRITEperantara. Namun, ada kelemahan seperti peningkatan penggunaan penyimpanan dan tantangan konsistensi data.
JOIN langkah
Pada langkah JOIN, BigQuery menggabungkan data dari dua sumber data.
Gabungan dapat menyertakan kondisi gabungan. Gabungan memerlukan banyak resource. Saat menggabungkan data besar di BigQuery, kunci gabungan di-shuffle secara independen untuk berbaris di slot yang sama, sehingga penggabungan dilakukan secara lokal di setiap slot.
Rencana kueri untuk langkah JOIN biasanya menampilkan detail berikut:
- Pola gabungan: ini menunjukkan jenis gabungan yang digunakan. Setiap jenis menentukan jumlah baris dari tabel yang digabungkan yang disertakan dalam set hasil.
- Kolom gabungan: ini adalah kolom yang digunakan untuk mencocokkan baris di antara sumber data. Pemilihan kolom sangat penting untuk performa penggabungan.
Pola join
- Penggabungan siaran: jika satu tabel, biasanya yang lebih kecil, dapat dimuat dalam memori pada satu worker node atau slot, BigQuery dapat menyiarkannya ke semua node lain untuk melakukan penggabungan secara efisien. Cari
JOIN EACH WITH ALLdi detail langkah. - Hash join: jika tabel berukuran besar atau gabungan siaran tidak sesuai, hash join dapat digunakan. BigQuery menggunakan operasi hash dan shuffle untuk mengacak tabel kiri dan kanan sehingga kunci yang cocok berakhir di slot yang sama untuk melakukan penggabungan lokal. Gabungan hash adalah operasi yang mahal karena data perlu dipindahkan, tetapi memungkinkan pencocokan baris yang efisien di seluruh hash. Cari
JOIN EACH WITH EACHdi detail langkah. - Self join: antipola SQL yang menggabungkan tabel dengan tabel itu sendiri.
- Cross join: antipola SQL yang dapat menyebabkan masalah performa yang signifikan karena menghasilkan data output yang lebih besar daripada input.
- Skewed join: distribusi data di seluruh kunci join dalam satu tabel sangat miring dan dapat menyebabkan masalah performa. Cari kasus saat waktu komputasi maksimum jauh lebih besar daripada waktu komputasi rata-rata dalam rencana kueri. Untuk mengetahui informasi selengkapnya, lihat Gabungan kardinalitas tinggi dan Penyimpangan partisi.
Proses Debug
- Volume data yang besar: jika rencana kueri menunjukkan jumlah data yang signifikan
yang diproses selama langkah
JOIN, selidiki kondisi join dan kunci join. Pertimbangkan untuk memfilter atau menggunakan kunci gabungan yang lebih selektif. - Distribusi data yang miring: analisis distribusi data kunci gabungan. Jika satu tabel sangat miring, pelajari strategi seperti memisahkan kueri atau melakukan pra-pemfilteran.
- Gabungan kardinalitas tinggi: gabungan yang menghasilkan baris yang jauh lebih banyak daripada jumlah baris input kiri dan kanan dapat mengurangi performa kueri secara drastis. Hindari join yang menghasilkan baris dalam jumlah yang sangat besar.
- Pengurutan tabel yang salah: Pastikan Anda telah memilih jenis join yang sesuai, seperti
INNERatauLEFT, dan mengurutkan tabel dari yang terbesar hingga terkecil berdasarkan persyaratan kueri Anda.
Optimalkan
- Kunci join selektif: untuk kunci join, gunakan
INT64, bukanSTRINGjika memungkinkan. PerbandinganSTRINGlebih lambat daripada perbandinganINT64karena membandingkan setiap karakter dalam string. Bilangan bulat hanya memerlukan satu perbandingan. - Filter sebelum menggabungkan: terapkan filter klausa
WHEREpada setiap tabel sebelum penggabungan. Hal ini mengurangi jumlah data yang terlibat dalam operasi gabungan. - Hindari fungsi pada kolom gabungan: hindari memanggil fungsi pada kolom gabungan. Sebagai gantinya, standarkan data tabel Anda selama proses penyerapan atau pasca-penyerapan menggunakan pipeline SQL ELT. Pendekatan ini menghilangkan kebutuhan untuk mengubah kolom gabungan secara dinamis, sehingga memungkinkan penggabungan yang lebih efisien tanpa mengorbankan integritas data.
- Menghindari self join: self-join umum digunakan untuk menghitung hubungan yang bergantung pada baris. Namun, self-join berpotensi melipatgandakan jumlah baris output, sehingga menyebabkan masalah performa. Daripada mengandalkan self-join, pertimbangkan untuk menggunakan fungsi jendela (analitik).
- Tabel besar terlebih dahulu: meskipun pengoptimal kueri SQL dapat menentukan tabel mana yang harus berada di sisi gabungan mana, urutkan tabel yang digabungkan dengan tepat. Praktik terbaiknya adalah menempatkan tabel terbesar terlebih dahulu, diikuti dengan tabel terkecil, lalu dengan mengurangi ukurannya.
- Denormalisasi: dalam beberapa kasus, denormalisasi tabel secara strategis (menambahkan data redundan) dapat menghilangkan penggabungan sepenuhnya. Namun, pendekatan ini memiliki konsekuensi terkait penyimpanan dan konsistensi data.
- Partisi dan pengelompokan: mempartisi tabel berdasarkan kunci gabungan dan mengelompokkan data yang ditempatkan bersama dapat mempercepat penggabungan secara signifikan dengan memungkinkan BigQuery menargetkan partisi data yang relevan.
- Mengoptimalkan penggabungan miring: untuk menghindari masalah performa yang terkait dengan penggabungan miring, lakukan pra-filter data dari tabel sedini mungkin atau bagi kueri menjadi dua kueri atau lebih.
AGGREGATE langkah
Pada langkah AGGREGATE, BigQuery menggabungkan dan mengelompokkan data.
Proses Debug
- Detail tahap: periksa jumlah baris input ke dan baris output dari agregasi, serta ukuran shuffle untuk menentukan seberapa besar pengurangan data yang dicapai langkah agregat dan apakah pengacakan data terlibat.
- Ukuran shuffle: ukuran shuffle yang besar mungkin menunjukkan bahwa sejumlah besar data dipindahkan di seluruh worker node selama agregasi.
- Periksa distribusi data: pastikan data didistribusikan secara merata di seluruh partisi. Distribusi data yang miring dapat menyebabkan workload yang tidak seimbang pada langkah agregat.
- Tinjau agregasi ulasan: analisis klausa agregasi untuk memastikan klausa tersebut diperlukan dan efisien.
Optimalkan
- Pengelompokan: kelompokkan tabel Anda pada kolom yang sering digunakan dalam
GROUP BY,COUNT, atau klausa agregasi lainnya. - Partisi: pilih strategi partisi yang sesuai dengan pola kueri Anda. Pertimbangkan untuk menggunakan tabel berpartisi berdasarkan waktu penyerapan untuk mengurangi jumlah data yang dipindai selama agregasi.
- Agregasi lebih awal: jika memungkinkan, lakukan agregasi lebih awal di pipeline kueri. Hal ini dapat mengurangi jumlah data yang perlu diproses selama agregasi.
- Pengoptimalan pengacakan: jika pengacakan menjadi bottleneck, pelajari cara meminimalkannya. Misalnya, denormalisasi tabel atau gunakan pengelompokan untuk menempatkan data yang relevan.
Kasus ekstrem
- Agregat DISTINCT: kueri dengan agregat
DISTINCTdapat memerlukan biaya komputasi yang tinggi, terutama pada set data besar. Pertimbangkan alternatif sepertiAPPROX_COUNT_DISTINCTuntuk hasil perkiraan. - Jumlah grup yang besar: jika kueri menghasilkan grup dalam jumlah besar, kueri tersebut dapat menggunakan memori dalam jumlah besar. Dalam kasus tersebut, pertimbangkan untuk membatasi jumlah grup atau menggunakan strategi agregasi yang berbeda.
REPARTITION langkah
REPARTITION dan COALESCE adalah teknik pengoptimalan yang diterapkan BigQuery langsung ke data yang diacak dalam kueri.
REPARTITION: operasi ini bertujuan untuk menyeimbangkan kembali distribusi data di seluruh worker node. Misalnya, setelah pengacakan, satu worker node memiliki jumlah data yang sangat besar. LangkahREPARTITIONmendistribusikan ulang data secara lebih merata, sehingga mencegah satu worker menjadi bottleneck. Hal ini sangat penting untuk operasi yang memerlukan komputasi intensif seperti join.COALESCE: langkah ini terjadi saat Anda memiliki banyak bucket data kecil setelah pengacakan. LangkahCOALESCEmenggabungkan bucket ini menjadi bucket yang lebih besar, sehingga mengurangi overhead yang terkait dengan pengelolaan banyak data kecil. Hal ini dapat sangat bermanfaat saat menangani set hasil perantara yang sangat kecil.
Jika Anda melihat langkah REPARTITION atau COALESCE dalam rencana kueri, bukan berarti ada masalah dengan kueri Anda. Hal ini sering kali merupakan tanda bahwa BigQuery secara proaktif mengoptimalkan distribusi data untuk performa yang lebih baik. Namun, jika Anda melihat operasi ini berulang kali, hal ini mungkin menunjukkan
bahwa data Anda pada dasarnya miring atau kueri Anda menyebabkan pengacakan data
yang berlebihan.
Optimalkan
Untuk mengurangi jumlah langkah REPARTITION, coba langkah berikut:
- Distribusi data: pastikan tabel Anda dipartisi dan dikelompokkan secara efektif. Data yang terdistribusi dengan baik mengurangi kemungkinan ketidakseimbangan yang signifikan setelah pengacakan.
- Struktur kueri: analisis kueri untuk mengetahui potensi sumber kecondongan data. Misalnya, apakah ada filter atau gabungan yang sangat selektif yang menghasilkan subset kecil data yang diproses pada satu worker?
- Strategi penggabungan: bereksperimenlah dengan berbagai strategi penggabungan untuk melihat apakah strategi tersebut menghasilkan distribusi data yang lebih seimbang.
Untuk mengurangi jumlah langkah COALESCE, coba langkah berikut:
- Strategi agregasi: pertimbangkan untuk melakukan agregasi lebih awal di pipeline kueri. Hal ini dapat membantu mengurangi jumlah set hasil perantara kecil yang mungkin menyebabkan langkah
COALESCE. - Volume data: jika Anda menangani set data yang sangat kecil,
COALESCEmungkin tidak menjadi masalah yang signifikan.
Jangan mengoptimalkan secara berlebihan. Pengoptimalan dini dapat membuat kueri Anda lebih kompleks tanpa memberikan manfaat yang signifikan.
Langkah UPDATE, DELETE, dan MERGE
Langkah-langkah UPDATE, DELETE, dan MERGE muncul dalam tahap yang menjalankan pernyataan bahasa pengolahan data (DML) terhadap tabel target.
Detail langkah biasanya mencakup sublangkah berikut:
- Kolom: kolom yang dibaca dari atau ditulis ke tabel target.
- Tabel target (
FROMatauINTO): tabel target yang diubah oleh pernyataan, menggunakanFROMuntuk langkahUPDATEdanDELETE, sertaINTOuntuk langkahMERGE.
EXPORT langkah
Langkah EXPORT menulis data output ke tabel tujuan. Langkah ini biasanya
muncul di tahap akhir pernyataan DML—seperti pernyataan INSERT, UPDATE,
DELETE, dan MERGE—dan dalam kueri yang mewujudkan hasil ke tabel
tujuan.
Detail langkah biasanya mencakup sublangkah berikut:
- Kolom output: daftar variabel yang ditulis ke tabel tujuan.
- Tabel tujuan (
TO): tabel tujuan yang menerima baris yang diekspor.
Penjelasan untuk kueri gabungan
Kueri gabungan memungkinkan Anda mengirim pernyataan kueri ke sumber data eksternal menggunakan fungsi EXTERNAL_QUERY.
Kueri gabungan tunduk pada teknik pengoptimalan yang dikenal sebagai pushdown SQL dan rencana kueri menunjukkan operasi yang didorong ke sumber data eksternal, jika ada. Misalnya, jika Anda menjalankan kueri berikut:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
Rencana kueri akan menampilkan langkah-langkah tahap berikut:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
Dalam rencana ini, table_for_external_query_$_0(...) mewakili fungsi EXTERNAL_QUERY. Dalam tanda kurung, Anda dapat melihat kueri yang dijalankan oleh sumber data eksternal. Berdasarkan hal itu, Anda dapat melihat bahwa:
- Sumber data eksternal hanya menampilkan 3 kolom yang dipilih.
- Sumber data eksternal hanya menampilkan baris yang
country_code-nya adalah'ee'atau'hu'. - Operator
LIKEtidak didorong ke bawah dan dievaluasi oleh BigQuery.
Sebagai perbandingan, jika tidak ada pushdown, rencana kueri akan menampilkan langkah-langkah tahapan berikut:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
Kali ini, sumber data eksternal menampilkan semua kolom dan semua baris dari tabel company dan BigQuery melakukan pemfilteran.
Metadata linimasa
Linimasa kueri melaporkan progres pada waktu tertentu, yang menyediakan tampilan snapshot progres kueri secara keseluruhan. Linimasa direpresentasikan sebagai serangkaian contoh yang melaporkan detail berikut:
| Kolom | Deskripsi |
|---|---|
elapsedMs |
Milidetik berlalu sejak awal eksekusi kueri. |
totalSlotMs |
Representasi kumulatif slot milidetik yang digunakan oleh kueri. |
pendingUnits |
Total unit tugas yang dijadwalkan dan menunggu eksekusi. |
activeUnits |
Total unit tugas aktif yang sedang diproses oleh worker. |
completedUnits |
Total unit tugas yang telah diselesaikan saat menjalankan kueri ini. |
Contoh kueri
Kueri berikut menghitung jumlah baris dalam set data publik Shakespeare dan memiliki jumlah bersyarat kedua yang membatasi hasil pada baris yang merujuk ke 'hamlet':
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
Klik Execution details untuk melihat rencana kueri:

Indikator warna menunjukkan pengaturan waktu relatif untuk semua langkah di seluruh stage.
Untuk mempelajari lebih lanjut langkah-langkah stage eksekusi, klik untuk meluaskan detail stage tersebut:
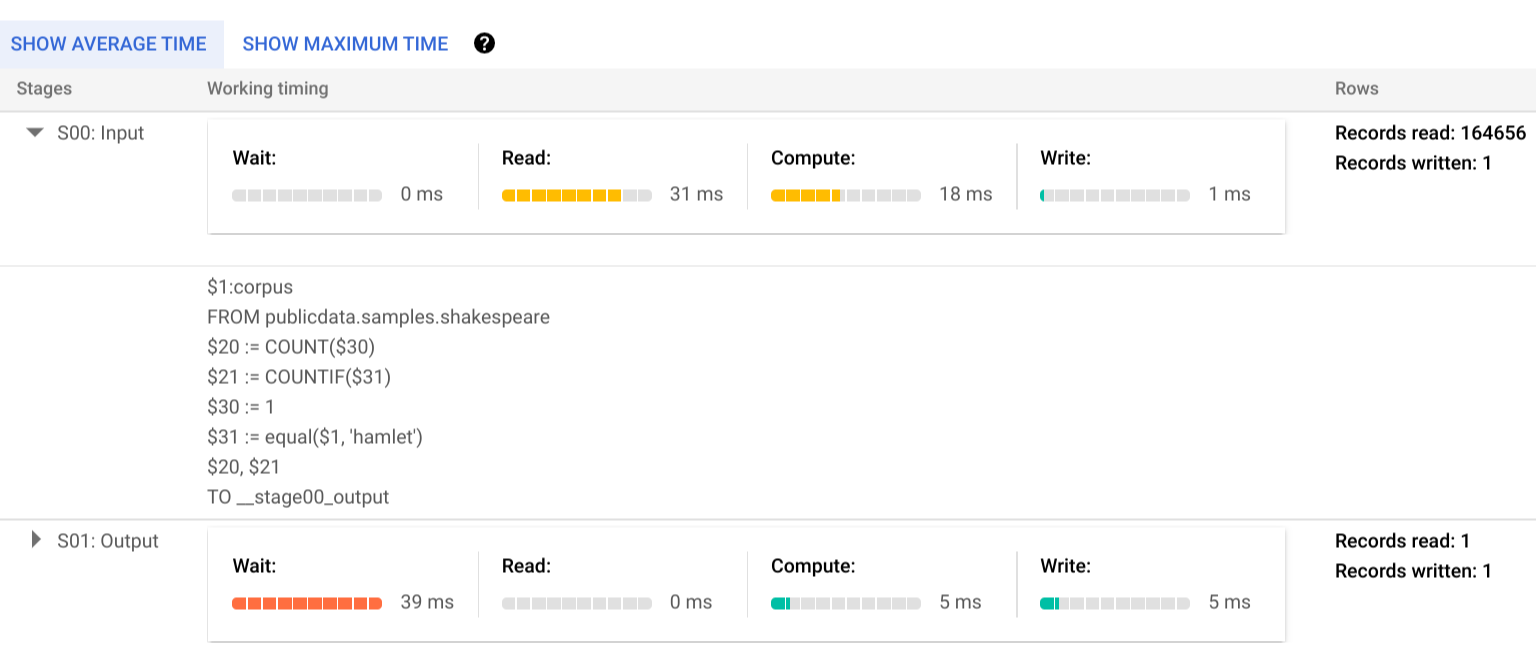
Dalam contoh ini, waktu terlama di segmen mana pun adalah waktu yang dihabiskan oleh satu worker di Stage 01 untuk menunggu Stage 00 selesai. Hal ini karena Stage 01 bergantung pada input Stage 00, dan tidak dapat dimulai hingga stage pertama menulis output-nya dalam mode shuffle menengah.
Pelaporan error
Tugas kueri mungkin saja gagal di tengah eksekusi. Karena informasi paket diperbarui secara berkala, Anda dapat mengamati di bagian mana kegagalan terjadi dalam grafik eksekusi. Dalam konsol Google Cloud , stage berhasil atau gagal dilabeli dengan tanda centang atau tanda seru di samping nama stage.
Untuk mengetahui informasi lebih lanjut tentang cara menafsirkan dan mengatasi error, lihat panduan pemecahan masalah.
Representasi contoh API
Informasi rencana kueri disematkan dalam informasi respons tugas, dan Anda dapat mengambilnya dengan memanggil jobs.get.
Misalnya, kutipan respons JSON berikut untuk tugas yang menampilkan contoh kueri hamlet menunjukkan paket kueri dan informasi linimasa.
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
Menggunakan informasi eksekusi
Rencana kueri BigQuery memberikan informasi tentang cara layanan mengeksekusi kueri, tetapi sifat layanan yang terkelola membatasi bisa tidaknya beberapa detail ditindaklanjuti secara langsung. Banyak pengoptimalan terjadi secara otomatis menggunakan layanan ini, yang dapat berbeda dengan lingkungan lain karena penyesuaian, penyediaan, dan pemantauan dapat memerlukan staf khusus yang berpengetahuan luas.
Untuk mengetahui teknik tertentu yang dapat meningkatkan eksekusi dan performa kueri, baca dokumentasi praktik terbaik. Statistik paket dan linimasa kueri dapat membantu Anda memahami apakah stage tertentu mendominasi penggunaan resource. Misalnya, stage JOIN yang menghasilkan baris output yang jauh lebih banyak daripada baris input dapat mengindikasikan peluang untuk memfilter lebih awal dalam kueri.
Selain itu, informasi linimasa dapat membantu mengidentifikasi apakah kueri tertentu lambat secara terpisah atau karena efek dari kueri lain yang menangani resource yang sama. Jika Anda mengamati bahwa jumlah unit aktif tetap terbatas selama masa aktif kueri, tetapi jumlah unit tugas yang diantrekan tetap tinggi, hal ini dapat mewakili kasus ketika pengurangan jumlah kueri serentak dapat secara signifikan meningkatkan waktu eksekusi secara keseluruhan untuk kueri tertentu.