


透過模型蒸餾,盡可能降低 AI 函式成本
本文說明如何在 BigQuery 中,使用代管 AI 函式的最佳化模式。您可以使用最佳化模式處理包含數千甚至數十億列的大規模資料集,與標準的逐列 LLM 推論相比,大型語言模型 (LLM) 詞元消耗量和查詢延遲時間大幅減少。這項最佳化僅適用於 AI.IF 和 AI.CLASSIFY 函式。
如果您想設定權杖總消耗量上限,避免預算超支,而不是最佳化查詢的權杖效率,請改為參閱「使用權杖配額控管費用」。
如要進一步瞭解權杖消耗量,您可以在Google Cloud 控制台中查看查詢使用的權杖數量。如要在執行查詢前估算這項用量,請使用 AI.COUNT_TOKENS 函式。
下列範例示範如何使用 AI.IF 函式和最佳化模式,並以 text-embedding-005 做為嵌入模型,找出有關自然災害的新聞報導:
SELECT
  title,
  body,
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    -- Optional, 'MINIMIZE_COST' is the default when embeddings are provided.
    optimization_mode => 'MINIMIZE_COST'
   ) AS is_natural_disaster
FROM
  `bigquery-public-data.bbc_news.fulltext`;
optimization_mode => 'MINIMIZE_COST' 引數會啟用最佳化模式。提供嵌入時,這是預設設定,因此您可以省略這個引數。
在這個範例中,嵌入是即時生成。實務上,建議您具體化嵌入,以便重複使用。
最佳化模式的運作方式
代管 AI 函式 AI.IF 和 AI.CLASSIFY 通常會為資料集中的每一列呼叫遠端 LLM。使用最佳化模式時,BigQuery 會在執行查詢期間,自動訓練輕量蒸餾模型。
流程如下:
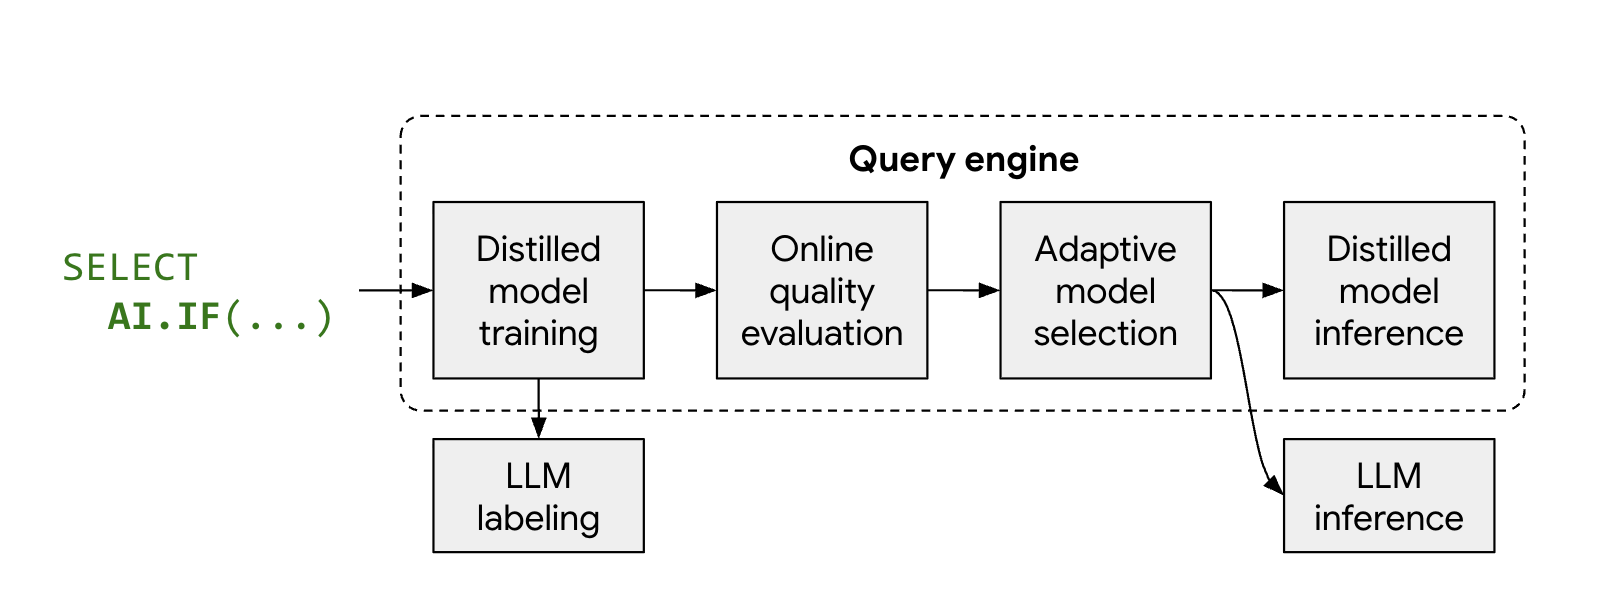
- 取樣和標籤:BigQuery 會選取一小部分具代表性的資料樣本,並呼叫 Gemini 提供標籤。
- 精煉模型訓練:使用 LLM 標籤和資料嵌入做為特徵,即時訓練本機精煉模型。
- 品質檢查:BigQuery 會根據 LLM 的結果,評估精煉模型的準確度。根據預設,如果精煉模型未達必要的品質門檻,查詢就會失敗,並顯示錯誤訊息,說明模型遭捨棄的原因。如果模型品質可接受,BigQuery 仍可能針對特定資料列,改用遠端 LLM 來維持一致的品質,或針對缺少有效嵌入的資料列,改用遠端 LLM。
- 推論:蒸餾模型會處理大部分的資料列,大幅減少 Gemini 呼叫次數。
限制
最佳化模式有下列限制:
- 資料列數量下限:AI 函式的輸入內容必須包含約 3,000 列,確保有足夠的資料訓練模型。
- 資料類型:如果提示參照多個資料欄,則只有字串資料欄支援最佳化。
- 多標籤分類:最佳化模式不支援
AI.CLASSIFY搭配output_mode => 'multi'。 - 函式支援:只有
AI.IF和AI.CLASSIFY函式支援最佳化模式。不過,如果精煉模型品質不足,使用AI.CLASSIFY搭配最佳化模式時,查詢可能會失敗。 - 錯誤率:最佳化模式不支援
max_error_ratio引數。
事前準備
如要取得在 BigQuery 執行代管 AI 函式所需的權限,請參閱「為呼叫 Gemini Enterprise Agent Platform LLM 的生成式 AI 函式設定權限」。
選擇嵌入模型
如要使用最佳化模式,您必須計算資料的嵌入,並提供給 AI 函式。如要讓輸入資料欄具有相關聯的嵌入,所有資料列都必須具有一致的嵌入維度,並由相同的嵌入模型生成。
為達到最佳成本效益和擴充性,建議您使用嵌入模型 (例如 text-embedding-005 或 Gemini 嵌入),為英文或多語言任務計算資料嵌入。如果是多模態資料 (文字和圖片),建議使用多模態嵌入模型,例如 Gemini Embedding 2 (gemini-embedding-2)。
生成嵌入項目
您可以使用 BigQuery 管理的自主生成功能,或手動建立嵌入資料欄,為資料計算嵌入。以下各節說明如何搭配使用這兩種方法與 AI.CLASSIFY 和 AI.IF 函式。
自主生成嵌入
如果使用自主嵌入生成功能,BigQuery 會在呼叫 AI.IF 或 AI.CLASSIFY 時自動使用嵌入。這是建議做法,但每個資料表只能有一個嵌入資料欄。
下列範例會建立資料表,並使用 text-embedding-005 做為嵌入模型,自動生成嵌入資料欄,然後使用 AI.CLASSIFY 函式分類資料:
-- Create a table with an autonomously generated embedding column
CREATE TABLE my_dataset.bbc_news (
  title STRING,
  body STRING,
  body_embedding STRUCT<result ARRAY<FLOAT64>, status STRING>
    GENERATED ALWAYS AS (
      AI.EMBED(
        body,
        connection_id => '<my_connection_id>',
        task_type => 'CLASSIFICATION',
        endpoint => 'text-embedding-005')
    ) STORED
    OPTIONS(asynchronous = TRUE)
);

-- Insert data into the table
INSERT INTO my_dataset.bbc_news (title, body)
SELECT title, body FROM `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query.
-- Wait for the background job to finish generating embeddings before running.
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other']
  ) AS category
FROM
  my_dataset.bbc_news;
手動指定資料欄
如果您已有嵌入資料欄,請在 AI.IF 或 AI.CLASSIFY 的 embeddings 引數中指定。您可以使用 AI.EMBED 函式產生這個值。
下列範例說明如何建立含有嵌入資料欄的資料表,並使用 text-embedding-005 做為嵌入模型,然後在 AI.CLASSIFY 查詢中使用該資料欄:
-- Create a table with an embedding column
CREATE TABLE my_dataset.bbc_news AS
SELECT
  title,
  body,
  AI.EMBED(
    body,
    endpoint => 'text-embedding-005',
    task_type => 'CLASSIFICATION'
  ).result AS body_embedding
FROM
  `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other'],
    embeddings => body_embedding,
  ) AS category
FROM
  my_dataset.bbc_news;
如果提示參照多個資料欄,請在 embeddings 引數中提供資料欄名稱清單和對應的嵌入。例如:embeddings => [('body', body_embedding), ('title', title_embedding)]。
監控查詢最佳化
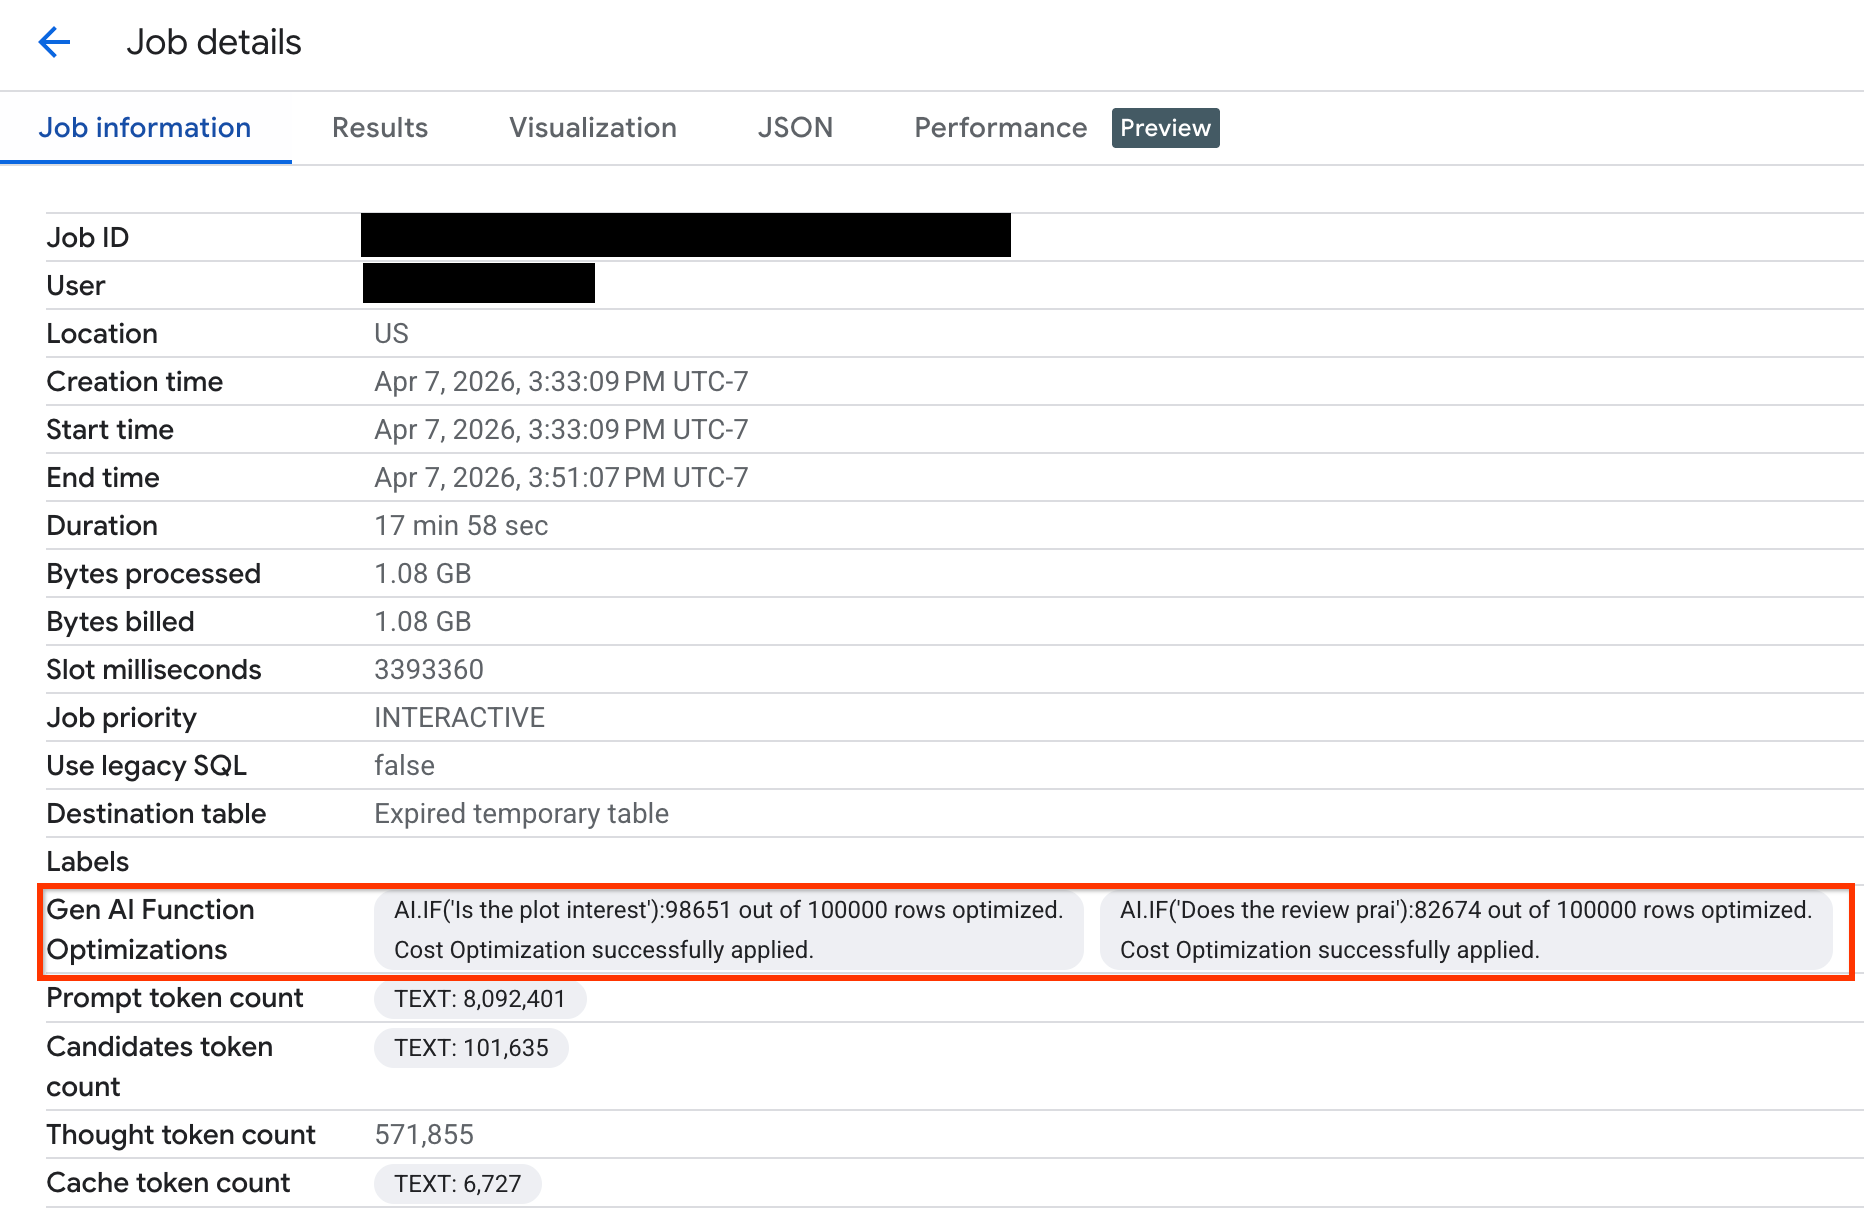
如要確認查詢執行期間最佳化的資料列數量,您可以在 Google Cloud 控制台或透過 API 查看執行統計資料:
控制台
如要查看最佳化的資料列數量,以及最佳化狀態的系統訊息,請按照下列步驟操作:
前往 Google Cloud 控制台的「BigQuery」頁面。
在導覽選單中,點選「Jobs explorer」(工作探索工具)。
按一下工作 ID,即可查看「Job details」(工作詳細資料) 窗格。
按一下「Job information」(工作資訊) 分頁標籤,然後在「Gen AI function optimizations」(生成式 AI 函式最佳化調整) 欄位中查看指標和狀態。
API
請查看工作中繼資料 GenAIFunctionStats 物件中的 FunctionGenAiCostOptimizationStats。這個物件包含透過最佳化工作流程推論出的資料列數量,以及系統產生的訊息,可提供最佳化狀態的深入分析。
疑難排解
以下各節說明如何診斷及解決使用最佳化模式時的常見問題。
資料量過小
問題:模型訓練資料不足。您可能會看到錯誤訊息:
Fail to apply cost optimizations because the number of rows to process is too
small.
解決方案:將輸入內容的大小增加到至少錯誤訊息中顯示的資料列數量,並確認所有資料列都已正確產生有效的嵌入。
部分類別的樣本很少或沒有
問題:在取樣階段,特定類別或案例的樣本數量不足,導致無法訓練模型。
AI.CLASSIFY函式可能會顯示錯誤訊息:Failed to apply cost optimizations because the random training sample did not contain enough examples of all categories.AI.IF函式可能會顯示錯誤訊息:Failed to apply cost optimizations because the random training sample did not include enough examples of both true/false cases.
解決方法:
- 針對
AI.CLASSIFY:- 從
AI.CLASSIFY函式呼叫中移除罕見或空白類別。 - 將不常見的類別歸入更廣泛的類別,增加樣本數。
您可以使用
OTHER類別,將不屬於更具體類別的項目分組。不過,如果類別清單已完整,請勿新增OTHER,因為這個詞彙語意模糊,可能會造成混淆。
- 從
AI.IF:更新提示的篩選條件,確保輸入資料列能充分代表true和false兩種情況。如果條件符合幾乎所有資料列,或幾乎不符合任何資料列,就可能導致這項錯誤。
嵌入維度不一致
問題:各列的嵌入維度不一致。您可能會看到錯誤訊息:Failed to apply cost optimizations because the
embeddings have inconsistent dimensions.
解決方案:確認所有嵌入都是由相同模型生成,且嵌入向量長度相同。您可以使用類似下列的 SQL 查詢,檢查資料欄中的嵌入長度是否相同:
SELECT ARRAY_LENGTH(body_embedding.result), COUNT(*)
FROM `PROJECT_ID.DATASET.TABLE_NAME`
GROUP BY 1;
提示過於複雜
問題:蒸餾模型無法達到高精確度門檻。您可能會看到下列其中一則錯誤訊息:
Fail to apply cost optimizations because the distilled model does not
approximate LLM behavior well enough for some categories.
Fail to apply cost optimization because the prompt complexity is too high.
解決方法:
如果錯誤訊息列出 F1 分數偏低的類別,請先著重於這些類別。請調整名稱和說明,清楚區分其他類別。
使用一組類別來形成分區。確保類別之間的重疊程度最低,且涵蓋所有可能的輸入內容。
- 避免使用重疊的類別,以免輸入內容可能同時屬於多個類別。例如,請避免使用
['terrible', 'bad', 'okay', 'good', 'excellent']等類別。 - 避免出現不適用任何類別的空檔。舉例來說,類別清單
['bad', 'average']不涵蓋表達讚美的評論。 提供類別說明,引導 LLM 解決類別之間的模糊地帶。例如:
AI.CLASSIFY(
  review,
  categories => [
    ('terrible', 'Review where customer was not happy and the message indicates they will never try this product again'),
    ('bad', 'Review where customer was not happy but suggested improvements to the product'),
    ('okay', 'Review where customer was neutral about the product. Short reviews qualify for this category'),
    ('good', 'Review where customers were happy using this product but had minor critiques'),
    ('excellent', 'Review where customers were very happy using this product and will recommend others to try it too')],
  embeddings => review_embeddings)
- 避免使用重疊的類別,以免輸入內容可能同時屬於多個類別。例如,請避免使用
試用更進階的嵌入模型,例如
text-embedding-005或gemini-embedding-2。如需其他偵錯協助,請傳送電子郵件至 bqml-feedback@google.com。
LLM 處理的資料列數量不符預期
問題:查詢執行統計資料顯示,遠端 LLM 處理的資料列數量高於預期,而非精煉模型。可能原因如下:
- 精煉模型已訓練成功,但部分資料列缺少嵌入。這些資料列會由遠端 LLM 處理。
- 精煉模型無法套用至每個資料列,因此必須改用遠端 LLM,才能維持一致的品質。
解決方案:確認嵌入已正確產生,且資料中的所有資料列都有效。如果問題持續發生,請與 bqml-feedback@google.com 聯絡,以便偵錯。
未偵測到自主嵌入欄
問題:BigQuery 偵測不到自主嵌入資料欄。如果指令碼使用臨時資料表,且原始資料表的參照遺失,就可能發生這種情況。
解決方案:使用 embeddings 參數明確傳遞自主嵌入資料欄 (例如 embeddings => content_embedding.result),觸發成本最佳化。
後續步驟
- 進一步瞭解 BigQuery 中的生成式 AI。
- 進一步瞭解如何在 BigQuery 中使用每日配額控管生成式 AI 費用。
- 請參閱
AI.IF函式說明文件。 - 請參閱
AI.CLASSIFY函式說明文件。