


Kosten für KI-Funktionen mit Modelldestillation optimieren
In diesem Dokument wird beschrieben, wie Sie den optimierten Modus für verwaltete KI-Funktionen in BigQuery verwenden. Mit dem optimierten Modus können Sie große Datasets mit Tausenden oder sogar Milliarden von Zeilen verarbeiten. Dabei werden im Vergleich zur standardmäßigen zeilenweisen LLM-Inferenz deutlich weniger Tokens für Large Language Models (LLMs) verbraucht und die Abfragelatenz ist geringer. Diese Optimierung gilt nur für die Funktionen AI.IF und AI.CLASSIFY.
Wenn Sie ein Limit für den gesamten Tokenverbrauch festlegen möchten, um Budgetüberschreitungen zu vermeiden, anstatt die Tokeneffizienz Ihrer Abfragen zu optimieren, lesen Sie stattdessen Kosten mit Tokenkontingenten kontrollieren.
Um Ihren Tokenverbrauch besser nachvollziehen zu können, können Sie sich in derGoogle Cloud Console die Anzahl der von einer Abfrage verwendeten Tokens ansehen. Wenn Sie diese Nutzung vor dem Ausführen einer Abfrage schätzen möchten, verwenden Sie die Funktion AI.COUNT_TOKENS.
Im folgenden Beispiel wird gezeigt, wie Sie die Funktion AI.IF im optimierten Modus verwenden, um Nachrichtenartikel über Naturkatastrophen zu identifizieren. Dabei wird text-embedding-005 als Einbettungsmodell verwendet:
SELECT
  title,
  body,
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    -- Optional, 'MINIMIZE_COST' is the default when embeddings are provided.
    optimization_mode => 'MINIMIZE_COST'
   ) AS is_natural_disaster
FROM
  `bigquery-public-data.bbc_news.fulltext`;
Mit dem Argument optimization_mode => 'MINIMIZE_COST' wird der optimierte Modus aktiviert. Dies ist die Standardeinstellung, wenn Einbettungen bereitgestellt werden. Sie können dieses Argument also weglassen.
In diesem Beispiel werden Einbettungen on the fly generiert. In der Praxis empfehlen wir, Einbettungen zu materialisieren, damit sie wiederverwendet werden können.
Funktionsweise des optimierten Modus
Die verwalteten KI-Funktionen AI.IF und AI.CLASSIFY rufen in der Regel für jede Zeile in Ihrem Dataset ein Remote-LLM auf. Wenn Sie den optimierten Modus verwenden, trainiert BigQuery während der Abfrageausführung automatisch ein einfaches, destilliertes Modell.
Der Prozess funktioniert so:
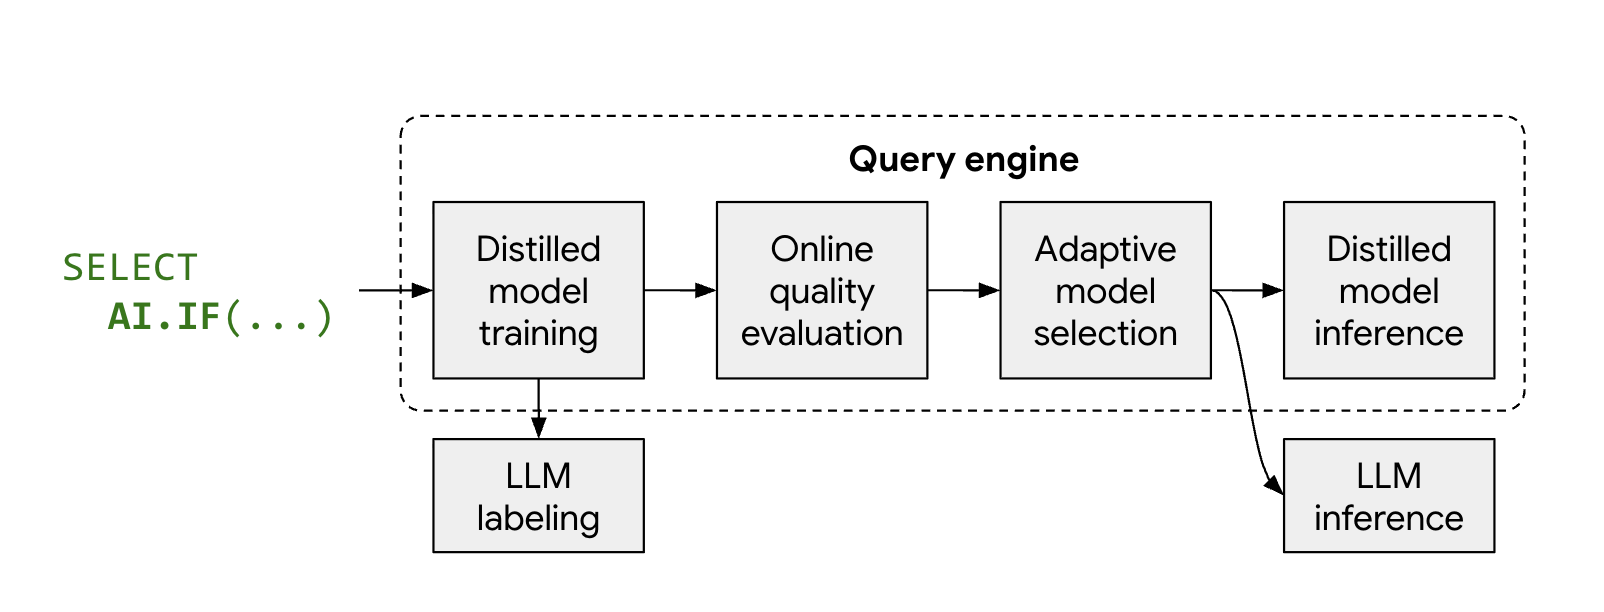
- Stichprobenerhebung und Labeling: BigQuery wählt eine kleine repräsentative Stichprobe Ihrer Daten aus und ruft Gemini auf, um Labels bereitzustellen.
- Training des destillierten Modells: Ein lokales destilliertes Modell wird Just-in-Time mit den LLM-Labels und Dateneinbettungen als Features trainiert.
- Qualitätsprüfung: BigQuery bewertet die Genauigkeit des destillierten Modells im Vergleich zu den Ergebnissen des LLM. Wenn das destillierte Modell den erforderlichen Qualitätsschwellenwert nicht erreicht, schlägt die Abfrage standardmäßig mit einem Fehler fehl, der erklärt, warum das Modell verworfen wurde. Wenn das Modell eine akzeptable Qualität hat, kann BigQuery für bestimmte Zeilen dennoch auf das Remote-LLM zurückgreifen, um eine konsistente Qualität zu gewährleisten, oder für Zeilen, die keine gültigen Einbettungen haben.
- Inferenz: Das destillierte Modell verarbeitet die meisten Zeilen, wodurch die Anzahl der Gemini-Aufrufe erheblich reduziert wird.
Beschränkungen
Für den optimierten Modus gelten die folgenden Einschränkungen:
- Mindestanzahl von Zeilen: Die Eingabe für die KI-Funktion muss etwa 3.000 Zeilen enthalten,damit genügend Daten für das Modelltraining vorhanden sind.
- Datentypen: Bei Prompts, die auf mehrere Spalten verweisen, werden nur Stringspalten für die Optimierung unterstützt.
- Klassifizierung mit mehreren Labels:
AI.CLASSIFYmitoutput_mode => 'multi'wird im optimierten Modus nicht unterstützt. - Funktionsunterstützung: Nur die Funktionen
AI.IFundAI.CLASSIFYunterstützen den optimierten Modus. Wenn Sie den optimierten Modus mitAI.CLASSIFYverwenden, können Abfragen jedoch fehlschlagen, wenn die Qualität des destillierten Modells nicht ausreicht. - Fehlerquote: Das Argument
max_error_ratiowird im optimierten Modus nicht unterstützt.
Hinweis
Informationen zu den Berechtigungen, die Sie zum Ausführen verwalteter KI-Funktionen in BigQuery benötigen, finden Sie unter Berechtigungen für generative KI-Funktionen festlegen, die Gemini Enterprise Agent Platform-LLMs aufrufen.
Einbettungsmodell auswählen
Wenn Sie den optimierten Modus verwenden möchten, müssen Sie Einbettungen für Ihre Daten berechnen und der KI-Funktion zur Verfügung stellen. Damit Eingabespalten verknüpfte Einbettungen haben, müssen alle Zeilen einheitliche Einbettungsdimensionen haben und vom selben Einbettungsmodell generiert werden.
Für ein optimales Preis-Leistungs-Verhältnis und eine gute Skalierbarkeit empfehlen wir, Einbettungen für Ihre Daten mit einem Einbettungsmodell wie text-embedding-005 oder den Gemini-Einbettungen für englische oder mehrsprachige Aufgaben zu berechnen. Für multimodale Daten (Text und Bilder) empfehlen wir die Verwendung eines multimodalen Einbettungsmodells wie Gemini Embedding 2 (gemini-embedding-2).
Einbettungen generieren
Sie können Einbettungen für Ihre Daten mithilfe der von BigQuery verwalteten autonomen Generierung oder durch manuelles Erstellen der Einbettungsspalten berechnen.
In den folgenden Abschnitten wird beschrieben, wie Sie beide Ansätze mit den Funktionen AI.CLASSIFY und AI.IF verwenden.
Autonome Einbettungsgenerierung
Wenn Sie die autonome Einbettungsgenerierung verwenden, verwendet BigQuery die Einbettungen automatisch, wenn AI.IF oder AI.CLASSIFY aufgerufen wird. Dies ist der empfohlene Ansatz, ist aber auf eine Einbettungsspalte pro Tabelle beschränkt.
Im folgenden Beispiel wird eine Tabelle mit einer automatisch generierten Einbettungsspalte erstellt. Dabei wird text-embedding-005 als Einbettungsmodell verwendet. Anschließend wird die Funktion AI.CLASSIFY verwendet, um die Daten zu kategorisieren:
-- Create a table with an autonomously generated embedding column
CREATE TABLE my_dataset.bbc_news (
  title STRING,
  body STRING,
  body_embedding STRUCT<result ARRAY<FLOAT64>, status STRING>
    GENERATED ALWAYS AS (
      AI.EMBED(
        body,
        connection_id => '<my_connection_id>',
        task_type => 'CLASSIFICATION',
        endpoint => 'text-embedding-005')
    ) STORED
    OPTIONS(asynchronous = TRUE)
);

-- Insert data into the table
INSERT INTO my_dataset.bbc_news (title, body)
SELECT title, body FROM `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query.
-- Wait for the background job to finish generating embeddings before running.
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other']
  ) AS category
FROM
  my_dataset.bbc_news;
Manuelle Spaltenspezifikation
Wenn Sie eine vorhandene Einbettungsspalte haben, geben Sie sie im Argument embeddings von AI.IF oder AI.CLASSIFY an. Sie können diesen mit der Funktion AI.EMBED generieren.
Im folgenden Beispiel wird gezeigt, wie Sie eine Tabelle mit einer Einbettungsspalte erstellen, wobei text-embedding-005 als Einbettungsmodell verwendet wird, und diese Spalte dann in einer AI.CLASSIFY-Abfrage verwenden:
-- Create a table with an embedding column
CREATE TABLE my_dataset.bbc_news AS
SELECT
  title,
  body,
  AI.EMBED(
    body,
    endpoint => 'text-embedding-005',
    task_type => 'CLASSIFICATION'
  ).result AS body_embedding
FROM
  `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other'],
    embeddings => body_embedding,
  ) AS category
FROM
  my_dataset.bbc_news;
Wenn Ihr Prompt auf mehrere Spalten verweist, geben Sie im Argument embeddings eine Liste mit Spaltennamen und den entsprechenden Einbettungen an. Beispiel: embeddings => [('body', body_embedding), ('title', title_embedding)].
Abfrageoptimierung überwachen
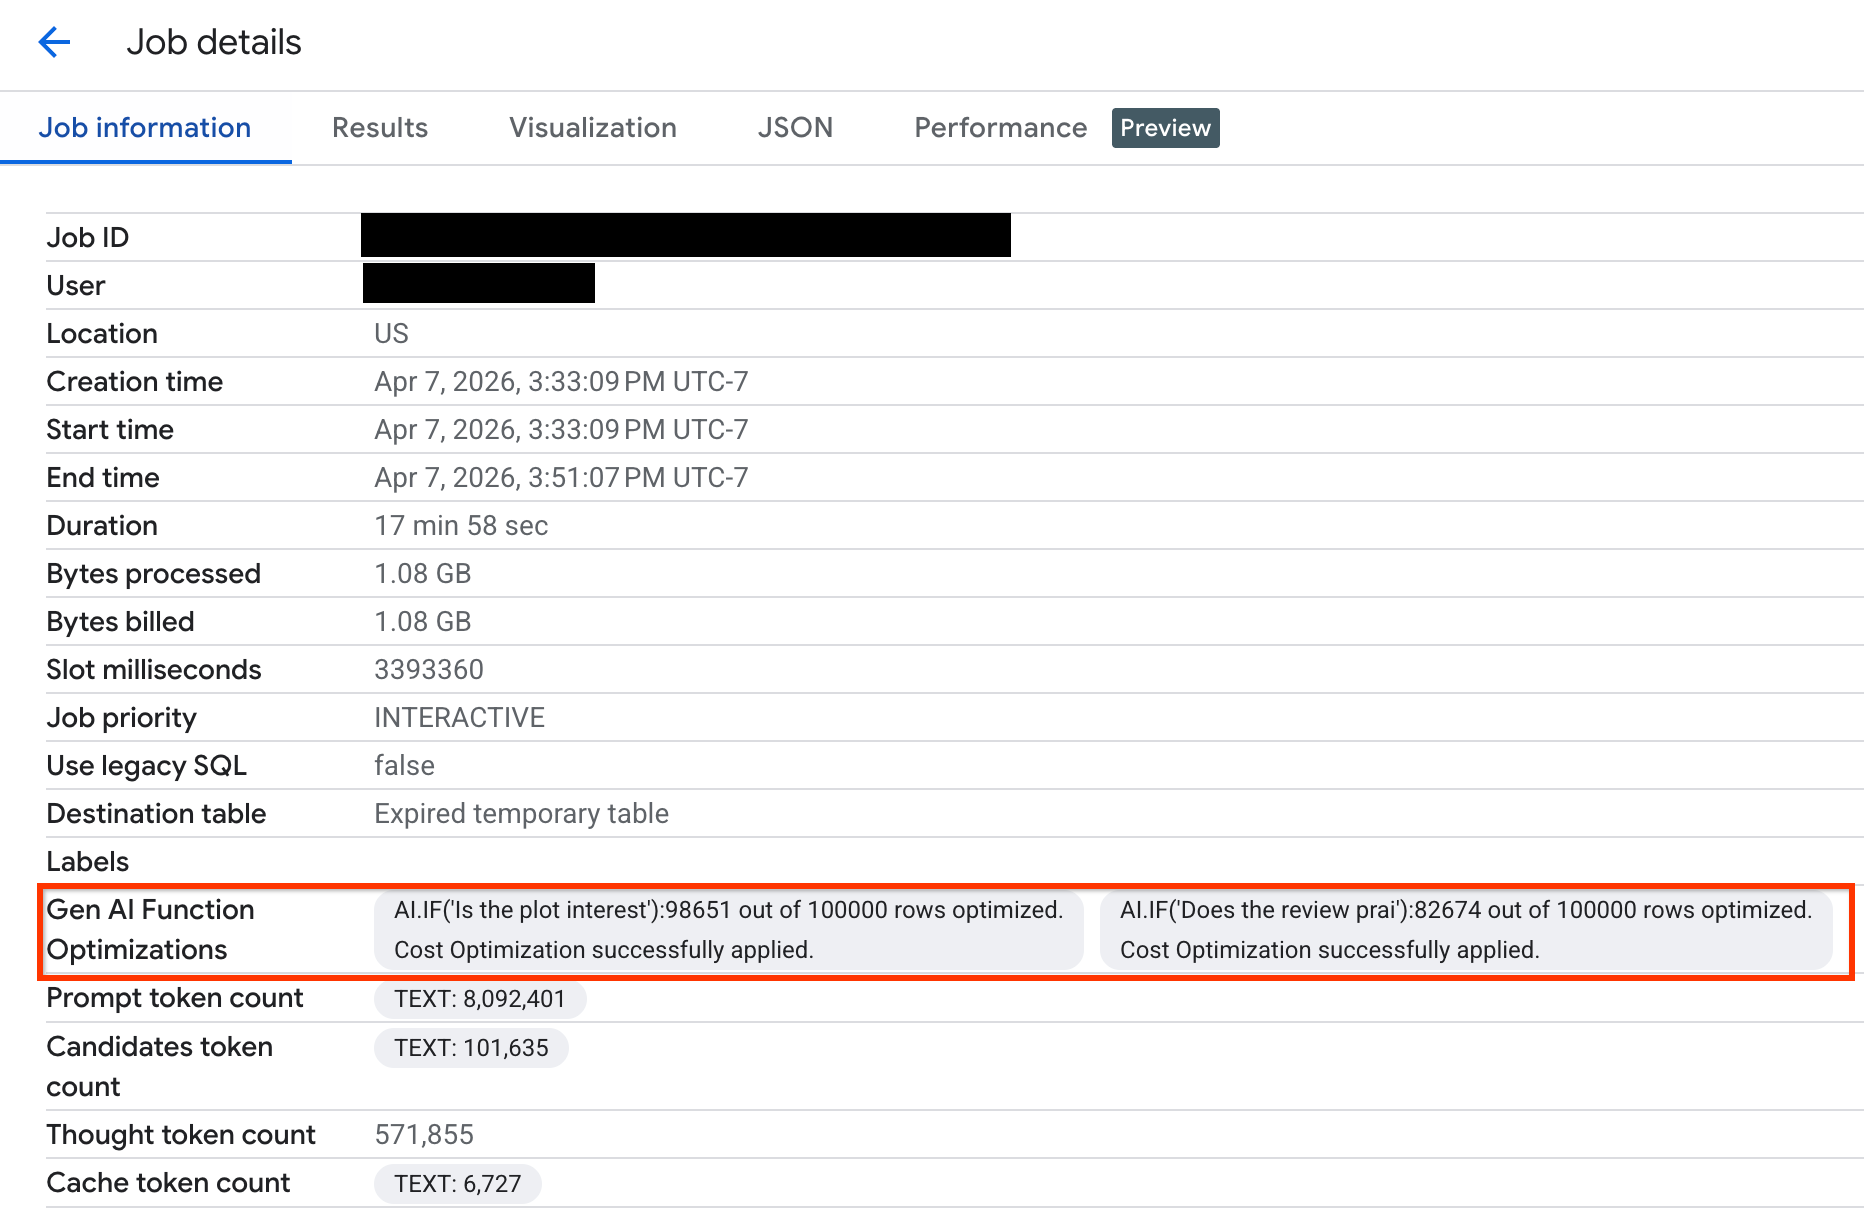
Wenn Sie prüfen möchten, wie viele Zeilen während der Abfrageausführung optimiert wurden, können Sie die Ausführungsstatistiken in der Google Cloud Console oder über die API aufrufen:
Console
So rufen Sie die Anzahl der optimierten Zeilen und Systemmeldungen zum Optimierungsstatus auf:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Job-Explorer.
Klicken Sie auf die Job-ID, um den Bereich Jobdetails aufzurufen.
Klicken Sie auf den Tab Jobinformationen und sehen Sie sich die Messwerte und den Status im Feld Optimierungen für Funktionen der generativen KI an.
API
Prüfen Sie den FunctionGenAiCostOptimizationStats im GenAIFunctionStats-Objekt der Jobmetadaten. Dieses Objekt enthält die Anzahl der Zeilen, die durch den optimierten Workflow abgeleitet wurden, und vom System generierte Nachrichten, die Einblicke in den Optimierungsstatus geben.
Fehlerbehebung
In den folgenden Abschnitten wird beschrieben, wie Sie häufige Probleme bei der Verwendung des optimierten Modus diagnostizieren und beheben können.
Datenmenge ist zu klein
Problem: Unzureichende Daten für das Modelltraining. Möglicherweise wird die folgende Fehlermeldung angezeigt:
Fail to apply cost optimizations because the number of rows to process is too
small.
Lösung: Erhöhen Sie die Größe Ihrer Eingabe auf mindestens die Anzahl der Zeilen, die in der Fehlermeldung angezeigt wird, und prüfen Sie, ob für alle Zeilen gültige Einbettungen generiert wurden.
Wenige oder keine Beispiele in einigen Klassen
Problem: Unzureichende Anzahl von Stichproben für bestimmte Kategorien oder Fälle während der Stichprobenphase, was das Modelltraining verhindert.
- Bei der Funktion
AI.CLASSIFYwird möglicherweise die FehlermeldungFailed to apply cost optimizations because the random training sample did not contain enough examples of all categories.angezeigt. - Bei der Funktion
AI.IFwird möglicherweise die FehlermeldungFailed to apply cost optimizations because the random training sample did not include enough examples of both true/false cases.angezeigt.
Lösung:
- Für
AI.CLASSIFY:- Entfernen Sie seltene oder leere Kategorien aus dem Funktionsaufruf
AI.CLASSIFY. - Fassen Sie seltene Kategorien in einer breiteren Kategorie zusammen, um die Stichprobengröße zu erhöhen.
Sie können eine
OTHER-Kategorie verwenden, um Elemente zu gruppieren, die nicht von spezifischeren Kategorien abgedeckt werden. Fügen Sie jedoch nichtOTHERhinzu, wenn Ihre Liste der Kategorien bereits vollständig ist, da dieser Begriff mehrdeutig ist und zu Verwirrung führen kann.
- Entfernen Sie seltene oder leere Kategorien aus dem Funktionsaufruf
- Für
AI.IF: Aktualisieren Sie die Filterbedingung des Prompts, sodass sowohltrue- als auchfalse-Fälle in den Eingabezeilen gut dargestellt werden. Eine Bedingung, die fast alle oder fast keine Zeilen abgleicht, kann diesen Fehler verursachen.
Einbettungen haben inkonsistente Dimensionen
Problem: Inkonsistenzen zwischen Einbettungsdimensionen in verschiedenen Zeilen. Möglicherweise wird die folgende Fehlermeldung angezeigt: Failed to apply cost optimizations because the
embeddings have inconsistent dimensions.
Lösung: Prüfen Sie, ob alle Einbettungen vom selben Modell generiert wurden und dieselbe Einbettungsvektorlänge haben. Mit einer SQL-Abfrage wie der folgenden können Sie prüfen, ob die Einbettungen in einer Spalte dieselbe Länge haben:
SELECT ARRAY_LENGTH(body_embedding.result), COUNT(*)
FROM `PROJECT_ID.DATASET.TABLE_NAME`
GROUP BY 1;
Der Prompt ist zu komplex
Problem: Das destillierte Modell kann keinen hohen Genauigkeitsschwellenwert erreichen. Möglicherweise wird eine der folgenden Fehlermeldungen angezeigt:
Fail to apply cost optimizations because the distilled model does not
approximate LLM behavior well enough for some categories.
Fail to apply cost optimization because the prompt complexity is too high.
Lösung:
Wenn in der Fehlermeldung Kategorien mit niedrigen F1-Werten aufgeführt sind, konzentrieren Sie sich zuerst auf diese Kategorien. Passen Sie die Namen und Beschreibungen an, damit sie sich klar von den anderen Kategorien unterscheiden.
Verwenden Sie eine Reihe von Kategorien, die eine Partition bilden. Achten Sie darauf, dass sich die Kategorien so wenig wie möglich überschneiden und alle möglichen Eingaben abdecken.
- Vermeiden Sie sich überschneidende Kategorien, bei denen eine Eingabe gleichzeitig zu mehreren Kategorien gehören könnte. Vermeiden Sie beispielsweise Kategorien wie
['terrible', 'bad', 'okay', 'good', 'excellent']. - Vermeiden Sie Lücken, in denen keine Kategorien zutreffen. Die Liste der Kategorien
['bad', 'average']deckt beispielsweise keine Rezension ab, in der Lob geäußert wird. Geben Sie Kategoriebeschreibungen an, um dem LLM zu helfen, Mehrdeutigkeiten zwischen Kategorien aufzulösen. Beispiel:
AI.CLASSIFY(
  review,
  categories => [
    ('terrible', 'Review where customer was not happy and the message indicates they will never try this product again'),
    ('bad', 'Review where customer was not happy but suggested improvements to the product'),
    ('okay', 'Review where customer was neutral about the product. Short reviews qualify for this category'),
    ('good', 'Review where customers were happy using this product but had minor critiques'),
    ('excellent', 'Review where customers were very happy using this product and will recommend others to try it too')],
  embeddings => review_embeddings)
- Vermeiden Sie sich überschneidende Kategorien, bei denen eine Eingabe gleichzeitig zu mehreren Kategorien gehören könnte. Vermeiden Sie beispielsweise Kategorien wie
Probieren Sie erweiterte Einbettungsmodelle wie
text-embedding-005odergemini-embedding-2aus.Wenden Sie sich an bqml-feedback@google.com, um weitere Unterstützung bei der Fehlerbehebung zu erhalten.
Unerwartete Anzahl von Zeilen, die vom LLM verarbeitet wurden
Problem: Die Abfrageausführungsstatistiken zeigen, dass eine unerwartet hohe Anzahl von Zeilen vom Remote-LLM anstelle des destillierten Modells verarbeitet wurde. Das kann folgende Gründe haben:
- Das destillierte Modell wurde erfolgreich trainiert, aber in einigen Zeilen fehlten Einbettungen. Diese Zeilen werden vom Remote-LLM verarbeitet.
- Das destillierte Modell konnte nicht auf jede Zeile angewendet werden und musste auf das Remote-LLM zurückgreifen, um eine gleichbleibende Qualität zu gewährleisten.
Lösung: Prüfen Sie, ob Einbettungen für alle Zeilen in Ihren Daten ordnungsgemäß generiert und gültig sind. Wenn das Problem weiterhin besteht, wenden Sie sich zur Fehlerbehebung an bqml-feedback@google.com.
Spalte für autonome Einbettung nicht erkannt
Problem: BigQuery kann keine Spalte für autonome Einbettungen erkennen. Dies kann passieren, wenn Ihr Skript eine temporäre Tabelle verwendet und der Verweis auf die ursprüngliche Tabelle verloren geht.
Lösung: Verwenden Sie den Parameter embeddings, um explizit eine autonome Einbettungsspalte zu übergeben, z. B. embeddings => content_embedding.result, wodurch die Kostenoptimierung ausgelöst wird.
Nächste Schritte
- Weitere Informationen zu generativer KI in BigQuery
- Weitere Informationen zum Kontrollieren der Kosten für generative KI mit täglichen Kontingenten in BigQuery
- Weitere Informationen finden Sie in der Dokumentation zur Funktion
AI.IF. - Weitere Informationen finden Sie in der Dokumentation zur Funktion
AI.CLASSIFY.