


Otimizar os custos das funções de IA com a destilação de modelos
Neste documento, descrevemos como usar o modo otimizado para funções de IA gerenciadas no BigQuery. É possível usar o modo otimizado para processar
conjuntos de dados em grande escala com milhares ou até bilhões de linhas, com
uma redução significativa no consumo de tokens de modelos de linguagem grandes (LLMs) e na latência de consulta
em comparação com a inferência de LLM padrão por linha. Essa otimização só se aplica às funções AI.IF e AI.CLASSIFY.
Se você quiser definir um limite para o consumo total de tokens para evitar estouros de orçamento, em vez de otimizar a eficiência de tokens das suas consultas, consulte Controlar custos com cotas de tokens.
Para entender melhor o consumo de tokens, confira o número de tokens
usados por uma consulta no
console do
Google Cloud . Para estimar esse uso antes de executar uma consulta, use a
função AI.COUNT_TOKENS.
O exemplo a seguir demonstra como usar a função AI.IF
com o modo otimizado para identificar notícias sobre desastres naturais, usando text-embedding-005
como o modelo de embedding:
SELECT
  title,
  body,
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    -- Optional, 'MINIMIZE_COST' is the default when embeddings are provided.
    optimization_mode => 'MINIMIZE_COST'
   ) AS is_natural_disaster
FROM
  `bigquery-public-data.bbc_news.fulltext`;
O argumento optimization_mode => 'MINIMIZE_COST' ativa o modo otimizado. Essa é a configuração padrão quando os embeddings são fornecidos, então é possível omitir
esse argumento.
Neste exemplo, os embeddings são gerados em tempo real. Na prática, recomendamos que você materialize embeddings para que eles possam ser reutilizados.
Como funciona o modo otimizado
As funções de IA gerenciadas, AI.IF e AI.CLASSIFY, normalmente chamam um
LLM remoto para cada linha no conjunto de dados. Quando você usa o modo otimizado,
o BigQuery treina automaticamente um modelo leve e destilado
durante a execução da consulta.
O processo funciona da seguinte maneira:
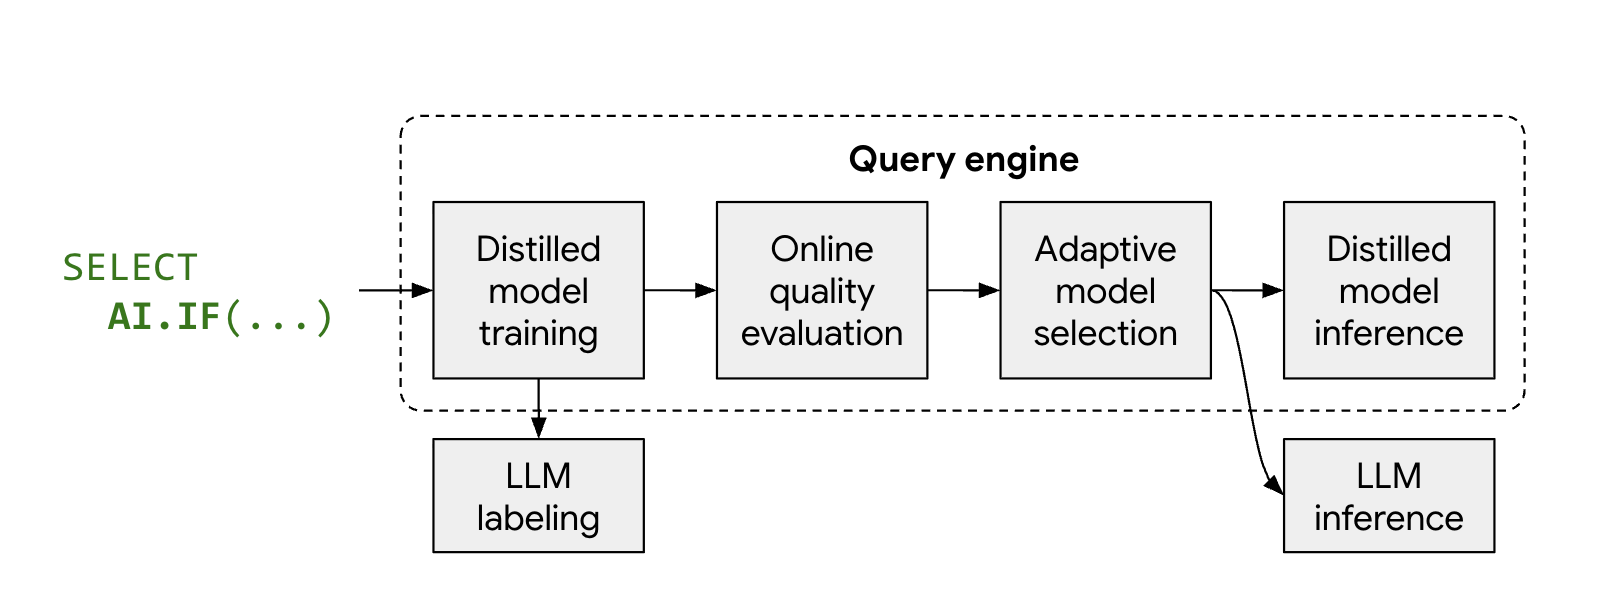
- Amostragem e rotulagem: o BigQuery seleciona uma pequena amostra representativa dos seus dados e chama o Gemini para fornecer rótulos.
- Treinamento de modelo destilado: um modelo destilado local é treinado em tempo real usando os rótulos do LLM e os embeddings de dados como atributos.
- Verificação de qualidade: o BigQuery avalia a acurácia do modelo destilado em relação aos resultados do LLM. Por padrão, se o modelo destilado não atender ao limite de qualidade exigido, a consulta vai falhar com um erro explicando por que o modelo foi descartado. Se o modelo for de qualidade aceitável, o BigQuery ainda poderá usar o LLM remoto para linhas específicas para manter a qualidade consistente ou para linhas sem embeddings válidos.
- Inferência: o modelo destilado processa a maioria das linhas, reduzindo significativamente o número de chamadas do Gemini.
Limitações
O modo otimizado tem as seguintes limitações:
- Contagem mínima de linhas: a entrada para a função de IA precisa conter aproximadamente 3.000 linhas para garantir dados suficientes para treinamento de modelo.
- Tipos de dados: para comandos que fazem referência a várias colunas, apenas colunas de string são compatíveis com a otimização.
- Classificação de vários rótulos:
AI.CLASSIFYcomoutput_mode => 'multi'não é compatível com o modo otimizado. - Suporte a funções: somente as funções
AI.IFeAI.CLASSIFYsão compatíveis com o modo otimizado. No entanto, ao usar o modo otimizado comAI.CLASSIFY, as consultas podem falhar se a qualidade do modelo destilado for insuficiente. - Proporção de erros: o argumento
max_error_rationão é compatível com o modo otimizado.
Antes de começar
Para receber as permissões necessárias para executar funções de IA gerenciadas no BigQuery, consulte Definir permissões para funções de IA generativa que chamam LLMs da Gemini Enterprise Agent Platform.
Escolher um modelo de embedding
Para usar o modo otimizado, é necessário calcular os embeddings dos dados e fornecê-los à função de IA. Para que as colunas de entrada tenham embeddings associados, todas as linhas precisam ter dimensões de embedding consistentes e ser geradas pelo mesmo modelo de embedding.
Para ter o melhor custo-benefício e escalonabilidade, recomendamos calcular embeddings para
seus dados usando um modelo de embedding, como
text-embedding-005 ou os embeddings do Gemini
para tarefas em inglês ou multilíngues. Para dados multimodais (texto e imagens), recomendamos o uso de um modelo de embedding multimodal, como o Gemini Embedding 2 (gemini-embedding-2).
Gerar embeddings
É possível calcular embeddings para seus dados usando a geração autônoma gerenciada pelo
BigQuery ou criando manualmente as colunas de embedding.
As seções a seguir descrevem como usar as duas abordagens com as funções AI.CLASSIFY e AI.IF.
Geração autônoma de embeddings
Se você usar a geração de embeddings autônomos,
o BigQuery vai usar os embeddings automaticamente quando AI.IF ou
AI.CLASSIFY forem chamados. Essa é a abordagem recomendada, mas é limitada a uma coluna de embedding por tabela.
O exemplo a seguir cria uma tabela com uma coluna de embedding gerada de forma autônoma, usando text-embedding-005 como o modelo de embedding, e depois usa a função AI.CLASSIFY para categorizar os dados:
-- Create a table with an autonomously generated embedding column
CREATE TABLE my_dataset.bbc_news (
  title STRING,
  body STRING,
  body_embedding STRUCT<result ARRAY<FLOAT64>, status STRING>
    GENERATED ALWAYS AS (
      AI.EMBED(
        body,
        connection_id => '<my_connection_id>',
        task_type => 'CLASSIFICATION',
        endpoint => 'text-embedding-005')
    ) STORED
    OPTIONS(asynchronous = TRUE)
);

-- Insert data into the table
INSERT INTO my_dataset.bbc_news (title, body)
SELECT title, body FROM `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query.
-- Wait for the background job to finish generating embeddings before running.
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other']
  ) AS category
FROM
  my_dataset.bbc_news;
Especificação manual de colunas
Se você tiver uma coluna de embedding, especifique-a no argumento embeddings de AI.IF ou AI.CLASSIFY. É possível gerar isso usando a
função AI.EMBED.
O exemplo a seguir demonstra como criar uma tabela com uma coluna de embedding, usando text-embedding-005 como o modelo de embedding, e usar essa coluna em uma consulta AI.CLASSIFY:
-- Create a table with an embedding column
CREATE TABLE my_dataset.bbc_news AS
SELECT
  title,
  body,
  AI.EMBED(
    body,
    endpoint => 'text-embedding-005',
    task_type => 'CLASSIFICATION'
  ).result AS body_embedding
FROM
  `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other'],
    embeddings => body_embedding,
  ) AS category
FROM
  my_dataset.bbc_news;
Se o comando fizer referência a várias colunas, forneça uma lista de nomes de colunas e
os embeddings correspondentes no argumento embeddings. Por exemplo, embeddings => [('body', body_embedding), ('title', title_embedding)].
Monitorar a otimização de consultas
Para verificar quantas linhas foram otimizadas durante a execução da consulta, confira as estatísticas de execução no console do Google Cloud ou pela API:
Console
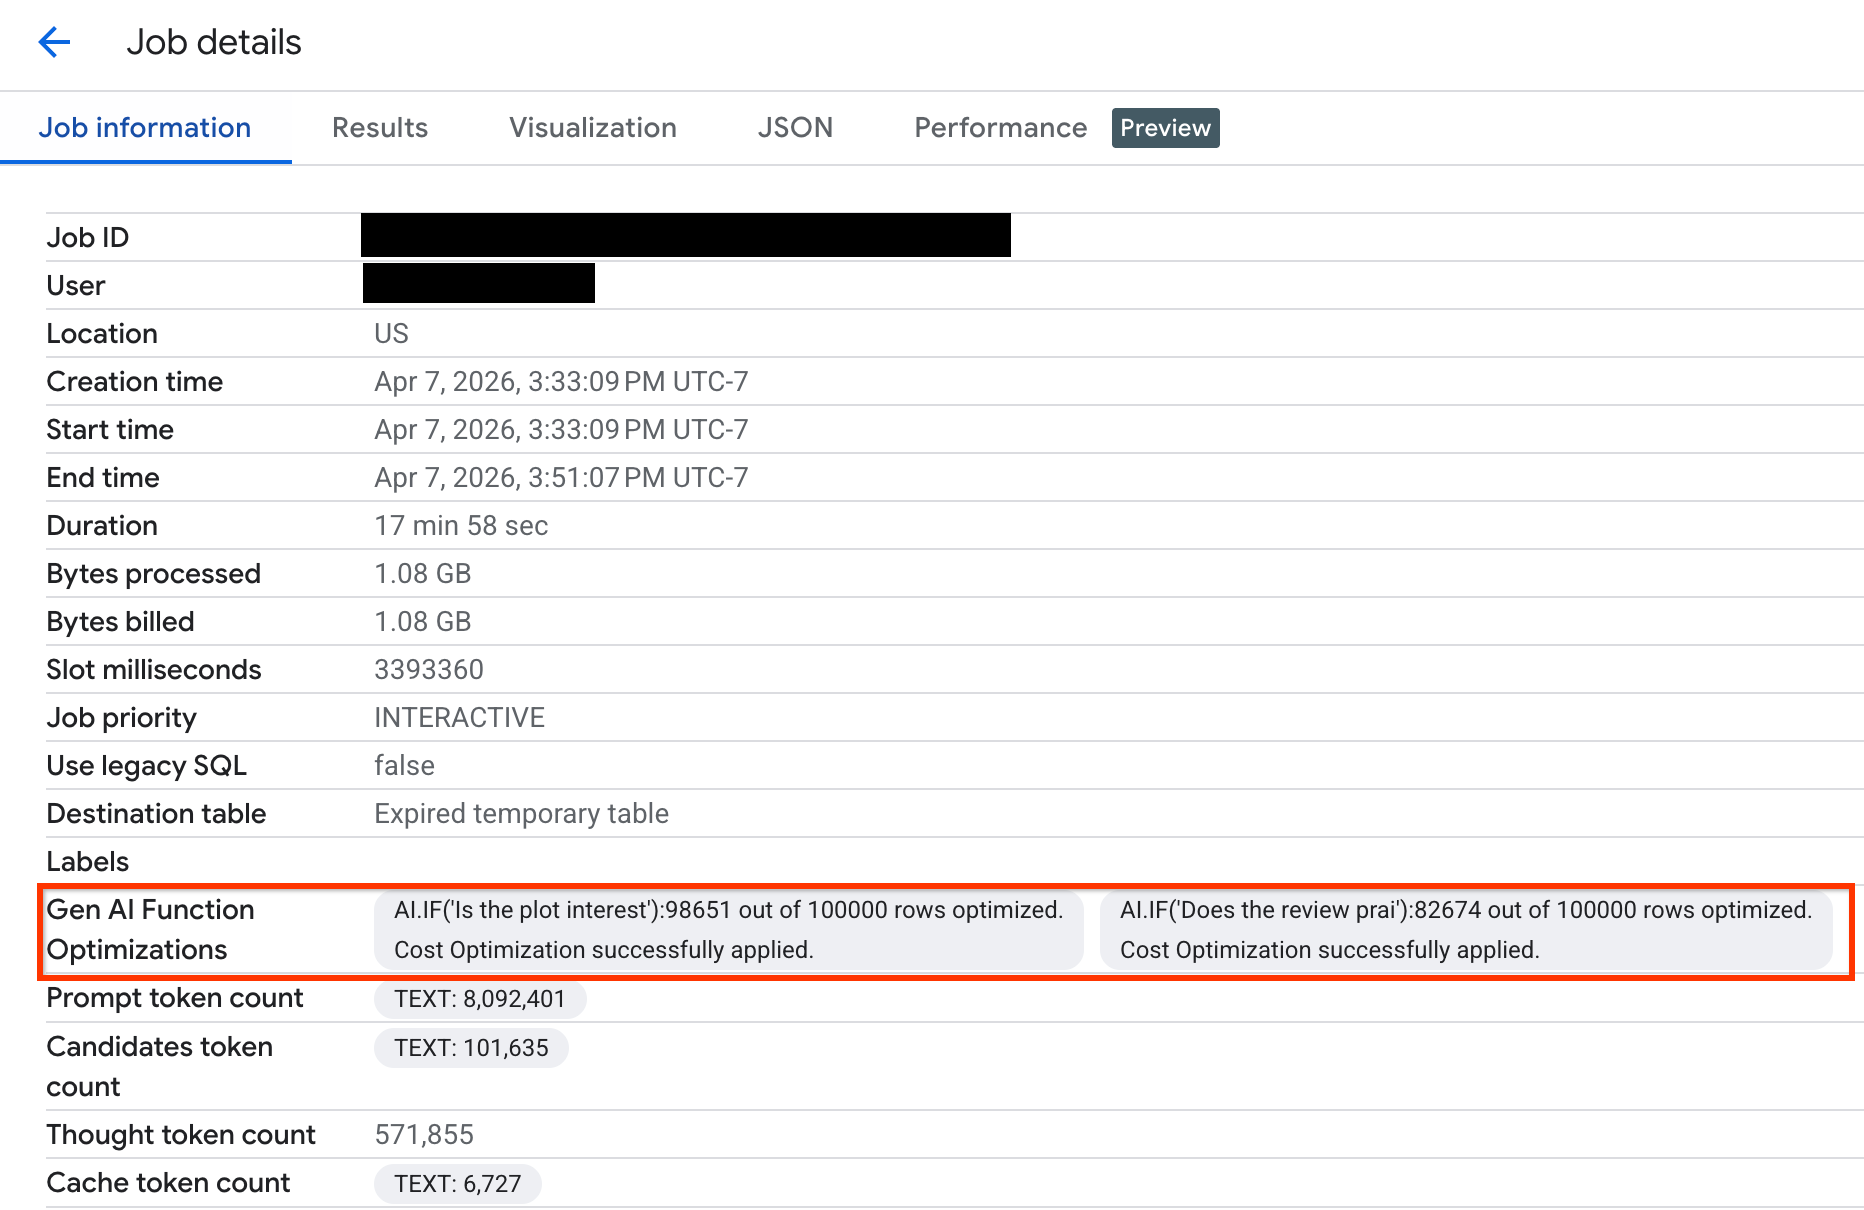
Para ver quantas linhas foram otimizadas e as mensagens do sistema sobre o status da otimização, faça o seguinte:
No console do Google Cloud , acesse a página BigQuery.
No menu de navegação, clique em Análise de jobs.
Clique no ID da tarefa para abrir o painel Detalhes do job.
Clique na guia Informações do job e confira as métricas e o status no campo Otimizações de função de IA generativa.
API
Verifique o FunctionGenAiCostOptimizationStats no objeto GenAIFunctionStats
dos metadados do job. Esse objeto inclui o número de linhas inferidas
pelo fluxo de trabalho otimizado e mensagens geradas pelo sistema que fornecem
insights sobre o estado da otimização.
Resolver problemas
As seções a seguir explicam como diagnosticar e resolver problemas comuns ao usar o modo otimizado.
O tamanho dos dados é muito pequeno
Problema: dados insuficientes para treinamento de modelo. Talvez você veja uma mensagem de erro:
Fail to apply cost optimizations because the number of rows to process is too
small.
Solução: aumente o tamanho da entrada para pelo menos o número de linhas mostrado na mensagem de erro e verifique se os embeddings válidos foram gerados corretamente para todas as linhas.
Poucas ou nenhuma amostra em algumas classes
Problema: número insuficiente de amostras para determinadas categorias ou casos durante a fase de amostragem, o que impede treinamento de modelo.
- Para a função
AI.CLASSIFY, talvez você veja uma mensagem de erro:Failed to apply cost optimizations because the random training sample did not contain enough examples of all categories. - Para a função
AI.IF, talvez você veja uma mensagem de erro:Failed to apply cost optimizations because the random training sample did not include enough examples of both true/false cases.
Solução:
- Para
AI.CLASSIFY:- Remova categorias raras ou vazias da chamada de função
AI.CLASSIFY. - Agrupe categorias raras em uma mais ampla para aumentar o tamanho da amostra.
É possível usar uma categoria
OTHERpara agrupar itens não cobertos por categorias mais específicas. No entanto, não adicioneOTHERse a lista de categorias já estiver completa, porque esse termo é ambíguo e pode causar confusão.
- Remova categorias raras ou vazias da chamada de função
- Para
AI.IF: atualize a condição de filtro do comando para que os casostrueefalsesejam bem representados nas linhas de entrada. Uma condição que corresponde a quase todas as linhas ou a quase nenhuma linha pode causar esse erro.
Os embeddings têm dimensões inconsistentes
Problema: inconsistências entre as dimensões de embedding nas linhas. Talvez
você veja uma mensagem de erro: Failed to apply cost optimizations because the
embeddings have inconsistent dimensions.
Solução: verifique se todos os embeddings são gerados pelo mesmo modelo e têm o mesmo comprimento de vetor de embedding. Use uma consulta SQL semelhante à seguinte para verificar se os embeddings em uma coluna têm o mesmo tamanho:
SELECT ARRAY_LENGTH(body_embedding.result), COUNT(*)
FROM `PROJECT_ID.DATASET.TABLE_NAME`
GROUP BY 1;
A complexidade do comando é muito alta
Problema: o modelo destilado não consegue atingir um limite de alta precisão. Talvez você veja uma das seguintes mensagens de erro:
Fail to apply cost optimizations because the distilled model does not
approximate LLM behavior well enough for some categories.
Fail to apply cost optimization because the prompt complexity is too high.
Solução:
Se a mensagem de erro listar categorias com pontuações F1 baixas, concentre-se primeiro nessas categorias. Refine os nomes e as descrições para que elas sejam claramente diferenciadas das outras categorias.
Use um conjunto de categorias que formam uma partição. Verifique se as categorias têm o mínimo de sobreposição e abrangem todas as entradas possíveis.
- Evite categorias sobrepostas em que uma entrada pode pertencer a várias categorias simultaneamente. Por exemplo, evite categorias como
['terrible', 'bad', 'okay', 'good', 'excellent']. - Evite lacunas em que nenhuma categoria se aplica. Por exemplo, a lista de
categorias
['bad', 'average']não abrange uma avaliação que expressa elogios. Forneça descrições de categoria para orientar o LLM a resolver ambiguidades entre categorias. Exemplo:
AI.CLASSIFY(
  review,
  categories => [
    ('terrible', 'Review where customer was not happy and the message indicates they will never try this product again'),
    ('bad', 'Review where customer was not happy but suggested improvements to the product'),
    ('okay', 'Review where customer was neutral about the product. Short reviews qualify for this category'),
    ('good', 'Review where customers were happy using this product but had minor critiques'),
    ('excellent', 'Review where customers were very happy using this product and will recommend others to try it too')],
  embeddings => review_embeddings)
- Evite categorias sobrepostas em que uma entrada pode pertencer a várias categorias simultaneamente. Por exemplo, evite categorias como
Teste modelos de embedding mais avançados, como
text-embedding-005ougemini-embedding-2.Entre em contato com bqml-feedback@google.com para receber mais ajuda com a depuração.
Número inesperado de linhas processadas pelo LLM
Problema: as estatísticas de execução da consulta mostram que um número inesperadamente alto de linhas foi processado pelo LLM remoto em vez do modelo destilado. Isso pode acontecer pelos seguintes motivos:
- O modelo destilado foi treinado, mas algumas linhas não tinham embeddings. Essas linhas são processadas pelo LLM remoto.
- Não foi possível aplicar o modelo destilado a cada linha, e foi necessário recorrer ao LLM remoto para manter a qualidade consistente.
Solução: verifique se os embeddings foram gerados corretamente e são válidos para todas as linhas dos dados. Se o problema persistir, entre em contato com bqml-feedback@google.com para depuração.
Coluna de embedding autônomo não detectada
Problema: o BigQuery não consegue detectar uma coluna de embedding autônomo. Isso pode ocorrer se o script usar uma tabela temporária e a referência à tabela original for perdida.
Solução: use o parâmetro embeddings para transmitir explicitamente uma coluna de embedding autônoma, por exemplo, embeddings => content_embedding.result, que aciona a otimização de custos.
A seguir
- Saiba mais sobre a IA generativa no BigQuery.
- Saiba mais sobre como controlar os custos da IA generativa com cotas diárias no BigQuery.
- Consulte a documentação da função
AI.IF. - Consulte a documentação da função
AI.CLASSIFY.