


Optimiser les coûts des fonctions d'IA avec la distillation de modèle
Ce document explique comment utiliser le mode optimisé pour les fonctions d'IA gérées dans BigQuery. Vous pouvez utiliser le mode optimisé pour traiter des ensembles de données à grande échelle contenant des milliers, voire des milliards de lignes, avec une consommation de jetons de grand modèle de langage (LLM) et une latence des requêtes considérablement réduites par rapport à l'inférence LLM standard par ligne. Cette optimisation ne s'applique qu'aux fonctions AI.IF et AI.CLASSIFY.
Si vous souhaitez définir une limite pour votre consommation totale de jetons afin d'éviter les dépassements de budget, plutôt que d'optimiser l'efficacité des jetons de vos requêtes, consultez plutôt Contrôler les coûts avec des quotas de jetons.
Pour mieux comprendre votre consommation de jetons, vous pouvez afficher le nombre de jetons utilisés par une requête dans la consoleGoogle Cloud . Pour estimer cette utilisation avant d'exécuter une requête, utilisez la fonction AI.COUNT_TOKENS.
L'exemple suivant montre comment utiliser la fonction AI.IF avec le mode optimisé pour identifier les articles d'actualité sur les catastrophes naturelles, en utilisant text-embedding-005 comme modèle d'embedding :
SELECT
  title,
  body,
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    -- Optional, 'MINIMIZE_COST' is the default when embeddings are provided.
    optimization_mode => 'MINIMIZE_COST'
   ) AS is_natural_disaster
FROM
  `bigquery-public-data.bbc_news.fulltext`;
L'argument optimization_mode => 'MINIMIZE_COST' active le mode optimisé. Il s'agit du paramètre par défaut lorsque des embeddings sont fournis. Vous pouvez donc omettre cet argument.
Dans cet exemple, les embeddings sont générés à la volée. En pratique, nous vous recommandons de matérialiser les embeddings afin qu'ils puissent être réutilisés.
Fonctionnement du mode optimisé
Les fonctions d'IA gérées, AI.IF et AI.CLASSIFY, appellent généralement un LLM distant pour chaque ligne de votre ensemble de données. Lorsque vous utilisez le mode optimisé, BigQuery entraîne automatiquement un modèle léger et distillé pendant l'exécution de la requête.
La procédure est la suivante :
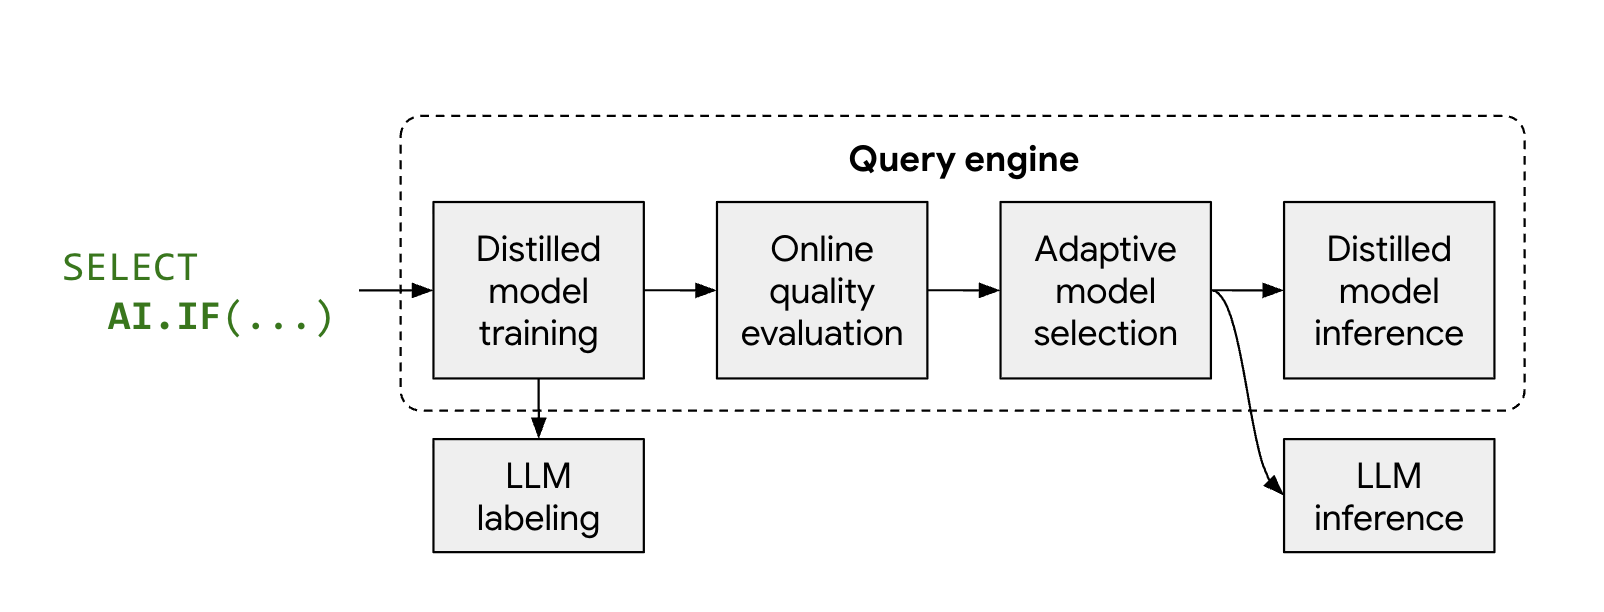
- Échantillonnage et étiquetage : BigQuery sélectionne un petit échantillon représentatif de vos données et appelle Gemini pour fournir des étiquettes.
- Entraînement du modèle distillé : un modèle distillé local est entraîné juste-à-temps à l'aide des étiquettes du LLM et des embeddings de données en tant que caractéristiques.
- Contrôle qualité : BigQuery évalue la précision du modèle distillé par rapport aux résultats du LLM. Par défaut, si le modèle distillé ne respecte pas le seuil de qualité requis, la requête échoue avec une erreur expliquant pourquoi le modèle a été rejeté. Si le modèle est d'une qualité acceptable, BigQuery peut toujours utiliser le LLM distant pour des lignes spécifiques afin de maintenir une qualité constante, ou pour les lignes ne disposant pas d'embeddings valides.
- Inférence : le modèle distillé traite la majorité des lignes, ce qui réduit considérablement le nombre d'appels Gemini.
Limites
Le mode optimisé présente les limites suivantes :
- Nombre minimal de lignes : l'entrée de la fonction AI doit contenir environ 3 000 lignes pour garantir que le modèle dispose de suffisamment de données pour l'entraînement.
- Types de données : pour les requêtes qui font référence à plusieurs colonnes, seules les colonnes de chaîne sont compatibles avec l'optimisation.
- Classification multi-étiquette :
AI.CLASSIFYavecoutput_mode => 'multi'n'est pas compatible avec le mode optimisé. - Compatibilité des fonctions : seules les fonctions
AI.IFetAI.CLASSIFYsont compatibles avec le mode optimisé. Toutefois, lorsque vous utilisez le mode optimisé avecAI.CLASSIFY, les requêtes peuvent échouer si la qualité du modèle distillé est insuffisante. - Taux d'erreur : l'argument
max_error_ration'est pas compatible avec le mode optimisé.
Avant de commencer
Pour obtenir les autorisations nécessaires pour exécuter des fonctions d'IA gérées dans BigQuery, consultez Définir des autorisations pour les fonctions d'IA générative qui appellent les LLM Gemini Enterprise Agent Platform.
Choisir un modèle d'embedding
Pour utiliser le mode optimisé, vous devez calculer les embeddings de vos données et les fournir à la fonction d'IA. Pour que les colonnes d'entrée soient associées à des embeddings, toutes les lignes doivent avoir des dimensions d'embedding cohérentes et être générées par le même modèle d'embedding.
Pour un rapport coût-qualité et une évolutivité optimaux, nous vous recommandons de calculer les embeddings de vos données à l'aide d'un modèle d'embedding, tel que text-embedding-005 ou les embeddings Gemini pour les tâches en anglais ou multilingues. Pour les données multimodales (texte et images), nous vous recommandons d'utiliser un modèle d'embedding multimodal tel que Gemini Embedding 2 (gemini-embedding-2).
Générer des embeddings
Vous pouvez calculer des embeddings pour vos données à l'aide de la génération autonome gérée par BigQuery ou en créant manuellement les colonnes d'embeddings.
Les sections suivantes décrivent comment utiliser les deux approches avec les fonctions AI.CLASSIFY et AI.IF.
Génération d'embeddings autonomes
Si vous utilisez la génération d'embeddings autonome, BigQuery utilise automatiquement les embeddings lorsque AI.IF ou AI.CLASSIFY sont appelés. Il s'agit de l'approche recommandée, mais elle est limitée à une colonne d'embedding par table.
L'exemple suivant crée une table avec une colonne d'embeddings générée de manière autonome, en utilisant text-embedding-005 comme modèle d'embeddings, puis utilise la fonction AI.CLASSIFY pour catégoriser les données :
-- Create a table with an autonomously generated embedding column
CREATE TABLE my_dataset.bbc_news (
  title STRING,
  body STRING,
  body_embedding STRUCT<result ARRAY<FLOAT64>, status STRING>
    GENERATED ALWAYS AS (
      AI.EMBED(
        body,
        connection_id => '<my_connection_id>',
        task_type => 'CLASSIFICATION',
        endpoint => 'text-embedding-005')
    ) STORED
    OPTIONS(asynchronous = TRUE)
);

-- Insert data into the table
INSERT INTO my_dataset.bbc_news (title, body)
SELECT title, body FROM `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query.
-- Wait for the background job to finish generating embeddings before running.
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other']
  ) AS category
FROM
  my_dataset.bbc_news;
Spécification manuelle des colonnes
Si vous disposez d'une colonne d'embeddings, spécifiez-la dans l'argument embeddings de AI.IF ou AI.CLASSIFY. Vous pouvez le générer à l'aide de la fonction AI.EMBED.
L'exemple suivant montre comment créer une table avec une colonne d'embedding, en utilisant text-embedding-005 comme modèle d'embedding, puis comment utiliser cette colonne dans une requête AI.CLASSIFY :
-- Create a table with an embedding column
CREATE TABLE my_dataset.bbc_news AS
SELECT
  title,
  body,
  AI.EMBED(
    body,
    endpoint => 'text-embedding-005',
    task_type => 'CLASSIFICATION'
  ).result AS body_embedding
FROM
  `bigquery-public-data.bbc_news.fulltext`;

-- Run the optimized query
SELECT
  title,
  body,
  AI.CLASSIFY(
    body,
    categories => ['tech', 'sport', 'business', 'other'],
    embeddings => body_embedding,
  ) AS category
FROM
  my_dataset.bbc_news;
Si votre requête fait référence à plusieurs colonnes, fournissez une liste de noms de colonnes et leurs embeddings correspondants dans l'argument embeddings. Exemple : embeddings => [('body', body_embedding), ('title', title_embedding)].
Surveiller l'optimisation des requêtes
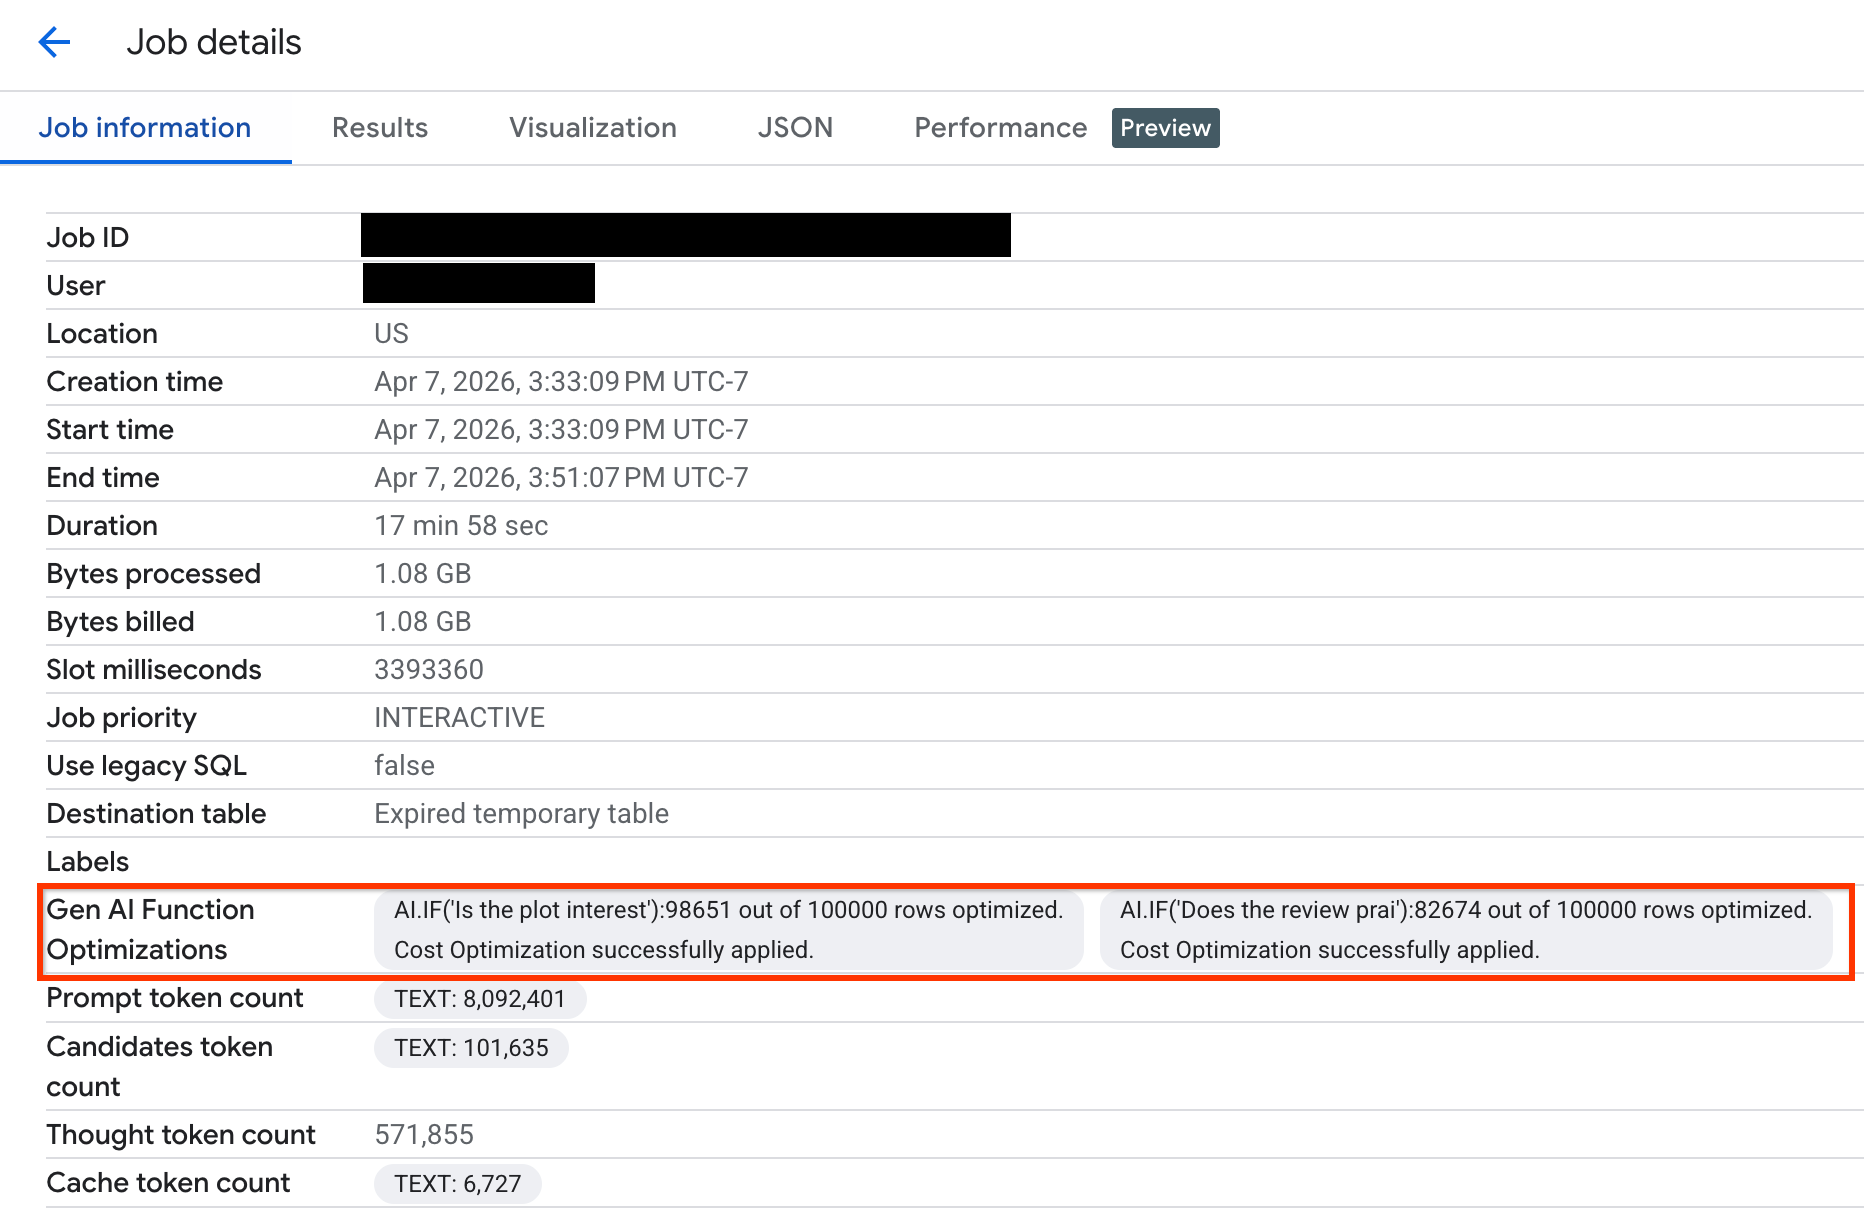
Pour vérifier le nombre de lignes optimisées lors de l'exécution de votre requête, vous pouvez afficher les statistiques d'exécution dans la console Google Cloud ou via l'API :
Console
Pour afficher le nombre de lignes optimisées et les messages système concernant l'état de l'optimisation, procédez comme suit :
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Explorateur de jobs.
Cliquez sur l'ID du job pour afficher le volet Détails du job.
Cliquez sur l'onglet Informations sur le job, puis consultez les métriques et l'état dans le champ Optimisations des fonctions d'IA générative.
API
Vérifiez le champ FunctionGenAiCostOptimizationStats dans l'objet GenAIFunctionStats des métadonnées du job. Cet objet inclut le nombre de lignes déduites via le workflow optimisé et les messages générés par le système fournissant des insights sur l'état de l'optimisation.
Résoudre les problèmes
Les sections suivantes expliquent comment diagnostiquer et résoudre les problèmes courants liés à l'utilisation du mode optimisé.
La taille des données est trop petite
Problème : données insuffisantes pour l'entraînement du modèle. Un message d'erreur peut s'afficher : Fail to apply cost optimizations because the number of rows to process is too
small.
Solution : augmentez la taille de votre entrée pour qu'elle atteigne au moins le nombre de lignes indiqué dans le message d'erreur, puis vérifiez que des embeddings valides ont été correctement générés pour toutes les lignes.
Peu ou pas d'exemples dans certaines classes
Problème : nombre insuffisant d'échantillons pour certaines catégories ou certains cas pendant la phase d'échantillonnage, ce qui empêche l'entraînement du modèle.
- Pour la fonction
AI.CLASSIFY, un message d'erreur peut s'afficher :Failed to apply cost optimizations because the random training sample did not contain enough examples of all categories. - Pour la fonction
AI.IF, un message d'erreur peut s'afficher :Failed to apply cost optimizations because the random training sample did not include enough examples of both true/false cases.
Solution :
- Pour
AI.CLASSIFY:- Supprimez les catégories rares ou vides de l'appel de fonction
AI.CLASSIFY. - Regroupez les catégories rares dans une catégorie plus large pour augmenter la taille de l'échantillon.
Vous pouvez utiliser une catégorie
OTHERpour regrouper les éléments qui ne sont pas couverts par des catégories plus spécifiques. Toutefois, n'ajoutez pasOTHERsi votre liste de catégories est déjà complète, car ce terme est ambigu et peut prêter à confusion.
- Supprimez les catégories rares ou vides de l'appel de fonction
- Pour
AI.IF: mettez à jour la condition de filtre de la requête afin que les castrueetfalsesoient bien représentés dans les lignes d'entrée. Une condition qui correspond à presque toutes les lignes, ou à presque aucune ligne, peut provoquer cette erreur.
Les embeddings ont des dimensions incohérentes
Problème : incohérences entre les dimensions d'embedding d'une ligne à l'autre. Le message d'erreur suivant peut s'afficher : Failed to apply cost optimizations because the
embeddings have inconsistent dimensions.
Solution : vérifiez que tous les embeddings sont générés par le même modèle et ont la même longueur de vecteur d'embedding. Vous pouvez utiliser une requête SQL semblable à la suivante pour vérifier que les embeddings d'une colonne ont la même longueur :
SELECT ARRAY_LENGTH(body_embedding.result), COUNT(*)
FROM `PROJECT_ID.DATASET.TABLE_NAME`
GROUP BY 1;
La complexité de la requête est trop élevée
Problème : le modèle distillé ne peut pas atteindre un seuil de haute précision. Un des messages d'erreur suivants peut s'afficher :
Fail to apply cost optimizations because the distilled model does not
approximate LLM behavior well enough for some categories.
Fail to apply cost optimization because the prompt complexity is too high.
Solution :
Si le message d'erreur répertorie des catégories avec des scores F1 faibles, concentrez-vous d'abord sur ces catégories. Affinez leurs noms et descriptions afin de les distinguer clairement des autres catégories.
Utilisez un ensemble de catégories qui forment une partition. Assurez-vous que les catégories se chevauchent le moins possible et couvrent toutes les entrées possibles.
- Évitez les catégories qui se chevauchent, où une entrée peut appartenir à plusieurs catégories simultanément. Par exemple, évitez les catégories telles que
['terrible', 'bad', 'okay', 'good', 'excellent']. - Évitez les lacunes où aucune catégorie ne s'applique. Par exemple, la liste des catégories
['bad', 'average']ne couvre pas un avis exprimant des éloges. Fournissez des descriptions de catégories pour aider le LLM à lever toute ambiguïté entre les catégories. Exemple :
AI.CLASSIFY(
  review,
  categories => [
    ('terrible', 'Review where customer was not happy and the message indicates they will never try this product again'),
    ('bad', 'Review where customer was not happy but suggested improvements to the product'),
    ('okay', 'Review where customer was neutral about the product. Short reviews qualify for this category'),
    ('good', 'Review where customers were happy using this product but had minor critiques'),
    ('excellent', 'Review where customers were very happy using this product and will recommend others to try it too')],
  embeddings => review_embeddings)
- Évitez les catégories qui se chevauchent, où une entrée peut appartenir à plusieurs catégories simultanément. Par exemple, évitez les catégories telles que
Essayez des modèles d'embedding plus avancés, comme
text-embedding-005ougemini-embedding-2.Contactez bqml-feedback@google.com pour obtenir une assistance supplémentaire pour le débogage.
Nombre inattendu de lignes traitées par le LLM
Problème : Les statistiques d'exécution de la requête indiquent qu'un nombre anormalement élevé de lignes ont été traitées par le LLM distant au lieu du modèle distillé. Cela peut être dû aux raisons suivantes :
- Le modèle distillé a bien été entraîné, mais certaines lignes ne comportaient pas d'embeddings. Ces lignes sont traitées par le LLM distant.
- Le modèle distillé n'a pas pu être appliqué à chaque ligne et a dû revenir au LLM distant pour maintenir une qualité constante.
Solution : vérifiez que les embeddings sont correctement générés et valides pour toutes les lignes de vos données. Si le problème persiste, contactez bqml-feedback@google.com pour le débogage.
Colonne d'embeddings autonomes non détectée
Problème : BigQuery ne peut pas détecter de colonne d'embedding autonome. Cela peut se produire si votre script utilise une table temporaire et que la référence à la table d'origine est perdue.
Solution : utilisez le paramètre embeddings pour transmettre explicitement une colonne d'embedding autonome (par exemple, embeddings => content_embedding.result), ce qui déclenche l'optimisation des coûts.
Étapes suivantes
- En savoir plus sur l'IA générative dans BigQuery
- Découvrez comment contrôler les coûts de l'IA générative avec des quotas quotidiens dans BigQuery.
- Consultez la documentation sur la fonction
AI.IF. - Consultez la documentation sur la fonction
AI.CLASSIFY.