


יצירת טבלאות BigLake ב-Azure Blob Storage
טבלאות BigLake ב-Azure Blob Storage מאפשרות להריץ שאילתות על נתונים ב-Blob Storage מ-BigQuery באמצעות הקצאת גישה. הגישה הזו מפרידה בין הגישה לטבלת BigLake לבין הגישה למאגר הנתונים הבסיסי, כך שהמשתמשים צריכים הרשאות רק בטבלה.
במאמר הזה מוסבר איך ליצור טבלת BigLake ב-Azure Blob Storage. במאמר זרימת הנתונים בזמן שליחת שאילתות על נתונים מוסבר איך הנתונים זורמים בין BigQuery לבין Blob Storage.
לפני שמתחילים
מוודאים שיש לכם חיבור לגישה לנתונים ב-Blob Storage.
התפקידים הנדרשים
כדי לקבל את ההרשאות שנדרשות ליצירת טבלה חיצונית, צריך לבקש מהאדמין להקצות לכם את התפקיד אדמין BigQuery (roles/bigquery.admin) ב-IAM במערך הנתונים.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות ליצירת טבלה חיצונית. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי ליצור טבלה חיצונית, צריך את ההרשאות הבאות:
-
bigquery.tables.create -
bigquery.connections.delegate
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
יצירת קבוצת נתונים
לפני שיוצרים טבלה חיצונית, צריך ליצור קבוצת נתונים באזור הנתמך. בוחרים באחת מהאפשרויות הבאות:המסוף
נכנסים לדף BigQuery.
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, בוחרים את הפרויקט שבו רוצים ליצור את מערך הנתונים.
- לוחצים על View actions ואז על Create dataset.
- בדף Create dataset, מציינים את הפרטים הבאים:
- בשדה Dataset ID מזינים שם ייחודי למערך הנתונים.
- בקטע מיקום הנתונים, בוחרים אזור נתמך.
- אופציונלי: כדי למחוק טבלאות באופן אוטומטי, מסמנים את התיבה Enable table expiration ומגדירים את Default maximum table age בימים. הנתונים ב-Azure לא נמחקים כשתוקף הטבלה פג.
- אם רוצים להשתמש באיסוף ברירת מחדל, מרחיבים את הקטע Advanced options ובוחרים באפשרות Enable default collation.
- לוחצים על Create dataset.
SQL
משתמשים בהצהרת ה-DDL CREATE SCHEMA.
בדוגמה הבאה נוצר מערך נתונים באזור azure-eastus2:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE SCHEMA mydataset
OPTIONS (
  location = 'azure-eastus2');
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
בסביבה של שורת הפקודה, יוצרים מערך נתונים באמצעות הפקודה bq mk:
bq --location=LOCATION mk \
    --dataset \
PROJECT_ID:DATASET_NAME
הפרמטר --project_id מבטל את פרויקט ברירת המחדל.
מחליפים את מה שכתוב בשדות הבאים:
LOCATION: המיקום של מערך הנתוניםלמידע על אזורים נתמכים, ראו מיקומים. אחרי שיוצרים מערך נתונים, אי אפשר לשנות את המיקום שלו. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ
.bigqueryrc.
PROJECT_ID: מזהה הפרויקט
DATASET_NAME: השם של קבוצת הנתונים שרוצים ליצורכדי ליצור קבוצת נתונים בפרויקט שאינו פרויקט ברירת המחדל, מוסיפים את מזהה הפרויקט לשם של קבוצת הנתונים בפורמט הבא:
PROJECT_ID:DATASET_NAME.
יצירת טבלאות BigLake בנתונים לא מחולקים למחיצות
בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית השמאלית, לוחצים על Explorer:
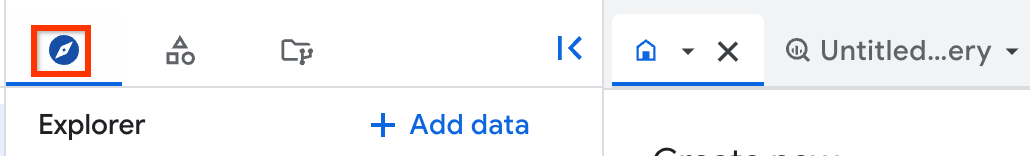
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים קבוצת נתונים.
בקטע Dataset info, לוחצים על Create table.
בדף Create table, בקטע Source:
- בקטע Create table from, בוחרים באפשרות Azure Blob Storage.
בשדה Select Azure Blob Storage path, מזינים נתיב של Blob Storage בפורמט הבא:
azure://AZURE_STORAGE_ACCOUNT_NAME.blob.core.windows.net/CONTAINER_NAME/FILE_PATHמחליפים את מה שכתוב בשדות הבאים:
-
AZURE_STORAGE_ACCOUNT_NAME: השם של חשבון Blob Storage. האזור של החשבון צריך להיות זהה לאזור של מערך הנתונים. -
CONTAINER_NAME: השם של מאגר ה-Blob Storage. -
FILE_PATH: נתיב הנתונים שמצביע על הנתונים ב-Blob Storage. לדוגמה, בקובץ CSV יחיד, הערך שלFILE_PATHיכול להיותmyfile.csv.
-
בשדה פורמט קובץ, בוחרים את פורמט הנתונים ב-Azure. הפורמטים הנתמכים הם AVRO, CSV, DELTA_LAKE, ICEBERG, JSONL, ORC ו-PARQUET.
בקטע Destination:
- בקטע Dataset, בוחרים את מערך הנתונים המתאים.
- בשדה Table, מזינים את שם הטבלה.
- מוודאים שהשדה Table type מוגדר ל-External table.
- בשדה Connection ID, בוחרים את מזהה החיבור המתאים מהתפריט הנפתח. למידע על חיבורים, קראו את המאמר התחברות ל-Blob Storage.
בקטע Schema, אתם יכולים להפעיל את האפשרות schema auto-detection או לציין סכימה באופן ידני אם יש לכם קובץ מקור. אם אין לכם קובץ מקור, אתם צריכים לציין סכימה באופן ידני.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto-detect.
כדי לציין סכימה באופן ידני, משאירים את האפשרות Auto-detect לא מסומנת. מפעילים את האפשרות Edit as text ומזינים את סכימת הטבלה כמערך JSON.
לוחצים על Create table.
SQL
כדי ליצור טבלת BigLake, משתמשים בהצהרה CREATE EXTERNAL TABLE עם הסעיף WITH CONNECTION:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE EXTERNAL TABLE DATASET_NAME.TABLE_NAME
WITH CONNECTION `AZURE_LOCATION.CONNECTION_NAME`
  OPTIONS (
    format = 'DATA_FORMAT',
    uris = ['azure://AZURE_STORAGE_ACCOUNT_NAME.blob.core.windows.net/CONTAINER_NAME/FILE_PATH']);
מחליפים את מה שכתוב בשדות הבאים:
-
DATASET_NAME: השם של מערך הנתונים שיצרתם -
TABLE_NAME: השם שרוצים לתת לטבלה הזו -
AZURE_LOCATION: מיקום של Azure בפורמט Google Cloud, למשלazure-eastus2 -
CONNECTION_NAME: שם החיבור שיצרתם -
DATA_FORMAT: כל אחד מהפורמטים המאוגדים הנתמכים של BigQuery, כמוAVRO,CSV,DELTA_LAKEאוICEBERG(גרסת טרום-השקה (Preview)) -
AZURE_STORAGE_ACCOUNT_NAME: השם של חשבון Blob Storage -
CONTAINER_NAME: השם של מאגר ה-Blob Storage -
FILE_PATH: נתיב הנתונים שמצביע על הנתונים ב-Blob Storage
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
דוגמה:
CREATE EXTERNAL TABLE absdataset.abstable
WITH CONNECTION `azure-eastus2.abs-read-conn`
  OPTIONS (
    format = 'CSV', uris = ['azure://account_name.blob.core.windows.net/container/path/file.csv']);
BQ
יוצרים קובץ הגדרת טבלה:
bq mkdef  \
    --source_format=DATA_FORMAT \
    --connection_id=AZURE_LOCATION.CONNECTION_NAME \
    "azure://AZURE_STORAGE_ACCOUNT_NAME.blob.core.windows.net/CONTAINER_NAME/FILE_PATH" > table_def
מחליפים את מה שכתוב בשדות הבאים:
-
DATA_FORMAT: כל אחד מהפורמטים המאוגדים הנתמכים של BigQuery, כמוAVRO,CSV,ICEBERGאוPARQUET -
AZURE_LOCATION: מיקום של Azure ב- Google Cloud, כמוazure-eastus2 -
CONNECTION_NAME: שם החיבור שיצרתם -
AZURE_STORAGE_ACCOUNT_NAME: השם של חשבון Blob Storage -
CONTAINER_NAME: השם של מאגר ה-Blob Storage -
FILE_PATH: נתיב הנתונים שמצביע על הנתונים ב-Blob Storage
בשלב הבא, יוצרים את טבלת BigLake:
bq mk --external_table_definition=table_def DATASET_NAME.TABLE_NAME
מחליפים את מה שכתוב בשדות הבאים:
-
DATASET_NAME: השם של מערך הנתונים שיצרתם -
TABLE_NAME: השם שרוצים לתת לטבלה הזו
לדוגמה, הפקודות הבאות יוצרות טבלת BigLake חדשה, my_dataset.my_table, שיכולה לשלוח שאילתות לנתונים ב-Blob Storage שמאוחסנים בנתיב azure://account_name.blob.core.windows.net/container/path ויש לה חיבור קריאה במיקום azure-eastus2:
bq mkdef \
    --source_format=AVRO \
    --connection_id=azure-eastus2.read-conn \
    "azure://account_name.blob.core.windows.net/container/path" > table_def

bq mk \
    --external_table_definition=table_def my_dataset.my_table
API
מפעילים את ה-method tables.insert ב-API ויוצרים ExternalDataConfiguration במשאב Table שמעבירים.
כדי להפעיל זיהוי אוטומטי של סכימה במקורות נתונים נתמכים, מציינים את המאפיין schema או מגדירים את המאפיין autodetect כ-true.
מציינים את המאפיין connectionId כדי לזהות את החיבור שבו רוצים להשתמש כדי להתחבר ל-Blob Storage.
יצירת טבלאות BigLake על נתונים מחולקים למחיצות
אתם יכולים ליצור טבלת BigLake לנתונים מחולקים למחיצות של Hive ב-Blob Storage. אחרי שיוצרים טבלה עם מחיצות חיצוניות, אי אפשר לשנות את מפתח המחיצה. כדי לשנות את מפתח המחיצה, צריך ליצור מחדש את הטבלה.
כדי ליצור טבלת BigLake שמבוססת על נתונים מחולקים למחיצות ב-Hive, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית השמאלית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים קבוצת נתונים.
לוחצים על Create table. החלונית Create table נפתחת.
בקטע מקור, מציינים את הפרטים הבאים:
בקטע יצירת טבלה מתוך, בוחרים אחת מהאפשרויות הבאות:
- Amazon S3
- Azure Blob Storage
מציינים את הנתיב לתיקייה באמצעות תווים כלליים לחיפוש. לדוגמה:
- ב-Amazon S3:
s3://mybucket/* - ב-Blob Storage:
azure://mystorageaccount.blob.core.windows.net/mycontainer/*
התיקייה צריכה להיות באותו מיקום של מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף או להחליף.
- ב-Amazon S3:
ברשימה פורמט קובץ, בוחרים את סוג הקובץ.
מסמנים את התיבה Source data partitioning ומציינים את הפרטים הבאים:
- בשדה Select Source URI Prefix, מזינים את הקידומת של ה-URI. לדוגמה,
s3://mybucket/my_files. - אופציונלי: כדי לדרוש מסנן מחיצה בכל השאילתות בטבלה הזו, מסמנים את התיבה Require partition filter. דרישה למסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. מידע נוסף זמין במאמר דרישה למסנני פרדיקטים במפתחות חלוקה למחיצות בשאילתות.
בקטע מצב היסק של מחיצה, בוחרים באחת מהאפשרויות הבאות:
- Automatically infer types: הגדרת מצב הזיהוי של סכימת המחיצה לערך
AUTO. - כל העמודות הן מחרוזות: מגדירים את מצב הזיהוי של סכימת המחיצה לערך
STRINGS. - Provide my own: מגדירים את מצב הזיהוי של סכימת המחיצות ל-
CUSTOMומזינים ידנית את פרטי הסכימה של מפתחות המחיצות. מידע נוסף מופיע במאמר סכימה של מפתח מחיצה בהתאמה אישית.
- Automatically infer types: הגדרת מצב הזיהוי של סכימת המחיצה לערך
- בשדה Select Source URI Prefix, מזינים את הקידומת של ה-URI. לדוגמה,
בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Project, בוחרים את הפרויקט שבו רוצים ליצור את הטבלה.
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהאפשרות External table נבחרה בשדה Table type.
- בשדה Connection ID, בוחרים את החיבור שיצרתם קודם.
בקטע Schema, אתם יכולים להפעיל את האפשרות schema auto-detection או לציין סכימה באופן ידני אם יש לכם קובץ מקור. אם אין לכם קובץ מקור, אתם צריכים לציין סכימה באופן ידני.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto-detect.
כדי לציין סכימה באופן ידני, משאירים את האפשרות Auto-detect לא מסומנת. מפעילים את האפשרות Edit as text ומזינים את סכימת הטבלה כמערך JSON.
כדי להתעלם משורות עם ערכי עמודות נוספים שלא תואמים לסכימה, מרחיבים את הקטע Advanced options ובוחרים באפשרות Unknown values.
לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL CREATE EXTERNAL TABLE:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE EXTERNAL TABLE `PROJECT_ID.DATASET.EXTERNAL_TABLE_NAME`
WITH PARTITION COLUMNS
(
  PARTITION_COLUMN PARTITION_COLUMN_TYPE,
)
WITH CONNECTION `PROJECT_ID.REGION.CONNECTION_ID`
OPTIONS (
  hive_partition_uri_prefix = "HIVE_PARTITION_URI_PREFIX",
  uris=['FILE_PATH'],
  format ="TABLE_FORMAT"
);
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את הטבלה, לדוגמהmyproject -
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור את הטבלה, למשלmydataset. -
EXTERNAL_TABLE_NAME: שם הטבלה שרוצים ליצור, לדוגמהmytable -
PARTITION_COLUMN: השם של עמודת החלוקה למחיצות -
PARTITION_COLUMN_TYPE: סוג עמודת החלוקה למחיצות -
REGION: האזור שבו נמצא החיבור, לדוגמהus -
CONNECTION_ID: שם החיבור, לדוגמהmyconnection -
HIVE_PARTITION_URI_PREFIX: הקידומת של ה-URI של חלוקה למחיצות ב-Hive, לדוגמה:s3://mybucket/azure://mystorageaccount.blob.core.windows.net/mycontainer/
-
FILE_PATH: הנתיב למקור הנתונים של הטבלה החיצונית שרוצים ליצור, לדוגמה:s3://mybucket/*.parquetazure://mystorageaccount.blob.core.windows.net/mycontainer/*.parquet
-
TABLE_FORMAT: הפורמט של הטבלה שרוצים ליצור, לדוגמהPARQUET
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
דוגמאות
בדוגמה הבאה נוצרת טבלת BigLake על נתונים מחולקים למחיצות ב-Amazon S3. הסכימה מזוהה באופן אוטומטי.
CREATE EXTERNAL TABLE `my_dataset.my_table`
WITH PARTITION COLUMNS
(
  sku STRING,
)
WITH CONNECTION `us.my-connection`
OPTIONS(
  hive_partition_uri_prefix = "s3://mybucket/products",
  uris = ['s3://mybucket/products/*']
);
בדוגמה הבאה יוצרים טבלת BigLake על נתונים מחולקים למחיצות ב-Blob Storage. הסכימה מצוינת.
CREATE EXTERNAL TABLE `my_dataset.my_table`
(
  ProductId INTEGER,
  ProductName, STRING,
  ProductType, STRING
)
WITH PARTITION COLUMNS
(
  sku STRING,
)
WITH CONNECTION `us.my-connection`
OPTIONS(
  hive_partition_uri_prefix = "azure://mystorageaccount.blob.core.windows.net/mycontainer/products",
  uris = ['azure://mystorageaccount.blob.core.windows.net/mycontainer/*']
);
BQ
קודם כל, משתמשים בפקודה bq mkdef כדי ליצור קובץ הגדרת טבלה:
bq mkdef \
--source_format=SOURCE_FORMAT \
--connection_id=REGION.CONNECTION_ID \
--hive_partitioning_mode=PARTITIONING_MODE \
--hive_partitioning_source_uri_prefix=URI_SHARED_PREFIX \
--require_hive_partition_filter=BOOLEAN \
 URIS > DEFINITION_FILE
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_FORMAT: הפורמט של מקור הנתונים החיצוני. לדוגמה,CSV. -
REGION: האזור שבו נמצא החיבור, לדוגמהus. -
CONNECTION_ID: שם החיבור, לדוגמהmyconnection. -
PARTITIONING_MODE: מצב החלוקה למחיצות של Hive. משתמשים באחד מהערכים הבאים:-
AUTO: זיהוי אוטומטי של השמות והסוגים של המפתחות. -
STRINGS: המרה אוטומטית של שמות המפתחות למחרוזות. -
CUSTOM: מקודדים את סכימת המפתח בקידומת של ה-URI במקור.
-
-
URI_SHARED_PREFIX: הקידומת של ה-URI במקור. -
BOOLEAN: מציין אם לדרוש מסנן פרדיקט בזמן השאילתה. הדגל הזה הוא אופציונלי. ערך ברירת המחדל הואfalse. -
URIS: הנתיב לתיקייה ב-Amazon S3 או ב-Blob Storage, בפורמט של תו כללי לחיפוש. -
DEFINITION_FILE: הנתיב לקובץ הגדרת הטבלה במחשב המקומי.
אם הערך של PARTITIONING_MODE הוא CUSTOM, צריך לכלול את סכימת מפתח המחיצה בקידומת של ה-URI של המקור, בפורמט הבא:
--hive_partitioning_source_uri_prefix=GCS_URI_SHARED_PREFIX/{KEY1:TYPE1}/{KEY2:TYPE2}/...
אחרי שיוצרים את קובץ הגדרת הטבלה, משתמשים בפקודה bq mk כדי ליצור את טבלת BigLake:
bq mk --external_table_definition=DEFINITION_FILE \
DATASET_NAME.TABLE_NAME \
SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
-
DEFINITION_FILE: הנתיב לקובץ הגדרת הטבלה. -
DATASET_NAME: שם מערך הנתונים שמכיל את הטבלה. -
TABLE_NAME: שם הטבלה שיוצרים. -
SCHEMA: מציין נתיב לקובץ סכימת JSON, או מציין את הסכימה בפורמטfield:data_type,field:data_type,.... כדי להשתמש בזיהוי אוטומטי של סכימה, משמיטים את הארגומנט הזה.
דוגמאות
בדוגמה הבאה נעשה שימוש במצב חלוקה למחיצות של AUTO Hive לנתונים של Amazon S3:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=AUTO \
  --hive_partitioning_source_uri_prefix=s3://mybucket/myTable \
  --metadata_cache_mode=AUTOMATIC \
  s3://mybucket/* > mytable_def

bq mk --external_table_definition=mytable_def \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
בדוגמה הבאה נעשה שימוש במצב חלוקה למחיצות של STRING Hive לנתונים של Amazon S3:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=STRING \
  --hive_partitioning_source_uri_prefix=s3://mybucket/myTable \
  s3://mybucket/myTable/* > mytable_def

bq mk --external_table_definition=mytable_def \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
בדוגמה הבאה נעשה שימוש במצב חלוקה למחיצות של CUSTOM Hive לנתונים של Blob Storage:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=CUSTOM \
  --hive_partitioning_source_uri_prefix=azure://mystorageaccount.blob.core.windows.net/mycontainer/{dt:DATE}/{val:STRING} \
  azure://mystorageaccount.blob.core.windows.net/mycontainer/* > mytable_def

bq mk --external_table_definition=mytable_def \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
API
כדי להגדיר חלוקה למחיצות ב-Hive באמצעות BigQuery API, צריך לכלול את האובייקט hivePartitioningOptions באובייקט ExternalDataConfiguration כשיוצרים את קובץ הגדרת הטבלה.
כדי ליצור טבלת BigLake, צריך לציין גם ערך בשדה connectionId.
אם מגדירים את השדה hivePartitioningOptions.mode לערך CUSTOM, צריך לקודד את הסכימה של מפתח המחיצה בשדה hivePartitioningOptions.sourceUriPrefix באופן הבא:
s3://BUCKET/PATH_TO_TABLE/{KEY1:TYPE1}/{KEY2:TYPE2}/...
כדי לאכוף את השימוש במסנן פרדיקט בזמן השאילתה, מגדירים את השדה hivePartitioningOptions.requirePartitionFilter לערך true.
טבלאות Delta Lake
Delta Lake הוא פורמט טבלה בקוד פתוח שתומך בטבלאות נתונים בקנה מידה של פטה-בייט. אפשר לשלוח שאילתות לטבלאות Delta Lake גם כטבלאות זמניות וגם כטבלאות קבועות, והן נתמכות כטבלאות BigLake.
סנכרון סכימה
Delta Lake שומר סכימה קנונית כחלק מהמטא-נתונים שלו. אי אפשר לעדכן סכימה באמצעות קובץ מטא-נתונים בפורמט JSON. כדי לעדכן את הסכימה:
משתמשים בפקודה
bq updateעם הדגל--autodetect_schema:bq update --autodetect_schema PROJECT_ID:DATASET.TABLE
מחליפים את מה שכתוב בשדות הבאים:
PROJECT_ID: מזהה הפרויקט שמכיל את הטבלה שרוצים לעדכן
DATASET: קבוצת הנתונים שמכילה את הטבלה שרוצים לעדכן
TABLE: הטבלה שרוצים לעדכן
המרת סוג
BigQuery ממיר את סוגי הנתונים של Delta Lake לסוגי הנתונים הבאים של BigQuery:
| סוג Delta Lake | סוג BigQuery |
|---|---|
boolean |
BOOL |
byte |
INT64 |
int |
INT64 |
long |
INT64 |
float |
FLOAT64 |
double |
FLOAT64 |
Decimal(P/S) |
NUMERIC או BIG_NUMERIC, בהתאם לרמת הדיוק |
date |
DATE |
time |
TIME |
timestamp (not partition column) |
TIMESTAMP |
timestamp (partition column) |
DATETIME |
string |
STRING |
binary |
BYTES |
array<Type> |
ARRAY<Type> |
struct |
STRUCT |
map<KeyType, ValueType> |
ARRAY<Struct<key KeyType, value ValueType>> |
מגבלות
המגבלות הבאות חלות על טבלאות Delta Lake:
המגבלות של טבלאות חיצוניות חלות על טבלאות Delta Lake.
טבלאות Delta Lake נתמכות רק ב-BigQuery Omni, ויש להן את המגבלות שמשויכות אליהן.
אי אפשר לעדכן טבלה באמצעות קובץ מטא-נתונים חדש בפורמט JSON. צריך להשתמש בפעולת עדכון של טבלת סכימה עם זיהוי אוטומטי. מידע נוסף זמין במאמר בנושא סנכרון סכימה.
אמצעי האבטחה של BigLake מגינים על טבלאות Delta Lake רק כשניגשים אליהן דרך שירותי BigQuery.
יצירת טבלת Delta Lake
בדוגמה הבאה יוצרים טבלה חיצונית באמצעות ההצהרה CREATE EXTERNAL
TABLE בפורמט Delta Lake:
CREATE [OR REPLACE] EXTERNAL TABLE table_name
WITH CONNECTION connection_name
OPTIONS (
         format = 'DELTA_LAKE',
         uris = ["parent_directory"]
       );
מחליפים את מה שכתוב בשדות הבאים:
table_name: שם הטבלה.
connection_name: שם החיבור. החיבור צריך לזהות מקור של Amazon S3 או של Blob Storage.
parent_directory: ה-URI של ספריית האם.
העברה של BigQuery Omni עם Delta Lake
בדוגמה הבאה משתמשים בהצהרה LOAD DATA כדי לטעון נתונים לטבלה המתאימה:
LOAD DATA [INTO | OVERWRITE] table_name
FROM FILES (
        format = 'DELTA_LAKE',
        uris = ["parent_directory"]
)
WITH CONNECTION connection_name;
דוגמאות נוספות להעברות נתונים של BigQuery Omni מפורטות במאמר טעינת נתונים באמצעות פעולות של BigQuery Omni.
הרצת שאילתות על טבלאות BigLake
מידע נוסף זמין במאמר שאילתות על נתונים ב-Blob Storage.
הצגת המטא-נתונים של המשאב באמצעות INFORMATION_SCHEMA
אפשר לראות את המטא-נתונים של המשאב בתצוגות של INFORMATION_SCHEMA. כששולחים שאילתה לתצוגות JOBS_BY_*, JOBS_TIMELINE_BY_* ו-RESERVATION*, צריך לציין את מיקום העיבוד של השאילתה שנמצא באותו אזור של הטבלה. למידע על מיקומים ב-BigQuery Omni, קראו את המאמר מיקומים. בכל שאר טבלאות המערכת, ציון המיקום של משימת השאילתה הוא אופציונלי.
בקטע מגבלות מפורט מידע על טבלאות המערכת שנתמכות ב-BigQuery Omni.
כדי לשלוח שאילתות לטבלאות המערכת של JOBS_* ו-RESERVATION*, צריך לבחור אחת מהשיטות הבאות כדי לציין את מיקום העיבוד:
המסוף
נכנסים לדף BigQuery.
אם הכרטיסייה Editor לא מוצגת, לוחצים על Compose new query.
לוחצים על עריכה > הגדרות השאילתה. תיפתח תיבת הדו-שיח Query settings.
בתיבת הדו-שיח Query settings, בקטע Additional settings > מיקום הנתונים, בוחרים את האזור ב-BigQuery שנמצא באותו מיקום כמו האזור ב-BigQuery Omni. לדוגמה, אם האזור של BigQuery Omni הוא
aws-us-east-1, צריך לציין אתus-east4.בוחרים את השדות שנותרו ולוחצים על שמירה.
BQ
משתמשים בדגל --location כדי להגדיר את מיקום העיבוד של המשימה לאזור של BigQuery שנמצא באותו מיקום כמו האזור של BigQuery Omni.
לדוגמה, אם האזור של BigQuery Omni הוא aws-us-east-1, צריך לציין את us-east4.
דוגמה
bq query --use_legacy_sql=false --location=us-east4 \
"SELECT * FROM region-azure-eastus2.INFORMATION_SCHEMA.JOBS limit 10;"
API
אם אתם מריצים משימות באופן פרוגרמטי, הגדירו את הארגומנט של המיקום לאזור BigQuery שנמצא באותו מיקום כמו אזור BigQuery Omni.
לדוגמה, אם האזור של BigQuery Omni הוא aws-us-east-1, צריך לציין את us-east4.
VPC Service Controls
כדי להוסיף שכבת הגנה, אתם יכולים להשתמש בהיקפי השירות של VPC Service Controls כדי להגביל את הגישה מ-BigQuery Omni לשירות ענן חיצוני. לדוגמה, היקפי השירות של VPC Service Controls יכולים להגביל את הייצוא מטבלאות BigQuery Omni לקטגוריה ספציפית של Amazon S3 או למאגר Blob Storage.
מידע נוסף על VPC Service Controls זמין בסקירה הכללית על VPC Service Controls.
ההרשאה הנדרשת
חשוב לוודא שיש לכם את ההרשאות הנדרשות כדי להגדיר את גבולות הגזרה לשירות. במאמר בקרת גישה באמצעות IAM שבמסמכי התיעוד של VPC Service Controls מפורטת רשימה של תפקידי IAM שנדרשים כדי להגדיר את VPC Service Controls.
הגדרת VPC Service Controls באמצעות מסוף Google Cloud
בתפריט הניווט במסוף Google Cloud , לוחצים על Security ואז על VPC Service Controls.
כדי להגדיר את VPC Service Controls ל-BigQuery Omni, פועלים לפי השלבים במדריך יצירת גבולות גזרה לשירות, וכשמגיעים לחלונית Egress rules פועלים לפי השלבים הבאים:
בחלונית Egress rules, לוחצים על Add rule.
בקטע From attributes of the API client, בוחרים אפשרות מהרשימה Identity.
בוחרים באפשרות למאפיינים של משאבים חיצוניים.
כדי להוסיף מקור מידע חיצוני, לוחצים על הוספת מקורות מידע חיצוניים.
בתיבת הדו-שיח Add external resource, בשדה External resource name מזינים שם תקין של משאב. לדוגמה:
Amazon Simple Storage Service (Amazon S3):
s3://BUCKET_NAMEמחליפים את BUCKET_NAME בשם הקטגוריה שלכם ב-Amazon S3.
ב-Azure Blob Storage:
azure://myaccount.blob.core.windows.net/CONTAINER_NAMEמחליפים את CONTAINER NAME בשם של מאגר ה-Blob Storage.
רשימה של מאפייני כללי תעבורת נתונים יוצאת מופיעה בחומר העזר בנושא כללי תעבורת נתונים יוצאת.
בוחרים את השיטות שרוצים לאפשר במשאבים החיצוניים:
- אם רוצים לאפשר את כל השיטות, בוחרים באפשרות All methods ברשימה Methods.
- אם רוצים לאפשר שיטות ספציפיות, בוחרים באפשרות Selected method, לוחצים על Select methods ובוחרים את השיטות שרוצים לאפשר במשאבים החיצוניים.
לוחצים על Create perimeter.
הגדרת VPC Service Controls באמצעות ה-CLI של gcloud
כדי להגדיר את VPC Service Controls באמצעות ה-CLI של gcloud:
- הגדרת מדיניות הגישה שמוגדרת כברירת מחדל.
- יוצרים את קובץ הקלט של מדיניות התעבורה היוצאת.
- מוסיפים את מדיניות התעבורה היוצאת.
הגדרת מדיניות הגישה שמוגדרת כברירת מחדל
מדיניות גישה היא מאגר ברמת הארגון של רמות גישה וגבולות גזרה לשירות. במאמר ניהול מדיניות גישה מוסבר איך מגדירים מדיניות גישה כברירת מחדל או איך מקבלים שם של מדיניות גישה.
יצירת קובץ הקלט של מדיניות התעבורה היוצאת
בלוק של כללי תעבורת נתונים יוצאת מגדיר את הגישה המותרת מתוך גבולות הגזרה למשאבים שמחוץ לגבולות הגזרה. במשאבים חיצוניים, המאפיין externalResources מגדיר את הנתיבים של המשאבים החיצוניים שמותר לגשת אליהם מתוך גבולות ההגנה של VPC Service Controls.
אפשר להגדיר כללי תעבורת נתונים יוצאת באמצעות קובץ JSON או קובץ YAML. בדוגמה הבאה נעשה שימוש בפורמט .yaml:
- egressTo:
    operations:
    - serviceName: bigquery.googleapis.com
      methodSelectors:
      - method: "*"
      *OR*
      - permission: "externalResource.read"
    externalResources:
      - EXTERNAL_RESOURCE_PATH
  egressFrom:
    identityType: IDENTITY_TYPE
    *OR*
    identities:
    - serviceAccount:SERVICE_ACCOUNT
egressTo: מפרט את פעולות השירות שמותר לבצע במשאבי Google Cloud בפרויקטים שצוינו מחוץ לגבולות ההגנה.
operations: רשימת השירותים והפעולות או השיטות הנגישים שלקוח שעומד בתנאי הבלוקfromיכול לגשת אליהם.
serviceName: הגדרתbigquery.googleapis.comל-BigQuery Omni.
methodSelectors: רשימת השיטות שלקוח שעומד בתנאים שלfromיכול לגשת אליהן. במאמר הגבלות נתמכות על שיטות של שירותים מפורטות השיטות וההרשאות שאפשר להגביל בשירותים.
method: שיטת שירות תקינה, או\"*\"כדי לאפשר את כל השיטות שלserviceName.
permission: הרשאת שירות תקינה, כמו\"*\",externalResource.readאוexternalResource.write. הגישה למשאבים מחוץ למתחם מותרת לפעולות שדורשות את ההרשאה הזו.
externalResources: רשימה של משאבים חיצוניים שלקוחות בתוך היקף ההרשאות יכולים לגשת אליהם. מחליפים את EXTERNAL_RESOURCE_PATH בקטגוריה תקינה של Amazon S3, כמוs3://bucket_name, או בנתיב של מאגר Blob Storage, כמוazure://myaccount.blob.core.windows.net/container_name.
egressFrom: מציג את פעולות השירות שמותר לבצע במשאבי Google Cloudבפרויקטים שצוינו בתוך גבולות הגזרה.
identityTypeאוidentities: מגדיר את סוגי הזהויות שיכולים לגשת למשאבים שצוינו מחוץ לגבולות האבטחה. מחליפים את IDENTITY_TYPE באחד מהערכים התקינים הבאים:-
ANY_IDENTITY: כדי לאפשר את כל הזהויות. -
ANY_USER_ACCOUNT: כדי לאפשר לכל המשתמשים. -
ANY_SERVICE_ACCOUNT: כדי לאשר את כל חשבונות השירות
-
identities: רשימה של חשבונות שירות שיכולים לגשת למשאבים שצוינו מחוץ להיקף.
serviceAccount(אופציונלי): מחליפים את SERVICE_ACCOUNT בחשבון השירות שיכול לגשת למשאבים שצוינו מחוץ להיקף.
דוגמאות
הדוגמה הבאה היא מדיניות שמאפשרת פעולות של תעבורת נתונים יוצאת מתוך ההיקף למיקום s3://mybucket של Amazon S3 ב-AWS.
- egressTo:
    operations:
    - serviceName: bigquery.googleapis.com
      methodSelectors:
      - method: "*"
    externalResources:
      - s3://mybucket
      - s3://mybucket2
  egressFrom:
    identityType: ANY_IDENTITY
בדוגמה הבאה אפשר לבצע פעולות של תעבורת נתונים יוצאת למאגר של Blob Storage:
- egressTo:
    operations:
    - serviceName: bigquery.googleapis.com
      methodSelectors:
      - method: "*"
    externalResources:
      - azure://myaccount.blob.core.windows.net/mycontainer
  egressFrom:
    identityType: ANY_IDENTITY
מידע נוסף על כללי תעבורת נתונים יוצאת מופיע בחומר העזר בנושא כללי תעבורת נתונים יוצאת.
הוספת מדיניות תעבורת הנתונים היוצאת
כדי להוסיף את מדיניות התעבורה היוצאת (egress) כשיוצרים גבולות גזרה לשירות חדשים, משתמשים בפקודה gcloud access-context-manager perimeters create.
לדוגמה, הפקודה הבאה יוצרת היקף חדש בשם omniPerimeter שכולל את הפרויקט עם מספר הפרויקט 12345, מגבילה את BigQuery API ומוסיפה מדיניות תעבורת נתונים יוצאת שמוגדרת בקובץ egress.yaml:
gcloud access-context-manager perimeters create omniPerimeter \
    --title="Omni Perimeter" \
    --resources=projects/12345 \
    --restricted-services=bigquery.googleapis.com \
    --egress-policies=egress.yaml
כדי להוסיף את כללי מדיניות התעבורה היוצאת לגבולות גזרה קיימים לשירות, משתמשים בפקודה gcloud access-context-manager perimeters update.
לדוגמה, הפקודה הבאה מוסיפה מדיניות תעבורת נתונים יוצאת שמוגדרת בקובץ egress.yaml לגבולות גזרה לשירות קיימים בשם omniPerimeter:
gcloud access-context-manager perimeters update omniPerimeter
    --set-egress-policies=egress.yaml
אימות המתחם
כדי לאמת את היקף האבטחה, משתמשים בפקודה gcloud access-context-manager perimeters describe:
gcloud access-context-manager perimeters describe PERIMETER_NAME
מחליפים את PERIMETER_NAME בשם של היקף האבטחה.
לדוגמה, הפקודה הבאה מתארת את ההיקף omniPerimeter:
gcloud access-context-manager perimeters describe omniPerimeter
מידע נוסף מופיע במאמר ניהול גבולות גזרה לשירות.
מתן גישה ל-Blob Storage דרך BigQuery Omni VPC
אדמינים ב-BigQuery יכולים ליצור כלל רשת כדי לתת ל-BigQuery Omni גישה למשאבים ב-Blob Storage. כך רק רשתות VPC מורשות של BigQuery Omni יכולות לקיים אינטראקציה עם Blob Storage, מה שמשפר את אבטחת הנתונים.
החלת כלל רשת על VPC של BigQuery Omni
כדי להחיל כלל רשת, משתמשים ב-Azure PowerShell או ב-Terraform:
Azure PowerShell
מריצים את הפקודה הבאה כדי להוסיף כלל רשת לחשבון האחסון, שמציין את מזהי רשתות המשנה של BigQuery Omni שאוחזרו בתור VirtualNetworkResourceId.
  Add-AzStorageAccountNetworkRule`
   -ResourceGroupName "RESOURCE_GROUP_NAME"`
   -Name "STORAGE_ACCOUNT_NAME"`
   -VirtualNetworkResourceId "SUBNET_ID1","SUBNET_ID2"
מחליפים את מה שכתוב בשדות הבאים:
-
RESOURCE_GROUP_NAME: שם קבוצת המשאבים. -
STORAGE_ACCOUNT_NAME: השם של חשבון האחסון. -
SUBNET_ID1,SUBNET_ID1: מזהי רשתות המשנה. המידע הזה מופיע בטבלה שבדף הזה.
Terraform
מוסיפים את הקוד הבא לקובץ התצורה של Terraform:
  resource "azurerm_storage_account_network_rules" "example" {
    storage_account_name       = "STORAGE_ACCOUNT_NAME"
    resource_group_name        = "RESOURCE_GROUP_NAME"
    default_action             = "Allow"
    bypass                     = ["Logging", "Metrics", "AzureServices"]
    virtual_network_subnet_ids = ["SUBNET_ID1","SUBNET_ID2"]
  }
מחליפים את מה שכתוב בשדות הבאים:
-
STORAGE_ACCOUNT_NAME: השם של חשבון האחסון. -
RESOURCE_GROUP_NAME: שם קבוצת המשאבים. -
SUBNET_ID1,SUBNET_ID1: מזהי רשתות המשנה. המידע הזה מופיע בטבלה שבדף הזה.
מזהי משאבים של BigQuery Omni VPC
| אזור | מזהי רשתות משנה |
|---|---|
| azure-eastus2 |
/subscriptions/95f30708-58d1-48ba-beac-d71870c3b2f5/resourceGroups/bqe-prod-eastus2-resource-group/providers/Microsoft.Network/virtualNetworks/bqe-prod-eastus2-network/subnets/azure-prod-eastus21-yurduaaaaa-private /subscriptions/95f30708-58d1-48ba-beac-d71870c3b2f5/resourceGroups/bqe-prod-eastus2-resource-group/providers/Microsoft.Network/virtualNetworks/bqe-prod-eastus2-network/subnets/azure-prod-eastus22-yurduaaaab-private |
מגבלות
רשימה מלאה של המגבלות שחלות על טבלאות BigLake שמבוססות על Amazon S3 ו-Blob Storage מופיעה בקטע מגבלות.