


שימוש בזיהוי אוטומטי של סכימה
זיהוי אוטומטי של סכימה
זיהוי אוטומטי של סכימה מאפשר ל-BigQuery להסיק את הסכימה של נתוני CSV, JSON או Google Sheets. זיהוי אוטומטי של סכימה זמין כשטוענים נתונים ל-BigQuery וכששולחים שאילתה למקור נתונים חיצוני.
כשמפעילים את הזיהוי האוטומטי, BigQuery מסיק את סוג הנתונים של כל עמודה. BigQuery בוחר קובץ אקראי במקור הנתונים וסורק עד 500 שורות הנתונים הראשונות כדי להשתמש בהן כדוגמה מייצגת.
לאחר מכן, BigQuery בודק כל שדה ומנסה להקצות לו סוג נתונים על סמך הערכים בדגימה. אם כל השורות בעמודה ריקות, הזיהוי האוטומטי יגדיר את סוג הנתונים של העמודה כ-STRING כברירת מחדל.
אם לא מפעילים זיהוי אוטומטי של סכימה לנתוני CSV, JSON או Google Sheets, צריך לספק את הסכימה באופן ידני כשיוצרים את הטבלה.
אין צורך להפעיל זיהוי אוטומטי של סכימה לקובצי ייצוא של Avro, Parquet, ORC, Firestore או Datastore. פורמטי הקבצים האלה מתארים את עצמם, כך ש-BigQuery מסיקה באופן אוטומטי את סכימת הטבלה מנתוני המקור. בקובצי Parquet, Avro ו-ORC, אפשר לספק סכימה מפורשת כדי לשנות את הסכימה שהוסקה.
אפשר לראות את הסכימה שזוהתה בטבלה בדרכים הבאות:
- משתמשים במסוף Google Cloud .
- משתמשים בפקודה
bq showשל כלי שורת הפקודה של BigQuery.
כש-BigQuery מזהה סכימות, יכול להיות שבמקרים נדירים הוא ישנה שם של שדה כדי להתאים אותו לתחביר של GoogleSQL.
למידע על המרות של סוגי נתונים, ראו:
- המרת סוגי נתונים כשמטעינים נתונים מ-Datastore
- המרת סוגי נתונים כשמעלים נתונים מ-Firestore
- המרות של Avro
- המרות של Parquet
- המרות מסוג ORC
טעינת נתונים באמצעות זיהוי אוטומטי של סכימה
כדי להפעיל זיהוי אוטומטי של סכימה בזמן טעינת נתונים, אפשר להשתמש באחת מהשיטות הבאות:
- במסוף Google Cloud , בקטע Schema, מסמנים את האפשרות Schema and input parameters בשדה Auto detect.
- בכלי שורת הפקודה של BigQuery, משתמשים בפקודה
bq loadעם הפרמטר--autodetect.
כשמפעילים את הזיהוי האוטומטי של הסכימה, BigQuery מנסה להסיק באופן אוטומטי את הסכימה של קובצי CSV ו-JSON.
לוגיקת הזיהוי האוטומטי מסיקה את סוגי השדות בסכימה על ידי קריאה של עד 500 שורות הנתונים הראשונות. המערכת מדלגת על שורות מובילות אם הדגל --skip_leading_rows קיים. סוגי השדות מבוססים על השורות עם הכי הרבה שדות.
לכן, הזיהוי האוטומטי אמור לפעול כצפוי כל עוד יש לפחות שורת נתונים אחת עם ערכים בכל עמודה או שדה.
זיהוי אוטומטי של סכימה לא משמש בקובצי Avro, בקובצי Parquet, בקובצי ORC, בקובצי ייצוא של Firestore או בקובצי ייצוא של Datastore. כשאתם טוענים את הקבצים האלה ל-BigQuery, סכימת הטבלה מאוחזרת באופן אוטומטי מנתוני המקור שמתארים את עצמם.
כדי להשתמש בזיהוי אוטומטי של סכימה כשאתם טוענים נתוני JSON או CSV:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
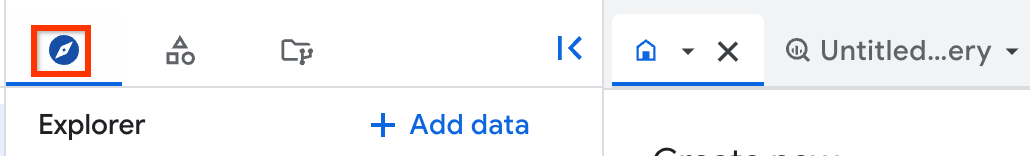
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז על מערך הנתונים.
בחלונית הפרטים, לוחצים על Create table.
בדף Create table, בקטע Source:
- בקטע Create table from, בוחרים את סוג המקור.
בשדה המקור, מחפשים את הקובץ או את הקטגוריה של Cloud Storage, או מזינים את ה-URI של Cloud Storage. שימו לב שאי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום של מערך הנתונים שמכיל את הטבלה שאתם יוצרים.
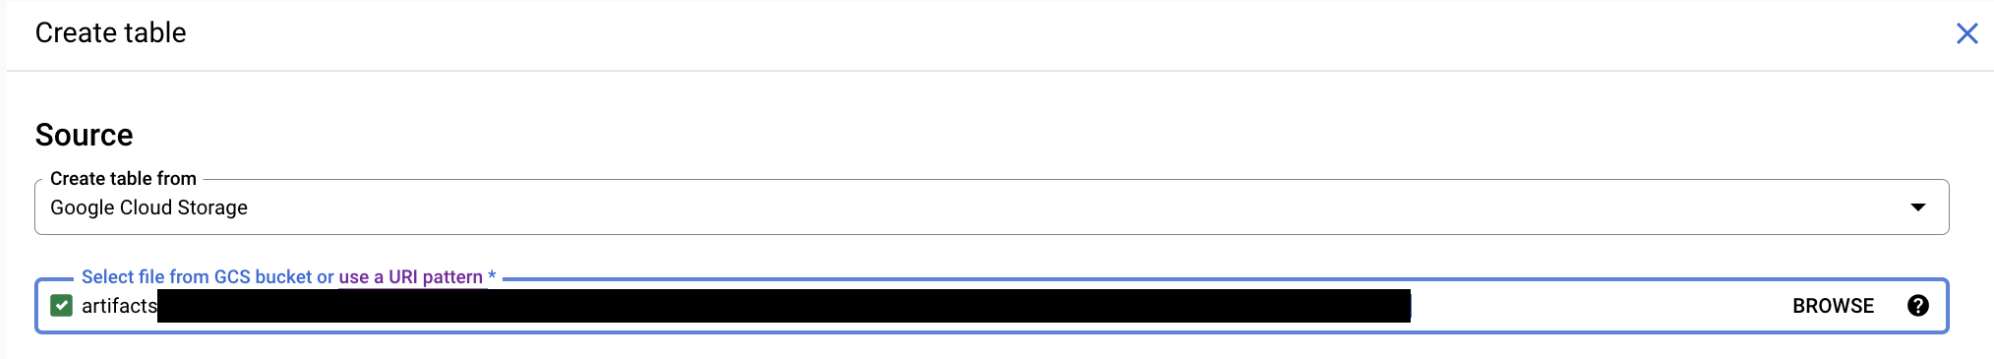
בקטע פורמט קובץ, בוחרים באפשרות CSV או JSON.
בדף Create table, בקטע Destination:
בקטע Dataset name, בוחרים את מערך הנתונים המתאים.
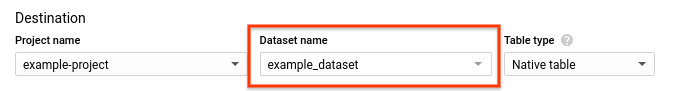
בשדה Table name, מזינים את שם הטבלה שיוצרים.
מוודאים שהשדה Table type מוגדר ל-Native table.
לוחצים על Create table.
BQ
מפעילים את הפקודה bq load עם הפרמטר --autodetect.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
הפקודה הבאה טוענת קובץ באמצעות זיהוי אוטומטי של סכימה:
bq --location=LOCATION load \
--autodetect \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: שם המיקום. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, הגדירו את ערך הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. -
FORMAT:NEWLINE_DELIMITED_JSONאוCSV. -
DATASET: קבוצת הנתונים שמכילה את הטבלה שאליה אתם טוענים נתונים. -
TABLE: שם הטבלה שאליה טוענים את הנתונים. PATH_TO_SOURCE: המיקום של קובץ ה-CSV או ה-JSON.
דוגמאות:
מזינים את הפקודה הבאה כדי לטעון את myfile.csv מהמכונה המקומית לטבלה בשם mytable שמאוחסנת במערך נתונים בשם mydataset.
bq load --autodetect --source_format=CSV mydataset.mytable ./myfile.csv
מזינים את הפקודה הבאה כדי לטעון את myfile.json מהמכונה המקומית לטבלה בשם mytable שמאוחסנת במערך נתונים בשם mydataset.
bq load --autodetect --source_format=NEWLINE_DELIMITED_JSON \
mydataset.mytable ./myfile.json
API
יוצרים משימת
loadשמפנה לנתוני המקור. למידע על יצירת משימות, קראו את המאמר הרצת משימות BigQuery באופן פרוגרמטי. מציינים את המיקום במאפייןlocationבקטעjobReference.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
sourceFormat. כדי להשתמש בזיהוי אוטומטי של סכימה, צריך להגדיר את הערך הזה ל-NEWLINE_DELIMITED_JSONאו ל-CSV.משתמשים במאפיין
autodetectכדי להגדיר את הזיהוי האוטומטי של הסכימה ל-true.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
כדי להפעיל זיהוי אוטומטי של סכימה, מגדירים את המאפיין LoadJobConfig.autodetect כ-True.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
זיהוי אוטומטי של סכימה למקורות נתונים חיצוניים
אפשר להשתמש בזיהוי אוטומטי של סכימה עם מקורות נתונים חיצוניים בפורמטים CSV, JSON ו-Google Sheets. כשמפעילים את הזיהוי האוטומטי של הסכימה, BigQuery מנסה להסיק באופן אוטומטי את הסכימה מנתוני המקור. אם לא תפעילו את הזיהוי האוטומטי של הסכימה במקורות האלה, תצטרכו לספק סכימה מפורשת.
אין צורך להפעיל זיהוי אוטומטי של סכימה כששולחים שאילתות לקובצי ייצוא חיצוניים של Avro, Parquet, ORC, Firestore או Datastore. פורמטים אלה של קבצים מתארים את עצמם, כך ש-BigQuery מסיק באופן אוטומטי את סכימת הטבלה מנתוני המקור. בקובצי Parquet, Avro ו-ORC, אפשר לספק סכימה מפורשת כדי לשנות את הסכימה שהמערכת הסיקה.
כדי להפעיל את הזיהוי האוטומטי של הסכימה במסוף Google Cloud , מסמנים את האפשרות Auto detect בקטע Schema and input parameters.
באמצעות כלי שורת הפקודה של BigQuery, אתם יכולים להפעיל זיהוי אוטומטי של סכימה כשאתם יוצרים קובץ הגדרת טבלה לנתונים בפורמט CSV, JSON או Google Sheets. כשמשתמשים בכלי bq כדי ליצור קובץ הגדרת טבלה, מעבירים את הדגל --autodetect לפקודה mkdef כדי להפעיל את הזיהוי האוטומטי של הסכימה, או מעבירים את הדגל --noautodetect כדי להשבית את הזיהוי האוטומטי.
כשמשתמשים בדגל --autodetect, ההגדרה autodetect נקבעת ל-true בקובץ הגדרת הטבלה. כשמשתמשים בדגל --noautodetect, ההגדרה autodetect מקבלת את הערך false. אם לא תספקו הגדרת סכימה למקור הנתונים החיצוני כשתיצרו הגדרת טבלה, ולא תשתמשו בדגל --noautodetect או --autodetect, ההגדרה של autodetect תהיה כברירת מחדל true.
כשיוצרים קובץ הגדרת טבלה באמצעות ה-API, מגדירים את הערך של המאפיין autodetect ל-true או ל-false. הגדרת המדיניות autodetect לערך true מפעילה את הזיהוי האוטומטי. הגדרת autodetect לערך false משביתה את הזיהוי האוטומטי.
פרטי הזיהוי האוטומטי
בנוסף לזיהוי פרטי הסכימה, הזיהוי האוטומטי מזהה את הפרטים הבאים:
דחיסה
כשפותחים קובץ, BigQuery מזהה דחיסת קבצים שתואמת ל-gzip.
ערכי תאריך ושעה
BigQuery מזהה ערכי תאריך ושעה על סמך הפורמט של נתוני המקור.
הערכים בעמודות DATE חייבים להיות בפורמט הבא: YYYY-MM-DD.
הערכים בעמודות TIME צריכים להיות בפורמט הבא: HH:MM:SS[.SSSSSS] (רכיב השניות החלקיות הוא אופציונלי).
בעמודות TIMESTAMP, המערכת של BigQuery מזהה מגוון רחב של פורמטים של חותמות זמן, כולל, בין היתר:
YYYY-MM-DD HH:MMYYYY-MM-DD HH:MM:SSYYYY-MM-DD HH:MM:SS.SSSSSSYYYY/MM/DD HH:MM
חותמת זמן יכולה גם להכיל הפרש זמן מ-UTC או את המציין של אזור הזמן UTC (האות Z).
הנה כמה דוגמאות לערכים ש-BigQuery יזהה באופן אוטומטי כערכים של חותמות זמן:
- 2018-08-19 12:11
- 2018-08-19 12:11:35.22
- 19/08/2018 12:11
- 2018-08-19 07:11:35.220 -05:00
אם הזיהוי האוטומטי לא מופעל והערך הוא בפורמט שלא מופיע בדוגמאות הקודמות, BigQuery יכול לטעון את העמודה רק כסוג הנתונים STRING. אתם יכולים להפעיל זיהוי אוטומטי כדי ש-BigQuery יזהה את העמודות האלה כחותמות זמן. לדוגמה, BigQuery יטען את 2025-06-16T16:55:22Z כחותמת זמן רק אם תפעילו את הזיהוי האוטומטי.
אפשר גם לעבד מראש את נתוני המקור לפני הטעינה. לדוגמה, אם אתם מייצאים נתוני CSV מגיליון אלקטרוני, הגדירו את פורמט התאריך כך שיתאים לאחת מהדוגמאות שמוצגות כאן. אפשר גם לשנות את הנתונים אחרי שטוענים אותם ל-BigQuery.
זיהוי אוטומטי של סכימה לנתוני CSV
תו מפריד בקובץ CSV
BigQuery מזהה את התווים המפרידים הבאים:
- פסיק ( , )
- קו ניצב ( | )
- טאב ( \t )
כותרת CSV
BigQuery מסיק מהן הכותרות על ידי השוואה בין השורה הראשונה בקובץ לשורות אחרות בקובץ. אם השורה הראשונה מכילה רק מחרוזות, והשורות האחרות מכילות סוגי נתונים אחרים, BigQuery מניח שהשורה הראשונה היא שורת כותרת. BigQuery מקצה שמות לעמודות על סמך שמות השדות בשורת הכותרת. יכול להיות שהשמות ישתנו כדי לעמוד בכללי מתן השמות לעמודות ב-BigQuery. לדוגמה, רווחים מוחלפים בקווים תחתונים.
אחרת, המערכת של BigQuery מניחה שהשורה הראשונה היא שורת נתונים, ומקצה שמות עמודות כלליים כמו string_field_1. שימו לב שאחרי שיוצרים טבלה, אי אפשר לעדכן את שמות העמודות בסכימה, אבל אפשר לשנות את השמות באופן ידני אחרי שיוצרים את הטבלה. אפשרות אחרת היא לספק סכימה מפורשת במקום להשתמש בזיהוי אוטומטי.
יכול להיות שיש לכם קובץ CSV עם שורת כותרת, שבו כל שדות הנתונים הם מחרוזות. במקרה כזה, BigQuery לא יזהה באופן אוטומטי שהשורה הראשונה היא כותרת. משתמשים באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת. אחרת, הכותרת מיובאת כנתונים. במקרה כזה, כדאי גם לספק סכימה מפורשת כדי שתוכלו להקצות שמות לעמודות.
שורות חדשות במירכאות בקובץ CSV
BigQuery מזהה תווי שורה חדשה במירכאות בתוך שדה CSV, ולא מפרש את תו השורה החדשה במירכאות כגבול של שורה.
פתרון בעיות
כשמזהים באופן אוטומטי סכימה של קובצי CSV, יכול להיות שתופיע השגיאה הבאה:
שגיאה: Error while reading data, error message: CSV processing encountered
too many errors, giving up.
השגיאה הזו יכולה להתרחש כשבקובץ ה-CSV יש שורת כותרת עם ערכי מחרוזת, ו-BigQuery לא זיהה אותה ככותרת. אפשר להשתמש באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת.
זיהוי אוטומטי של סכימה לנתוני JSON
שדות בתוך שדות ושדות חוזרים ב-JSON
BigQuery מסיק שדות חוזרים ושדות בתוך שדות בקובצי JSON. אם ערך השדה הוא אובייקט JSON, BigQuery טוען את העמודה כסוג RECORD. אם ערך השדה הוא מערך, BigQuery טוען את העמודה כעמודה חוזרת. דוגמה לנתוני JSON עם נתונים בתצוגת עץ ונתונים חוזרים מופיעה במאמר טעינת נתוני JSON בתצוגת עץ ונתונים חוזרים.
המרת מחרוזת
אם מפעילים זיהוי אוטומטי של סכימה, BigQuery ממיר מחרוזות לסוגים בוליאניים, מספריים או של תאריך/שעה, כשאפשר. לדוגמה, אם משתמשים בנתוני ה-JSON הבאים, הזיהוי האוטומטי של הסכימה ממיר את השדה id לעמודה INTEGER:
{ "name":"Alice","id":"12"}
{ "name":"Bob","id":"34"}
{ "name":"Charles","id":"45"}
מידע נוסף זמין במאמר טעינת נתוני JSON מ-Cloud Storage.
זיהוי אוטומטי של סכימה ב-Google Sheets
ב-Sheets, המערכת של BigQuery מזהה באופן אוטומטי אם השורה הראשונה היא שורת כותרת, בדומה לזיהוי אוטומטי של קובצי CSV. אם השורה הראשונה מזוהה ככותרת, BigQuery מקצה שמות לעמודות על סמך שמות השדות בשורת הכותרת ומדלג על השורה. יכול להיות שהשמות ישתנו כדי לעמוד בכללי מתן השמות לעמודות ב-BigQuery. לדוגמה, רווחים יוחלפו בקווים תחתונים.
אבטחת טבלאות
כדי לשלוט בגישה לטבלאות ב-BigQuery, קראו את המאמר בקרת גישה למשאבים באמצעות IAM.