


Crea tabelle di oggetti
Questo documento descrive come rendere accessibili i dati non strutturati in Cloud Storage in BigQuery creando una tabella di oggetti.
Per creare una tabella di oggetti, devi completare le seguenti attività:
- Crea un set di dati per contenere la tabella degli oggetti.
- Crea una connessione per leggere le informazioni sugli oggetti da Cloud Storage.
- Concedi il ruolo Storage Object Viewer (
roles/storage.objectViewer) al account di servizio associato alla connessione. - Crea la tabella di oggetti e associala alla connessione utilizzando l'istruzione
CREATE EXTERNAL TABLE.
Prima di iniziare
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the BigQuery and BigQuery Connection API APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the BigQuery and BigQuery Connection API APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Ruoli obbligatori
Per creare tabelle di oggetti, devi disporre dei seguenti ruoli nel progetto:
- Per creare set di dati e tabelle, devi disporre del ruolo BigQuery Data Editor (
roles/bigquery.dataEditor). - Per creare una connessione, devi disporre del ruolo Amministratore connessione BigQuery (
roles/bigquery.connectionAdmin). - Per concedere un ruolo al account di servizio della connessione, devi disporre del ruolo Amministratore IAM progetto (
roles/resourcemanager.projectIamAdmin).
Per eseguire query sulle tabelle di oggetti, devi disporre dei seguenti ruoli nel progetto:
- Ruolo BigQuery Data Viewer (
roles/bigquery.dataViewer) - Ruolo BigQuery Connection User (
roles/bigquery.connectionUser)
Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
bigquery.datasets.createbigquery.tables.createbigquery.tables.updatebigquery.connections.createbigquery.connections.getbigquery.connections.listbigquery.connections.updatebigquery.connections.usebigquery.connections.deletebigquery.connections.delegatestorage.bucket.*storage.object.*bigquery.jobs.createbigquery.tables.getbigquery.tables.getDatabigquery.readsessions.create
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Crea un set di dati
Crea un set di dati BigQuery per contenere la tabella di oggetti:
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
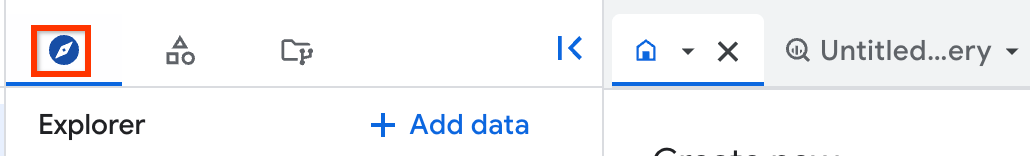
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, fai clic sul nome del progetto.
Fai clic su Visualizza azioni > Crea set di dati.
Nella pagina Crea set di dati, segui questi passaggi:
In ID set di dati, digita un nome per il set di dati.
Per Tipo di località, seleziona Regione o Multi-regione.
- Se hai selezionato Regione, seleziona una località dall'elenco Regione.
- Se hai selezionato Multiregione, seleziona Stati Uniti o Europa dall'elenco Multiregione.
Fai clic su Crea set di dati.
Crea una connessione
Puoi saltare questo passaggio se hai configurato una connessione predefinita o se hai il ruolo Amministratore BigQuery.
Crea una connessione alle risorse Cloud per la tabella esterna da utilizzare e ottieni il account di servizio della connessione.
Vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
Nel riquadro Explorer, fai clic su Aggiungi dati.
Si apre la finestra di dialogo Aggiungi dati.
Nel riquadro Filtra per, nella sezione Tipo di origine dati, seleziona Applicazioni aziendali.
In alternativa, nel campo Cerca origini dati, puoi inserire
Vertex AI.Nella sezione Origini dati in primo piano, fai clic su Vertex AI.
Fai clic sulla scheda della soluzione Modelli di AI Vertex AI: federazione BigQuery.
Nell'elenco Tipo di connessione, seleziona Modelli remoti di Vertex AI, funzioni remote, BigLake e Spanner (risorsa Cloud).
Nel campo ID connessione, digita un nome per la connessione.
Per Tipo di località, seleziona Regione o Multi-regione.
- Se hai selezionato Regione, seleziona una località dall'elenco Regione.
- Se hai selezionato Multiregione, seleziona Stati Uniti o Europa dall'elenco Multiregione.
Fai clic su Crea connessione.
Fai clic su Vai alla connessione.
Nel riquadro Informazioni sulla connessione, copia l'ID account di servizio da utilizzare in un passaggio successivo.
Concedi l'accesso al account di servizio
Concedi al account di servizio della connessione il ruolo Storage Object Viewer:
Console
Vai alla pagina IAM e amministrazione.
Fai clic su Aggiungi.
Viene visualizzata la finestra di dialogo Aggiungi entità.
Nel campo Nuove entità, inserisci l'ID del account di servizio che hai copiato in precedenza.
Nel campo Seleziona un ruolo, scegli Cloud Storage e poi seleziona Visualizzatore oggetti Storage.
Fai clic su Salva.
gcloud
Utilizza il comando gcloud projects add-iam-policy-binding.
gcloud projects add-iam-policy-binding 'PROJECT_NUMBER' --member='serviceAccount:MEMBER' --role='roles/storage.objectViewer' --condition=None
Sostituisci quanto segue:
PROJECT_NUMBER: il numero del progetto in cui concedere il ruolo.MEMBER: l'ID del account di servizio che hai copiato in precedenza.
Crea una tabella di oggetti
Per creare una tabella di oggetti:
SQL
Utilizza l'istruzione CREATE EXTERNAL TABLE.
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
CREATE EXTERNAL TABLE `PROJECT_ID.DATASET_ID.TABLE_NAME`
WITH CONNECTION {`PROJECT_ID.REGION.CONNECTION_ID`| DEFAULT}
OPTIONS(
  object_metadata = 'SIMPLE',
  uris = ['BUCKET_PATH'[,...]],
  max_staleness = STALENESS_INTERVAL,
  metadata_cache_mode = 'CACHE_MODE');
Sostituisci quanto segue:
PROJECT_ID: il tuo ID progetto.DATASET_ID: l'ID del set di dati che deve contenere la tabella degli oggetti.TABLE_NAME: il nome della tabella di oggetti.REGION: la regione o multi-regione che contiene la connessione.CONNECTION_ID: l'ID della connessione alle risorse Cloud da utilizzare con questa tabella di oggetti. La connessione determina quale service account viene utilizzato per leggere i dati da Cloud Storage.Quando visualizzi i dettagli della connessione nella console Google Cloud , l'ID connessione è il valore nell'ultima sezione dell'ID connessione completo mostrato in ID connessione, ad esempio
projects/myproject/locations/connection_location/connections/myconnection.Per utilizzare una connessione predefinita, specifica
DEFAULTanziché la stringa di connessione contenente PROJECT_ID.REGION.CONNECTION_ID.BUCKET_PATH: il percorso del bucket Cloud Storage che contiene gli oggetti rappresentati dalla tabella degli oggetti, nel formato['gs://bucket_name/[folder_name/]*'].Puoi utilizzare un carattere jolly asterisco (
*) in ogni percorso per limitare gli oggetti inclusi nella tabella degli oggetti. Ad esempio, se il bucket contiene diversi tipi di dati non strutturati, puoi creare la tabella degli oggetti solo sugli oggetti PDF specificando['gs://bucket_name/*.pdf']. Per saperne di più, consulta Supporto dei caratteri jolly per gli URI Cloud Storage.Puoi specificare più bucket per l'opzione
urisfornendo più percorsi, ad esempio['gs://mybucket1/*', 'gs://mybucket2/folder5/*']. Per prestazioni ottimali, specifica un massimo di 10 URI per tabella di oggetti. Se fornisci più di 10 URI dei bucket, il numero totale di file supportati dalla tabella di oggetti si riduce.Per saperne di più sull'utilizzo degli URI Cloud Storage in BigQuery, consulta Percorso della risorsa Cloud Storage.
STALENESS_INTERVAL: specifica se i metadati memorizzati nella cache vengono utilizzati dalle operazioni sulla tabella degli oggetti e quanto devono essere aggiornati i metadati memorizzati nella cache affinché l'operazione li utilizzi. Per ulteriori informazioni sulle considerazioni relative alla memorizzazione nella cache dei metadati, consulta Memorizzazione nella cache dei metadati per le prestazioni.Per disattivare la memorizzazione nella cache dei metadati, specifica 0. Questa è l'impostazione predefinita.
Per abilitare la memorizzazione nella cache dei metadati, specifica un valore valore letterale dell'intervallo compreso tra 30 minuti e 7 giorni. Ad esempio, specifica
INTERVAL 4 HOURper un intervallo di inattività di 4 ore. Con questo valore, le operazioni sulla tabella utilizzano i metadati memorizzati nella cache se sono stati aggiornati nelle ultime 4 ore. Se i metadati memorizzati nella cache sono più vecchi, l'operazione recupera i metadati da Cloud Storage.CACHE_MODE: specifica se la cache dei metadati viene aggiornata automaticamente o manualmente. Per saperne di più sulle considerazioni relative alla memorizzazione nella cache dei metadati, consulta Memorizzazione nella cache dei metadati per le prestazioni.Imposta su
AUTOMATICper aggiornare la cache dei metadati a un intervallo definito dal sistema, in genere compreso tra 30 e 60 minuti.Impostalo su
MANUALse vuoi aggiornare la cache dei metadati in base a una pianificazione che hai stabilito. In questo caso, puoi chiamare la procedura di sistemaBQ.REFRESH_EXTERNAL_METADATA_CACHEper aggiornare la cache.Devi impostare
CACHE_MODEseSTALENESS_INTERVALè impostato su un valore maggiore di 0.
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
Esempi
L'esempio seguente crea una tabella di oggetti con un intervallo di inattività della cache dei metadati di 1 giorno:
CREATE EXTERNAL TABLE `my_dataset.object_table`
WITH CONNECTION `us.my-connection`
OPTIONS(
  object_metadata = 'SIMPLE',
  uris = ['gs://mybucket/*'],
  max_staleness = INTERVAL 1 DAY,
  metadata_cache_mode = 'AUTOMATIC'
);
L'esempio seguente crea una tabella di oggetti sugli oggetti in tre bucket Cloud Storage:
CREATE EXTERNAL TABLE `my_dataset.object_table`
WITH CONNECTION `us.my-connection`
OPTIONS(
  object_metadata = 'SIMPLE',
  uris = ['gs://bucket1/*','gs://bucket2/folder1/*','gs://bucket3/*']
);
L'esempio seguente crea una tabella di oggetti solo sugli oggetti PDF in un bucket Cloud Storage:
CREATE EXTERNAL TABLE `my_dataset.object_table`
WITH CONNECTION `us.my-connection`
OPTIONS(
  object_metadata = 'SIMPLE',
  uris = ['gs://bucket1/*.pdf']
);
bq
Utilizza il comando bq mk.
bq mk --table \
--external_table_definition=BUCKET_PATH@REGION.CONNECTION_ID \
--object_metadata=SIMPLE \
--max_staleness=STALENESS_INTERVAL \
--metadata_cache_mode=CACHE_MODE \
PROJECT_ID:DATASET_ID.TABLE_NAME
Sostituisci quanto segue:
PROJECT_ID: il tuo ID progetto.DATASET_ID: l'ID del set di dati che deve contenere la tabella degli oggetti.TABLE_NAME: il nome della tabella di oggetti.REGION: la regione o multi-regione che contiene la connessione.CONNECTION_ID: l'ID della connessione alle risorse Cloud da utilizzare con questa tabella esterna. La connessione determina quale account di servizio viene utilizzato per leggere i dati da Cloud Storage.Quando visualizzi i dettagli della connessione nella console Google Cloud , l'ID connessione è il valore nell'ultima sezione dell'ID connessione completo mostrato in ID connessione, ad esempio
projects/myproject/locations/connection_location/connections/myconnection.BUCKET_PATH: il percorso del bucket Cloud Storage che contiene gli oggetti rappresentati dalla tabella degli oggetti, nel formatogs://bucket_name/[folder_name/]*.Puoi utilizzare un carattere jolly asterisco (
*) in ogni percorso per limitare gli oggetti inclusi nella tabella degli oggetti. Ad esempio, se il bucket contiene diversi tipi di dati non strutturati, puoi creare la tabella degli oggetti solo sugli oggetti PDF specificandogs://bucket_name/*.pdf. Per saperne di più, consulta Supporto dei caratteri jolly per gli URI Cloud Storage.Puoi specificare più bucket per l'opzione
urisfornendo più percorsi, ad esempiogs://mybucket1/*,gs://mybucket2/folder5/*.Per saperne di più sull'utilizzo degli URI Cloud Storage in BigQuery, consulta Percorso della risorsa Cloud Storage.
STALENESS_INTERVAL: specifica se i metadati memorizzati nella cache vengono utilizzati dalle operazioni sulla tabella degli oggetti e quanto devono essere aggiornati i metadati memorizzati nella cache affinché l'operazione li utilizzi. Per ulteriori informazioni sulle considerazioni relative alla memorizzazione nella cache dei metadati, consulta Memorizzazione nella cache dei metadati per le prestazioni.Per disattivare la memorizzazione nella cache dei metadati, specifica 0. Questa è l'impostazione predefinita.
Per attivare la memorizzazione nella cache dei metadati, specifica un valore di intervallo compreso tra 30 minuti e 7 giorni, utilizzando il formato
Y-M D H:M:Sdescritto nella documentazione del tipo di datiINTERVAL. Ad esempio, specifica0-0 0 4:0:0per un intervallo di inattività di 4 ore. Con questo valore, le operazioni sulla tabella utilizzano i metadati memorizzati nella cache se sono stati aggiornati nelle ultime 4 ore. Se i metadati memorizzati nella cache sono più vecchi, l'operazione recupera i metadati da Cloud Storage.CACHE_MODE: specifica se la cache dei metadati viene aggiornata automaticamente o manualmente. Per saperne di più sulle considerazioni relative alla memorizzazione nella cache dei metadati, consulta Memorizzazione nella cache dei metadati per le prestazioni.Imposta su
AUTOMATICper aggiornare la cache dei metadati a un intervallo definito dal sistema, in genere compreso tra 30 e 60 minuti.Imposta su
MANUALse vuoi aggiornare la cache dei metadati in base a una pianificazione che hai stabilito. In questo caso, puoi chiamare la procedura di sistemaBQ.REFRESH_EXTERNAL_METADATA_CACHEper aggiornare la cache.Devi impostare
CACHE_MODEseSTALENESS_INTERVALè impostato su un valore maggiore di 0.
Esempi
L'esempio seguente crea una tabella di oggetti con un intervallo di inattività della cache dei metadati di 1 giorno:
bq mk --table \
--external_table_definition=gs://mybucket/*@us.my-connection \
--object_metadata=SIMPLE \
--max_staleness=0-0 1 0:0:0 \
--metadata_cache_mode=AUTOMATIC \
my_dataset.object_table
L'esempio seguente crea una tabella di oggetti sugli oggetti in tre bucket Cloud Storage:
bq mk --table \
--external_table_definition=gs://bucket1/*,gs://bucket2/folder1/*,gs://bucket3/*@us.my-connection \
--object_metadata=SIMPLE \
my_dataset.object_table
L'esempio seguente crea una tabella di oggetti solo sugli oggetti PDF in un bucket Cloud Storage:
bq mk --table \
--external_table_definition=gs://bucket1/*.pdf@us.my-connection \
--object_metadata=SIMPLE \
my_dataset.object_table
API
Chiama il
metodo tables.insert.
Includi un
oggetto ExternalDataConfiguration
con il campo objectMetadata impostato su SIMPLE nella
risorsa Table
che passi.
L'esempio seguente mostra come chiamare questo metodo utilizzando curl:
ACCESS_TOKEN=$(gcloud auth print-access-token) curl \
-H "Authorization: Bearer ${ACCESS_TOKEN}" \
-H "Content-Type: application/json" \
-X POST \
-d '{"tableReference": {"projectId": "my_project", "datasetId": "my_dataset", "tableId": "object_table_name"}, "externalDataConfiguration": {"objectMetadata": "SIMPLE", "sourceUris": ["gs://mybucket/*"]}}' \
https://www.googleapis.com/bigquery/v2/projects/my_project/datasets/my_dataset/tables
Terraform
Questo esempio crea una tabella di oggetti con la memorizzazione nella cache dei metadati abilitata con l'aggiornamento manuale.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
I campi chiave da specificare per una tabella di oggetti sono google_bigquery_table.external_data_configuration.object_metadata, google_bigquery_table.external_data_configuration.metadata_cache_mode e google_bigquery_table.max_staleness. Per saperne di più su ogni risorsa, consulta la documentazione di Terraform BigQuery.
Per applicare la configurazione Terraform in un progetto Google Cloud , completa i passaggi descritti nelle sezioni seguenti.
Prepara Cloud Shell
- Avvia Cloud Shell.
-
Imposta il progetto Google Cloud predefinito in cui vuoi applicare le configurazioni Terraform.
Devi eseguire questo comando una sola volta per progetto e puoi eseguirlo in qualsiasi directory.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Le variabili di ambiente vengono sostituite se imposti valori espliciti nel file di configurazione Terraform.
Prepara la directory
Ogni file di configurazione Terraform deve avere la propria directory (chiamata anche modulo principale).
-
In Cloud Shell, crea una directory e un nuovo file al suo interno. Il nome file deve avere l'estensione
.tf, ad esempiomain.tf. In questo tutorial, il file è denominatomain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Se stai seguendo un tutorial, puoi copiare il codice campione in ogni sezione o passaggio.
Copia il codice campione nel file
main.tfappena creato.Facoltativamente, copia il codice da GitHub. Questa opzione è consigliata quando lo snippet Terraform fa parte di una soluzione end-to-end.
- Esamina e modifica i parametri di esempio da applicare al tuo ambiente.
- Salva le modifiche.
-
Inizializza Terraform. Devi eseguire questa operazione una sola volta per directory.
terraform init
Facoltativamente, per utilizzare l'ultima versione del provider Google, includi l'opzione
-upgrade:terraform init -upgrade
Applica le modifiche
-
Esamina la configurazione e verifica che le risorse che Terraform creerà o aggiornerà corrispondano alle tue aspettative:
terraform plan
Apporta le correzioni necessarie alla configurazione.
-
Applica la configurazione Terraform eseguendo il comando seguente e inserendo
yesal prompt:terraform apply
Attendi che Terraform visualizzi il messaggio "Apply complete!".
- Apri il tuo progetto Google Cloud per visualizzare i risultati. Nella console Google Cloud , vai alle risorse nell'interfaccia utente per assicurarti che Terraform le abbia create o aggiornate.
Esegui query sulle tabelle di oggetti
Puoi eseguire query su una tabella di oggetti come su qualsiasi altra tabella BigQuery, ad esempio:
SELECT *
FROM mydataset.myobjecttable;
L'esecuzione di query su una tabella di oggetti restituisce i metadati per gli oggetti sottostanti. Per saperne di più, consulta Schema della tabella degli oggetti.
Passaggi successivi
- Scopri come eseguire l'inferenza sulle tabelle degli oggetti immagine.
- Scopri come analizzare le tabelle di oggetti utilizzando le funzioni remote.