


Ce tutoriel vous explique comment utiliser des requêtes SQL, les fonctions AI.GENERATE et AI.EMBED, ainsi que BigQuery DataFrames pour analyser les données multimodales de l'ensemble de données public Cymbal Pet Store.
La fonction AI.GENERATE vous permet d'analyser n'importe quelle combinaison de données structurées et non structurées, et la fonction AI.EMBED vous permet de créer des embeddings à partir de données textuelles ou d'image dans BigQuery.
Pour trouver des images similaires, utilisez la fonction VECTOR_SEARCH. La fonction VECTOR_SEARCH vous permet d'effectuer une recherche sémantique ou hybride sur les embeddings pour trouver des entités similaires.
Ce tutoriel utilise une table d'objets persistante qui stocke les valeurs ObjectRef.
Objectifs
- Utilisez les valeurs
ObjectRefpour stocker les données d'image aux côtés des données structurées dans une table BigQuery. - Utilisez la fonction
AI.GENERATEpour enrichir vos données. - Utilisez la fonction
AI.EMBEDpour générer des embeddings basés sur des données d'image. - Utilisez la fonction
VECTOR_SEARCHpour trouver des images similaires. - Utilisez des tableaux de valeurs
ObjectRefpour résumer les manuels d'utilisation.
Coûts
Dans ce document, vous utilisez les composants facturables suivants de Google Cloud :
- BigQuery: you incur costs for the data that you process in BigQuery.
- Cloud Storage: you incur costs for reading the objects stored in Cloud Storage.
- Gemini Enterprise Agent Platform: you incur costs for calls to Agent Platform models.
Pour obtenir une estimation des coûts en fonction de votre utilisation prévue, utilisez le simulateur de coût.
Pour en savoir plus sur les coûts, consultez les pages suivantes sur les tarifs :
Avant de commencer
-
Dans la console Google Cloud , sur la page de sélection du projet, sélectionnez ou créez un projet Google Cloud .
Rôles requis pour sélectionner ou créer un projet
- Sélectionnez un projet : la sélection d'un projet ne nécessite pas de rôle IAM spécifique. Vous pouvez sélectionner n'importe quel projet pour lequel un rôle vous a été attribué.
-
Créer un projet : pour créer un projet, vous devez disposer du rôle Créateur de projet (
roles/resourcemanager.projectCreator), qui contient l'autorisationresourcemanager.projects.create. Découvrez comment attribuer des rôles.
-
Vérifiez que la facturation est activée pour votre projet Google Cloud .
-
Activez les API BigQuery, BigQuery Connection, Cloud Storage et Agent Platform.
Rôles requis pour activer les API
Pour activer les API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation grâce au rôle Propriétaire (roles/owner). Sinon, vous pouvez obtenir cette autorisation grâce au rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.
Rôles requis
Pour obtenir les autorisations nécessaires pour suivre ce tutoriel, demandez à votre administrateur de vous accorder les rôles IAM suivants :
-
Créer des ensembles de données et des tables : Propriétaire de données BigQuery (
roles/bigquery.dataOwner) -
Pour exécuter des jobs BigQuery : Utilisateur de job BigQuery (
roles/bigquery.jobUser) -
Créer des connexions : Administrateur de connexion BigQuery (
roles/bigquery.connectionAdmin) -
Accorder des autorisations au compte de service d'une connexion : Administrateur de projet IAM (
roles/resourcemanager.projectIamAdmin) -
Créer des URL qui vous permettent de lire et de modifier des objets Cloud Storage :
Administrateur d'ObjectRef BigQuery (
roles/bigquery.objectRefAdmin)
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Vous pouvez également obtenir les autorisations requises avec des rôles personnalisés ou d'autres rôles prédéfinis.
Créer l'ensemble de données, les tables, les modèles et la connexion
Dans cette section, vous allez créer l'ensemble de données, la connexion, les tables et les modèles utilisés dans ce tutoriel.
Créer un ensemble de données
Créez un ensemble de données BigQuery pour contenir les objets que vous allez créer dans ce tutoriel. Pour ce faire, choisissez l'une des options suivantes :
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
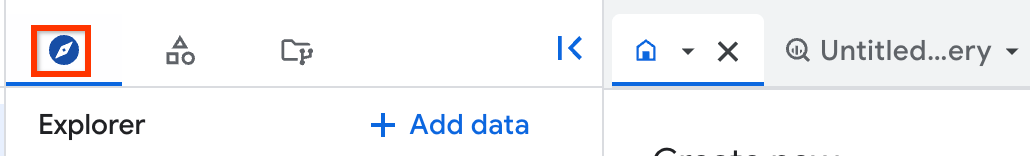
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans l'explorateur, développez votre projet, puis cliquez sur Ensembles de données.
Sur la page Ensembles de données, cliquez sur Créer un ensemble de données.
Sur la page Créer un ensemble de données, procédez comme suit :
Dans le champ ID de l'ensemble de données, saisissez
cymbal_pets.Pour Emplacement des données, sélectionnez États-Unis.
Conservez les autres paramètres par défaut, puis cliquez sur Créer un ensemble de données.
SQL
Utilisez l'instruction CREATE SCHEMA.
Dans la console Google Cloud , accédez à la page BigQuery.
Dans l'éditeur de requête, saisissez l'instruction suivante :
CREATE SCHEMA PROJECT_ID.cymbal_pets
  OPTIONS (
    description = 'Dataset for BigQuery ML tutorial',
    location = 'US');
Remplacez
PROJECT_IDpar l'ID du projet.Cliquez sur Exécuter.
Pour en savoir plus sur l'exécution des requêtes, consultez Exécuter une requête interactive.
Vous recevez un message de confirmation semblable à celui-ci : The dataset
named cymbal_pets was created.
Créer une connexion
Créez une connexion aux ressources Cloud et obtenez le compte de service de la connexion. BigQuery utilise la connexion pour accéder aux objets dans Cloud Storage.
Dans le volet de gauche, cliquez sur Explorateur :
Dans le volet Explorateur, cliquez sur Connexions.
Sur la page Connexions, cliquez sur Créer une connexion.
Sur la page Source de données externes, procédez comme suit :
Pour Type de connexion, sélectionnez Modèles distants Vertex AI, fonctions à distance, Lakehouse et Spanner (ressource Cloud).
Dans le champ ID de connexion, saisissez
cymbal_conn.Laissez les autres paramètres tels quels, puis cliquez sur Créer une connexion.
Sur la page Connexions, cliquez sur
cymbal_conn.Dans le volet Informations de connexion, copiez la valeur ID du compte de service. Elle est requise pour les étapes suivantes.
Accorder des autorisations pour utiliser les modèles Agent Platform
Attribuez le rôle "Utilisateur Agent Platform" au compte de service de la connexion pour accéder aux modèles à distance dans Agent Platform. Vous devez accorder ce rôle dans le projet que vous avez créé ou sélectionné précédemment. L'attribution des rôles dans un autre projet génère l'erreur bqcx-1234567890-abcd@gcp-sa-bigquery-condel.iam.gserviceaccount.com
does not have the permission to access resource.
Pour accorder au compte de service l'accès aux modèles Agent Platform, procédez comme suit :
Accédez à la page IAM et administration.
Cliquez sur Accorder l'accès.
Dans la boîte de dialogue Accorder l'accès, procédez comme suit :
Dans le champ Nouveaux comptes principaux, saisissez l'ID du compte de service que vous avez copié précédemment.
Dans le champ Sélectionner un rôle, choisissez ou recherchez Utilisateur Agent Platform.
Cliquez sur Enregistrer.
Créer la table products
Pour créer une table standard contenant les informations produit des animaux de compagnie Cymbal, procédez comme suit pour charger les données depuis Cloud Storage :
Dans la console Google Cloud , accédez à la page Studio.
Pour créer la table
products, choisissez l'une des options suivantes :SQL
Collez cette commande dans l'éditeur de requête, puis cliquez sur Exécuter :
LOAD DATA OVERWRITE cymbal_pets.products
FROM
  FILES(
    format = 'avro',
    uris = [
      'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/tables/products/products_*.avro']);
Vous recevez un message de confirmation semblable à celui-ci :
Data was
successfully loaded into managed table.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames. Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application. Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Créer la table product_images
Pour créer une table d'objets (product_images) contenant les images des produits Cymbal Pets, sélectionnez l'une des options suivantes :
* { SQL }
Paste this command into the query editor, and then click
<span class="material-icons" aria-hidden="true">play_circle</span>
**Run**:
<pre class="lang-googlesql notranslate prettyprint devsite-click-to-copy">
CREATE OR REPLACE EXTERNAL TABLE cymbal_pets.product_images
WITH CONNECTION `us.cymbal_conn`
OPTIONS (
object_metadata = 'SIMPLE',
uris = ['gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/images/*.png'],
max_staleness = INTERVAL 30 MINUTE,
metadata_cache_mode = AUTOMATIC);
</pre>
You receive a confirmation message similar to the following: `This
statement created a new table named product_images.`
* { BigQuery DataFrames }
Before trying this sample, follow the BigQuery DataFrames
setup instructions in the BigQuery quickstart
using BigQuery DataFrames.
For more information, see the
BigQuery DataFrames reference documentation.
To authenticate to BigQuery, set up Application Default Credentials.
For more information, see Set
up ADC for a local development environment.
Créer des modèles
Les instructions SQL de ce tutoriel montrent comment appeler des fonctions d'IA qui ne nécessitent pas de créer un modèle. Si vous suivez les instructions de BigQuery DataFrames, sélectionnez cette option pour créer des modèles distants qui représentent un modèle Gemini et un modèle d'embedding multimodal.
SQL
Vous pouvez passer cette étape.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Créer une table products_mm avec des données multimodales
Créez une table products_mm contenant une colonne image remplie avec des images de produits provenant de la table d'objets product_images. La colonne image créée est une colonne STRUCT qui utilise des valeurs ObjectRef pour stocker les données d'image aux côtés des données structurées dans une table standard BigQuery.
Une valeur ObjectRef est un type STRUCT avec un schéma prédéfini qui fait référence aux objets Cloud Storage pour l'analyse multimodale.
Les valeurs ObjectRef peuvent être traitées par des fonctions OBJ, des fonctions d'IA ou des fonctions définies par l'utilisateur Python.
Pour créer et remplir la table products_mm, procédez comme suit :
Pour créer une table products_mm, choisissez l'une des options suivantes :
SQL
Collez cette commande dans l'éditeur de requête, puis cliquez sur
Exécuter :
CREATE OR REPLACE TABLE cymbal_pets.products_mm
AS
SELECT products.* EXCEPT (uri), ot.ref AS image FROM cymbal_pets.products
INNER JOIN cymbal_pets.product_images ot
ON ot.uri = products.uri;
Vous recevez un message de confirmation semblable à celui-ci : This
statement created a new table named products_mm.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour afficher les données de la colonne image, choisissez l'une des options suivantes :
SQL
Collez cette commande dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT product_name, image
FROM cymbal_pets.products_mm
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| product_name | image.uri | image.version | image.authorizer | image.details |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| AquaClear Aquarium Background | gs://cloud-samples-data/bigquery/ | 1234567891011 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"image/png", |
| | tutorials/cymbal-pets/images/ | | | "md5_hash":"494f63b9b137975ff3e7a11b060edb1d", |
| | aquaclear-aquarium-background.png | | | "size":1282805,"updated":1742492680017000}} |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| AquaClear Aquarium | gs://cloud-samples-data/bigquery/ | 2345678910112 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"image/png", |
| Gravel Vacuum | tutorials/cymbal-pets/images/ | | | "md5_hash":"b7bfc2e2641a77a402a1937bcf0003fd", |
| | aquaclear-aquarium-gravel-vacuum.png | | | "size":820254,"updated":1742492682411000}} |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| ... | ... | ... | | ... |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
Générer des informations produit
Utilisez la fonction AI.GENERATE pour générer les données suivantes pour les produits de l'animalerie :
- Ajoutez une colonne
image_description au tableau products_mm.
- Remplissez les colonnes
animal_type, search_keywords et subcategory de la table products_mm.
- Exécutez une requête qui renvoie une description de chaque marque de produit ainsi que le nombre de produits de cette marque. La description de la marque est générée en analysant les informations produit pour tous les produits de cette marque, y compris les images des produits.
La fonction AI.GENERATE vous permet de générer du texte ou des sorties structurées selon un schéma personnalisé que vous spécifiez. La fonction envoie des requêtes à un modèle Gemini et renvoie une structure contenant les données générées, la réponse complète du modèle et un état.
Pour générer les données produit, procédez comme suit :
Pour générer les informations produit à l'aide de AI.GENERATE, choisissez l'une des options suivantes :
SQL
Pour créer et remplir la colonne image_description, collez le code suivant dans l'éditeur de requête, puis cliquez sur
Exécuter :
-- Add the column to the existing table
ALTER TABLE bqml_tutorial.products_mm
ADD COLUMN IF NOT EXISTS image_description STRING;
-- Populate the new column using the AI.GENERATE function
UPDATE bqml_tutorial.products_mm
SET image_description = AI.GENERATE(
('Describe the following image: ', image),
endpoint => 'gemini-3.5-flash'
).result
WHERE image_description IS NULL;
Vous recevez un message de confirmation semblable à celui-ci : This
statement altered the table named products_mm.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour afficher le contenu de la colonne image_description, collez ce qui suit dans l'éditeur de requête, puis cliquez sur Exécuter :
SELECT product_name, image_description
FROM cymbal_pets.products_mm;
Les résultats ressemblent à ce qui suit :
+--------------------------------+-------------------------------------+
| product_name | image_description |
+--------------------------------+-------------------------------------+
| AquaClear Aquarium Background | The image shows a colorful coral |
| | reef backdrop. The background is a |
| | blue ocean with a bright light... |
| | |
| | |
+--------------------------------+-------------------------------------+
| AquaClear Aquarium | The image shows a long, clear |
| Gravel Vacuum | plastic tube with a green hose |
| | attached to one end. The tube... |
| | |
| | |
+--------------------------------+-------------------------------------+
| ... | ... |
+--------------------------------+-------------------------------------+
Pour mettre à jour les colonnes animal_type, search_keywords et subcategory avec les données générées, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
UPDATE cymbal_pets.products_mm t
SET
animal_type = r.animal_type,
search_keywords = SPLIT(r.search_keywords, ','),
subcategory = r.subcategory
FROM (
SELECT
product_id,
g.* EXCEPT(full_response, status)
FROM bqml_tutorial.products_mm,
UNNEST([AI.GENERATE(
('For the image and description of a pet product, concisely generate the following metadata: 1) animal_type and 2) 5 SEO search keywords (comma separated), and 3) product subcategory. ', image, description),
endpoint => 'gemini-3.5-flash',
output_schema => 'animal_type STRING, search_keywords STRING, subcategory STRING'
)]) AS g
) r
WHERE t.product_id = r.product_id;
Vous recevez un message de confirmation semblable à celui-ci : This
statement modified 205 rows in products_mm.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour afficher les données générées, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT
product_name,
image_description,
animal_type,
search_keywords,
subcategory,
FROM cymbal_pets.products_mm;
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| product_name | image_description | animal_type | search_keywords | subcategory |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| AquaClear Aquarium Background | The image shows a colorful coral | fish | aquarium background | aquarium decor |
| | reef backdrop. The background is a | | fish tank backdrop | |
| | blue ocean with a bright light... | | coral reef decor | |
| | | | underwater scenery | |
| | | | aquarium decoration | |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| AquaClear Aquarium | The image shows a long, clear | fish | aquarium gravel vacuum | aquarium |
| Gravel Vacuum | plastic tube with a green hose | | aquarium cleaning | cleaning |
| | attached to one end. The tube... | | aquarium maintenance | |
| | | | fish tank cleaning | |
| | | | gravel siphon | |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| ... | ... | ... | ... | ... |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
Pour générer une description de chaque marque de produit et un décompte du nombre de produits de cette marque, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT
brand,
COUNT(*) AS cnt,
AI.GENERATE(('Use the images and text to give one concise brand description ',
'for a website brand page. Return the description only.',
ARRAY_AGG(image LIMIT 10), ARRAY_AGG(description), ARRAY_AGG(category),
ARRAY_AGG(subcategory)),
endpoint => 'gemini-2.5-pro').result AS brand_description
FROM
cymbal_pets.products_mm
GROUP BY brand
ORDER BY cnt DESC;
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+--------------+-------------------------------------+-----+
| brand | brand_description | cnt |
+--------------+-------------------------------------+-----+
| AquaClear | AquaClear is a brand of aquarium | 33 |
| | and pond care products that offer | |
| | a wide range of solutions for... | |
+--------------+-------------------------------------+-----+
| Ocean | Ocean Bites is a brand of cat food | 28 |
| Bites | that offers a variety of recipes | |
| | and formulas to meet the specific.. | |
+--------------+-------------------------------------+-----+
| ... | ... |... |
+--------------+-------------------------------------+-----+
Générer des embeddings et effectuer une recherche vectorielle
Générez des embeddings à partir de données d'image, puis utilisez-les pour renvoyer des images similaires à l'aide de la recherche vectorielle.
Dans un scénario de production, nous vous recommandons de créer un index vectoriel avant d'exécuter une recherche vectorielle. Un index vectoriel vous permet d'effectuer une recherche vectorielle plus rapidement et renvoie des résultats plus approximatifs, mais le rappel est réduit.
Pour créer les embeddings et effectuer une recherche vectorielle, procédez comme suit :
Pour créer la table products_embeddings, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
CREATE OR REPLACE TABLE cymbal_pets.products_embedding
AS (
SELECT
product_id,
AI.EMBED(image, endpoint => 'gemini-embedding-2').result AS embedding,
image
FROM cymbal_pets.products_mm
);
Vous recevez un message de confirmation semblable à celui-ci : This
statement created a new table named products_embedding.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour effectuer une recherche vectorielle qui renvoie des images de produits semblables à l'image d'entrée donnée, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT *
FROM
VECTOR_SEARCH(
TABLE cymbal_pets.products_embedding,
'embedding',
query_value => AI.EMBED(
OBJ.MAKE_REF('gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/images/cozy-naps-cat-scratching-post-with-condo.png'),
endpoint => 'gemini-embedding-2').result);
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| query.embedding | base.product_id | base.embedding | base.image.uri | base.image.version | base.image.authorizer | base.image.details | distance |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| -0.0112330541 | 181 | -0.0112330541 | gs://cloud-samples-data/bigquery/ | 12345678910 | myproject.region.myconnection | {"gcs_metadata":{"content_type": | 0.0 |
| 0.0142525584 | | 0.0142525584 | tutorials/cymbal-pets/images/ | | | "image/png","md5_hash":"21234567hst16555w60j", | |
| 0.0135886827 | | 0.0135886827 | cozy-naps-cat-scratching-post-with-condo.png | | | "size":828318,"updated":1742492688982000}} | |
| 0.0149955815 | | 0.0149955815 | | | | | |
| ... | | ... | | | | | |
| | | | | | | | |
| | | | | | | | |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| -0.0112330541 | 187 | -0.0190353896 | gs://cloud-samples-data/bigquery/ | 23456789101 | myproject.region.myconnection | {"gcs_metadata":{"content_type": | 0.4216330832.. |
| 0.0142525584 | | 0.0116206668 | tutorials/cymbal-pets/images/ | | | "image/png","md5_hash":"7328728fhakd9937djo4", | |
| 0.0135886827 | | 0.0136198215 | cozy-naps-cat-scratching-post-with-bed.png | | | "size":860113,"updated":1742492688774000}} | |
| 0.0149955815 | | 0.0173457414 | | | | | |
| ... | | ... | | | | | |
| | | | | | | | |
| | | | | | | | |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| ... | ... | ... | ... | ... | ... | ... | ... |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
Traiter des données multimodales ordonnées à l'aide de tableaux de valeurs ObjectRef
Cette section vous explique comment résumer des manuels d'utilisation en traitant des données multimodales ordonnées à l'aide de tableaux de valeurs ObjectRef. BigQuery peut analyser plusieurs fichiers non structurés simultanément à l'aide de tableaux.
Effectuez les tâches suivantes :
Créez la table product_manuals de sorte qu'elle contienne à la fois un fichier PDF pour le manuel du produit Crittercuisine Pro 5000 et des fichiers PDF pour chaque page de ce manuel.
Créez un tableau qui mappe le manuel à ses blocs. Le manuel complet et les pages du manuel sont chacun stockés dans une colonne ObjectRef.
Analysez un tableau de valeurs ObjectRef ensemble pour renvoyer une seule valeur générée.
Analysez un tableau de valeurs ObjectRef séparément et renvoyez une valeur générée pour chaque valeur du tableau.
Pour traiter des données multimodales ordonnées à l'aide de valeurs ObjectRef, procédez comme suit :
Pour créer la table product_manuals, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
CREATE OR REPLACE EXTERNAL TABLE `cymbal_pets.product_manuals`
WITH CONNECTION `us.cymbal_conn`
OPTIONS (
object_metadata = 'SIMPLE',
uris = [
'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/documents/*.pdf',
'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/document_chunks/*.pdf']);
Vous recevez un message de confirmation semblable à celui-ci : This
statement created a new table named product_manuals.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour écrire des données PDF dans la table map_manual_to_chunks, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
-- Extract the file and chunks into a single table.
-- Store the chunks in the chunks column as array of ObjectRefs (ordered by page number)
CREATE OR REPLACE TABLE cymbal_pets.map_manual_to_chunks
AS
SELECT ARRAY_AGG(m1.ref)[0] manual, ARRAY_AGG(m2.ref ORDER BY m2.ref.uri) chunks
FROM cymbal_pets.product_manuals m1
JOIN cymbal_pets.product_manuals m2
ON
REGEXP_EXTRACT(m1.uri, r'.*/([^.]*).[^/]+')
= REGEXP_EXTRACT(m2.uri, r'.*/([^.]*)_page[0-9]+.[^/]+')
GROUP BY m1.uri;
Vous recevez un message de confirmation semblable à celui-ci : This
statement created a new table named map_manual_to_chunks.
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Pour afficher les données PDF dans le tableau map_manual_to_chunks, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT *
FROM cymbal_pets.map_manual_to_chunks;
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| manual.uri | manual.version | manual.authorizer | manual.details | chunks.uri | chunks.version | chunks.authorizer | chunks.details |
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| gs://cloud-samples-data/bigquery/ | 1742492785900455 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"application/pef", | gs://cloud-samples-data/bigquery/ | 1745875761227129 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"application/pdf", |
| tutorials/cymbal-pets/documents/ | | | "md5_hash":"c9032b037693d15a33210d638c763d0e", | tutorials/cymbal-pets/documents/ | | | "md5_hash":"5a1116cce4978ec1b094d8e8b49a1d7c", |
| crittercuisine_5000_user_manual.pdf | | | "size":566105,"updated":1742492785941000}} | crittercuisine_5000_user_manual_page1.pdf | | | "size":504583,"updated":1745875761266000}} |
| | | | +-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| | | | | crittercuisine_5000_user_manual_page1.pdf | 1745875760613874 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"application/pdf", |
| | | | | tutorials/cymbal-pets/documents/ | | | "md5_hash":"94d03ec65d28b173bc87eac7e587b325", |
| | | | | crittercuisine_5000_user_manual_page2.pdf | | | "size":94622,"updated":1745875760649000}} |
| | | | +-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| | | | | ... | ... | ... | ... |
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
Pour générer une seule réponse à partir d'un modèle Gemini en fonction de l'analyse d'un tableau de valeurs ObjectRef, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT
AI.GENERATE((
'''Can you provide a page by page summary for the first 3 pages of the attached manual?
Only write one line for each page. The pages are provided in serial order''',
chunks),
endpoint => 'gemini-3.5-flash').result AS Response,
FROM cymbal_pets.map_manual_to_chunks;
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+---------------------------------------------------------------------------+
| Response |
+---------------------------------------------------------------------------+
| Here is a one-line summary for each of the first 3 pages: |
| |
| Page 1 introduces the CritterCuisine Pro 5000 automatic pet feeder and |
| presents the initial part of the manual's Table of Contents. |
| Page 2 lists the items included with the feeder and details important |
| safety precautions for its use. |
| Page 3 describes the feeder's key features, provides assembly and initial |
| setup instructions, and begins the programming guide with clock setting. |
+---------------------------------------------------------------------------+
Pour générer plusieurs réponses à partir d'un modèle Gemini en fonction de l'analyse d'un tableau de valeurs ObjectRef, choisissez l'une des options suivantes :
SQL
Collez la requête suivante dans l'éditeur de requête, puis cliquez sur
Exécuter :
WITH results AS (
SELECT
AI.GENERATE((
'''Can you provide a page by page summary for the first 3 pages of the attached manual?
Only write one line for each page. The pages are provided in serial order''',
chunks),
endpoint => 'gemini-3.5-flash',
output_schema => 'page1_summary STRING, page2_summary STRING, page3_summary STRING').*
FROM cymbal_pets.map_manual_to_chunks)
SELECT page1_summary, page2_summary, page3_summary
FROM results;
BigQuery DataFrames
Avant d'essayer cet exemple, suivez les instructions de configuration pour BigQuery DataFrames du guide de démarrage rapide de BigQuery DataFrames.
Pour en savoir plus, consultez la documentation de référence sur BigQuery DataFrames.
Pour vous authentifier auprès de BigQuery, configurez le service Identifiants par défaut de l'application.
Pour en savoir plus, consultez Configurer les ADC pour un environnement de développement local.
Les résultats ressemblent à ce qui suit :
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
| page1_summary | page2_summary | page3_summary |
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
| This manual provides an overview of the | This section explains how to program | This page covers connecting the feeder to Wi-Fi |
| CritterCuisine Pro 5000 automatic pet feeder, | the feeder's clock, set feeding | using the CritterCuisine Connect app, remote |
| including its features, safety precautions, | schedules, copy and delete meal settings, | feeding, managing feeding schedules, viewing |
| assembly instructions, and initial setup. | manually feed your pet, record | feeding logs, receiving low food alerts, |
| | a voice message, and understand | updating firmware, creating multiple pet profiles, |
| | the low food level indicator. | sharing access with other users, and cleaning |
| | | and maintaining the feeder. |
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
Effectuer un nettoyage
Pour éviter que les ressources utilisées lors de ce tutoriel soient facturées sur votre compte Google Cloud, supprimez le projet contenant les ressources, ou conservez le projet et supprimez les ressources individuelles.
- Dans la console Google Cloud , accédez à la page Gérer les ressources.
- Dans la liste des projets, sélectionnez le projet que vous souhaitez supprimer, puis cliquez sur Supprimer.
- Dans la boîte de dialogue, saisissez l'ID du projet, puis cliquez sur Arrêter pour supprimer le projet.
Vous pouvez également conserver le projet et supprimer les ressources utilisées dans ce tutoriel en procédant comme suit :
Accédez à la page BigQuery.
Dans le volet de gauche, développez votre projet, puis cliquez sur Ensembles de données.
Pour l'ensemble de données
bqml_tutorial, cliquez sur Ouvrir les actions > Supprimer.Dans la boîte de dialogue Supprimer l'ensemble de données, cliquez sur Supprimer pour confirmer l'opération.
Dans le volet de gauche, cliquez sur Connexions.
Pour la connexion
cymbal_conn, cliquez sur Ouvrir les actions > Supprimer.Dans la boîte de dialogue Supprimer la connexion, saisissez
delete, puis cliquez sur Supprimer pour confirmer.
Étapes suivantes
- Pour en savoir plus sur l'utilisation des données multimodales, consultez Analyser des données multimodales dans BigQuery.
- Pour en savoir plus sur les valeurs
ObjectRef, consultez Utiliser des valeurs ObjectRef. - Pour découvrir comment analyser des données multimodales avec SQL et la fonction
OBJ.LIST, consultez Analyser des données multimodales avec SQL.
Sauf indication contraire, le contenu de cette page est régi par une licence Creative Commons Attribution 4.0, et les échantillons de code sont régis par une licence Apache 2.0. Pour en savoir plus, consultez les Règles du site Google Developers. Java est une marque déposée d'Oracle et/ou de ses sociétés affiliées.
Dernière mise à jour le 2026/09/17 (UTC).