


In dieser Anleitung erfahren Sie, wie Sie SQL-Abfragen, die Funktion AI.GENERATE, die Funktion AI.EMBED und BigQuery DataFrames verwenden, um multimodale Daten aus dem öffentlichen Dataset des Cymbal-Zoofachgeschäfts zu analysieren.
Mit der Funktion AI.GENERATE können Sie jede Kombination aus strukturierten und unstrukturierten Daten analysieren. Mit der Funktion AI.EMBED können Sie Einbettungen aus Text- oder Bilddaten in BigQuery erstellen.
Sie finden ähnliche Bilder mit der Funktion VECTOR_SEARCH. Mit der Funktion VECTOR_SEARCH können Sie eine semantische Suche oder eine hybride Suche nach Einbettungen ausführen, um ähnliche Entitäten zu finden.
In dieser Anleitung wird eine persistente Objekttabelle verwendet, in der ObjectRef-Werte gespeichert werden.
Ziele
- Verwenden Sie
ObjectRef-Werte, um Bilddaten zusammen mit strukturierten Daten in einer BigQuery-Tabelle zu speichern. - Verwenden Sie die Funktion
AI.GENERATE, um Ihre Daten anzureichern. - Verwenden Sie die Funktion
AI.EMBED, um Einbettungen basierend auf Bilddaten zu generieren. - Verwenden Sie die Funktion
VECTOR_SEARCH, um ähnliche Bilder zu finden. - Verwenden Sie Arrays von
ObjectRef-Werten, um Nutzerhandbücher zusammenzufassen.
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Google Cloud:
- BigQuery: you incur costs for the data that you process in BigQuery.
- Cloud Storage: you incur costs for reading the objects stored in Cloud Storage.
- Gemini Enterprise Agent Platform: you incur costs for calls to Agent Platform models.
Mit dem Preisrechner können Sie eine Kostenschätzung für Ihre voraussichtliche Nutzung vornehmen.
Weitere Informationen zu den Kosten finden Sie auf den folgenden Preisseiten:
Hinweis
-
Wählen Sie in der Google Cloud Console auf der Seite für die Projektauswahl ein Projekt von Google Cloud aus oder erstellen Sie eines.
Erforderliche Rollen zum Auswählen oder Erstellen eines Projekts
- Projekt auswählen: Für die Auswahl eines Projekts ist keine bestimmte IAM-Rolle erforderlich. Sie können jedes Projekt auswählen, für das Ihnen eine Rolle zugewiesen wurde.
-
Projekt erstellen: Zum Erstellen eines Projekts benötigen Sie die Rolle „Project Creator“ (
roles/resourcemanager.projectCreator), die die Berechtigungresourcemanager.projects.createenthält. Informationen zum Zuweisen von Rollen
-
Prüfen Sie, ob die Abrechnung für Ihr Google Cloud -Projekt aktiviert ist.
-
Aktivieren Sie die BigQuery, BigQuery Connection, Cloud Storage und Agent Platform API, falls sie noch nicht aktiviert sind.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Rollen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, damit Sie die nötigen Berechtigungen für diese Anleitung haben:
-
Datasets und Tabellen erstellen: BigQuery-Dateninhaber (
roles/bigquery.dataOwner) -
BigQuery-Jobs ausführen:
BigQuery-Jobnutzer (
roles/bigquery.jobUser) -
Verbindungen erstellen: BigQuery Connection Admin (
roles/bigquery.connectionAdmin) -
Berechtigungen für das Dienstkonto einer Verbindung gewähren: Projekt-IAM-Administrator (
roles/resourcemanager.projectIamAdmin) -
URLs erstellen, mit denen Sie Cloud Storage-Objekte lesen und ändern können:
BigQuery ObjectRef Admin (
roles/bigquery.objectRefAdmin)
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Sie können die erforderlichen Berechtigungen auch über benutzerdefinierte Rollen oder andere vordefinierte Rollen erhalten.
Dataset, Tabellen, Modelle und Verbindung erstellen
In diesem Abschnitt erstellen Sie das Dataset, die Verbindung, die Tabellen und die Modelle, die in dieser Anleitung verwendet werden.
Dataset erstellen
Erstellen Sie ein BigQuery-Dataset, das die in dieser Anleitung erstellten Objekte enthalten soll. Wählen Sie dazu eine der folgenden Optionen aus:
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
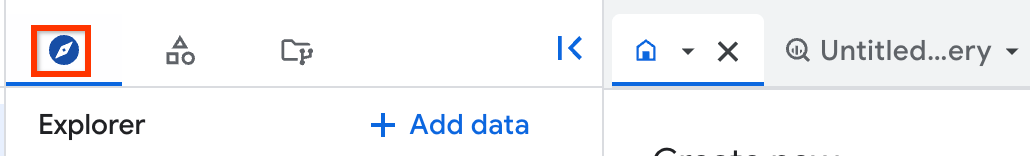
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Maximieren Sie im Explorer Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie auf der Seite Datasets auf Dataset erstellen.
Führen Sie auf der Seite Dataset erstellen die folgenden Schritte aus:
Geben Sie unter Dataset-ID
cymbal_petsein.Wählen Sie unter Speicherort der Daten die Option USA aus.
Übernehmen Sie die verbleibenden Standardeinstellungen unverändert und klicken Sie auf Dataset erstellen.
SQL
Verwenden Sie die Anweisung CREATE SCHEMA.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Geben Sie im Abfrageeditor die folgende Anweisung ein:
CREATE SCHEMA PROJECT_ID.cymbal_pets
  OPTIONS (
    description = 'Dataset for BigQuery ML tutorial',
    location = 'US');
Ersetzen Sie
PROJECT_IDdurch Ihre Projekt-ID.Klicken Sie auf Ausführen.
Informationen zum Ausführen von Abfragen finden Sie unter Interaktive Abfrage ausführen.
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht: The dataset
named cymbal_pets was created.
Verbindung herstellen
Erstellen Sie eine Cloud-Ressourcenverbindung und rufen Sie das Dienstkonto der Verbindung ab. BigQuery verwendet die Verbindung, um auf Objekte in Cloud Storage zuzugreifen.
Klicken Sie im linken Bereich auf Explorer:
Klicken Sie im Bereich Explorer auf Verbindungen.
Klicken Sie auf der Seite Verbindungen auf Verbindung erstellen.
Führen Sie auf der Seite Externe Datenquelle die folgenden Schritte aus:
Wählen Sie als Verbindungstyp die Option Vertex AI-Remote-Modelle, Remote-Funktionen, Lakehouse und Cloud Spanner (Cloud-Ressource) aus.
Geben Sie im Feld Verbindungs-ID
cymbal_connein.Lassen Sie alle anderen Einstellungen unverändert und klicken Sie auf Verbindung erstellen.
Klicken Sie auf der Seite Verbindungen auf
cymbal_conn.Kopieren Sie im Bereich Verbindungsinformationen den Wert für Dienstkonto-ID. Sie wird für die folgenden Schritte benötigt.
Berechtigungen zur Verwendung von Agent Platform-Modellen gewähren
Weisen Sie dem Dienstkonto der Verbindung die Rolle „Agent Platform User“ zu, um auf Remote-Modelle in der Agent Platform zuzugreifen. Sie müssen diese Rolle in dem Projekt zuweisen, das Sie zuvor erstellt oder ausgewählt haben. Die Zuweisung der Rollen in einem anderen Projekt führt zu dem Fehler bqcx-1234567890-abcd@gcp-sa-bigquery-condel.iam.gserviceaccount.com
does not have the permission to access resource.
So gewähren Sie dem Dienstkonto Zugriff auf die Agent Platform-Modelle:
Rufen Sie die Seite IAM und Verwaltung auf.
Klicken Sie auf Zugriffsrechte erteilen.
Führen Sie im Dialogfeld Zugriff gewähren die folgenden Schritte aus:
Geben Sie im Feld Neue Hauptkonten die Dienstkonto-ID ein, die Sie zuvor kopiert haben.
Wählen Sie im Feld Rolle auswählen die Option Agent Platform User aus oder suchen Sie danach.
Klicken Sie auf Speichern.
Tabelle products erstellen
So erstellen Sie eine Standardtabelle mit den Produktinformationen von Cymbal Pets und laden die Daten aus Cloud Storage:
Rufen Sie in der Google Cloud Console die Seite Studio auf.
Wählen Sie eine der folgenden Optionen aus, um die Tabelle
productszu erstellen:SQL
Fügen Sie diesen Befehl in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
LOAD DATA OVERWRITE cymbal_pets.products
FROM
  FILES(
    format = 'avro',
    uris = [
      'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/tables/products/products_*.avro']);
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
Data was
successfully loaded into managed table.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Tabelle product_images erstellen
Wählen Sie eine der folgenden Optionen aus, um eine Objekttabelle (product_images) mit den Produktbildern von Cymbal Pets zu erstellen:
SQL
Fügen Sie diesen Befehl in den Abfrageeditor ein und klicken Sie auf Ausführen:
CREATE OR REPLACE EXTERNAL TABLE cymbal_pets.product_images
  WITH CONNECTION `us.cymbal_conn`
  OPTIONS (
    object_metadata = 'SIMPLE',
    uris = ['gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/images/*.png'],
    max_staleness = INTERVAL 30 MINUTE,
    metadata_cache_mode = AUTOMATIC);
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht: This
statement created a new table named product_images.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Modelle erstellen
In den SQL-Anleitungen in diesem Tutorial wird gezeigt, wie Sie KI-Funktionen aufrufen, für die Sie kein Modell erstellen müssen. Wenn Sie der Anleitung für BigQuery DataFrames folgen, wählen Sie diese Option aus, um Remote-Modelle zu erstellen, die ein Gemini-Modell und ein multimodales Einbettungsmodell darstellen.
SQL
Dann können Sie diesen Schritt überspringen.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
products_mm-Tabelle mit multimodalen Daten erstellen
Erstellen Sie eine products_mm-Tabelle, die eine image-Spalte mit Produktbildern aus der Objekttabelle product_images enthält. Die erstellte Spalte image ist eine STRUCT-Spalte, die ObjectRef-Werte verwendet, um Bilddaten zusammen mit strukturierten Daten in einer BigQuery-Standardtabelle zu speichern.
Ein ObjectRef-Wert ist ein STRUCT-Typ mit einem vordefinierten Schema, das auf Cloud Storage-Objekte für die multimodale Analyse verweist.
ObjectRef-Werte können von OBJ-Funktionen, KI-Funktionen oder benutzerdefinierten Python-Funktionen verarbeitet werden.
So erstellen und füllen Sie die Tabelle products_mm:
Wählen Sie eine der folgenden Optionen aus, um eine
products_mm-Tabelle zu erstellen:SQL
Fügen Sie diesen Befehl in den Abfrageeditor ein und klicken Sie auf Ausführen:
CREATE OR REPLACE TABLE cymbal_pets.products_mm
AS
SELECT products.* EXCEPT (uri), ot.ref AS image FROM cymbal_pets.products
INNER JOIN cymbal_pets.product_images ot
ON ot.uri = products.uri;
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement created a new table named products_mm.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wählen Sie eine der folgenden Optionen aus, um die Daten der Spalte
imageaufzurufen:SQL
Fügen Sie diesen Befehl in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT product_name, image
FROM cymbal_pets.products_mm
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| product_name                   | image.uri                            | image.version | image.authorizer              | image.details                                  |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
|  AquaClear Aquarium Background | gs://cloud-samples-data/bigquery/    | 1234567891011 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"image/png",   |
|                                | tutorials/cymbal-pets/images/        |               |                               | "md5_hash":"494f63b9b137975ff3e7a11b060edb1d", |
|                                | aquaclear-aquarium-background.png    |               |                               | "size":1282805,"updated":1742492680017000}}    |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
|  AquaClear Aquarium            | gs://cloud-samples-data/bigquery/    | 2345678910112 | myproject.region.myconnection | {"gcs_metadata":{"content_type":"image/png",   |
|  Gravel Vacuum                 | tutorials/cymbal-pets/images/        |               |                               | "md5_hash":"b7bfc2e2641a77a402a1937bcf0003fd", |
|                                | aquaclear-aquarium-gravel-vacuum.png |               |                               | "size":820254,"updated":1742492682411000}}     |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
| ...                            | ...                                  | ...           |                               | ...                                            |
+--------------------------------+--------------------------------------+---------------+-------------------------------+------------------------------------------------+
Produktinformationen generieren
Verwenden Sie die Funktion AI.GENERATE, um die folgenden Daten für die Produkte der Zoohandlung zu generieren:
- Fügen Sie der Tabelle
products_mmeineimage_description-Spalte hinzu. - Füllen Sie die Spalten
animal_type,search_keywordsundsubcategoryder Tabelleproducts_mmaus. - Führen Sie eine Abfrage aus, die eine Beschreibung jeder Produktmarke und die Anzahl der Produkte dieser Marke zurückgibt. Die Markenbeschreibung wird durch die Analyse von Produktinformationen für alle Produkte dieser Marke, einschließlich Produktbildern, generiert.
Mit der Funktion AI.GENERATE können Sie Text oder eine strukturierte Ausgabe gemäß einem von Ihnen angegebenen benutzerdefinierten Schema generieren. Die Funktion sendet Anfragen an ein Gemini-Modell und gibt eine Struktur zurück, die die generierten Daten, die vollständige Modellantwort und einen Status enthält.
So generieren Sie die Produktdaten:
Wählen Sie eine der folgenden Optionen aus, um die Produktinformationen mit
AI.GENERATEzu generieren:SQL
Fügen Sie Folgendes in den Abfrageeditor ein, um die Spalte
image_descriptionzu erstellen und zu füllen, und klicken Sie dann auf Ausführen:-- Add the column to the existing table ALTER TABLE bqml_tutorial.products_mm ADD COLUMN IF NOT EXISTS image_description STRING; -- Populate the new column using the AI.GENERATE function UPDATE bqml_tutorial.products_mm SET image_description = AI.GENERATE( ('Describe the following image: ', image), endpoint => 'gemini-3.5-flash' ).result WHERE image_description IS NULL;
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement altered the table named products_mm.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wenn Sie den Inhalt der Spalte
image_descriptionaufrufen möchten, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:SELECT product_name, image_description FROM cymbal_pets.products_mm;
Die Ergebnisse sehen in etwa so aus:
+--------------------------------+-------------------------------------+
| product_name                   | image_description                   |
+--------------------------------+-------------------------------------+
|  AquaClear Aquarium Background | The image shows a colorful coral    |
|                                | reef backdrop. The background is a  |
|                                | blue ocean with a bright light...   |
|                                |                                     |
|                                |                                     |
+--------------------------------+-------------------------------------+
|  AquaClear Aquarium            | The image shows a long, clear       |
|  Gravel Vacuum                 | plastic tube with a green hose      |
|                                | attached to one end. The tube...    |
|                                |                                     |
|                                |                                     |
+--------------------------------+-------------------------------------+
| ...                            | ...                                 |
+--------------------------------+-------------------------------------+
Wählen Sie eine der folgenden Optionen aus, um die Spalten
animal_type,search_keywordsundsubcategorymit generierten Daten zu aktualisieren:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
UPDATE cymbal_pets.products_mm t
SET
animal_type = r.animal_type,
search_keywords = SPLIT(r.search_keywords, ','),
subcategory = r.subcategory
FROM (
SELECT
  product_id,
  g.* EXCEPT(full_response, status)
FROM bqml_tutorial.products_mm,
UNNEST([AI.GENERATE(
  ('For the image and description of a pet product, concisely generate the following metadata: 1) animal_type and 2) 5 SEO search keywords (comma separated), and 3) product subcategory. ', image, description),
  endpoint => 'gemini-3.5-flash',
  output_schema => 'animal_type STRING, search_keywords STRING, subcategory STRING'
)]) AS g
) r
WHERE t.product_id = r.product_id;
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement modified 205 rows in products_mm.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wählen Sie eine der folgenden Optionen aus, um die generierten Daten aufzurufen:
SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
SELECT
product_name,
image_description,
animal_type,
search_keywords,
subcategory,
FROM cymbal_pets.products_mm;
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| product_name                   | image_description                   | animal_type | search_keywords        | subcategory      |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
|  AquaClear Aquarium Background | The image shows a colorful coral    | fish        | aquarium background    | aquarium decor   |
|                                | reef backdrop. The background is a  |             | fish tank backdrop     |                  |
|                                | blue ocean with a bright light...   |             | coral reef decor       |                  |
|                                |                                     |             | underwater scenery     |                  |
|                                |                                     |             | aquarium decoration    |                  |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
|  AquaClear Aquarium            | The image shows a long, clear       | fish        | aquarium gravel vacuum | aquarium         |
|  Gravel Vacuum                 | plastic tube with a green hose      |             | aquarium cleaning      | cleaning         |
|                                | attached to one end. The tube...    |             | aquarium maintenance   |                  |
|                                |                                     |             | fish tank cleaning     |                  |
|                                |                                     |             | gravel siphon          |                  |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
| ...                            | ...                                 | ...         |  ...                   | ...              |
+--------------------------------+-------------------------------------+-------------+------------------------+------------------+
Wählen Sie eine der folgenden Optionen aus, um eine Beschreibung der einzelnen Produktmarken und die Anzahl der Produkte dieser Marke zu generieren:
SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
SELECT
brand,
COUNT(*) AS cnt,
AI.GENERATE(('Use the images and text to give one concise brand description ',
            'for a website brand page. Return the description only.',
              ARRAY_AGG(image LIMIT 10), ARRAY_AGG(description), ARRAY_AGG(category),
              ARRAY_AGG(subcategory)),
            endpoint => 'gemini-2.5-pro').result AS brand_description
FROM
cymbal_pets.products_mm
GROUP BY brand
ORDER BY cnt DESC;
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+--------------+-------------------------------------+-----+
| brand        | brand_description                   | cnt |
+--------------+-------------------------------------+-----+
|  AquaClear   | AquaClear is a brand of aquarium    | 33  |
|              | and pond care products that offer   |     |
|              | a wide range of solutions for...    |     |
+--------------+-------------------------------------+-----+
|  Ocean       | Ocean Bites is a brand of cat food  | 28  |
|  Bites       | that offers a variety of recipes    |     |
|              | and formulas to meet the specific.. |     |
+--------------+-------------------------------------+-----+
|  ...         | ...                                 |...  |
+--------------+-------------------------------------+-----+
Einbettungen generieren und eine Vektorsuche ausführen
Einbettungen aus Bilddaten generieren und dann mit den Einbettungen ähnliche Bilder mithilfe der Vektorsuche zurückgeben.
In einer Produktionsumgebung empfehlen wir, vor dem Ausführen einer Vektorsuche einen Vektorindex zu erstellen. Mit einem Vektorindex können Sie die Vektorsuche schneller ausführen und erhalten genauere Ergebnisse, aber der Recall ist reduziert.
So erstellen Sie die Einbettungen und führen eine Vektorsuche durch:
Wählen Sie eine der folgenden Optionen aus, um die Tabelle
products_embeddingszu erstellen:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
CREATE OR REPLACE TABLE cymbal_pets.products_embedding
AS (
SELECT
  product_id,
  AI.EMBED(image, endpoint => 'gemini-embedding-2').result AS embedding,
  image
FROM cymbal_pets.products_mm
);
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement created a new table named products_embedding.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wählen Sie eine der folgenden Optionen aus, um eine Vektorsuche auszuführen, die Produktbilder zurückgibt, die dem angegebenen Eingabebild ähneln:
SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
SELECT *
FROM
VECTOR_SEARCH(
  TABLE cymbal_pets.products_embedding,
  'embedding',
  query_value => AI.EMBED(
                  OBJ.MAKE_REF('gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/images/cozy-naps-cat-scratching-post-with-condo.png'),
                  endpoint => 'gemini-embedding-2').result);
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| query.embedding | base.product_id | base.embedding | base.image.uri                               | base.image.version | base.image.authorizer         | base.image.details                             | distance       |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| -0.0112330541   | 181             | -0.0112330541  | gs://cloud-samples-data/bigquery/            | 12345678910        | myproject.region.myconnection | {"gcs_metadata":{"content_type":               | 0.0            |
| 0.0142525584    |                 |  0.0142525584  | tutorials/cymbal-pets/images/                |                    |                               | "image/png","md5_hash":"21234567hst16555w60j", |                |
| 0.0135886827    |                 |  0.0135886827  | cozy-naps-cat-scratching-post-with-condo.png |                    |                               | "size":828318,"updated":1742492688982000}}     |                |
| 0.0149955815    |                 |  0.0149955815  |                                              |                    |                               |                                                |                |
| ...             |                 |  ...           |                                              |                    |                               |                                                |                |
|                 |                 |                |                                              |                    |                               |                                                |                |
|                 |                 |                |                                              |                    |                               |                                                |                |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| -0.0112330541   | 187             | -0.0190353896  | gs://cloud-samples-data/bigquery/            | 23456789101        | myproject.region.myconnection | {"gcs_metadata":{"content_type":               | 0.4216330832.. |
| 0.0142525584    |                 |  0.0116206668  | tutorials/cymbal-pets/images/                |                    |                               | "image/png","md5_hash":"7328728fhakd9937djo4", |                |
| 0.0135886827    |                 |  0.0136198215  | cozy-naps-cat-scratching-post-with-bed.png   |                    |                               | "size":860113,"updated":1742492688774000}}     |                |
| 0.0149955815    |                 |  0.0173457414  |                                              |                    |                               |                                                |                |
| ...             |                 |  ...           |                                              |                    |                               |                                                |                |
|                 |                 |                |                                              |                    |                               |                                                |                |
|                 |                 |                |                                              |                    |                               |                                                |                |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
| ...             | ...             | ...            | ...                                          | ...                | ...                           | ...                                            | ...            |
+-----------------+-----------------+----------------+----------------------------------------------+--------------------+-------------------------------+------------------------------------------------+----------------+
Geordnete multimodale Daten mit Arrays von ObjectRef-Werten verarbeiten
In diesem Abschnitt erfahren Sie, wie Sie Bedienungsanleitungen zusammenfassen, indem Sie geordnete multimodale Daten mithilfe von Arrays mit ObjectRef-Werten verarbeiten. BigQuery kann mithilfe von Arrays mehrere unstrukturierte Dateien gleichzeitig analysieren.
Sie führen dabei die folgenden Aufgaben aus:
Erstellen Sie die Tabelle
product_manualsso, dass sie sowohl eine PDF-Datei für das ProdukthandbuchCrittercuisine Pro 5000als auch PDF-Dateien für jede Seite dieses Handbuchs enthält.Erstellen Sie eine Tabelle, in der das Handbuch den zugehörigen Chunks zugeordnet wird. Das vollständige Handbuch und die Handbuchseiten werden jeweils in einer
ObjectRef-Spalte gespeichert.Ein Array von
ObjectRef-Werten zusammen analysieren, um einen einzelnen generierten Wert zurückzugeben.Ein Array von
ObjectRef-Werten separat analysieren und für jeden Arraywert einen generierten Wert zurückgeben.
So verarbeiten Sie geordnete multimodale Daten mit ObjectRef-Werten:
Wählen Sie eine der folgenden Optionen aus, um die Tabelle
product_manualszu erstellen:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
CREATE OR REPLACE EXTERNAL TABLE `cymbal_pets.product_manuals`
WITH CONNECTION `us.cymbal_conn`
OPTIONS (
  object_metadata = 'SIMPLE',
  uris = [
      'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/documents/*.pdf',
      'gs://cloud-samples-data/bigquery/tutorials/cymbal-pets/document_chunks/*.pdf']);
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement created a new table named product_manuals.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wählen Sie eine der folgenden Optionen aus, um PDF-Daten in die Tabelle
map_manual_to_chunkszu schreiben:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
-- Extract the file and chunks into a single table.
-- Store the chunks in the chunks column as array of ObjectRefs (ordered by page number)
CREATE OR REPLACE TABLE cymbal_pets.map_manual_to_chunks
AS
SELECT ARRAY_AGG(m1.ref)[0] manual, ARRAY_AGG(m2.ref ORDER BY m2.ref.uri) chunks
FROM cymbal_pets.product_manuals m1
JOIN cymbal_pets.product_manuals m2
ON
  REGEXP_EXTRACT(m1.uri, r'.*/([^.]*).[^/]+')
  = REGEXP_EXTRACT(m2.uri, r'.*/([^.]*)_page[0-9]+.[^/]+')
GROUP BY m1.uri;
Sie erhalten eine Bestätigungsmeldung, die in etwa so aussieht:
This
statement created a new table named map_manual_to_chunks.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Wählen Sie eine der folgenden Optionen aus, um die PDF-Daten in der Tabelle
map_manual_to_chunksaufzurufen:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
SELECT *
FROM cymbal_pets.map_manual_to_chunks;
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| manual.uri                          | manual.version                 | manual.authorizer                 | manual.details                                       | chunks.uri                                | chunks.version                  | chunks.authorizer                  | chunks.details                                        |
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
| gs://cloud-samples-data/bigquery/   | 1742492785900455               | myproject.region.myconnection     | {"gcs_metadata":{"content_type":"application/pef",   | gs://cloud-samples-data/bigquery/         | 1745875761227129                | myproject.region.myconnection      | {"gcs_metadata":{"content_type":"application/pdf",    |
| tutorials/cymbal-pets/documents/    |                                |                                   | "md5_hash":"c9032b037693d15a33210d638c763d0e",       | tutorials/cymbal-pets/documents/          |                                 |                                    | "md5_hash":"5a1116cce4978ec1b094d8e8b49a1d7c",        |
| crittercuisine_5000_user_manual.pdf |                                |                                   | "size":566105,"updated":1742492785941000}}           | crittercuisine_5000_user_manual_page1.pdf |                                 |                                    | "size":504583,"updated":1745875761266000}}            |
|                                     |                                |                                   |                                                      +-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
|                                     |                                |                                   |                                                      | crittercuisine_5000_user_manual_page1.pdf | 1745875760613874                | myproject.region.myconnection      | {"gcs_metadata":{"content_type":"application/pdf",    |
|                                     |                                |                                   |                                                      | tutorials/cymbal-pets/documents/          |                                 |                                    | "md5_hash":"94d03ec65d28b173bc87eac7e587b325",        |
|                                     |                                |                                   |                                                      | crittercuisine_5000_user_manual_page2.pdf |                                 |                                    | "size":94622,"updated":1745875760649000}}             |
|                                     |                                |                                   |                                                      +-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
|                                     |                                |                                   |                                                      | ...                                       | ...                             |  ...                               | ...                                                   |
+-------------------------------------+--------------------------------+-----------------------------------+------------------------------------------------------+-------------------------------------------+---------------------------------+------------------------------------+-------------------------------------------------------+
Wählen Sie eine der folgenden Optionen aus, um eine einzelne Antwort von einem Gemini-Modell basierend auf der Analyse eines Arrays von
ObjectRef-Werten zu generieren:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
SELECT
AI.GENERATE((
  '''Can you provide a page by page summary for the first 3 pages of the attached manual?
  Only write one line for each page. The pages are provided in serial order''',
  chunks),
  endpoint => 'gemini-3.5-flash').result AS Response,
FROM cymbal_pets.map_manual_to_chunks;
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+---------------------------------------------------------------------------+
| Response                                                                  |
+---------------------------------------------------------------------------+
| Here is a one-line summary for each of the first 3 pages:                 |
|                                                                           |
| Page 1 introduces the CritterCuisine Pro 5000 automatic pet feeder and    |
| presents the initial part of the manual's Table of Contents.              |
| Page 2 lists the items included with the feeder and details important     |
| safety precautions for its use.                                           |
| Page 3 describes the feeder's key features, provides assembly and initial |
| setup instructions, and begins the programming guide with clock setting.  |
+---------------------------------------------------------------------------+
Wenn Sie mehrere Antworten von einem Gemini-Modell basierend auf der Analyse eines Arrays von
ObjectRef-Werten generieren möchten, wählen Sie eine der folgenden Optionen aus:SQL
Fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:
WITH results AS (
SELECT
  AI.GENERATE((
    '''Can you provide a page by page summary for the first 3 pages of the attached manual?
    Only write one line for each page. The pages are provided in serial order''',
    chunks),
    endpoint => 'gemini-3.5-flash',
    output_schema =>  'page1_summary STRING, page2_summary STRING, page3_summary STRING').*
FROM cymbal_pets.map_manual_to_chunks)
SELECT page1_summary, page2_summary, page3_summary
FROM results;
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ergebnisse sehen in etwa so aus:
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
| page1_summary                                 | page2_summary                             | page3_summary                                      |
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
| This manual provides an overview of the       | This section explains how to program      | This page covers connecting the feeder to Wi-Fi    |
| CritterCuisine Pro 5000 automatic pet feeder, | the feeder's clock, set feeding           | using the CritterCuisine Connect app,  remote      |
| including its features, safety precautions,   | schedules, copy and delete meal settings, | feeding, managing feeding schedules, viewing       |
| assembly instructions, and initial setup.     | manually feed your pet, record            | feeding logs, receiving low food alerts,           |
|                                               | a voice message, and understand           | updating firmware, creating multiple pet profiles, |
|                                               | the low food level indicator.             | sharing access with other users, and cleaning      |
|                                               |                                           | and maintaining the feeder.                        |
+-----------------------------------------------+-------------------------------------------+----------------------------------------------------+
Bereinigen
Damit Ihrem Google Cloud-Konto die in dieser Anleitung verwendeten Ressourcen nicht in Rechnung gestellt werden, löschen Sie entweder das Projekt, das die Ressourcen enthält, oder Sie behalten das Projekt und löschen die einzelnen Ressourcen.
- Wechseln Sie in der Google Cloud -Console zur Seite Ressourcen verwalten.
- Wählen Sie in der Projektliste das Projekt aus, das Sie löschen möchten, und klicken Sie dann auf Löschen.
- Geben Sie im Dialogfeld die Projekt-ID ein und klicken Sie auf Shut down (Beenden), um das Projekt zu löschen.
Alternativ können Sie das Projekt beibehalten und die in dieser Anleitung verwendeten Ressourcen löschen. Gehen Sie dazu so vor:
Rufen Sie die Seite BigQuery auf.
Maximieren Sie im linken Bereich Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie für das Dataset
bqml_tutorialauf Aktionen öffnen > Löschen.Klicken Sie im Dialogfeld Dataset löschen zur Bestätigung auf Löschen.
Klicken Sie im linken Bereich auf Verbindungen.
Klicken Sie für die Verbindung
cymbal_connauf Aktionen öffnen > Löschen.Geben Sie im Dialogfeld Verbindung löschen
deleteein und klicken Sie dann zur Bestätigung auf Löschen.
Nächste Schritte
- Weitere Informationen zum Arbeiten mit multimodalen Daten finden Sie unter Multimodale Daten in BigQuery analysieren.
- Weitere Informationen zu
ObjectRef-Werten finden Sie unter Mit ObjectRef-Werten arbeiten.