


验证数据仓库迁移
借助 BigQuery Migration Service 验证服务,您可以验证从源数据仓库迁移的表是否与 BigQuery 中的目标表匹配。您可以比较架构和表数据,以找出迁移期间的差异。
验证服务客户端会连接到源数据库,并将源架构和行数据提取到您控制的 Cloud Storage 存储桶中。提取后,验证服务会将 Cloud Storage 存储桶中提取的架构和数据与迁移的 BigQuery 表进行比较。
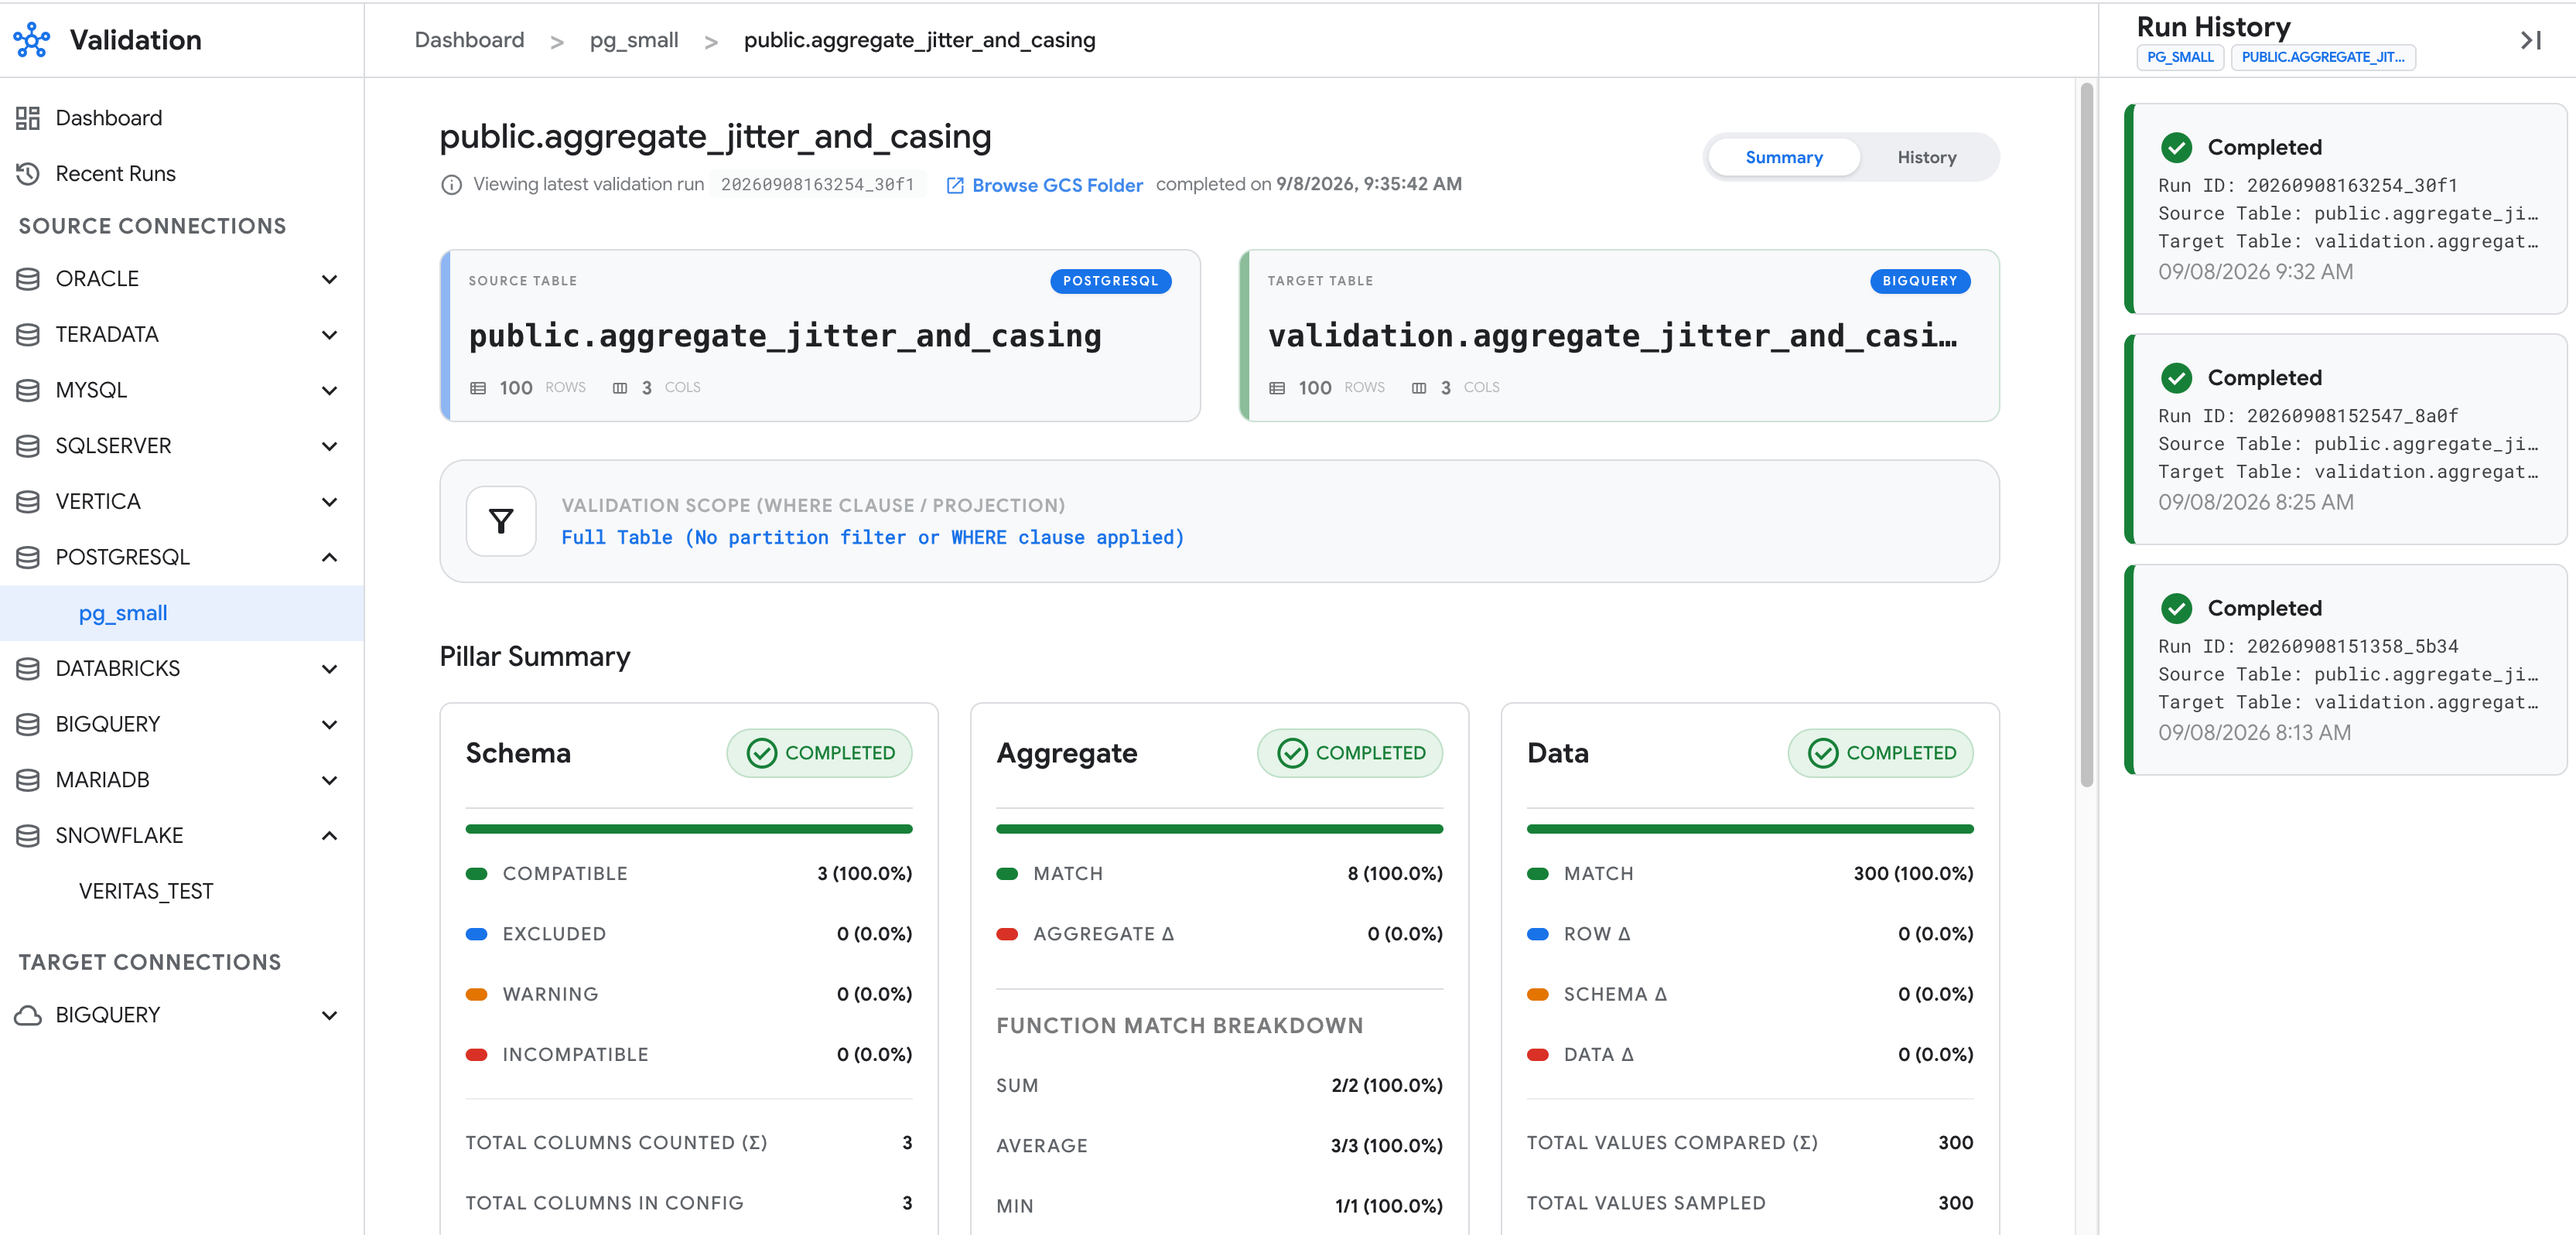
验证工作流会通过以下三个验证支柱来比较源表和目标 BigQuery 表:
- 架构验证 (
--schema):比较源表和目标 BigQuery 表之间的列名称、数据类型和类型兼容性。 - 汇总验证 (
--aggregate):计算并比较整个表中的表级和列级汇总指标,例如行数、SUM、AVG、MIN、MAX、布尔值分布和字符串长度。 - 数据验证 (
--data):使用详尽的全表扫描 (BRUTE_FORCE) 或基于键的随机抽样 (SAMPLE) 执行逐行比较,以检测缺失的行和单元格级值偏移。
支持的位置
验证服务仅在部分国家/地区提供。如需了解详情,请参阅 BigQuery Migration Service 位置。
数据处理和安全注意事项
验证服务会根据您运行的验证支柱提取和暂存不同的数据:
- 架构验证 (
--schema):仅将列名称、数据类型和表统计信息上传到source_query_result.json文件,而不提取单元格值。 - 汇总验证 (
--aggregate):将计算出的汇总指标上传到source_aggregates.parquet文件,包括所含列中的实际MIN和MAX单元格值。 - 数据验证 (
--data):从抽样行或从所有行(使用BRUTE_FORCE策略时)中提取原始、未遮盖的单元格值。它会以 Apache Parquet 或 CSV 格式将这些值上传到 Cloud Storage 暂存存储桶,并将其加载到 BigQuery 中的validation_results数据集中。
为保护您的数据并确保验证环境的安全,请配置以下设置:
- 排除敏感列:将敏感列添加到
columnSettings.exclude字段,以便在源提取查询、目标比较和验证报告中忽略这些列。 - 最大限度减少本地数据存储:在
settings.yaml文件中设置googleCloudStorage.gcsPath字段,以将采样行直接流式传输到 Cloud Storage,而无需将其写入本地磁盘。在共享主机上,每次运行后删除本地--output-dir工作目录,以移除本地元数据、汇总和日志文件。 - 加密暂存数据和结果:在运行验证之前,使用 Cloud Key Management Service 在 Cloud Storage 暂存存储桶和 BigQuery 结果数据集(默认为
validation_results,或在results.dataset字段中指定的数据集)上配置客户管理的加密密钥 (CMEK)。 - 限制配置访问权限:将验证配置文件存储在需要代码审核的版本控制代码库中,或存储在只有受信任用户才拥有
storage.objects.create权限的 Cloud Storage 存储桶中。 - 强制执行最小权限访问:仅向工作流创建者授予对要验证的目标数据集或表的
roles/bigquery.dataViewer角色,而不授予对项目的角色。使用只读源数据库用户,如配置源数据库权限中所述。
准备工作
在 Google Cloud 控制台的项目选择器页面上,选择或创建一个 Google Cloud 项目,其中包含您的目标 BigQuery 数据集。
验证是否已为您的 Google Cloud 项目启用结算功能。
启用 BigQuery、BigQuery Migration Service、Cloud Storage 和 Secret Manager API(如果将数据库密码存储在 Secret Manager 中)。
在目标 BigQuery 数据集所在的位置创建或选择一个 Cloud Storage 存储桶,以暂存提取的元数据和数据样本。如需了解详情,请参阅创建存储桶。
所需的角色和权限
验证运行包含三个部分,每个部分都可以由不同的主账号执行:
- 数据收集:验证客户端会读取源数据库,并将元数据、汇总和采样行上传到 Cloud Storage 暂存存储桶。它不会调用 BigQuery。
- 验证:BigQuery Migration Service 验证工作流会将暂存数据与目标表进行比较。工作流使用创建它的主账号的凭据运行,无论该主账号是验证客户端、
gcloud还是 Google Cloud 控制台。 - 查看结果:读取结果数据集和 Cloud Storage 报告。
generate-config不需要任何 Google Cloud 权限。
数据收集
如需获得收集源数据所需的权限,请让您的管理员为您授予以下 IAM 角色:
- 针对暂存存储桶的 Storage Object Creator (
roles/storage.objectCreator) - 针对暂存存储桶的 Storage Object Viewer (
roles/storage.objectViewer) -
从 Cloud Storage 读取配置文件:针对配置存储桶的 Storage Object Viewer (
roles/storage.objectViewer) -
从 Secret Manager 读取数据库密码:Secret 的 Secret Manager Secret Accessor (
roles/secretmanager.secretAccessor)
如需详细了解如何授予角色,请参阅管理对项目、文件夹和组织的访问权限。
这些预定义角色包含收集源数据所需的权限。如需查看所需的确切权限,请展开所需权限部分:
所需权限
您需要具备以下权限才能收集源数据:
-
针对暂存存储桶的
storage.objects.create权限 -
针对暂存存储桶的
storage.objects.get权限 -
从 Cloud Storage 读取配置文件:
-
针对配置存储桶的
storage.objects.get -
针对配置存储桶的
storage.objects.list
-
针对配置存储桶的
-
从 Secret Manager 读取数据库密码:针对 Secret 的
secretmanager.versions.access
使用 --extract-only 时,数据收集不需要任何 BigQuery 或 BigQuery Migration Service 权限。如果没有该角色,客户端还会创建验证工作流,并且需要 validation 角色。
验证
如需获得创建和运行验证工作流所需的权限,请让您的管理员为您授予以下 IAM 角色:
- 项目的 MigrationWorkflow Editor (
roles/bigquerymigration.editor) - 项目的 BigQuery Job User (
roles/bigquery.jobUser) - 针对每个目标数据集的 BigQuery Data Viewer (
roles/bigquery.dataViewer) - 结果数据集的 BigQuery Data Editor (
roles/bigquery.dataEditor) 角色 - 针对暂存存储桶的 Storage Object User (
roles/storage.objectUser) -
如果结果数据集不存在:针对项目的 BigQuery User (
roles/bigquery.user) 角色
这些预定义角色包含创建和运行验证工作流所需的权限。如需查看所需的确切权限,请展开所需权限部分:
所需权限
如需创建和运行验证工作流,您需要具备以下权限:
-
针对项目的
bigquerymigration.workflows.create权限 -
针对项目的
bigquerymigration.workflows.get权限 -
针对项目的
bigquery.jobs.create权限 -
针对每个目标数据集的
bigquery.tables.get权限 -
针对每个目标数据集的
bigquery.tables.getData权限 -
针对结果数据集的
bigquery.datasets.get权限 -
针对结果数据集的
bigquery.tables.get权限 -
针对结果数据集的
bigquery.tables.create权限 -
针对结果数据集的
bigquery.tables.update权限 -
针对结果数据集的
bigquery.tables.updateData权限 -
针对结果数据集的
bigquery.tables.getData权限 -
针对暂存存储桶的
storage.objects.get权限 -
针对暂存存储桶的
storage.objects.create权限 -
针对暂存存储桶的
storage.objects.delete权限 -
如果结果数据集不存在:针对项目的
bigquery.datasets.create
roles/bigquerymigration.editor 包含许多验证不使用的权限。为遵循最小权限原则,请授予仅具有 bigquerymigration.workflows.create 和 bigquerymigration.workflows.get 的自定义角色。
验证只会读取目标表,并且只会写入结果数据集。 我们建议您提前创建结果数据集,这样任何主账号都不需要拥有在项目中创建数据集的权限。
查看结果
如需获得查看验证结果所需的权限,请让您的管理员为您授予以下 IAM 角色:
- 针对包含结果数据集的项目的 BigQuery Job User (
roles/bigquery.jobUser) - 针对结果数据集的 BigQuery Data Viewer (
roles/bigquery.dataViewer) 角色 -
读取 Cloud Storage 中的报告:针对暂存存储桶的 Storage Object Viewer (
roles/storage.objectViewer) -
在 Google Cloud 控制台中列出和查看验证工作流:项目的 MigrationWorkflow Viewer (
roles/bigquerymigration.viewer)
这些预定义角色包含查看验证结果所需的权限。如需查看所需的确切权限,请展开所需权限部分:
所需权限
如需查看验证结果,您需要具备以下权限:
-
针对项目的
bigquery.jobs.create权限 -
针对结果数据集的
bigquery.tables.get权限 -
针对结果数据集的
bigquery.tables.getData权限 -
在 Cloud Storage 中阅读报告:
-
针对暂存存储桶的
storage.objects.get权限 -
针对暂存存储桶的
storage.objects.list权限
-
针对暂存存储桶的
-
在 Google Cloud 控制台中列出并查看验证工作流:
- 针对项目的
bigquerymigration.workflows.list权限 - 针对项目的
bigquerymigration.workflows.get权限
- 针对项目的
配置源数据库权限
您必须为源数据库用户配置只读权限,并具有以下权限:
- 对要验证的每个源表的
SELECT权限。 - 对用于架构和主键发现的系统目录视图(例如 Oracle 上的
information_schema表、ALL_CONSTRAINTS和ALL_TAB_COLUMNS,或 Amazon Redshift 上的SVV_COLUMNS和pg_attribute)的读取权限。
请勿向此用户授予写入、DDL 或管理员权限。验证客户端会以该用户的身份运行验证配置中的 SQL。如需了解详情,请参阅数据处理和安全注意事项。
限制
验证服务存在以下限制:
- BigQuery 是唯一受支持的目标数据库。不支持在两个非 BigQuery 数据库之间进行验证,也不支持将 BigQuery 用作验证来源。
- 目标 BigQuery 数据集、结果数据集(默认为
validation_results,或在settings.yaml的results下配置的自定义数据集)、Cloud Storage 暂存存储桶和验证工作流位置 (BQMS_VALIDATION_LOCATION) 必须位于同一位置。验证服务创建结果数据集时,会将数据集位置默认设置为 Cloud Storage 暂存存储桶和目标 BigQuery 数据集使用的区域,如果明确设置,则为results.location。 - 支持的数据类型因来源而异。系统会从验证中排除类型不受支持的列。如需了解详情,请参阅支持的数据仓库。
- 在 BigQuery 中创建的每次运行比较表会根据
settings.yaml中的resultTtlHours自动过期,默认值为168.0小时或 7 天。请勿在validation_results数据集上配置数据集级默认表到期时间,因为这样做也会导致长期存在的审核表(例如run_history、run_metrics和column_history)到期。 - BigQuery 表名称区分大小写。当
generate-config根据dwh-migration-dumper工具元数据归档创建配置,且没有转换tables.yaml映射时,目标表名称会保留源标识符的大小写。例如,Oracle 或 Snowflake 中的大写表名称。验证targetTable.name是否与 BigQuery 中表的大小写完全匹配。
支持的数据仓库
验证服务支持以下源数据库。每个部分都包含安装时捆绑的 JDBC 驱动程序、是否可以从 dwh-migration-dumper 工具元数据归档自动生成表配置、此数据库中大表支持的分区类型,以及支持验证的数据类型。
- TeraData
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
此外,还支持所支持数据类型的参数化变体,例如 VARCHAR(255) 或 DECIMAL(10,2)。
验证服务会在自动下载的驱动程序之前加载 drivers/ 目录中的所有 JAR 文件,因此您也可以使用 drivers/ 替换捆绑的驱动程序版本。
如果您自动生成验证配置文件,则具有不受支持的数据类型的列会自动添加到 columnSettings.exclude。对于手动配置,您必须在 columnSettings.exclude 中明确排除它们。
对于大多数受支持的源数据库,验证工具会在首次使用时自动从 Maven Central 下载所需的 JDBC 驱动程序,验证其 SHA-256 校验和,并将其本地缓存在 ~/.cache/google-cloud-bqms/drivers/(或 $XDG_CACHE_HOME/google-cloud-bqms/drivers/)中。对于使用专有驱动程序的数据仓库(例如 Teradata),或者在离线或经过网闸隔离的环境中运行时,请执行以下操作:
- 将所需的驱动程序 JAR 文件放在
./drivers/、<sdk_root>/platform/bqms/drivers/或BQMS_DRIVER_DIR环境变量指定的目录中。放置在这些本地目录中的任何驱动程序 JAR 的优先级都高于自动 Maven Central 下载。 - 如需在经过网闸隔离的环境中完全停用自动网络下载,请设置
BQMS_AUTO_DOWNLOAD_DRIVERS=false,或将BQMS_MAVEN_MIRROR设置为指向内部 Maven 仓库镜像。
如需了解验证服务支持的每个数据源,请选择以下选项之一:
TeraData
Teradata 迁移支持以下验证:
dialect值:teradata- JDBC 驱动程序:由用户提供。从 Teradata 下载 Teradata JDBC 驱动程序 JAR(例如
terajdbc4.jar或terajdbc.jar),并将其复制到drivers/目录或BQMS_DRIVER_DIR指定的目录中。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector teradata) 生成。 - 分区提取:
INTEGER_RANGE、PHYSICAL
| 类别 | 数据类型 |
|---|---|
| 数字 | BYTEINT、SMALLINT、INTEGER、INT、BIGINT、DECIMAL、DEC、NUMERIC、NUMBER、FLOAT、REAL、DOUBLE PRECISION |
| 字符串 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、LONG VARCHAR |
| 日期和时间 | DATE、TIME、TIME WITH TIME ZONE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
验证从 Teradata 迁移的数据时,请考虑以下事项:
- 如果表没有显式主键,则会从唯一主索引 (
UPI) 或唯一二级索引 (USI) 中发现比较键。非唯一主索引 (NUPI) 不用作比较键。 - 支持固定精度
NUMBER(P,S);不支持无约束NUMBER(无精度)。generate-config会自动排除无约束的NUMBER、CLOB、BLOB、BYTE、VARBYTE、INTERVAL、PERIOD、JSON和XML列(对于手动配置,这些列必须列在columnSettings.exclude中)。 - 固定宽度的
CHAR列会自动剪裁。支持LATIN和UNICODE字符集以及CASESPECIFIC/NOT CASESPECIFIC属性。 TIME WITH TIME ZONE和TIMESTAMP WITH TIME ZONE值在比较之前会归一化为世界协调时间 (UTC) (AT 0)。
Snowflake
Snowflake 迁移验证支持如下:
dialect值:snowflake- JDBC 驱动程序:在首次使用时自动下载 (
net.snowflake:snowflake-jdbc),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector snowflake) 生成。 - 分区提取:
INTEGER_RANGE、DATE_RANGE
验证服务支持以下数据类型进行 Snowflake 迁移:
| 类别 | 数据类型 |
|---|---|
| 数字 | NUMBER、DECIMAL、NUMERIC、FLOAT、REAL、DOUBLE |
| 字符串 | CHAR、VARCHAR、STRING、TEXT |
| 日期和时间 | DATE、TIME、TIMESTAMP_NTZ、TIMESTAMP_LTZ、TIMESTAMP_TZ |
| 布尔值 | BOOLEAN |
验证从 Snowflake 迁移的数据时,请考虑以下事项:
- 固定宽度的
CHAR列会自动剪裁。 - 如果您使用 BigQuery Data Transfer Service 复制了数据,请设置
tolerances.timestamp: 0.001以吸收亚毫秒级舍入。
Amazon Redshift
Amazon Redshift 迁移支持以下验证:
dialect值:redshift- JDBC 驱动程序:在首次使用时自动下载 (
com.amazon.redshift:redshift-jdbc42),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector redshift) 生成。 - 分区提取:
INTEGER_RANGE、PHYSICAL
验证服务支持以下数据类型进行 Amazon Redshift 迁移:
| 类别 | 数据类型 |
|---|---|
| 数字 | SMALLINT、INTEGER、BIGINT、DECIMAL、NUMERIC、REAL、DOUBLE PRECISION |
| 字符串 | CHAR、VARCHAR、TEXT |
| 日期和时间 | DATE、TIME、TIMETZ、TIMESTAMP、TIMESTAMPTZ |
| 布尔值 | BOOLEAN |
| 半结构化 | SUPER |
验证从 Amazon Redshift 迁移的数据时,请考虑以下事项:
- 架构检查使用
SVV_COLUMNS,因此支持后期绑定视图。 - 如果表没有主键,比较键会自动回退到单列
DISTKEY或SORTKEY。 - 不支持
GEOMETRY列。
Databricks
Databricks 迁移支持以下验证:
dialect值:databricks- JDBC 驱动程序:在首次使用时自动下载 (
com.databricks:databricks-jdbc),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:不支持。创建手动表配置文件。
- 分区提取:
INTEGER_RANGE
验证服务支持以下 Databricks 迁移数据类型:
| 类别 | 数据类型 |
|---|---|
| 数字 | BYTE、TINYINT、SHORT、SMALLINT、INT、INTEGER、LONG、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字符串 | CHAR、VARCHAR、STRING |
| 日期和时间 | DATE,TIMESTAMP |
| 布尔值 | BOOLEAN |
| 二进制 | BINARY |
| 复杂 | ARRAY、MAP、STRUCT |
验证从 Databricks 迁移的数据时,请考虑以下事项:
- 使用个人访问令牌进行身份验证:设置
user: token并通过passwordSecret提供令牌。 - 架构检查基于查询 (
SELECT * ... WHERE 1=0),因此 Unity Catalog 和 Hive Metastore 工作区均受支持。
Apache Hive
Apache Hive 迁移支持以下验证:
dialect值:hive- JDBC 驱动程序:首次使用时自动下载(
org.apache.hive:hive-jdbc独立 JAR),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector hiveql) 生成。 - 分区提取:
INTEGER_RANGE
验证服务支持以下 Hive 迁移数据类型:
| 类别 | 数据类型 |
|---|---|
| 数字 | TINYINT、SMALLINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字符串 | CHAR、VARCHAR、STRING |
| 日期和时间 | DATE,TIMESTAMP |
| 布尔值 | BOOLEAN |
| 二进制 | BINARY |
| 复杂 | ARRAY、MAP、STRUCT |
验证从 Hive 迁移的数据时,请考虑以下事项:
- 架构检查基于查询 (
SELECT * ... WHERE 1=0)。 - Hive 表很少定义主键。没有比较键的表会自动对数据支柱使用整行哈希聚合。
SQL Server
SQL Server 迁移支持以下验证:
dialect值:sqlserver- JDBC 驱动程序:在首次使用时自动下载 (
com.microsoft.sqlserver:mssql-jdbc),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector sqlserver) 生成。 - 分区提取:
INTEGER_RANGE
验证服务支持以下数据类型进行 SQL Server 迁移:
| 类别 | 数据类型 |
|---|---|
| 数字 | INT、BIGINT、DECIMAL、NUMERIC、FLOAT、REAL |
| 字符串 | CHAR、VARCHAR、TEXT |
| 日期和时间 | DATE、DATETIME、TIMESTAMP |
| 布尔值 | BIT |
验证从 SQL Server 迁移的数据时,请考虑以下事项:
- 默认 JDBC 网址会设置
encrypt=true;trustServerCertificate=true;。如果您需要严格的 TLS 证书验证,请使用url连接密钥替换它。
MariaDB
MariaDB 迁移验证支持情况如下:
dialect值:mariadb- JDBC 驱动程序:在首次使用时自动下载 (
org.mariadb.jdbc:mariadb-java-client),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:创建手动表配置文件。
- 分区提取:
INTEGER_RANGE
验证服务支持以下 MariaDB 迁移数据类型:
| 类别 | 数据类型 |
|---|---|
| 数字 | TINYINT、SMALLINT、MEDIUMINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字符串 | CHAR、VARCHAR、TINYTEXT、TEXT、MEDIUMTEXT、LONGTEXT、ENUM、SET |
| 日期和时间 | DATE、TIME、DATETIME、TIMESTAMP、YEAR |
| 二进制和大型对象 | BINARY、VARBINARY、TINYBLOB、BLOB、MEDIUMBLOB、LONGBLOB |
MySQL
MySQL 迁移支持以下验证:
dialect值:mysql- JDBC 驱动程序:在首次使用时自动下载 (
com.mysql:mysql-connector-j),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:创建手动表配置文件。
- 分区提取:
INTEGER_RANGE
验证服务支持以下 MySQL 迁移数据类型:
| 类别 | 数据类型 |
|---|---|
| 数字 | INT、BIGINT、DECIMAL、FLOAT、DOUBLE |
| 字符串 | CHAR、VARCHAR、TEXT |
| 日期和时间 | DATE、TIME、DATETIME、TIMESTAMP |
| 布尔值 | BOOLEAN |
Oracle
Oracle 迁移支持以下验证:
dialect值:oracle- JDBC 驱动程序:在首次使用时自动下载 (
com.oracle.database.jdbc:ojdbc11),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector oracle) 生成。 - 分区提取:
INTEGER_RANGE、PHYSICAL
验证服务支持以下数据类型进行 Oracle 迁移:
| 类别 | 数据类型 |
|---|---|
| 数字 | NUMBER、NUMERIC、INTEGER、FLOAT、DOUBLE |
| 字符串 | CHAR、NCHAR、VARCHAR、VARCHAR2、NVARCHAR2 |
| 日期和时间 | DATE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
| 二进制和大型对象 | RAW、BINARY、BLOB、CLOB、NCLOB |
验证从 Oracle 迁移的数据时,请考虑以下事项:
DATE列在 Oracle 中包含时间组件。验证工具会以天为精度 (YYYY-MM-DD) 提取 OracleDATE列,因此一天中的时间差异会被截断。
PostgreSQL
PostgreSQL 迁移支持以下验证:
dialect值:postgresql- JDBC 驱动程序:在首次使用时自动下载 (
org.postgresql:postgresql),或由用户在drivers/目录中提供,以便在离线环境中使用。 - 自动生成配置:支持从
dwh-migration-dumper工具元数据归档 (--connector postgres) 生成。 - 分区提取:
INTEGER_RANGE、DATE_RANGE、PHYSICAL
验证服务支持以下 PostgreSQL 迁移数据类型:
| 类别 | 数据类型 |
|---|---|
| 数字 | SMALLINT、INTEGER、BIGINT、NUMERIC、DOUBLE PRECISION |
| 字符串 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、TEXT |
| 日期和时间 | DATE、TIME、TIMESTAMP、TIMESTAMP WITHOUT TIME ZONE、TIMESTAMP WITH TIME ZONE、TIMESTAMPTZ |
| 布尔值 | BOOLEAN |
| 其他 | UUID |
验证从 PostgreSQL 迁移的数据时,请考虑以下事项:
- 大于 253 的
BIGINT值在AVG()上可能会显示细微的精度差异;SUM和COUNT保持精确。
设置验证配置目录和文件
验证服务会从名为 validation_config/ 的模块化配置目录中读取数据,该目录包含以下文件:
- 数据库连接文件:定义
source数据仓库连接配置文件和targetBigQuery 连接配置文件。 - 暂存和结果设置文件:定义 Cloud Storage 暂存路径 (
googleCloudStorage)、BigQuery 结果数据集配置 (results)、每次运行的比较表过期时间 (resultTtlHours) 以及可选的全局默认值(tolerances、aggregate、labels)。 - 表验证配置文件:包含每个表的映射(
sourceTable和targetTable)、比较键 (comparisonKeys)、验证策略 (strategy)、分区提取设置 (partitioning) 和列设置 (columnSettings)。
以下部分介绍了设置验证配置目录的步骤,以及创建迁移验证所需的配置文件的步骤。
创建验证配置目录
创建一个名为 validation_config/ 的验证配置目录,用于存储验证配置文件。您可以将此目录存储在运行验证服务的机器上,也可以将其存储在 Cloud Storage 存储桶中,以便团队可以在多次运行中共享一个配置。
创建数据库连接文件
在验证配置目录中,创建一个名为 connections.yaml 的文件,并使用连接到源数据库和目标 BigQuery 数据库的信息对其进行配置。
每个数据仓库来源都有特定的功能和要求,在创建数据库连接文件时需要考虑这些功能和要求。如需详细了解每个数据源,请参阅支持的数据仓库。
当您在连接配置文件中指定 passwordSecret 时,验证服务会使用您的本地应用默认凭据 (ADC) 从客户端机器上的 Secret Manager 提取密钥版本,并将解析后的密码直接传递给本地 JDBC 驱动程序。您的源数据库不需要对 Google Cloud的网络访问权限或 IAM 访问权限,因此 passwordSecret 适用于本地数据库和托管在其他云(例如 Amazon Redshift 或 Snowflake)中的数据库。或者,您可以省略 passwordSecret,并在运行验证服务的机器上设置 BQMS_VALIDATION_SOURCE_PASSWORD 环境变量。
如需为数据仓库创建数据库连接文件,请选择以下选项之一:
TeraData
对于 Teradata 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:Teradata 系统的主机名或 IP 地址。SOURCE_DATABASE:必需的 Teradata 数据库名称。SOURCE_USER:Teradata 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
Snowflake
对于 Snowflake 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SNOWFLAKE_ACCOUNT:您的 Snowflake 账号标识符(例如myorg-myaccount)。SNOWFLAKE_WAREHOUSE:用于执行提取查询的虚拟仓库。SOURCE_DATABASE:所需的 Snowflake 数据库名称。SOURCE_SCHEMA:所需的 Snowflake 架构名称。SNOWFLAKE_ROLE:可选的 Snowflake 角色。SOURCE_USER:Snowflake 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
Amazon Redshift
对于 Amazon Redshift 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:您的 Amazon Redshift 集群端点主机名。SOURCE_DATABASE:所需的 Amazon Redshift 数据库名称。SOURCE_SCHEMA:默认架构名称(如果省略,则默认为public)。SOURCE_USER:数据库用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
Databricks
对于 Databricks 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
DATABRICKS_HOST:Databricks SQL 仓库或集群的服务器主机名。HTTP_PATH:Databricks SQL 仓库的 HTTP 路径(例如sql/protocolv1/o/1234567890/0123-456789-abcdef)。CATALOG_NAME:所需的 Unity Catalog 名称(或hive_metastore)。SCHEMA_NAME:所需的架构名称。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含 Databricks 个人访问令牌 (PAT) 的项目 ID 和 Secret ID,或者省略passwordSecret并设置BQMS_VALIDATION_SOURCE_PASSWORD。将user: token与passwordSecret搭配使用可确保您的令牌永远不会写入暂存元数据文件。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
Apache Hive
对于 Apache Hive 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:HiveServer2 主机名或 IP 地址。SOURCE_DATABASE:所需的 Hive 数据库名称(例如default)。SOURCE_USER:Hive 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
SQL Server
对于 SQL Server 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:SQL Server 实例的主机名或 IP 地址(可选择为命名实例指定instanceName)。SOURCE_DATABASE:所需的数据库名称。SOURCE_SCHEMA:默认架构名称(如果省略,则默认为dbo)。SOURCE_USER:数据库用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
MariaDB
对于 MariaDB 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:MariaDB 服务器的主机名或 IP 地址。SOURCE_DATABASE:所需的 MariaDB 数据库名称。SOURCE_USER:MariaDB 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
MySQL
对于 MySQL 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:MySQL 服务器的主机名或 IP 地址。SOURCE_DATABASE:所需的 MySQL 数据库名称。SOURCE_USER:MySQL 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密码的项目 ID 和 Secret ID,或设置为BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
Oracle
对于 Oracle 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:Oracle 服务器的主机名或 IP 地址。SERVICE_NAME:Oracle 服务名称(用于构建jdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME)。对于自定义 TNS 或 SID 连接,请改为使用完整 JDBC 网址指定url。SOURCE_SCHEMA:可选的默认架构名称。SOURCE_USER:所需的 Oracle 用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含数据库密码的项目 ID 和 Secret ID,或设置BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目标 Google Cloud项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
PostgreSQL
对于 PostgreSQL 迁移验证,请使用以下信息配置数据库连接文件:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
替换以下内容:
SOURCE_HOST:PostgreSQL 服务器的主机名或 IP 地址。SOURCE_DATABASE:所需的 PostgreSQL 数据库名称。SOURCE_SCHEMA:默认架构名称(如果省略,则默认为public)。SOURCE_USER:数据库用户名。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含数据库密码的项目 ID 和 Secret ID。或者,省略passwordSecret并设置BQMS_VALIDATION_SOURCE_PASSWORD环境变量。TARGET_PROJECT_ID:包含已迁移的 BigQuery 表且将在其中创建validation_results数据集的 Google Cloud 项目 ID。TARGET_DATASET:目标 BigQuery 数据集名称。
创建设置文件
在验证配置目录中创建一个名为 settings.yaml 的暂存和结果设置文件,以配置 Cloud Storage 暂存路径、BigQuery 结果数据集、每次运行的表过期时间以及可选的全局默认值。
使用以下内容配置暂存和结果设置文件:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
替换以下内容:
BUCKET_NAME:Cloud Storage 暂存存储桶的名称。PATH_PREFIX:存储桶中用于暂存提取的架构元数据、汇总指标、采样行和摘要报告的 Cloud Storage URI 前缀。FORMAT:暂存数据样本的文件格式。支持的值包括parquet(默认)和csv。RESULTS_PROJECT_ID:写入验证结果和运行历史记录表的 Google Cloud 项目 ID。如果省略,则默认为connections.yaml中的target.projectId。RESULTS_DATASET:写入验证结果和运行历史记录表(run_history、run_metrics和column_history)的 BigQuery 数据集名称。如果省略,则默认为validation_results。如果数据集不存在,验证服务会自动创建数据集。RESULTS_LOCATION:结果数据集的 BigQuery 位置。如果省略,则自动创建的结果数据集默认为 Cloud Storage 暂存存储桶和目标 BigQuery 数据集的区域。RESULT_TTL_HOURS:在结果数据集中创建的每次运行比较表和不匹配表的留存时间(以小时为单位)。默认值为168.0小时(7 天)。长期可观测性表(run_history、run_metrics和column_history)不受resultTtlHours的影响。RESULTS_CONFIG:配置用于存储比较结果和审核历史记录的目标 BigQuery 数据集。支持的值包括projectId、dataset和location。如果省略,验证服务会写入TARGET_PROJECT_ID.validation_results`,并自动在与目标数据集和 Cloud Storage 暂存存储桶相同的区域中创建数据集(如果尚不存在)。
您还可以通过在 settings.yaml 或 validation-config.yaml 的顶层指定 tolerances、aggregate 或 labels 来指定全局表默认值。这些默认值适用于所有表,除非在单个表配置中被覆盖。
生成表验证配置
配置连接和设置文件后,定义表验证配置。generate-config 命令会在 validation_config/databases/DATABASE/SCHEMA/TABLE.yaml 处为每个表写入一个 YAML 文件,其中包含顶级 table: 键,您也可以手动创建 validation_config/tables.yaml 文件。
选择以下选项之一,了解如何为源数据库生成表验证配置:
TeraData
对于 Teradata 迁移验证,请执行以下操作,为源架构生成 dwh-migration-dumper 工具元数据归档:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
Snowflake
对于 Snowflake 迁移验证,请执行以下操作,为源架构生成 dwh-migration-dumper 工具元数据归档:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请单独添加标志 --tables-yaml,或将其与 --metadata 一起添加,以使用源聚簇键(用于对没有主键的分区表进行分区)、物理分区元数据和元数据归档中的数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
Amazon Redshift
对于 Amazon Redshift 迁移验证,请执行以下操作,为源架构生成元数据 ZIP 归档文件:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
Databricks
Databricks 不支持自动生成配置。在 validation_config/ 目录中手动创建一个 tables.yaml 文件,其中包含以下配置:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
对于 Apache Hive 迁移验证,请执行以下操作,为源架构生成元数据 ZIP 归档文件:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
SQL Server
对于 SQL Server 迁移验证,请执行以下操作,为源架构生成 dwh-migration-dumper 工具元数据归档:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
MariaDB
MariaDB 不支持自动生成配置。在 validation_config/ 目录中手动创建一个 tables.yaml 文件,其中包含以下配置:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
MySQL 不支持自动生成配置。在 validation_config/ 目录中手动创建一个 tables.yaml 文件,其中包含以下配置:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
对于 Oracle 迁移验证,请执行以下操作,为源架构生成 dwh-migration-dumper 工具元数据归档:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
PostgreSQL
对于 PostgreSQL 迁移验证,请执行以下操作,为源架构生成 dwh-migration-dumper 工具元数据归档:
- 安装
dwh-migration-dumper工具。 - 为源数据库运行
dwh-migration-dumper,以生成dwh-migration-dumper工具元数据归档。
使用元数据归档,运行 generate-config 以生成每个表的配置文件。您可以使用 --update 标志来保留您在 validation_config/ 中创建的现有 connections.yaml 和 settings.yaml 文件。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您还拥有批量 SQL 转换器中的 tables.yaml 架构映射文件,请添加标志 --tables-yaml(单独添加或与 --metadata 一起添加),以使用元数据归档中的源分区元数据和数据类型排除项来补充转换后的表映射。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 命令支持以下标志:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具元数据归档(ZIP 文件)或包含元数据归档的目录的路径。--tables-yaml PATH_TO_TABLES_YAML:一个或多个翻译tables.yaml文件或目录的路径(以逗号分隔)。--target-dataset TARGET_DATASET:要作为前缀添加到生成的targetTable.name条目的目标 BigQuery 数据集名称。-o, --output-dir DIRECTORY:模块化配置文件的输出目录。默认值为validation_config。--schemas SCHEMA_LIST:要包含的源架构或数据库的英文逗号分隔列表(区分大小写;支持*通配符)。--tables TABLE_LIST:要包含的表名称(TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE)的英文逗号分隔列表(区分大小写;支持*通配符)。--filter-file PATH:要包含的表名称的换行符分隔文件的路径(以#开头的行会被忽略)。--update:将发现的表合并到现有validation_config/目录中,同时保留现有的connections.yaml、settings.yaml和自定义的每个表替换。--force:允许将新发现的表文件写入非空输出目录,同时保留现有表配置文件。--clean:在写入新发现的文件之前,删除输出目录中的所有现有文件。
自定义表格设置
generate-config 生成的每个表文件都包含一个 table: 部分,您可以在运行验证之前对其进行自定义。下表列出了每个表条目下支持的所有可选键。
| 可选 YAML 键 | 默认值 | 说明 |
|---|---|---|
runSchema、runAggregate、runData |
true |
在未传递任何支柱命令行 flag 时,用于启用或停用各个验证支柱的每表布尔值。 |
maxColumnsPerTile |
100 |
在宽表中,可分组到单个比较图块中的列数上限。 |
strategy |
SMART |
数据验证执行策略:SMART(如果行数少于 100,000,则为 BRUTE_FORCE,否则为 SAMPLE)、SAMPLE 或 BRUTE_FORCE。 |
sampleSize |
70000 |
当解析策略为 SAMPLE 时,要提取的行数(分区时按切片计算)。默认值 70,000 行可确保在缺陷率为 0.01%(每 10,000 行中有 1 行)或更高时,检测到至少一个不匹配行的概率大于 99.9%。 |
whereClause |
无 | 应用于来源提取和目标比较查询的 SQL 谓词(不含 WHERE 关键字)。也可以在 sourceTable.whereClause 和 targetTable.whereClause 上单独设置。 |
skipRandomization |
false |
如果为 true,则按自然表顺序最多读取 sampleSize 行,而不是按随机函数排序,从而降低大型表的查询费用。 |
maxConcurrency |
1 |
分区表的并行切片提取线程数上限。 |
maxSlices |
0(无限制) |
分区表允许的分区切片数上限。如果计算出的切片数量超过 maxSlices(当大于 0 时),分区规划会失败并报错。 |
disablePartitioning |
false |
如果为 true,则即使配置了 partitioning 代码块或行数超过 1000000,也会停用表的分区切片。 |
labels |
空地图 | 附加到 validation_results 中的验证运行指标的键值对字符串标签。 |
以下部分介绍了如何使用这些 YAML 键来自定义验证运行。
选择验证策略
对表条目使用 strategy 键,以选择用于控制 --data 支柱如何提取和比较行的验证策略。支持以下值:
SMART(默认):首先对源表中的行进行计数。 如果表的行数少于 100,000,则运行BRUTE_FORCE;如果表的行数达到或超过 100,000,则运行SAMPLE。SAMPLE:根据sampleSize的值(默认值为70,000)提取随机行样本,并使用comparisonKeys将其与目标表联接。如果至少有 0.01% 的行(万分之一)包含不匹配项,则 70,000 行的样本可提供超过 99.9% 的置信度来捕获至少一个有缺陷的行。BRUTE_FORCE:在单个未分区查询传递中提取并比较每一行。使用BRUTE_FORCE时,系统会忽略分区设置。
配置比较键
比较键是用于在源系统和目标系统之间唯一标识和联接行的列。比较键描述了为稳定联接提供足够唯一性的属性。
运行行级数据比较时,您可以通过以下方式配置比较键:
- 自动发现:从
sourceTable部分中省略comparisonKeys,以便验证工具在预检期间自动检测源数据库中的主键(回退到 Oracle 和 Snowflake 上的NOT NULL唯一性限制条件、Teradata 上的唯一索引,或 Amazon Redshift 上的单列DISTKEY或SORTKEY)。 手动复合键或自定义键:通过在
sourceTable下的comparisonKeys中列出来源键列名称,手动指定复合键或自定义比较键。 源键列名称与目标键列名称之间的大小写差异会自动匹配;如果比较键列在 BigQuery 中被重命名,请在columnSettings.columns.SOURCE_COLUMN.targetColumn下进行映射。 以下示例配置了复合比较键:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
对没有唯一键的表进行哈希比较:如果表没有主键,请在
sourceTable下设置useAllColumnsAsKey: true。当预检元数据检查未找到主键时,系统也会自动选择此选项。
为大型表配置分区提取
当表的策略解析为 SAMPLE 且表配置中存在 partitioning 块(默认情况下 generate-config 会写入该块)或表的行数超过 1,000,000 时,验证工具会将表拆分为切片,以便抽样查询扫描有界范围,而不是一次性对整个表进行排序。进行分区后,每个切片最多可提取 sampleSize 行。如需将验证限制为部分行,请改用 whereClause。
如需配置分区提取,请在 table: 部分中使用 partitioning 代码块。例如:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
partitioning 块支持以下字段:
type:INTEGER_RANGE:将表切分为数字键值对区间 (COLUMN BETWEEN START AND END)。这是默认值。DATE_RANGE:将表切分为日期或时间戳间隔。支持 PostgreSQL 和 Snowflake。PHYSICAL:当存在物理分区元数据时,对 Oracle 和 Amazon Redshift 表使用数据库分区。
column:指定源表上用于计算切片边界的已编入索引的数字、日期或时间戳列。在分区列中具有NULL值的行会从基于范围的切片(INTEGER_RANGE和DATE_RANGE)中排除。partitionSize:对于INTEGER_RANGE类型,此值指定每个切片的数字键值对范围宽度,默认值为1000000。对于DATE_RANGE类型,此值指定每个切片的天数,默认值为30。maxSlices:指定表允许的最大切片总数(在table:下设置)。如果表需要的切片数量超过maxSlices,则分区规划会失败,并显示错误,要求提供更大的partitionSize或maxSlices。maxConcurrency:指定用于提取切片的并行工作器线程数,默认值为1。在table:下设置。
自定义汇总检查
汇总分析默认处于启用状态,通过宏观层面的汇总检查来补充行级采样。此配置对于验证大型表非常有用,因为随机抽样可能会遗漏细微的数据倾斜。
如果没有自定义列配置,验证工具会根据列类型自动应用标准汇总检查:
- 精确数值(
INTEGER、NUMERIC、BIGNUMERIC):COUNT、SUM、AVG、MIN、MAX - 浮点(
FLOAT、DOUBLE、REAL):COUNT、MIN、MAX - 布尔值 (
BOOLEAN):COUNT、COUNT_TRUE、COUNT_FALSE、COUNT_NULL - 字符串(
STRING、VARCHAR、CHAR、TEXT):COUNT、SUM_LENGTH - 日期、时间和时间戳:
COUNT、MIN、MAX
您可以使用 columnSettings 部分自定义或停用汇总检查。以下示例展示了如何配置汇总容差和替换特定列检查:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
以下汇总配置规则适用:
columnSettings.columns下的列键必须与源列名称匹配(区分大小写)。- 汇总
tolerance是绝对差值阈值 (ABS(target - source) <= tolerance)。如果未设置汇总tolerance(在列级或columnSettings.aggregate.tolerance),并且该列具有行级tolerances.numeric设置,则AVG、MIN和MAX会直接沿用tolerances.numeric,而SUM会将沿用的行级容差乘以COUNT。 - 您只能在
columnSettings.columns.SOURCE_COLUMN.aggregate.functions下为每列替换functions。
排除列、映射列名称以及应用 SQL 比较表达式
您可以使用 columnSettings 排除列、设置数字或时间容差、映射重命名的目标列,或在比较之前应用 SQL 转换。columnSettings.columns 下的每个键都是源列名称。如果列在 BigQuery 中具有不同的名称,请使用该条目中的 targetColumn 属性。例如:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings 支持以下字段:
exclude:指定不区分大小写的列名称或 glob 模式 (*) 的列表,以从所有验证支柱中排除。tolerances:numeric:数值列的容差(对于基于键的比较,为ABS(target - source) <= tolerance;当useAllColumnsAsKey: true时,四舍五入到ceil(-log10(tolerance))位小数)。timestamp:时间戳列的容差(以秒为单位)。例如,0.001表示 1 毫秒。date:日期列的容差(以天为单位)。
columns:按列设置的映射,以来源列名称 (SOURCE_COLUMN) 为键:targetColumn:将源列映射到 BigQuery 中名称不同的目标列。transform:在比较之前应用的内置转换:TRIM、UPPER、LOWER:所有方言均支持。EMPTY_TO_NULL、NULL_TO_EMPTY、CAST_TO_STRING:在 PostgreSQL、Amazon Redshift、Oracle 和 Teradata 数据源的源查询中受支持。
transformExpression:引用字面量来源列名称的自定义 SQL 表达式。例如"ROUND(SOURCE_COLUMN, 4)"。由于表达式会同时在源查询和 BigQuery 比较查询中求值,因此请使用在源方言和 GoogleSQL 中都有效的 SQL 函数。
值标准化
在行级比较 (--data) 期间,验证服务会标准化值,以便源引擎和 BigQuery 之间的表示差异不会导致不匹配。验证服务会通过以下方式对值进行标准化:
- 精确数值类型(
INTEGER、NUMERIC、DECIMAL、BIGNUMERIC):在基于键的比较中,系统会比较值的完整范围(NUMERIC最多 9 位小数,BIGNUMERIC最多 38 位小数),并且在设置tolerances.numeric时,如果ABS(target - source) <= tolerance,则值匹配。在整行哈希比较 (useAllColumnsAsKey: true) 中,默认情况下,值会四舍五入到小数点后 9 位;如果设置了数值容差,则会四舍五入到小数点后ceil(-log10(tolerance))位。 - 浮点类型(
FLOAT、DOUBLE、REAL):默认情况下,标准化为 6 位小数 (1e-6)。 - 时间戳:标准化为 UTC,精确到微秒。
- 固定宽度字符类型(
CHAR、NCHAR、CHARACTER):前导空格和尾随空格会自动剪裁,以与 BigQuerySTRING语义保持一致。
运行验证服务
设置验证配置后,运行 validate 命令以启动迁移验证工具。您可以传递指向 validation_config/ 目录的本地路径或 Cloud Storage gs:// URI。
以下示例在本地存储的验证配置文件上运行验证服务:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
将 PATH_TO_VALIDATION_CONFIG 替换为模块化 validation_config/ 目录的路径。
如果您的验证配置存储在 Cloud Storage 中,请传递配置目录的 gs:// URI:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
将 BUCKET_NAME 替换为您的 Cloud Storage 存储分区的名称。
默认情况下,验证服务会在所有三个验证支柱中运行验证服务:
--schema:仅验证架构--aggregate:仅验证汇总--data:仅验证行级数据
您可以使用支柱标志在特定验证支柱上运行验证服务。以下示例使用自定义 WHERE 过滤条件对两个特定表运行架构和聚合验证:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
validate 命令支持以下可选标志:
--table或--tables:要验证的表名称的逗号分隔列表。--tables匹配区分大小写,并且必须与sourceTable.name或targetTable.name中使用的大小写一致。--where SQL_PREDICATE:在此运行期间,同时替换来源表和目标表的whereClause。--source-where SQL_PREDICATE:仅替换源表的whereClause。--target-where SQL_PREDICATE:仅替换目标表的whereClause。--gcs-path:替换googleCloudStorage.gcsPath。例如--gcs-path gs://my-bucket/validation。--max-concurrency、--concurrency或--threads:替换maxConcurrency以进行并行切片提取。--no-partition或--disable-partitioning:为运行中的所有表停用分区切片提取。--labels KEY=VALUE[,KEY=VALUE...]:将自定义键值对标签附加到运行结果。--output-dir:用于存储临时运行元数据和状态文件的本地目录。默认值为/tmp/validation_outputs。-v、--verbose、-d或--debug:启用详细或调试日志记录。
异步工作流交接
validate 会同步执行来源提取,然后为每个表触发异步 BigQuery Migration Service 工作流。
如果目标数据集位于
us以外的位置(例如eu),请在运行validate之前设置BQMS_VALIDATION_LOCATION环境变量:export BQMS_VALIDATION_LOCATION=LOCATION
对于每个表,请验证输出是否包含一个
Workflow:行,其中包含创建的工作流资源名称。例如:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
退出代码
0表示来源提取和上传成功,而不是目标比较已完成或数据匹配。如果工作流创建失败(例如,由于缺少权限),则 CLI 会记录一条警告,指出触发验证工作流失败,输出手动gcloud回退命令,并省略Workflow:行,即使进程以0退出也是如此。
查看验证结果
验证运行完成后,您可以在Google Cloud 控制台中查看验证结果,方法是查询结果数据集 validation_results、查询在 settings.yaml 的 results 下配置的 BigQuery 数据集,或读取 Cloud Storage 中的摘要报告。从下列选项中选择一项:
Google Cloud 控制台
前往 Google Cloud 控制台中的迁移服务页面。
在验证迁移下,点击查看近期迁移。
点击选择项目,然后选择存储
validation_results数据集的项目。
GoogleSQL
查询 TARGET_PROJECT_ID.validation_results.run_history 以检查近期验证运行的状态:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
将 TARGET_PROJECT_ID 替换为存储 validation_results 数据集的项目的 ID。
如需查看详细的每列指标和历史趋势,请使用以下命令进行查询:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics:每次运行、每列的不匹配计数、汇总比较以及通过或失败状态<var>TARGET_PROJECT_ID</var>.validation_results.column_history:跨运行的纵向列审核历史记录<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details:源值和目标值不同的抽样行和列
Cloud Storage 报告
每次运行完成后,系统都会将以下报告工件写入运行的 gcs_uri 目录 (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt:架构、汇总和行比较结果的摘要column_details.txt:不匹配项和汇总差异的逐列细分results.json:所有验证结果的结构化 JSON 报告queries.sql:验证运行期间执行的确切 SQL 查询
如需输出某次运行的摘要报告,请运行以下命令:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
解读验证结果
validation_results.run_history 中的每次验证运行都会报告以下执行状态或 status 值之一:
| 状态 | 说明 | 建议采取的操作 |
|---|---|---|
IN_PROGRESS |
验证工作流仍在 BigQuery 中运行。 | 等待 finished_at 填充,然后再次查询 run_history。 |
COMPLETED |
验证流水线已完成,行级数据或汇总数据不匹配项为零。架构类型兼容性详细信息分别记录在 validation_summary.txt 和 column_history 中。 |
无需执行任何操作。该表已通过验证。 |
HEALED |
验证流水线已完成,没有缺失行,并且所有检测到的值差异都是微观浮点表示抖动(单元格级比较为 < 1e-4,聚合为 < 1e-6),由验证器自动协调。 |
视为通过的运行。如果您想在上游抑制抖动,可以选择配置显式数字 tolerance。 |
COMPLETED_WITH_MISMATCHES |
验证流水线已完全执行,并发现源表和目标表之间存在缺失行、缺失目标列、汇总差异或单元格级数据差异。这表示验证运行已完成,而不是系统崩溃。 | 检查 column_details.txt、run_metrics 和 run_RUN_ID_mismatches_details,查看不匹配的列和行。如需了解详情,请参阅列级不匹配类型。 |
ERROR |
由于系统或配置错误,验证流水线未能完成。例如,由于缺少目标表、权限错误或自定义 whereClause 或 transformExpression 中的 SQL 无效。 |
查看 run_history 中的 error_message 列。如需详细了解如何解决常见错误,请参阅问题排查。 |
列级不匹配类型
当运行以 COMPLETED_WITH_MISMATCHES 结束时,每次运行的不匹配表都会使用以下结果之一对每个列比较进行分类:
EXACT_MATCH:列的比较单元格值在配置的容差范围内匹配DATA_DRIFT:行在comparisonKeys上匹配,但单元格值差异超出了配置的容差SCHEMA:该列存在于源表中,但目标表中缺少该列ROW:在comparisonKeys上联接时,目标表中缺少源行,或源表中缺少目标行
排查常见错误
下表列出了常见的命令行和工作流错误以及解决方法:
| 出错提示或问题 | 原因 | 解决方法 |
|---|---|---|
Failed to load or parse YAML |
表、partitioning、columnSettings 或 googleCloudStorage 块包含无法识别的键或无效的枚举值,例如 SAMPLING 而不是 SAMPLE。 |
根据表设置选项验证 YAML 缩进和字段名称。 |
Connection name '...' is invalid. Must be alphanumeric. |
connections: 下的配置文件名称包含下划线或连字符。例如 my_source。 |
将连接配置文件重命名为字母数字名称,例如 source 和 target。 |
googleCloudStorage cannot be null |
validation_config/settings.yaml 中缺少 googleCloudStorage.gcsPath,且未传递 --gcs-path。 |
在 validation_config/settings.yaml 中设置 googleCloudStorage.gcsPath: gs://BUCKET/PREFIX,不带尾部斜杠。 |
Target discovery directory 'validation_config/' is non-empty |
当 validation_config/ 已包含 YAML 文件时,generate-config 在没有 --update、--force 或 --clean 的情况下执行。 |
传递 --update 以合并发现的表,同时保留现有的 connections.yaml 和 settings.yaml。 |
运行 validate 时出现 tables is required |
工作目录中存在不含 tables: 列表的旧版 validation-config.yaml 文件,且其优先级高于 validation_config/,或者 validation_config/ 下不存在表 YAML 文件。 |
删除工作目录中的所有杂散 validation-config.yaml 文件,以便 validate 加载 validation_config/。 |
| 单个低基数比较键出现预检错误 | 一个包含超过 1,000 个过滤行的表配置了单个低基数比较键,这会导致多对多联接爆炸。 | 在 comparisonKeys 中指定构成唯一复合键的所有列,或在 sourceTable 下设置 useAllColumnsAsKey: true。 |
Failed to initialize MemoryUtil 或 InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
JVM 为 Java 17 或更高版本,并且在启动时未使用 --add-opens=java.base/java.nio=ALL-UNNAMED,这通常是因为命令行是通过自定义封装容器启动的,或者直接使用 java -jar 启动。 |
在环境中设置 JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED",或使用命令 gcloud bq migration validate。 |
WARNING: Failed to trigger validation workflow |
来源提取成功,但由于缺少 IAM 权限、API 未启用或位置不受支持,调用 CreateMigrationWorkflow 失败。 |
请验证 bigquerymigration.googleapis.com 是否已启用、您的账号是否具有 roles/bigquerymigration.editor,以及 BQMS_VALIDATION_LOCATION 是否与您的数据集位置一致。 |
清理验证工件
如需在查看验证结果后管理存储费用,请执行以下操作:
- 在 Cloud Storage 中,删除暂存存储桶中
gcsPath前缀下的旧运行目录,或在存储桶上配置对象生命周期管理规则。 - 在 BigQuery 中,结果数据集(默认为
validation_results)中的每次运行比较表会在resultTtlHours(默认为168.0小时或 7 天)后自动过期。在settings.yaml中调整resultTtlHours以缩短或延长保留时间,或手动删除每次运行的表,同时保留共享历史记录表和视图(run_history、run_metrics和column_history)不变。 - 使用本地文件时,请移除验证工具在
--output-dir下写入的本地工作目录。默认目录是/tmp/validation_outputs。
价格
验证服务会使用您项目中的以下资源:
- BigQuery 计算和存储:目标聚合查询、行比较联接以及
validation_results数据集中表的存储费用会根据标准 BigQuery 价格计入您的 Google Cloud 项目或billingProjectId(如果在target连接上配置)。 - Cloud Storage 存储和网络:存储桶中的暂存 Parquet 或 CSV 示例文件以及结果报告会根据标准 Cloud Storage 价格计费。
- 源数据库负载:提取查询直接针对源数据库运行。为尽量减少大型源表的负载,请使用
strategy: SAMPLE、通过whereClause进行过滤,或在不希望产生随机排序开销时设置skipRandomization: true。
后续步骤
- 了解如何使用
dwh-migration-dumper工具生成元数据以进行转换和评估。 - 批量转换 SQL 查询,将源 SQL 脚本和 DDL 转换为 GoogleSQL。
- 使用迁移沿袭规划迁移,以直观呈现源数据仓库中的数据依赖性。