


データ ウェアハウスの移行を検証する
BigQuery Migration Service の検証サービスを使用すると、ソース データ ウェアハウスから移行されたテーブルが BigQuery のターゲット テーブルと一致することを確認できます。スキーマとテーブルデータを比較して、移行中に不一致を特定できます。
検証サービス クライアントは、ソース データベースに接続し、ソーススキーマと行データを、ユーザーが管理する Cloud Storage バケットに抽出します。抽出が完了すると、検証サービスは、抽出されたスキーマと Cloud Storage バケット内のデータを、移行された BigQuery テーブルと比較します。
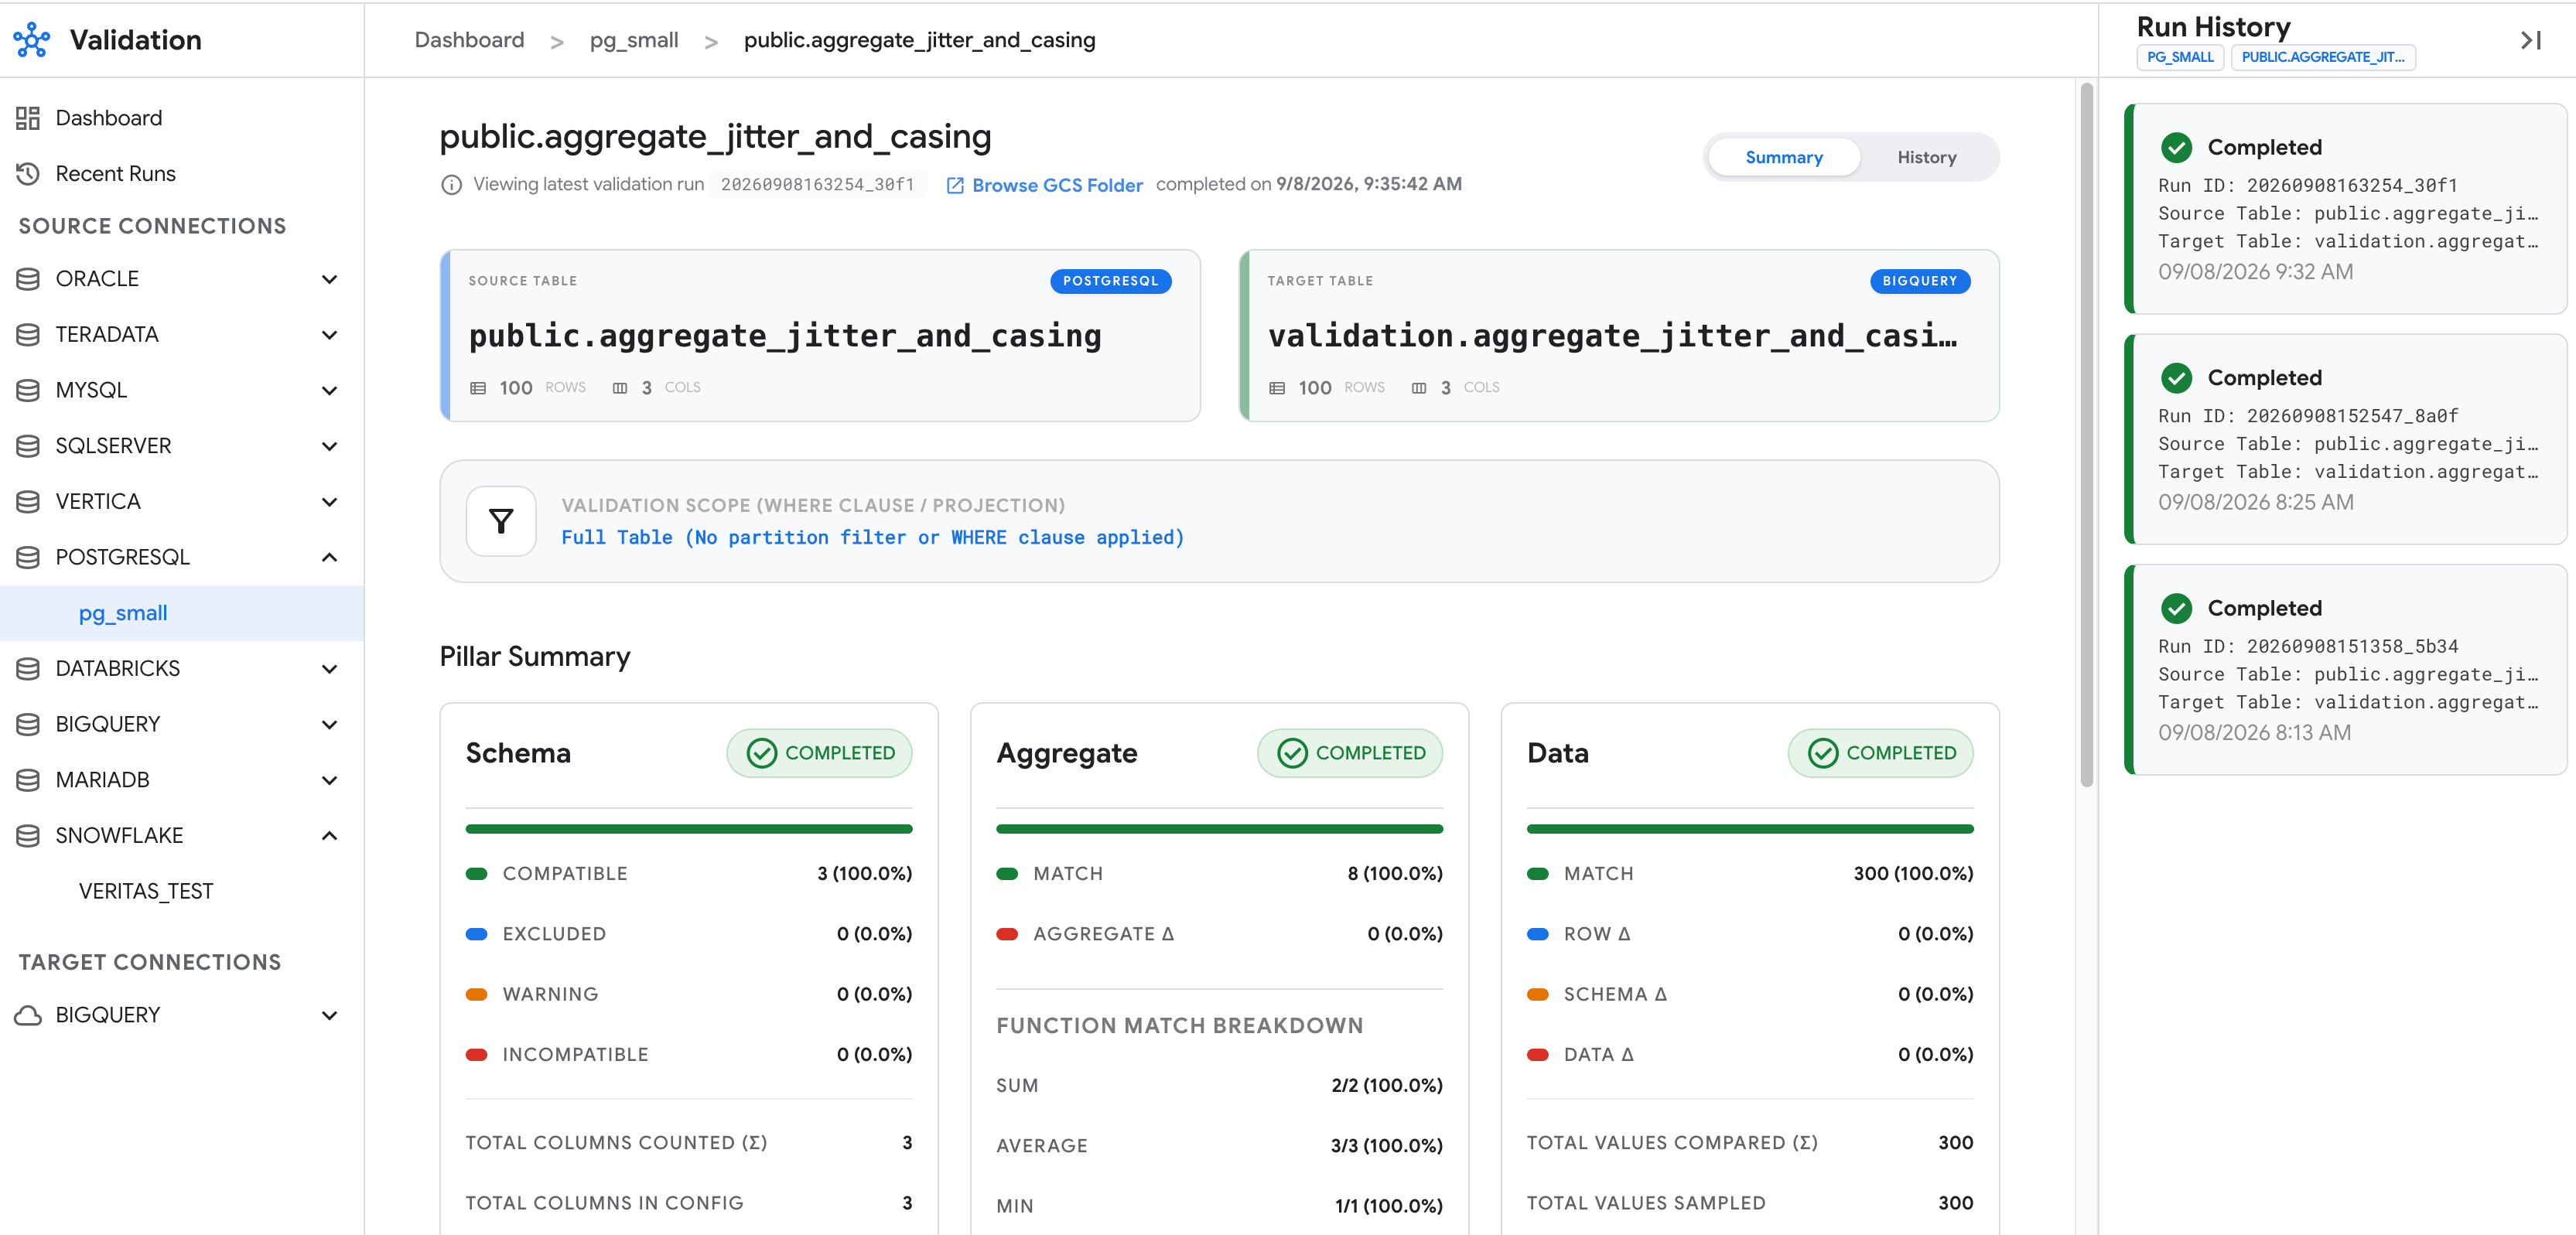
検証ワークフローでは、次の 3 つの検証要素にわたってソーステーブルとターゲット BigQuery テーブルを比較します。
- スキーマ検証(
--schema): ソーステーブルとターゲット BigQuery テーブルの列名、データ型、型の互換性を比較します。 - 集計検証(
--aggregate): テーブル全体で、テーブルレベルと列レベルの集計指標(行数、SUM、AVG、MIN、MAX、ブール分布、文字列長など)を計算して比較します。 - データ検証(
--data): 包括的なフルテーブル スキャン(BRUTE_FORCE)またはランダム化されたキーベースのサンプリング(SAMPLE)を使用して、行ごとの比較を行い、欠落している行とセルレベルの値のドリフトを検出します。
サポートされているロケーション
検証サービスは一部の地域でご利用いただけます。詳細については、BigQuery Migration Service のロケーションをご覧ください。
データ処理とセキュリティに関する考慮事項
検証サービスは、実行する検証の柱に応じて異なるデータを抽出してステージングします。
- スキーマ検証(
--schema): セル値を抽出せずに、列名、データ型、テーブル統計のみをsource_query_result.jsonファイルにアップロードします。 - 集計検証(
--aggregate): 計算された集計指標をsource_aggregates.parquetファイルにアップロードします。これには、含まれる列の実際のMINセル値とMAXセル値が含まれます。 - データ検証(
--data): サンプリングされた行、またはBRUTE_FORCE戦略を使用する場合はすべての行から、マスクされていない未加工のセル値を抽出します。これらの値は、Apache Parquet 形式または CSV 形式で Cloud Storage ステージング バケットにアップロードされ、BigQuery のvalidation_resultsデータセットに読み込まれます。
データを保護し、検証環境を保護するには、次の設定を構成します。
- 機密性の高い列を除外する: 機密性の高い列を
columnSettings.excludeフィールドに追加して、ソース抽出クエリ、ターゲット比較、検証レポートから除外します。 - ローカル データ ストレージを最小限に抑える:
settings.yamlファイルのgoogleCloudStorage.gcsPathフィールドを設定して、サンプリングされた行をローカル ディスクに書き込まずに Cloud Storage に直接ストリーミングします。共有ホストでは、実行ごとにローカルの--output-dir作業ディレクトリを削除して、ローカル メタデータ、集計、ログファイルを削除します。 - ステージング データと結果を暗号化する: 検証を実行する前に、Cloud Storage ステージング バケットと BigQuery 結果データセット(デフォルトでは
validation_results、またはresults.datasetフィールドで指定されたデータセット)で Cloud Key Management Service を使用して顧客管理の暗号鍵(CMEK)を構成します。 - 構成アクセスを制限する: 検証構成ファイルを、コードレビューが必要なバージョン管理されたリポジトリに保存するか、信頼できるユーザーのみが
storage.objects.create権限を持つ Cloud Storage バケットに保存します。 - 最小権限のアクセスを適用する: ワークフロー作成者に、プロジェクトではなく、検証対象のデータセットまたはテーブルに対してのみ
roles/bigquery.dataViewerロールを付与します。ソース データベースの権限を構成するの説明に従って、読み取り専用のソース データベース ユーザーを使用します。
始める前に
Google Cloud コンソールのプロジェクト セレクタページで、ターゲット BigQuery データセットを含む Google Cloud プロジェクトを選択または作成します。
Google Cloud プロジェクトで課金が有効になっていることを確認します。
BigQuery、BigQuery Migration Service、Cloud Storage、Secret Manager API(データベース パスワードを Secret Manager に保存する場合)を有効にします。
抽出されたメタデータとデータサンプルをステージングするために、ターゲットの BigQuery データセットと同じロケーションに Cloud Storage バケットを作成または選択します。詳細については、バケットを作成するをご覧ください。
必要なロールと権限
検証実行には 3 つの部分があり、それぞれ異なるプリンシパルで実行できます。
- データの収集: 検証クライアントは、ソース データベースを読み取り、メタデータ、集計、サンプリングされた行を Cloud Storage ステージング バケットにアップロードします。BigQuery は呼び出されません。
- 検証: BigQuery Migration Service の検証ワークフローにより、ステージングされたデータとターゲット テーブルが比較されます。ワークフローは、検証クライアント、
gcloud、 Google Cloud コンソールのいずれであっても、ワークフローを作成したプリンシパルの認証情報で実行されます。 - 結果の表示: 結果データセットと Cloud Storage レポートを読み取ります。
generate-config には Google Cloud 権限は必要ありません。
データの収集
ソースデータの収集に必要な権限を取得するには、次の IAM ロールを付与するよう管理者に依頼してください。
- ステージング バケットに対するストレージ オブジェクト作成者(
roles/storage.objectCreator) - ステージング バケットに対するストレージ オブジェクト閲覧者(
roles/storage.objectViewer) -
Cloud Storage から構成ファイルを読み取る: 構成バケットに対する Storage オブジェクト閲覧者(
roles/storage.objectViewer) -
Secret Manager からデータベース パスワードを読み取る: シークレットに対する Secret Manager のシークレット アクセサー(
roles/secretmanager.secretAccessor)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
これらの事前定義ロールには、ソースデータの収集に必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
ソースデータを収集するには、次の権限が必要です。
-
ステージング バケットに対する
storage.objects.create -
ステージング バケットに対する
storage.objects.get -
Cloud Storage から構成ファイルを読み取る:
-
構成バケットに対する
storage.objects.get -
構成バケットに対する
storage.objects.list
-
構成バケットに対する
-
Secret Manager からデータベース パスワードを読み取る: シークレットに対する
secretmanager.versions.access
カスタムロールや他の事前定義ロールを使用して、これらの権限を取得することもできます。
--extract-only では、データの収集に BigQuery または BigQuery Migration Service の権限は必要ありません。これがない場合、クライアントは検証ワークフローも作成し、検証ロールが必要です。
検証
検証ワークフローの作成と実行に必要な権限を取得するには、次の IAM ロールを付与するよう管理者に依頼してください。
- プロジェクトに対する MigrationWorkflow 編集者(
roles/bigquerymigration.editor) - プロジェクトに対する BigQuery ジョブユーザー(
roles/bigquery.jobUser)。 - 各ターゲット データセットに対する BigQuery データ閲覧者(
roles/bigquery.dataViewer) - 結果データセットに対する BigQuery データ編集者(
roles/bigquery.dataEditor) - ステージング バケットに対するStorage オブジェクト ユーザー(
roles/storage.objectUser) -
結果データセットが存在しない場合: プロジェクトに対する BigQuery ユーザー(
roles/bigquery.user)
これらの事前定義ロールには、検証ワークフローの作成と実行に必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
検証ワークフローを作成して実行するには、次の権限が必要です。
- プロジェクトに対する
bigquerymigration.workflows.create - プロジェクトに対する
bigquerymigration.workflows.get - プロジェクトに対する
bigquery.jobs.create -
各ターゲット データセットに対する
bigquery.tables.get -
各ターゲット データセットに対する
bigquery.tables.getData -
結果データセットに対する
bigquery.datasets.get -
結果データセットに対する
bigquery.tables.get -
結果データセットに対する
bigquery.tables.create -
結果データセットに対する
bigquery.tables.update -
結果データセットに対する
bigquery.tables.updateData -
結果データセットに対する
bigquery.tables.getData -
ステージング バケットに対する
storage.objects.get -
ステージング バケットに対する
storage.objects.create -
ステージング バケットに対する
storage.objects.delete -
結果データセットが存在しない場合: プロジェクトに対する
bigquery.datasets.create
roles/bigquerymigration.editor には、検証で使用されない権限が多数含まれています。最小権限を付与するには、bigquerymigration.workflows.create と bigquerymigration.workflows.get のみを含むカスタムロールを付与します。
検証では、ターゲット テーブルの読み取りと、結果データセットへの書き込みのみが行われます。プリンシパルがプロジェクトにデータセットを作成する権限を必要としないように、結果データセットを事前に作成することをおすすめします。
結果の表示
検証結果の表示に必要な権限を取得するには、次の IAM ロールを付与するよう管理者に依頼してください。
- 結果データセットを含むプロジェクトに対する BigQuery ジョブユーザー(
roles/bigquery.jobUser) - 結果データセットに対する BigQuery データ閲覧者(
roles/bigquery.dataViewer) -
Cloud Storage のレポートを読み取る: ステージング バケットに対する Storage オブジェクト閲覧者(
roles/storage.objectViewer) -
Google Cloud コンソールで検証ワークフローを一覧表示して表示する: プロジェクトに対する MigrationWorkflow 閲覧者(
roles/bigquerymigration.viewer)
これらの事前定義ロールには、検証結果の表示に必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
検証結果を表示するには、次の権限が必要です。
- プロジェクトに対する
bigquery.jobs.create -
結果データセットに対する
bigquery.tables.get -
結果データセットに対する
bigquery.tables.getData -
Cloud Storage でレポートを読み取る:
-
ステージング バケットに対する
storage.objects.get -
ステージング バケットに対する
storage.objects.list
-
ステージング バケットに対する
-
Google Cloud コンソールで検証ワークフローを一覧表示して表示する。
- プロジェクトに対する
bigquerymigration.workflows.list - プロジェクトに対する
bigquerymigration.workflows.get
- プロジェクトに対する
ソース データベースの権限を構成する
次の権限を持つソース データベース ユーザーへの読み取り専用権限を構成する必要があります。
- 検証対象のすべてのソーステーブルに対する
SELECT権限。 - スキーマと主キーの検出に使用されるシステム カタログ ビュー(
information_schemaテーブル、Oracle のALL_CONSTRAINTSとALL_TAB_COLUMNS、Amazon Redshift のSVV_COLUMNSとpg_attributeなど)に対する読み取りアクセス権。
このユーザーに書き込み権限、DDL 権限、管理者権限を付与しないでください。検証クライアントは、このユーザーとして検証構成から SQL を実行します。詳細については、データ処理とセキュリティに関する考慮事項をご覧ください。
制限事項
検証サービスには次の制限があります。
- サポートされているターゲット データベースは BigQuery のみです。BigQuery 以外の 2 つのデータベース間の検証や、BigQuery を検証ソースとして使用することはサポートされていません。
- ターゲット BigQuery データセット、結果データセット(デフォルトでは
validation_results、またはsettings.yamlのresultsで構成されたカスタム データセット)、Cloud Storage ステージング バケット、検証ワークフローのロケーション(BQMS_VALIDATION_LOCATION)は、同じロケーションに存在する必要があります。検証サービスが結果データセットを作成するときに、データセットのロケーションは、Cloud Storage ステージング バケットとターゲット BigQuery データセットで使用されるリージョンにデフォルトで設定されます。明示的に設定されている場合はresults.locationに設定されます。 - サポートされるデータタイプはソースによって異なります。サポートされていない型の列は検証から除外されます。詳細については、サポートされているデータ ウェアハウスをご覧ください。
- BigQuery で作成された実行ごとの比較テーブルは、
settings.yamlのresultTtlHoursに基づいて自動的に期限切れになります。デフォルトは168.0時間(7 日間)です。validation_resultsデータセットにデータセット レベルのデフォルトのテーブル有効期限を構成しないでください。構成すると、run_history、run_metrics、column_historyなどの有効期間の長い監査テーブルも期限切れになります。 - BigQuery テーブル名では大文字と小文字が区別されます。
generate-configがtables.yamlマッピングなしでdwh-migration-dumperツール メタデータ アーカイブから構成を作成する場合、ターゲット テーブル名ではソース識別子の大文字と小文字が保持されます。たとえば、Oracle や Snowflake の大文字のテーブル名です。targetTable.nameが BigQuery のテーブルの正確な大文字と小文字と一致していることを確認します。
サポートされているデータ ウェアハウス
検証サービスは、次のソース データベースをサポートしています。各セクションには、インストールにバンドルされている JDBC ドライバ、dwh-migration-dumper ツール メタデータ アーカイブからテーブル構成を自動的に生成できるかどうか、このデータベースの大きなテーブルでサポートされているパーティショニング タイプ、検証でサポートされているデータ型が含まれています。
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
サポートされているデータ型のパラメータ化されたバリアント(VARCHAR(255) や DECIMAL(10,2) など)もサポートされています。
検証サービスは、自動的にダウンロードされたドライバの前に drivers/ ディレクトリ内の JAR ファイルを読み込みます。そのため、drivers/ を使用して、バンドルされたドライバ バージョンをオーバーライドすることもできます。
検証構成ファイルを自動的に生成すると、サポートされていないデータ型の列が columnSettings.exclude に自動的に追加されます。手動構成の場合は、columnSettings.exclude で明示的に除外する必要があります。
サポートされているほとんどのソース データベースでは、検証ツールは初回使用時に Maven Central から必要な JDBC ドライバを自動的にダウンロードし、SHA-256 チェックサムを検証して、~/.cache/google-cloud-bqms/drivers/(または $XDG_CACHE_HOME/google-cloud-bqms/drivers/)にローカルにキャッシュします。Teradata などの独自のドライバを使用するデータ ウェアハウスの場合、またはオフライン環境やエアギャップ環境で実行する場合は、次の操作を行います。
- 必要なドライバ JAR ファイルを
./drivers/、<sdk_root>/platform/bqms/drivers/、またはBQMS_DRIVER_DIR環境変数で指定されたディレクトリに配置します。これらのローカル ディレクトリに配置されたドライバ JAR は、Maven Central の自動ダウンロードよりも優先されます。 - エアギャップ環境で自動ネットワーク ダウンロードを完全に無効にするには、
BQMS_AUTO_DOWNLOAD_DRIVERS=falseを設定するか、内部 Maven リポジトリ ミラーを指すようにBQMS_MAVEN_MIRRORを設定します。
検証サービスでサポートされている各データソースの詳細については、次のいずれかのオプションを選択してください。
Teradata
Teradata 移行の検証は、次のようにサポートされています。
dialect値:teradata- JDBC ドライバ: ユーザー指定。Teradata から Teradata JDBC ドライバ JAR(
terajdbc4.jarやterajdbc.jarなど)をダウンロードし、drivers/ディレクトリまたはBQMS_DRIVER_DIRで指定されたディレクトリにコピーします。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector teradata)からサポートされています。 - パーティション分割抽出:
INTEGER_RANGE、PHYSICAL
| カテゴリ | データ型 |
|---|---|
| 数値 | BYTEINT、SMALLINT、INTEGER、INT、BIGINT、DECIMAL、DEC、NUMERIC、NUMBER、FLOAT、REAL、DOUBLE PRECISION |
| 文字列 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、LONG VARCHAR |
| 日時 | DATE、TIME、TIME WITH TIME ZONE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
Teradata からの移行を検証する際は、次の点を考慮してください。
- テーブルに明示的な主キーがない場合、比較キーは一意のプライマリ インデックス(
UPI)または一意のセカンダリ インデックス(USI)から検出されます。一意でないプライマリ インデックス(NUPI)は、比較キーとして使用されません。 - 固定精度の
NUMBER(P,S)はサポートされています。制約のないNUMBER(精度なし)はサポートされていません。制約のないNUMBER、CLOB、BLOB、BYTE、VARBYTE、INTERVAL、PERIOD、JSON、XML列は、generate-configによって自動的に除外されます(または、手動構成の場合はcolumnSettings.excludeにリストする必要があります)。 - 固定幅の
CHAR列は自動的にトリミングされます。LATINとUNICODEの両方の文字セットと、CASESPECIFIC/NOT CASESPECIFIC属性がサポートされています。 TIME WITH TIME ZONE値とTIMESTAMP WITH TIME ZONE値は、比較前に UTC(AT 0)に正規化されます。
Snowflake
Snowflake 移行の検証は、次のようにサポートされています。
dialect値:snowflake- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
net.snowflake:snowflake-jdbc)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector snowflake)からサポートされています。 - パーティション分割抽出:
INTEGER_RANGE、DATE_RANGE
検証サービスは、Snowflake の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | NUMBER、DECIMAL、NUMERIC、FLOAT、REAL、DOUBLE |
| 文字列 | CHAR、VARCHAR、STRING、TEXT |
| 日時 | DATE、TIME、TIMESTAMP_NTZ、TIMESTAMP_LTZ、TIMESTAMP_TZ |
| ブール値 | BOOLEAN |
Snowflake からの移行を検証する際は、次の点を考慮してください。
- 固定幅の
CHAR列は自動的にトリミングされます。 - BigQuery Data Transfer Service でデータを複製した場合は、ミリ秒未満の丸めを吸収するように
tolerances.timestamp: 0.001を設定します。
Amazon Redshift
Amazon Redshift の移行の検証は、次のようにサポートされています。
dialect値:redshift- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
com.amazon.redshift:redshift-jdbc42)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector redshift)からサポートされています。 - パーティション分割抽出:
INTEGER_RANGE、PHYSICAL
検証サービスは、Amazon Redshift の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | SMALLINT、INTEGER、BIGINT、DECIMAL、NUMERIC、REAL、DOUBLE PRECISION |
| 文字列 | CHAR、VARCHAR、TEXT |
| 日時 | DATE、TIME、TIMETZ、TIMESTAMP、TIMESTAMPTZ |
| ブール値 | BOOLEAN |
| 半構造化 | SUPER |
Amazon Redshift からの移行を検証する際は、次の点を考慮してください。
- スキーマ検査では
SVV_COLUMNSが使用されるため、遅延バインディング ビューがサポートされます。 - テーブルに主キーがない場合、比較キーは自動的に単一列の
DISTKEYまたはSORTKEYにフォールバックします。 GEOMETRY列はサポートされていません。
Databricks
Databricks 移行の検証は、次のようにサポートされています。
dialect値:databricks- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
com.databricks:databricks-jdbc)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成: サポートされていません。手動テーブル構成ファイルを作成します。
- パーティション分割された抽出:
INTEGER_RANGE
検証サービスは、Databricks の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | BYTE、TINYINT、SHORT、SMALLINT、INT、INTEGER、LONG、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 文字列 | CHAR、VARCHAR、STRING |
| 日時 | DATE、TIMESTAMP |
| ブール値 | BOOLEAN |
| バイナリ | BINARY |
| 複雑 | ARRAY、MAP、STRUCT |
Databricks からの移行を検証する際は、次の点を考慮してください。
- 個人用アクセス トークンで認証する:
user: tokenを設定し、passwordSecretを介してトークンを指定します。 - スキーマ検査はクエリベース(
SELECT * ... WHERE 1=0)であるため、Unity Catalog と Hive metastore の両方のワークスペースがサポートされています。
Apache Hive
Apache Hive 移行の検証は、次のようにサポートされています。
dialect値:hive- JDBC ドライバ: 初回使用時に自動的にダウンロードされます(
org.apache.hive:hive-jdbcスタンドアロン JAR)。オフライン環境の場合は、drivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector hiveql)からサポートされています。 - パーティション分割された抽出:
INTEGER_RANGE
検証サービスは、Hive 移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | TINYINT、SMALLINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 文字列 | CHAR、VARCHAR、STRING |
| 日時 | DATE、TIMESTAMP |
| ブール値 | BOOLEAN |
| バイナリ | BINARY |
| 複雑 | ARRAY、MAP、STRUCT |
Hive からの移行を検証する際は、次の点を考慮してください。
- スキーマ検査はクエリベース(
SELECT * ... WHERE 1=0)です。 - Hive テーブルで主キーが定義されることはまれです。比較キーのないテーブルでは、データピラーにフルロー ハッシュ集計が自動的に使用されます。
SQL Server
SQL Server 移行の検証は、次のようにサポートされています。
dialect値:sqlserver- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
com.microsoft.sqlserver:mssql-jdbc)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector sqlserver)からサポートされています。 - パーティション分割された抽出:
INTEGER_RANGE
検証サービスは、SQL Server の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | INT、BIGINT、DECIMAL、NUMERIC、FLOAT、REAL |
| 文字列 | CHAR、VARCHAR、TEXT |
| 日時 | DATE、DATETIME、TIMESTAMP |
| ブール値 | BIT |
SQL Server からの移行を検証する際は、次の点を考慮してください。
- デフォルトの JDBC URL は
encrypt=true;trustServerCertificate=true;を設定します。厳格な TLS 証明書の検証が必要な場合は、url接続キーでオーバーライドします。
MariaDB
MariaDB 移行の検証は、次のようにサポートされています。
dialect値:mariadb- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
org.mariadb.jdbc:mariadb-java-client)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成: 手動テーブル構成ファイルを作成します。
- パーティション分割された抽出:
INTEGER_RANGE
検証サービスは、MariaDB の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | TINYINT、SMALLINT、MEDIUMINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 文字列 | CHAR、VARCHAR、TINYTEXT、TEXT、MEDIUMTEXT、LONGTEXT、ENUM、SET |
| 日時 | DATE、TIME、DATETIME、TIMESTAMP、YEAR |
| バイナリ オブジェクトとラージ オブジェクト | BINARY、VARBINARY、TINYBLOB、BLOB、MEDIUMBLOB、LONGBLOB |
MySQL
MySQL 移行の検証は、次のようにサポートされています。
dialect値:mysql- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
com.mysql:mysql-connector-j)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成: 手動テーブル構成ファイルを作成します。
- パーティション分割された抽出:
INTEGER_RANGE
検証サービスは、MySQL 移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | INT、BIGINT、DECIMAL、FLOAT、DOUBLE |
| 文字列 | CHAR、VARCHAR、TEXT |
| 日時 | DATE、TIME、DATETIME、TIMESTAMP |
| ブール値 | BOOLEAN |
Oracle
Oracle 移行の検証は、次のようにサポートされています。
dialect値:oracle- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
com.oracle.database.jdbc:ojdbc11)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector oracle)からサポートされています。 - パーティション分割抽出:
INTEGER_RANGE、PHYSICAL
検証サービスは、Oracle の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | NUMBER、NUMERIC、INTEGER、FLOAT、DOUBLE |
| 文字列 | CHAR、NCHAR、VARCHAR、VARCHAR2、NVARCHAR2 |
| 日時 | DATE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
| バイナリ オブジェクトとラージ オブジェクト | RAW、BINARY、BLOB、CLOB、NCLOB |
Oracle からの移行を検証する際は、次の点を考慮してください。
DATE列には、Oracle の時刻コンポーネントが含まれます。検証ツールは、Oracle のDATE列を日単位の精度(YYYY-MM-DD)で抽出するため、時刻の差は切り捨てられます。
PostgreSQL
PostgreSQL 移行の検証は、次のようにサポートされています。
dialect値:postgresql- JDBC ドライバ: 初回使用時に自動的にダウンロードされる(
org.postgresql:postgresql)か、オフライン環境の場合はdrivers/ディレクトリにユーザーが指定します。 - 構成の自動生成:
dwh-migration-dumperツール メタデータ アーカイブ(--connector postgres)からサポートされています。 - パーティション分割された抽出:
INTEGER_RANGE、DATE_RANGE、PHYSICAL
検証サービスは、PostgreSQL の移行で次のデータ型をサポートしています。
| カテゴリ | データ型 |
|---|---|
| 数値 | SMALLINT、INTEGER、BIGINT、NUMERIC、DOUBLE PRECISION |
| 文字列 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、TEXT |
| 日時 | DATE、TIME、TIMESTAMP、TIMESTAMP WITHOUT TIME ZONE、TIMESTAMP WITH TIME ZONE、TIMESTAMPTZ |
| ブール値 | BOOLEAN |
| その他 | UUID |
PostgreSQL からの移行を検証する際は、次の点を考慮してください。
BIGINTの値が 253 より大きい場合、AVG()でわずかな精度の違いが生じることがあります。SUMとCOUNTは正確なままです。
検証構成ディレクトリとファイルを設定する
検証サービスは、次のファイルを含む validation_config/ という名前のモジュラー構成ディレクトリから読み取ります。
- データベース接続ファイル:
sourceデータ ウェアハウス接続プロファイルとtargetBigQuery 接続プロファイルを定義します。 - ステージングと結果の設定ファイル: Cloud Storage ステージング パス(
googleCloudStorage)、BigQuery 結果データセット構成(results)、実行ごとの比較テーブルの有効期限(resultTtlHours)、オプションのグローバル デフォルト(tolerances、aggregate、labels)を定義します。 - テーブル検証構成ファイル: テーブルごとのマッピング(
sourceTableとtargetTable)、比較キー(comparisonKeys)、検証戦略(strategy)、パーティション分割された抽出設定(partitioning)、列設定(columnSettings)が含まれます。
以降のセクションでは、検証構成ディレクトリを設定する手順と、移行検証に必要な構成ファイルを作成する手順について説明します。
検証構成ディレクトリを作成する
検証構成ファイルを保存する validation_config/ という名前の検証構成ディレクトリを作成します。このディレクトリは、検証サービスを実行するマシンに保存することも、Cloud Storage バケットに保存して、チームが実行間で 1 つの構成を共有することもできます。
データベース接続ファイルを作成する
検証構成ディレクトリに connections.yaml という名前のファイルを作成し、ソース データベースとターゲット BigQuery データベースに接続するための情報を構成します。
各データ ウェアハウス ソースには、データベース接続ファイルを作成する際に考慮すべき特定の機能と要件があります。各データソースの詳細については、サポートされているデータ ウェアハウスをご覧ください。
接続プロファイルで passwordSecret を指定すると、検証サービスは、ローカルのアプリケーションのデフォルト認証情報(ADC)を使用して、クライアント マシンの Secret Manager からシークレット バージョンを取得し、解決されたパスワードをローカルの JDBC ドライバに直接渡します。ソース データベースには、 Google Cloudへのネットワーク アクセスや IAM アクセスは必要ありません。そのため、passwordSecret は、オンプレミス データベースや、Amazon Redshift や Snowflake などの他のクラウドでホストされているデータベースでも機能します。または、passwordSecret を省略して、検証サービスを実行しているマシンに BQMS_VALIDATION_SOURCE_PASSWORD 環境変数を設定することもできます。
データ ウェアハウスのデータベース接続ファイルを作成するには、次のいずれかのオプションを選択します。
Teradata
Teradata 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: Teradata システムのホスト名または IP アドレス。SOURCE_DATABASE: 必要な Teradata データベース名。SOURCE_USER: Teradata のユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
Snowflake
Snowflake 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SNOWFLAKE_ACCOUNT: Snowflake アカウント ID(myorg-myaccountなど)。SNOWFLAKE_WAREHOUSE: 抽出クエリの実行に使用される仮想ウェアハウス。SOURCE_DATABASE: 必要な Snowflake データベース名。SOURCE_SCHEMA: 必要な Snowflake スキーマ名。SNOWFLAKE_ROLE: オプションの Snowflake ロール。SOURCE_USER: Snowflake のユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
Amazon Redshift
Amazon Redshift の移行検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: Amazon Redshift クラスタ エンドポイントのホスト名。SOURCE_DATABASE: 必要な Amazon Redshift データベース名。SOURCE_SCHEMA: デフォルトのスキーマ名(省略した場合はデフォルトのpublic)。SOURCE_USER: データベースのユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
Databricks
Databricks 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
DATABRICKS_HOST: Databricks SQL ウェアハウスまたはクラスタのサーバー ホスト名。HTTP_PATH: Databricks SQL ウェアハウスの HTTP パス(例:sql/protocolv1/o/1234567890/0123-456789-abcdef)。CATALOG_NAME: 必要な Unity Catalog 名(またはhive_metastore)。SCHEMA_NAME: 必要なスキーマ名。SECRET_PROJECT_ID、SECRET_ID: Databricks 個人アクセス トークン(PAT)を含む Secret Manager のプロジェクト ID とシークレット ID。または、passwordSecretを省略してBQMS_VALIDATION_SOURCE_PASSWORDを設定します。passwordSecretでuser: tokenを使用すると、トークンがステージング メタデータ ファイルに書き込まれることはありません。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
Apache Hive
Apache Hive 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: HiveServer2 のホスト名または IP アドレス。SOURCE_DATABASE: 必須の Hive データベース名(例:default)。SOURCE_USER: Hive ユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
SQL Server
SQL Server の移行検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: SQL Server インスタンスのホスト名または IP アドレス(必要に応じて、名前付きインスタンスにinstanceNameを指定します)。SOURCE_DATABASE: 必要なデータベース名。SOURCE_SCHEMA: デフォルトのスキーマ名(省略した場合はデフォルトのdbo)。SOURCE_USER: データベースのユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
MariaDB
MariaDB 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: MariaDB サーバーのホスト名または IP アドレス。SOURCE_DATABASE: 必要な MariaDB データベース名。SOURCE_USER: MariaDB のユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
MySQL
MySQL 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: MySQL サーバーのホスト名または IP アドレス。SOURCE_DATABASE: 必要な MySQL データベース名。SOURCE_USER: MySQL ユーザー名。SECRET_PROJECT_IDとSECRET_ID: パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
Oracle
Oracle 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: Oracle サーバーのホスト名または IP アドレス。SERVICE_NAME: Oracle サービス名(jdbc:oracle:thin:@//HOST:PORT/SERVICE_NAMEの作成に使用)。カスタム TNS 接続または SID 接続の場合は、代わりに完全な JDBC URL を指定してurlを指定します。SOURCE_SCHEMA: 省略可能なデフォルトのスキーマ名。SOURCE_USER: 必要な Oracle ユーザー名。SECRET_PROJECT_IDとSECRET_ID: データベース パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。またはBQMS_VALIDATION_SOURCE_PASSWORDを設定します。TARGET_PROJECT_ID: ターゲット Google Cloudプロジェクト ID。TARGET_DATASET: ターゲット BigQuery データセット名。
PostgreSQL
PostgreSQL 移行の検証では、次の情報を使用してデータベース接続ファイルを構成します。
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
次のように置き換えます。
SOURCE_HOST: PostgreSQL サーバーのホスト名または IP アドレス。SOURCE_DATABASE: 必要な PostgreSQL データベース名。SOURCE_SCHEMA: デフォルトのスキーマ名(省略した場合はデフォルトのpublic)。SOURCE_USER: データベースのユーザー名。SECRET_PROJECT_IDとSECRET_ID: データベース パスワードを含む Secret Manager のプロジェクト ID とシークレット ID。または、passwordSecretを省略してBQMS_VALIDATION_SOURCE_PASSWORD環境変数を設定します。TARGET_PROJECT_ID: 移行された BigQuery テーブルを含む Google Cloud プロジェクト ID。validation_resultsデータセットが作成される場所。TARGET_DATASET: ターゲット BigQuery データセット名。
設定ファイルを作成する
検証構成ディレクトリに settings.yaml という名前のステージングと結果の設定ファイルを作成して、Cloud Storage ステージング パス、BigQuery 結果データセット、実行ごとのテーブル有効期限、オプションのグローバル デフォルトを構成します。
ステージングと結果の設定ファイルを次のように構成します。
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
次のように置き換えます。
BUCKET_NAME: Cloud Storage ステージング バケットの名前。PATH_PREFIX: 抽出されたスキーマ メタデータ、集計指標、サンプリングされた行、サマリー レポートのステージングに使用されるバケット内の Cloud Storage URI 接頭辞。FORMAT: ステージングされたデータサンプルのファイル形式。サポートされている値はparquet(デフォルト)とcsvです。RESULTS_PROJECT_ID: 検証結果と実行履歴テーブルが書き込まれる Google Cloud プロジェクト ID。省略した場合、connections.yamlのtarget.projectIdがデフォルトになります。RESULTS_DATASET: 検証結果と実行履歴テーブル(run_history、run_metrics、column_history)が書き込まれる BigQuery データセット名。省略された場合、デフォルトのvalidation_resultsになります。データセットが存在しない場合、検証サービスによって自動的に作成されます。RESULTS_LOCATION: 結果データセットの BigQuery のロケーション。省略すると、自動的に作成された結果データセットは、デフォルトで Cloud Storage ステージング バケットとターゲット BigQuery データセットのリージョンになります。RESULT_TTL_HOURS: 結果データセットに作成された実行ごとの比較テーブルと不一致テーブルの有効期間(時間)。デフォルトは168.0時間(7 日間)です。長期間のオブザーバビリティ テーブル(run_history、run_metrics、column_history)はresultTtlHoursの影響を受けません。RESULTS_CONFIG: 比較結果と監査履歴の宛先 BigQuery データセットを構成します。サポートされる値はprojectId、dataset、locationです。省略すると、検証サービスはTARGET_PROJECT_ID.validation_results` に書き込み、ターゲット データセットおよび Cloud Storage ステージング バケットと同じリージョンにデータセットを自動的に作成します(まだ存在しない場合)。
settings.yaml または validation-config.yaml の最上位で tolerances、aggregate、labels を指定して、グローバル テーブルのデフォルトを指定することもできます。これらのデフォルトは、個々のテーブル構成でオーバーライドされていない限り、すべてのテーブルに適用されます。
テーブル検証構成を生成する
接続ファイルと設定ファイルを構成したら、テーブル検証構成を定義します。generate-config コマンドは、validation_config/databases/DATABASE/SCHEMA/TABLE.yaml にテーブルごとに 1 つの YAML ファイルを書き込みます。このファイルには、最上位の table: キーが含まれます。または、手動で validation_config/tables.yaml ファイルを作成することもできます。
ソース データベースのテーブル検証構成の生成に関する情報については、次のいずれかのオプションを選択してください。
Teradata
Teradata の移行検証では、次の操作を行って、ソーススキーマの dwh-migration-dumper ツール メタデータ アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
Snowflake
Snowflake 移行の検証では、次の操作を行って、ソーススキーマの dwh-migration-dumper ツール メタデータ アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に含めて、変換されたテーブル マッピングをソース クラスタリング キー(主キーのないパーティション分割テーブル用)、物理パーティション メタデータ、メタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
Amazon Redshift
Amazon Redshift の移行検証では、次の手順でソーススキーマのメタデータ ZIP アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
Databricks
Databricks では、構成の自動生成はサポートされていません。validation_config/ ディレクトリに、次の構成の tables.yaml ファイルを手動で作成します。
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Apache Hive の移行検証では、次の操作を行って、ソーススキーマのメタデータ ZIP アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
SQL Server
SQL Server の移行検証では、次の操作を行って、移行元スキーマの dwh-migration-dumper ツール メタデータ アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
MariaDB
MariaDB では、構成の自動生成はサポートされていません。validation_config/ ディレクトリに、次の構成の tables.yaml ファイルを手動で作成します。
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
MySQL では、構成の自動生成はサポートされていません。validation_config/ ディレクトリに、次の構成の tables.yaml ファイルを手動で作成します。
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Oracle 移行の検証では、次の操作を行って、ソーススキーマの dwh-migration-dumper ツール メタデータ アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
PostgreSQL
PostgreSQL 移行の検証では、次の操作を行って、ソーススキーマの dwh-migration-dumper ツール メタデータ アーカイブを生成します。
dwh-migration-dumperツールをインストールします。- ソース データベースに対して
dwh-migration-dumperを実行して、dwh-migration-dumperツール メタデータ アーカイブを生成します。
メタデータ アーカイブを使用して generate-config を実行し、テーブルごとの構成ファイルを生成します。--update フラグを使用すると、validation_config/ で作成した既存の connections.yaml ファイルと settings.yaml ファイルを保持できます。次に例を示します。
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
バッチ SQL トランスレータの tables.yaml スキーマ マッピング ファイルもある場合は、--tables-yaml フラグを単独で、または --metadata と一緒に指定して、変換されたテーブル マッピングをソース パーティション メタデータとメタデータ アーカイブからのデータ型除外で補完します。次に例を示します。
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config コマンドは、次のフラグをサポートしています。
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumperツール メタデータ アーカイブ(ZIP ファイル)またはメタデータ アーカイブを含むディレクトリのパス。--tables-yaml PATH_TO_TABLES_YAML: 1 つ以上の変換tables.yamlファイルまたはディレクトリのパス(カンマ区切り)。--target-dataset TARGET_DATASET: 生成されたtargetTable.nameエントリの先頭に付加するターゲット BigQuery データセット名。-o, --output-dir DIRECTORY: モジュラー構成ファイルの出力ディレクトリ。デフォルト値はvalidation_configです。--schemas SCHEMA_LIST: 含めるソーススキーマまたはデータベースのカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポートしています)。--tables TABLE_LIST: 含めるテーブル名(TABLE、SCHEMA.TABLE、DB.SCHEMA.TABLE)のカンマ区切りのリスト(大文字と小文字を区別します。*ワイルドカードをサポート)。--filter-file PATH: 含めるテーブル名の改行区切りファイルへのパス(#で始まる行は無視されます)。--update: 検出されたテーブルを既存のvalidation_config/ディレクトリにマージします。既存のconnections.yaml、settings.yaml、カスタムのテーブルごとのオーバーライドは保持されます。--force: 既存のテーブル構成ファイルを保持しながら、新しく検出されたテーブル ファイルを空でない出力ディレクトリに書き込むことができます。--clean: 新しく検出されたファイルを書き込む前に、出力ディレクトリ内の既存のファイルをすべて削除します。
表の設定をカスタマイズする
generate-config によって生成された各テーブル ファイルには、検証を実行する前にカスタマイズできる table: セクションが含まれています。次の表に、各テーブル エントリでサポートされているすべてのオプションキーを示します。
| オプションの YAML キー | デフォルト値 | 説明 |
|---|---|---|
runSchema、runAggregate、runData |
true |
テーブルごとのブール値。柱のコマンドライン フラグが渡されない場合に、個々の検証柱を有効または無効にします。 |
maxColumnsPerTile |
100 |
幅の広いテーブルで 1 つの比較タイルにグループ化される列の最大数。 |
strategy |
SMART |
データ検証の実行戦略: SMART(100,000 行未満の場合は BRUTE_FORCE、それ以外の場合は SAMPLE)、SAMPLE、または BRUTE_FORCE。 |
sampleSize |
70000 |
解決された戦略が SAMPLE の場合に抽出する行数(パーティション分割されている場合はスライスごと)。デフォルトの 70,000 行では、不良率が 0.01%(10,000 行に 1 行)以上の場合、少なくとも 1 つの不一致行が検出される確率は 99.9% を超えます。 |
whereClause |
なし | ソース抽出クエリとターゲット比較クエリの両方に適用される SQL 述語(WHERE キーワードなし)。sourceTable.whereClause と targetTable.whereClause で個別に設定することもできます。 |
skipRandomization |
false |
true の場合、ランダム関数で並べ替えるのではなく、自然なテーブル順序で最大 sampleSize 行を読み取り、大規模なテーブルでのクエリ費用を削減します。 |
maxConcurrency |
1 |
パーティション分割テーブルの並列スライス抽出スレッドの最大数。 |
maxSlices |
0(無制限) |
パーティション分割テーブルに許可されるパーティション スライスの最大数。計算されたスライス数が maxSlices を超えると(0 より大きい場合)、パーティション計画はエラーで失敗します。 |
disablePartitioning |
false |
true の場合、partitioning ブロックが構成されている場合や行数が 1000000 を超えている場合でも、テーブルのパーティション分割スライスが無効になります。 |
labels |
空の地図 | validation_results の検証実行指標に付加された Key-Value 文字列ラベル。 |
以降のセクションでは、これらの YAML キーを使用して検証実行をカスタマイズする方法について説明します。
検証戦略を選択する
テーブル エントリで strategy キーを使用して、--data 柱がどのように行を抽出して比較するかを制御する検証戦略を選択します。次の値を使用できます。
SMART(デフォルト): 最初にソーステーブルの行をカウントします。テーブルの行数が 100,000 未満の場合はBRUTE_FORCEを実行し、テーブルの行数が 100,000 以上の場合はSAMPLEを実行します。SAMPLE:sampleSizeの値(デフォルトは70,000)に基づいて行のランダム化されたサンプルを抽出し、comparisonKeysを使用してターゲット テーブルに結合します。70,000 行のサンプルでは、少なくとも 0.01% の行(10,000 行に 1 行)に不一致が含まれている場合、少なくとも 1 つの欠陥行を検出する信頼度が 99.9% を超えます。BRUTE_FORCE: 単一のパーティション分割されていないクエリパスですべての行を抽出して比較します。BRUTE_FORCEが使用されている場合、パーティショニング設定は無視されます。
比較用キーを構成する
比較キーは、ソースシステムとターゲット システム間で行を一意に識別して結合するために使用される列です。比較キーは、安定した結合に十分な一意性を提供する属性を記述します。
行レベルのデータ比較を実行する場合、次の方法で比較キーを構成できます。
- 自動検出:
sourceTableセクションからcomparisonKeysを省略すると、検証ツールは、プリフライト中にソース データベースの主キーを自動的に検出します(Oracle と Snowflake のNOT NULL一意制約、Teradata の一意インデックス、Amazon Redshift の単一列DISTKEYまたはSORTKEYにフォールバックします)。 手動の複合キーまたはカスタムキー:
sourceTableのcomparisonKeysにソースキー列名をリストして、複合比較キーまたはカスタム比較キーを手動で指定します。ソースとターゲットのキー列名の大文字と小文字の違いは自動的に照合されます。BigQuery で比較キー列の名前が変更された場合は、columnSettings.columns.SOURCE_COLUMN.targetColumnでマッピングします。次の例では、複合比較キーを構成しています。table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
一意のキーがないテーブルのハッシュ比較: テーブルに主キーがない場合は、
sourceTableでuseAllColumnsAsKey: trueを設定します。これは、プリフライト メタデータ検査で主キーが見つからない場合にも自動的に選択されます。
大規模なテーブルのパーティション分割抽出を構成する
テーブルの戦略が SAMPLE に解決され、partitioning ブロックがテーブル構成に存在する場合(generate-config はデフォルトで書き込みます)、またはテーブルの行数が 1,000,000 を超える場合、検証ツールはテーブルをスライスに分割します。これにより、サンプリング クエリはテーブル全体を一度に並べ替えるのではなく、制限された範囲をスキャンします。パーティション分割されている場合、スライスごとに最大 sampleSize 行が抽出されます。検証を行のサブセットに制限するには、代わりに whereClause を使用します。
パーティション分割抽出を構成するには、table: セクションの partitioning ブロックを使用します。次に例を示します。
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
partitioning ブロックは、次のフィールドをサポートしています。
type:INTEGER_RANGE: テーブルを数値の Key-Value 間隔(COLUMN BETWEEN START AND END)にスライスします。これがデフォルト値です。DATE_RANGE: テーブルを日付またはタイムスタンプの間隔にスライスします。PostgreSQL と Snowflake でサポートされています。PHYSICAL: 物理パーティション メタデータが存在する場合、Oracle テーブルと Amazon Redshift テーブルにデータベース パーティションを使用します。
column: スライス境界の計算に使用される、ソーステーブルのインデックス付きの数値、日付、またはタイムスタンプ列を指定します。パーティショニング列にNULL値を持つ行は、範囲ベースのスライス(INTEGER_RANGEとDATE_RANGE)から除外されます。partitionSize:INTEGER_RANGE型の場合、この値はスライスあたりの数値の Key-Value 範囲の幅を指定します。デフォルト値は1000000です。DATE_RANGEタイプの場合、この値はスライスあたりの日数を指定します。デフォルト値は30です。maxSlices: テーブルに許可されるスライスの最大合計数を指定します(table:で設定)。テーブルにmaxSlicesを超えるスライスが必要な場合、パーティション計画は失敗し、より大きなpartitionSizeまたはmaxSlicesを必要とするエラーが発生します。maxConcurrency: スライスの抽出に使用される並列ワーカー スレッドの数を指定します。デフォルト値は1です。table:で設定します。
集計チェックをカスタマイズする
集計分析はデフォルトで有効になっており、マクロレベルの集計チェックで行レベルのサンプリングを補完します。この構成は、ランダム サンプリングで微妙なデータスキューを見逃す可能性がある大規模なテーブルを検証する場合に役立ちます。
カスタム列の構成がない場合、検証ツールは列タイプに基づいて標準の集計チェックを自動的に適用します。
- 正確な数値(
INTEGER、NUMERIC、BIGNUMERIC):COUNT、SUM、AVG、MIN、MAX - 浮動小数点(
FLOAT、DOUBLE、REAL):COUNT、MIN、MAX - ブール値(
BOOLEAN):COUNT、COUNT_TRUE、COUNT_FALSE、COUNT_NULL - 文字列(
STRING、VARCHAR、CHAR、TEXT):COUNT、SUM_LENGTH - 日付、時刻、タイムスタンプ:
COUNT、MIN、MAX
集計チェックをカスタマイズまたは無効にするには、columnSettings セクションを使用します。次の例は、集計許容値を構成し、特定の列チェックをオーバーライドする方法を示しています。
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
次の集計構成ルールが適用されます。
columnSettings.columnsの列キーは、ソース列名と大文字と小文字を区別して一致する必要があります。- 集計
toleranceは絶対差のしきい値(ABS(target - source) <= tolerance)です。集計toleranceが設定されておらず(列レベルまたはcolumnSettings.aggregate.toleranceのいずれでも)、列に行レベルのtolerances.numeric設定がある場合、AVG、MIN、MAXはtolerances.numericを直接継承し、SUMは継承された行レベルの許容範囲にCOUNTを乗算します。 columnSettings.columns.SOURCE_COLUMN.aggregate.functionsの列ごとにfunctionsのみをオーバーライドできます。
列の除外、列名のマッピング、SQL 比較式の適用
columnSettings を使用すると、列の除外、数値または時間許容値の設定、名前変更されたターゲット列のマッピング、比較前の SQL 変換の適用を行うことができます。columnSettings.columns の各キーは、ソース列名です。BigQuery で列の名前が異なる場合は、そのエントリ内の targetColumn プロパティを使用します。次に例を示します。
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings は次のフィールドをサポートしています。
exclude: すべての検証の柱から除外する、大文字と小文字を区別しない列名または glob パターン(*)のリストを指定します。tolerances:numeric: 数値列の許容範囲(キーベースの比較の場合はABS(target - source) <= tolerance、useAllColumnsAsKey: trueの場合は小数点以下ceil(-log10(tolerance))桁に丸められます)。timestamp: タイムスタンプ列の許容範囲(秒単位)。たとえば、1 ミリ秒の場合は0.001です。date: 日付列の許容範囲(日数)。
columns: ソース列名(SOURCE_COLUMN)をキーとする列ごとの設定のマップ。targetColumn: ソース列を BigQuery の別の名前のターゲット列にマッピングします。transform: 比較前に適用される組み込み変換:TRIM、UPPER、LOWER: すべての言語でサポートされています。EMPTY_TO_NULL、NULL_TO_EMPTY、CAST_TO_STRING: PostgreSQL、Amazon Redshift、Oracle、Teradata ソースのソースクエリでサポートされています。
transformExpression: リテラル ソース列名を参照するカスタム SQL 式。例:"ROUND(SOURCE_COLUMN, 4)"。式はソースクエリと BigQuery 比較クエリの両方で評価されるため、ソース言語と GoogleSQL の両方で有効な SQL 関数を使用します。
値の正規化
行レベルの比較(--data)では、検証サービスは値を正規化して、ソースエンジンと BigQuery の表現の違いによって不一致が発生しないようにします。検証サービスは、次の方法で値を正規化します。
- 正確な数値型(
INTEGER、NUMERIC、DECIMAL、BIGNUMERIC): キーベースの比較では、値はフルスケールで比較されます(NUMERICの場合は小数点以下 9 桁まで、BIGNUMERICの場合は小数点以下 38 桁まで)。tolerances.numericが設定されている場合、ABS(target - source) <= toleranceのときに値が一致します。行全体のハッシュ比較(useAllColumnsAsKey: true)では、値はデフォルトで小数点以下 9 桁に丸められます。数値許容値が設定されている場合は、小数点以下ceil(-log10(tolerance))桁に丸められます。 - 浮動小数点型(
FLOAT、DOUBLE、REAL): デフォルトでは、小数点以下 6 桁(1e-6)に正規化されます。 - タイムスタンプ: マイクロ秒単位の精度で UTC に正規化されます。
- 固定幅文字型(
CHAR、NCHAR、CHARACTER): 先頭と末尾のスペースは、BigQuery のSTRINGセマンティクスに合わせて自動的にトリミングされます。
検証サービスを実行する
検証構成を設定したら、validate コマンドを実行して移行検証ツールを起動します。validation_config/ ディレクトリを指すローカルパスまたは Cloud Storage gs:// URI を渡すことができます。
次の例では、ローカルに保存されている検証構成ファイルに対して検証サービスを実行します。
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
PATH_TO_VALIDATION_CONFIG は、モジュラー validation_config/ ディレクトリのパスに置き換えます。
検証構成が Cloud Storage に保存されている場合は、構成ディレクトリの gs:// URI を渡します。
gcloud bq migration validate gs://BUCKET_NAME/validation_config
BUCKET_NAME は、Cloud Storage バケットの名前に置き換えてください。
デフォルトでは、検証サービスは、次の 3 つの検証の柱すべてにわたって検証サービスを実行します。
--schema: スキーマのみを検証します--aggregate: 集計のみを検証します--data: 行レベルのデータのみを検証します
検証サービスは、柱フラグを使用して特定の検証柱で実行できます。次の例では、カスタム WHERE フィルタを使用して、2 つの特定のテーブルに対してスキーマと集計の検証を実行します。
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
validate コマンドは、次のオプション フラグをサポートしています。
--tableまたは--tables: 検証するテーブル名のカンマ区切りのリスト。--tablesの照合では大文字と小文字が区別され、sourceTable.nameまたはtargetTable.nameで使用されている大文字と小文字が一致する必要があります。--where SQL_PREDICATE: この実行中に、ソーステーブルとターゲット テーブルの両方のwhereClauseをオーバーライドします。--source-where SQL_PREDICATE: ソーステーブルのwhereClauseのみをオーバーライドします。--target-where SQL_PREDICATE: ターゲット テーブルのwhereClauseのみをオーバーライドします。--gcs-path:googleCloudStorage.gcsPathをオーバーライドします。例:--gcs-path gs://my-bucket/validation--max-concurrency、--concurrency、--threads: 並列スライス抽出のmaxConcurrencyをオーバーライドします。--no-partitionまたは--disable-partitioning: 実行中のすべてのテーブルで、パーティション分割されたスライスの抽出を無効にします。--labels KEY=VALUE[,KEY=VALUE...]: 実行結果にカスタム Key-Value ラベルをアタッチします。--output-dir: 一時的な実行メタデータと状態ファイルのローカル ディレクトリ。デフォルト値は/tmp/validation_outputsです。-v、--verbose、-d、--debug: 詳細ログまたはデバッグログを有効にします。
非同期ワークフローの引き継ぎ
validate は、ソースの抽出を同期的に実行し、テーブルごとに非同期の BigQuery Migration Service ワークフローをトリガーします。
ターゲット データセットが
us以外のロケーション(euなど)にある場合は、validateを実行する前にBQMS_VALIDATION_LOCATION環境変数を設定します。export BQMS_VALIDATION_LOCATION=LOCATION
各テーブルについて、出力に作成されたワークフロー リソース名を含む
Workflow:行が含まれていることを確認します。次に例を示します。Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
終了コード
0は、ソースの抽出とアップロードが成功したことを示します。ターゲットの比較が完了したことや、データが一致したことを示すものではありません。権限がないなどの理由でワークフローの作成に失敗すると、CLI は検証ワークフローのトリガーに失敗したという警告をログに記録し、手動のgcloudフォールバック コマンドを出力します。プロセスが0で終了しても、Workflow:行は省略されます。
検証結果を表示する
検証の実行が完了したら、Google Cloud コンソールで検証結果を確認します。これには、結果データセット validation_results をクエリするか、settings.yaml の results で構成された BigQuery データセットをクエリするか、Cloud Storage の概要レポートを読み取ります。次のオプションのいずれかを選択します。
Google Cloud コンソール
Google Cloud コンソールの [移行サービス] ページに移動します。
[移行を検証] で [最近の移行を表示] をクリックします。
[プロジェクトを選択] をクリックし、
validation_resultsデータセットが保存されているプロジェクトを選択します。
GoogleSQL
TARGET_PROJECT_ID.validation_results.run_history をクエリして、最近の検証実行のステータスを確認します。
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
TARGET_PROJECT_ID は、validation_results データセットが保存されているプロジェクトの ID に置き換えます。
列ごとの詳細な指標と過去の傾向を確認するには、次のクエリを実行します。
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: 実行ごと、列ごとの不一致数、集計比較、合格または不合格のステータス<var>TARGET_PROJECT_ID</var>.validation_results.column_history: 実行全体にわたる縦方向の列監査履歴<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: ソース値とターゲット値が異なるサンプリングされた行と列
Cloud Storage レポート
完了した各実行では、次のレポート アーティファクトが実行の gcs_uri ディレクトリ(gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/)に書き込まれます。
validation_summary.txt: スキーマ、集計、行の比較結果のエグゼクティブ サマリーcolumn_details.txt:column_details.txt: 不一致と集計差分の列ごとの内訳results.json: すべての検証結果の構造化 JSON レポートqueries.sql: 検証実行中に実行された正確な SQL クエリ
実行の概要レポートを出力するには、次のコマンドを実行します。
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
検証結果を解釈する
validation_results.run_history での各検証実行では、次のいずれかの実行ステータス(status)値が報告されます。
| ステータス | 説明 | 推奨される対処方法 |
|---|---|---|
IN_PROGRESS |
検証ワークフローは BigQuery でまだ実行中です。 | finished_at が入力されるまで待ってから、run_history を再度クエリします。 |
COMPLETED |
検証パイプラインが完了し、行レベルのデータまたは集計の不一致はゼロでした。スキーマタイプの互換性の詳細は、validation_summary.txt と column_history に個別に記録されます。 |
対応は不要です。テーブルは検証に合格しました。 |
HEALED |
検証パイプラインは、欠落した行なしで完了しました。検出された値の違いはすべて、バリデータによって自動的に調整された微小な浮動小数点表現のジッター(セルレベルの比較では < 1e-4、集計では < 1e-6)でした。 |
合格した実行として扱われます。アップストリームのジッターを抑制する場合は、必要に応じて明示的な数値 tolerance を構成できます。 |
COMPLETED_WITH_MISMATCHES |
検証パイプラインが完全に実行され、ソーステーブルとターゲット テーブルの間で、欠落している行、欠落しているターゲット列、集計の違い、セルレベルのデータの違いが検出されました。これは、検証実行が完了したことを示しており、システム クラッシュではありません。 | column_details.txt、run_metrics、run_RUN_ID_mismatches_details を調べて、不一致の列と行を確認します。詳細については、列レベルの不一致タイプをご覧ください。 |
ERROR |
システムエラーまたは構成エラーのため、検証パイプラインを完了できませんでした。たとえば、ターゲット テーブルがない、権限エラー、カスタム whereClause または transformExpression の無効な SQL などが原因です。 |
run_history の error_message 列を確認します。一般的なエラーの解決方法については、トラブルシューティングをご覧ください。 |
列レベルの不一致タイプ
実行が COMPLETED_WITH_MISMATCHES で終了すると、実行ごとの不一致テーブルは、各列の比較を次のいずれかの結果に分類します。
EXACT_MATCH: 比較された列のセル値が、構成された許容範囲内で一致しましたDATA_DRIFT:comparisonKeysで一致した行。ただし、セル値が構成された許容範囲を超えて異なっています。SCHEMA: 列はソーステーブルに存在しますが、ターゲット テーブルに存在しません。ROW:comparisonKeysで結合したときに、ターゲット テーブルにソース行がないか、ソーステーブルにターゲット行がありません。
一般的なエラーのトラブルシューティング
次の表に、一般的なコマンドライン エラーとワークフロー エラー、およびその解決方法を示します。
| エラー メッセージまたは問題 | 原因 | 解決策 |
|---|---|---|
Failed to load or parse YAML |
テーブル、partitioning、columnSettings、googleCloudStorage ブロックに、認識されないキーまたは無効な列挙値(SAMPLE ではなく SAMPLING など)が含まれています。 |
YAML のインデントとフィールド名がテーブル設定オプションと一致していることを確認します。 |
Connection name '...' is invalid. Must be alphanumeric. |
connections: のプロファイル名にアンダースコアまたはハイフンが含まれています。例: my_source |
接続プロファイルの名前を英数字の名前(source や target など)に変更します。 |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath が validation_config/settings.yaml になく、--gcs-path が渡されませんでした。 |
validation_config/settings.yaml で、末尾にスラッシュを付けずに googleCloudStorage.gcsPath: gs://BUCKET/PREFIX を設定します。 |
Target discovery directory 'validation_config/' is non-empty |
validation_config/ に YAML ファイルがすでに含まれているときに、--update、--force、--clean を指定せずに generate-config が実行されました。 |
--update を渡して、既存の connections.yaml と settings.yaml を保持しながら、検出されたテーブルをマージします。 |
validate の実行時に tables is required |
tables: リストのない以前の validation-config.yaml ファイルが作業ディレクトリに存在し、validation_config/ よりも優先されるか、validation_config/ の下にテーブル YAML ファイルが存在しません。 |
validate が validation_config/ を読み込むように、作業ディレクトリ内の不要な validation-config.yaml ファイルを削除します。 |
| 単一の低カーディナリティ比較キーに関するプリフライト エラー | フィルタされた行が 1,000 行を超えるテーブルが、単一の低カーディナリティ比較キーで構成されているため、多対多の結合が急増します。 | comparisonKeys で一意の複合キーを形成するすべての列を指定するか、sourceTable で useAllColumnsAsKey: true を設定します。 |
Failed to initialize MemoryUtil または InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
JVM が Java 17 以降であり、--add-opens=java.base/java.nio=ALL-UNNAMED なしで起動された。通常、これはコマンドラインがカスタム ラッパーを介して、または java -jar を使用して直接起動されたことが原因です。 |
環境で JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" を設定するか、コマンド gcloud bq migration validate を使用します。 |
WARNING: Failed to trigger validation workflow |
ソースの抽出は成功しましたが、IAM 権限がない、API が有効になっていない、またはサポートされていないロケーションが原因で、CreateMigrationWorkflow の呼び出しに失敗しました。 |
bigquerymigration.googleapis.com が有効になっていること、アカウントに roles/bigquerymigration.editor があること、BQMS_VALIDATION_LOCATION がデータセットのロケーションと一致していることを確認します。 |
検証アーティファクトをクリーンアップする
検証結果を確認した後にストレージ費用を管理するには、次の操作を行います。
- Cloud Storage で、ステージング バケットの
gcsPath接頭辞の下にある古い実行ディレクトリを削除するか、バケットにオブジェクトのライフサイクル管理ルールを構成します。 - BigQuery では、結果データセット(デフォルトでは
validation_results)の実行ごとの比較テーブルは、resultTtlHours(デフォルトでは168.0時間、つまり 7 日間)後に自動的に期限切れになります。settings.yamlのresultTtlHoursを調整して保持期間を短縮または延長するか、共有履歴テーブルとビュー(run_history、run_metrics、column_history)をそのままにして、実行ごとのテーブルを手動で削除します。 - ローカル ファイルを操作する場合は、検証ツールによって
--output-dirに書き込まれたローカル作業ディレクトリを削除します。デフォルトのディレクトリは/tmp/validation_outputsです。
料金
検証サービスは、プロジェクトで次のリソースを使用します。
- BigQuery のコンピューティングとストレージ: ターゲット集計クエリ、行比較結合、
validation_resultsデータセット内のテーブルのストレージは、標準の BigQuery の料金に従って、 Google Cloud プロジェクトまたはbillingProjectId(target接続で構成されている場合)に課金されます。 - Cloud Storage のストレージとネットワーク: バケット内のステージングされた Parquet または CSV サンプル ファイルと結果レポートは、標準の Cloud Storage の料金に従って課金されます。
- ソース データベースの負荷: 抽出クエリはソース データベースに対して直接実行されます。大規模なソーステーブルの負荷を最小限に抑えるには、
strategy: SAMPLEを使用するか、whereClauseでフィルタするか、ランダムな並べ替えのオーバーヘッドが望ましくない場合はskipRandomization: trueを設定します。
次のステップ
dwh-migration-dumperツールを使用して変換と評価用のメタデータを生成する方法を学習する。- SQL クエリをバッチで変換して、ソース SQL スクリプトと DDL を GoogleSQL に変換します。
- 移行リネージを使用して移行を計画し、ソース データ ウェアハウスのデータの依存関係を可視化します。