


Data-Warehouse-Migration validieren
Mit dem Validierungsdienst des BigQuery-Migrationsdienstes können Sie prüfen, ob die aus Ihrem Quell-Data-Warehouse migrierten Tabellen mit Ihren Zieltabellen in BigQuery übereinstimmen. Sie können Schemas und Tabellendaten vergleichen, um Abweichungen während der Migration zu erkennen.
Der Validierungsdienst-Client stellt eine Verbindung zu Ihrer Quelldatenbank her und extrahiert das Quellschema und die Zeilendaten in einen Cloud Storage-Bucket, den Sie steuern. Nach der Extraktion vergleicht der Validierungsdienst das extrahierte Schema und die Daten im Cloud Storage-Bucket mit Ihren migrierten BigQuery-Tabellen.
In einem Validierungsworkflow werden Ihre Quelltabellen und BigQuery-Zieltabellen anhand von drei Validierungssäulen verglichen:
- Schemavalidierung (
--schema): Vergleicht Spaltennamen, Datentypen und Typkompatibilität zwischen Ihrer Quelltabelle und der BigQuery-Zieltabelle. - Aggregatvalidierung (
--aggregate): Berechnet und vergleicht aggregierte Messwerte auf Tabellen- und Spaltenebene, z. B. Zeilenanzahl,SUM,AVG,MIN,MAX, boolesche Verteilungen und Stringlängen, für die gesamte Tabelle. - Datenvalidierung (
--data): Führt einen zeilenweisen Vergleich durch, entweder mit einem vollständigen Tabellenscan (BRUTE_FORCE) oder einer zufälligen schlüsselbasierten Stichprobe (SAMPLE), um fehlende Zeilen und Wertabweichungen auf Zellebene zu erkennen.
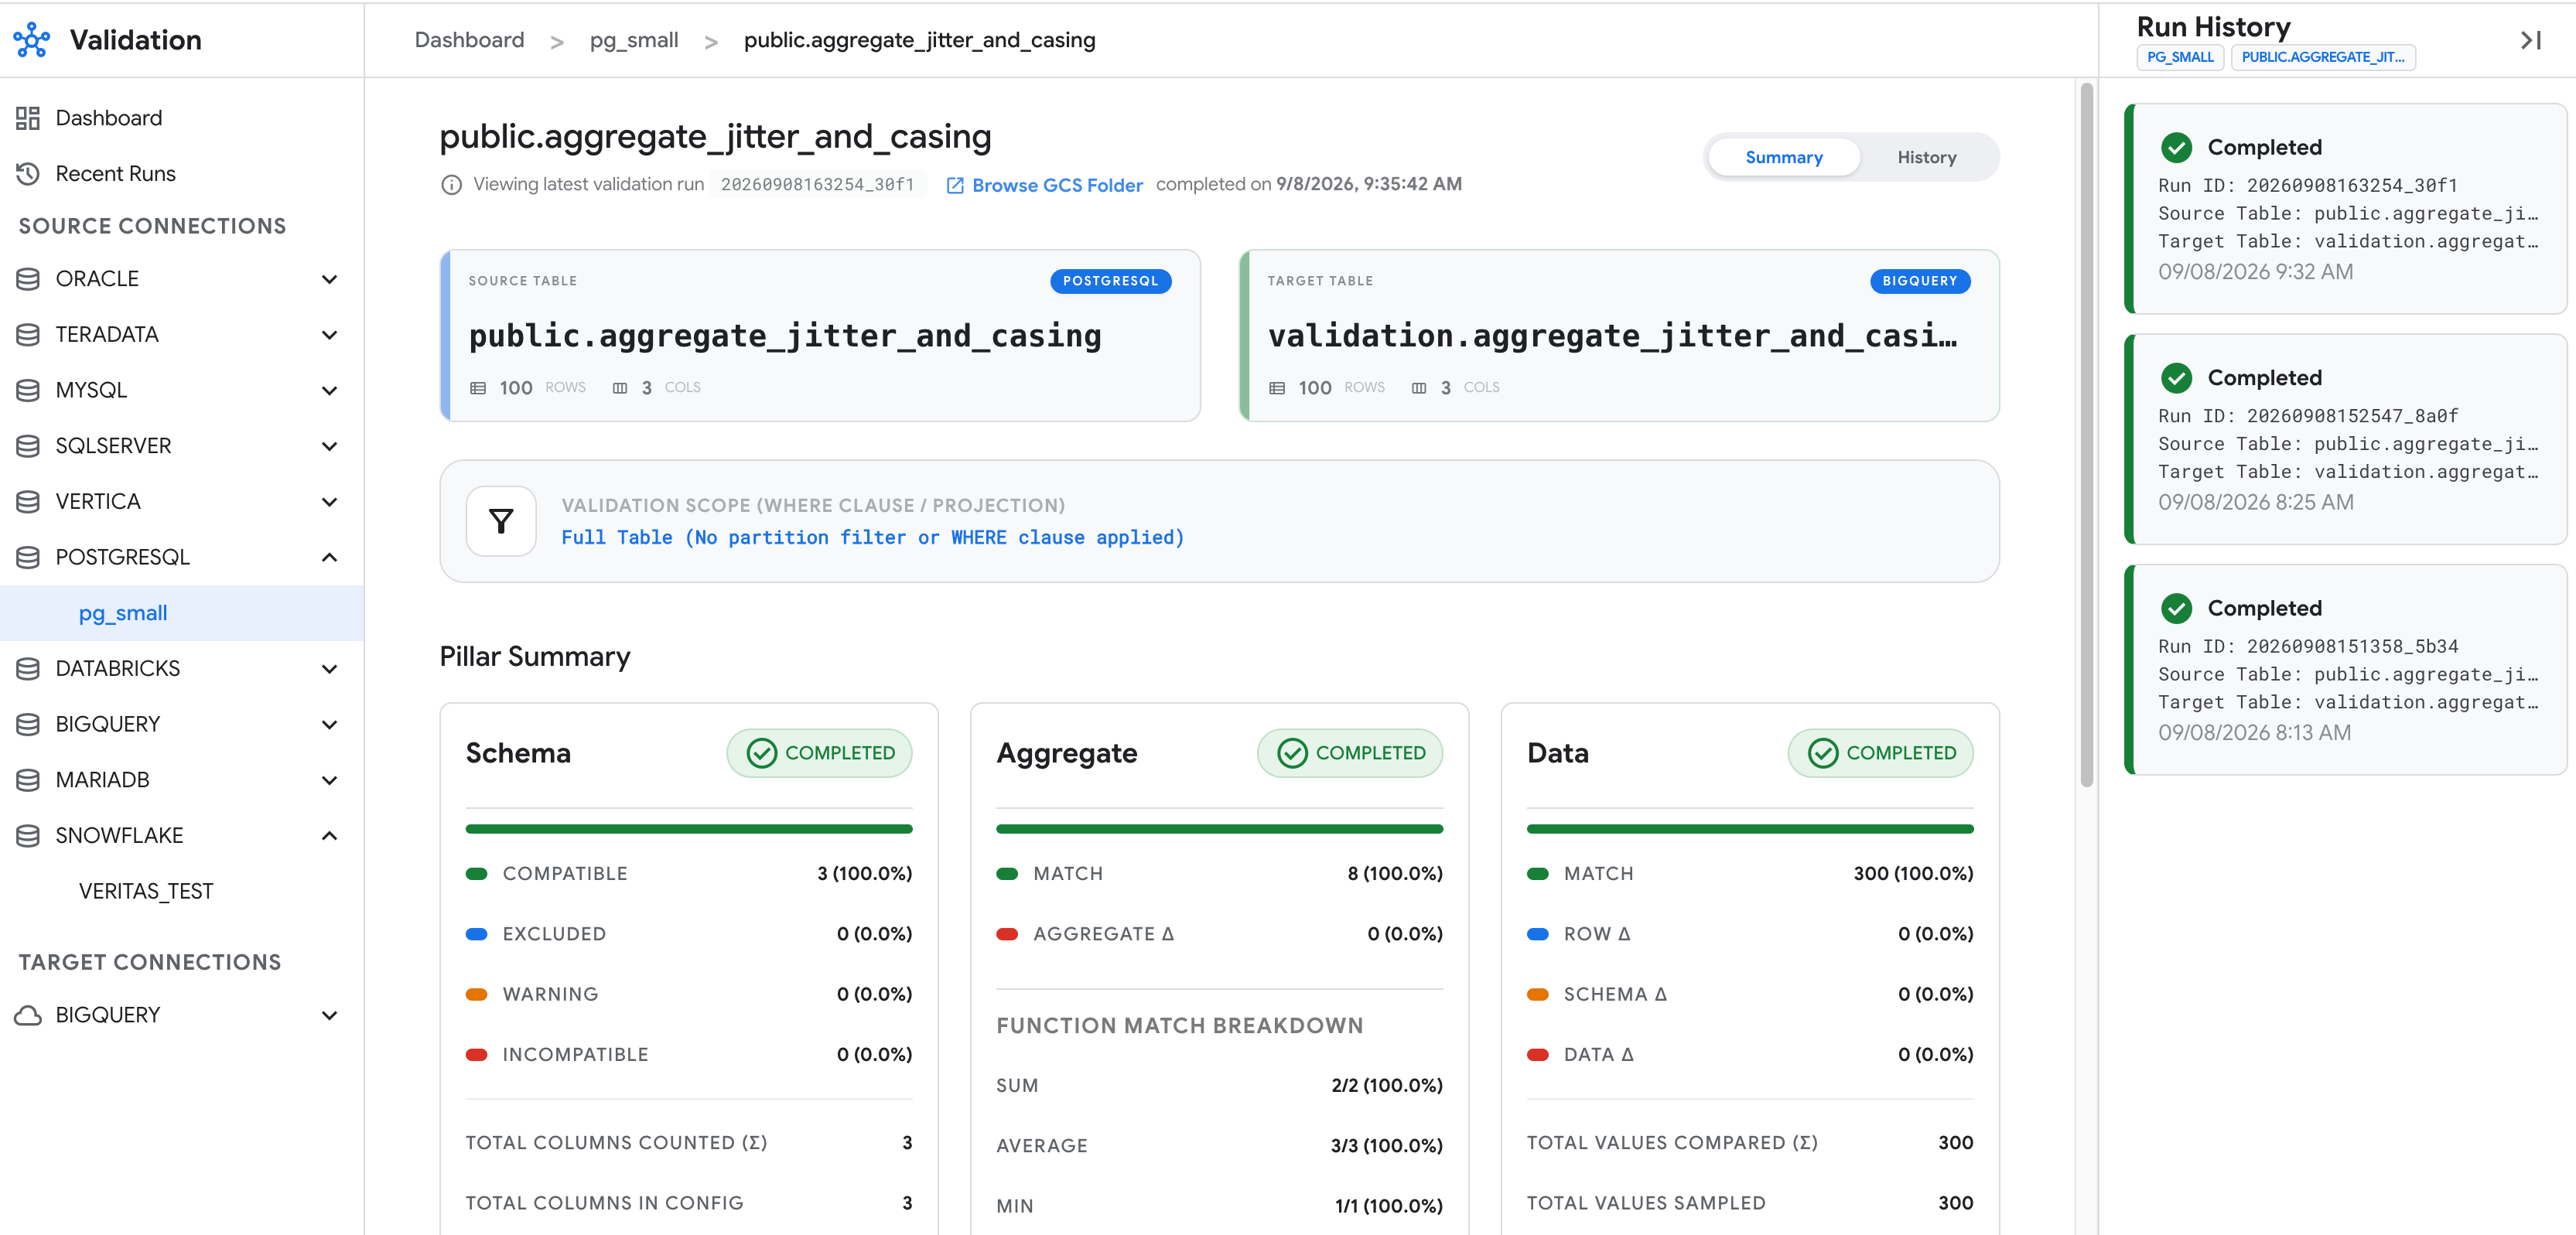
Unterstützte Standorte
Der Validierungsdienst ist an ausgewählten Standorten verfügbar. Weitere Informationen finden Sie unter Standorte des BigQuery-Migrationsdienstes.
Überlegungen zur Datenverarbeitung und -sicherheit
Der Validierungsdienst extrahiert und stellt je nach ausgeführter Validierungssäule unterschiedliche Daten bereit:
- Schemavalidierung (
--schema): Es werden nur Spaltennamen, Datentypen und Tabellenstatistiken in diesource_query_result.json-Datei hochgeladen, ohne dass Zellenwerte extrahiert werden. - Aggregatvalidierung (
--aggregate): Lädt berechnete aggregierte Messwerte in die Dateisource_aggregates.parquethoch, einschließlich der tatsächlichenMIN- undMAX-Zellenwerte aus den enthaltenen Spalten. - Datenvalidierung (
--data): Extrahiert unmaskierte Rohzellenwerte aus Stichprobenzeilen oder aus allen Zeilen, wenn die StrategieBRUTE_FORCEverwendet wird. Diese Werte werden im Apache Parquet- oder CSV-Format in Ihren Cloud Storage-Staging-Bucket hochgeladen und in das Datasetvalidation_resultsin BigQuery geladen.
Konfigurieren Sie die folgenden Einstellungen, um Ihre Daten zu schützen und Ihre Validierungsumgebung zu sichern:
- Vertrauliche Spalten ausschließen: Fügen Sie dem Feld
columnSettings.excludevertrauliche Spalten hinzu, um sie aus Abfragen zur Quellextraktion, Zielvergleichen und Validierungsberichten auszuschließen. - Lokale Datenspeicherung minimieren: Legen Sie das Feld
googleCloudStorage.gcsPathin der Dateisettings.yamlfest, um Stichprobenzeilen direkt in Cloud Storage zu streamen, ohne sie auf ein lokales Laufwerk zu schreiben. Löschen Sie auf freigegebenen Hosts nach jeder Ausführung das lokale Arbeitsverzeichnis--output-dir, um lokale Metadaten, Aggregat- und Logdateien zu entfernen. - Bereitgestellte Daten und Ergebnisse verschlüsseln: Konfigurieren Sie vor der Validierung kundenverwaltete Verschlüsselungsschlüssel (CMEK) mit Cloud Key Management Service für Ihren Cloud Storage-Staging-Bucket und Ihr BigQuery-Ergebnis-Dataset (standardmäßig
validation_resultsoder das im Feldresults.datasetangegebene Dataset). - Konfigurationszugriff einschränken: Speichern Sie Validierungskonfigurationsdateien in einem Repository mit Versionsverwaltung, für das eine Codeüberprüfung erforderlich ist, oder in einem Cloud Storage-Bucket, in dem nur vertrauenswürdige Nutzer die Berechtigung
storage.objects.createhaben. - Prinzip der geringsten Berechtigung erzwingen: Gewähren Sie dem Ersteller des Workflows die Rolle
roles/bigquery.dataViewernur für die Ziel-Datasets oder -Tabellen, die validiert werden, nicht für das Projekt. Verwenden Sie einen Quelldatenbanknutzer mit Lesezugriff, wie unter Berechtigungen für Quelldatenbank konfigurieren beschrieben.
Hinweis
Wählen Sie in der Google Cloud Console auf der Seite für die Projektauswahl ein Google Cloud -Projekt aus, das Ihre BigQuery-Zieldatasets enthält, oder erstellen Sie ein solches Projekt.
Prüfen Sie, ob die Abrechnung für Ihr Google Cloud -Projekt aktiviert ist.
Aktivieren Sie die BigQuery, BigQuery Migration Service, Cloud Storage und (wenn Sie Datenbankpasswörter in Secret Manager speichern) Secret Manager APIs.
Erstellen oder wählen Sie einen Cloud Storage-Bucket am selben Standort wie Ihr BigQuery-Ziel-Dataset aus, um extrahierte Metadaten und Datenstichproben bereitzustellen. Weitere Informationen finden Sie unter Bucket erstellen.
Erforderliche Rollen und Berechtigungen
Ein Validierungslauf besteht aus drei Teilen, die jeweils von einem anderen Hauptkonto ausgeführt werden können:
- Datenerhebung: Der Validierungsclient liest Ihre Quelldatenbank und lädt Metadaten, Aggregate und Stichprobenzeilen in Ihren Cloud Storage-Staging-Bucket hoch. BigQuery wird nicht aufgerufen.
- Validierung: Ein Validierungs-Workflow des BigQuery-Migrationsdienstes vergleicht die bereitgestellten Daten mit Ihren Zieltabellen. Der Workflow wird mit den Anmeldedaten des Hauptkontos ausgeführt, das ihn erstellt hat, unabhängig davon, ob es sich bei diesem Hauptkonto um den Validierungsclient,
gcloudoder die Google Cloud Console handelt. - Ergebnisse ansehen: Lesen des Ergebnis-Datasets und der Cloud Storage-Berichte.
generate-config benötigt keine Google Cloud Berechtigungen.
Datenerhebung
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erfassen von Quelldaten benötigen:
- Storage-Objekt-Ersteller (
roles/storage.objectCreator) für den Staging-Bucket - Storage Object Viewer (
roles/storage.objectViewer) für den Staging-Bucket -
Konfigurationsdateien aus Cloud Storage lesen:
Storage-Objekt-Betrachter (
roles/storage.objectViewer) für den Konfigurations-Bucket -
Datenbankpasswörter aus Secret Manager lesen:
Secret Manager Secret Accessor (
roles/secretmanager.secretAccessor) für das Secret
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erfassen von Quelldaten erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Quelldaten zu erfassen:
-
storage.objects.createfür den Staging-Bucket -
storage.objects.getfür den Staging-Bucket -
Konfigurationsdateien aus Cloud Storage lesen:
-
storage.objects.getfür den Konfigurations-Bucket -
storage.objects.listfür den Konfigurations-Bucket
-
-
Datenbankpasswörter aus Secret Manager lesen:
secretmanager.versions.accessfür das Secret
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Für die Datenerfassung mit --extract-only sind keine BigQuery- oder BigQuery Migration Service-Berechtigungen erforderlich. Ohne sie erstellt der Client auch die Validierungsworkflows und benötigt die Validierungsrollen.
Validierung
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen und Ausführen von Validierungsworkflows benötigen:
- MigrationWorkflow-Bearbeiter (
roles/bigquerymigration.editor) für das Projekt - BigQuery-Jobnutzer (
roles/bigquery.jobUser) für das Projekt - BigQuery-Datenbetrachter (
roles/bigquery.dataViewer) für jedes Ziel-Dataset - BigQuery Data Editor (
roles/bigquery.dataEditor) für das Ergebnis-Dataset - Storage-Objekt-Nutzer (
roles/storage.objectUser) für den Staging-Bucket -
Wenn das Ergebnis-Dataset nicht vorhanden ist:
BigQuery-Nutzer (
roles/bigquery.user) für das Projekt
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erstellen und Ausführen von Validierungsworkflows erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Validierungsworkflows zu erstellen und auszuführen:
bigquerymigration.workflows.createfür das Projektbigquerymigration.workflows.getfür das Projektbigquery.jobs.createfür das Projekt-
bigquery.tables.getfür jedes Ziel-Dataset -
bigquery.tables.getDatafür jedes Ziel-Dataset -
bigquery.datasets.getfür das Ergebnis-Dataset -
bigquery.tables.getfür das Ergebnis-Dataset -
bigquery.tables.createfür das Ergebnis-Dataset -
bigquery.tables.updatefür das Ergebnis-Dataset -
bigquery.tables.updateDatafür das Ergebnis-Dataset -
bigquery.tables.getDatafür das Ergebnis-Dataset -
storage.objects.getfür den Staging-Bucket -
storage.objects.createfür den Staging-Bucket -
storage.objects.deletefür den Staging-Bucket -
Wenn das Ergebnis-Dataset nicht vorhanden ist:
bigquery.datasets.createfür das Projekt
roles/bigquerymigration.editor enthält viele Berechtigungen, die bei der Validierung nicht verwendet werden. Weisen Sie für die geringste Berechtigung eine benutzerdefinierte Rolle mit nur bigquerymigration.workflows.create und bigquerymigration.workflows.get zu.
Bei der Validierung werden nur Ihre Zieltabellen gelesen und nur in das Ergebnis-Dataset geschrieben. Wir empfehlen, das Ergebnis-Dataset im Voraus zu erstellen, damit kein Hauptkonto die Berechtigung zum Erstellen von Datasets in Ihrem Projekt benötigt.
Ergebnisse ansehen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Aufrufen von Validierungsergebnissen benötigen:
- BigQuery-Jobnutzer (
roles/bigquery.jobUser) für das Projekt, das das Ergebnis-Dataset enthält - BigQuery Data Viewer (
roles/bigquery.dataViewer) für das Ergebnis-Dataset -
Berichte in Cloud Storage lesen:
Storage-Objekt-Betrachter (
roles/storage.objectViewer) für den Staging-Bucket -
Validierungs-Workflows in der Google Cloud Console auflisten und ansehen:
MigrationWorkflow-Betrachter (
roles/bigquerymigration.viewer) für das Projekt
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Aufrufen von Validierungsergebnissen erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Validierungsergebnisse aufzurufen:
bigquery.jobs.createfür das Projekt-
bigquery.tables.getfür das Ergebnis-Dataset -
bigquery.tables.getDatafür das Ergebnis-Dataset -
Berichte in Cloud Storage lesen:
-
storage.objects.getfür den Staging-Bucket -
storage.objects.listfür den Staging-Bucket
-
-
Validierungsworkflows in der Google Cloud Console auflisten und ansehen:
bigquerymigration.workflows.listfür das Projektbigquerymigration.workflows.getfür das Projekt
Berechtigungen für die Quelldatenbank konfigurieren
Sie müssen den Lesezugriff auf den Quelldatenbanknutzer mit den folgenden Berechtigungen konfigurieren:
- Berechtigung
SELECTfür jede zu validierende Quelltabelle. - Lesezugriff auf die Systemkatalogansichten, die für die Schema- und Primärschlüsselerkennung verwendet werden (z. B.
information_schema-Tabellen,ALL_CONSTRAINTSundALL_TAB_COLUMNSin Oracle oderSVV_COLUMNSundpg_attributein Amazon Redshift).
Gewähren Sie diesem Nutzer keine Schreib-, DDL- oder Administratorberechtigungen. Der Validierungsclient führt SQL aus Ihrer Validierungskonfiguration als dieser Nutzer aus. Weitere Informationen finden Sie unter Überlegungen zur Datenverarbeitung und Sicherheit.
Beschränkungen
Für den Validierungsdienst gelten die folgenden Einschränkungen:
- BigQuery ist die einzige unterstützte Zieldatenbank. Die Validierung zwischen zwei Nicht-BigQuery-Datenbanken oder die Verwendung von BigQuery als Validierungsquelle wird nicht unterstützt.
- Ihr BigQuery-Ziel-Dataset, das Ergebnis-Dataset (standardmäßig
validation_resultsoder das benutzerdefinierte Dataset, das unterresultsinsettings.yamlkonfiguriert ist), Ihr Cloud Storage-Staging-Bucket und der Standort des Validierungs-Workflows (BQMS_VALIDATION_LOCATION) müssen sich am selben Standort befinden. Wenn der Validierungsdienst das Ergebnis-Dataset erstellt, wird der Dataset-Standort standardmäßig auf die Region festgelegt, die von Ihrem Cloud Storage-Staging-Bucket und dem BigQuery-Ziel-Dataset verwendet wird, oder aufresults.location, wenn explizit festgelegt. - Die Unterstützung von Datentypen variiert je nach Quelle. Spalten mit nicht unterstützten Typen werden von der Validierung ausgeschlossen. Weitere Informationen finden Sie unter Unterstützte Data Warehouses.
- In BigQuery erstellte Vergleichstabellen pro Ausführung laufen automatisch gemäß
resultTtlHoursinsettings.yamlab. Der Standardwert ist168.0Stunden oder sieben Tage. Konfigurieren Sie für das Datasetvalidation_resultskeine Standardablaufzeit für Tabellen auf Dataset-Ebene, da dadurch auch langlebige Audit-Tabellen wierun_history,run_metricsundcolumn_historyablaufen. - Bei BigQuery-Tabellennamen wird zwischen Groß- und Kleinschreibung unterschieden. Wenn
generate-configKonfigurationen aus einemdwh-migration-dumper-Tool-Metadatenarchiv ohnetables.yaml-Übersetzungszuordnung erstellt, wird die Groß-/Kleinschreibung der Quell-ID in den Zieltabellennamen beibehalten. Beispiel: Tabellennamen in Großbuchstaben aus Oracle oder Snowflake. Prüfen Sie, obtargetTable.namegenau der Groß-/Kleinschreibung Ihrer Tabelle in BigQuery entspricht.
Unterstützte Data Warehouses
Der Validierungsdienst unterstützt die folgenden Quelldatenbanken. In jedem Abschnitt wird beschrieben, welcher JDBC-Treiber in der Installation enthalten ist, ob Sie Tabellenkonfigurationen automatisch aus einem Metadatenarchiv des dwh-migration-dumper-Tools generieren können, welche Partitionierungstypen für große Tabellen aus dieser Datenbank unterstützt werden und welche Datentypen für die Validierung unterstützt werden.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
Parametrisierte Varianten der unterstützten Datentypen wie VARCHAR(255) oder DECIMAL(10,2) werden ebenfalls unterstützt.
Der Validierungsdienst lädt alle JAR-Dateien im Verzeichnis drivers/ vor den automatisch heruntergeladenen Treibern. Sie können also auch drivers/ verwenden, um eine gebündelte Treiberversion zu überschreiben.
Wenn Sie automatisch eine Validierungskonfigurationsdatei generieren, werden Spalten mit nicht unterstützten Datentypen automatisch zu columnSettings.exclude hinzugefügt. Bei manuellen Konfigurationen müssen Sie sie explizit in columnSettings.exclude ausschließen.
Für die meisten unterstützten Quelldatenbanken lädt das Validierungstool den erforderlichen JDBC-Treiber bei der ersten Verwendung automatisch von Maven Central herunter, überprüft die SHA-256-Prüfsumme und speichert ihn lokal in ~/.cache/google-cloud-bqms/drivers/ (oder $XDG_CACHE_HOME/google-cloud-bqms/drivers/) im Cache. Gehen Sie bei Data Warehouses, die proprietäre Treiber verwenden, z. B. Teradata, oder bei der Ausführung in einer Offline- oder Air-Gap-Umgebung so vor:
- Legen Sie die erforderliche Treiber-JAR-Datei in
./drivers/,<sdk_root>/platform/bqms/drivers/oder dem Verzeichnis ab, das durch die UmgebungsvariableBQMS_DRIVER_DIRangegeben ist. Alle Treiber-JARs, die in diesen lokalen Verzeichnissen abgelegt werden, haben Vorrang vor automatischen Maven Central-Downloads. - Wenn Sie automatische Netzwerkdownloads in Umgebungen mit Air Gap vollständig deaktivieren möchten, legen Sie
BQMS_AUTO_DOWNLOAD_DRIVERS=falsefest oder legen SieBQMS_MAVEN_MIRRORso fest, dass es auf einen internen Maven-Repository-Spiegel verweist.
Wählen Sie eine der folgenden Optionen aus, um mehr über die einzelnen vom Validierungsdienst unterstützten Datenquellen zu erfahren:
Teradata
Validierungen für Teradata-Migrationen werden so unterstützt:
dialect-Wert:teradata- JDBC-Treiber: Vom Nutzer bereitgestellt. Laden Sie die JAR-Datei des Teradata-JDBC-Treibers, z. B.
terajdbc4.jaroderterajdbc.jar, von Teradata herunter und kopieren Sie sie in das Verzeichnisdrivers/oder das vonBQMS_DRIVER_DIRangegebene Verzeichnis. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector teradata) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE,PHYSICAL
| Kategorie | Datentypen |
|---|---|
| Numerisch | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| String | CHAR: CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| Datum und Uhrzeit | DATE: TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Beachten Sie bei der Validierung von Migrationen aus Teradata Folgendes:
- Wenn eine Tabelle keinen expliziten Primärschlüssel hat, werden Vergleichsschlüssel aus eindeutigen Primärindexen (
UPI) oder eindeutigen Sekundärindexen (USI) ermittelt. Nicht eindeutige Primärindexe (NUPI) werden nicht als Vergleichsschlüssel verwendet. NUMBER(P,S)mit fester Genauigkeit wird unterstützt. UnbeschränktesNUMBER(ohne Genauigkeit) wird nicht unterstützt. Unbeschränkte Spalten vom TypNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONundXMLwerden automatisch vongenerate-configausgeschlossen (oder müssen bei manuellen Konfigurationen incolumnSettings.excludeaufgeführt werden).CHAR-Spalten mit fester Breite werden automatisch gekürzt. Sowohl die ZeichensätzeLATINundUNICODEals auch die AttributeCASESPECIFICundNOT CASESPECIFICwerden unterstützt.TIME WITH TIME ZONE- undTIMESTAMP WITH TIME ZONE-Werte werden vor dem Vergleich auf UTC (AT 0) normalisiert.
Snowflake
Validierungen für Snowflake-Migrationen werden so unterstützt:
dialect-Wert:snowflake- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
net.snowflake:snowflake-jdbc) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector snowflake) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE,DATE_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für Snowflake-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| String | CHAR, VARCHAR, STRING, TEXT |
| Datum und Uhrzeit | DATE: TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| Boolesch | BOOLEAN |
Beachten Sie bei der Validierung von Migrationen von Snowflake Folgendes:
CHAR-Spalten mit fester Breite werden automatisch gekürzt.- Wenn Sie Daten mit BigQuery Data Transfer Service repliziert haben, legen Sie
tolerances.timestamp: 0.001fest, um Rundungen im Submillisekundenbereich zu berücksichtigen.
Amazon Redshift
Validierungen für Amazon Redshift-Migrationen werden so unterstützt:
dialect-Wert:redshift- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
com.amazon.redshift:redshift-jdbc42) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector redshift) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE,PHYSICAL
Der Validierungsdienst unterstützt die folgenden Datentypen für Amazon Redshift-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| String | CHAR, VARCHAR, TEXT |
| Datum und Uhrzeit | DATE: TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| Boolesch | BOOLEAN |
| Semistrukturiert | SUPER |
Beachten Sie bei der Validierung von Migrationen von Amazon Redshift Folgendes:
- Bei der Schemaprüfung wird
SVV_COLUMNSverwendet, sodass Ansichten mit später Bindung unterstützt werden. - Wenn eine Tabelle keinen Primärschlüssel hat, werden Vergleichsschlüssel automatisch auf eine einspaltige
DISTKEYoderSORTKEYzurückgesetzt. GEOMETRY-Spalten werden nicht unterstützt.
Databricks
Validierungen für Databricks-Migrationen werden so unterstützt:
dialect-Wert:databricks- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
com.databricks:databricks-jdbc) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationserstellung: Nicht unterstützt. Erstellen Sie eine manuelle Tabellenkonfigurationsdatei.
- Partitionierte Extraktion:
INTEGER_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für Databricks-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Datum und Uhrzeit | DATE, TIMESTAMP |
| Boolesch | BOOLEAN |
| Binär | BINARY |
| Komplex | ARRAY, MAP, STRUCT |
Beachten Sie bei der Validierung von Migrationen aus Databricks Folgendes:
- Mit einem persönlichen Zugriffstoken authentifizieren: Legen Sie
user: tokenfest und geben Sie das Token überpasswordSecretan. - Die Schemaprüfung ist abfragebasiert (
SELECT * ... WHERE 1=0), sodass sowohl Unity Catalog- als auch Hive-Metastore-Arbeitsbereiche unterstützt werden.
Apache Hive
Validierungen für Apache Hive-Migrationen werden so unterstützt:
dialect-Wert:hive- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (eigenständige JAR-Datei
org.apache.hive:hive-jdbc) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector hiveql) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für Hive-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Datum und Uhrzeit | DATE, TIMESTAMP |
| Boolesch | BOOLEAN |
| Binär | BINARY |
| Komplex | ARRAY, MAP, STRUCT |
Beachten Sie bei der Validierung von Migrationen aus Hive Folgendes:
- Die Schemaprüfung ist abfragebasiert (
SELECT * ... WHERE 1=0). - In Hive-Tabellen werden selten Primärschlüssel definiert. Bei Tabellen ohne Vergleichsschlüssel wird automatisch die Hash-Aggregation für die gesamte Zeile für die Datensäule verwendet.
SQL Server
Validierungen für SQL Server-Migrationen werden so unterstützt:
dialect-Wert:sqlserver- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
com.microsoft.sqlserver:mssql-jdbc) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector sqlserver) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für SQL Server-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| String | CHAR, VARCHAR, TEXT |
| Datum und Uhrzeit | DATE, DATETIME, TIMESTAMP |
| Boolesch | BIT |
Beachten Sie bei der Validierung von Migrationen von SQL Server Folgendes:
- Die Standard-JDBC-URL legt
encrypt=true;trustServerCertificate=true;fest. Überschreiben Sie ihn mit dem Verbindungsschlüsselurl, wenn Sie eine strenge TLS-Zertifikatsvalidierung benötigen.
MariaDB
Validierungen für MariaDB-Migrationen werden so unterstützt:
dialect-Wert:mariadb- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
org.mariadb.jdbc:mariadb-java-client) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Erstellen Sie eine manuelle Tabellenkonfigurationsdatei.
- Partitionierte Extraktion:
INTEGER_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für MariaDB-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Datum und Uhrzeit | DATE: TIME, DATETIME, TIMESTAMP, YEAR |
| Binäre und große Objekte | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
Prüfungen für MySQL-Migrationen werden so unterstützt:
dialect-Wert:mysql- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
com.mysql:mysql-connector-j) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Erstellen Sie eine manuelle Tabellenkonfigurationsdatei.
- Partitionierte Extraktion:
INTEGER_RANGE
Der Validierungsdienst unterstützt die folgenden Datentypen für MySQL-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | INT: BIGINT, DECIMAL, FLOAT, DOUBLE |
| String | CHAR, VARCHAR, TEXT |
| Datum und Uhrzeit | DATE, TIME, DATETIME, TIMESTAMP |
| Boolesch | BOOLEAN |
Oracle
Validierungen für Oracle-Migrationen werden so unterstützt:
dialect-Wert:oracle- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
com.oracle.database.jdbc:ojdbc11) oder vom Nutzer im Verzeichnisdrivers/für Offline-Umgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector oracle) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE,PHYSICAL
Der Validierungsdienst unterstützt die folgenden Datentypen für Oracle-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | NUMBER: NUMERIC, INTEGER, FLOAT, DOUBLE |
| String | CHAR: NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| Datum und Uhrzeit | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Binäre und große Objekte | RAW: BINARY, BLOB, CLOB, NCLOB |
Beachten Sie bei der Validierung von Migrationen von Oracle Folgendes:
DATE-Spalten enthalten in Oracle eine Zeitkomponente. Das Validierungstool extrahiert Oracle-DATE-Spalten mit Tagesgenauigkeit (YYYY-MM-DD), sodass Unterschiede bei der Tageszeit abgeschnitten werden.
PostgreSQL
Validierungen für PostgreSQL-Migrationen werden so unterstützt:
dialect-Wert:postgresql- JDBC-Treiber: Wird bei der ersten Verwendung automatisch heruntergeladen (
org.postgresql:postgresql) oder vom Nutzer im Verzeichnisdrivers/für Offlineumgebungen bereitgestellt. - Automatische Konfigurationsgenerierung: Wird aus einem
dwh-migration-dumper-Tool-Metadatenarchiv (--connector postgres) unterstützt. - Partitionierte Extraktion:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
Der Validierungsdienst unterstützt die folgenden Datentypen für PostgreSQL-Migrationen:
| Kategorie | Datentypen |
|---|---|
| Numerisch | SMALLINT: INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| String | CHAR: CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| Datum und Uhrzeit | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Boolesch | BOOLEAN |
| Sonstiges | UUID |
Beachten Sie bei der Validierung von Migrationen von PostgreSQL Folgendes:
BIGINT-Werte, die größer als 253 sind, können geringfügige Genauigkeitsunterschiede beiAVG()aufweisen.SUMundCOUNTbleiben genau.
Verzeichnis und Dateien für die Validierungskonfiguration einrichten
Der Validierungsdienst liest aus einem modularen Konfigurationsverzeichnis mit dem Namen validation_config/, das die folgenden Dateien enthält:
- Datei für Datenbankverbindungen: Definiert Ihr
source-Data-Warehouse-Verbindungsprofil und Ihrtarget-BigQuery-Verbindungsprofil. - Datei für Staging- und Ergebniseinstellungen: Definiert den Cloud Storage-Staging-Pfad (
googleCloudStorage), die Konfiguration des BigQuery-Ergebnis-Datasets (results), die Ablaufzeit der Vergleichstabelle pro Ausführung (resultTtlHours) und optionale globale Standardwerte (tolerances,aggregate,labels). - Konfigurationsdatei für die Tabellenvalidierung: enthält tabellenspezifische Zuordnungen (
sourceTableundtargetTable), Vergleichsschlüssel (comparisonKeys), Validierungsstrategie (strategy), Einstellungen für die partitionierte Extraktion (partitioning) und Spalteneinstellungen (columnSettings).
In den folgenden Abschnitten werden die Schritte zum Einrichten des Verzeichnisses für die Validierungskonfiguration und zum Erstellen der für eine Migrationsvalidierung erforderlichen Konfigurationsdateien beschrieben.
Verzeichnis für die Validierungskonfiguration erstellen
Erstellen Sie ein Verzeichnis für die Validierungskonfiguration mit dem Namen validation_config/, um Ihre Validierungskonfigurationsdateien zu speichern. Sie können dieses Verzeichnis auf dem Computer speichern, auf dem der Validierungsdienst ausgeführt wird, oder in einem Cloud Storage-Bucket, damit ein Team eine Konfiguration für mehrere Ausführungen freigeben kann.
Datei für Datenbankverbindungen erstellen
Erstellen Sie im Verzeichnis für die Validierungskonfiguration eine Datei mit dem Namen connections.yaml und konfigurieren Sie sie mit den Informationen, die für die Verbindung mit einer Quelldatenbank und einer BigQuery-Zieldatenbank erforderlich sind.
Jede Data-Warehouse-Quelle hat bestimmte Funktionen und Anforderungen, die beim Erstellen der Datenbankverbindungsdatei berücksichtigt werden müssen. Weitere Informationen zu den einzelnen Datenquellen finden Sie unter Unterstützte Data Warehouses.
Wenn Sie passwordSecret in einem Verbindungsprofil angeben, ruft der Validierungsdienst die Secret-Version aus Secret Manager auf dem Clientcomputer mithilfe Ihrer lokalen Standardanmeldedaten für Anwendungen (Application Default Credentials, ADC) ab und übergibt das aufgelöste Passwort direkt an den lokalen JDBC-Treiber. Ihre Quelldatenbank benötigt keinen Netzwerk- oder IAM-Zugriff auf Google Cloud. Daher funktioniertpasswordSecret für lokale Datenbanken und Datenbanken, die in anderen Clouds gehostet werden, z. B. Amazon Redshift oder Snowflake. Alternativ können Sie passwordSecret weglassen und die Umgebungsvariable BQMS_VALIDATION_SOURCE_PASSWORD auf dem Computer festlegen, auf dem der Validierungsdienst ausgeführt wird.
Wählen Sie eine der folgenden Optionen aus, um eine Datenbankverbindungsdatei für ein Data Warehouse zu erstellen:
Teradata
Konfigurieren Sie für Teradata-Migrationsprüfungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse Ihres Teradata-Systems.SOURCE_DATABASE: der erforderliche Teradata-Datenbankname.SOURCE_USER: der Teradata-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Snowflake
Konfigurieren Sie für Snowflake-Migrationsprüfungen Ihre Datenbankverbindungsdatei mit den folgenden Informationen:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SNOWFLAKE_ACCOUNT: Ihre Snowflake-Konto-ID (z. B.myorg-myaccount).SNOWFLAKE_WAREHOUSE: das virtuelle Warehouse, das zum Ausführen von Extraktionsabfragen verwendet wird.SOURCE_DATABASE: der erforderliche Snowflake-Datenbankname.SOURCE_SCHEMA: der erforderliche Snowflake-Schemaname.SNOWFLAKE_ROLE: optionale Snowflake-Rolle.SOURCE_USER: der Snowflake-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Amazon Redshift
Konfigurieren Sie für Amazon Redshift-Migrationsprüfungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname Ihres Amazon Redshift-Clusterendpunkts.SOURCE_DATABASE: der erforderliche Name der Amazon Redshift-Datenbank.SOURCE_SCHEMA: der Standard-Schemaname (wenn nicht angegeben, wird standardmäßigpublicverwendet).SOURCE_USER: der Datenbanknutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Databricks
Konfigurieren Sie für Databricks-Migrationsvalidierungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
DATABRICKS_HOST: der Serverhostname Ihres Databricks SQL-Warehouse oder -Clusters.HTTP_PATH: der HTTP-Pfad Ihres Databricks SQL-Warehouse (z. B.sql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: der erforderliche Unity-Katalogname (oderhive_metastore).SCHEMA_NAME: der erforderliche Schemaname.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die Ihr persönliches Databricks-Zugriffstoken (PAT) enthalten, oder lassen SiepasswordSecretweg und legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest. Wenn Sieuser: tokenmitpasswordSecretverwenden, wird Ihr Token nie in Staging-Metadatendateien geschrieben.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Apache Hive
Konfigurieren Sie für Apache Hive-Migrationsvalidierungen Ihre Datenbankverbindungsdatei mit den folgenden Informationen:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der HiveServer2-Hostname oder die IP-Adresse.SOURCE_DATABASE: der erforderliche Hive-Datenbankname (z. B.default).SOURCE_USER: der Hive-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
SQL Server
Konfigurieren Sie für SQL Server-Migrationsprüfungen Ihre Datenbankverbindungsdatei mit den folgenden Informationen:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse Ihrer SQL Server-Instanz (optionalinstanceNamefür benannte Instanzen angeben).SOURCE_DATABASE: der erforderliche Datenbankname.SOURCE_SCHEMA: der Standard-Schemaname (wenn nicht angegeben, wird standardmäßigdboverwendet).SOURCE_USER: der Datenbanknutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
MariaDB
Konfigurieren Sie für MariaDB-Migrationsprüfungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse des MariaDB-Servers.SOURCE_DATABASE: der erforderliche MariaDB-Datenbankname.SOURCE_USER: der MariaDB-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
MySQL
Konfigurieren Sie für MySQL-Migrationsprüfungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse des MySQL-Servers.SOURCE_DATABASE: der erforderliche MySQL-Datenbankname.SOURCE_USER: der MySQL-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Passwort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Oracle
Konfigurieren Sie für Oracle-Migrationsprüfungen Ihre Datenbankverbindungsdatei mit den folgenden Informationen:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse des Oracle-Servers.SERVICE_NAME: der Oracle-Dienstname (wird zum Erstellen vonjdbc:oracle:thin:@//HOST:PORT/SERVICE_NAMEverwendet). Geben Sie für benutzerdefinierte TNS- oder SID-Verbindungen stattdessenurlmit der vollständigen JDBC-URL an.SOURCE_SCHEMA: optionaler Standardschemaname.SOURCE_USER: der erforderliche Oracle-Nutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Datenbankpasswort enthalten, oder legen SieBQMS_VALIDATION_SOURCE_PASSWORDfest.TARGET_PROJECT_ID: die Projekt-ID des Ziels Google Cloud.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
PostgreSQL
Konfigurieren Sie für PostgreSQL-Migrationsprüfungen die Datei mit den Datenbankverbindungen mit den folgenden Informationen:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ersetzen Sie Folgendes:
SOURCE_HOST: der Hostname oder die IP-Adresse Ihres PostgreSQL-Servers.SOURCE_DATABASE: der erforderliche PostgreSQL-Datenbankname.SOURCE_SCHEMA: der Standard-Schemaname (wenn nicht angegeben, wird standardmäßigpublicverwendet).SOURCE_USER: der Datenbanknutzername.SECRET_PROJECT_IDundSECRET_ID: die Projekt-ID und die Secret-ID in Secret Manager, die das Datenbankpasswort enthalten. Alternativ können SiepasswordSecretweglassen und die UmgebungsvariableBQMS_VALIDATION_SOURCE_PASSWORDfestlegen.TARGET_PROJECT_ID: die Projekt-ID in Google Cloud , die Ihre migrierten BigQuery-Tabellen enthält und in der das Datasetvalidation_resultserstellt wird.TARGET_DATASET: der Name des BigQuery-Ziel-Datasets.
Einstellungsdatei erstellen
Erstellen Sie im Verzeichnis für die Validierungskonfiguration eine Datei für die Staging- und Ergebniseinstellungen mit dem Namen settings.yaml, um den Cloud Storage-Staging-Pfad, das BigQuery-Ergebnis-Dataset, den Ablauf von Tabellen pro Ausführung und optionale globale Standardwerte zu konfigurieren.
Konfigurieren Sie die Datei mit den Einstellungen für die Bereitstellung und die Ergebnisse mit den folgenden Angaben:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Ersetzen Sie Folgendes:
BUCKET_NAME: der Name Ihres Cloud Storage-Staging-Buckets.PATH_PREFIX: das Cloud Storage-URI-Präfix im Bucket, das zum Bereitstellen extrahierter Schemametadaten, aggregierter Messwerte, Stichprobenzeilen und Zusammenfassungsberichte verwendet wird.FORMAT: das Dateiformat für bereitgestellte Datenstichproben. Unterstützte Werte sindparquet(Standard) undcsv.RESULTS_PROJECT_ID: die Google Cloud Projekt-ID, in die Validierungsergebnisse und Tabellen mit dem Ausführungsverlauf geschrieben werden. Wenn keine Angabe gemacht wird, wird standardmäßigtarget.projectIdausconnections.yamlverwendet.RESULTS_DATASET: der Name des BigQuery-Datasets, in das Validierungsergebnisse und Tabellen mit dem Ausführungsverlauf (run_history,run_metricsundcolumn_history) geschrieben werden. Wenn keine Angabe gemacht wird, lautet die Standardeinstellungvalidation_results. Wenn das Dataset nicht vorhanden ist, wird es vom Validierungsdienst automatisch erstellt.RESULTS_LOCATION: der BigQuery-Standort für das Ergebnis-Dataset. Wenn Sie nichts angeben, wird standardmäßig ein automatisch erstelltes Ergebnis-Dataset in der Region Ihres Cloud Storage-Staging-Buckets und des BigQuery-Ziel-Datasets verwendet.RESULT_TTL_HOURS: Gültigkeitsdauer in Stunden für die im Ergebnis-Dataset erstellten Vergleichs- und Abweichungstabellen pro Ausführung. Der Standardwert ist168.0Stunden (7 Tage). Langlebige Beobachtbarkeitstabellen (run_history,run_metricsundcolumn_history) sind vonresultTtlHoursnicht betroffen.RESULTS_CONFIG: Konfiguriert das BigQuery-Ziel-Dataset für Vergleichsergebnisse und den Prüfverlauf. Unterstützte Werte sindprojectId,datasetundlocation. Wenn Sie diesen Wert weglassen, schreibt der Validierungsdienst inTARGET_PROJECT_ID.validation_results` und erstellt das Dataset automatisch in derselben Region wie Ihr Ziel-Dataset und Ihr Cloud Storage-Staging-Bucket, falls es noch nicht vorhanden ist.
Sie können auch globale Tabellenstandardwerte angeben, indem Sie tolerances, aggregate oder labels auf der obersten Ebene von settings.yaml oder validation-config.yaml angeben. Diese Standardeinstellungen gelten für alle Tabellen, sofern sie nicht in einer einzelnen Tabellenkonfiguration überschrieben werden.
Konfigurationen für die Tabellenvalidierung generieren
Nachdem Sie die Verbindungen und Einstellungsdateien konfiguriert haben, definieren Sie die Konfigurationen für die Tabellenvalidierung. Der Befehl generate-config schreibt eine YAML-Datei pro Tabelle unter validation_config/databases/DATABASE/SCHEMA/TABLE.yaml mit einem table:-Schlüssel auf oberster Ebene. Alternativ können Sie eine manuelle validation_config/tables.yaml-Datei erstellen.
Wählen Sie eine der folgenden Optionen aus, um Informationen zum Generieren von Tabellenvalidierungskonfigurationen für Ihre Quelldatenbank zu erhalten:
Teradata
Führen Sie für Teradata-Migrationsvalidierungen die folgenden Schritte aus, um ein Metadatenarchiv des dwh-migration-dumper-Tools für Ihre Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
Snowflake
Gehen Sie bei Snowflake-Migrationsvalidierungen so vor, um ein dwh-migration-dumper-Tool-Metadatenarchiv Ihrer Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei aus dem Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quell-Clustering-Schlüsseln (für partitionierte Tabellen ohne Primärschlüssel), Metadaten für physische Partitionen und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
Amazon Redshift
Führen Sie für Amazon Redshift-Migrationsvalidierungen die folgenden Schritte aus, um ein Metadaten-ZIP-Archiv Ihrer Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
Databricks
Die automatische Konfigurationserstellung wird für Databricks nicht unterstützt. Erstellen Sie manuell eine tables.yaml-Datei im Verzeichnis validation_config/ mit den folgenden Konfigurationen:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Führen Sie für Apache Hive-Migrationsvalidierungen die folgenden Schritte aus, um ein Metadaten-ZIP-Archiv Ihrer Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
SQL Server
Gehen Sie für SQL Server-Migrationsvalidierungen so vor, um ein Metadatenarchiv des dwh-migration-dumper-Tools für Ihre Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
MariaDB
Die automatische Konfigurationserstellung wird für MariaDB nicht unterstützt. Erstellen Sie manuell eine tables.yaml-Datei im Verzeichnis validation_config/ mit den folgenden Konfigurationen:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
Die automatische Konfigurationserstellung wird für MySQL nicht unterstützt. Erstellen Sie manuell eine tables.yaml-Datei im Verzeichnis validation_config/ mit den folgenden Konfigurationen:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Führen Sie für Oracle-Migrationsvalidierungen die folgenden Schritte aus, um ein Metadatenarchiv des dwh-migration-dumper-Tools für Ihre Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
PostgreSQL
Führen Sie für PostgreSQL-Migrationsvalidierungen die folgenden Schritte aus, um ein dwh-migration-dumper-Tool-Metadatenarchiv Ihrer Quellschemas zu generieren:
- Installieren Sie das
dwh-migration-dumper-Tool. - Führen Sie
dwh-migration-dumperfür Ihre Quelldatenbank aus, um ein Metadatenarchiv für dasdwh-migration-dumper-Tool zu erstellen.
Führen Sie mit dem Metadatenarchiv generate-config aus, um tabellenspezifische Konfigurationsdateien zu generieren. Mit dem Flag --update können Sie Ihre vorhandenen connections.yaml- und settings.yaml-Dateien beibehalten, die Sie in validation_config/ erstellt haben. Beispiel:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Wenn Sie auch eine tables.yaml-Schemazuordnungsdatei vom Batch-SQL-Übersetzer haben, fügen Sie das Flag --tables-yaml entweder allein oder zusammen mit --metadata ein, um übersetzte Tabellenzuordnungen mit Quellpartitionsmetadaten und Datentypausschlüssen aus dem Metadatenarchiv zu ergänzen. Beispiel:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Der Befehl generate-config unterstützt die folgenden Flags:
--metadata PATH_TO_METADATA_ZIP: der Pfad zu einem Metadatenarchiv desdwh-migration-dumper-Tools (ZIP-Datei) oder zu einem Verzeichnis mit Metadatenarchiven.--tables-yaml PATH_TO_TABLES_YAML: der Pfad zu einer oder mehreren Übersetzungsdateien oder -verzeichnissen vontables.yaml(kommagetrennt).--target-dataset TARGET_DATASET: der Name des BigQuery-Ziel-Datasets, der den generiertentargetTable.name-Einträgen vorangestellt werden soll.-o, --output-dir DIRECTORY: das Ausgabeverzeichnis für modulare Konfigurationsdateien. Der Standardwert istvalidation_config.--schemas SCHEMA_LIST: Durch Kommas getrennte Liste der einzuschließenden Quellschemas oder ‑datenbanken (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--tables TABLE_LIST: durch Kommas getrennte Liste von Tabellennamen (TABLE,SCHEMA.TABLEoderDB.SCHEMA.TABLE), die einbezogen werden sollen (Groß-/Kleinschreibung beachten; unterstützt*-Platzhalter).--filter-file PATH: Pfad zu einer durch Zeilenumbrüche getrennten Datei mit Tabellennamen, die einbezogen werden sollen (Zeilen, die mit#beginnen, werden ignoriert).--update: Zusammenführen der erkannten Tabellen in ein vorhandenesvalidation_config/-Verzeichnis, wobei die vorhandenenconnections.yaml-,settings.yaml- und benutzerdefinierten Überschreibungen pro Tabelle beibehalten werden.--force: Ermöglicht das Schreiben neu erkannter Tabellendateien in ein nicht leeres Ausgabeverzeichnis, während vorhandene Tabellenkonfigurationsdateien beibehalten werden.--clean: Löscht alle vorhandenen Dateien im Ausgabeverzeichnis, bevor neu gefundene Dateien geschrieben werden.
Tabelleneinstellungen anpassen
Jede von generate-config generierte Tabellendatei enthält einen table:-Abschnitt, den Sie vor der Validierung anpassen können. In der folgenden Tabelle sind alle optionalen Schlüssel aufgeführt, die für die einzelnen Tabelleneinträge unterstützt werden.
| Optionaler YAML-Schlüssel | Standardwert | Beschreibung |
|---|---|---|
runSchema, runAggregate, runData |
true |
Boolesche Werte pro Tabelle, um einzelne Validierungssäulen zu aktivieren oder zu deaktivieren, wenn keine Befehlszeilen-Flags für Säulen übergeben werden. |
maxColumnsPerTile |
100 |
Maximale Anzahl von Spalten, die in breiten Tabellen in einer einzelnen Vergleichskachel gruppiert werden. |
strategy |
SMART |
Ausführungsstrategie für die Datenvalidierung: SMART (BRUTE_FORCE bei weniger als 100.000 Zeilen, sonst SAMPLE), SAMPLE oder BRUTE_FORCE. |
sampleSize |
70000 |
Anzahl der zu extrahierenden Zeilen (pro Slice, wenn partitioniert), wenn die aufgelöste Strategie SAMPLE ist. Der Standardwert von 70.000 Zeilen bietet eine Wahrscheinlichkeit von über 99,9 %, dass mindestens eine nicht übereinstimmende Zeile erkannt wird, wenn die Fehllieferungsquote 0,01 % (1 von 10.000 Zeilen) oder höher ist. |
whereClause |
Keine | SQL-Prädikat (ohne das Schlüsselwort WHERE), das sowohl auf die Quell- als auch auf die Zielvergleichsabfragen angewendet wird. Kann auch separat für sourceTable.whereClause und targetTable.whereClause festgelegt werden. |
skipRandomization |
false |
Wenn true, werden bis zu sampleSize Zeilen in der natürlichen Tabellenreihenfolge gelesen, anstatt nach einer Zufallsfunktion zu sortieren. Dadurch werden die Abfragekosten für große Tabellen reduziert. |
maxConcurrency |
1 |
Maximale Anzahl paralleler Slice-Extraktions-Threads für eine partitionierte Tabelle. |
maxSlices |
0 (unbegrenzt) |
Maximale Anzahl von Partitionsslices, die für eine partitionierte Tabelle zulässig sind. Wenn die berechnete Anzahl von Slices maxSlices überschreitet (wenn größer als 0), schlägt die Partitionsplanung mit einem Fehler fehl. |
disablePartitioning |
false |
Wenn true, wird das partitionierte Slicing für die Tabelle deaktiviert, auch wenn ein partitioning-Block konfiguriert ist oder die Zeilenanzahl 1000000 überschreitet. |
labels |
Leere Karte | Schlüssel/Wert-Stringlabels, die an die Messwerte des Validierungslaufs in validation_results angehängt sind. |
In den folgenden Abschnitten wird beschrieben, wie Sie diese YAML-Schlüssel verwenden können, um Ihre Validierungsläufe anzupassen.
Validierungsstrategie auswählen
Verwenden Sie den Schlüssel strategy für einen Tabelleneintrag, um eine Validierungsstrategie auszuwählen, die steuert, wie die Säule --data Zeilen extrahiert und vergleicht. Folgende Werte werden unterstützt:
SMART(Standard): Zählt zuerst die Zeilen in der Quelltabelle. Wenn die Tabelle weniger als 100.000 Zeilen enthält, wirdBRUTE_FORCEausgeführt. Wenn die Tabelle 100.000 Zeilen oder mehr enthält, wirdSAMPLEausgeführt.SAMPLE: Extrahiert eine zufällige Stichprobe von Zeilen basierend auf dem Wert vonsampleSize(Standardwert ist70,000) und verknüpft sie mit der Zieltabelle mithilfe voncomparisonKeys. Eine Stichprobe von 70.000 Zeilen bietet eine Wahrscheinlichkeit von mehr als 99,9 %, mindestens eine fehlerhafte Zeile zu finden, wenn mindestens 0,01 % der Zeilen (1 von 10.000) eine Abweichung enthalten.BRUTE_FORCE: Extrahiert und vergleicht jede Zeile in einem einzelnen nicht partitionierten Abfragedurchlauf. Partitionierungseinstellungen werden ignoriert, wennBRUTE_FORCEverwendet wird.
Vergleichsschlüssel konfigurieren
Ein Vergleichsschlüssel ist die Spalte oder die Spalten, die verwendet werden, um Zeilen zwischen dem Quell- und dem Zielsystem eindeutig zu identifizieren und zu verknüpfen. Der Vergleichsschlüssel beschreibt die Attribute, die für eine stabile Verknüpfung ausreichend eindeutig sind.
Beim Ausführen eines Datenvergleichs auf Zeilenebene können Sie Vergleichsschlüssel auf folgende Weise konfigurieren:
- Automatische Erkennung: Lassen Sie
comparisonKeysim AbschnittsourceTableweg, damit das Validierungstool während der Preflight-Prüfung automatisch Primärschlüssel in Ihrer Quelldatenbank erkennt. Dabei wird aufNOT NULL-Eindeutigkeitseinschränkungen in Oracle und Snowflake, eindeutige Indexe in Teradata oder eine einspaltigeDISTKEYoderSORTKEYin Amazon Redshift zurückgegriffen. Manuelle zusammengesetzte oder benutzerdefinierte Schlüssel: Geben Sie zusammengesetzte oder benutzerdefinierte Vergleichsschlüssel manuell an, indem Sie die Spaltennamen der Quellschlüssel in
comparisonKeysuntersourceTableauflisten. Unterschiede bei der Groß-/Kleinschreibung zwischen den Spaltennamen der Quell- und Zielschlüssel werden automatisch abgeglichen. Wenn eine Vergleichsschlüsselspalte in BigQuery umbenannt wurde, ordnen Sie sie untercolumnSettings.columns.SOURCE_COLUMN.targetColumnzu. Im folgenden Beispiel wird ein zusammengesetzter Vergleichsschlüssel konfiguriert:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Hash-Vergleich für Tabellen ohne eindeutigen Schlüssel: Wenn eine Tabelle keinen Primärschlüssel hat, legen Sie unter
sourceTableden WertuseAllColumnsAsKey: truefest. Diese Option wird auch automatisch ausgewählt, wenn bei der Preflight-Metadatenprüfung keine Primärschlüssel gefunden werden.
Partitionierte Extraktion für große Tabellen konfigurieren
Wenn die Strategie einer Tabelle zu SAMPLE aufgelöst wird und entweder ein partitioning-Block in der Tabellenkonfiguration vorhanden ist (der standardmäßig generate-config schreibt) oder die Zeilenanzahl der Tabelle 1,000,000 überschreitet, teilt das Validierungstool die Tabelle in Slices auf, sodass Stichprobenabfragen begrenzte Bereiche scannen, anstatt die gesamte Tabelle auf einmal zu sortieren. Bei der Partitionierung werden bis zu sampleSize Zeilen pro Slice extrahiert. Wenn Sie die Validierung auf eine Teilmenge von Zeilen beschränken möchten, verwenden Sie stattdessen whereClause.
Verwenden Sie den Block partitioning im Abschnitt table:, um die partitionierte Extraktion zu konfigurieren. Beispiel:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
Der Block partitioning unterstützt die folgenden Felder:
type:INTEGER_RANGE: Teilt die Tabelle in numerische Schlüssel/Wert-Intervalle (COLUMN BETWEEN START AND END) auf. Dies ist der Standardwert.DATE_RANGE: Teilt die Tabelle in Datums- oder Zeitstempelintervalle auf. Unterstützt für PostgreSQL und Snowflake.PHYSICAL: Verwendet Datenbankpartitionen für Oracle- und Amazon Redshift-Tabellen, wenn Metadaten für physische Partitionen vorhanden sind.
column: Gibt eine indexierte numerische, Datums- oder Zeitstempelspalte in der Quelltabelle an, die zum Berechnen von Slice-Grenzen verwendet wird. Zeilen mitNULL-Werten in der Partitionierungsspalte werden von bereichsbasierten Slices (INTEGER_RANGEundDATE_RANGE) ausgeschlossen.partitionSize: Für den TypINTEGER_RANGEgibt dieser Wert die Breite des numerischen Schlüssel/Wert-Bereichs pro Slice an. Der Standardwert ist1000000. Für den TypDATE_RANGEgibt dieser Wert die Anzahl der Tage pro Slice an. Der Standardwert ist30.maxSlices: Gibt die maximal zulässige Gesamtzahl von Slices für die Tabelle an (festgelegt untertable:). Wenn eine Tabelle mehr Slices alsmaxSliceserfordert, schlägt die Partitionsplanung mit einem Fehler fehl, der einen größerenpartitionSizeodermaxSliceserfordert.maxConcurrency: Gibt die Anzahl der parallelen Arbeitsthreads an, die zum Extrahieren von Slices verwendet werden. Der Standardwert ist1. Untertable:festgelegt.
Zusammengefasste Prüfungen anpassen
Die aggregierte Analyse ist standardmäßig aktiviert und ergänzt die Stichprobenerhebung auf Zeilenebene durch aggregierte Prüfungen auf Makroebene. Diese Konfiguration ist nützlich, um große Tabellen zu validieren, bei denen durch Zufallsstichproben möglicherweise subtile Datenverzerrungen übersehen werden.
Ohne benutzerdefinierte Spaltenkonfigurationen wendet das Validierungstool automatisch Standardprüfungen für Aggregationen basierend auf den Spaltentypen an:
- Exakte numerische Werte (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - Gleitkomma (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - Boolescher Wert (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - String (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - Datum, Uhrzeit und Zeitstempel:
COUNT,MIN,MAX
Im Abschnitt columnSettings können Sie die aggregierten Prüfungen anpassen oder deaktivieren. Im folgenden Beispiel wird gezeigt, wie Sie aggregierte Toleranzen konfigurieren und bestimmte Spaltenprüfungen überschreiben:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
Es gelten die folgenden Regeln für die Aggregatkonfiguration:
- Spaltenschlüssel unter
columnSettings.columnsmüssen mit dem Namen der Quellspalte übereinstimmen (Groß-/Kleinschreibung beachten). - Das Aggregat
toleranceist ein absoluter Differenzschwellenwert (ABS(target - source) <= tolerance). Wenn kein Aggregattolerancefestgelegt ist (weder auf Spaltenebene noch aufcolumnSettings.aggregate.tolerance) und die Spalte einetolerances.numeric-Einstellung auf Zeilenebene hat, übernehmenAVG,MINundMAXtolerances.numericdirekt, währendSUMdie übernommene Toleranz auf Zeilenebene mitCOUNTmultipliziert. - Sie können
functionsnur pro Spalte untercolumnSettings.columns.SOURCE_COLUMN.aggregate.functionsüberschreiben.
Spalten ausschließen, Spaltennamen zuordnen und SQL-Vergleichsausdrücke anwenden
Mit columnSettings können Sie Spalten ausschließen, numerische oder zeitliche Toleranzen festlegen, umbenannte Zielspalten zuordnen oder SQL-Transformationen vor dem Vergleich anwenden. Jeder Schlüssel unter columnSettings.columns ist der Name der Quellspalte. Verwenden Sie das Attribut targetColumn in diesem Eintrag, wenn die Spalte in BigQuery einen anderen Namen hat. Beispiel:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings unterstützt die folgenden Felder:
exclude: Geben Sie eine Liste von Spaltennamen ohne Berücksichtigung der Groß-/Kleinschreibung oder Glob-Muster (*) an, die von allen Validierungssäulen ausgeschlossen werden sollen.tolerances:numeric: Toleranz für numerische Spalten (ABS(target - source) <= tolerancefür schlüsselbasierten Vergleich oder gerundet aufceil(-log10(tolerance))Dezimalstellen, wennuseAllColumnsAsKey: true).timestamp: Toleranz in Sekunden für Zeitstempelspalten. Beispiel:0.001für 1 Millisekunde.date: Toleranz in Tagen für Datumsspalten.
columns: Zuordnung der spaltenspezifischen Einstellungen, die nach dem Namen der Quellspalte (SOURCE_COLUMN) sortiert sind:targetColumn: Ordnet die Quellspalte einer Zielspalte mit einem anderen Namen in BigQuery zu.transform: Integrierte Transformation, die vor dem Vergleich angewendet wird:TRIM,UPPER,LOWER: werden in allen Dialekten unterstützt.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: Unterstützt für Quellabfragen für PostgreSQL-, Amazon Redshift-, Oracle- und Teradata-Quellen.
transformExpression: benutzerdefinierter SQL-Ausdruck, der auf den literalen Namen der Quellspalte verweist. Beispiel:"ROUND(SOURCE_COLUMN, 4)". Da der Ausdruck sowohl für die Quellabfrage als auch für die BigQuery-Vergleichsabfrage ausgewertet wird, sollten Sie SQL-Funktionen verwenden, die sowohl in Ihrem Quelldialekt als auch in GoogleSQL gültig sind.
Wertnormalisierung
Beim Vergleich auf Zeilenebene (--data) normalisiert der Validierungsdienst die Werte, damit Unterschiede in der Darstellung zwischen Quell-Engines und BigQuery nicht zu Abweichungen führen. Der Validierungsdienst normalisiert Werte auf folgende Weise:
- Exakte numerische Typen (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): Beim schlüsselbasierten Vergleich werden Werte in voller Größe verglichen (bis zu 9 Dezimalstellen fürNUMERICoder bis zu 38 Dezimalstellen fürBIGNUMERIC). Wenntolerances.numericfestgelegt ist, stimmen die Werte überein, wennABS(target - source) <= tolerancegilt. Beim Hash-Vergleich für ganze Zeilen (useAllColumnsAsKey: true) werden Werte standardmäßig auf 9 Dezimalstellen gerundet, oder aufceil(-log10(tolerance))Dezimalstellen, wenn eine numerische Toleranz festgelegt ist. - Gleitkommatypen (
FLOAT,DOUBLE,REAL): standardmäßig auf 6 Dezimalstellen (1e-6) normalisiert. - Zeitstempel: auf UTC mit Mikrosekundengenauigkeit normalisiert.
- Zeichentypen mit fester Breite (
CHAR,NCHAR,CHARACTER): Führende und nachgestellte Leerzeichen werden automatisch gekürzt, um der BigQuery-SemantikSTRINGzu entsprechen.
Validierungsdienst ausführen
Nachdem Sie die Validierungskonfiguration eingerichtet haben, führen Sie den Befehl validate aus, um das Tool zur Migrationsvalidierung zu starten. Sie können einen lokalen Pfad oder einen Cloud Storage-gs://-URI übergeben, der auf das Verzeichnis validation_config/ verweist.
Im folgenden Beispiel wird der Validierungsdienst für lokal gespeicherte Konfigurationsdateien ausgeführt:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Ersetzen Sie PATH_TO_VALIDATION_CONFIG durch den Pfad zu Ihrem modularen validation_config/-Verzeichnis.
Wenn Ihre Validierungskonfiguration in Cloud Storage gespeichert ist, übergeben Sie den gs://-URI des Konfigurationsverzeichnisses:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Ersetzen Sie BUCKET_NAME dabei durch den Namen des Cloud Storage-Buckets.
Standardmäßig führt der Validierungsdienst die Validierung für alle drei Validierungssäulen aus:
--schema: validiert nur das Schema--aggregate: validiert nur das Aggregat--data: validiert nur Daten auf Zeilenebene
Sie können den Validierungsdienst für eine bestimmte Validierungssäule ausführen, indem Sie die Säulen-Flags verwenden. Im folgenden Beispiel wird die Schema- und Aggregatvalidierung für zwei bestimmte Tabellen mit einem benutzerdefinierten WHERE-Filter ausgeführt:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
Der Befehl validate unterstützt die folgenden optionalen Flags:
--tableoder--tables: durch Kommas getrennte Liste der zu validierenden Tabellennamen. Beim Abgleich von--tableswird zwischen Groß- und Kleinschreibung unterschieden. Die Schreibweise muss mit der insourceTable.nameodertargetTable.nameverwendeten Schreibweise übereinstimmen.--where SQL_PREDICATE: ÜberschreibtwhereClausesowohl für Quell- als auch für Zieltabellen während dieser Ausführung.--source-where SQL_PREDICATE: ÜberschreibtwhereClausenur für die Quelltabelle.--target-where SQL_PREDICATE: ÜberschreibtwhereClausenur für die Zieltabelle.--gcs-path: überschreibtgoogleCloudStorage.gcsPath. Beispiel:--gcs-path gs://my-bucket/validation--max-concurrency,--concurrencyoder--threads: ÜberschreibtmaxConcurrencyfür die parallele Slice-Extraktion.--no-partitionoder--disable-partitioning: Deaktiviert die Extraktion partitionierter Slices für alle Tabellen in der Ausführung.--labels KEY=VALUE[,KEY=VALUE...]: Hängt benutzerdefinierte Schlüssel/Wert-Labels an die Ausführungsergebnisse an.--output-dir: Lokales Verzeichnis für temporäre Ausführungsmetadaten und Statusdateien. Der Standardwert ist/tmp/validation_outputs.-v,--verbose,-doder--debug: Aktiviert das ausführliche Logging oder das Debugging-Logging.
Asynchrone Workflow-Übergabe
validate führt die Quellextraktion synchron aus und löst dann für jede Tabelle einen asynchronen BigQuery Migration Service-Workflow aus.
Wenn sich Ihr Ziel-Dataset an einem anderen Standort als
usbefindet, z. B.eu, legen Sie die UmgebungsvariableBQMS_VALIDATION_LOCATIONfest, bevor Sievalidateausführen:export BQMS_VALIDATION_LOCATION=LOCATION
Prüfen Sie für jede Tabelle, ob die Ausgabe eine
Workflow:-Zeile mit dem Namen der erstellten Workflowressource enthält. Beispiel:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
Der Exit-Code
0gibt an, dass die Extraktion und der Upload der Quelle erfolgreich waren, nicht, dass der Zielvergleich abgeschlossen ist oder dass die Daten übereinstimmen. Wenn die Workflowerstellung fehlschlägt, z. B. aufgrund einer fehlenden Berechtigung, protokolliert die Befehlszeile eine Warnung, dass das Auslösen des Validierungsworkflows fehlgeschlagen ist, gibt einen manuellengcloud-Fallback-Befehl aus und lässt die ZeileWorkflow:weg, obwohl der Prozess mit0beendet wird.
Validierungsergebnisse ansehen
Nach Abschluss des Validierungslaufs können Sie die Validierungsergebnisse in derGoogle Cloud -Konsole aufrufen. Fragen Sie dazu das Ergebnis-Dataset validation_results ab, fragen Sie das unter results in settings.yaml konfigurierte BigQuery-Dataset ab oder lesen Sie die Zusammenfassungsberichte in Cloud Storage. Wählen Sie eine der folgenden Optionen aus:
Google Cloud Console
Rufen Sie in der Google Cloud Console die Seite Migrationsdienste auf.
Klicken Sie unter Migration validieren auf Letzte ansehen.
Klicken Sie auf Projekt auswählen und wählen Sie das Projekt aus, in dem das Dataset
validation_resultsgespeichert ist.
GoogleSQL
Fragen Sie TARGET_PROJECT_ID.validation_results.run_history ab, um den Status der letzten Validierungsläufe zu prüfen:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Ersetzen Sie TARGET_PROJECT_ID durch die ID des Projekts, in dem das Dataset validation_results gespeichert ist.
Wenn Sie detaillierte Messwerte pro Spalte und historische Trends abrufen möchten, führen Sie die folgende Abfrage aus:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: Anzahl der Abweichungen pro Ausführung und Spalte, aggregierte Vergleiche und Status „Bestanden“ oder „Fehlgeschlagen“<var>TARGET_PROJECT_ID</var>.validation_results.column_history: Audit-Verlauf der Spalte über mehrere Ausführungen hinweg<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: Stichprobenzeilen und ‑spalten, in denen sich Quell- und Zielwerte unterschieden haben
Cloud Storage-Berichte
Bei jeder abgeschlossenen Ausführung werden die folgenden Berichtsarfakte in das Verzeichnis gcs_uri der Ausführung (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/) geschrieben:
validation_summary.txt: Zusammenfassung der Ergebnisse des Schema-, Aggregat- und Zeilenvergleichscolumn_details.txt: Aufschlüsselung der Abweichungen und aggregierten Unterschiede nach Spaltenresults.json: Strukturierter JSON-Bericht aller Validierungsergebnissequeries.sql: die genauen SQL-Abfragen, die während der Validierung ausgeführt wurden
Führen Sie den folgenden Befehl aus, um den Zusammenfassungsbericht für eine Ausführung auszugeben:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Validierungsergebnisse interpretieren
Bei jeder Validierungsausführung in validation_results.run_history wird einer der folgenden Ausführungsstatuswerte oder status-Werte gemeldet:
| Status | Beschreibung | Empfohlene Maßnahmen |
|---|---|---|
IN_PROGRESS |
Der Validierungsworkflow wird noch in BigQuery ausgeführt. | Warten Sie, bis finished_at ausgefüllt ist, und fragen Sie dann run_history noch einmal ab. |
COMPLETED |
Die Validierungspipeline wurde ohne Abweichungen bei Daten auf Zeilenebene oder Aggregaten abgeschlossen. Die Details zur Kompatibilität des Schematyps werden separat in validation_summary.txt und column_history aufgezeichnet. |
Es sind keine weiteren Schritte erforderlich. Die Tabelle wurde validiert. |
HEALED |
Die Validierungspipeline wurde ohne fehlende Zeilen abgeschlossen. Alle erkannten Wertunterschiede waren minimale Abweichungen bei der Gleitkommadarstellung (< 1e-4 für Vergleiche auf Zellebene und < 1e-6 für Aggregate), die vom Validator automatisch abgeglichen wurden. |
Wird als bestandener Lauf behandelt. Optional können Sie einen expliziten numerischen tolerance konfigurieren, wenn Sie Jitter vorgelagert unterdrücken möchten. |
COMPLETED_WITH_MISMATCHES |
Die Validierungspipeline wurde vollständig ausgeführt und hat fehlende Zeilen, fehlende Zielspalten, aggregierte Unterschiede oder Datenunterschiede auf Zellebene zwischen den Quell- und Zieltabellen gefunden. Dies weist auf einen abgeschlossenen Validierungslauf hin, nicht auf einen Systemabsturz. | Prüfen Sie column_details.txt, run_metrics und run_RUN_ID_mismatches_details, um die nicht übereinstimmenden Spalten und Zeilen zu sehen. Weitere Informationen finden Sie unter Nichtübereinstimmungstypen auf Spaltenebene. |
ERROR |
Die Validierungspipeline konnte aufgrund eines System- oder Konfigurationsfehlers nicht abgeschlossen werden. Beispielsweise aufgrund einer fehlenden Zieltabelle, eines Berechtigungsfehlers oder eines ungültigen SQL-Codes in einem benutzerdefinierten whereClause oder transformExpression. |
Sehen Sie sich die Spalte error_message in run_history an. Weitere Informationen zum Beheben häufiger Fehler finden Sie unter Fehlerbehebung. |
Arten von Abweichungen auf Spaltenebene
Wenn eine Ausführung mit COMPLETED_WITH_MISMATCHES abgeschlossen wird, wird jeder Spaltenvergleich in den Tabellen mit Abweichungen pro Ausführung mit einem der folgenden Ergebnisse klassifiziert:
EXACT_MATCH: Die verglichenen Zellenwerte für die Spalte stimmen innerhalb der konfigurierten Toleranzen überein.DATA_DRIFT: Zeilen stimmten beicomparisonKeysüberein, aber die Zellenwerte unterschieden sich über die konfigurierte Toleranz hinausSCHEMA: Die Spalte ist in der Quelltabelle vorhanden, fehlt aber in der Zieltabelle.ROW: Quellzeilen fehlten in der Zieltabelle oder Zielzeilen fehlten in der Quelltabelle, wenn sie mitcomparisonKeysverknüpft wurden.
Häufige Fehler beheben
In der folgenden Tabelle sind häufige Befehlszeilen- und Workflowfehler sowie deren Behebung aufgeführt:
| Fehlermeldung oder Problem | Ursache | Lösung |
|---|---|---|
Failed to load or parse YAML |
Ein partitioning-, columnSettings- oder googleCloudStorage-Block enthält einen nicht erkannten Schlüssel oder einen ungültigen Enum-Wert, z. B. SAMPLING anstelle von SAMPLE. |
Prüfen Sie die YAML-Einrückung und die Feldnamen anhand der Optionen für Tabelleneinstellungen. |
Connection name '...' is invalid. Must be alphanumeric. |
Ein Profilname unter connections: enthält Unterstriche oder Bindestriche. Beispiel: my_source. |
Benennen Sie die Verbindungsprofile in alphanumerische Namen wie source und target um. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath fehlt in validation_config/settings.yaml und --gcs-path wurde nicht übergeben. |
Legen Sie googleCloudStorage.gcsPath: gs://BUCKET/PREFIX ohne abschließenden Schrägstrich in validation_config/settings.yaml fest. |
Target discovery directory 'validation_config/' is non-empty |
generate-config wurde ohne --update, --force oder --clean ausgeführt, obwohl validation_config/ bereits YAML-Dateien enthielt. |
Übergeben Sie --update, um erkannte Tabellen zusammenzuführen und gleichzeitig Ihre vorhandenen connections.yaml und settings.yaml beizubehalten. |
tables is required beim Ausführen von validate |
Im Arbeitsverzeichnis ist eine Legacy-validation-config.yaml-Datei ohne tables:-Liste vorhanden, die Vorrang vor validation_config/ hat, oder unter validation_config/ sind keine YAML-Dateien für Tabellen vorhanden. |
Löschen Sie alle verbleibenden validation-config.yaml-Dateien in Ihrem Arbeitsverzeichnis, damit validate die Datei validation_config/ lädt. |
| Preflight-Fehler bei einem einzelnen Vergleichsschlüssel mit niedriger Kardinalität | Eine Tabelle mit mehr als 1.000 gefilterten Zeilen ist mit einem einzelnen Vergleichsschlüssel mit geringer Kardinalität konfiguriert, was zu einer Many-to-Many-Join-Explosion führen würde. | Geben Sie alle Spalten an, die einen eindeutigen zusammengesetzten Schlüssel in comparisonKeys bilden, oder legen Sie useAllColumnsAsKey: true unter sourceTable fest. |
Failed to initialize MemoryUtil oder InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
Die JVM ist Java 17 oder höher und wurde ohne --add-opens=java.base/java.nio=ALL-UNNAMED gestartet, in der Regel, weil die Befehlszeile über einen benutzerdefinierten Wrapper oder direkt mit java -jar gestartet wurde. |
Legen Sie JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" in der Umgebung fest oder verwenden Sie den Befehl gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
Die Quellextraktion war erfolgreich, aber der Aufruf von CreateMigrationWorkflow ist aufgrund fehlender IAM-Berechtigungen, einer nicht aktivierten API oder eines nicht unterstützten Standorts fehlgeschlagen. |
Prüfen Sie, ob bigquerymigration.googleapis.com aktiviert ist, Ihr Konto roles/bigquerymigration.editor hat und BQMS_VALIDATION_LOCATION mit dem Standort Ihres Datasets übereinstimmt. |
Validierungsartefakte bereinigen
So verwalten Sie die Speicherkosten, nachdem Sie die Validierungsergebnisse überprüft haben:
- Löschen Sie in Cloud Storage alte Ausführungsverzeichnisse unter dem Präfix
gcsPathin Ihrem Staging-Bucket oder konfigurieren Sie eine Regel für die Verwaltung des Objektlebenszyklus für den Bucket. - In BigQuery laufen die Vergleichstabellen pro Ausführung in Ihrem Ergebnis-Dataset (standardmäßig
validation_results) automatisch nachresultTtlHours(standardmäßig168.0Stunden oder 7 Tage) ab. Passen SieresultTtlHoursinsettings.yamlan, um die Aufbewahrungsdauer zu verkürzen oder zu verlängern, oder löschen Sie die Tabellen pro Ausführung manuell, während die freigegebenen Verlaufstabellen und Ansichten (run_history,run_metricsundcolumn_history) intakt bleiben. - Wenn Sie mit lokalen Dateien arbeiten, entfernen Sie das lokale Arbeitsverzeichnis, das vom Validierungstool unter
--output-dirgeschrieben wurde. Das Standardverzeichnis ist/tmp/validation_outputs.
Preise
Der Validierungsdienst verwendet die folgenden Ressourcen in Ihrem Projekt:
- BigQuery-Computing und -Speicher: Zielaggregatabfragen, Zeilenvergleichs-Joins und Speicher für Tabellen im Dataset
validation_resultswerden Ihrem Projekt Google Cloud oderbillingProjectIdin Rechnung gestellt, wenn dies für die Verbindungtargetkonfiguriert ist, gemäß den standardmäßigen BigQuery-Preisen. - Cloud Storage-Speicher und -Netzwerk: Bereitgestellte Parquet- oder CSV-Beispieldateien und Ergebnisberichte in Ihrem Bucket werden gemäß den standardmäßigen Cloud Storage-Preisen abgerechnet.
- Quelldatenbanklast: Extraktionsabfragen werden direkt in der Quelldatenbank ausgeführt. Wenn Sie die Last auf großen Quelltabellen minimieren möchten, verwenden Sie
strategy: SAMPLE, filtern Sie mitwhereClauseoder legen SieskipRandomization: truefest, wenn der Aufwand für die zufällige Sortierung unerwünscht ist.
Nächste Schritte
- Metadaten für Übersetzung und Bewertung
mit dem
dwh-migration-dumper-Tool generieren - SQL-Abfragen im Batch übersetzen, um Ihre SQL-Quellskripts und DDL in GoogleSQL zu konvertieren.
- Migration mit Migrationsherkunft planen, um Datenabhängigkeiten in Ihrem Quell-Data-Warehouse zu visualisieren.