


ניהול צינורות עיבוד נתונים
צינורות עיבוד נתונים ב-BigQuery מאפשרים לבדוק את היסטוריית ההרצה, להגדיר התראות על כשלים ולשלוט בנכסי קוד שמופעלים על ידי Dataform. אתם יכולים גם להעשיר את המטא-נתונים של תהליך העבודה ב-Knowledge Catalog כדי לעקוב אחרי איכות הנתונים, ולמחוק תהליכי עבודה מיושנים כדי לשמור על הסדר בפרויקט. בהתאם למקום שבו הצוות שלכם מאחסן קוד, אתם יכולים לגשת לצינורות עיבוד נתונים ב-Files and Folders, כולל תיקיות משתמשים ותיקיות צוות, או ב-מאגרי Git ב-BigQuery Studio (תיקיות Git) (גרסת טרום-השקה (Preview)).
לפני שמתחילים
- יצירת צינור עיבוד נתונים ב-BigQuery.
- כדי לנהל את המטא-נתונים של צינור עיבוד הנתונים ב-Knowledge Catalog, ודאו ש-Dataplex API מופעל בפרויקט ב- Google Cloud .
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות לניהול צינורות עיבוד נתונים, בקשו מהאדמין לתת לכם את התפקידים הבאים ב-IAM:
-
כדי להציג ולהריץ צינורות עיבוד נתונים:
- צפייה ב-Dataform (
roles/dataform.Viewer) בפרויקט - BigQuery Job User (
roles/bigquery.jobUser) בפרויקט
- צפייה ב-Dataform (
-
כדי להריץ צינורות עיבוד נתונים עם פרטי כניסה של משתמש לחשבון Google:
BigQuery Data Editor (
roles/bigquery.dataEditor) בפרויקט או במערכי נתונים ספציפיים של BigQuery -
כדי למחוק צינורות עיבוד נתונים:
אדמין ב-Dataform (
roles/dataform.Admin) בצינור עיבוד הנתונים -
כדי לנהל צינורות עיבוד נתונים בתיקיות של משתמשים:
- בעלי הקוד (
roles/dataform.codeOwner) בתיקייה - עריכת קוד (
roles/dataform.codeEditor) בתיקייה - צפייה בקוד (
roles/dataform.codeViewer) בתיקייה
- בעלי הקוד (
-
כדי לנהל צינורות עיבוד נתונים בתיקיות של צוותים:
- בעלים של תיקיית צוות (
roles/dataform.teamFolderOwner) בתיקיית הצוות - בעל הרשאת עריכה בתיקיית צוות (
roles/dataform.teamFolderContributor) בתיקיית הצוות - צפייה בתיקיית צוות (
roles/dataform.teamFolderViewer) בתיקיית הצוות
- בעלים של תיקיית צוות (
-
כדי לנהל צינורות עיבוד נתונים במאגרי Git:
משתמש OAuth ב-Developer Connect (
roles/developerconnect.oauthUser) בפרויקט -
כדי לראות ולנהל מטא-נתונים ב-Knowledge Catalog:
עריכת קטלוג Dataplex (
roles/dataplex.catalogEditor) בפרויקט או בקבוצת הרשומות@bigquery
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
יכול להיות שאפשר לקבל את ההרשאות הנדרשות גם באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש.
מידע נוסף על IAM ב-Dataform זמין במאמר בקרת גישה באמצעות IAM. מידע נוסף על תפקידים בתיקיות זמין במאמר יצירה וניהול של תיקיות. מידע נוסף על תפקידים במאגרי Git זמין במאמר ניהול קוד באמצעות מאגרי Git ב-BigQuery Studio.
אם אתם משתמשים בחשבון שירות בהתאמה אישית כדי להריץ צינורות עיבוד נתונים, אתם צריכים להקצות לחשבון השירות את התפקידים הבאים:
- BigQuery Job User (
roles/bigquery.jobUser) בפרויקט - עריכה של נתוני BigQuery (
roles/bigquery.dataEditor) בפרויקט או במערכי נתונים ספציפיים של BigQuery - Dataplex Catalog Editor
(
roles/dataplex.catalogEditor) בפרויקט או בקבוצת הרשומות@bigquery
הצגת צינורות עיבוד נתונים
בחלונית Files אפשר לראות ולבדוק צינורות עיבוד נתונים שמאוחסנים בתיקיות או בתיקיות Git. בחלונית Explorer אפשר לראות צינורות עיבוד נתונים עצמאיים וצינורות עיבוד נתונים שמאוחסנים בתיקיות. תהליכים שמאוחסנים בתיקיות Git לא מוצגים בחלונית Explorer.
הצגת צינורות עיבוד נתונים בחלונית Files
צינורות עיבוד נתונים שמאוחסנים בתיקיות או בתיקיות Git מופיעים ישירות בחלונית Files.
כדי לראות צינור עיבוד נתונים שמאוחסן בתיקייה או בתיקיית Git, מבצעים את הפעולות הבאות:
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית הימנית, לוחצים על קבצים כדי לפתוח את דפדפן הקבצים.
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
מרחיבים את התיקייה User, את התיקייה Team folder או תיקייה של מאגר Git מקושר.
צינורות עיבוד נתונים מוצגים עם סמל של צינור עיבוד נתונים במקום סמל תיקייה רגיל.
לוחצים על תיקיית צינור עיבוד נתונים כדי לפתוח את Pipeline Viewer.
ב-Pipeline Viewer מוצגים הגרף האציקלי המכוון (DAG) שעבר הידור של משימות צינור עיבוד הנתונים, סטטוס הביצוע וכרטיסיות ההגדרות האישיות.
מרחיבים את ספריית הצינור בדפדפן הקבצים כדי לעיין בספריות בתצוגת עץ (כמו
definitions/) ובקבצי משימות נפרדים.
הצגת צינורות עיבוד נתונים בחלונית Explorer
כדי להציג רשימה של צינורות עיבוד נתונים עצמאיים וצינורות עיבוד נתונים שמאוחסנים בתיקיות:
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
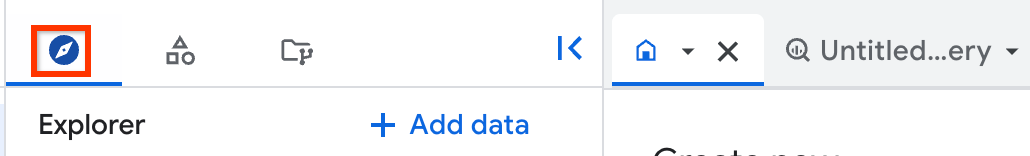
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט ולוחצים על Pipelines.
בוחרים צינור עיבוד נתונים כדי לפתוח אותו ב-Pipeline Viewer.
צפייה בהפעלות ידניות קודמות
כדי לראות את ההפעלות הידניות הקודמות של צינור עיבוד נתונים מסוים:
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Pipelines ובוחרים צינור עיבוד נתונים.
לוחצים על Executions.
אופציונלי: כדי לרענן את רשימת ההפעלות הקודמות, לוחצים על רענון.
הגדרת התראות על הפעלות שנכשלו של צינורות עיבוד נתונים
לכל צינור עיבוד נתונים יש מזהה מאגר תואם ב-Dataform. כל הפעלה של צינור עיבוד נתונים ב-BigQuery מתועדת ב-Cloud Logging באמצעות המזהה התואם של מאגר Dataform. אתם יכולים להשתמש ב-Cloud Monitoring כדי לצפות במגמות ביומני Cloud Logging של הרצות צינורות עיבוד נתונים ב-BigQuery, ולקבל התראות כשמתקיימים תנאים מסוימים שהגדרתם.
כדי לקבל התראות כשנכשלת הרצה של צינור עיבוד נתונים ב-BigQuery, אתם יכולים ליצור מדיניות התראות מבוססת-יומנים למאגר הנתונים המתאים ב-Dataform. להוראות, קראו את המאמר הגדרת התראות על הפעלות כושלות של תהליכי עבודה.
כדי למצוא את מזהה המאגר של Dataform בצינור עיבוד הנתונים:
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Pipelines ובוחרים צינור עיבוד נתונים.
לוחצים על הגדרות.
מזהה המאגר של Dataform של צינור עיבוד הנתונים מוצג בתחתית הכרטיסייה Settings.
מחיקת צינור עיבוד נתונים
כדי למחוק צינור עיבוד נתונים באופן סופי:
- נכנסים לדף BigQuery במסוף Google Cloud . כניסה ל-BigQuery
כדי למחוק צינור עיבוד נתונים שמאוחסן בתיקייה או בתיקיית Git:
בחלונית הימנית, לוחצים על קבצים.
בעץ הקבצים, מוצאים את תיקיית הצינור שרוצים למחוק.
לוחצים על View actions ליד תיקיית הצינור, ואז על Delete.
בתיבת הדו-שיח לאישור, לוחצים על מחיקה.
תיקיית הצינור וכל המשימות והקבצים שבה נמחקים מסביבת העבודה.
כדי למחוק צינור עיבוד נתונים שמופיע בחלונית Explorer:
בחלונית השמאלית, לוחצים על Explorer:
בחלונית Explorer, מרחיבים את הפרויקט ולוחצים על Pipelines.
מאתרים את צינור עיבוד הנתונים שרוצים למחוק.
לוחצים על הצגת פעולות לצד הצינור, ואז לוחצים על מחיקה.
לוחצים על Delete.
ניהול מטא-נתונים ב-Knowledge Catalog
ב-Knowledge Catalog אתם יכולים לאחסן ולנהל את המטא-נתונים של צינורות עיבוד הנתונים. כברירת מחדל, צינורות עיבוד נתונים זמינים ב-Knowledge Catalog בלי הגדרות נוספות.
אתם יכולים להשתמש ב-Knowledge Catalog כדי לנהל צינורות עיבוד נתונים בכל המיקומים של צינורות עיבוד הנתונים. ניהול צינורות עיבוד נתונים ב-Knowledge Catalog כפוף למכסות ולמגבלות של Knowledge Catalog ולתמחור של Knowledge Catalog.
Knowledge Catalog מאחזר באופן אוטומטי את המטא-נתונים הבאים מצינורות עיבוד נתונים:
- שם נכס הנתונים
- נכס הורה של נכס נתונים
- המיקום של נכס הנתונים
- סוג נכס הנתונים
- הפרויקט התואם ב- Google Cloud
ב-Knowledge Catalog, צינורות עיבוד הנתונים מתועדים ביומן כרשומות עם ערכי הרשומות הבאים:
- קבוצת רשומות מערכת
- קבוצת הרשומות של המערכת לצינורות עיבוד נתונים היא
@dataform. כדי לראות את הפרטים של רשומות צינור עיבוד הנתונים ב-Knowledge Catalog, צריך להציג את קבוצת הרשומות של המערכתdataform. במאמר הצגת הפרטים של קבוצת רשומות שבמסמכי התיעוד של Knowledge Catalog מוסבר איך להציג רשימה של כל הרשומות בקבוצת רשומות. - סוג רשומה במערכת
- סוג הרשומה במערכת של צינורות עיבוד נתונים הוא
dataform-code-asset. כדי לראות את הפרטים של צינורות עיבוד נתונים, צריך להציג את סוג הרשומה של המערכתdataform-code-asset, לסנן את התוצאות באמצעות מסנן מבוסס-היבט ולהגדיר את השדהtypeבתוך ההיבטdataform-code-assetלערךWORKFLOW. אחר כך בוחרים רשומה בצינור עיבוד הנתונים שנבחר. במאמר הצגת פרטים של סוג רשומה שבמסמכי התיעוד של Knowledge Catalog מוסבר איך להציג פרטים של סוג רשומה שנבחר. במאמר הצגת פרטים של רשומה שבמסמכי התיעוד של Knowledge Catalog מוסבר איך להציג פרטים של רשומה שנבחרה. - סוג היבט המערכת
- סוג ההיבט של המערכת לצינורות עיבוד נתונים הוא
dataform-code-asset. כדי לספק הקשר נוסף לפייפליינים ב-Knowledge Catalog, אפשר להוסיף הערות לרשומות של פייפליינים של נתונים באמצעות היבטים. לשם כך, צריך להציג את סוג ההיבטdataform-code-asset, לסנן את התוצאות באמצעות מסנן שמבוסס על היבטים ולהגדיר את השדהtypeבתוך ההיבטdataform-code-assetלערךWORKFLOW. הוראות להוספת הערות לרשומות עם היבטים מופיעות במאמר ניהול היבטים והעשרת מטא-נתונים במסמכי התיעוד של Knowledge Catalog. - סוג
- הסוג של קנבס נתונים הוא
WORKFLOW. הסוג הזה מאפשר לסנן צינורות עיבוד נתונים בסוג הרשומהdataform-code-assetשל המערכת ובסוג ההיבטdataform-code-assetבאמצעות השאילתהaspect:dataplex-types.global.dataform-code-asset.type=WORKFLOWבמסנן מבוסס-היבט.
במאמר חיפוש נכסי נתונים ב-Knowledge Catalog שבמסמכי התיעוד של Knowledge Catalog מוסבר איך לחפש נכסים ב-Knowledge Catalog.
העשרת מטא-נתונים ושילוב כרטיס מידע על איכות הנתונים
אפשר לפרסם ב-Knowledge Catalog את המטא-נתונים הבאים של Dataform:
- סוג ההיבט של הסקירה הכללית
- סוג היבט כללי
- סוג ההיבט של כרטיס המידע על איכות הנתונים
הצהרות Dataform משולבות באופן אוטומטי עם כרטיס המידע של איכות הנתונים ב-Knowledge Catalog. במהלך הפעלת צינור עיבוד הנתונים, התוצאות של כל טענות הנכוֹנוּת (assertions) של Dataform מתפרסמות באופן אוטומטי ב-Knowledge Catalog. התוצאות האלה מאכלסות את כרטיס המידע של איכות הנתונים ב-Knowledge Catalog בסטטוס "עבר" או "נכשל".
כדי לבדוק את הסטטוס של עדכון המטא-נתונים, פועלים לפי ההוראות במאמר הצגת הפעלות ידניות קודמות.
אחרי שהמטא-נתונים סונכרנו, אפשר לחפש את הרשומה ב-Knowledge Catalog ולצפות בה. למידע נוסף, קראו את המאמר חיפוש משאבים.
המאמרים הבאים
- מידע נוסף על צינורות עיבוד נתונים ב-BigQuery
- איך יוצרים צינורות עיבוד נתונים
- איך מתזמנים צינורות עיבוד נתונים
- איך מנהלים קוד באמצעות מאגרי Git ב-BigQuery Studio
- איך מארגנים נכסי קוד בתיקיות
- מידע נוסף על פריסות של Dataform