


從 Firestore 匯出作業載入資料
BigQuery 支援從使用 Firestore 代管匯入和匯出服務建立的 Firestore 匯出作業載入資料。代管匯入和匯出服務會將 Firestore 文件匯出至 Cloud Storage bucket。之後您可以將匯出的資料載入到 BigQuery 資料表中。
限制
從 Firestore 匯出作業將資料載入 BigQuery 時,請注意下列限制:
- 資料集必須與含有匯出檔案的 Cloud Storage bucket 位於相同位置。
- 您只能指定一個 Cloud Storage URI,且無法使用 URI 萬用字元。
- 如要正確載入 Firestore 匯出作業,匯出資料中的文件必須共用一致的結構定義,且不重複的欄位名稱不得超過 10,000 個。
- 您可以建立新資料表來儲存資料,也可以覆寫現有資料表,您無法將 Firestore 匯出資料附加至現有資料表。
- 您的匯出指令必須指定
collection-ids篩選器。未指定集合 ID 篩選器的匯出資料無法載入 BigQuery。
事前準備
授予 Identity and Access Management (IAM) 角色,讓使用者具備必要權限,可執行本文件中的各項工作。
所需權限
如要將資料載入 BigQuery,您必須具備 IAM 權限,才能執行載入工作,並將資料載入 BigQuery 資料表和分區。如果您是從 Cloud Storage 載入資料,也需要 IAM 權限,才能存取含有資料的 bucket。
將資料載入 BigQuery 的權限
如要將資料載入新的 BigQuery 資料表或分區,或附加或覆寫現有資料表或分區,您必須具備下列 IAM 權限:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
下列各項預先定義的 IAM 角色,都包含將資料載入 BigQuery 資料表或分區所需的權限:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(包含bigquery.jobs.create權限)bigquery.user(包含bigquery.jobs.create權限)bigquery.jobUser(包含bigquery.jobs.create權限)
此外,如果您具備 bigquery.datasets.create 權限,則可在建立的資料集中,使用載入工作建立及更新資料表。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「預先定義的角色和權限」。
從 Cloud Storage 載入資料的權限
如要取得從 Cloud Storage bucket 載入資料所需的權限,請要求管理員授予您 bucket 的儲存空間管理員 (roles/storage.admin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備從 Cloud Storage bucket 載入資料所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能從 Cloud Storage bucket 載入資料:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
載入 Firestore 匯出服務資料
您可以使用 Google Cloud 控制台、bq 指令列工具或 API,從 Firestore 匯出中繼資料檔案載入資料。
有時 Google Cloud 控制台和 bq 指令列工具會使用 Datastore 術語,但下列程序與 Firestore 匯出檔案相容。Firestore 和 Datastore 共用匯出格式。
控制台
前往 Google Cloud 控制台的「BigQuery」頁面。
- 點選左側窗格中的 「Explorer」。
- 在「Explorer」窗格中展開專案,點選「資料集」,然後選取資料集。
- 在「資料集資訊」部分,點選 「建立資料表」。
- 在「建立資料表」窗格中,指定下列詳細資料:
- 在「Source」(來源) 部分,從「Create table from」(建立資料表來源) 清單中選取「Google Cloud Storage」。接著,按照下列步驟操作:
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Google Cloud 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
Firestore 匯出檔案的 URI 必須以KIND_COLLECTION_ID.export_metadata結尾。舉例來說,在default_namespace_kind_Book.export_metadata中,Book是集合 ID,default_namespace_kind_Book則是 Firestore 產生的檔案名稱。如果 URI 不是以KIND_COLLECTION_ID.export_metadata結尾,您會收到下列錯誤訊息: does not contain valid backup metadata. (錯誤代碼:無效)。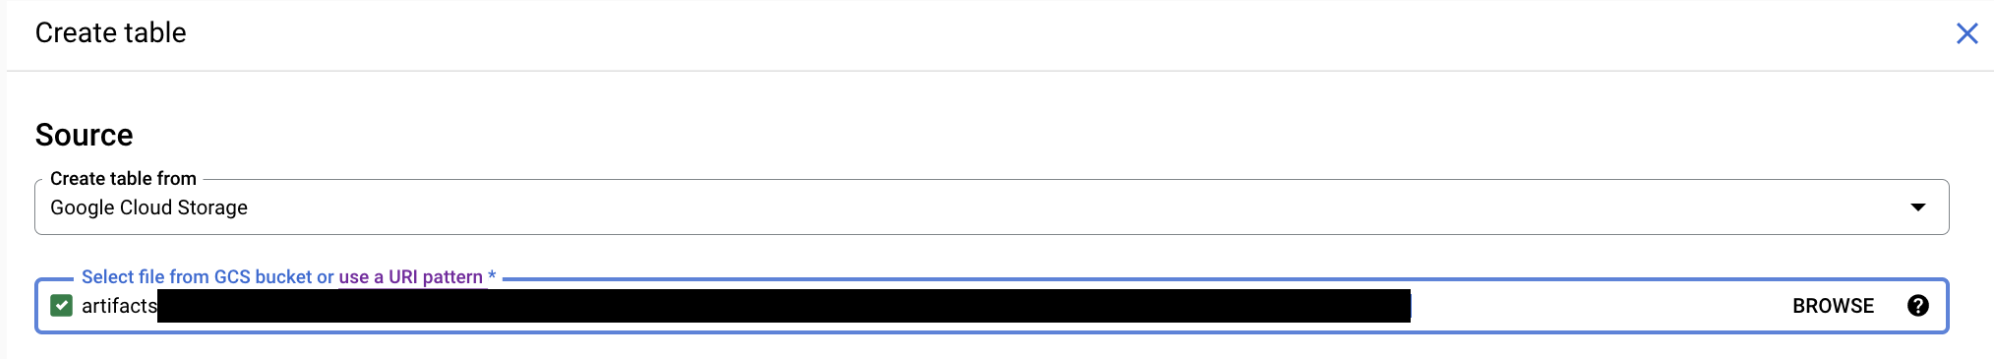
- 在「File format」(檔案格式) 部分,選取「Cloud Datastore Backup」(Cloud Datastore 備份)。Firestore 和 Datastore 共用匯出格式。
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Google Cloud 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
- 在「Destination」(目的地) 部分,指定下列詳細資料:
- 在「Dataset」(資料集) 部分,選取要在其中建立資料表的資料集。
- 在「Table」(資料表) 欄位中,輸入要建立的資料表名稱。
- 確認「資料表類型」欄位設為「原生資料表」。
- 在「Schema」(結構定義) 區段中,無需採取任何行動。系統會推論 Firestore 匯出作業的結構定義。
- 選用:指定分區和叢集設定。詳情請參閱「建立分區資料表」和「建立及使用分群資料表」。
- 按一下「進階選項」,然後執行下列操作:
- 讓「Write preference」(寫入偏好設定) 的 [Write if empty] (空白時寫入) 選項維持在已選取狀態。這個選項會建立新資料表,並將資料載入其中。
- 如要忽略資料列中未出現在資料表結構定義的值,請選取「Unknown values」(不明的值)。
- 在「Encryption」(加密) 部分,按一下「Customer-managed key」(客戶自行管理的金鑰),即可使用 Cloud Key Management Service 金鑰。如果保留 Google-managed key 設定,BigQuery 會加密靜態資料。
- 點選「建立資料表」。
bq
使用 bq load 指令,並將 source_format 設為 DATASTORE_BACKUP。加上 --location 標記,並該標記值設為您的位置。如要覆寫現有資料表,請新增 --replace 旗標。
如果只要載入特定欄位,請使用 --projection_fields 旗標。
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
更改下列內容:
LOCATION:您的位置。--location旗標為選用。FORMAT:DATASTORE_BACKUP。 Datastore 備份是 Firestore 的正確選項。Firestore 和 Datastore 共用匯出格式。DATASET:資料集,其中包含您要載入資料的資料表。TABLE:要載入資料的資料表。如果資料表不存在,系統會建立資料表。PATH_TO_SOURCE:Cloud Storage URI。
舉例來說,下列指令會將 gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata Firestore 匯出檔案載入名為 book_data 的資料表。mybucket 和 mydataset 是在 US 多地區位置建立的。
bq --location=US load \
--source_format=DATASTORE_BACKUP \
mydataset.book_data \
gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata
API
設定下列屬性,使用 API 載入 Firestore 匯出資料。
建立
load工作設定指向 Cloud Storage 中的來源資料。sourceUris必須完整限定,格式為載入工作設定中的gs://BUCKET/OBJECT。檔案 (物件) 名稱的結尾必須是KIND_NAME.export_metadata。Firestore 匯出作業只能使用一個 URI,且不得使用萬用字元。在載入工作設定中,將
sourceFormat屬性設為DATASTORE_BACKUP以指定資料格式。Datastore 備份是 Firestore 的正確選項。Firestore 和 Datastore 共用匯出格式。如要僅載入特定欄位,請設定
projectionFields屬性。如果您要覆寫現有資料表,請將
writeDisposition屬性設為WRITE_TRUNCATE以指定寫入配置。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Firestore 選項
如要變更 BigQuery 剖析 Firestore 匯出資料的方式,請指定下列選項:
| Google Cloud 控制台選項 | `bq` 旗標 | BigQuery API 屬性 | 說明 |
|---|---|---|---|
| 無法使用 | --projection_fields |
projectionFields (Java、Python) |
(選用) 以半形逗號分隔的清單,指出要從 Firestore 匯出作業載入哪些文件欄位。根據預設,BigQuery 會載入所有欄位。欄位名稱區分大小寫,且必須出現在匯出內容中。您無法在 map.foo 等對應欄位內指定欄位路徑。 |
資料類型轉換
BigQuery 會將 Firestore 匯出檔案中各份文件的資料轉換為 BigQuery 資料類型。下表說明支援資料類型之間的轉換。
| Firestore 資料類型 | BigQuery 資料類型 |
|---|---|
| 陣列 | RECORD |
| 布林值 | BOOLEAN |
| 參考資料 | RECORD |
| 日期和時間 | TIMESTAMP |
| 對應 | RECORD |
| 浮點數 | FLOAT |
| 地理點 |
RECORD [{"lat","FLOAT"},
{"long","FLOAT"}]
|
| 整數 | INTEGER |
| 字串 | STRING (截斷至 64 KB) |
Firestore 金鑰屬性
Firestore 中的每份文件都有專屬金鑰,其中包含文件 ID 和文件路徑等資訊。BigQuery 會為金鑰建立 RECORD 資料類型 (也稱為 STRUCT),並透過巢狀欄位整理不同類型的資訊,如下表所示。
| 金鑰屬性 | 說明 | BigQuery 資料類型 |
|---|---|---|
__key__.app |
Firestore 應用程式名稱。 | STRING |
__key__.id |
文件的 ID;如有設定 __key__.name,則為 null。 |
INTEGER |
__key__.kind |
文件的集合 ID。 | STRING |
__key__.name |
文件的名稱;如有設定 __key__.id,則為 null。 |
STRING |
__key__.namespace |
Firestore 不支援自訂命名空間。預設命名空間會以空白字串表示。 | 字串 |
__key__.path |
文件的路徑:文件的序列與根集合的集合配對。例如 "Country",
"USA", "PostalCode", 10011, "Route", 1234。 |
STRING |