


측정 작업
이 문서에서는 그래프에서 측정값을 정의하고 쿼리하는 방법을 보여줍니다. 측정값을 사용하여 조인 전체에서 집계가 올바르게 수행되도록 할 수 있습니다.
개요
측정값은 노드 또는 에지 테이블의 PROPERTIES 절 내에서 정의된 집계 속성입니다. 측정값은 측정값 표현식으로 정의되며, 이는 다음 중 하나를 둘러싼 MEASURE 키워드를 사용하여 생성됩니다.
- 집계 표현식
- 집계 함수와 스칼라 연산을 결합하는 표현식
- 파생 측정: 동일한 요소 테이블에 정의된
AGG함수로 래핑된 측정의 조합입니다.
측정값은 다음 집계 함수를 지원합니다.
SUMAVGCOUNTMINMAXAGG(파생 측정용)
AGG를 제외한 모든 집계 함수는 DISTINCT 키워드를 지원합니다. 지원되는 측정 표현식에 대한 자세한 내용은 측정 유형을 참조하세요.
측정값은 정의된 노드 또는 에지 테이블의 KEY를 참조하여 집계를 정의합니다. 즉, 측정값을 쿼리할 때 기본 테이블이 행을 중복시키는 방식으로 조인되더라도 집계가 올바르게 수행됩니다.
GQL 쿼리에서 측정값으로 정의된 속성을 참조할 수 없습니다. 대신 GRAPH_EXPAND TVF를 호출하여 그래프의 관계형 표현을 쿼리하여 측정값에 액세스합니다. 기본적으로 GRAPH_EXPAND는 속성당 하나의 열이 있는 그래프의 평탄화된 테이블 표현을 반환합니다. flatten_results => FALSE를 지정하여 중첩된 STRUCT 열이 있는 계층적 테이블을 반환할 수도 있습니다. 그래프에 여러 루트 노드 테이블이 포함된 경우 start_node 인수를 지정하여 순회할 루트 테이블을 선택할 수 있습니다.
이 함수는 일부 유형의 그래프를 허용하지 않습니다. 유효한 입력을 형성하는 그래프에 대한 자세한 내용은 입력 제한사항을 참조하세요.
GQL 쿼리를 실행하려면 Enterprise 또는 Enterprise Plus 버전을 사용하는 예약이 있어야 합니다.
주문형 가격 책정을 사용하는 경우 GRAPH_EXPAND 함수를 호출하여 그래프에서 SQL 쿼리를 실행할 수 있습니다.
GRAPH_EXPAND TVF의 출력에서 AGG 함수를 호출하여 측정에 정의된 집계에 따라 속성을 집계할 수 있습니다.
측정값 정의
측정 표현식 주위에 MEASURE() 키워드를 사용하여 노드 또는 에지 테이블 정의의 PROPERTIES 절 내에서 측정값을 정의합니다.
다음 예시에서는 university이라는 데이터 세트와 대학, 학과, 과정에 대한 테이블을 만듭니다.
CREATE SCHEMA IF NOT EXISTS university;

CREATE OR REPLACE TABLE university.College (
  college_id INT64 PRIMARY KEY NOT ENFORCED,
  college_name STRING
);

CREATE OR REPLACE TABLE university.Department (
  dept_id INT64 PRIMARY KEY NOT ENFORCED,
  dept_name STRING,
  college_id INT64,
  budget FLOAT64,
  FOREIGN KEY (college_id) REFERENCES university.College(college_id) NOT ENFORCED
);

CREATE OR REPLACE TABLE university.Course (
  course_id INT64 PRIMARY KEY NOT ENFORCED,
  course_name STRING,
  dept_id INT64,
  credits INT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.College (college_id, college_name)
VALUES (101, 'College of Engineering'),
       (102, 'College of Arts');

INSERT INTO university.Department (dept_id, dept_name, college_id, budget)
VALUES (1001, 'Computer Science', 101, 500000),
       (1002, 'Mechanical Engineering', 101, 400000),
       (1003, 'Fine Arts', 102, 200000),
       (1004, 'Research', 101, 50000);

INSERT INTO university.Course (course_id, course_name, dept_id, credits)
VALUES (1, 'Intro to CS', 1001, 3),
       (2, 'Data Structures', 1001, 4),
       (3, 'Thermodynamics', 1002, 3),
       (4, 'Oil Painting', 1003, 2);
다음 문은 Department 및 Course 노드의 속성에 대한 측정값을 정의하는 SchoolGraph라는 그래프를 만듭니다.
측정값으로 정의된 속성의 별칭을 제공해야 합니다.
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id,
        budget OPTIONS(description="Department budget in USD"),
        MEASURE(SUM(budget)) AS total_budget,
        MEASURE(SUM(budget) * 1.10) AS budget_with_overhead OPTIONS(
          description="Total department budget including 10% overhead",
          extensions=[("unit", "USD"), ("tier", "planning")]
        )),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id,
        course_name,
        credits,
        dept_id,
        MEASURE(AVG(credits)) AS avg_credits,
        MEASURE(SUM(credits)) AS total_credits,
        MEASURE(COUNT(course_id)) AS course_count,
        MEASURE(COUNT(DISTINCT CASE WHEN credits >= 3 THEN course_id ELSE NULL END)) AS major_course_count,
        MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
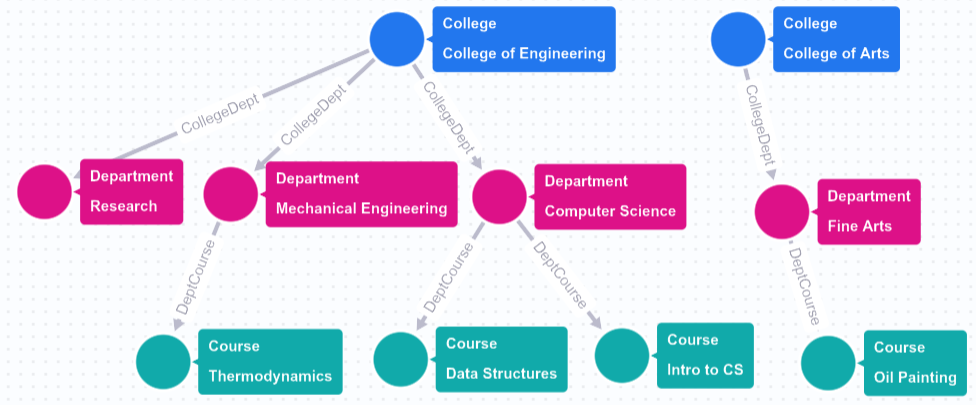
total_budget 측정은 MEASURE(SUM(budget))로 정의됩니다. 측정값은 집계를 KEY(dept_id)로 잠급니다.
파생 측정값
파생 측정은 AGG() 함수를 사용하여 동일한 요소 테이블에 정의된 다른 측정을 참조하는 측정입니다. 이 기능을 사용하면 재사용 가능한 측정 계층 구조를 빌드할 수 있습니다.
예를 들어 university.Course에서 computed_avg_credits 측정은 total_credits 측정과 course_count 측정 간의 비율을 계산합니다.
MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits
파생 측정은 기본 요소 테이블 키의 세분화 잠금 속성을 유지합니다. 측정값 종속 항목은 그래프 컴파일 시간에 확인됩니다. 측정 간의 순환 참조는 오류를 반환합니다.
과다 집계 이해하기
테이블을 조인하면 데이터에 일대다 관계가 있을 때마다 데이터가 반복됩니다. 예를 들어 Course, Department, College 테이블을 조인하면 여러 과정이 있는 학과가 출력의 여러 행에 표시됩니다.
SELECT
  college_name,
  dept_name,
  course_name,
  budget
FROM university.Course
LEFT JOIN university.Department
  ON Course.dept_id = Department.dept_id
LEFT JOIN university.College
  ON Department.college_id = College.college_id;

/*------------------------+------------------------+-----------------+----------+
 | college_name           | dept_name              | course_name     | budget   |
 +------------------------+------------------------+-----------------+----------+
 | College of Engineering | Computer Science       | Intro to CS     | 500000.0 |
 | College of Engineering | Computer Science       | Data Structures | 500000.0 |
 | College of Engineering | Mechanical Engineering | Thermodynamics  | 400000.0 |
 | College of Arts        | Fine Arts              | Oil Painting    | 200000.0 |
 +------------------------+------------------------+-----------------+----------*/
SUM(budget)를 사용하여 대학별 총 예산을 계산하려고 하면 컴퓨터 공학과의 예산이 두 번 계산됩니다. Department 테이블을 직접 쿼리하면 이 문제를 방지할 수 있지만, 조인된 데이터에 기여하는 여러 테이블에서 여러 집계를 계산하려는 경우에는 이 방법이 작동하지 않습니다. 다음 섹션에서는 측정으로 이 문제를 해결하는 방법을 보여줍니다.
측정값으로 그래프 쿼리
GQL을 사용하여 측정값이 있는 그래프를 쿼리할 수 있지만 쿼리는 측정값으로 정의된 속성을 직접 참조할 수 없습니다. 예를 들어 다음 쿼리는 측정 속성이 정의된 노드를 참조하지만 측정 필드를 사용하거나 반환하지 않습니다.
GRAPH university.SchoolGraph
MATCH (c:College)->(d:Department)->(course:Course)
RETURN c.college_name, d.dept_name, course.course_name;

/*------------------------+------------------------+-----------------+
 | college_name           | dept_name              | course_name     |
 +------------------------+------------------------+-----------------+
 | College of Engineering | Computer Science       | Intro to CS     |
 | College of Engineering | Computer Science       | Data Structures |
 | College of Engineering | Mechanical Engineering | Thermodynamics  |
 | College of Arts        | Fine Arts              | Oil Painting    |
 +------------------------+------------------------+-----------------*/
측정값을 사용하려면 GRAPH_EXPAND 테이블 값 함수 (TVF)를 사용하여 그래프를 관계형 테이블로 쿼리합니다.
GRAPH_EXPAND(
  graph_name [, start_node => 'NodeName'] [, flatten_results => TRUE|FALSE]
)
이 함수는 다음 인수를 허용합니다.
graph_name: 그래프 이름이 포함된STRING입니다.start_node: 순회를 위한 시작 노드 테이블을 지정하는 선택적STRING입니다. 그래프에 루트 노드 테이블이 여러 개 있는 경우 이 인수가 필요합니다.flatten_results: 선택사항인BOOL(기본값은TRUE)입니다.TRUE: 모든 노드 및 에지 속성을<element>_<property>프리픽스가 있는 최상위 열로 평면화합니다.FALSE: 루트 노드 속성을 프리픽스가 없는 최상위 열로 반환하고 조인된 인접 테이블을STRUCT열로 반환합니다.
평탄화된 출력 사용
flatten_results가 TRUE(기본 모드)로 설정된 경우 출력 테이블의 열 이름은 노드 또는 에지 테이블 라벨과 속성 이름을 연결하여 지정됩니다(예: Course_course_name 또는 Department_total_budget). 다음 쿼리는 GRAPH_EXPAND TVF의 샘플 출력을 보여줍니다.
SELECT
  College_college_name,
  Department_dept_name,
  Department_budget,
  Course_course_name
FROM
  GRAPH_EXPAND("university.SchoolGraph");

/*------------------------+------------------------+-------------------+--------------------+
 | College_college_name   | Department_dept_name   | Department_budget | Course_course_name |
 +------------------------+------------------------+-------------------+--------------------+
 | College of Engineering | Computer Science       | 500000.0          | Intro to CS        |
 | College of Engineering | Computer Science       | 500000.0          | Data Structures    |
 | College of Engineering | Mechanical Engineering | 400000.0          | Thermodynamics     |
 | College of Arts        | Fine Arts              | 200000.0          | Oil Painting       |
 +------------------------+------------------------+-------------------+--------------------*/
GRAPH_EXPAND 함수는 노드 및 에지 테이블에 일련의 LEFT JOIN 작업을 적용하여 평면화된 테이블을 생성합니다. 시작 노드를 지정하지 않으면 입력 그래프에 스키마 관계 그래프에 단일 루트 노드 테이블이 있어야 합니다.
마찬가지로 루트 노드 테이블은 에지를 공유하는 다른 모든 노드 테이블과 다대일 관계여야 합니다.
일련의 조인을 통해 루트 노드 테이블에서 연결할 수 없는 데이터는 출력에 표시되지 않습니다. 이전 예시에서 Course는 루트 노드 테이블입니다. Research 학과는 과정이 없으므로 출력에서 생략됩니다.
측정값으로 정의된 속성의 열을 직접 선택할 수 없습니다.
대신 AGG() 함수로 래핑해야 합니다.
이 함수는 측정값에 정의된 집계가 키당 정확히 한 번 수행되도록 합니다.
다음 쿼리는 각 대학의 총 예산과 총 과정 수를 동시에 계산합니다.
SELECT
  College_college_name,
  AGG(Department_total_budget) AS college_budget,
  AGG(Course_course_count) AS total_courses
FROM
  GRAPH_EXPAND("university.SchoolGraph")
GROUP BY
  College_college_name;

/*------------------------+----------------+---------------+
 | College_college_name   | college_budget | total_courses |
 +------------------------+----------------+---------------+
 | College of Engineering | 900000.0       | 3             |
 | College of Arts        | 200000.0       | 1             |
 +------------------------+----------------+---------------*/
계층적 출력 사용
flatten_results => FALSE를 지정하면 GRAPH_EXPAND는 프리픽스가 지정된 열 대신 계층적 관계를 반환합니다.
- 시작 루트 노드의 속성은 프리픽스가 없는 최상위 열로 표시됩니다(예:
course_name또는credits). - 노드 또는 에지 테이블일 수 있는 조인된 이웃 테이블의 속성은 요소 테이블의 이름을 딴 중첩된
STRUCT필드로 표시됩니다. 예를 들어 시작 노드가Course이면 DeptCourse.Department.CollegeDept.College.college_nameto access thecollege_name` 속성을 사용합니다. - 중첩된 구조체 내의 측정값은
AGG()내에서 점 표기법을 사용하여 쿼리됩니다(예:AGG(DeptCourse.Department.total_budget)). - 요소 테이블에 인접한 요소 테이블과 이름이 같은 속성이 있는 경우
flatten_results => FALSE를 사용하여 그래프를 쿼리할 수 없습니다. 대신 결과를 평면화해야 합니다.
SELECT
  DeptCourse.Department.dept_name AS department_name,
  DeptCourse.Department.CollegeDept.College.college_name,
  AGG(DeptCourse.Department.total_budget) AS total_budget,
  AGG(course_count) AS total_courses
FROM GRAPH_EXPAND(
       "university.SchoolGraph",
       start_node => "Course",
       flatten_results => FALSE)
GROUP BY department_name, college_name;
여러 루트 노드 테이블로 작업
그래프에는 측정기준 테이블을 공유하는 여러 루트 노드 테이블(사실 테이블이라고도 함)이 포함되는 경우가 많습니다. 여러 루트 노드 테이블이 있는 그래프를 쿼리하려면 GRAPH_EXPAND에서 start_node 인수를 사용합니다. 함수는 시작 노드에서 연결할 수 있는 하위 그래프를 순회합니다.
예를 들어 Department에도 연결되는 university 데이터 세트에 Instructor 테이블을 추가할 수 있습니다.
CREATE OR REPLACE TABLE university.Instructor (
  instructor_id INT64 PRIMARY KEY NOT ENFORCED,
  instructor_name STRING,
  dept_id INT64,
  salary FLOAT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.Instructor (instructor_id, instructor_name, dept_id, salary)
VALUES (501, 'Dr. Dana', 1001, 120000),
       (502, 'Dr. Lee', 1001, 110000),
       (503, 'Dr. Taylor', 1002, 115000),
       (504, 'Prof. Izumi', 1003, 90000);
Instructor 노드 테이블과 Instructor에서 Department로의 에지를 포함하는 university.SchoolGraphMultiRoot라는 새 그래프를 만들 수 있습니다.
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraphMultiRoot
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id, budget,
        MEASURE(SUM(budget)) AS total_budget),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id, course_name, credits, dept_id,
        MEASURE(COUNT(course_id)) AS course_count),
    university.Instructor
      KEY(instructor_id)
      PROPERTIES(
        instructor_id, instructor_name, dept_id, salary,
        MEASURE(COUNT(instructor_id)) AS instructor_count,
        MEASURE(SUM(salary)) AS total_salary)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id),
    university.Instructor AS DeptInstructor
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (instructor_id) REFERENCES Instructor (instructor_id)
  );
이 그래프에서 Course 및 Instructor는 모두 Department 및 College에 연결되는 루트 노드 테이블 역할을 합니다. start_node를 전달하여 하위 그래프를 타겟팅할 수 있습니다.
-- Expand the Course subgraph (Course -> Department -> College)
SELECT
  College_college_name,
  AGG(Course_course_count) AS total_courses
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course")
GROUP BY College_college_name;

-- Expand the Instructor subgraph (Instructor -> Department -> College)
SELECT
  College_college_name,
  AGG(Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor")
GROUP BY College_college_name;
여러 팩트 테이블에서 측정항목을 분석하려면 GRAPH_EXPAND를 사용하여 각 하위 그래프를 쿼리하고 표준 SQL에서 공유 측정기준에 조인합니다.
SELECT
  C.College_college_name,
  AGG(C.Course_course_count) AS total_courses,
  AGG(I.Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course") AS C
INNER JOIN GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor") AS I
  ON C.Department_dept_id = I.Department_dept_id
GROUP BY C.College_college_name;
AGG(C.Course_course_count) 및 AGG(I.Instructor_total_salary) 모두 조인의 간섭 없이 각 세부사항에서 집계를 정확하게 계산합니다.
권장사항
측정값이 있는 그래프를 설계할 때는 다음 권장사항을 따르세요.
단일 테이블 내에서 노드와 에지 정의
노드 테이블 정의와 해당 연결 에지 테이블 정의에 동일한 테이블을 사용하는 것이 좋습니다. 테이블을 재사용하면 노드 테이블과 에지 테이블 간의 일대일 (1:1) 관계가 보장되므로 팬아웃이 방지되고 GRAPH_EXPAND 함수가 에지를 모호하게 무시하지 않습니다.
예를 들어 Student 및 Course 테이블을 가리키는 외래 키가 포함된 입력 테이블 Enrollment가 있는 경우 Enrollment 입력 테이블을 사용하여 Enrollment 노드와 발신 에지를 정의합니다.
에지 테이블에서 불필요한 속성 정의 방지
동일한 물리적 테이블을 사용하여 노드 테이블과 에지 테이블을 정의할 때는 에지에 캡처할 새 정보가 없으면 에지 테이블에 PROPERTIES 절을 사용하지 마세요. 노드 테이블과 에지 테이블은 동일한 실제 테이블을 사용하므로 이러한 모든 속성은 이미 노드 테이블의 일부입니다.
에지 테이블에 중복 속성을 정의하면 GRAPH_EXPAND 함수가 에지 테이블을 공유 노드 테이블과 별개의 항목으로 처리할 수 있습니다. 성능을 최적화하려면 에지에서 캡처할 새 속성이 없는 경우 에지 테이블 정의에 NO PROPERTIES를 지정합니다.
다대다 관계를 노드 테이블로 모델링
다대다 (M:N) 관계는 테이블 A의 행이 테이블 B의 여러 행에 대응할 수 있고 테이블 B의 행이 테이블 A의 여러 행에 대응할 수 있을 때 발생합니다. 예를 들어 한 학생이 여러 과정에 등록할 수 있고 한 과정에 여러 학생이 있을 수 있습니다. 중간 연결 테이블을 사용하여 다대다 관계를 두 개의 일대다 관계로 분리할 수 있습니다. 예를 들어 Student 및 Course 테이블을 가리키는 외래 키가 포함된 Enrollment 테이블을 정의할 수 있습니다. 다음 예시와 같이 CREATE PROPERTY GRAPH 문에서 두 측정기준 노드 테이블을 연결하는 에지 테이블로 중간 연결 테이블을 모델링하는 경우 GRAPH_EXPAND 함수는 이러한 에지를 무시합니다. 관계가 명확하지 않기 때문입니다(다대일 또는 일대일이 명확하지 않음).
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student,
    university.Course
  )
  EDGE TABLES (
    -- Modeling the junction table as a standalone edge causes ambiguity
    university.Enrollment AS StudentEnrollment
      SOURCE KEY (student_id) REFERENCES Student (student_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
그래프의 모든 에지가 무시되면 GRAPH_EXPAND 또는 BQ.SHOW_GRAPH_EXPAND_SCHEMA 호출이 오류와 함께 실패합니다.
측정값의 M:N 관계를 올바르게 모델링하려면 중간 교차 테이블을 노드 테이블로 승격합니다. 이 구조에서 접합 노드 테이블은 단일 루트 노드 테이블 (진입 차수가 0인 노드 테이블) 역할을 합니다. 그런 다음 연결 테이블을 공유하는 두 개의 다대일 (N:1) 에지 테이블을 정의하여 N:1을 각 측정기준 노드 테이블에 연결합니다.
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student KEY (student_id),
    university.Course KEY (course_id),
    -- Promote the junction table to a node table (acting as the single root node)
    university.Enrollment KEY (enrollment_id)
  )
  EDGE TABLES (
    -- Share (reuse) the Enrollment table to define N:1 edges to each dimension
    university.Enrollment AS EnrollmentToStudent
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (student_id) REFERENCES Student (student_id),
    university.Enrollment AS EnrollmentToCourse
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
이 구조에서 Enrollment는 N:1을 Student 및 Course 측정기준 테이블(진입 차수 1)에 연결하는 단일 루트 노드 테이블 (진입 차수 0) 역할을 합니다. GRAPH_EXPAND 함수는 Enrollment에서 Student 및 Course로 바깥쪽으로 순회하여 이 그래프를 평면화할 수 있습니다. 이러한 테이블에서 측정값을 정의하는 경우 측정값 열에서 AGG 함수를 호출하여 과다 계산 없이 집계를 올바르게 계산할 수 있습니다.
측정값이 일치하지 않는 행을 처리하는 방법 선택
연결된 요소 테이블에 일치하는 행이 없으면 해당 테이블의 열은 GRAPH_EXPAND 출력에서 NULL입니다. 예를 들어 과정에 dept_id 값이 없으면 해당 행의 Department 열은 NULL입니다. Department 노드의 측정에 이러한 행이 포함되는지 여부는 측정이 집계하는 스칼라 표현식을 작성하는 위치에 따라 달라집니다.
집계 함수 내에 표현식을 작성하면 일치하는 항목이 없는 행을 포함하여 확장된 출력의 모든 행에 대해 표현식이 평가됩니다.
표현식이 이러한 행 중 하나에 대해 NULL가 아닌 값을 반환하면 해당 값이 결과에 기여합니다.
표현식을 속성으로 정의하고 측정에서 해당 속성을 참조하는 경우 표현식은 노드 테이블의 행에서 평가되고 일치하지 않는 행은 결과에 영향을 미치지 않습니다.
다음 예시에서는 university.Department에서 두 가지 방법으로 동일한 표현식을 정의합니다.
university.Department
  KEY(dept_id)
  PROPERTIES(dept_id, dept_name, college_id, budget,
    COALESCE(budget, 0) AS budget_or_zero,
    -- Includes courses that have no department, as a budget of 0.
    MEASURE(AVG(COALESCE(budget, 0))) AS avg_budget_inline,
    -- Averages only departments that exist.
    MEASURE(AVG(budget_or_zero)) AS avg_budget_property)
두 조치 모두 NULL 예산을 0로 대체합니다. 또한 인라인 양식은 학과가 없는 과정에 대해 생성된 NULL 값을 대체하므로 해당 과정은 예산이 0인 학과로 평균화됩니다. 측정하려는 항목과 일치하는 양식을 선택합니다.
GRAPH_EXPAND 스키마 보기
함수를 호출하지 않고 GRAPH_EXPAND 함수에서 반환된 테이블의 스키마를 보려면 BQ.SHOW_GRAPH_EXPAND_SCHEMA 시스템 프로시져를 사용합니다.
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('university.SchoolGraph', schema);
SELECT schema;
이 프로시저는 각 열의 이름, 유형, 모드로 schema 변수를 채웁니다. 또한 열에서 참조하는 속성이 측정값인지 여부를 나타내고 정의한 설명이나 동의어를 나열합니다.
다음 단계
- 그래프를 만들고 쿼리하는 방법 알아보기
- 그래프 스키마 알아보기