


Mit Messwerten arbeiten
In diesem Dokument wird beschrieben, wie Sie Messwerte in Ihren Diagrammen definieren und abfragen. Mit Measures können Sie dafür sorgen, dass Aggregationen über Joins hinweg korrekt ausgeführt werden.
Übersicht
Ein Messwert ist ein aggregiertes Attribut, das in der PROPERTIES-Klausel einer Knoten- oder Kantentabelle definiert ist. Messwerte werden durch einen Messwertausdruck definiert, der mit dem Schlüsselwort MEASURE um eines der folgenden Elemente erstellt wird:
- ein Aggregatausdruck
- ein Ausdruck, der Aggregatfunktionen mit skalaren Vorgängen kombiniert
- ein abgeleiteter Messwert, d. h. eine Kombination von Messwerten, die in der Funktion
AGGverpackt sind und in derselben Elementtabelle definiert sind
Messwerte unterstützen die folgenden Aggregatfunktionen:
SUMAVGCOUNTMINMAXAGG(für abgeleitete Messwerte)
Alle Aggregatfunktionen außer AGG unterstützen das Schlüsselwort DISTINCT. Weitere Informationen zu unterstützten Messwertausdrücken finden Sie unter measure-Typ.
Messwerte definieren ihre Aggregation in Bezug auf den KEY der Knoten- oder Edge-Tabelle, für die sie definiert sind. Das bedeutet, dass die Aggregation bei der Abfrage eines Messwerts auch dann korrekt durchgeführt wird, wenn die zugrunde liegende Tabelle so verknüpft ist, dass Zeilen dupliziert werden.
Sie können in einer GQL-Abfrage nicht auf ein Attribut verweisen, das durch einen Messwert definiert ist. Stattdessen greifen Sie auf Messwerte zu, indem Sie die GRAPH_EXPAND-TVF aufrufen, um eine relationale Darstellung Ihres Graphen abzufragen. Standardmäßig gibt GRAPH_EXPAND eine vereinfachte Tabellendarstellung Ihres Graphen mit einer Spalte pro Attribut zurück. Sie können auch flatten_results => FALSE angeben, um eine hierarchische Tabelle mit verschachtelten STRUCT-Spalten zurückzugeben. Wenn Ihr Graph mehrere Wurzelknotentabellen enthält, können Sie mit dem Argument start_node angeben, welche Wurzeltabelle durchlaufen werden soll.
Diese Funktion akzeptiert nicht alle Arten von Diagrammen. Weitere Informationen dazu, welche Graphen gültige Eingaben darstellen, finden Sie unter Einschränkungen für Eingaben.
Zum Ausführen von GQL-Abfragen benötigen Sie eine Reservierung mit der Enterprise- oder Enterprise Plus-Version.
Wenn Sie On-Demand-Preise verwenden, können Sie die Funktion GRAPH_EXPAND aufrufen, um SQL-Abfragen für Ihren Graphen auszuführen.
Sie können die AGG-Funktion für die Ausgabe der TVF GRAPH_EXPAND aufrufen, um die Attribute gemäß der im Messwert definierten Aggregation zu aggregieren.
Messwerte definieren
Sie definieren Measures in der PROPERTIES-Klausel einer Knoten- oder Kantentabellendefinition, indem Sie das Schlüsselwort MEASURE() um einen Measure-Ausdruck herum verwenden.
Im folgenden Beispiel wird ein Dataset mit dem Namen university und Tabellen für Hochschulen, Abteilungen und Kurse erstellt:
CREATE SCHEMA IF NOT EXISTS university;

CREATE OR REPLACE TABLE university.College (
  college_id INT64 PRIMARY KEY NOT ENFORCED,
  college_name STRING
);

CREATE OR REPLACE TABLE university.Department (
  dept_id INT64 PRIMARY KEY NOT ENFORCED,
  dept_name STRING,
  college_id INT64,
  budget FLOAT64,
  FOREIGN KEY (college_id) REFERENCES university.College(college_id) NOT ENFORCED
);

CREATE OR REPLACE TABLE university.Course (
  course_id INT64 PRIMARY KEY NOT ENFORCED,
  course_name STRING,
  dept_id INT64,
  credits INT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.College (college_id, college_name)
VALUES (101, 'College of Engineering'),
       (102, 'College of Arts');

INSERT INTO university.Department (dept_id, dept_name, college_id, budget)
VALUES (1001, 'Computer Science', 101, 500000),
       (1002, 'Mechanical Engineering', 101, 400000),
       (1003, 'Fine Arts', 102, 200000),
       (1004, 'Research', 101, 50000);

INSERT INTO university.Course (course_id, course_name, dept_id, credits)
VALUES (1, 'Intro to CS', 1001, 3),
       (2, 'Data Structures', 1001, 4),
       (3, 'Thermodynamics', 1002, 3),
       (4, 'Oil Painting', 1003, 2);
Mit der folgenden Anweisung wird ein Graph mit dem Namen SchoolGraph erstellt, der Messwerte für Attribute in den Knoten Department und Course definiert.
Sie müssen einen Alias für Attribute angeben, die durch eine Messung definiert sind.
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id,
        budget OPTIONS(description="Department budget in USD"),
        MEASURE(SUM(budget)) AS total_budget,
        MEASURE(SUM(budget) * 1.10) AS budget_with_overhead OPTIONS(
          description="Total department budget including 10% overhead",
          extensions=[("unit", "USD"), ("tier", "planning")]
        )),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id,
        course_name,
        credits,
        dept_id,
        MEASURE(AVG(credits)) AS avg_credits,
        MEASURE(SUM(credits)) AS total_credits,
        MEASURE(COUNT(course_id)) AS course_count,
        MEASURE(COUNT(DISTINCT CASE WHEN credits >= 3 THEN course_id ELSE NULL END)) AS major_course_count,
        MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
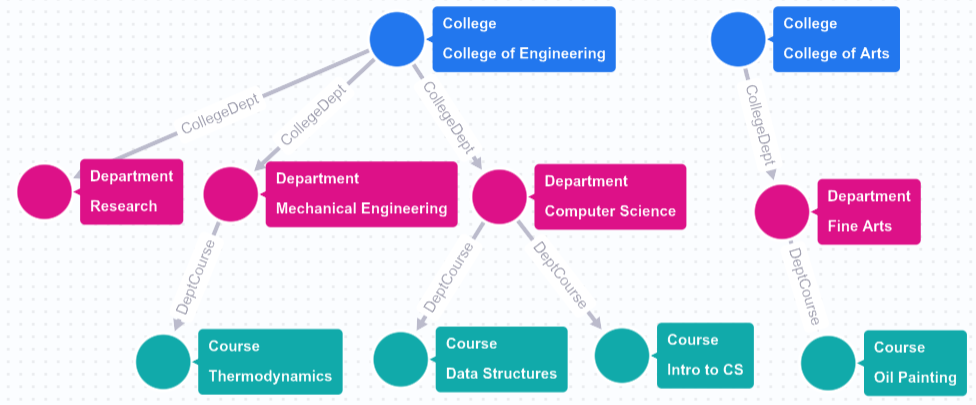
Der Messwert total_budget ist als MEASURE(SUM(budget)) definiert. Der Messwert sperrt die Aggregation auf KEY, also dept_id.
Abgeleitete Messwerte
Ein abgeleiteter Messwert ist ein Messwert, der mit der Funktion AGG() auf andere Messwerte verweist, die in derselben Elementtabelle definiert sind. Mit dieser Funktion können Sie wiederverwendbare Messwerthierarchien erstellen.
In university.Course berechnet der Measure computed_avg_credits beispielsweise das Verhältnis zwischen den Measures total_credits und course_count:
MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits
Abgeleitete Messwerte behalten die Granularitätssperre des zugrunde liegenden Elementschlüssels bei. Messwertabhängigkeiten werden beim Kompilieren des Diagramms aufgelöst. Zirkelbezüge zwischen Messwerten geben einen Fehler zurück.
Informationen zu Mehrfachzählungen
Wenn Sie Tabellen verknüpfen, werden Daten jedes Mal wiederholt, wenn eine 1:n-Beziehung in Ihren Daten vorliegt. Wenn Sie beispielsweise die Tabellen Course, Department und College zusammenführen, wird eine Abteilung mit mehreren Kursen in mehreren Zeilen der Ausgabe angezeigt:
SELECT
  college_name,
  dept_name,
  course_name,
  budget
FROM university.Course
LEFT JOIN university.Department
  ON Course.dept_id = Department.dept_id
LEFT JOIN university.College
  ON Department.college_id = College.college_id;

/*------------------------+------------------------+-----------------+----------+
 | college_name           | dept_name              | course_name     | budget   |
 +------------------------+------------------------+-----------------+----------+
 | College of Engineering | Computer Science       | Intro to CS     | 500000.0 |
 | College of Engineering | Computer Science       | Data Structures | 500000.0 |
 | College of Engineering | Mechanical Engineering | Thermodynamics  | 400000.0 |
 | College of Arts        | Fine Arts              | Oil Painting    | 200000.0 |
 +------------------------+------------------------+-----------------+----------*/
Wenn Sie versuchen, das Gesamtbudget pro Hochschule mit SUM(budget) zu berechnen, wird das Budget der Informatikabteilung doppelt gezählt. Sie können dieses Problem vermeiden, indem Sie die Tabelle Department direkt abfragen. Dieser Ansatz funktioniert jedoch nicht, wenn Sie mehrere Aggregationen aus verschiedenen Tabellen berechnen möchten, die zu Ihren zusammengeführten Daten beitragen. Im folgenden Abschnitt wird gezeigt, wie Measures dieses Problem lösen.
Diagramm mit Messwerten abfragen
Sie können einen Graphen mit Messwerten mithilfe von GQL abfragen. Ihre Abfrage kann jedoch nicht direkt auf ein Attribut verweisen, das durch einen Messwert definiert ist. Die folgende Abfrage verweist beispielsweise auf Knoten, für die Messwertattribute definiert sind, verwendet oder gibt jedoch keine der Messwertfelder zurück:
GRAPH university.SchoolGraph
MATCH (c:College)->(d:Department)->(course:Course)
RETURN c.college_name, d.dept_name, course.course_name;

/*------------------------+------------------------+-----------------+
 | college_name           | dept_name              | course_name     |
 +------------------------+------------------------+-----------------+
 | College of Engineering | Computer Science       | Intro to CS     |
 | College of Engineering | Computer Science       | Data Structures |
 | College of Engineering | Mechanical Engineering | Thermodynamics  |
 | College of Arts        | Fine Arts              | Oil Painting    |
 +------------------------+------------------------+-----------------*/
Wenn Sie mit Messwerten arbeiten möchten, verwenden Sie die Tabellenwertfunktion (TVF) GRAPH_EXPAND, um Ihren Graphen als relationale Tabelle abzufragen:
GRAPH_EXPAND(
  graph_name [, start_node => 'NodeName'] [, flatten_results => TRUE|FALSE]
)
Die Funktion akzeptiert die folgenden Argumente:
graph_name: EinSTRING, der den Namen des Graphen enthält.start_node: Ein optionalerSTRING, der die Startknotentabelle für die Traversierung angibt. Dieses Argument ist erforderlich, wenn der Graph mehrere Stammknotentabellen hat.flatten_results: Ein optionalerBOOL(Standardwert istTRUE):TRUE: Reduziert alle Knoten- und Edge-Attribute auf Spalten oberster Ebene mit<element>_<property>-Präfixen.FALSE: Gibt die Eigenschaften des Stammknotens als Spalten auf oberster Ebene ohne Präfix und verknüpfte Nachbartabellen alsSTRUCT-Spalten zurück.
Vereinfachte Ausgabe verwenden
Wenn flatten_results auf TRUE (Standardmodus) gesetzt ist, werden die Spalten in der Ausgabetabelle benannt, indem das Label der Knoten- oder Kantentabelle und der Attributname verkettet werden, z. B. Course_course_name oder Department_total_budget. Die folgende Abfrage zeigt eine Beispielausgabe der TVF GRAPH_EXPAND:
SELECT
  College_college_name,
  Department_dept_name,
  Department_budget,
  Course_course_name
FROM
  GRAPH_EXPAND("university.SchoolGraph");

/*------------------------+------------------------+-------------------+--------------------+
 | College_college_name   | Department_dept_name   | Department_budget | Course_course_name |
 +------------------------+------------------------+-------------------+--------------------+
 | College of Engineering | Computer Science       | 500000.0          | Intro to CS        |
 | College of Engineering | Computer Science       | 500000.0          | Data Structures    |
 | College of Engineering | Mechanical Engineering | 400000.0          | Thermodynamics     |
 | College of Arts        | Fine Arts              | 200000.0          | Oil Painting       |
 +------------------------+------------------------+-------------------+--------------------*/
Die Funktion GRAPH_EXPAND erzeugt die vereinfachte Tabelle, indem sie eine Reihe von LEFT JOIN-Vorgängen auf Knoten- und Kantentabellen anwendet. Wenn Sie keinen Startknoten angeben, muss der Eingabegraf im Schemabeziehungsgraf eine einzelne Stammknotentabelle haben.
Ebenso muss die Tabelle des Stammknotens eine n:1-Beziehung zu jeder anderen Knotentabelle haben, mit der sie eine Kante teilt.
Daten, die nicht über eine Reihe von Joins von der Stammknotentabelle aus erreichbar sind, werden in der Ausgabe nicht angezeigt. Im vorherigen Beispiel ist Course die Tabelle des Stammknotens. Die Abteilung Research wird in der Ausgabe weggelassen, da sie keine Kurse hat.
Sie können nicht direkt eine Spalte für ein Attribut auswählen, das durch einen Messwert definiert ist.
Stattdessen müssen Sie sie in die AGG()-Funktion einbinden.
Diese Funktion sorgt dafür, dass die für die Messwerte definierte Aggregation genau einmal pro Schlüssel ausgeführt wird.
Mit der folgenden Abfrage werden gleichzeitig das Gesamtbudget und die Gesamtzahl der Kurse für jede Hochschule berechnet:
SELECT
  College_college_name,
  AGG(Department_total_budget) AS college_budget,
  AGG(Course_course_count) AS total_courses
FROM
  GRAPH_EXPAND("university.SchoolGraph")
GROUP BY
  College_college_name;

/*------------------------+----------------+---------------+
 | College_college_name   | college_budget | total_courses |
 +------------------------+----------------+---------------+
 | College of Engineering | 900000.0       | 3             |
 | College of Arts        | 200000.0       | 1             |
 +------------------------+----------------+---------------*/
Hierarchische Ausgabe verwenden
Wenn Sie flatten_results => FALSE angeben, gibt GRAPH_EXPAND eine hierarchische Beziehung anstelle von Spalten mit Präfix zurück:
- Attribute des Start-Stammknotens werden als Spalten auf oberster Ebene ohne Präfix angezeigt (z. B.
course_nameodercredits). - Attribute von verknüpften Nachbartabellen, die Knoten- oder Kantentabellen sein können, werden als verschachtelte
STRUCT-Felder angezeigt, die nach der Elementtabelle benannt sind. Wenn der Startknoten beispielsweiseCourseist, verwenden Sie das Attribut DeptCourse.Department.CollegeDept.College.college_nameto access thecollege_name`. - Messwerte in verschachtelten Strukturen werden mit der Punktnotation in
AGG()abgefragt, z. B.AGG(DeptCourse.Department.total_budget). - Wenn eine Elementtabelle ein Attribut mit demselben Namen wie eine benachbarte Elementtabelle hat, können Sie den Graphen nicht mit
flatten_results => FALSEabfragen. Sie müssen die Ergebnisse stattdessen vereinfachen.
SELECT
  DeptCourse.Department.dept_name AS department_name,
  DeptCourse.Department.CollegeDept.College.college_name,
  AGG(DeptCourse.Department.total_budget) AS total_budget,
  AGG(course_count) AS total_courses
FROM GRAPH_EXPAND(
       "university.SchoolGraph",
       start_node => "Course",
       flatten_results => FALSE)
GROUP BY department_name, college_name;
Mit mehreren Stammknotentabellen arbeiten
Graphen enthalten oft mehrere Stammknotentabellen, auch Faktentabellen genannt, die Dimensionstabellen gemeinsam nutzen. Wenn Sie einen Graphen mit mehreren Stammknotentabellen abfragen möchten, verwenden Sie das Argument start_node in GRAPH_EXPAND. Die Funktion durchläuft den Untergraphen, der vom Startknoten aus erreichbar ist.
Sie können beispielsweise dem Dataset university eine Instructor-Tabelle hinzufügen, die auch mit Department verknüpft ist:
CREATE OR REPLACE TABLE university.Instructor (
  instructor_id INT64 PRIMARY KEY NOT ENFORCED,
  instructor_name STRING,
  dept_id INT64,
  salary FLOAT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.Instructor (instructor_id, instructor_name, dept_id, salary)
VALUES (501, 'Dr. Dana', 1001, 120000),
       (502, 'Dr. Lee', 1001, 110000),
       (503, 'Dr. Taylor', 1002, 115000),
       (504, 'Prof. Izumi', 1003, 90000);
Sie können einen neuen Graphen mit dem Namen university.SchoolGraphMultiRoot erstellen, der die Knotentabelle Instructor und eine Kante von Instructor zu Department enthält:
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraphMultiRoot
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id, budget,
        MEASURE(SUM(budget)) AS total_budget),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id, course_name, credits, dept_id,
        MEASURE(COUNT(course_id)) AS course_count),
    university.Instructor
      KEY(instructor_id)
      PROPERTIES(
        instructor_id, instructor_name, dept_id, salary,
        MEASURE(COUNT(instructor_id)) AS instructor_count,
        MEASURE(SUM(salary)) AS total_salary)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id),
    university.Instructor AS DeptInstructor
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (instructor_id) REFERENCES Instructor (instructor_id)
  );
In diesem Diagramm dienen sowohl Course als auch Instructor als Stammknotentabellen, die mit Department und College verknüpft sind. Sie können einen der beiden Untergraphen mit start_node als Ziel festlegen:
-- Expand the Course subgraph (Course -> Department -> College)
SELECT
  College_college_name,
  AGG(Course_course_count) AS total_courses
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course")
GROUP BY College_college_name;

-- Expand the Instructor subgraph (Instructor -> Department -> College)
SELECT
  College_college_name,
  AGG(Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor")
GROUP BY College_college_name;
Wenn Sie Messwerte über mehrere Faktentabellen hinweg analysieren möchten, fragen Sie jeden Untergraphen mit GRAPH_EXPAND ab und verknüpfen Sie sie über ihre gemeinsamen Dimensionen in Standard-SQL:
SELECT
  C.College_college_name,
  AGG(C.Course_course_count) AS total_courses,
  AGG(I.Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course") AS C
INNER JOIN GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor") AS I
  ON C.Department_dept_id = I.Department_dept_id
GROUP BY C.College_college_name;
Sowohl AGG(C.Course_course_count) als auch AGG(I.Instructor_total_salary) berechnen ihre Aggregationen genau auf der jeweiligen Detailebene, ohne dass der Join sie beeinträchtigt.
Best Practices
Beachten Sie beim Entwerfen eines Diagramms mit Messwerten die folgenden Best Practices:
Knoten und Kanten in einer einzelnen Tabelle definieren
Wir empfehlen, für eine Knotentabellendefinition und die zugehörigen Verbindungskantentabellendefinitionen dieselbe Tabelle zu verwenden. Durch die Wiederverwendung der Tabelle wird eine 1:1-Beziehung zwischen der Knotentabelle und der Kantentabelle sichergestellt. Dadurch wird ein Fan-out verhindert und die Funktion GRAPH_EXPAND ignoriert die Kante nicht als mehrdeutig.
Wenn Sie beispielsweise eine Eingabetabelle Enrollment haben, die Fremdschlüssel enthält, die auf die Tabellen Student und Course verweisen, definieren Sie den Knoten Enrollment und seine ausgehenden Kanten mithilfe der Eingabetabelle Enrollment.
Vermeiden Sie es, unnötige Attribute für Edge-Tabellen zu definieren.
Wenn Sie eine Knotentabelle und eine Kantentabelle mit derselben physischen Tabelle definieren, verwenden Sie die PROPERTIES-Klausel nicht für die Kantentabelle, es sei denn, es gibt neue Informationen, die für die Kante erfasst werden müssen. Da die Knoten- und die Kantentabelle dieselbe physische Tabelle verwenden, sind alle diese Attribute bereits Teil der Knotentabelle.
Wenn Sie redundante Attribute in der Kantentabelle definieren, kann die Funktion GRAPH_EXPAND die Kantentabelle als separate Entität von der freigegebenen Knotentabelle behandeln. Wenn keine neuen Attribute für die Kante erfasst werden müssen, können Sie die Leistung optimieren, indem Sie NO PROPERTIES in der Definition der Kantentabelle angeben.
N:N-Beziehungen als Knotentabellen modellieren
Eine Many-to-Many-Beziehung (M:N) tritt auf, wenn eine Zeile in Tabelle A mehreren Zeilen in Tabelle B entsprechen kann und eine Zeile in Tabelle B mehreren Zeilen in Tabelle A entsprechen kann. Beispielsweise kann sich ein Schüler für mehrere Kurse anmelden und ein Kurs kann viele Schüler haben. Sie können eine m:n-Beziehung mithilfe einer Zwischenverknüpfungstabelle in zwei 1:n-Beziehungen aufteilen. Sie können beispielsweise eine Enrollment-Tabelle definieren, die Fremdschlüssel enthält, die auf die Tabellen Student und Course verweisen. Wenn Sie eine Zwischentabelle als Edge-Tabelle modellieren, die zwei Dimensionstabellen in Ihrer CREATE PROPERTY GRAPH-Anweisung verbindet, wie im folgenden Beispiel, ignoriert die Funktion GRAPH_EXPAND diese Edges, da ihre Beziehung mehrdeutig ist: nicht eindeutig n:1 oder 1:1.
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student,
    university.Course
  )
  EDGE TABLES (
    -- Modeling the junction table as a standalone edge causes ambiguity
    university.Enrollment AS StudentEnrollment
      SOURCE KEY (student_id) REFERENCES Student (student_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
Wenn alle Kanten in einem Diagramm ignoriert werden, schlagen Aufrufe von GRAPH_EXPAND oder BQ.SHOW_GRAPH_EXPAND_SCHEMA mit einem Fehler fehl.
Um eine M:N-Beziehung für Messwerte korrekt zu modellieren, müssen Sie die Zwischentabelle zu einer Knotentabelle heraufstufen. In dieser Struktur dient die Kreuzungsknotentabelle als einzige Wurzelknotentabelle (eine Knotentabelle mit einem Eingangsgrad von null). Definieren Sie dann zwei N:1-Kantentabellen, die die Verknüpfungstabelle gemeinsam nutzen, um N:1 mit jeder der Dimensionsknotentabellen zu verbinden:
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student KEY (student_id),
    university.Course KEY (course_id),
    -- Promote the junction table to a node table (acting as the single root node)
    university.Enrollment KEY (enrollment_id)
  )
  EDGE TABLES (
    -- Share (reuse) the Enrollment table to define N:1 edges to each dimension
    university.Enrollment AS EnrollmentToStudent
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (student_id) REFERENCES Student (student_id),
    university.Enrollment AS EnrollmentToCourse
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
In dieser Struktur dient Enrollment als einzige Stammknotentabelle (In-Degree von null), die N:1 mit den Dimensionstabellen Student und Course (In-Degree von eins) verbindet. Mit der Funktion GRAPH_EXPAND kann dieser Graph vereinfacht werden, indem von Enrollment nach außen zu Student und Course navigiert wird. Wenn Sie Messwerte für eine dieser Tabellen definieren, können Sie die Funktion AGG für die Messwertspalten aufrufen, um die Aggregationen korrekt zu berechnen, ohne dass Werte doppelt gezählt werden.
Festlegen, wie Messwerte mit nicht übereinstimmenden Zeilen umgehen
Wenn eine Zeile keine Übereinstimmung in einer verbundenen Elementtabelle hat, sind die Spalten dieser Tabelle in der GRAPH_EXPAND-Ausgabe NULL. Wenn ein Kurs beispielsweise keinen dept_id-Wert hat, sind die Department-Spalten dieser Zeile NULL. Ob ein Measure auf dem Department-Knoten diese Zeilen enthält, hängt davon ab, wo Sie den skalaren Ausdruck schreiben, den das Measure aggregiert.
Wenn Sie den Ausdruck innerhalb der Aggregatfunktion schreiben, wird er für jede Zeile der erweiterten Ausgabe ausgewertet, einschließlich Zeilen ohne Übereinstimmung.
Wenn der Ausdruck für eine dieser Zeilen einen Wert anstelle von NULL zurückgibt, trägt dieser Wert zum Ergebnis bei.
Wenn Sie den Ausdruck als Attribut definieren und dieses Attribut im Measure referenzieren, wird der Ausdruck für die Zeilen der Knotentabelle ausgewertet. Zeilen ohne Übereinstimmung tragen nicht zum Ergebnis bei.
Im folgenden Beispiel wird derselbe Ausdruck auf beide Arten für university.Department definiert:
university.Department
  KEY(dept_id)
  PROPERTIES(dept_id, dept_name, college_id, budget,
    COALESCE(budget, 0) AS budget_or_zero,
    -- Includes courses that have no department, as a budget of 0.
    MEASURE(AVG(COALESCE(budget, 0))) AS avg_budget_inline,
    -- Averages only departments that exist.
    MEASURE(AVG(budget_or_zero)) AS avg_budget_property)
Bei beiden Maßnahmen wird ein NULL-Budget durch 0 ersetzt. Mit dem Inline-Formular werden auch die NULL-Werte ersetzt, die für einen Kurs ohne Abteilung generiert wurden. Dieser Kurs wird dann als Abteilung mit einem Budget von 0 in den Durchschnitt einbezogen. Wählen Sie das Formular aus, das dem entspricht, was Sie messen möchten.
Schema von GRAPH_EXPAND ansehen
Wenn Sie das Schema der von der Funktion GRAPH_EXPAND zurückgegebenen Tabelle aufrufen möchten, ohne die Funktion aufzurufen, verwenden Sie die Systemprozedur BQ.SHOW_GRAPH_EXPAND_SCHEMA:
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('university.SchoolGraph', schema);
SELECT schema;
Bei diesem Verfahren wird die Variable schema mit dem Namen, dem Typ und dem Modus jeder Spalte gefüllt. Außerdem wird angegeben, ob das Attribut, auf das sich die Spalte bezieht, ein Messwert ist. Außerdem werden alle Beschreibungen oder Synonyme aufgeführt, die Sie dafür definiert haben.