


メジャーを操作する
このドキュメントでは、グラフでメジャーを定義してクエリを実行する方法について説明します。メジャーを使用すると、結合全体で集計が正しく実行されるようにすることができます。
概要
メジャーは、ノードテーブルまたはエッジテーブルの PROPERTIES 句内で定義される集計プロパティです。メジャーは、メジャー式によって定義されます。これは、次のいずれかの MEASURE キーワードを使用して作成されます。
- 集計式
- 集計関数とスカラー演算を組み合わせた式
- 派生メジャー。これは、同じ要素テーブルで定義された
AGG関数でラップされたメジャーの組み合わせです。
メジャーは、次の集計関数をサポートしています。
SUMAVGCOUNTMINMAXAGG(派生メジャーの場合)
AGG を除くすべての集計関数は、DISTINCT キーワードをサポートしています。サポートされているメジャー式の詳細については、メジャータイプをご覧ください。
メジャーは、定義されているノードテーブルまたはエッジテーブルの KEY を参照して集計を定義します。つまり、メジャーをクエリすると、基になるテーブルが重複する行を生成する方法で結合されていても、集計は正しく実行されます。
GQL クエリでメジャーによって定義されたプロパティを参照することはできません。代わりに、GRAPH_EXPAND TVF を呼び出してグラフのリレーショナル表現をクエリすることで、メジャーにアクセスします。デフォルトでは、GRAPH_EXPAND は、プロパティごとに 1 つの列を持つグラフのフラット化されたテーブル表現を返します。flatten_results => FALSE を指定して、ネストされた STRUCT 列を含む階層テーブルを返すこともできます。グラフに複数のルートノード テーブルが含まれている場合は、start_node 引数を指定して、走査するルートテーブルを選択できます。
この関数は、すべてのタイプのグラフを受け入れるわけではありません。有効な入力を形成するグラフの詳細については、入力の制限事項をご覧ください。GQL クエリを実行するには、Enterprise エディションまたは Enterprise Plus エディションを使用する予約が必要です。オンデマンド料金を使用する場合は、GRAPH_EXPAND 関数を呼び出してグラフで SQL クエリを実行できます。
GRAPH_EXPAND TVF の出力で AGG 関数を呼び出して、メジャーで定義された集計に従ってプロパティを集計できます。
メジャーを定義する
メジャーは、ノードテーブルまたはエッジテーブルの定義の PROPERTIES 句内で、メジャー式の周囲に MEASURE() キーワードを使用して定義します。
次の例では、university という名前のデータセットと、大学、学部、コースのテーブルを作成します。
CREATE SCHEMA IF NOT EXISTS university;

CREATE OR REPLACE TABLE university.College (
  college_id INT64 PRIMARY KEY NOT ENFORCED,
  college_name STRING
);

CREATE OR REPLACE TABLE university.Department (
  dept_id INT64 PRIMARY KEY NOT ENFORCED,
  dept_name STRING,
  college_id INT64,
  budget FLOAT64,
  FOREIGN KEY (college_id) REFERENCES university.College(college_id) NOT ENFORCED
);

CREATE OR REPLACE TABLE university.Course (
  course_id INT64 PRIMARY KEY NOT ENFORCED,
  course_name STRING,
  dept_id INT64,
  credits INT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.College (college_id, college_name)
VALUES (101, 'College of Engineering'),
       (102, 'College of Arts');

INSERT INTO university.Department (dept_id, dept_name, college_id, budget)
VALUES (1001, 'Computer Science', 101, 500000),
       (1002, 'Mechanical Engineering', 101, 400000),
       (1003, 'Fine Arts', 102, 200000),
       (1004, 'Research', 101, 50000);

INSERT INTO university.Course (course_id, course_name, dept_id, credits)
VALUES (1, 'Intro to CS', 1001, 3),
       (2, 'Data Structures', 1001, 4),
       (3, 'Thermodynamics', 1002, 3),
       (4, 'Oil Painting', 1003, 2);
次のステートメントは、Department ノードと Course ノードのプロパティのメジャーを定義する SchoolGraph というグラフを作成します。メジャーで定義されたプロパティにはエイリアスを指定する必要があります。
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id,
        budget OPTIONS(description="Department budget in USD"),
        MEASURE(SUM(budget)) AS total_budget,
        MEASURE(SUM(budget) * 1.10) AS budget_with_overhead OPTIONS(
          description="Total department budget including 10% overhead",
          extensions=[("unit", "USD"), ("tier", "planning")]
        )),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id,
        course_name,
        credits,
        dept_id,
        MEASURE(AVG(credits)) AS avg_credits,
        MEASURE(SUM(credits)) AS total_credits,
        MEASURE(COUNT(course_id)) AS course_count,
        MEASURE(COUNT(DISTINCT CASE WHEN credits >= 3 THEN course_id ELSE NULL END)) AS major_course_count,
        MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
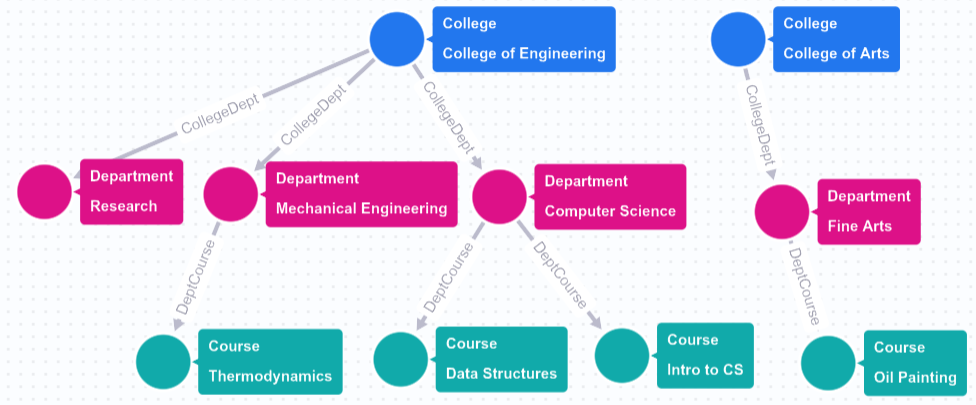
total_budget メジャーは MEASURE(SUM(budget)) として定義されます。このメジャーは、集計を KEY(dept_id)にロックします。
派生メジャー
派生メジャーは、AGG() 関数を使用して、同じ要素テーブルで定義された他のメジャーを参照するメジャーです。この機能を使用すると、再利用可能なメジャー階層を構築できます。
たとえば、university.Course では、computed_avg_credits メジャーはメジャー total_credits と course_count の比率を計算します。
MEASURE(SAFE_DIVIDE(AGG(total_credits), NULLIF(AGG(course_count), 0))) AS computed_avg_credits
派生メジャーは、基になる要素テーブルキーの粒度ロック プロパティを保持します。メジャーの依存関係は、グラフのコンパイル時に解決されます。メジャー間の循環参照はエラーを返します。
過剰カウントについて
テーブルを結合すると、データに 1 対多の関係があるたびにデータが繰り返されます。たとえば、Course、Department、College の各テーブルを結合すると、複数のコースがある学部が出力で複数の行に表示されます。
SELECT
  college_name,
  dept_name,
  course_name,
  budget
FROM university.Course
LEFT JOIN university.Department
  ON Course.dept_id = Department.dept_id
LEFT JOIN university.College
  ON Department.college_id = College.college_id;

/*------------------------+------------------------+-----------------+----------+
 | college_name           | dept_name              | course_name     | budget   |
 +------------------------+------------------------+-----------------+----------+
 | College of Engineering | Computer Science       | Intro to CS     | 500000.0 |
 | College of Engineering | Computer Science       | Data Structures | 500000.0 |
 | College of Engineering | Mechanical Engineering | Thermodynamics  | 400000.0 |
 | College of Arts        | Fine Arts              | Oil Painting    | 200000.0 |
 +------------------------+------------------------+-----------------+----------*/
SUM(budget) を使用して大学ごとの合計予算を計算しようとすると、コンピュータ サイエンス学部の予算が 2 回カウントされます。この問題を回避するには、Department テーブルに直接クエリを実行します。ただし、結合されたデータに寄与する異なるテーブルから複数の集計を計算する場合は、この方法は機能しません。次のセクションでは、メジャーがこの問題を解決する方法について説明します。
メジャーを使用してグラフをクエリする
GQL を使用してメジャーを含むグラフをクエリできますが、クエリでメジャーによって定義されたプロパティを直接参照することはできません。たとえば、次のクエリは、メジャー プロパティが定義されているノードを参照しますが、メジャー フィールドを使用したり、返したりしません。
GRAPH university.SchoolGraph
MATCH (c:College)->(d:Department)->(course:Course)
RETURN c.college_name, d.dept_name, course.course_name;

/*------------------------+------------------------+-----------------+
 | college_name           | dept_name              | course_name     |
 +------------------------+------------------------+-----------------+
 | College of Engineering | Computer Science       | Intro to CS     |
 | College of Engineering | Computer Science       | Data Structures |
 | College of Engineering | Mechanical Engineering | Thermodynamics  |
 | College of Arts        | Fine Arts              | Oil Painting    |
 +------------------------+------------------------+-----------------*/
メジャーを操作するには、GRAPH_EXPAND テーブル値関数(TVF)を使用して、グラフをリレーショナル テーブルとしてクエリします。
GRAPH_EXPAND(
  graph_name [, start_node => 'NodeName'] [, flatten_results => TRUE|FALSE]
)
この関数は、次の引数を受け入れます。
graph_name: グラフの名前を含むSTRING。start_node: トラバーサルの開始ノードテーブルを指定するオプションのSTRING。グラフに複数のルートノード テーブルがある場合、この引数は必須です。flatten_results: 省略可能なBOOL(デフォルトはTRUE):TRUE: すべてのノードとエッジのプロパティを<element>_<property>接頭辞付きの最上位列にフラット化します。FALSE: ルートノードのプロパティを接頭辞のない最上位列として返し、結合された隣接テーブルをSTRUCT列として返します。
フラット化された出力を使用する
flatten_results が TRUE(デフォルト モード)に設定されている場合、出力テーブルの列には、ノードまたはエッジテーブルのラベルとプロパティ名を連結した名前が付けられます(例: Course_course_name、Department_total_budget)。次のクエリは、GRAPH_EXPAND TVF の出力例を示しています。
SELECT
  College_college_name,
  Department_dept_name,
  Department_budget,
  Course_course_name
FROM
  GRAPH_EXPAND("university.SchoolGraph");

/*------------------------+------------------------+-------------------+--------------------+
 | College_college_name   | Department_dept_name   | Department_budget | Course_course_name |
 +------------------------+------------------------+-------------------+--------------------+
 | College of Engineering | Computer Science       | 500000.0          | Intro to CS        |
 | College of Engineering | Computer Science       | 500000.0          | Data Structures    |
 | College of Engineering | Mechanical Engineering | 400000.0          | Thermodynamics     |
 | College of Arts        | Fine Arts              | 200000.0          | Oil Painting       |
 +------------------------+------------------------+-------------------+--------------------*/
GRAPH_EXPAND 関数は、ノードテーブルとエッジテーブルに一連の LEFT JOIN オペレーションを適用して、フラット化されたテーブルを生成します。開始ノードを指定しない場合、入力グラフにはスキーマ関係グラフに 1 つのルートノード テーブルが必要です。同様に、ルートノード テーブルは、エッジを共有する他のすべてのノードテーブルと多対 1 の関係を持つ必要があります。一連の結合を介してルートノード テーブルから到達できないデータは、出力に表示されません。上記の例では、Course がルートノード テーブルです。Research 部門にはコースがないため、出力から除外されています。
メジャーで定義されたプロパティの列を直接選択することはできません。代わりに、AGG() 関数でラップする必要があります。この関数により、メジャーで定義された集計がキーごとに正確に 1 回だけ実行されます。
次のクエリは、各大学の合計予算とコースの合計数を同時に計算します。
SELECT
  College_college_name,
  AGG(Department_total_budget) AS college_budget,
  AGG(Course_course_count) AS total_courses
FROM
  GRAPH_EXPAND("university.SchoolGraph")
GROUP BY
  College_college_name;

/*------------------------+----------------+---------------+
 | College_college_name   | college_budget | total_courses |
 +------------------------+----------------+---------------+
 | College of Engineering | 900000.0       | 3             |
 | College of Arts        | 200000.0       | 1             |
 +------------------------+----------------+---------------*/
階層出力を使用する
flatten_results => FALSE を指定すると、GRAPH_EXPAND は接頭辞付きの列ではなく、階層関係を返します。
- 開始ルートノードのプロパティは、接頭辞のない最上位の列(
course_nameやcreditsなど)として表示されます。 - 結合された隣接テーブル(ノードテーブルまたはエッジテーブル)のプロパティは、要素テーブルにちなんで名付けられたネストされた
STRUCTフィールドとして表示されます。たとえば、開始ノードがCourseの場合、DeptCourse.Department.CollegeDept.College.college_nameto access thecollege_name` プロパティを使用します。 - ネストされた構造体内のメジャーは、
AGG()内でドット表記を使用してクエリされます(例:AGG(DeptCourse.Department.total_budget))。 - 要素テーブルに、隣接する要素テーブルと同じ名前のプロパティがある場合、
flatten_results => FALSEを使用してグラフをクエリすることはできません。代わりに、結果をフラット化する必要があります。
SELECT
  DeptCourse.Department.dept_name AS department_name,
  DeptCourse.Department.CollegeDept.College.college_name,
  AGG(DeptCourse.Department.total_budget) AS total_budget,
  AGG(course_count) AS total_courses
FROM GRAPH_EXPAND(
       "university.SchoolGraph",
       start_node => "Course",
       flatten_results => FALSE)
GROUP BY department_name, college_name;
複数のルートノード テーブルを操作する
グラフには、ディメンション テーブルを共有する複数のルートノード テーブル(ファクト テーブルとも呼ばれます)が含まれていることがよくあります。複数のルートノード テーブルを含むグラフをクエリするには、GRAPH_EXPAND で start_node 引数を使用します。この関数は、開始ノードから到達可能なサブグラフを走査します。
たとえば、Department にもリンクする university データセットに Instructor テーブルを追加できます。
CREATE OR REPLACE TABLE university.Instructor (
  instructor_id INT64 PRIMARY KEY NOT ENFORCED,
  instructor_name STRING,
  dept_id INT64,
  salary FLOAT64,
  FOREIGN KEY (dept_id) REFERENCES university.Department(dept_id) NOT ENFORCED
);

INSERT INTO university.Instructor (instructor_id, instructor_name, dept_id, salary)
VALUES (501, 'Dr. Dana', 1001, 120000),
       (502, 'Dr. Lee', 1001, 110000),
       (503, 'Dr. Taylor', 1002, 115000),
       (504, 'Prof. Izumi', 1003, 90000);
Instructor ノードテーブルと Instructor から Department へのエッジを含む university.SchoolGraphMultiRoot という名前の新しいグラフを作成できます。
CREATE OR REPLACE PROPERTY GRAPH university.SchoolGraphMultiRoot
  NODE TABLES (
    university.College
      KEY(college_id)
      PROPERTIES(college_id, college_name),
    university.Department
      KEY(dept_id)
      PROPERTIES(dept_id, dept_name, college_id, budget,
        MEASURE(SUM(budget)) AS total_budget),
    university.Course
      KEY(course_id)
      PROPERTIES(
        course_id, course_name, credits, dept_id,
        MEASURE(COUNT(course_id)) AS course_count),
    university.Instructor
      KEY(instructor_id)
      PROPERTIES(
        instructor_id, instructor_name, dept_id, salary,
        MEASURE(COUNT(instructor_id)) AS instructor_count,
        MEASURE(SUM(salary)) AS total_salary)
  )
  EDGE TABLES (
    university.Department AS CollegeDept
      SOURCE KEY (college_id) REFERENCES College (college_id)
      DESTINATION KEY (dept_id) REFERENCES Department (dept_id),
    university.Course AS DeptCourse
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id),
    university.Instructor AS DeptInstructor
      SOURCE KEY (dept_id) REFERENCES Department (dept_id)
      DESTINATION KEY (instructor_id) REFERENCES Instructor (instructor_id)
  );
このグラフでは、Course と Instructor の両方が、Department と College にリンクするルートノード テーブルとして機能します。start_node を渡すことで、いずれかのサブグラフをターゲットに設定できます。
-- Expand the Course subgraph (Course -> Department -> College)
SELECT
  College_college_name,
  AGG(Course_course_count) AS total_courses
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course")
GROUP BY College_college_name;

-- Expand the Instructor subgraph (Instructor -> Department -> College)
SELECT
  College_college_name,
  AGG(Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor")
GROUP BY College_college_name;
複数のファクト テーブルにわたる指標を分析するには、GRAPH_EXPAND を使用して各サブグラフをクエリし、標準 SQL で共有ディメンションで結合します。
SELECT
  C.College_college_name,
  AGG(C.Course_course_count) AS total_courses,
  AGG(I.Instructor_total_salary) AS total_faculty_salary
FROM GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Course") AS C
INNER JOIN GRAPH_EXPAND("university.SchoolGraphMultiRoot", start_node => "Instructor") AS I
  ON C.Department_dept_id = I.Department_dept_id
GROUP BY C.College_college_name;
AGG(C.Course_course_count) と AGG(I.Instructor_total_salary) の両方が、結合による干渉を受けずに、それぞれの粒度で集計を正確に計算します。
ベスト プラクティス
メジャーを含むグラフを設計する場合は、次のベスト プラクティスに従ってください。
単一テーブル内でノードとエッジを定義する
ノードテーブルの定義とその接続エッジテーブルの定義には、同じテーブルを使用することをおすすめします。テーブルを再利用すると、ノードテーブルとエッジテーブルの間に 1 対 1(1:1)の関係が確保されます。これにより、ファンアウトが防止され、GRAPH_EXPAND 関数がエッジを曖昧として無視することがなくなります。
たとえば、Student テーブルと Course テーブルを指す外部キーを含む入力テーブル Enrollment がある場合は、Enrollment 入力テーブルを使用して Enrollment ノードとその出力エッジを定義します。
エッジテーブルで不要なプロパティを定義しない
同じ物理テーブルを使用してノードテーブルとエッジテーブルを定義する場合は、エッジでキャプチャする新しい情報がない限り、エッジテーブルで PROPERTIES 句を使用しないでください。ノードテーブルとエッジテーブルは同じ物理テーブルを使用するため、これらのプロパティはすべてノードテーブルの一部になっています。
エッジテーブルに冗長なプロパティを定義すると、GRAPH_EXPAND 関数がエッジテーブルを共有ノードテーブルとは別のエンティティとして扱う可能性があります。パフォーマンスを最適化するには、エッジでキャプチャする新しいプロパティがない場合は、エッジテーブル定義で NO PROPERTIES を指定します。
多対多の関係をノードテーブルとしてモデル化する
多対多(M:N)の関係は、テーブル A の行がテーブル B の複数の行に対応し、テーブル B の行がテーブル A の複数の行に対応する場合に発生します。たとえば、1 人の学生が複数のコースに登録でき、1 つのコースに多くの学生が登録できます。中間ジャンクション テーブルを使用すると、多対多の関係を 2 つの 1 対多の関係に分割できます。たとえば、Student テーブルと Course テーブルを指す外部キーを含む Enrollment テーブルを定義できます。次の例のように、CREATE PROPERTY GRAPH ステートメントで 2 つのディメンション ノードテーブルを接続するエッジテーブルとして中間ジャンクション テーブルをモデル化すると、GRAPH_EXPAND 関数はこれらのエッジを無視します。これは、関係が曖昧で、多対 1 または 1 対 1 が明確でないためです。
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student,
    university.Course
  )
  EDGE TABLES (
    -- Modeling the junction table as a standalone edge causes ambiguity
    university.Enrollment AS StudentEnrollment
      SOURCE KEY (student_id) REFERENCES Student (student_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
グラフ内のすべてのエッジが無視されると、GRAPH_EXPAND または BQ.SHOW_GRAPH_EXPAND_SCHEMA の呼び出しはエラーで失敗します。
メジャーの M:N 関係を正しくモデル化するには、中間ジャンクション テーブルをノードテーブルに昇格させます。この構造では、ジャンクション ノード テーブルが単一のルートノード テーブル(入次数が 0 のノードテーブル)として機能します。次に、ジャンクション テーブルを共有する 2 つの多対 1(N:1)エッジテーブルを定義して、N:1 を各ディメンション ノードテーブルに接続します。
CREATE PROPERTY GRAPH university.SchoolGraph
  NODE TABLES (
    university.Student KEY (student_id),
    university.Course KEY (course_id),
    -- Promote the junction table to a node table (acting as the single root node)
    university.Enrollment KEY (enrollment_id)
  )
  EDGE TABLES (
    -- Share (reuse) the Enrollment table to define N:1 edges to each dimension
    university.Enrollment AS EnrollmentToStudent
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (student_id) REFERENCES Student (student_id),
    university.Enrollment AS EnrollmentToCourse
      SOURCE KEY (enrollment_id) REFERENCES Enrollment (enrollment_id)
      DESTINATION KEY (course_id) REFERENCES Course (course_id)
  );
この構造では、Enrollment は単一のルートノード テーブル(入次数が 0)として機能し、Student ディメンション テーブルと Course ディメンション テーブル(入次数が 1)に N:1 で接続します。GRAPH_EXPAND 関数は、Enrollment から Student と Course に外向きに走査することで、このグラフをフラット化できます。これらのテーブルのいずれかでメジャーを定義する場合は、メジャー列で AGG 関数を呼び出して、過剰カウントなしで集計を正しく計算できます。
メジャーで一致しない行を処理する方法を選択する
行が接続された要素テーブルに一致しない場合、そのテーブルの列は GRAPH_EXPAND 出力で NULL になります。たとえば、コースに dept_id 値がない場合、その行の Department 列は NULL になります。Department ノードのメジャーにこれらの行が含まれるかどうかは、メジャーが集計するスカラー式を記述する場所によって異なります。
集計関数内に式を記述すると、一致しない行を含む、展開された出力のすべての行に対して式が評価されます。式がこれらの行のいずれかに対して NULL 以外の値を返すと、その値が結果に反映されます。
式をプロパティとして定義し、メジャーからそのプロパティを参照すると、式はノードテーブルの行で評価され、一致しない行は結果に影響しません。
次の例では、university.Department で同じ式を両方の方法で定義しています。
university.Department
  KEY(dept_id)
  PROPERTIES(dept_id, dept_name, college_id, budget,
    COALESCE(budget, 0) AS budget_or_zero,
    -- Includes courses that have no department, as a budget of 0.
    MEASURE(AVG(COALESCE(budget, 0))) AS avg_budget_inline,
    -- Averages only departments that exist.
    MEASURE(AVG(budget_or_zero)) AS avg_budget_property)
どちらの指標も、NULL の予算を 0 に置き換えます。インライン フォームは、部門のないコースに対して生成された NULL 値も置き換えます。これにより、そのコースは 0 の予算を持つ部門として平均化されます。測定対象に合ったフォームを選択します。
GRAPH_EXPAND スキーマを表示する
関数を呼び出さずに GRAPH_EXPAND 関数から返されたテーブルのスキーマを表示するには、BQ.SHOW_GRAPH_EXPAND_SCHEMA システム プロシージャを使用します。
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('university.SchoolGraph', schema);
SELECT schema;
この手順では、各列の名前、タイプ、モードを schema 変数に入力します。また、列によって参照されるプロパティがメジャーであるかどうかを示し、定義した説明や類義語を一覧表示します。
次のステップ
- グラフを作成してクエリを実行する方法を確認する。
- グラフスキーマについて確認する。