


Introdução ao framework de resolução de entidades do BigQuery
Com a resolução de entidades do BigQuery, é possível encontrar correspondências de registros em conjuntos de dados compartilhados que não têm um identificador comum. Você também pode usar um provedor de identidade de um parceiro do Google Cloud para aumentar seus dados pessoais compartilhados com outros atributos. Por exemplo, é possível vincular registros de clientes em conjuntos de dados para criar perfis unificados, detectar fraudes financeiras ou analisar cadeias de suprimentos.
Antes de contribuir com dados para uma data clean room, use a resolução de entidade para preparar e corresponder seus registros. A resolução de entidades está disponível nos modelos de preços sob demanda e por capacidade em todas as edições do BigQuery. Para mais informações sobre a implementação, consulte Configurar e usar a resolução de entidades no BigQuery.
Benefícios da resolução de entidades
A resolução de entidades oferece vantagens operacionais e de compartilhamento de dados para usuários finais e provedores de identidade.
Benefícios para os usuários finais
Ao resolver entidades no BigQuery, você tem os seguintes benefícios para o usuário final:
- Resolução no local: você resolve entidades no local sem taxas de transferência de dados. Um provedor de identidade faz a correspondência dos seus dados com o gráfico de identidade dele e grava os resultados da resolução de entidade em um conjunto de dados no seu projeto Google Cloud .
- Operações simplificadas: você evita gerenciar pipelines de extração, transformação e carregamento (ETL) ou fluxos de trabalho de replicação de dados personalizados.
Benefícios do provedor de identidade
Ao oferecer serviços de identidade no BigQuery, você tem os seguintes benefícios do provedor de identidade:
- Integração com o Marketplace: é possível oferecer a resolução de entidades como um produto de software como serviço (SaaS) gerenciado no Google Cloud Marketplace.
- Proteção da propriedade intelectual: você usa seus gráficos de identidade reservados e a lógica de correspondência sem revelá-los aos usuários finais. Essa arquitetura ajuda a proteger sua propriedade intelectual.
Arquitetura de resolução de entidades
O BigQuery implementa a resolução de entidades chamando funções remotas que executam processos de correspondência no ambiente de um provedor de identidade. O BigQuery não copia nem move seus dados durante esse processo.
O diagrama a seguir ilustra o fluxo de trabalho de resolução de entidades entre um projeto Google Cloud do usuário final e um projeto Google Cloud do provedor de identidade:
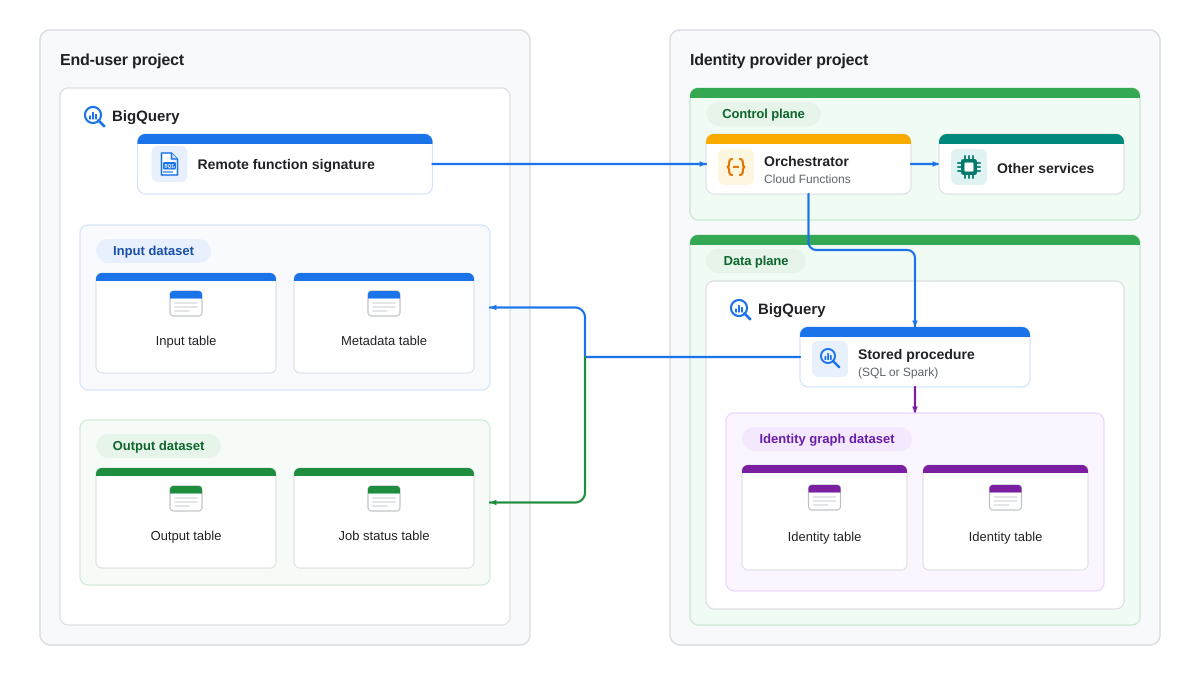
O fluxo de trabalho de resolução de entidades envolve as seguintes etapas:
- Você concede à conta de serviço do provedor de identidade acesso de leitura ao conjunto de dados de entrada e de gravação ao de saída.
- Você chama a função remota para corresponder seus dados de entrada aos dados do gráfico de identidade do provedor de identidade. A função remota transmite seus parâmetros de correspondência ao provedor de identidade.
- A conta de serviço do provedor de identidade lê e processa seu conjunto de dados de entrada.
- A conta de serviço do provedor de identidade grava os resultados da resolução de entidades no conjunto de dados de saída.
Para executar esse fluxo de trabalho, a resolução de entidade depende de componentes no seu ambiente e no ambiente do provedor de identidade.
Componentes do usuário final
Seu projeto Google Cloud contém os seguintes componentes do usuário final:
- Chamada de função remota: uma chamada que executa um procedimento definido e implementado pelo provedor de identidade. Essa chamada inicia o processo de resolução de entidades.
- Conjunto de dados de entrada: o conjunto de origem que contém os dados que você quer corresponder. Como opção, o conjunto de dados de entrada pode conter uma tabela de metadados com parâmetros adicionais. Os provedores de identidade especificam os requisitos de esquema para conjuntos de dados de entrada.
- Conjunto de dados de saída: o conjunto de dados de destino em que o provedor de identidade grava os resultados correspondentes como uma tabela de saída. Opcionalmente, o provedor de identidade pode gravar uma tabela de status do job com detalhes do job nesse conjunto de dados. O conjunto de dados de saída pode ser igual ao de entrada.
Componentes do provedor de identidade
O ambiente do provedor de identidade contém os seguintes componentes:
- Plano de controle: contém uma função remota do BigQuery que orquestra o processo de correspondência. O provedor de identidade pode implementar essa função como um job do Cloud Run ou uma função do Cloud Run. O plano de controle também pode conter serviços de autenticação e autorização.
- Plano de dados: contém o conjunto de dados do gráfico de identidade e o procedimento armazenado que executa a lógica de correspondência. Um gráfico de identidade é um banco de dados de referência de identificadores e atributos de entidades conhecidas. O provedor de identidade pode implementar o procedimento armazenado como um procedimento armazenado do SQL ou um procedimento armazenado do Apache Spark. O conjunto de dados do gráfico de identidade contém as tabelas que o provedor de identidade usa para fazer a correspondência com seus dados.
Considerações
Ao planejar a implantação da resolução de entidades, considere os seguintes fatores:
- Coordenação do provedor de identidade: antes de executar jobs de correspondência, coordene com um provedor de identidade compatível para receber as credenciais da conta de serviço e a assinatura da função remota.
- Bancos de dados externos: os provedores de identidade geralmente hospedam gráficos de identidade no BigQuery, mas também podem armazená-los em bancos de dados externos.
A seguir
- Saiba como configurar e usar a resolução de entidades.
- Saiba como trabalhar com funções remotas.
- Saiba como trabalhar com procedimentos armazenados em SQL.
- Saiba como compartilhar dados sensíveis com data clean rooms.