


Einführung in das BigQuery-Framework zur Identitätsabgleichung
Mit der BigQuery-Entitätsauflösung können Sie Datensätze in freigegebenen Datasets abgleichen, denen eine gemeinsame Kennung fehlt. Sie können auch einen Identitätsanbieter von einem Google Cloud Partner verwenden, um Ihre freigegebenen Daten mit zusätzlichen Attributen zu ergänzen. Sie können beispielsweise Kundendatensätze in verschiedenen Datasets verknüpfen, um einheitliche Kundenprofile zu erstellen, Finanzbetrug zu erkennen oder Lieferketten zu analysieren.
Bevor Sie Daten für einen Data-Clean-Room beitragen, können Sie die Entitätsauflösung verwenden, um Ihre Datensätze vorzubereiten und abzugleichen. Die Entitätsauflösung ist in allen BigQuery-Versionen für On-Demand- und Kapazitätsmodelle verfügbar. Weitere Informationen zur Implementierung finden Sie unter Entitätsauflösung in BigQuery konfigurieren und verwenden.
Vorteile der Identitätsabgleichung
Die Entitätsauflösung bietet sowohl Endnutzern als auch Identitätsanbietern Vorteile in Bezug auf den Betrieb und die gemeinsame Nutzung von Daten.
Vorteile für Endnutzer
Wenn Sie Entitäten in BigQuery auflösen, ergeben sich die folgenden Vorteile für Endnutzer:
- Direkte Auflösung: Sie lösen Entitäten direkt auf, ohne dass Datenübertragungsgebühren anfallen. Ein Identitätsanbieter gleicht Ihre Daten mit seinem Identitätsdiagramm ab und schreibt die Ergebnisse der Entitätsauflösung in ein Dataset in Ihrem Google Cloud -Projekt.
- Vereinfachte Abläufe: Sie müssen keine ETL-Pipelines (Extrahieren, Transformieren, Laden) oder benutzerdefinierte Workflows zur Datenreplikation verwalten.
Vorteile von Identitätsanbietern
Wenn Sie Identitätsdienste in BigQuery anbieten, profitieren Sie von den folgenden Vorteilen als Identitätsanbieter:
- Marketplace-Integration: Sie können die Entitätsauflösung als verwaltetes SaaS-Produkt (Software as a Service) auf dem Google Cloud Marketplace anbieten.
- Schutz des geistigen Eigentums: Sie verwenden Ihre proprietären Identitätsdiagramme und Abgleichslogik, ohne sie Endnutzern preiszugeben. Diese Architektur trägt zum Schutz Ihres geistigen Eigentums bei.
Architektur der Entitätsauflösung
BigQuery implementiert die Identitätsabgleichung durch Aufrufen von Remote-Funktionen, die Abgleichsprozesse in der Umgebung eines Identitätsanbieters ausführen. Ihre Daten werden dabei nicht kopiert oder verschoben.
Das folgende Diagramm veranschaulicht den Workflow für die Entitätsauflösung zwischen einem Endnutzerprojekt Google Cloud und einem Identitätsanbieterprojekt Google Cloud :
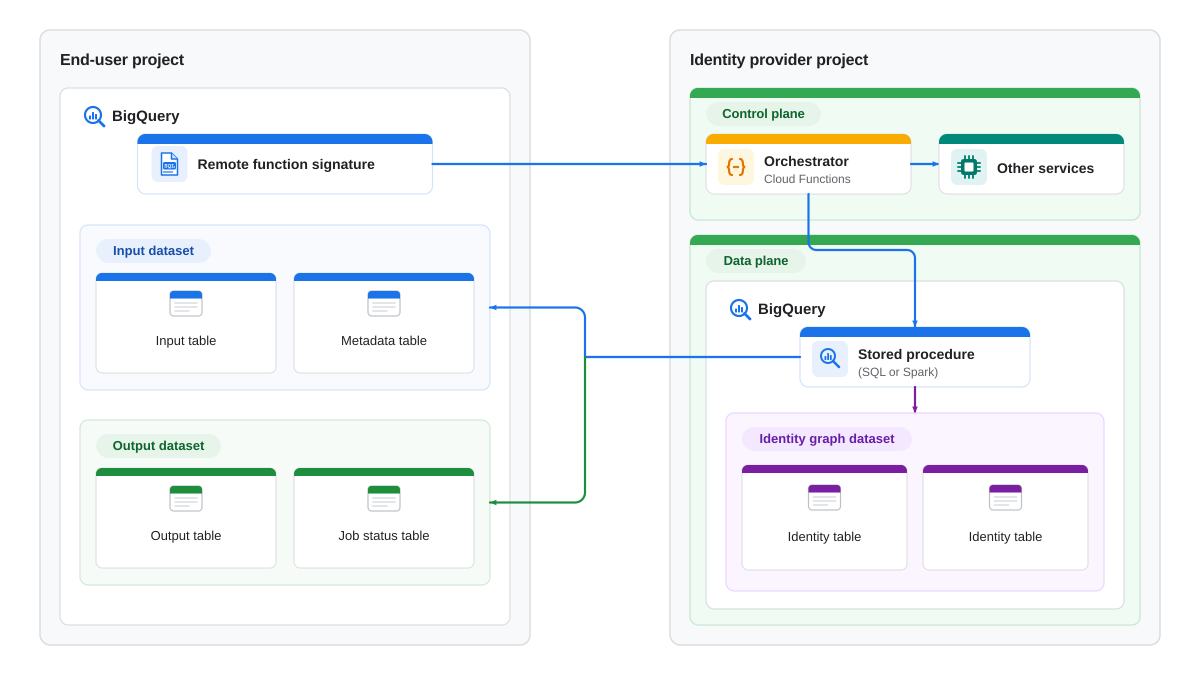
Der Workflow zur Identitätsabgleichung umfasst die folgenden Schritte:
- Sie gewähren dem Dienstkonto des Identitätsanbieters Lesezugriff auf Ihr Eingabe-Dataset und Schreibzugriff auf Ihr Ausgabe-Dataset.
- Sie rufen die Remote-Funktion auf, um Ihre Eingabedaten mit den Daten des Identitätsdiagramms des Identitätsanbieters abzugleichen. Die Remote-Funktion übergibt Ihre entsprechenden Parameter an den Identitätsanbieter.
- Das Dienstkonto des Identitätsanbieters liest und verarbeitet Ihr Eingabe-Dataset.
- Das Dienstkonto des Identitätsanbieters schreibt die Ergebnisse der Identitätsabgleichung in Ihr Ausgabe-Dataset.
Für die Ausführung dieses Workflows ist die Entitätsauflösung auf Komponenten in Ihrer Umgebung und in der Umgebung des Identitätsanbieters angewiesen.
Endnutzerkomponenten
Ihr Google Cloud Projekt enthält die folgenden Endnutzerkomponenten:
- Remote-Funktionsaufruf: Ein Aufruf, mit dem eine Prozedur ausgeführt wird, die vom Identitätsanbieter definiert und implementiert wird. Mit diesem Aufruf wird der Entitätsabgleichsprozess gestartet.
- Eingabe-Dataset: Das Quelldataset, das die Daten enthält, die Sie abgleichen möchten. Optional kann das Eingabe-Dataset eine Metadatentabelle mit zusätzlichen Parametern enthalten. Identitätsanbieter geben die Schemaanforderungen für Eingabedatasets an.
- Ausgabe-Dataset: Das Ziel-Dataset, in das der Identitätsanbieter die abgeglichenen Ergebnisse als Ausgabetabelle schreibt. Optional kann der Identitätsanbieter eine Jobstatustabelle mit Jobdetails in dieses Dataset schreiben. Das Ausgabedataset kann dasselbe Dataset wie das Eingabedataset sein.
Komponenten des Identitätsanbieters
Die Umgebung des Identitätsanbieters enthält die folgenden Komponenten:
- Steuerungsebene: enthält eine BigQuery-Remote-Funktion, die den Abgleichsprozess orchestriert. Der Identitätsanbieter kann diese Funktion als Cloud Run-Job oder Cloud Run-Funktion implementieren. Die Steuerungsebene kann auch Authentifizierungs- und Autorisierungsdienste enthalten.
- Datenebene: Enthält das Dataset mit dem Identitätsdiagramm und die gespeicherte Prozedur, in der die Abgleichslogik ausgeführt wird. Ein Identitätsdiagramm ist eine Referenzdatenbank mit bekannten Entitäts-IDs und Attributen. Der Identitätsanbieter kann die gespeicherte Prozedur als gespeicherte SQL-Prozedur oder als gespeicherte Apache Spark-Prozedur implementieren. Das Dataset für den Identitätsgraph enthält die Tabellen, die der Identitätsanbieter mit Ihren Daten abgleicht.
Hinweise
Berücksichtigen Sie bei der Planung der Bereitstellung der Identitätsabgleichs die folgenden Faktoren:
- Abstimmung mit dem Identitätsanbieter: Bevor Sie Abgleichsjobs ausführen, müssen Sie sich mit einem unterstützten Identitätsanbieter abstimmen, um dessen Dienstkontoanmeldedaten und die Signatur der Remote-Funktion zu erhalten.
- Externe Datenbanken: Identitätsanbieter hosten Identitätsdiagramme in der Regel in BigQuery, können sie aber auch in externen Datenbanken speichern.
Nächste Schritte
- Informationen zum Konfigurieren und Verwenden der Entitätsauflösung
- Mit Remote-Funktionen arbeiten
- Mit gespeicherten SQL-Prozeduren arbeiten
- Weitere Informationen zum Teilen vertraulicher Daten mit Data-Clean-Rooms