המחשה חזותית של תרשימים באמצעות BigQuery DataFrames

אתם יכולים להשתמש בספריית הוויזואליזציה של BigQuery DataFrames כדי לשרטט סוגים שונים של תרשימים, וכך לחקור ולהבין את הנתונים באופן חזותי. ה-API של bigframes.pandas מאפשר לשלב בצורה חלקה פעולות סטטיסטיות מתקדמות עם כלי שרטוט מוכרים של Python, כולל דגימה מובנית של מערכי נתונים גדולים.

היסטוגרמה

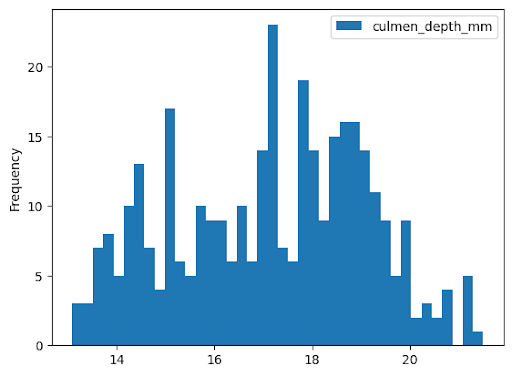
בדוגמה הבאה, קוראים נתונים מהטבלה bigquery-public-data.ml_datasets.penguins כדי לשרטט היסטוגרמה של התפלגות עומקי המקור של הפינגווינים:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")
penguins["culmen_depth_mm"].plot.hist(bins=40)

דוגמה להיסטוגרמה ב-BigQuery DataFrames.

תרשים קו

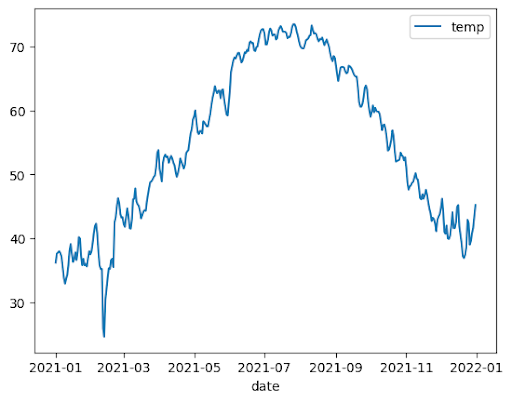
בדוגמה הבאה נעשה שימוש בנתונים מהטבלה bigquery-public-data.noaa_gsod.gsod2021 כדי לשרטט תרשים קו של השינויים בטמפרטורה החציונית במהלך השנה:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line()

דוגמה לתרשים קו ב-BigQuery DataFrames.

תרשים שטח

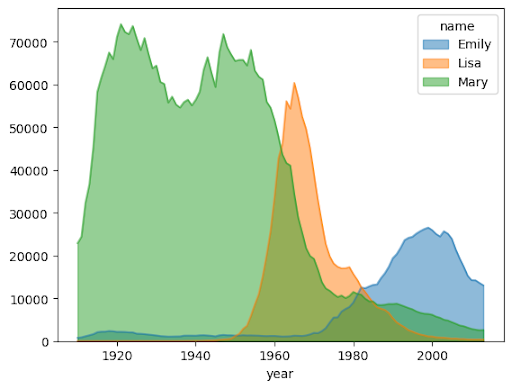
בדוגמה הבאה נעשה שימוש בטבלה bigquery-public-data.usa_names.usa_1910_2013 כדי לעקוב אחרי הפופולריות של שמות בהיסטוריה של ארה"ב, תוך התמקדות בשמות Mary, Emily ו-Lisa:
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(stacked=False, alpha=0.5)

דוגמה לתרשים שטח ב-BigQuery DataFrames.

תרשים עמודות

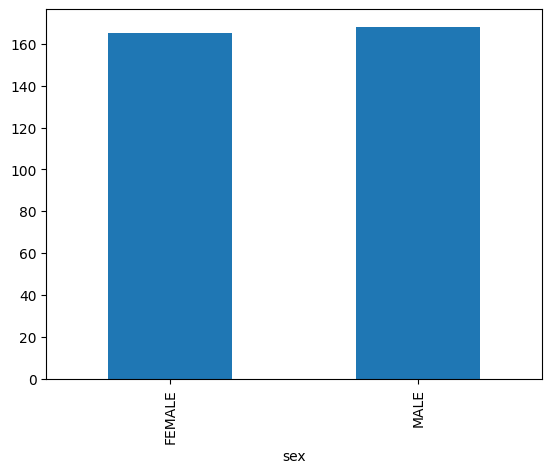
בדוגמה הבאה משתמשים בטבלה bigquery-public-data.ml_datasets.penguins כדי להציג באופן חזותי את התפלגות המינים של הפינגווינים:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")

penguin_count_by_sex = (
    penguins[penguins["sex"].isin(("MALE", "FEMALE"))]
    .groupby("sex")["species"]
    .count()
)
penguin_count_by_sex.plot.bar()

דוגמה לתרשים עמודות ב-BigQuery DataFrames.

תרשים פיזור

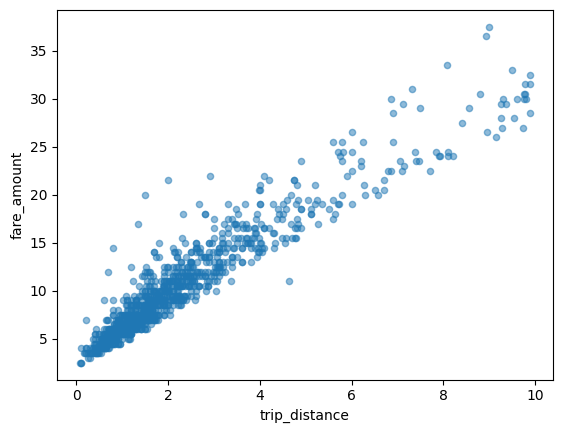
בדוגמה הבאה נעשה שימוש בטבלה bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021 כדי לבחון את הקשר בין סכומי התעריפים של המוניות לבין מרחקי הנסיעה:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you will also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips.plot.scatter(x="trip_distance", y="fare_amount", alpha=0.5)

דוגמה לתרשים פיזור ב-BigQuery DataFrames.

המחשה של קבוצת נתונים גדולה

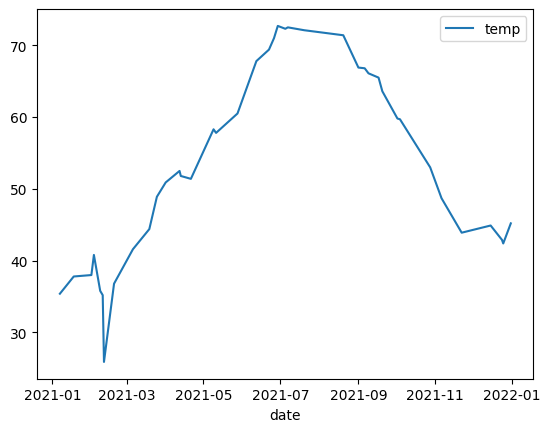
‫BigQuery DataFrames מוריד נתונים למחשב המקומי שלכם לצורך תצוגה חזותית. כברירת מחדל, מספר נקודות הנתונים שאפשר להוריד מוגבל ל-1,000. אם מספר הנקודות על הגרף חורג מהמגבלה, BigQuery DataFrames דוגם באופן אקראי את מספר הנקודות על הגרף ששווה למגבלה.

אפשר לשנות את המגבלה הזו על ידי הגדרת הפרמטר sampling_n כשמשרטטים תרשים, כמו בדוגמה הבאה:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line(sampling_n=40)

דוגמה לתרשים קו שממחיש באופן חזותי מערך נתונים גדול ב-BigQuery DataFrames.

שרטוט מתקדם עם פרמטרים של pandas ו-Matplotlib

אפשר להעביר עוד פרמטרים כדי לשפר את התרשים, כמו ב-pandas, כי ספריית השרטוט של BigQuery DataFrames מבוססת על pandas ו-Matplotlib. בקטעים הבאים מפורטות דוגמאות.

תרשים עם עלילות משנה שמציג את מגמת הפופולריות של שמות

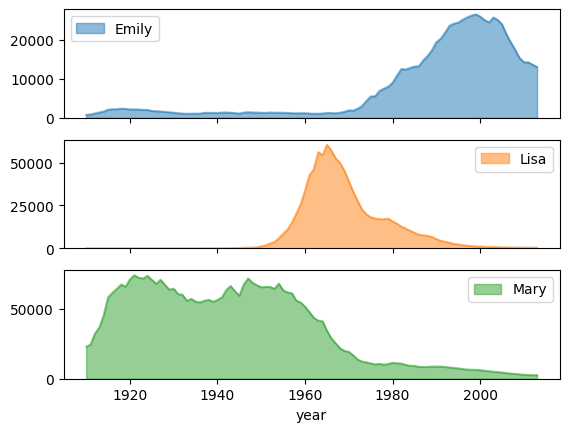
בדוגמה הבאה, שמשתמשת בנתוני ההיסטוריה של השמות מהדוגמה של תרשים השטח, נוצרים תרשימים נפרדים לכל שם על ידי הגדרת subplots=True בבקשה להפעלת פונקציה plot.area():
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(subplots=True, alpha=0.5)

דוגמה לתרשימים נפרדים עם תרשימי משנה ב-BigQuery DataFrames.

תרשים פיזור של נסיעות במונית עם כמה מימדים

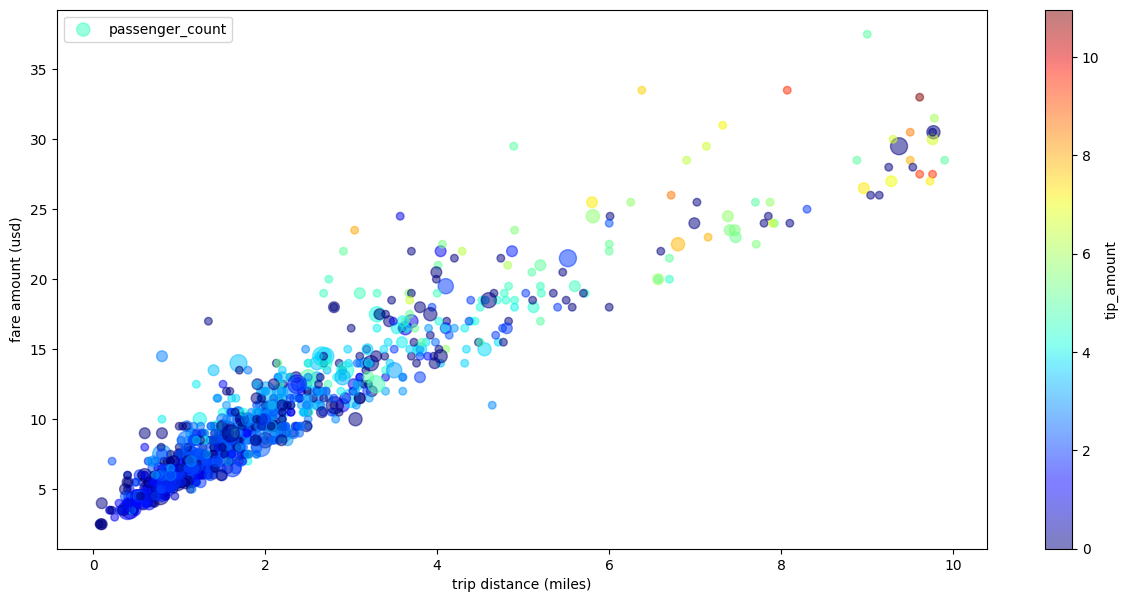
בדוגמה הבאה, שמשתמשת בנתונים מהדוגמה של תרשים הפיזור, משנים את השמות של התוויות בציר ה-X ובציר ה-Y, משתמשים בפרמטר passenger_count לגודל הנקודות, משתמשים בנקודות צבעוניות עם הפרמטר tip_amount ומשנים את גודל התרשים:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips["passenger_count_scaled"] = taxi_trips["passenger_count"] * 30

taxi_trips.plot.scatter(
    x="trip_distance",
    xlabel="trip distance (miles)",
    y="fare_amount",
    ylabel="fare amount (usd)",
    alpha=0.5,
    s="passenger_count_scaled",
    label="passenger_count",
    c="tip_amount",
    cmap="jet",
    colorbar=True,
    legend=True,
    figsize=(15, 7),
    sampling_n=1000,
)

דוגמה לתרשים פיזור עם כמה מאפיינים ב-BigQuery DataFrames.

המאמרים הבאים