Diagramme mit BigQuery DataFrames visualisieren

Mit der BigQuery DataFrames-Visualisierungsbibliothek können Sie verschiedene Arten von Diagrammen erstellen, um Ihre Daten visuell zu untersuchen und zu verstehen. Mit der bigframes.pandas API können Sie erweiterte statistische Vorgänge nahtlos mit vertrauten Python-Plotting-Tools kombinieren, einschließlich integrierter Stichproben für große Datasets.

Histogramm

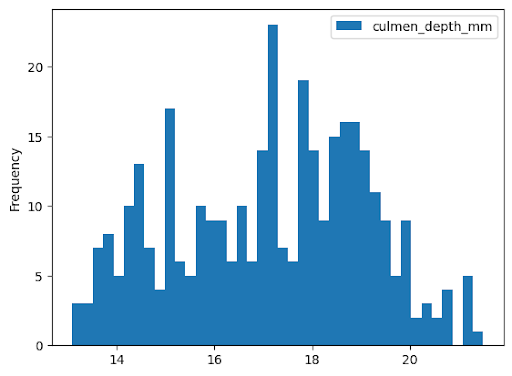
Im folgenden Beispiel werden Daten aus der Tabelle bigquery-public-data.ml_datasets.penguins gelesen, um ein Histogramm zur Verteilung der Schnabeltiefe von Pinguinen zu erstellen:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")
penguins["culmen_depth_mm"].plot.hist(bins=40)

Beispiel für ein Histogramm in BigQuery DataFrames.

Liniendiagramm

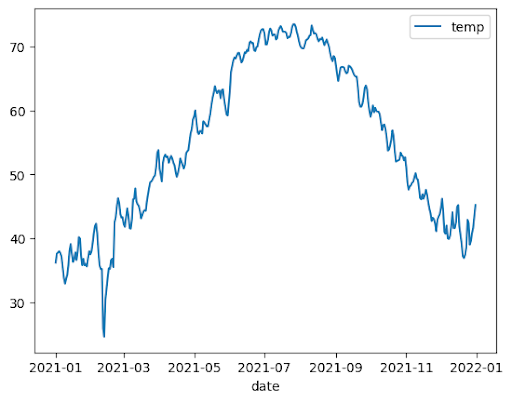
Im folgenden Beispiel werden Daten aus der Tabelle bigquery-public-data.noaa_gsod.gsod2021 verwendet, um ein Liniendiagramm der mittleren Temperaturänderungen im Laufe des Jahres zu erstellen:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line()

Beispiel für ein Liniendiagramm in BigQuery DataFrames.

Flächendiagramm

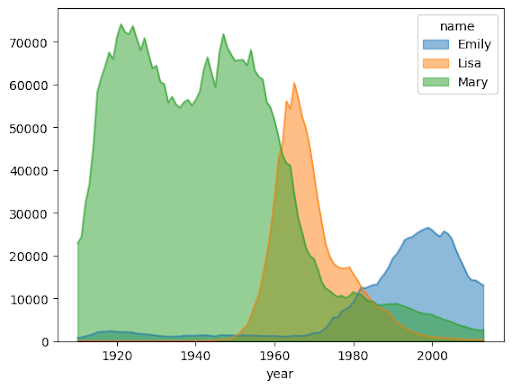
Im folgenden Beispiel wird die Tabelle bigquery-public-data.usa_names.usa_1910_2013 verwendet, um die Beliebtheit von Namen in der Geschichte der USA zu verfolgen. Dabei liegt der Fokus auf den Namen Mary, Emily und Lisa:
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(stacked=False, alpha=0.5)

Beispiel für ein Flächendiagramm in BigQuery DataFrames.

Balkendiagramm

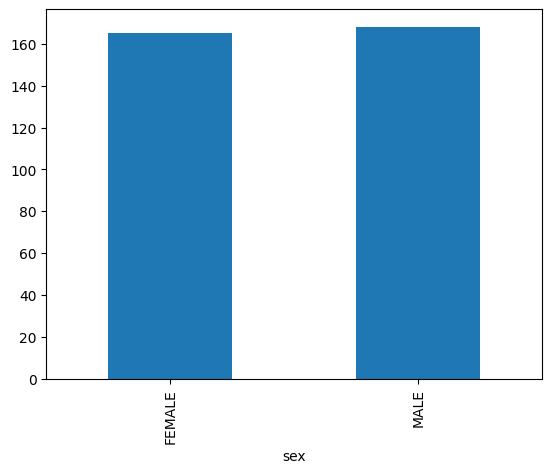
Im folgenden Beispiel wird die Tabelle bigquery-public-data.ml_datasets.penguins verwendet, um die Verteilung der Geschlechter von Pinguinen zu visualisieren:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")

penguin_count_by_sex = (
    penguins[penguins["sex"].isin(("MALE", "FEMALE"))]
    .groupby("sex")["species"]
    .count()
)
penguin_count_by_sex.plot.bar()

Beispiel für ein Balkendiagramm in BigQuery DataFrames.

Streudiagramm

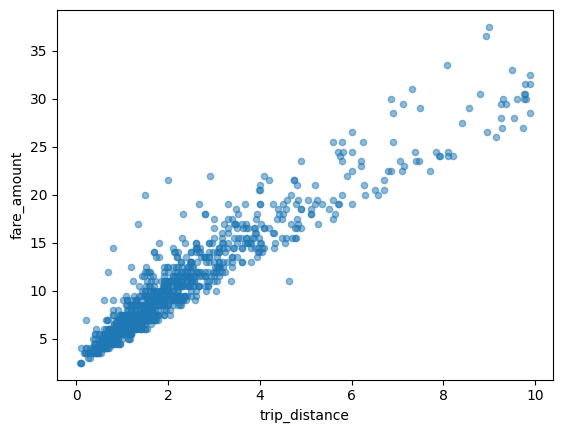
Im folgenden Beispiel wird die Tabelle bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021 verwendet, um die Beziehung zwischen Taxifahrpreisen und Fahrstrecken zu untersuchen:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you will also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips.plot.scatter(x="trip_distance", y="fare_amount", alpha=0.5)

Beispiel für ein Streudiagramm in BigQuery DataFrames.

Großes Dataset visualisieren

BigQuery DataFrames lädt Daten zur Visualisierung auf Ihren lokalen Computer herunter. Die Anzahl der herunterzuladenden Datenpunkte ist standardmäßig auf 1.000 begrenzt. Wenn die Anzahl der Datenpunkte die Obergrenze überschreitet, werden in BigQuery DataFrames zufällig so viele Datenpunkte ausgewählt, wie die Obergrenze zulässt.

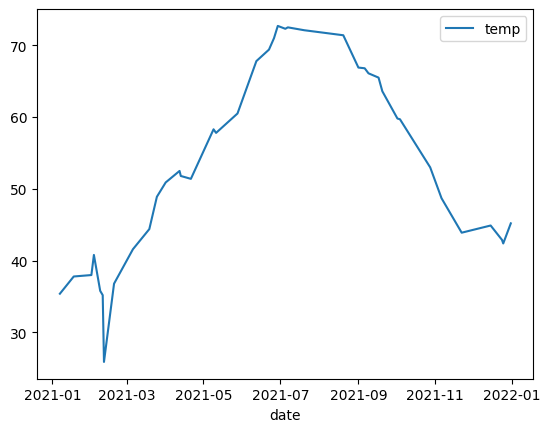
Sie können diese Obergrenze überschreiben, indem Sie beim Zeichnen eines Diagramms den Parameter sampling_n festlegen, wie im folgenden Beispiel gezeigt:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line(sampling_n=40)

Beispiel für ein Liniendiagramm, das ein großes Dataset in BigQuery DataFrames visualisiert.

Erweiterte Diagrammerstellung mit Pandas- und Matplotlib-Parametern

Sie können weitere Parameter übergeben, um Ihr Diagramm wie mit Pandas zu optimieren, da die Plotting-Bibliothek von BigQuery DataFrames auf Pandas und Matplotlib basiert. In den folgenden Abschnitten werden Beispiele beschrieben.

Trend der Namensbeliebtheit mit Unterdiagrammen

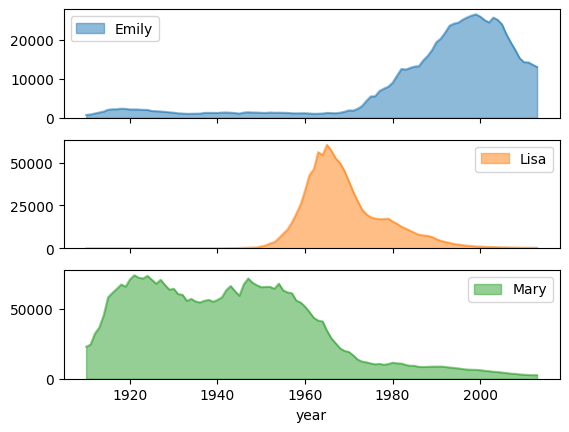
Im folgenden Beispiel werden die Namensverlaufsdaten aus dem Beispiel für ein Flächendiagramm verwendet, um für jeden Namen ein eigenes Diagramm zu erstellen. Dazu wird im Funktionsaufruf plot.area() der Wert subplots=True festgelegt:
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(subplots=True, alpha=0.5)

Beispiel für einzelne Diagramme mit Unterdiagrammen in BigQuery DataFrames.

Streudiagramm für Taxifahrten mit mehreren Dimensionen

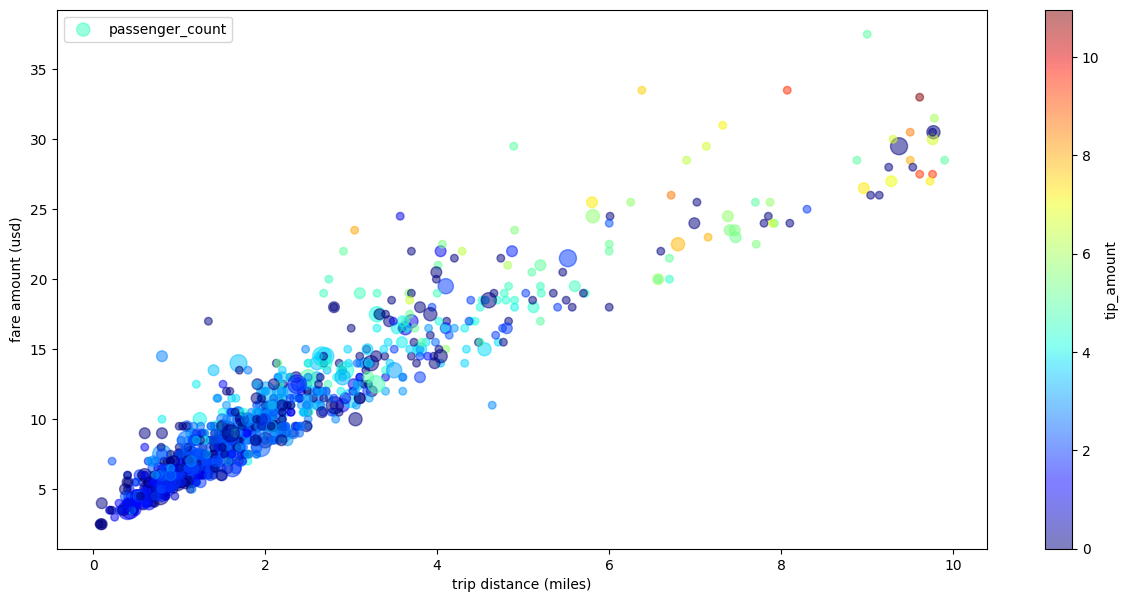
Im folgenden Beispiel werden die Daten aus dem Beispiel für ein Streudiagramm verwendet. Die Labels für die x- und y-Achse werden umbenannt, der Parameter passenger_count wird für die Punktgrößen verwendet, Farbpunkte werden mit dem Parameter tip_amount verwendet und die Größe der Abbildung wird angepasst:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips["passenger_count_scaled"] = taxi_trips["passenger_count"] * 30

taxi_trips.plot.scatter(
    x="trip_distance",
    xlabel="trip distance (miles)",
    y="fare_amount",
    ylabel="fare amount (usd)",
    alpha=0.5,
    s="passenger_count_scaled",
    label="passenger_count",
    c="tip_amount",
    cmap="jet",
    colorbar=True,
    legend=True,
    figsize=(15, 7),
    sampling_n=1000,
)

Beispiel für ein Streudiagramm mit mehreren Dimensionen in BigQuery DataFrames.

Nächste Schritte