


Visualiser des graphiques à l'aide de BigQuery DataFrames
Vous pouvez utiliser la bibliothèque de visualisation BigQuery DataFrames pour tracer différents types de graphiques afin d'explorer et de comprendre visuellement vos données. L'API bigframes.pandas vous permet de combiner facilement des opérations statistiques avancées avec des outils de traçage Python familiers, y compris l'échantillonnage intégré pour les grands ensembles de données.
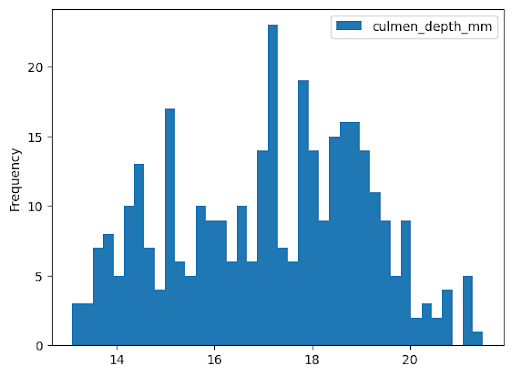
Histogramme
L'exemple suivant lit les données de la table bigquery-public-data.ml_datasets.penguins pour tracer un histogramme de la distribution de la profondeur du culmen des manchots :
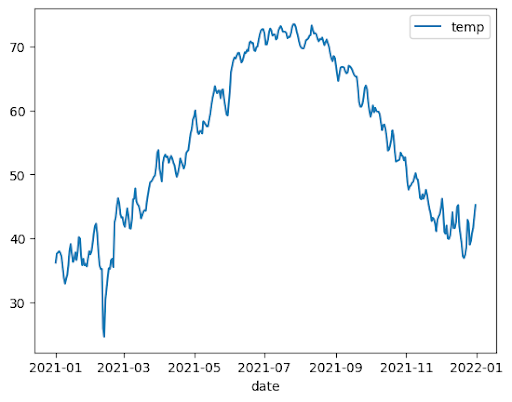
Graphique en courbes
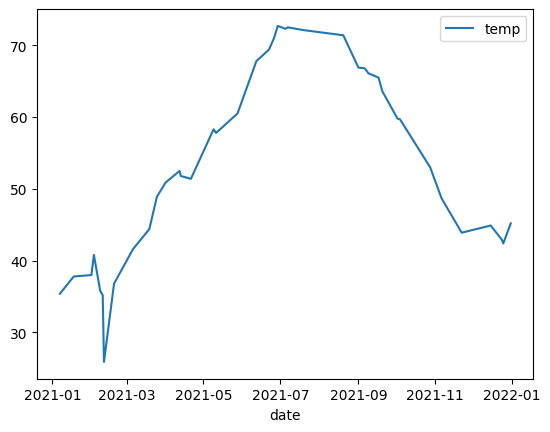
L'exemple suivant utilise les données de la table bigquery-public-data.noaa_gsod.gsod2021 pour tracer un graphique en courbes des changements de température médiane tout au long de l'année :
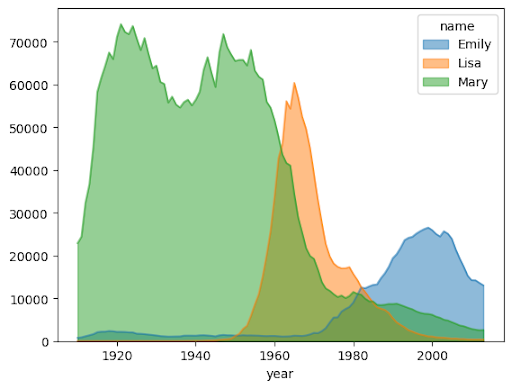
Graphique en aires
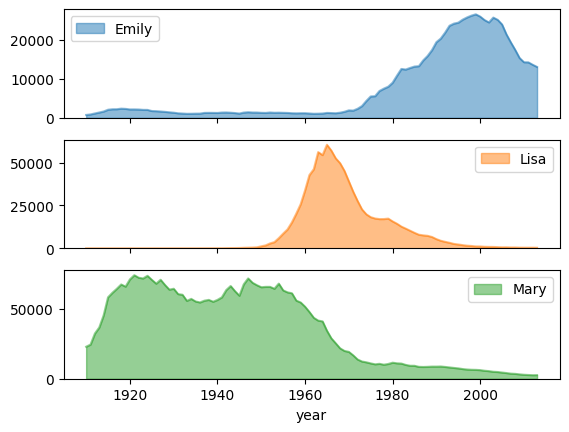
L'exemple suivant utilise la table bigquery-public-data.usa_names.usa_1910_2013 pour suivre la popularité des prénoms dans l'histoire des États-Unis et se concentre sur les prénoms Mary, Emily et Lisa :
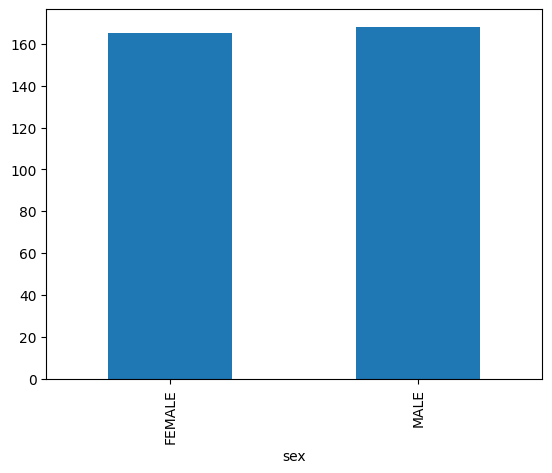
Graphique à barres
L'exemple suivant utilise la table bigquery-public-data.ml_datasets.penguins pour visualiser la répartition des sexes des manchots :
Graphique à nuage de points
L'exemple suivant utilise la table bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021 pour explorer la relation entre le montant des courses en taxi et la distance parcourue :
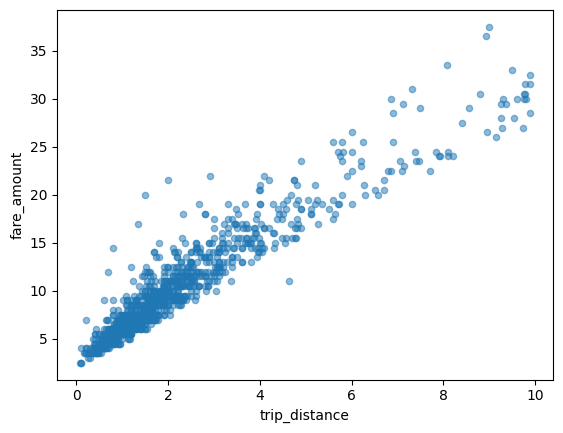
Visualiser un ensemble de données volumineux
BigQuery DataFrames télécharge les données sur votre ordinateur local pour les visualiser. Le nombre de points de données à télécharger est limité à 1 000 par défaut. Si le nombre de points de données dépasse la limite, BigQuery DataFrames échantillonne de manière aléatoire le nombre de points de données égal à la limite.
Vous pouvez remplacer cette limite en définissant le paramètre sampling_n lors du traçage d'un graphique, comme illustré dans l'exemple suivant :
Tracé avancé avec les paramètres pandas et Matplotlib
Vous pouvez transmettre d'autres paramètres pour affiner votre graphique, comme vous le feriez avec pandas, car la bibliothèque de traçage de BigQuery DataFrames est optimisée par pandas et Matplotlib. Les sections suivantes décrivent des exemples.
Tendance de popularité des noms avec des sous-graphiques
En utilisant les données de l'historique des noms de l'exemple de graphique en aires, l'exemple suivant crée des graphiques individuels pour chaque nom en définissant subplots=True dans l'appel de fonction plot.area() :
Graphique à nuage de points des courses en taxi avec plusieurs dimensions
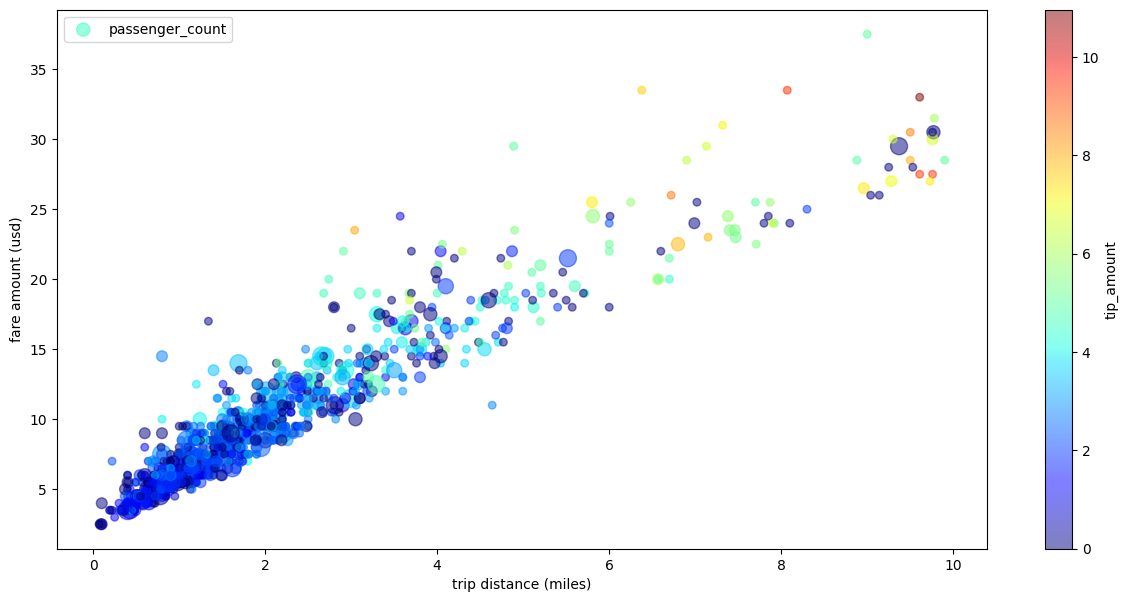
En utilisant les données de l'exemple de graphique à nuage de points, l'exemple suivant renomme les étiquettes des axes X et Y, utilise le paramètre passenger_count pour la taille des points, utilise des points de couleur avec le paramètre tip_amount et redimensionne la figure :
Étapes suivantes
- En savoir plus sur BigQuery DataFrames.
- Découvrez comment utiliser BigQuery DataFrames dans dbt.
- Explorez la documentation de référence de l'API BigQuery DataFrames.