


Personnaliser les fonctions Python pour BigQuery DataFrames
La personnalisation des fonctions Python pour BigQuery DataFrames vous permet de transformer votre code en artefacts BigQuery évolutifs, tels que des fonctions définies par l'utilisateur (UDF) ou des fonctions distantes. Vous pouvez déployer ces fonctions personnalisées pour exploiter des bibliothèques Open Source et effectuer des opérations qui dépassent les capacités des API SQL standard.
Rôles requis
Pour obtenir les autorisations nécessaires pour effectuer les tâches décrites dans ce document, demandez à votre administrateur de vous accorder les rôles IAM suivants sur votre projet :
- Éditeur de données BigQuery (
roles/bigquery.dataEditor) - Administrateur de connexion BigQuery (
roles/bigquery.connectionAdmin) - Développeur Cloud Functions (
roles/cloudfunctions.developer) -
Utilisateur du compte de service (
roles/iam.serviceAccountUser) - Lecteur des objets Storage (
roles/storage.objectViewer)
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Vous pouvez également obtenir les autorisations requises avec des rôles personnalisés ou d'autres rôles prédéfinis.
Fonctions définies par l'utilisateur
Avec les fonctions définies par l'utilisateur (preview), vous pouvez transformer votre fonction Python personnalisée en fonction définie par l'utilisateur Python. Pour obtenir un exemple d'utilisation, consultez Créer une UDF Python persistante.
La création d'une UDF dans BigQuery DataFrames crée une routine BigQuery en tant qu'UDF Python dans l'ensemble de données spécifié. Pour obtenir la liste complète des paramètres compatibles, consultez bigframes.pandas.udf.
Conditions requises
Pour utiliser une UDF BigQuery DataFrames, activez l'API BigQuery dans votre projet. Si vous fournissez le paramètre bigquery_connection dans votre projet, vous devez également activer l'API BigQuery Connection.
Effectuer un nettoyage
En plus de nettoyer les artefacts cloud directement dans la console Google Cloud ou avec d'autres outils, vous pouvez nettoyer les UDF BigQuery DataFrames créées avec un argument de nom explicite à l'aide de la commande bigframes.pandas.get_global_session().bqclient.delete_routine(routine_id).
Limites
- Le code de l'UDF doit être autonome, ce qui signifie qu'il ne doit pas contenir de références à une importation ou à une variable définie en dehors du corps de la fonction.
- Le code de la UDF;utilisateur doit être compatible avec Python 3.11, car il s'agit de l'environnement dans lequel le code est exécuté dans le cloud.
- La réexécution du code de définition de la UDF définie par l'utilisateur après des modifications mineures dans le code de la fonction (par exemple, renommer une variable ou insérer une nouvelle ligne) entraîne la recréation de la UDF, même si ces modifications n'ont aucune incidence sur le comportement de la fonction.
- Le code utilisateur est visible par les utilisateurs disposant d'un accès en lecture aux routines BigQuery. Vous ne devez donc inclure du contenu sensible qu'avec précaution.
- Un projet peut contenir jusqu'à 1 000 fonctions Cloud Run à la fois dans un emplacement BigQuery.
L'UDF BigQuery DataFrames déploie une fonction Python BigQuery définie par l'utilisateur, et les limites associées s'appliquent.
Fonctions distantes
BigQuery DataFrames vous permet de transformer vos fonctions scalaires personnalisées en fonctions distantes BigQuery. Pour obtenir un exemple d'utilisation, consultez Créer une fonction distante. Pour obtenir la liste complète des paramètres compatibles, consultez remote_function.
La création d'une fonction distante dans BigQuery DataFrames crée les éléments suivants :
- Une fonction Cloud Run
une connexion BigQuery.
Par défaut, une connexion nommée
bigframes-default-connectionest utilisée. Si vous préférez, vous pouvez utiliser une connexion BigQuery préconfigurée. Dans ce cas, la création de la connexion est ignorée. Le compte de service de la connexion par défaut se voit attribuer le rôle Cloud Run (roles/run.invoker).Une fonction distante BigQuery qui utilise la fonction Cloud Run créée avec la connexion BigQuery.
Conditions requises
Pour utiliser les fonctions distantes BigQuery DataFrames, vous devez activer les API suivantes :
- API BigQuery (
bigquery.googleapis.com) - API BigQuery Connection (
bigqueryconnection.googleapis.com) - API Cloud Functions (
cloudfunctions.googleapis.com) - API Cloud Run Admin (
run.googleapis.com) - API Artifact Registry (
artifactregistry.googleapis.com) - API Cloud Build (
cloudbuild.googleapis.com) - API Compute Engine (
compute.googleapis.com) - API Cloud Resource Manager (
cloudresourcemanager.googleapis.com)
Lorsque vous utilisez des fonctions distantes BigQuery DataFrames, vous devez disposer du rôle d'administrateur IAM du projet (roles/resourcemanager.projectIamAdmin) si vous utilisez une connexion BigQuery par défaut, ou du rôle de navigateur (roles/browser) si vous utilisez une connexion préconfigurée. Vous pouvez éviter cette exigence en définissant l'option bigframes.pandas.options.bigquery.skip_bq_connection_check sur True. Dans ce cas, la connexion (par défaut ou préconfigurée) est utilisée telle quelle, sans aucune vérification d'existence ni d'autorisation. Si vous utilisez la connexion préconfigurée et que vous ignorez la vérification de connexion, vérifiez les points suivants :
- La connexion est créée au bon emplacement.
- Si vous utilisez des fonctions distantes BigQuery DataFrames, le compte de service dispose du rôle Demandeur Cloud Run (
roles/run.invoker) sur le projet.
Afficher et gérer les connexions
Les connexions BigQuery sont créées au même emplacement que la session BigQuery DataFrames, en utilisant le nom que vous fournissez dans la définition de la fonction personnalisée. Pour afficher et gérer les connexions, procédez comme suit :
Dans la console Google Cloud , accédez à la page BigQuery.
Sélectionnez le projet dans lequel vous avez créé la fonction distante.
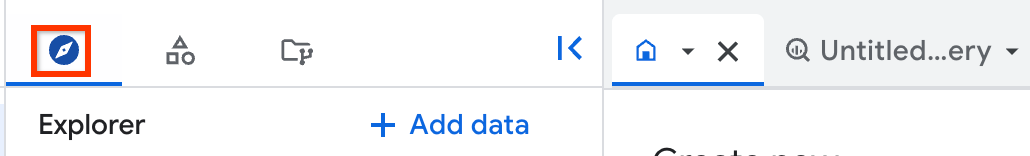
Dans le volet de gauche, cliquez sur Explorateur :
Dans le volet Explorateur, développez le projet, puis cliquez sur Connexions.
Les fonctions distantes BigQuery sont créées dans l'ensemble de données que vous spécifiez ou dans un ensemble de données anonyme, qui est un type d'ensemble de données masqué.
Si vous ne définissez pas de nom pour une fonction distante lors de sa création, BigQuery DataFrames applique un nom par défaut commençant par le préfixe bigframes. Pour afficher et gérer les fonctions distantes créées dans un ensemble de données spécifié par l'utilisateur, procédez comme suit :
Dans la console Google Cloud , accédez à la page BigQuery.
Sélectionnez le projet dans lequel vous avez créé la fonction distante.
Dans le volet de gauche, cliquez sur Explorateur :
Dans le volet Explorateur, développez le projet, puis cliquez sur Ensembles de données.
Cliquez sur l'ensemble de données dans lequel vous avez créé la fonction distante.
Cliquez sur l'onglet Routines.
Pour afficher et gérer les fonctions Cloud Run, procédez comme suit :
Accédez à la page Cloud Run
Sélectionnez le projet dans lequel vous avez créé la fonction.
Dans la liste des services disponibles, filtrez par Type de déploiement de fonction.
Pour identifier les fonctions créées par BigQuery DataFrames, recherchez les noms de fonctions précédés du préfixe
bigframes.
Effectuer un nettoyage
En plus de nettoyer les artefacts cloud directement dans la console Google Cloud ou avec d'autres outils, vous pouvez nettoyer les fonctions distantes BigQuery créées sans argument de nom explicite et leurs fonctions Cloud Run Functions associées de la manière suivante :
- Pour une session BigQuery DataFrames, utilisez la commande
session.close(). - Pour la session BigQuery DataFrames par défaut, utilisez la commande
bigframes.pandas.close_session(). - Pour une session passée avec
session_id, utilisez la commandebigframes.pandas.clean_up_by_session_id(session_id).
Vous pouvez également nettoyer les fonctions distantes BigQuery créées avec un argument de nom explicite et leurs fonctions Cloud Run Functions associées à l'aide de la commande bigframes.pandas.get_global_session().bqclient.delete_routine(routine_id).
Limites
- Les fonctions distantes sont disponibles en environ 90 secondes lorsque vous les créez. Les dépendances de packages supplémentaires peuvent augmenter la latence.
- Réexécuter le code de définition de la fonction distante après des modifications mineures dans et autour du code de la fonction (par exemple, renommer une variable, insérer une nouvelle ligne ou insérer une nouvelle cellule dans le notebook) peut entraîner la recréation de la fonction distante, même si ces modifications n'ont aucune incidence sur le comportement de la fonction.
- Le code utilisateur est visible par les utilisateurs disposant d'un accès en lecture aux fonctions Cloud Run. Vous ne devez donc inclure du contenu sensible qu'avec prudence.
- Un projet peut contenir jusqu'à 1 000 fonctions Cloud Run à la fois dans une région. Pour en savoir plus, consultez la page consacrée aux quotas.
Étapes suivantes
- Découvrez les fonctionnalités de ML et d'IA avec les BigQuery DataFrames.
- Découvrez comment générer du code BigQuery DataFrames avec Gemini.
- Découvrez comment analyser les téléchargements de packages depuis PyPI avec BigQuery DataFrames.
- Consultez le code source, les exemples de notebooks et les exemples de BigQuery DataFrames sur GitHub.
- Explorez la documentation de référence de l'API BigQuery DataFrames.