


יצירת טבלאות BigLake ב-Cloud Storage
טבלאות BigLake ב-Cloud Storage מאפשרות להריץ שאילתות על נתונים מובְנים ב-Cloud Storage באמצעות הקצאת גישה. בגישה הזו, הגישה לטבלת BigLake מופרדת מהגישה למאגר הנתונים הבסיסי, כך שהמשתמשים צריכים הרשאות רק בטבלה.
במאמר הזה מוסבר איך ליצור טבלת BigLake ב-Cloud Storage.
לפני שמתחילים
-
בדף לבחירת הפרויקט במסוף Google Cloud , בוחרים פרויקט ב- Google Cloud או יוצרים אותו.
התפקידים שנדרשים כדי לבחור או ליצור פרויקט
- בחירת פרויקט: כדי לבחור פרויקט לא נדרש תפקיד IAM ספציפי – אתם יכולים לבחור כל פרויקט שקיבלתם בו תפקיד.
-
יצירת פרויקט: כדי ליצור פרויקט, צריך את התפקיד "יצירת פרויקטים" (
roles/resourcemanager.projectCreator), שכולל את ההרשאהresourcemanager.projects.create. איך מקצים תפקידים?
-
מפעילים את BigQuery Connection API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידיםאם אתם רוצים לקרוא טבלאות BigLake ממנועי קוד פתוח כמו Apache Spark, אתם צריכים להפעיל את BigQuery Storage Read API.
-
מפעילים את Cloud Shell במסוף Google Cloud .
מוודאים שיש לכם קבוצת נתונים ב-BigQuery.
מוודאים שגרסת Google Cloud SDK היא 366.0.0 ואילך:
gcloud versionבמקרה הצורך, מעדכנים את Google Cloud SDK.
- אופציונלי: ל-Terraform נדרשת גרסה 4.25.0 ומעלה של
terraform-provider-google. גרסאותterraform-provider-googleמפורטות ב-GitHub. אתם יכולים להוריד את הגרסה העדכנית של Terraform מההורדות של HashiCorp Terraform.
- אופציונלי: ל-Terraform נדרשת גרסה 4.25.0 ומעלה של
יוצרים קישור למשאבים ב-Cloud או מגדירים קישור כברירת מחדל למקור הנתונים החיצוני. כדי ליצור חיבורים, צריך תפקידים והרשאות נוספים. מידע נוסף זמין במאמר יצירת חיבור למשאבים ב-Cloud ובסקירה הכללית על חיבור ברירת המחדל.
התפקידים הנדרשים
כדי ליצור טבלת BigLake, אתם צריכים את ההרשאות הבאות בממשק של ניהול הזהויות והרשאות הגישה (IAM) ב-BigQuery:
bigquery.tables.createbigquery.connections.delegate
התפקיד המוגדר מראש "אדמין ב-BigQuery (roles/bigquery.admin)" בניהול הזהויות והרשאות הגישה כולל את ההרשאות האלה.
אם אתם לא חשבון משתמש בתפקיד הזה, בקשו מהאדמין לתת לכם גישה או ליצור בשבילכם את טבלת BigLake.
למידע נוסף על תפקידים והרשאות של ניהול זהויות והרשאות גישה ב-BigQuery, קראו את המאמר תפקידים והרשאות מוגדרים מראש.
שיקולים בקשר למיקום
כשמשתמשים ב-Cloud Storage כדי לאחסן קובצי נתונים, אפשר לשפר את הביצועים באמצעות קטגוריות של Cloud Storage באזור אחד או בשני אזורים, במקום קטגוריות במספר אזורים.
יצירת טבלאות חיצוניות בנתונים לא מחולקים למחיצות
אם אתם יודעים איך ליצור טבלאות ב-BigQuery, תהליך היצירה של טבלה חיצונית דומה. הטבלה יכולה להשתמש בכל פורמט קובץ שנתמך בטבלאות חיצוניות. מידע נוסף מופיע בקטע מגבלות.
לפני שיוצרים טבלת BigLake, צריך שיהיו לכם קבוצת נתונים וקישור למשאבים ב-Cloud שיכולים לגשת ל-Cloud Storage.
כדי ליצור טבלת BigLake, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית השמאלית, לוחצים על Explorer:
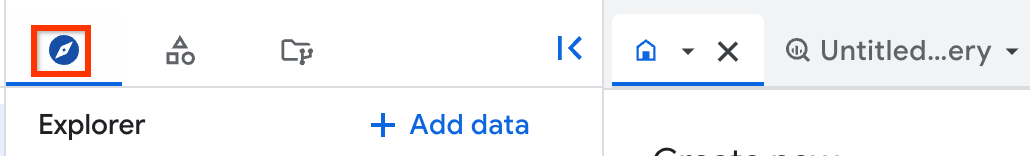
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים קבוצת נתונים.
מרחיבים את האפשרות Actions ולוחצים על Create table.
בקטע מקור, מציינים את הפרטים הבאים:
בשדה Create table from, בוחרים באפשרות Google Cloud Storage.
בשדה Select file from GCS bucket or use a URI pattern, בוחרים קטגוריה וקובץ לשימוש, או מקלידים את הנתיב בפורמט
gs://bucket_name/[folder_name/]file_name.אי אפשר לציין כמה מזהי URI במסוף Google Cloud , אבל אפשר לבחור כמה קבצים על ידי ציון תו כללי לחיפוש אחד – כוכבית (
*). לדוגמה,gs://mybucket/file_name*. מידע נוסף מופיע במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.הקטגוריה של Cloud Storage צריכה להיות באותו מיקום שבו נמצא מערך הנתונים שמכיל את הטבלה שאתם יוצרים.
בקטע פורמט קובץ, בוחרים את הפורמט שמתאים לקובץ.
בקטע Destination, מציינים את הפרטים הבאים:
בשדה Project, בוחרים את הפרויקט שבו רוצים ליצור את הטבלה.
בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
בשדה Table, מזינים את שם הטבלה שיוצרים.
בשדה Table type, בוחרים באפשרות External table.
בוחרים באפשרות Create a BigLake table using a קישור למשאבים ב-Cloud.
בשדה Connection ID, בוחרים את החיבור שיצרתם קודם.
בקטע Schema, אתם יכולים להפעיל את האפשרות schema auto-detection או לציין סכימה באופן ידני אם יש לכם קובץ מקור. אם אין לכם קובץ מקור, אתם צריכים לציין סכימה באופן ידני.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto-detect.
כדי לציין סכימה באופן ידני, משאירים את האפשרות Auto-detect לא מסומנת. מפעילים את האפשרות Edit as text ומזינים את סכימת הטבלה כמערך JSON.
כדי להתעלם משורות עם ערכי עמודות נוספים שלא תואמים לסכימה, מרחיבים את הקטע Advanced options ובוחרים באפשרות Unknown values.
לוחצים על Create table.
אחרי שיוצרים את הטבלה הקבועה, אפשר להריץ שאילתה על הטבלה כאילו היא טבלה ב-BigQuery. אחרי שהשאילתה מסתיימת, אפשר לייצא את התוצאות כקובצי CSV או JSON, לשמור את התוצאות כטבלה או לשמור את התוצאות ב-Google Sheets.
SQL
משתמשים בהצהרת ה-DDL CREATE EXTERNAL TABLE.
אתם יכולים לציין את הסכימה באופן מפורש, או להשתמש בזיהוי אוטומטי של סכימה כדי להסיק את הסכימה מהנתונים החיצוניים.
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE EXTERNAL TABLE `PROJECT_ID.DATASET.EXTERNAL_TABLE_NAME`
  WITH CONNECTION {`PROJECT_ID.REGION.CONNECTION_ID` | DEFAULT}
  OPTIONS (
    format ="TABLE_FORMAT",
    uris = ['BUCKET_PATH'[,...]],
    max_staleness = STALENESS_INTERVAL,
    metadata_cache_mode = 'CACHE_MODE'
    );
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את הטבלה, לדוגמהmyproject -
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור את הטבלה, למשלmydataset. -
EXTERNAL_TABLE_NAME: שם הטבלה שרוצים ליצור, לדוגמהmytable -
REGION: האזור שבו נמצא החיבור, לדוגמהus -
CONNECTION_ID: מזהה החיבור, לדוגמהmyconnectionכש מציגים את פרטי החיבור במסוף Google Cloud , מזהה החיבור הוא הערך בקטע האחרון של מזהה החיבור המלא שמוצג ב-Connection ID, לדוגמה
projects/myproject/locations/connection_location/connections/myconnection.כדי להשתמש ב חיבור שמוגדר כברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה את PROJECT_ID.REGION.CONNECTION_ID. -
TABLE_FORMAT: הפורמט של הטבלה שרוצים ליצור, לדוגמהPARQUETמידע נוסף על הפורמטים הנתמכים מופיע בקטע מגבלות.
-
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את הנתונים של הטבלה החיצונית, בפורמט['gs://bucket_name/[folder_name/]file_name'].אפשר לבחור כמה קבצים מהקטגוריה על ידי ציון תו כללי אחד של כוכבית (
*) בנתיב. לדוגמה,['gs://mybucket/file_name*']. מידע נוסף זמין במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.אפשר לציין כמה קטגוריות באפשרות
urisעל ידי ציון כמה נתיבים.בדוגמאות הבאות מוצגים ערכים תקינים של
uris:['gs://bucket/path1/myfile.csv']['gs://bucket/path1/*.csv']['gs://bucket/path1/*', 'gs://bucket/path2/file00*']
כשמציינים ערכי
urisשמטרגטים כמה קבצים, כל הקבצים האלה חייבים להיות בעלי סכימה תואמת.מידע נוסף על השימוש במזהי URI של Cloud Storage ב-BigQuery זמין במאמר נתיב המשאבים של Cloud Storage.
-
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלת BigLake, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל שמירת מטא-נתונים במטמון, מציינים ערך של ליטרל מרווח בין 30 דקות ל-7 ימים. לדוגמה, מציינים
INTERVAL 4 HOURלמרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת מטא-נתונים מ-Cloud Storage. -
CACHE_MODE: מציין אם המטמון של המטא-נתונים מתרענן באופן אוטומטי או ידני. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.מגדירים את הערך
AUTOMATICכדי לרענן את המטמון של המטא-נתונים במרווח זמן שמוגדר על ידי המערכת, בדרך כלל בין 30 ל-60 דקות.מגדירים את הערך
MANUALאם רוצים לרענן את המטמון של המטא-נתונים לפי לוח זמנים שאתם קובעים. במקרה כזה, אפשר להפעיל את הפרוצדורה של המערכתBQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון.צריך להגדיר את
CACHE_MODEאם הערך שלSTALENESS_INTERVALגדול מ-0.
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
אפשרות 1: קובץ הגדרת טבלה
משתמשים בפקודה bq mkdef כדי ליצור קובץ הגדרת טבלה, ואז מעבירים את הנתיב לפקודה bq mk באופן הבא:
bq mkdef \
    --connection_id=CONNECTION_ID \
    --source_format=SOURCE_FORMAT \
  BUCKET_PATH > DEFINITION_FILE

bq mk --table \
    --external_table_definition=DEFINITION_FILE \
    --max_staleness=STALENESS_INTERVAL \
    PROJECT_ID:DATASET.EXTERNAL_TABLE_NAME \
    SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
CONNECTION_ID: מזהה החיבור, לדוגמהmyconnectionכשמציגים את פרטי החיבור במסוף Google Cloud , מזהה החיבור הוא הערך שמופיע בקטע האחרון של מזהה החיבור המלא שמוצג ב-Connection ID, לדוגמה
projects/myproject/locations/connection_location/connections/myconnection.כדי להשתמש בחיבור ברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה את PROJECT_ID.REGION.CONNECTION_ID.
SOURCE_FORMAT: הפורמט של מקור הנתונים החיצוני. לדוגמה,PARQUET.
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את הנתונים של הטבלה, בפורמטgs://bucket_name/[folder_name/]file_pattern.אפשר לבחור כמה קבצים מהקטגוריה על ידי ציון תו כללי אחד של כוכבית (
*) ב-file_pattern. לדוגמה,gs://mybucket/file00*.parquet. מידע נוסף מופיע במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.אפשר לציין כמה קטגוריות לאפשרות
urisעל ידי ציון כמה נתיבים.בדוגמאות הבאות מוצגים ערכים תקינים של
uris:gs://bucket/path1/myfile.csvgs://bucket/path1/*.parquetgs://bucket/path1/file1*,gs://bucket1/path1/*
כשמציינים ערכי
urisשמטרגטים כמה קבצים, לכל הקבצים האלה צריכה להיות סכימה תואמת.מידע נוסף על השימוש במזהי URI של Cloud Storage ב-BigQuery זמין במאמר נתיב המשאבים של Cloud Storage.
DEFINITION_FILE: הנתיב לקובץ הגדרת הטבלה במחשב המקומי.
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלת BigLake, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל את שמירת המטא-נתונים במטמון, מציינים ערך מרווח בין 30 דקות ל-7 ימים, בפורמט
Y-M D H:M:Sשמתואר במסמכי התיעוד של סוג הנתוניםINTERVAL. לדוגמה, מציינים0-0 0 4:0:0למרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת את המטא-נתונים מ-Cloud Storage.
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור טבלה, למשלmydataset.
EXTERNAL_TABLE_NAME: שם הטבלה שרוצים ליצור, לדוגמהmytable
SCHEMA: הסכימה של טבלת BigLake
דוגמה:
bq mkdef
    --connection_id=myconnection
    --metadata_cache_mode=CACHE_MODE
    --source_format=CSV 'gs://mybucket/*.csv' > mytable_def

bq mk
    --table
    --external_table_definition=mytable_def='gs://mybucket/*.csv'
    --max_staleness=0-0 0 4:0:0
    myproject:mydataset.mybiglaketable
    Region:STRING,Quarter:STRING,Total_sales:INTEGER
כדי להשתמש בזיהוי אוטומטי של סכימה, מגדירים את הדגל --autodetect=true בפקודה mkdef ומשמיטים את הסכימה:
bq mkdef \
    --connection_id=myconnection \
    --metadata_cache_mode=CACHE_MODE \
    --source_format=CSV --autodetect=true \
    gs://mybucket/*.csv > mytable_def

bq mk \
    --table \
    --external_table_definition=mytable_def=gs://mybucket/*.csv \
    --max_staleness=0-0 0 4:0:0 \
    myproject:mydataset.myexternaltable
אפשרות 2: הגדרת טבלה מוטבעת
במקום ליצור קובץ הגדרת טבלה, אתם יכולים להעביר את הגדרת הטבלה ישירות לפקודה bq mk.
משתמשים במעטר @connection כדי לציין את החיבור שבו רוצים להשתמש בסוף הדגל --external_table_definition.
bq mk --table \
  --external_table_definition=@SOURCE_FORMAT=BUCKET_PATH@projects/PROJECT_ID/locations/REGION/connections/CONNECTION_ID \
  DATASET_NAME.TABLE_NAME \
  SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
SOURCE_FORMAT: הפורמט של מקור הנתונים החיצונילדוגמה,
CSV.
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את הנתונים של הטבלה, בפורמטgs://bucket_name/[folder_name/]file_pattern.אפשר לבחור כמה קבצים מהקטגוריה על ידי ציון תו כללי אחד של כוכבית (
*) ב-file_pattern. לדוגמה,gs://mybucket/file00*.parquet. מידע נוסף מופיע במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.אפשר לציין כמה קטגוריות לאפשרות
urisעל ידי ציון כמה נתיבים.בדוגמאות הבאות מוצגים ערכים תקינים של
uris:gs://bucket/path1/myfile.csvgs://bucket/path1/*.parquetgs://bucket/path1/file1*,gs://bucket1/path1/*
כשמציינים ערכי
urisשמטרגטים כמה קבצים, לכל הקבצים האלה צריכה להיות סכימה תואמת.מידע נוסף על השימוש במזהי URI של Cloud Storage ב-BigQuery זמין במאמר נתיב המשאבים של Cloud Storage.
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את הטבלה, לדוגמהmyproject
REGION: האזור שבו נמצא החיבור,us
CONNECTION_ID: מזהה החיבור, לדוגמהmyconnectionכשמציגים את פרטי החיבור במסוף Google Cloud , מזהה החיבור הוא הערך שמופיע בקטע האחרון של מזהה החיבור המלא שמוצג ב-Connection ID, לדוגמה
projects/myproject/locations/connection_location/connections/myconnection.כדי להשתמש בחיבור ברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה את PROJECT_ID.REGION.CONNECTION_ID.
DATASET_NAME: שם מערך הנתונים שבו רוצים ליצור את טבלת BigLake
TABLE_NAME: השם של טבלת BigLake
SCHEMA: הסכימה של טבלת BigLake
דוגמה:
bq mk --table \
    --external_table_definition=@CSV=gs://mybucket/*.parquet@projects/myproject/locations/us/connections/myconnection \
    --max_staleness=0-0 0 4:0:0 \
    myproject:mydataset.myexternaltable \
    Region:STRING,Quarter:STRING,Total_sales:INTEGER
API
מפעילים את ה-method tables.insert ב-API ויוצרים ExternalDataConfiguration במשאב Table שמעבירים.
כדי להפעיל זיהוי אוטומטי של סכימה במקורות נתונים נתמכים, מציינים את המאפיין schema או מגדירים את המאפיין autodetect כ-true.
מציינים את המאפיין connectionId כדי לזהות את החיבור שבו רוצים להשתמש כדי להתחבר ל-Cloud Storage.
Terraform
בדוגמה הזו יוצרים טבלת BigLake בנתונים שלא חולקו למחיצות.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כך מחילים את ההגדרות של Terraform בפרויקט ב- Google Cloud :
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את פרויקט ברירת המחדל ב- Google Cloud שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את הפרויקט ב- Google Cloud כדי להציג את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
ב-BigLake יש תמיכה בזיהוי אוטומטי של סכימות. עם זאת, אם לא סיפקתם סכימה ולא נתתם גישה לחשבון השירות בשלבים הקודמים, השלבים האלה ייכשלו ותופיע הודעה על דחיית הגישה אם תנסו לזהות את הסכימה באופן אוטומטי.
יצירת טבלאות BigLake על נתונים מחולקים למחיצות ב-Apache Hive
אתם יכולים ליצור טבלת BigLake לנתונים שמחולקים למחיצות ב-Hive ב-Cloud Storage. אחרי שיוצרים טבלה מחולקת למחיצות חיצוניות, אי אפשר לשנות את מפתח המחיצה. כדי לשנות את מפתח המחיצה, צריך ליצור מחדש את הטבלה.
לפני שיוצרים טבלת BigLake, צריך שיהיו לכם קבוצת נתונים וקישור למשאבים ב-Cloud שיכולים לגשת ל-Cloud Storage.
כדי ליצור טבלת BigLake שמבוססת על נתונים מחולקים למחיצות של Hive ב-Cloud Storage, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
בחלונית השמאלית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז לוחצים על מערך נתונים.
לוחצים על Create table. החלונית Create table נפתחת.
בקטע מקור, מציינים את הפרטים הבאים:
בקטע Create table from, בוחרים באפשרות Google Cloud Storage.
מציינים את הנתיב לתיקייה באמצעות תווים כלליים לחיפוש. לדוגמה,
my_bucket/my_files*. התיקייה צריכה להיות באותו מיקום של מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף או להחליף.ברשימה פורמט קובץ, בוחרים את סוג הקובץ.
מסמנים את התיבה Source data partitioning ומציינים את הפרטים הבאים:
- בשדה Select Source URI Prefix, מזינים את הקידומת של ה-URI. לדוגמה,
gs://my_bucket/my_files. - אופציונלי: כדי לדרוש מסנן מחיצה בכל השאילתות בטבלה הזו, מסמנים את התיבה Require partition filter. דרישה למסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. מידע נוסף זמין במאמר דרישה למסנני פרדיקטים במפתחות חלוקה למחיצות בשאילתות.
בקטע מצב היסק של מחיצה, בוחרים באחת מהאפשרויות הבאות:
- Automatically infer types: הגדרת מצב הזיהוי של סכימת המחיצה לערך
AUTO. - כל העמודות הן מחרוזות: מגדירים את מצב הזיהוי של סכימת המחיצה לערך
STRINGS. - Provide my own: מגדירים את מצב הזיהוי של סכימת המחיצות ל-
CUSTOMומזינים ידנית את פרטי הסכימה של מפתחות המחיצות. מידע נוסף מופיע במאמר מתן סכימה של מפתח מחיצה בהתאמה אישית.
- Automatically infer types: הגדרת מצב הזיהוי של סכימת המחיצה לערך
- בשדה Select Source URI Prefix, מזינים את הקידומת של ה-URI. לדוגמה,
בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Project, בוחרים את הפרויקט שבו רוצים ליצור את הטבלה.
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- בשדה Table type, בוחרים באפשרות External table.
- מסמנים את התיבה Create a BigLake table using a Cloud Resource connection.
- בשדה Connection ID, בוחרים את החיבור שיצרתם קודם.
בקטע Schema, מפעילים את האפשרות schema auto-detection על ידי בחירה באפשרות Auto detect.
כדי להתעלם משורות עם ערכי עמודות נוספים שלא תואמים לסכימה, מרחיבים את הקטע Advanced options ובוחרים באפשרות Unknown values.
לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL CREATE EXTERNAL TABLE:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE EXTERNAL TABLE `PROJECT_ID.DATASET.EXTERNAL_TABLE_NAME`
WITH PARTITION COLUMNS
(
  PARTITION_COLUMN PARTITION_COLUMN_TYPE,
)
WITH CONNECTION {`PROJECT_ID.REGION.CONNECTION_ID` | DEFAULT}
OPTIONS (
  hive_partition_uri_prefix = "HIVE_PARTITION_URI_PREFIX",
  uris=['FILE_PATH'],
  max_staleness = STALENESS_INTERVAL,
  metadata_cache_mode = 'CACHE_MODE',
  format ="TABLE_FORMAT"
);
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שבו רוצים ליצור את הטבלה, לדוגמהmyproject -
DATASET: השם של מערך הנתונים ב-BigQuery שבו רוצים ליצור את הטבלה, למשלmydataset. -
EXTERNAL_TABLE_NAME: שם הטבלה שרוצים ליצור, לדוגמהmytable -
PARTITION_COLUMN: השם של עמודת החלוקה למחיצות -
PARTITION_COLUMN_TYPE: סוג עמודת החלוקה למחיצות -
REGION: האזור שבו נמצא החיבור, לדוגמהus -
CONNECTION_ID: מזהה החיבור, לדוגמהmyconnectionכשמציגים את פרטי החיבור במסוף Google Cloud , מזהה החיבור הוא הערך שמופיע בקטע האחרון של מזהה החיבור המלא שמוצג ב-Connection ID, לדוגמה
projects/myproject/locations/connection_location/connections/myconnection.כדי להשתמש ב חיבור ברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה את PROJECT_ID.REGION.CONNECTION_ID. -
HIVE_PARTITION_URI_PREFIX: קידומת URI של חלוקה למחיצות ב-Hive, לדוגמהgs://mybucket/ -
FILE_PATH: הנתיב למקור הנתונים של הטבלה החיצונית שרוצים ליצור, לדוגמהgs://mybucket/*.parquet -
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלת BigLake, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל שמירת מטא-נתונים במטמון, מציינים ערך של ליטרל מרווח בין 30 דקות ל-7 ימים. לדוגמה, מציינים
INTERVAL 4 HOURלמרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת מטא-נתונים מ-Cloud Storage. -
CACHE_MODE: מציין אם המטמון של המטא-נתונים מתרענן באופן אוטומטי או ידני. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.מגדירים את הערך
AUTOMATICכדי לרענן את המטמון של המטא-נתונים במרווח זמן שמוגדר על ידי המערכת, בדרך כלל בין 30 ל-60 דקות.מגדירים את הערך
MANUALאם רוצים לרענן את המטמון של המטא-נתונים לפי לוח זמנים שאתם קובעים. במקרה כזה, אפשר להפעיל את הפרוצדורה של המערכתBQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון.צריך להגדיר את
CACHE_MODEאם הערך שלSTALENESS_INTERVALגדול מ-0. -
TABLE_FORMAT: הפורמט של הטבלה שרוצים ליצור, לדוגמהPARQUET
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
דוגמאות
בדוגמה הבאה נוצרת טבלת BigLake על נתונים מחולקים למחיצות, כאשר:
- המערכת מזהה את הסכימה באופן אוטומטי.
- מרווח הזמן להתיישנות המטמון של המטא-נתונים בטבלה הוא יום אחד.
- המטמון של המטא-נתונים מתרענן באופן אוטומטי.
CREATE EXTERNAL TABLE `my_dataset.my_table`
WITH PARTITION COLUMNS
(
  sku STRING,
)
WITH CONNECTION `us.my-connection`
OPTIONS(
  hive_partition_uri_prefix = "gs://mybucket/products",
  uris = ['gs://mybucket/products/*'],
  max_staleness = INTERVAL 1 DAY,
  metadata_cache_mode = 'AUTOMATIC'
);
בדוגמה הבאה נוצרת טבלת BigLake על נתונים מחולקים למחיצות, כאשר:
- הסכימה מצוינת.
- מרווח הזמן של התיישנות המטמון של המטא-נתונים בטבלה הוא 8 שעות.
- צריך לרענן את המטמון של המטא-נתונים באופן ידני.
CREATE EXTERNAL TABLE `my_dataset.my_table`
(
  ProductId INTEGER,
  ProductName STRING,
  ProductType STRING
)
WITH PARTITION COLUMNS
(
  sku STRING,
)
WITH CONNECTION `us.my-connection`
OPTIONS(
  hive_partition_uri_prefix = "gs://mybucket/products",
  uris = ['gs://mybucket/products/*'],
  max_staleness = INTERVAL 8 HOUR,
  metadata_cache_mode = 'MANUAL'
);
BQ
קודם כל, משתמשים בפקודה bq mkdef כדי ליצור קובץ הגדרת טבלה:
bq mkdef \
--source_format=SOURCE_FORMAT \
--connection_id=REGION.CONNECTION_ID \
--hive_partitioning_mode=PARTITIONING_MODE \
--hive_partitioning_source_uri_prefix=GCS_URI_SHARED_PREFIX \
--require_hive_partition_filter=BOOLEAN \
--metadata_cache_mode=CACHE_MODE \
 GCS_URIS > DEFINITION_FILE
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_FORMAT: הפורמט של מקור הנתונים החיצוני. לדוגמה,CSV. -
REGION: האזור שבו נמצא החיבור, לדוגמהus.
CONNECTION_ID: מזהה החיבור, לדוגמהmyconnection.כשמציגים את פרטי החיבור במסוף Google Cloud , מזהה החיבור הוא הערך שמופיע בקטע האחרון של מזהה החיבור המלא שמוצג ב-Connection ID, לדוגמה
projects/myproject/locations/connection_location/connections/myconnection.כדי להשתמש בחיבור ברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה את PROJECT_ID.REGION.CONNECTION_ID.
PARTITIONING_MODE: מצב החלוקה למחיצות של Hive. משתמשים באחד מהערכים הבאים:-
AUTO: זיהוי אוטומטי של השמות והסוגים של המפתחות. -
STRINGS: המרה אוטומטית של שמות המפתחות למחרוזות. -
CUSTOM: מקודדים את סכימת המפתח בקידומת של ה-URI במקור.
-
GCS_URI_SHARED_PREFIX: הקידומת של ה-URI במקור.
BOOLEAN: מציין אם לדרוש מסנן פרדיקט בזמן השאילתה. הדגל הזה הוא אופציונלי. ערך ברירת המחדל הואfalse.
CACHE_MODE: קובע אם המטמון של המטא-נתונים מתרענן באופן אוטומטי או ידני. צריך לכלול את הדגל הזה רק אם מתכננים להשתמש גם בדגל--max_stalenessבפקודהbq mkהבאה כדי להפעיל את המטמון של המטא-נתונים. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.מגדירים את הערך
AUTOMATICכדי לרענן את המטמון של המטא-נתונים במרווח זמן שמוגדר במערכת, בדרך כלל בין 30 ל-60 דקות.מגדירים את הערך
MANUALאם רוצים לרענן את המטמון של המטא-נתונים לפי לוח זמנים שאתם קובעים. במקרה כזה, אפשר להפעיל את הפרוצדורה של המערכתBQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון.צריך להגדיר את
CACHE_MODEאם הערך שלSTALENESS_INTERVALגדול מ-0.
GCS_URIS: הנתיב לתיקייה ב-Cloud Storage, בפורמט של תו כללי לחיפוש.
DEFINITION_FILE: הנתיב לקובץ הגדרת הטבלה במחשב המקומי.
אם הערך של PARTITIONING_MODE הוא CUSTOM, צריך לכלול את סכימת מפתח המחיצה בקידומת של ה-URI של המקור, בפורמט הבא:
--hive_partitioning_source_uri_prefix=GCS_URI_SHARED_PREFIX/{KEY1:TYPE1}/{KEY2:TYPE2}/...
אחרי שיוצרים את קובץ הגדרת הטבלה, משתמשים בפקודה bq mk כדי ליצור את טבלת BigLake:
bq mk --external_table_definition=DEFINITION_FILE \
--max_staleness=STALENESS_INTERVAL \
DATASET_NAME.TABLE_NAME \
SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
-
DEFINITION_FILE: הנתיב לקובץ הגדרת הטבלה.
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלת BigLake, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. אם אתם כוללים את הדגל הזה, אתם צריכים לציין גם ערך לדגל--metadata_cache_modeבפקודהbq mkdefהקודמת. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל את המטמון של המטא-נתונים, מציינים ערך מרווח בין 30 דקות ל-7 ימים, בפורמט
Y-M D H:M:Sשמתואר במסמכי התיעוד של סוג הנתוניםINTERVAL. לדוגמה, מציינים0-0 0 4:0:0למרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת מטא-נתונים מ-Cloud Storage.
DATASET_NAME: שם מערך הנתונים שמכיל את הטבלה.
TABLE_NAME: שם הטבלה שיוצרים.
SCHEMA: מציין נתיב לקובץ סכימת JSON, או מציין את הסכימה בפורמטfield:data_type,field:data_type,.... כדי להשתמש בזיהוי אוטומטי של סכימה, משמיטים את הארגומנט הזה.
דוגמאות
בדוגמה הבאה נעשה שימוש במצב חלוקה למחיצות של AUTO Hive, וגם מוגדר למטמון המטא-נתונים מרווח זמן של 12 שעות עד שהוא נחשב למיושן, ומתרענן אוטומטית:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=AUTO \
  --hive_partitioning_source_uri_prefix=gs://myBucket/myTable \
  --metadata_cache_mode=AUTOMATIC \
  gs://myBucket/myTable/* > mytable_def

bq mk --external_table_definition=mytable_def \
  --max_staleness=0-0 0 12:0:0 \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
בדוגמה הבאה נעשה שימוש במצב החלוקה למחיצות STRING של Hive:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=STRING \
  --hive_partitioning_source_uri_prefix=gs://myBucket/myTable \
  gs://myBucket/myTable/* > mytable_def

bq mk --external_table_definition=mytable_def \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
בדוגמה הבאה נעשה שימוש במצב החלוקה למחיצות CUSTOM של Hive:
bq mkdef --source_format=CSV \
  --connection_id=us.my-connection \
  --hive_partitioning_mode=CUSTOM \
  --hive_partitioning_source_uri_prefix=gs://myBucket/myTable/{dt:DATE}/{val:STRING} \
  gs://myBucket/myTable/* > mytable_def

bq mk --external_table_definition=mytable_def \
  mydataset.mytable \
  Region:STRING,Quarter:STRING,Total_sales:INTEGER
API
כדי להגדיר חלוקה למחיצות ב-Hive באמצעות BigQuery API, צריך לכלול את האובייקט hivePartitioningOptions באובייקט ExternalDataConfiguration כשיוצרים את קובץ הגדרת הטבלה.
כדי ליצור טבלת BigLake, צריך לציין גם ערך בשדה connectionId.
אם מגדירים את השדה hivePartitioningOptions.mode לערך CUSTOM, צריך לקודד את הסכימה של מפתח המחיצה בשדה hivePartitioningOptions.sourceUriPrefix באופן הבא:
gs://BUCKET/PATH_TO_TABLE/{KEY1:TYPE1}/{KEY2:TYPE2}/...
כדי לאכוף את השימוש במסנן פרדיקט בזמן השאילתה, מגדירים את השדה hivePartitioningOptions.requirePartitionFilter לערך true.
Terraform
בדוגמה הזו יוצרים טבלת BigLake על נתונים מחולקים למחיצות.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כך מחילים את ההגדרות של Terraform בפרויקט ב- Google Cloud :
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את פרויקט ברירת המחדל ב- Google Cloud שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את הפרויקט ב- Google Cloud כדי להציג את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
הגדרת כללי מדיניות של בקרת גישה
יש כמה שיטות שבהן אפשר להשתמש כדי לשלוט בגישה לטבלאות BigLake:
במדריך לאבטחה ברמת העמודה מוסבר איך מגדירים אבטחה ברמת העמודה.
במדריך להסתרת נתונים מוסבר איך להגדיר הסתרת נתונים.
במדריך לאבטחה ברמת השורה מוסבר איך להגדיר אבטחה ברמת השורה.
לדוגמה, נניח שאתם רוצים להגביל את הגישה לשורות בטבלה mytable במערך הנתונים mydataset:
+---------+---------+-------+
| country | product | price |
+---------+---------+-------+
| US      | phone   |   100 |
| JP      | tablet  |   300 |
| UK      | laptop  |   200 |
+---------+---------+-------+
אתם יכולים ליצור מסנן ברמת השורה בשביל קים (kim@example.com) שמגביל את הגישה שלה לשורות שבהן country שווה ל-US.
CREATE ROW ACCESS POLICY only_us_filter
ON mydataset.mytable
GRANT TO ('user:kim@example.com')
FILTER USING (country = 'US');
לאחר מכן, קים מריצה את השאילתה הבאה:
SELECT * FROM projectid.mydataset.mytable;
בפלט מוצגות רק השורות שבהן הערך של country שווה ל-US:
+---------+---------+-------+
| country | product | price |
+---------+---------+-------+
| US      | phone   |   100 |
+---------+---------+-------+
הרצת שאילתות על טבלאות BigLake
מידע נוסף זמין במאמר שליחת שאילתות על נתוני Cloud Storage בטבלאות BigLake.
עדכון טבלאות BigLake
במקרה הצורך, אתם יכולים לעדכן את טבלאות BigLake, למשל כדי לשנות את שמירת המטא-נתונים שלהן במטמון. במאמר קבלת מידע על טבלאות מוסבר איך לקבל פרטים על טבלאות, כמו פורמט המקור ו-URI של המקור.
אתם יכולים להשתמש באותו תהליך גם כדי לשדרג טבלאות חיצוניות שמבוססות על Cloud Storage לטבלאות BigLake, על ידי שיוך הטבלה החיצונית לחיבור. למידע נוסף, קראו את המאמר שדרוג טבלאות חיצוניות לטבלאות BigLake.
כדי לעדכן טבלת BigLake, בוחרים אחת מהאפשרויות הבאות:
SQL
כדי לעדכן טבלה, משתמשים בהצהרת ה-DDL של CREATE OR REPLACE EXTERNAL TABLE:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE OR REPLACE EXTERNAL TABLE
  `PROJECT_ID.DATASET.EXTERNAL_TABLE_NAME`
  WITH CONNECTION {`REGION.CONNECTION_ID` | DEFAULT}
  OPTIONS(
    format ="TABLE_FORMAT",
    uris = ['BUCKET_PATH'],
    max_staleness = STALENESS_INTERVAL,
    metadata_cache_mode = 'CACHE_MODE'
    );
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שמכיל את הטבלה -
DATASET: שם קבוצת הנתונים שמכילה את הטבלה -
EXTERNAL_TABLE_NAME: שם הטבלה -
REGION: האזור שבו נמצא החיבור -
CONNECTION_ID: שם החיבור שבו רוצים להשתמשכדי להשתמש ב חיבור שמוגדר כברירת מחדל, מציינים את
DEFAULTבמקום את מחרוזת החיבור שמכילה אתREGION.CONNECTION_ID. TABLE_FORMAT: הפורמט של הטבלהאי אפשר לשנות את זה כשמעדכנים את הטבלה.
-
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את הנתונים של הטבלה החיצונית, בפורמט['gs://bucket_name/[folder_name/]file_name'].אפשר לבחור כמה קבצים מהקטגוריה על ידי ציון תו כללי אחד של כוכבית (
*) בנתיב. לדוגמה,['gs://mybucket/file_name*']. מידע נוסף זמין במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.אפשר לציין כמה קטגוריות באפשרות
urisעל ידי ציון כמה נתיבים.בדוגמאות הבאות מוצגים ערכים תקינים של
uris:['gs://bucket/path1/myfile.csv']['gs://bucket/path1/*.csv']['gs://bucket/path1/*', 'gs://bucket/path2/file00*']
כשמציינים ערכי
urisשמטרגטים כמה קבצים, כל הקבצים האלה חייבים להיות בעלי סכימה תואמת.מידע נוסף על השימוש במזהי URI של Cloud Storage ב-BigQuery זמין במאמר נתיב המשאבים של Cloud Storage.
-
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלה, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהםלמידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.
כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל שמירת מטא-נתונים במטמון, מציינים ערך של ליטרל מרווח בין 30 דקות ל-7 ימים. לדוגמה, מציינים
INTERVAL 4 HOURלמרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת מטא-נתונים מ-Cloud Storage. -
CACHE_MODE: מציין אם המטמון של המטא-נתונים מתרענן באופן אוטומטי או ידנילמידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.
מגדירים את הערך
AUTOMATICכדי לרענן את המטמון של המטא-נתונים במרווח זמן שמוגדר על ידי המערכת, בדרך כלל בין 30 ל-60 דקות.מגדירים את הערך
MANUALאם רוצים לרענן את המטמון של המטא-נתונים לפי לוח זמנים שאתם קובעים. במקרה כזה, אפשר להפעיל את הפרוצדורה של המערכתBQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון.צריך להגדיר את
CACHE_MODEאם הערך שלSTALENESS_INTERVALגדול מ-0.
-
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
כדי לעדכן טבלה, משתמשים בפקודות bq mkdef ו-bq update:
יוצרים הגדרה של טבלה חיצונית שמתארת את ההיבטים של הטבלה שרוצים לשנות:
bq mkdef --connection_id=PROJECT_ID.REGION.CONNECTION_ID \
--source_format=TABLE_FORMAT \
--metadata_cache_mode=CACHE_MODE \
"BUCKET_PATH" > /tmp/DEFINITION_FILE
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: שם הפרויקט שמכיל את החיבור -
REGION: האזור שבו נמצא החיבור -
CONNECTION_ID: שם החיבור שבו רוצים להשתמש -
TABLE_FORMAT: הפורמט שבו משתמשים בטבלה. אי אפשר לשנות את זה כשמעדכנים את הטבלה.
CACHE_MODE: קובע אם המטמון של המטא-נתונים מתרענן באופן אוטומטי או ידני. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.מגדירים את הערך
AUTOMATICכדי לרענן את המטמון של המטא-נתונים במרווח זמן שמוגדר במערכת, בדרך כלל בין 30 ל-60 דקות.מגדירים את הערך
MANUALאם רוצים לרענן את המטמון של המטא-נתונים לפי לוח זמנים שאתם קובעים. במקרה כזה, אתם יכולים להפעיל את הפרוצדורה של המערכתBQ.REFRESH_EXTERNAL_METADATA_CACHEכדי לרענן את המטמון.צריך להגדיר את
CACHE_MODEאם הערך שלSTALENESS_INTERVALגדול מ-0.
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את הנתונים של הטבלה החיצונית, בפורמטgs://bucket_name/[folder_name/]file_name.כדי להגביל את הקבצים שנבחרו מהקטגוריה, אפשר לציין תו כללי לחיפוש של כוכבית אחת (
*) בנתיב. לדוגמה,gs://mybucket/file_name*. מידע נוסף מופיע במאמר תמיכה בתווים כלליים לחיפוש במזהי URI של Cloud Storage.אפשר לציין כמה קטגוריות לאפשרות
urisעל ידי ציון כמה נתיבים.בדוגמאות הבאות מוצגים ערכים תקינים של
uris:gs://bucket/path1/myfile.csvgs://bucket/path1/*.csvgs://bucket/path1/*,gs://bucket/path2/file00*
כשמציינים ערכי
urisשמטרגטים כמה קבצים, לכל הקבצים האלה צריכה להיות סכימה תואמת.מידע נוסף על השימוש במזהי URI של Cloud Storage ב-BigQuery זמין במאמר נתיב המשאבים של Cloud Storage.
DEFINITION_FILE: השם של קובץ הגדרת הטבלה שאתם יוצרים.
-
מעדכנים את הטבלה באמצעות ההגדרה החדשה של הטבלה החיצונית:
bq update --max_staleness=STALENESS_INTERVAL \
--external_table_definition=/tmp/DEFINITION_FILE \
PROJECT_ID:DATASET.EXTERNAL_TABLE_NAME
מחליפים את מה שכתוב בשדות הבאים:
STALENESS_INTERVAL: מציין אם המטא-נתונים שנשמרו במטמון משמשים לפעולות בטבלה, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. למידע נוסף על שיקולים לשמירת מטא-נתונים במטמון, ראו שמירת מטא-נתונים במטמון לשיפור הביצועים.כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל)
כדי להפעיל את שמירת המטא-נתונים במטמון, מציינים ערך מרווח בין 30 דקות ל-7 ימים, בפורמט
Y-M D H:M:Sשמתואר במסמכי התיעוד של סוג הנתוניםINTERVAL. לדוגמה, מציינים0-0 0 4:0:0למרווח זמן של 4 שעות. עם הערך הזה, פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון אם הם רועננו ב-4 השעות האחרונות. אם המטא-נתונים במטמון ישנים יותר, הפעולה מאחזרת את המטא-נתונים מ-Cloud Storage.
DEFINITION_FILE: השם של קובץ הגדרת הטבלה שיצרתם או עדכנתם.
PROJECT_ID: שם הפרויקט שמכיל את הטבלה
DATASET: שם מערך הנתונים שמכיל את הטבלה
EXTERNAL_TABLE_NAME: שם הטבלה
דוגמה
בדוגמה הבאה, mytable מעודכן כך שישתמש במטא-נתונים שנשמרו במטמון, כל עוד הם רועננו ב-4.5 השעות האחרונות, וגם ירענן אוטומטית את המטא-נתונים שנשמרו במטמון:
bq update --project_id=myproject --max_staleness='0-0 0 4:30:0' \
--external_table_definition=enable_metadata.json mydataset.mytable
כאשר enable_metadata.json מכיל את התוכן הבא:
json
{
"metadataCacheMode": "AUTOMATIC"
}
רישום ביומן ביקורת
למידע נוסף על רישום ביומן ב-BigQuery, קראו את המאמר מבוא למעקב ב-BigQuery. מידע נוסף על רישום ביומן ב- Google Cloudזמין במאמר Cloud Logging.
המאמרים הבאים
- BigLake
- מידע על Cloud Storage
- מידע ולמידה על שליחת שאילתות לגבי נתונים של Amazon Web Services (AWS)
- איך שולחים שאילתות לנתונים ב-Microsoft Azure