


Introduzione al controllo dell'accesso a livello di colonna
BigQuery fornisce un accesso granulare alle colonne sensibili utilizzando i tag di policy (basati su Data Catalog) o i tag di governance dei dati (basati sui tag di Resource Manager). Utilizzando questi metodi di classificazione, puoi creare policy che verificano, al momento della query, se un utente dispone dell'accesso corretto. Ad esempio, un criterio può applicare controlli di accesso come:
- Devi trovarti in
group:high-accessper visualizzare le colonne contenentiTYPE_SSN.
Per migliorare controllo dell'accesso a livello di colonna, puoi utilizzare facoltativamente il mascheramento dinamico dei dati. Il mascheramento dei dati consente di mascherare i dati sensibili sostituendo i contenuti nulli, predefiniti o con hash al posto del valore effettivo della colonna.
Questo documento descrive l'utilizzo dei tag di criteri per controllo dell'accesso a livello di colonna. In alternativa, puoi utilizzare i tag di governance dei dati, che sono tag Resource Manager utilizzati per controllo dell'accesso a livello di colonna e la mascheratura dei dati.
Workflow controllo dell'accesso a livello di colonna
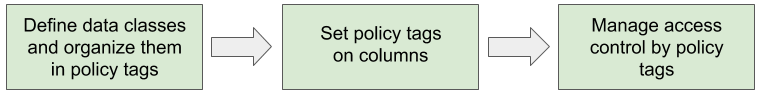
Per limitare l'accesso ai dati a livello di colonna:
Definisci una tassonomia e i tag di policy. Crea e gestisci una tassonomia e tag di criteri per i tuoi dati. Per le linee guida, consulta Best practice per i tag delle norme.
Assegna tag di criteri alle colonne BigQuery. In BigQuery, utilizza le annotazioni dello schema per assegnare un tag di criteri a ogni colonna a cui vuoi limitare l'accesso.
Applica controllo dell'accesso alla tassonomia. L'applicazione del controllo dell'accesso comporta l'applicazione delle limitazioni di accesso definite per tutti i tag criterio nella tassonomia.
Gestisci l'accesso ai tag di criteri. Utilizza le policy Identity and Access Management (IAM) per limitare l'accesso a ogni tag di criteri. La norma è in vigore per ogni colonna appartenente altag di criteriy.
Quando un utente tenta di accedere ai dati delle colonne al momento della query, BigQuery controlla iltag di criteriy della colonna e i relativi criteri per verificare se l'utente è autorizzato ad accedere ai dati.
Identificare gli elementi da taggare
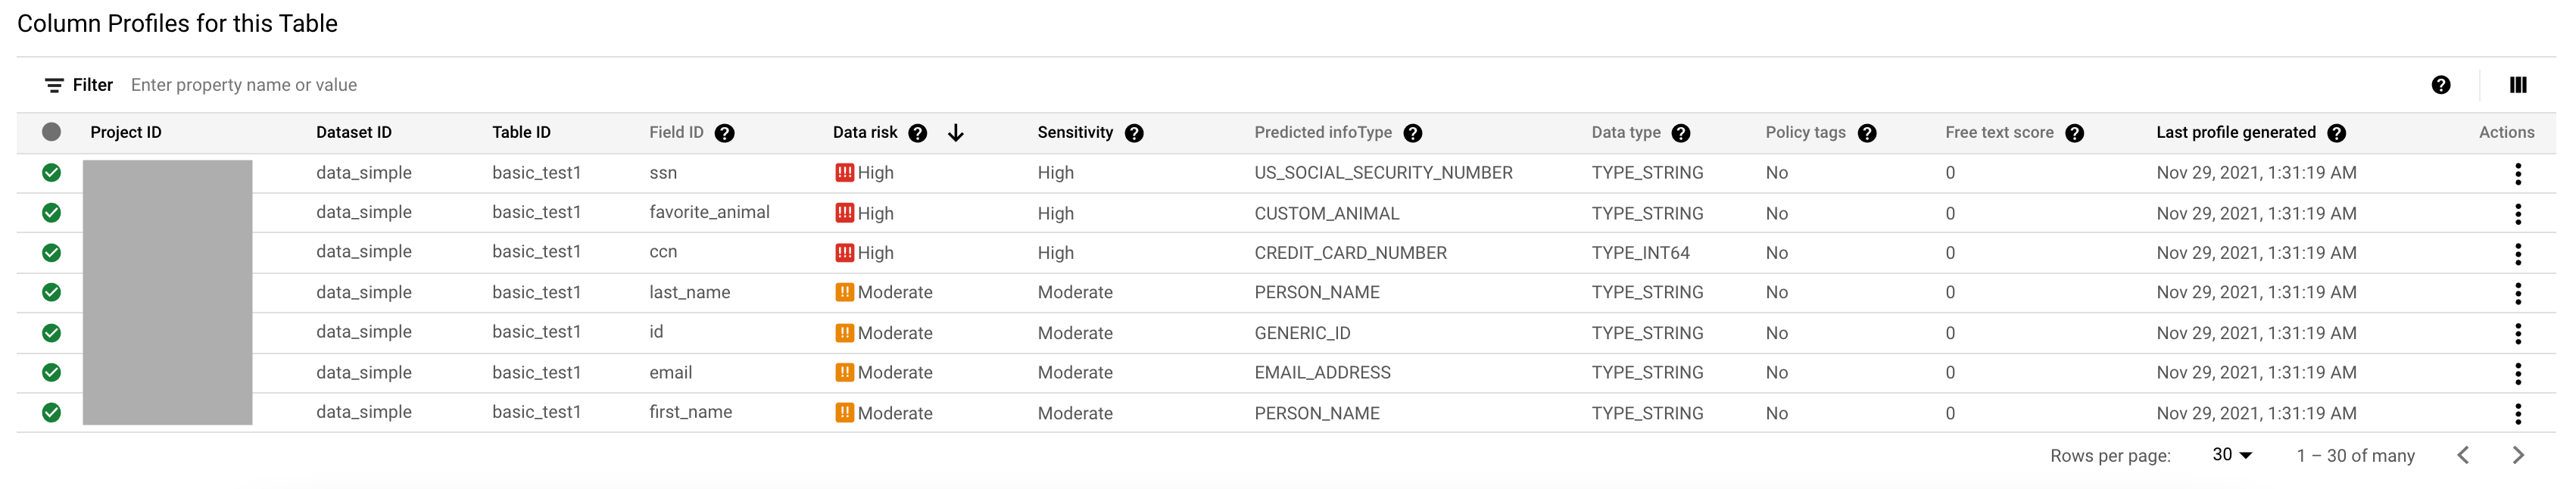
Per determinare i tipi di dati sensibili che hai e le colonne che richiedono tag di policy, valuta la possibilità di generare profili sui tuoi dati in un'organizzazione, una cartella o un progetto utilizzando Sensitive Data Protection. I profili di dati contengono metriche e metadati sulle tabelle e ti aiutano a determinare la posizione dei dati sensibili e ad alto rischio. Sensitive Data Protection riporta queste metriche a livello di progetto, tabella e colonna. Per saperne di più, consulta Panoramica del rilevamento dei dati sensibili.
L'immagine seguente mostra un elenco di profili dei dati delle colonne (fai clic per ingrandire). Le colonne con valori di rischio elevato per i dati potrebbero contenere dati ad alta sensibilità e non disporre di controlli dell'accesso a livello di colonna. In alternativa, queste colonne potrebbero contenere dati a sensibilità moderata o elevata accessibili a molte persone.
Caso d'uso di esempio
Considera un'organizzazione che deve classificare i dati sensibili in due categorie: Alta e Media.

Per configurare la sicurezza a livello di colonna, un data steward, che dispone delle autorizzazioni appropriate, esegue i seguenti passaggi per configurare una gerarchia di classificazione dei dati.
Il responsabile dei dati crea una tassonomia denominata "Criticità aziendale". La tassonomia include i nodi o tag policy High e Medium.
Il responsabile della gestione dei dati decide che la policy per il nodo High includa l'accesso per un gruppo denominato high-tier-access.
Il responsabile dei dati crea più livelli di nodi nella tassonomia, in Alto e Medio. Il nodo di livello più basso è un nodo foglia, come il nodo foglia employee_ssn. Il responsabile dei dati può creare o meno un criterio di accesso diverso per il nodo foglia employee_ssn.
Il responsabile della gestione dei dati assegna un tag di criteri a colonne specifiche della tabella. In questo esempio, il responsabile dei dati assegna il criterio di accesso Alto alla colonna employee_ssn di una tabella.
Nella pagina Schema attuale della console, il responsabile dei dati può visualizzare il tag di criteriy che regola una determinata colonna. In questo esempio, la colonna employee_ssn si trova sotto il tag di criteri High, quindi quando visualizzi lo schema per employee_ssn, la console mostra il nome della tassonomia e il tag di criteri nel campo
Policy tags:Business criticality:High.
Per informazioni dettagliate sull'utilizzo della console per impostare un tag di criteri, vedi Impostare un tag di criteri su una colonna.
In alternativa, puoi impostare il tag di criteri utilizzando il comando
bq update. Il camponamesdipolicyTagsinclude l'ID del tag di criteri Alto,projects/project-id/locations/location/taxonomies/taxonomy-id/policyTags/policytag-id:[ ... { "name": "ssn", "type": "STRING", "mode": "REQUIRED", "policyTags": { "names": ["projects/project-id/locations/location/taxonomies/taxonomy-id/policyTags/policytag-id"] } }, ... ]
Per informazioni dettagliate sull'utilizzo del comando
bq updateper impostare un tag di criteri, vedi Impostare un tag di criteri su una colonna.L'amministratore esegue passaggi simili per il tag di criteri Media.
Con questo accesso granulare, puoi gestire l'accesso a molte colonne controllando solo un numero ridotto di tag criterio di classificazione dei dati.
Per informazioni dettagliate su questi passaggi, consulta Limitare l'accesso con il controllo dell'accesso a livello di colonna.
Ruoli utilizzati con controllo dell'accesso a livello di colonna
I seguenti ruoli vengono utilizzati per controllo dell'accesso a livello di colonna BigQuery.
Il ruolo Amministratore tag di criteri Data Catalog è necessario per gli utenti che devono creare e gestire tassonomie e tag di criteri.
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Amministratore tag di policy Data Catalog (datacatalog.categoryAdmin)
|
datacatalog.categories.getIamPolicydatacatalog.categories.setIamPolicydatacatalog.taxonomies.createdatacatalog.taxonomies.deletedatacatalog.taxonomies.getdatacatalog.taxonomies.getIamPolicydatacatalog.taxonomies.listdatacatalog.taxonomies.setIamPolicydatacatalog.taxonomies.updateresourcemanager.projects.getresourcemanager.projects.list
|
Si applica a livello di progetto. Questo ruolo concede la possibilità di svolgere le seguenti operazioni:
|
Per creare e gestire le policy dei dati sono necessari il ruolo Amministratore policy dei dati BigQuery, Amministratore BigQuery o Proprietario dati BigQuery. Quando utilizzi la consoleGoogle Cloud per applicare controllo dell'accesso a una tassonomia, il servizio crea automaticamente una policy relativa ai dati.
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Amministratore delle norme sui dati BigQuery (bigquerydatapolicy.admin) Amministratore BigQuery ( bigquery.admin) Proprietario dei dati BigQuery ( bigquery.dataOwner)
|
bigquery.dataPolicies.createbigquery.dataPolicies.deletebigquery.dataPolicies.getbigquery.dataPolicies.getIamPolicybigquery.dataPolicies.listbigquery.dataPolicies.setIamPolicybigquery.dataPolicies.update
|
Le autorizzazioni Questo ruolo concede la possibilità di svolgere le seguenti operazioni:
|
datacatalog.taxonomies.get, che puoi ottenere da diversi
dei
ruoli predefiniti di Data Catalog.
Il ruolo Lettore granulare Data Catalog è obbligatorio per gli utenti che devono accedere ai dati nelle colonne protette.
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Lettore granulare/datacatalog.categoryFineGrainedReader
|
datacatalog.categories.fineGrainedGet |
Si applica a livello di tag di criteri. Questo ruolo concede la possibilità di accedere ai contenuti delle colonne limitati da un tag di criteri. |
Per saperne di più sui ruoli di Data Catalog, consulta Identity and Access Management (IAM) di Data Catalog. Per saperne di più sui ruoli BigQuery, consulta Controllo dell'accesso con IAM.
Impatto delle operazioni di scrittura
Per leggere i dati da una colonna protetta dal controllo dell'accesso a livello di colonna, l'utente deve sempre disporre dell'autorizzazione di lettura tramite l'accesso in lettura granulare sui tag criterio per la colonna.
Ciò si applica a:
- Tabelle, incluse quelle con caratteri jolly
- Visualizzazioni
- Copiare le tabelle
Per scrivere dati in una riga per una colonna protetta dal controllo dell'accesso a livello di colonna, il requisito dell'utente dipende dal tipo di scrittura.
Se l'operazione di scrittura è un'inserimento, non è necessario l'accesso in lettura granulare. Tuttavia, l'utente non ha accesso alla lettura dei dati inseriti, a meno che non disponga di un accesso in lettura granulare.
Se un utente esegue un'istruzione INSERT SELECT, è necessario il ruolo di lettore granulare nella tabella sottoposta a query.
Se l'operazione di scrittura è un aggiornamento, un'eliminazione o un'unione, l'utente non può eseguire l'operazione a meno che non disponga di un accesso in lettura granulare alle colonne di lettura.
Un utente può caricare i dati da file locali o da Cloud Storage. Quando carichi i dati in una tabella, BigQuery non controlla l'autorizzazione di lettura granulare sulle colonne della tabella di destinazione. Questo perché il caricamento dei dati non richiede la lettura dei contenuti dalla tabella di destinazione. Allo stesso modo, un utente può caricare dati dallo streaming, perché i caricamenti di streaming non controllano i tag delle norme. L'utente non ha accesso in lettura ai dati caricati da uno stream, a meno che non disponga di un accesso in lettura granulare.
Per saperne di più, consulta Impatto sulle scritture con il controllo dell'accesso a livello di colonna.
Tabelle di query
Se un utente ha accesso al set di dati e dispone del ruolo Lettore granulare di Data Catalog, i dati delle colonne sono disponibili per l'utente. L'utente esegue una query come di consueto.
Se un utente ha accesso al set di dati, ma non ha il ruolo Lettore granulare di Data Catalog, i dati delle colonne non sono disponibili per l'utente. Se un utente di questo tipo esegue SELECT *, riceve un errore che elenca le colonne a cui non può accedere. Per risolvere l'errore, puoi:
Modifica la query in modo da escludere le colonne a cui l'utente non può accedere. Ad esempio, se l'utente non ha accesso alla colonna
ssn, ma ha accesso alle colonne rimanenti, può eseguire la seguente query:SELECT * EXCEPT (ssn) FROM ...
Nell'esempio precedente, la clausola
EXCEPTesclude la colonnassn.Chiedi a un amministratore Data Catalog di aggiungere l'utente come lettore granulare Data Catalog alla classificazione dei dati pertinente. Il messaggio di errore fornisce il nome completo del tag di criteri a cui l'utente deve accedere.
Visualizzazioni query
L'impatto della sicurezza a livello di colonna sulle viste è indipendente dal fatto che la vista sia una vista autorizzata o meno. In entrambi i casi, la sicurezza a livello di colonna viene applicata in modo trasparente.
Una vista autorizzata è una delle seguenti:
- Una vista esplicitamente autorizzata ad accedere alle tabelle in un set di dati.
- Una vista autorizzata implicitamente ad accedere alle tabelle in un set di dati perché è contenuta in un set di dati autorizzato.
Per saperne di più, consulta Viste autorizzate e Set di dati autorizzati.
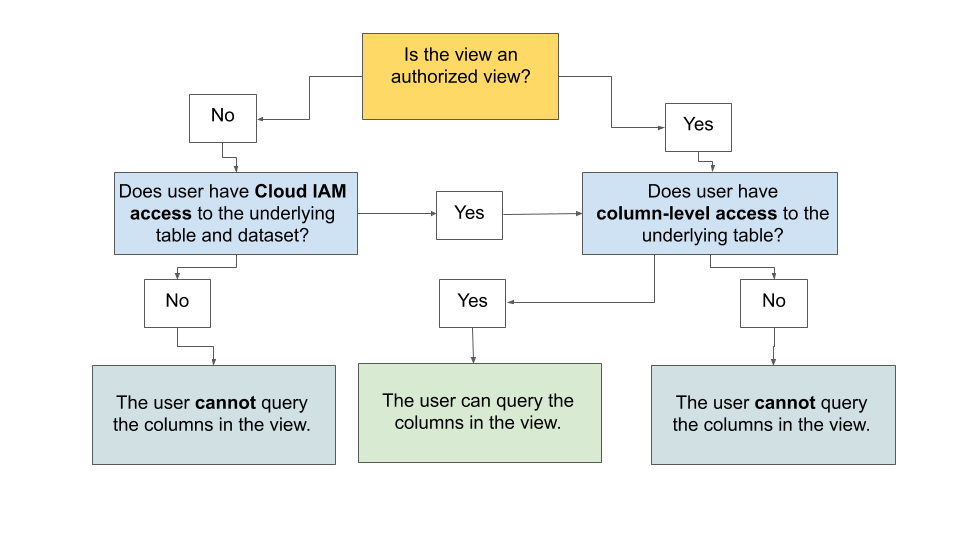
Se la visualizzazione non è una vista autorizzata:
Se l'utente dispone dell'accesso IAM alle tabelle e al set di dati sottostanti della vista, nonché dell'accesso a livello di colonna alle tabelle sottostanti della vista, può eseguire query sulle colonne della vista. In caso contrario, l'utente non può eseguire query sulle colonne nella visualizzazione.
Se la visualizzazione è una vista autorizzata:
Solo la sicurezza a livello di colonna nelle colonne delle tabelle sottostanti della vista controlla l'accesso. I criteri IAM a livello di tabella e di set di dati, se presenti, non vengono utilizzati per controllare l'accesso. Se l'utente ha accesso ai tag di policy utilizzati nelle tabelle sottostanti della vista autorizzata, può eseguire query sulle colonne della vista autorizzata.
Il seguente diagramma mostra come viene valutato l'accesso a una visualizzazione.
Impatto del time travel e delle viste materializzate con max_staleness
BigQuery ti consente di eseguire query su una tabella in uno stato precedente. Questa funzionalità ti consente di eseguire query sulle righe da un momento precedente. Ti consente anche di ripristinare una tabella da un momento specifico.
In SQL precedente, esegui query sui dati storici utilizzando i decoratori temporali sul nome della tabella. In GoogleSQL, esegui query sui dati storici utilizzando la clausola
FOR SYSTEM_TIME AS OF nella tabella.
Le viste materializzate con l'opzione max_staleness impostata restituiscono i dati storici
all'interno dell'intervallo di obsolescenza. Questo comportamento è simile a una query che utilizza
FOR SYSTEM_TIME AS OF al momento dell'ultimo aggiornamento della vista, in quanto
consente a BigQuery di eseguire query sui record eliminati o aggiornati.
Supponiamo di eseguire una query sui dati storici di una tabella al momento t. In questo caso:
Se lo schema al momento t è identico o un sottoinsieme dello schema attuale della tabella, BigQuery esegue il controllo in base alla sicurezza a livello di colonna più recente nella tabella attuale. Se l'utente è autorizzato a leggere le colonne attuali, può eseguire query sui dati storici di queste colonne. Per eliminare o mascherare i dati sensibili delle colonne protette dalla sicurezza a livello di colonna, quest'ultima può essere tranquillamente ridotta solo dopo che è trascorso il periodo di tempo configurato per il time travel dall'eliminazione dei dati sensibili.
Se lo schema al momento t è diverso dallo schema attuale per le colonne della query, la query non riesce.
Eliminazione implicita delle policy di accesso a livello di colonna
I tag delle policy possono essere rimossi implicitamente (automaticamente) da una tabella in diverse condizioni.
Il principio generale per l'eliminazione automatica dei tag policy è:
- Le operazioni che utilizzano una disposizione di scrittura
WRITE_TRUNCATEsovrascrivono sempre i tag di criteri esistenti nella tabella di destinazione, a meno che non venga fornito un nuovo schema con tag di criteri. - Per le operazioni con una disposizione di scrittura
WRITE_APPEND, i tag di policy correnti della tabella di destinazione vengono conservati.
Nello specifico, i tag criterio vengono rimossi implicitamente nelle seguenti situazioni:
Sostituzione di una tabella: quando una tabella viene sostituita utilizzando l'istruzione DDL
CREATE OR REPLACE
TABLE
, tutti i tag di criteri esistenti nella tabella originale vengono eliminati.Caricamento o query con
WRITE_TRUNCATE: le operazioni che utilizzano la disposizione di scritturaWRITE_TRUNCATErimuovono tutti i tag di criteri esistenti. Ciò include il caricamento dei dati utilizzando il comandobq load --replacee l'esecuzione di una query con lo statowriteDispositionimpostato suWRITE_TRUNCATE. Queste operazioni sovrascrivono completamente la tabella e i tag di policy esistenti non vengono trasferiti a meno che non li fornisci esplicitamente nello schema di destinazione.Ad esempio, se scrivi i risultati della query in una tabella specificando il flag
--destination_table, tutti i tag di policy esistenti vengono rimossi dalla tabella, a meno che tu non utilizzi il flag--destination_schemaper specificare uno schema con tag di policy. L'esempio seguente mostra come utilizzare--destination_schema.bq query --destination_table mydataset.mytable2 \ --use_legacy_sql=false --destination_schema=schema.json \ 'SELECT * FROM mydataset.mytable1'Le modifiche allo schema vengono eseguite in un'operazione separata dall'esecuzione della query. Se la query genera successivamente un'eccezione, è possibile che le modifiche allo schema vengano ignorate. In questo caso, controlla lo schema della tabella di destinazione e aggiornalo manualmente, se necessario.
Eliminazione o scadenza della tabella: se una tabella viene eliminata esplicitamente o se raggiunge il tempo di scadenza e viene rimossa automaticamente, vengono rimosse anche tutte le tag di policy associate dallo schema della tabella.
Operazioni di copia delle tabelle: quando si copia una tabella senza tag di criteri in una tabella di destinazione con tag di criteri, i tag nella tabella di destinazione vengono rimossi, a meno che non venga utilizzato il flag
--append_tableo"writeDisposition": "WRITE_APPEND".
L'utilizzo dell'istruzione DML TRUNCATE
TABLE, che rimuove tutte le righe da una tabella mantenendone lo schema, non rimuove i tag delle norme.
Considerazioni sulla posizione
Quando scegli una posizione per la tua tassonomia, tieni presente le seguenti limitazioni.
Tag di policy
Le tassonomie sono risorse regionali, come i set di dati e le tabelle BigQuery. Quando crei una tassonomia, specifichi la regione o la località per la tassonomia.
Puoi creare una tassonomia e applicare tag policy alle tabelle in tutte le regioni in cui è disponibile BigQuery. Tuttavia, per applicare i tag di policy di una tassonomia a una colonna della tabella, la tassonomia e la tabella devono esistere nella stessa posizione regionale.
Sebbene non sia possibile applicare un tag di criteri a una colonna della tabella che si trova in una posizione diversa, puoi copiare la tassonomia in un'altra posizione replicandola esplicitamente.
Se vuoi utilizzare la stessa tassonomia e gli stessi tag di policy in più località regionali, scopri di più sulla replica delle tassonomie in Gestire i tag di policy in più località.
Organizzazioni
Non puoi utilizzare i riferimenti tra organizzazioni. Una tabella e tutti i tag di policy che vuoi applicare alle relative colonne devono esistere nella stessa organizzazione.
Limitazioni
Quando esegui la migrazione di un progetto tra risorse dell'organizzazione, le tassonomie tag di criteri non vengono aggiornate automaticamente. Devi ricreare manualmente le classificazioni nell'organizzazione di destinazione per renderle visibili nella console Google Cloud . Per maggiori informazioni, vedi Gestire i casi speciali.
Questa funzionalità potrebbe non essere disponibile quando utilizzi prenotazioni create con alcune versioni di BigQuery. Per ulteriori informazioni sulle funzionalità abilitate in ogni edizione, vedi Introduzione alle versioni di BigQuery.
BigQuery supporta controllo dell'accesso a livello di colonna solo per le tabelle BigLake, le tabelle BigQuery e le tabelle BigQuery Omni.
Una colonna può avere un solo tag di criteri.
Una tabella può avere al massimo 1000 tag di criteri unici.
Non puoi utilizzare SQL precedente se hai attivato controllo dell'accesso a livello di colonna. Tutte le query SQL precedente vengono rifiutate se sono presenti tag di policy nelle tabelle di destinazione.
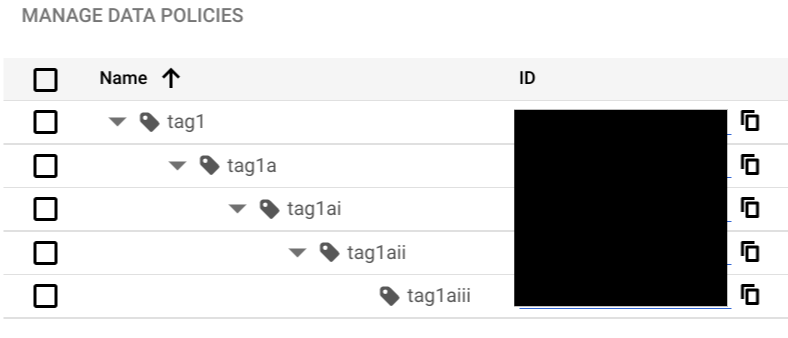
Una gerarchia di tag di criteri non può avere più di cinque livelli di profondità dal nodo principale al sottotag di livello più basso, come mostrato nello screenshot seguente:
I nomi delle tassonomie devono essere univoci tra tutti i progetti all'interno di un'organizzazione.
Non puoi copiare una tabella tra regioni se hai attivato il controllo dell'accesso a livello di colonna o riga. Tutte le copie delle tabelle tra le regioni vengono rifiutate se sono presenti tag di policy nelle tabelle di origine.
Prezzi
Controllo dell'accesso a livello di colonna richiede l'utilizzo sia di BigQuery sia di Data Catalog. Per informazioni sui prezzi di questi prodotti, consulta i seguenti argomenti:
Audit logging
Quando vengono letti i dati della tabella con i tag di policy, salviamo i tag di policy a cui viene fatto riferimento in Cloud Logging. Tuttavia, il controllo tag di criteri non è associato alla query che ha attivato il controllo.
Tramite Cloud Logging, gli auditor possono capire chi ha quale tipo di accesso a quali categorie di dati sensibili. Per saperne di più, consulta Audit dei tag delle policy.
Per ulteriori informazioni sulla registrazione in BigQuery, consulta Introduzione al monitoraggio di BigQuery.
Per saperne di più sul logging in Google Cloud, consulta Cloud Logging.
Passaggi successivi
Per informazioni dettagliate sull'utilizzo controllo dell'accesso a livello di colonna, vedi Limitare l'accesso con il controllo dell'accesso a livello di colonna.
Per informazioni sulle best practice per i tag di criteri, consulta Best practice di BigQuery: utilizzo dei tag di criteri.