


创建数据智能体
本文档介绍了如何在 BigQuery 中创建、修改、管理和删除数据智能体。
在 BigQuery 中,您可以与数据智能体进行对话,使用自然语言询问有关 BigQuery 数据的问题。数据智能体包含表元数据和特定于用例的查询处理指令,这些指令定义了回答用户关于一组知识来源(例如您选择的表、视图或用户定义的函数 [UDF])的问题的最佳方式。
准备工作
-
启用 BigQuery、Gemini 数据分析、Gemini for Google Cloud和 Knowledge Catalog API(如果尚未启用)。
启用 API 所需的角色
如需启用 API,您需要拥有
serviceusage.services.enable权限。如果您创建了项目,则可能已经通过 Owner 角色 (roles/owner) 拥有此权限。否则,您可以通过 Service Usage Admin 角色 (roles/serviceusage.serviceUsageAdmin) 获得此权限。了解如何授予角色。
所需的角色
如需使用数据智能体,您必须拥有与您的用例相匹配的 Identity and Access Management (IAM) 权限。以下部分根据您是要创建和发布代理、在 Gemini Enterprise 中预配代理,还是在各种平台上发现和使用代理,列出了所需的角色。如需了解详情,请参阅 Conversational Analytics API IAM 角色。
- 创建、修改、发布、分享和删除代理:
- 在项目中创建数据智能体:针对项目的 Gemini 数据分析 Data Agent Creator (
roles/geminidataanalytics.dataAgentCreator)。此角色会自动为您授予对您创建的数据代理的 Gemini Data Analytics Data Agent Owner 角色。 - 如需修改、共享或删除数据智能体,您需要拥有智能体或项目上的 Gemini Data Analytics 数据代理所有者 (
roles/geminidataanalytics.dataAgentOwner) 角色。 - 如需修改项目中的数据智能体,请执行以下操作:针对项目授予 Gemini Data Analytics Data Agent Editor (
roles/geminidataanalytics.dataAgentEditor) 角色。 - 如需查看项目中的数据智能体,请拥有项目的 Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer) 角色。
- 在项目中创建数据智能体:针对项目的 Gemini 数据分析 Data Agent Creator (
- 在 Gemini Enterprise 中预配代理:
- 如需让 Gemini Enterprise 中的用户能够使用已发布的智能体,您需要拥有在 Gemini Enterprise 管理控制台中注册和管理自定义智能体以及配置Agent Gateway的权限。
- 发现和使用代理:
- 如需与数据智能体对话:Gemini Data Analytics Data Agent User (
roles/geminidataanalytics.dataAgentUser)。 - 如需查看项目中的所有数据智能体,请使用 Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer)。 - 如需与数据洞察中由 Gemini 赋能的对话界面互动,您需要:BigQuery Studio User (
roles/bigquery.studioUser) 或 Gemini for Google Cloud User (roles/cloudaicompanion.user),这两个角色都提供cloudaicompanion.topics.create权限。在项目级层授予这些角色。用户还需要数据洞察 Asset Viewer (roles/datastudio.viewer) 角色。
- 如需与数据智能体对话:Gemini Data Analytics Data Agent User (
- 向智能体添加知识来源:
- 项目的 Data Catalog Viewer (
roles/datacatalog.viewer)。
- 项目的 Data Catalog Viewer (
- 配置和查看对话日志:
- 如需在代理的项目中创建日志数据集并授予访问权限,您需要拥有
bigquery.datasets.create角色,以及日志数据集的 BigQuery Data Owner (roles/bigquery.dataOwner) 或 BigQuery Admin (roles/bigquery.admin) 角色。 - 如需更改代理的对话日志记录设置,请执行以下操作:
geminidataanalytics.dataAgents.update,包含在 Gemini Data Analytics Data Agent Editor (roles/geminidataanalytics.dataAgentEditor) 中。 - 对于 Conversational Analytics API 服务代理 (
service-PROJECT_NUMBER@gcp-sa-geminidataanalytics.iam.gserviceaccount.com),需要创建日志表并写入行:日志数据集上的 BigQuery Data Editor (roles/bigquery.dataEditor)。如果日志数据集使用客户管理的 Cloud KMS 密钥 (CMEK),请向 BigQuery 加密服务账号 (bq-PROJECT_NUMBER@bigquery-encryption.iam.gserviceaccount.com) 授予 Cloud KMS 密钥的 Cloud KMS CryptoKey Encrypter/Decrypter (roles/cloudkms.cryptoKeyEncrypterDecrypter) 角色。 - 对于查询对话日志的分析师:日志数据集上的 BigQuery Data Viewer (
roles/bigquery.dataViewer) 和项目上的 BigQuery Job User (roles/bigquery.jobUser)(用于运行查询)。
- 如需在代理的项目中创建日志数据集并授予访问权限,您需要拥有
如需进行对话,请参阅对话所需的角色。
代理会代表您执行操作,并使用您的权限。智能体只能访问您有权访问的数据和资源。
最佳做法
对话式分析会自动代表您运行查询,以回答您的问题。请考虑以下可能增加查询费用的因素:
- 表大小较大
- 在查询中使用数据联接
- 在查询中频繁调用 AI 函数
生成数据分析
您可以选择在 Knowledge Catalog 中为要用作知识来源的任何表生成数据洞见。
生成的分析洞见提供表元数据,数据智能体可以使用这些元数据来帮助生成您的问题的回答。
如果您未提前生成分析洞见,那么在创建数据智能体时,当您选择表作为知识源后,系统会自动生成分析洞见。
使用抽样数据智能体
如果您不熟悉如何为对话式分析配置代理,则可以选择查看为每个Google Cloud 项目生成的预定义示例代理。您可以与其对话,并查看其参数以了解其创建方式,但无法对其进行修改。
如需查看示例代理,请执行以下操作:
在 Google Cloud 控制台中,前往 BigQuery 代理页面。
选择智能体目录标签页。
在 Google 提供的示例代理部分下,点击示例代理卡片。
创建数据代理
以下部分介绍了如何创建数据智能体。
创建代理后,您可以修改其设置。
初始步骤
在 Google Cloud 控制台中,前往 BigQuery 代理页面。
选择智能体目录标签页。
点击新建代理 (New agent)。 系统会打开新建代理页面。
在编辑器部分的代理名称字段中,输入数据代理的描述性名称,例如
Q4 sales data或User activity logs。在智能体说明字段中,输入数据智能体的说明。一个好的说明会解释智能体的用途、使用的数据,并帮助您了解何时适合与该数据智能体对话,例如
Ask questions about customer orders and revenue。在知识来源部分中,点击添加来源。系统会打开添加知识来源页面。
在近期部分中,选择要用作知识源的任何表、视图、图表或 UDF。在 Google Cloud 控制台中,UDF 带有“fx”指示符前缀。
如需查看更多知识来源,请选择 展开。
可选:添加未在最近部分中列出的知识来源:
在搜索部分,在搜索表字段中输入来源名称,然后按 Enter 键。来源名称不必完全一致。
在搜索结果部分中,选择一个或多个来源。
点击添加。系统会重新打开新代理页面。
自定义表和字段说明
为了提高数据智能体的准确性,您可以选择提供额外的表元数据。只有数据智能体使用此元数据,它不会影响源表。
创建表和字段说明时,请遵循以下最佳实践:
请参考这些说明,了解数据智能体如何理解架构。如果代理建议的说明正确无误,您可以接受这些说明。
如果您在配置这些说明后,数据智能体仍未显示对架构的理解,请手动调整说明以提供正确的信息。
请按照以下步骤配置表和字段说明:
在知识来源部分中,点击表的自定义链接。
创建表说明。您可以在表说明字段中输入说明,也可以接受 Gemini 给出的建议。
在字段部分中,查看 Gemini 建议的字段说明。
选择要接受的任何字段说明,然后点击接受建议。选择要拒绝的所有说明,然后点击拒绝建议。
点击字段旁边的修改,手动修改任何字段说明。系统会打开修改字段窗格。
- 在说明字段中,输入字段说明。
- 如需保存字段说明,请点击更新。
如需保存说明和字段更新,请点击更新。系统会重新打开新代理页面。
针对需要自定义的每个表重复上述步骤。
创建智能体指令
智能体应无需任何自定义指令即可理解用户问题的上下文。仅当您需要更改代理的行为或以其他上下文功能(例如自定义表和字段元数据或经过验证的查询)尚不支持的方式改进上下文时,才为代理创建自定义指令。
在指令部分,在智能体指令字段中输入数据智能体的指令。由于数据智能体使用这些指令来理解用户问题的上下文并提供回答,因此请尽可能使指令清晰。
如果您未从智能体获得满意的回答,请添加结构化上下文,例如说明、示例或词汇表术语。如果您仍然没有得到满意的答案,请添加自定义指令,如下表中的示例所示。
如需查看更多指令示例,请点击显示示例。
| 信息类型 | 说明 | 示例 |
|---|---|---|
| 关键字段 | 用于分析的最重要字段。 | “此表中最重要字段是:客户 ID、商品 ID、订单日期。” |
| 过滤和分组 | 代理应用于对数据进行过滤和分组的字段。 | “如果问题涉及时间轴或‘一段时间内’,请始终使用 order_created_date 列。” “当有人说‘按商品’时,按 product_category 列分组。” |
| 默认过滤 | 默认过滤字段。 | "Unless stated otherwise, always filter the data on order_status = 'Complete'." |
| 同义词和业务术语 | 关键字段的替代术语。 | “如果有人询问‘收入’或‘销售额’,请使用 total_sale_amount 列。”"我们认为,‘忠实’客户是指 purchase_count > 5 的客户。" |
| 排除的字段 | 数据代理应避免使用的字段。 | “请勿使用以下字段:推断的交易日期、推断的城市。” |
| 联接关系 | 两个或更多表之间的关系,以及用于联接这些表的列。智能体必须对列对使用标准 SQL 联接来合并数据。请参阅示例列。 |
客户活动
|
创建经过验证的查询
代理会通过以下两种方式使用经过验证的查询:
- 如果代理可以使用经过验证的查询来回答您提出的问题,则代理会完全按照编写的方式调用查询,以确保回答可靠。
- 如果代理无法使用经过验证的查询来回答问题,它仍会将该查询用作参考,以了解数据和查询数据的最佳实践。
您可以从系统生成的列表中选择经过验证的查询,也可以自行创建。
如需为数据智能体创建经过验证的查询(以前称为黄金查询),请执行以下操作:
选择一个或多个 Gemini 建议的经验证的查询:
- 在已验证的查询部分中,点击查看建议。系统会打开查看建议的经过验证的查询页面。
- 查看建议的经过验证的查询。选择适用于您的用例的任何选项。
- 点击添加。系统会重新打开新代理页面。
如需创建您自己的经过验证的查询,请点击添加查询。添加经过验证的查询页面随即打开。
- 在问题字段中,输入经过验证的查询所回答的用户问题。
- 点击生成 SQL,让 Gemini 生成与您指定的用户问题对应的已验证查询。
- 根据需要修改经过验证的查询。
- 点击运行,并验证查询是否返回了您预期的结果。
- 点击添加。系统会重新打开新代理页面。
根据需要重复上述步骤,以创建更多经过验证的查询。
创建参数化验证查询
参数化已验证查询会从用户向对话分析智能体提出的问题中提取值,并提供量身定制的结果。
分析师和构建者可以创建可重复使用的 SQL 模板,其中包含这些值的占位符。与常规验证查询相比,这些模板在运行时动态替换参数,以回答更广泛的用户问题。
当用户提出与模板格式匹配的问题时,对话分析代理会从问题中提取参数值,例如商品名称、区域和日期。然后,它会将这些值注入参数化查询。查询模板中的匹配回答会显示为已验证。
参数化验证查询可显著增强验证查询的功能和灵活性。它们可确保针对各种输入提供一致、可信的答案,并减少需要维护的单个查询数量。
工作原理
专家(例如数据分析师)使用模板问题定义经过验证的查询,例如“@product在 @region的销售额是多少?”然后,专家使用 SQL 参数创建或修改经过验证的查询,如以下示例所示:
SELECT * FROM sales WHERE region = @region AND product = @product
保存经过验证的查询后,用户可以使用自然语言向对话式分析代理提问,例如“北美地区的笔记本电脑销售额是多少?”
为了回答用户的问题,智能体执行以下步骤:
- 将问题与和参数化验证查询关联的模式进行匹配。智能体使用自然语言理解 (NLU) 从用户的问题中识别并提取
@region(北美)和@product(笔记本电脑)的值。 - 将提取的值代入 SQL 模板中的
@region和@product占位符。 - 运行完整的 SQL 查询,例如
SELECT * FROM sales WHERE
region = 'North America' AND product = 'Laptops'
。 - 将结果返回给用户。匹配项始终标记为已验证。
有关如何创建有效参数化查询的提示
- 使用清晰的参数名称。为参数使用描述性名称,例如
@start_date,而不是@d1。 - 创建详细的参数说明。用于对话式分析的大语言模型 (LLM) 会使用参数说明从用户问题中识别参数及其值。例如,
num_enrollments是一个有效的参数名称,但number of student enrollments from ages 5-14是一个参数说明,可提供有关查询的更多上下文。 - 确保数据类型一致。确保 SQL 查询预期的数据类型与可能从用户问题中提取的数据类型相匹配。
- 提供明确定义的范围。为常见且重要的问题模式创建模板,这些模式的查询结构复杂或逻辑不直观。这样做有助于 LLM 返回最佳结果。
- 全面测试。使用各种自然语言措辞进行测试,以确保正确提取参数。
创建参数化验证查询
您可以从系统生成的列表中选择经过验证的查询,也可以创建自己的查询。
在创建或修改查询之前,请先草拟查询,同时考虑自然语言模式和您的问题。例如,如果您询问“我们是否知道美国东部仓库中有机香蕉的总库存?”,则可以将该问题重写为参数化验证查询,即“@region 仓库中 @product 的总库存是多少?”代理会将此问题转换为 SQL 查询,您可以使用默认值更新该查询。
如需为数据智能体创建参数化验证查询,您可以在创建新智能体时创建新查询,也可以为新智能体或现有智能体修改现有验证查询。
以下说明使用经过验证的示例查询来配置参数。
选择 Gemini 建议的现有已验证查询
- 在新的或现有智能体的已验证的查询部分中,点击查看建议。系统会打开查看建议的经过验证的查询页面。
- 选中建议的已验证查询旁边的复选框。
- 在查询窗口中,点击 展开以展开查询说明。
- 如需打开现有查询,请点击修改。
- 如需完成查询配置,请参阅配置已验证查询的参数。
创建代理,然后创建经过验证的查询
- 请参阅初始步骤,然后继续执行其余配置步骤,直至经过验证的查询。
- 在 Google Cloud 控制台中,在新的智能体的已验证的查询部分,点击添加查询。系统会打开添加经过验证的查询页面。
- 如需完成查询配置,请参阅配置已验证查询的参数。
为已验证的查询配置参数
- 在问题字段中,输入由经过验证的查询回答的用户问题。
- 如需指定参数,请使用
@符号,后跟参数名称。此语法标识一个占位符,用于从用户问题中提取值。使用自然语言问题,展示如何在用户问题中使用这些参数。例如:“@product 在 @region 仓库的总库存是多少?” 点击生成 SQL。SQL 类似于以下示例:
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = @product AND region = @region;如需向查询中的占位符添加默认值,请点击管理查询参数,然后点击添加查询参数。
对于第一个参数,系统会显示名称、类型、值和说明四个字段。
- 对于名称,请从问题中复制
@product并将其粘贴到此字段中。 - 在类型部分中,选择字符串。
- 对于值,输入
organic bananas。 - 在说明部分,输入尽可能具体的说明。 例如,位于地区仓库中的商品。
- 对于名称,请从问题中复制
对于第二个参数,点击添加查询参数。
- 对于名称,请从问题中复制
@region并将其粘贴到此字段中。 - 在类型部分中,选择字符串。
- 对于值,输入
US-EAST。 - 对于说明,请输入尽可能具体的说明,例如
a regional warehouse where products are located.
- 对于名称,请从问题中复制
填写完这两个参数的字段后,点击保存。
测试参数化验证查询
- 点击运行,验证查询是否返回了您预期的结果。
- 如需在后续界面中测试针对用户的查询,请复制整个问题字段。
- 点击保存以退出添加查询界面,并返回到代理修改页面。
- 在代理修改页面上,将您之前复制的问题字段粘贴到预览窗口中。
- 将
@product变量替换为organic bananas。 - 将
@region变量替换为US-EAST。
- 将
- 按 Enter 键。查看结果,在这种情况下,有效答案是 US-EAST 区域的香蕉总库存数量,例如 1,000。
- 如需创建或修改其他经过验证的查询,请根据需要重复上述步骤。
保存查询后,用户可以提出以下问题:“我们知道 US-EAST 仓库中有机香蕉的总库存吗?”然后,对话式分析会执行以下操作:
- 将此问题与模式进行匹配。
- 从问题中提取
@product参数(@product=“有机香蕉”) 和@region参数(=“US-EAST”)。 - 执行查询:
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = 'organic bananas' AND region = 'US-EAST'; - 返回计算得出的
total_stock。
创建或审核术语表
您可以创建代理本地的 BigQuery 自定义术语表术语,也可以查看从 Knowledge Catalog 导入的、适用于您为代理选择的知识来源的业务术语库术语。
- 由于 Knowledge Catalog 中的业务术语库术语会全局应用于 BigQuery 资源,因此如果您使用 Knowledge Catalog,请在 Knowledge Catalog 中创建和管理业务术语库术语,而不是为各个代理创建和管理。
- 如果您需要修改从 Knowledge Catalog 导入的业务术语库术语,则必须在 Knowledge Catalog 中修改这些术语,然后返回 BigQuery 查看。
- BigQuery 自定义术语表中的字词会保留在 BigQuery 中。 不会显示在 Knowledge Catalog 中。
- 如果您不使用 Knowledge Catalog,则可以为需要为特定代理定义的术语创建 BigQuery 自定义术语表术语。
请按照以下步骤为代理创建自定义术语表:
- 在代理编辑器页面的术语表部分中,点击添加字词。
- 在自定义条款部分,您可以修改或删除任何现有自定义条款。
- 如需创建一个或多个新字词,请点击创建字词。
- 输入术语、定义以及一个或多个同义词(以英文逗号分隔)。
- 如需创建术语,请点击添加。
- 如果您想删除新条款,请点击删除。
- 如需创建更多自定义字词,请重复上述步骤。
如需查看从 Knowledge Catalog 导入的业务术语库术语,请按以下步骤操作:
- 在代理编辑器页面的术语表部分中,点击添加字词。
- 前往名为从 Dataplex 导入的网页版块。
- 如需在 Knowledge Catalog 中修改导入的术语,请点击前往 Dataplex 术语库。
- 在 Knowledge Catalog 中修改术语后,您可以返回代理编辑器页面查看修改后的术语。
配置设置
在设置部分中,您可以配置以下可选设置:
在模型部分中,选择用户在与智能体对话时可以使用哪些类型的模型。默认情况下,预览版和正式版模型均可用。处于预览阶段的模型可能会使用全球端点。
创建标签,以帮助您整理Google Cloud 资源。标签是键值对,可用于将相关对象组合在一起或者与其他 Google Cloud 资源组合在一起。
- 在设置部分中,点击管理标签。
- 点击添加标签。
- 在键和值字段中,输入标签的键值对。
- 如果您想添加更多标签,请再次点击添加标签。
- 如需删除标签,请点击删除。
- 完成后,点击添加。系统会重新打开新代理页面。
如需将智能体的对话事件写入智能体项目中的 BigQuery 表,以便进行监控和分析,请在对话日志记录部分中开启启用对话日志记录:
如果在修改现有代理时对话日志记录设置不可用,请将视图选择器切换到草稿,并确保选择特定 BigQuery 表作为知识来源。
在设置日志存储目标位置下,在数据集 ID 中选择代理项目中的现有目标数据集。在表 ID 中,选择一个现有表,或点击选择或创建表 > + 新建表,在指定新表下输入表名称(例如
agent_events),然后点击保存。查看数据日志记录和用户披露声明。
等待设置验证完成。如果数据集不存在,请先在 BigQuery 中创建。如果 Conversational Analytics API 服务代理 (
service-PROJECT_NUMBER@gcp-sa-geminidataanalytics.iam.gserviceaccount.com) 缺少对数据集的访问权限,请点击授予访问权限以授予对数据集的roles/bigquery.dataEditor权限,或让管理员授予该权限。
发布代理后,从已发布代理的主聊天界面(预览部分不会记录)提出一个测试问题,然后在 BigQuery Studio 中刷新目标数据集,以确认日志表是否显示。如需稍后更新目标位置或关闭日志记录,请修改代理并发布更改(现有行不会被删除)。如需了解详情,请参阅对话日志记录概览。
为数据智能体处理的查询设置大小限制。在设置部分中,在结算字节数上限字段中输入一个值。您必须将此限制设置为
10485760或更高,否则您会收到以下出错提示:
Value error. In BigQuery on-demand pricing charges are
rounded up to the nearest MB, with a minimum of 10 MB of data processed
per query. So, max bytes billed must be set to greater or equal to
10485760.
如果您未指定值,则 maximum bytes billed 默认为项目的每天查询用量配额。除非您指定了自定义配额,否则每日用量配额不受限制。
继续阅读下一部分,将代理置于草稿模式或发布代理。
预览并发布代理
在预览部分,在提问字段中输入一个示例用户问题,然后按 Enter 键。如需验证数据智能体是否返回了您预期的数据,请查看智能体的响应。如果回答不符合您的预期,请在Editor部分中更改设置,以优化数据智能体配置,直到获得令人满意的回答。您可以继续测试和修改代理,以优化代理的结果。
点击保存。
如需将数据智能体置于草稿模式(以便日后重新修改),请点击 返回,返回到智能体目录页面。由于您的代理现在处于草稿模式,因此它会显示在代理目录标签页上的我的草稿代理部分中。
如需发布智能体,请留在智能体创建页面,然后继续执行下一步。
点击发布,打开发布渠道窗格并发布数据智能体,使其可在项目中使用。
可选:在您的智能体已发布对话框中,点击分享,与其他用户分享数据智能体。
在共享权限窗格中,点击添加主账号。
在新的主账号字段中,输入一个或多个主账号。
点击选择角色列表。
在角色列表中,选择以下角色之一:
- Gemini 数据分析 Data Agent User (
roles/geminidataanalytics.dataAgentUser):授予与数据智能体对话的权限。 - Gemini 数据分析 Data Agent Editor (
roles/geminidataanalytics.dataAgentEditor):授予修改数据智能体的权限。 - Gemini 数据分析 Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer):授予查看数据智能体的权限。
- Gemini 数据分析 Data Agent User (
点击保存。
如需返回新代理页面,请点击关闭。保存或发布智能体后,您会立即在智能体目录中看到它。
您可以使用 BigQuery Studio 或数据洞察创建与数据智能体的对话。您还可以使用 Conversational Analytics API 构建自己的界面,以便与数据智能体对话。如需了解如何发布到数据洞察,请参阅在数据洞察中发布数据智能体。如需了解如何发布到 Gemini Enterprise,请参阅在 Gemini Enterprise 中发布数据智能体。
管理数据智能体
您可以在代理目录标签页中找到现有代理,该标签页包含三个部分:
- 我的代理:您创建和发布的所有代理的列表。您可以修改已发布的代理并与他人分享。
- 我的代理草稿:您尚未发布的代理。您无法共享代理草稿。
- 您组织中的其他人分享的代理:其他人创建并与您分享的代理。如果其他人向您授予权限,您可以修改这些共享代理。
修改数据代理
如需修改数据智能体,请按以下步骤操作:
前往 BigQuery 代理页面。
选择智能体目录标签页。
找到要修改的数据智能体的智能体卡片。
如需在智能体编辑器中打开数据智能体,请点击 打开操作 > 点击智能体卡片上的修改。
根据需要修改数据代理的配置。
如需保存更改但不发布,请点击保存。
如要发布更改后的网站,请点击发布。在分享对话框中,您可以与他人分享代理,也可以点击取消。
如需返回代理窗格,请点击 返回。
共享数据智能体
请按照以下步骤分享已发布的数据智能体。您无法共享代理草稿。
前往 BigQuery 代理页面。
选择智能体目录标签页。
找到要修改的数据智能体的智能体卡片。
如需在智能体编辑器中打开数据智能体,请点击 打开操作 > 点击智能体卡片上的修改。
如需与其他用户共享数据智能体,请点击共享。
在共享权限窗格中,点击添加主账号。
在新的主账号字段中,输入一个或多个主账号。
点击选择角色列表。
在角色列表中,选择以下角色之一:
- Gemini Data Analytics Data Agent User (
roles/geminidataanalytics.dataAgentUser):授予与数据智能体对话的权限。 - Gemini 数据分析 Data Agent Editor (
roles/geminidataanalytics.dataAgentEditor):授予修改数据智能体的权限。 - Gemini 数据分析 Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer):授予查看数据智能体的权限。
- Gemini Data Analytics Data Agent User (
点击保存。
如需返回代理编辑页面,请点击关闭。
如需返回代理窗格,请点击 返回。
删除数据智能体
前往 BigQuery 代理页面。
选择智能体目录标签页。
在代理目录标签页的我的代理或我的代理草稿部分中,找到要删除的数据智能体的代理卡片。
点击 打开操作 > 删除。
在要删除代理吗?对话框中,点击删除。
在数据洞察中发布数据智能体
当您发布代理并与数据洞察用户共享时,该代理会自动显示在数据洞察的与数据对话页面上,供这些用户与之对话。
创建智能体并将其发布到数据洞察
作为数据分析师,您可以通过完成以下步骤来创建、修改代理并将其发布到数据洞察:
- 在 BigQuery 中创建或修改数据智能体。
- 发布代理。发布智能体时,请选择数据洞察作为发布选项。
- 按照说明共享代理,向您的数据洞察用户授予适当的 Identity and Access Management 角色。
与数据洞察用户分享您的代理
您可以直接与数据洞察用户分享智能体,方法是复制一个链接,该链接可打开与数据洞察中的智能体的对话;您也可以发送邮件,通知用户他们有权访问某个智能体。
如需分享指向智能体的直接链接,您可以通过以下方式复制智能体的专用网址:
- 在代理目录中:选择 打开操作 > 选择复制链接 > 选择 数据洞察。
- 在代理详情视图中:选择 复制代理链接 > 选择数据洞察。
- 从分享溢出菜单中,选择复制数据洞察中代理的链接。
- 在共享权限面板中点击保存后:选择复制链接。
如需发送电子邮件通知,告知收件人他们对代理的访问权限,请在共享权限面板中选择发送电子邮件。系统只会向您在相应编辑会话中刚刚与之共享代理的用户或群组发送邮件通知。群组的所有成员都会收到电子邮件通知,即使某个用户已经拥有该代理的代理级权限也是如此。该邮件包含分享代理的用户名称、代理名称,以及用于在数据洞察中打开代理的链接。
在 Gemini Enterprise 中发布数据智能体
您可以在 Gemini Enterprise 中发布 BigQuery 数据智能体,以便业务用户直接在 Gemini Enterprise 中使用自然语言查询和分析数据。此过程通常涉及数据分析师、Gemini Enterprise 管理员和业务用户之间的协作。如需详细了解这些用户所需的角色,请参阅必需的角色。
如需在 Gemini Enterprise 中发布数据智能体,请完成以下步骤:
- 查看前提条件。
- 在 BigQuery 中创建并发布数据智能体。
- 在 Gemini Enterprise 中配置代理。
- 发现智能体并与之对话。
查看前提条件
建议使用 Agent Registry 发布 BigQuery 对话式分析智能体。请遵循本部分中的前提条件,确保代理可在 Gemini Enterprise 中被检测到。
或者,您也可以使用 A2A 卡片 JSON 发布智能体。如果您使用此方法,请参阅在 BigQuery 中创建和发布数据智能体。
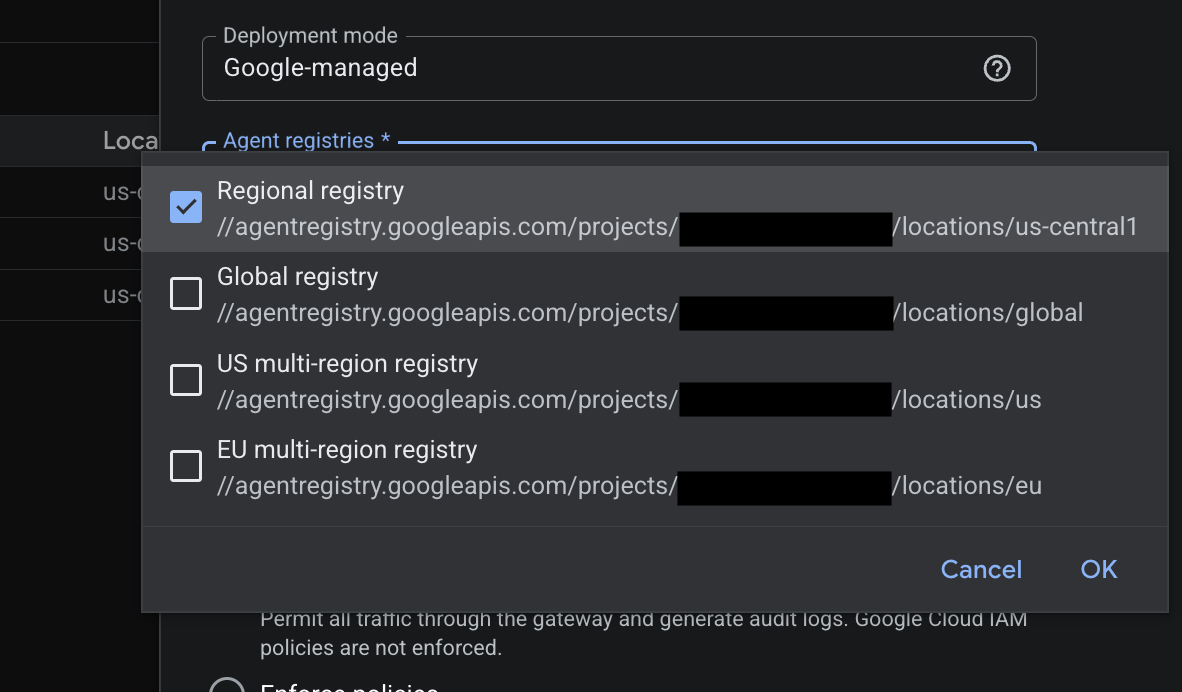
如需使用 Agent Registry,您必须先为 Agent Gateway 配置适当的区域映射。BigQuery 数据智能体的存储区域必须与 Gemini Enterprise 中的 Agent Gateway 注册表绑定区域一致。
您可以在 BigQuery Web 界面中智能体编辑器的区域部分为智能体配置存储区域。智能体一经保存,便无法更改其所在区域。
下图显示了 Agent Gateway 中可用的区域选项:
作为 Gemini Enterprise 管理员,请完成以下步骤,为 Gemini Enterprise 应用配置 Agent Gateway:
- 设置 Agent Gateway,其中包含与数据智能体所在区域匹配的 Agent Registry 绑定。选项包括美国、欧盟或全球。
- 在 Gemini Enterprise 中,打开您的应用,依次前往安全 > 配置,然后在Agent Gateway 配置部分中输入网关资源名称。如需了解详细说明,请参阅通过 Agent Gateway 路由 Gemini Enterprise 流量。
在 BigQuery 中创建并发布数据智能体
作为数据分析师,您可以通过完成以下步骤在 BigQuery 中创建、配置和发布智能体:
- 在 BigQuery 中,创建或修改数据智能体。
- 在区域部分中,验证存储区域是否与您的数据源和 Agent Gateway 配置一致。选项包括美国、欧盟或全球。
- 点击发布,如果之前已发布过该智能体,则点击发布更新。
- 在发布渠道窗格中的其他渠道下,选择发布方法:
- 如果您的 BigQuery 和 Gemini Enterprise 位于同一项目中,请在代理注册表部分中选中注册此代理复选框。
- 如果您想从注册表中移除代理,请点击取消注册。
- 如果您的 BigQuery 和 Gemini Enterprise 位于不同的项目中,请在通过 A2A (Agent2Agent) 集成部分中,点击复制 JSON 以复制 A2A 端点 JSON 数据,然后与 Gemini Enterprise 管理员分享该 JSON 数据。当您在 Gemini Enterprise 中预配代理时,会用到这些 JSON 数据。
- 如果您的 BigQuery 和 Gemini Enterprise 位于同一项目中,请在代理注册表部分中选中注册此代理复选框。
- 点击发布或发布更新。
- 与需要访问权限的用户和群组共享代理,并向其授予 Gemini 数据分析 Data Agent User (
roles/geminidataanalytics.dataAgentUser) 角色。
在 Gemini Enterprise 中配置代理
作为 Gemini Enterprise 管理员,您可以使用以下方法之一,让应用中的用户可以使用数据智能体:
选项 1:从 Agent Registry 导入
请按照以下步骤导入已注册的代理:
- 如果 Gemini Enterprise 与 BigQuery 项目位于不同的项目中,请完成以下步骤,在 Agent Registry 中手动注册代理。否则,请跳过此步骤:
- 在 Google Cloud 控制台中,前往 Gemini Enterprise 所在项目的智能体注册表,选择智能体标签页,然后点击添加智能体。
- 在代理详情窗格中,对于类型,选择 A2A。
- 在区域部分,选择与您的数据智能体和 Agent Gateway 配置匹配的区域。
- 选择粘贴 JSON,粘贴 BigQuery 中的 A2A 端点 JSON 数据,然后点击保存。
- 在 Gemini Enterprise 中,点击要添加代理的应用的名称。
- 在导航菜单中,依次点击代理 > 添加代理。
- 在选择代理类型窗格中,找到来自代理注册表的代理,然后点击添加。
- 在添加代理窗格中,按名称、Agent Registry ID、类型、提供方或用例搜索代理,或在列表中找到代理卡片。
- 在代理卡片上,点击添加代理。
- 在查看代理详情步骤中,查看从代理的 A2A 卡片填充的代理元数据,包括名称、说明、代理网址、功能和技能,然后点击下一步。
- 在对代理进行身份验证步骤中,选择 Gemini Enterprise 如何向代理提供方进行身份验证:
- Google 管理的默认凭据:Google 会自动管理 OAuth 凭据。您无需手动配置或输入客户端凭据。
- 自定义 OAuth:仅当贵组织需要自定义 OAuth 客户端凭证时,才选择此选项,然后输入客户端 ID、客户端密钥、授权网址和令牌网址。
- 点击完成。
- 该代理会显示在代理表中,状态为已启用,代理类型为 A2A(自定义)。
- 与需要访问权限的用户或群组共享智能体。
方法 2:使用 A2A 卡片 JSON 导入
如果 BigQuery 和 Gemini Enterprise 位于不同的项目中,请按照以下步骤使用 A2A 卡片 JSON 导入代理:
- 在 Gemini Enterprise 中,点击要添加代理的应用的名称。
- 在导航菜单中,依次点击代理 > 添加代理。
- 在选择代理类型窗格中,找到通过 A2A 构建的自定义代理,然后点击添加。
- 在代理卡片 JSON 字段中,输入从数据分析师处收到的代理卡片 JSON。
- 点击预览代理详情 > 点击下一步。
- 在代理授权步骤中,选择身份验证方法:
- 默认 Google 管理的凭证:Google 会自动管理 OAuth 凭证,无需您手动输入或生成客户端 ID 和客户端密钥。
- 自定义 OAuth:如果您想手动提供自定义 OAuth 凭证,请选择此选项,然后按照注册和管理 A2A 智能体中的步骤操作。
- 在工具授权步骤中,点击完成。
- 该代理会显示在代理表中,状态为已启用,代理类型为 A2A(自定义)。
- 与需要访问权限的用户或群组共享智能体。
发现和使用智能体
您可以通过以下任一方法在 Gemini Enterprise 中发现和使用数据智能体:
- 手动发现:在 Agent Gallery 中找到数据智能体,然后通过以下任一方法使用:
- 浏览库:选择智能体,然后开始专属对话。
- 直接链接:使用智能体的专用网址,直接在 Gemini Enterprise 中打开与该特定 BigQuery 数据智能体的对话。
- 定向意图:在 Gemini Enterprise 核心对话中通过
@mention(例如@sales_pipeline_agent)调用智能体。 - 无缝编排:提出一个宽泛的分析问题(例如,“过去 3 个月我们的销售管道趋势如何?”),Gemini Enterprise 会自动将查询路由到相关的数据智能体。
发现代理后,您可以通过执行以下步骤与其进行交互:
- 进行身份验证:完成一次性 OAuth 登录,以安全地向 BigQuery 进行身份验证。
- 对话:使用自然语言向智能体提问。请求由代理处理,响应以文本、Markdown、图表或表格的形式流式传输回 Gemini Enterprise。
- 查看对话记录:对话会自动保存在历史记录窗格中。
监控代理和对话
您可以在 BigQuery 中使用 Google Cloud Observability 监控数据智能体及其对话的性能、采用情况、延迟时间和费用。启用代理可观测性后,您可以查看以下指标:
- 对话中使用的代理数量
- 提问的用户数量
- 创建的对话数量
- 回答问题最多的客服人员
- 最常用的知识来源
- 用户互动度
- 预计 token 用量
- 每小时回答延迟时间
准备工作
启用 Cloud Trace、Cloud Monitoring、Cloud Logging API(如果尚未启用)。
启用 API 所需的角色
如需启用 API,您需要拥有 serviceusage.services.enable 权限。如果您创建了项目,则可能已经通过 Owner 角色 (roles/owner) 拥有此权限。否则,您可以通过 Service Usage Admin 角色 (roles/serviceusage.serviceUsageAdmin) 获得此权限。了解如何授予角色。
所需的角色和权限
如需启用智能体可观测性,您必须对项目拥有以下权限:
cloudaicompanion.gibqObservabilitySettings.createcloudaicompanion.gibqObservabilitySettings.listcloudaicompanion.gibqObservabilitySettings.updatecloudaicompanion.settingBindings.gibqObservabilitySettingsCreatecloudaicompanion.settingBindings.gibqObservabilitySettingsListcloudaicompanion.settingBindings.gibqObservabilitySettingsUsegeminidataanalytics.dataAgents.creategeminidataanalytics.operations.getobservability.traceScopes.createresourcemanager.projects.updateserviceusage.services.enableserviceusage.values.test
如需获得使用指标、跟踪记录和日志监控代理所需的权限,请让管理员为您授予项目的以下 IAM 角色:
-
查看监控数据和配置:Monitoring Viewer (
roles/monitoring.viewer) -
查看跟踪记录:Cloud Trace User (
roles/cloudtrace.user) -
查看日志:日志查看器 (
roles/logging.viewer) -
查看数据集及其内容:BigQuery Data Viewer (
roles/bigquery.dataViewer) -
查看管理员设置:Gemini for Google Cloud User (
roles/cloudaicompanion.user)
如需详细了解如何授予角色,请参阅管理对项目、文件夹和组织的访问权限。
启用可观测性
智能体可观测性默认处于停用状态。管理员可以为您的项目或组织启用此功能。如需为代理启用可观测性,请选择以下选项之一:
控制台
在 Google Cloud 控制台中,前往 BigQuery 代理页面。
选择监控标签页。
如果可观测性功能处于停用状态,请按照提示启用该功能。
Google Cloud CLI
创建可观测性设置:
gcloud gemini gibq-observability-settings create SETTING_NAME \
  --conversational-analytics-setting-metrics-enabled \
  --conversational-analytics-setting-traces-enabled \
  --project=PROJECT_ID \
  --location=global
替换以下内容:
SETTING_NAME:可观测性设置的名称。PROJECT_ID:您的项目 ID。
将可观测性设置绑定到您的项目:
gcloud gemini gibq-observability-settings setting-bindings create BINDING_NAME \
  --gibq-observability-setting=SETTING_NAME \
  --target=projects/PROJECT_ID \
  --location=global \
  --project=PROJECT_ID
将
BINDING_NAME替换为设置绑定的名称。我们建议您使用binding-PROJECT_ID作为绑定名称。
API
创建可观测性设置:
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "conversational_analytics_setting": {
            "metrics_enabled": true
          }
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings?gibq_observability_setting_id=SETTING_NAME"
替换以下内容:
SETTING_NAME:可观测性设置的名称。PROJECT_ID:您的项目 ID。
将可观测性设置绑定到您的项目:
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "target": "projects/PROJECT_ID",
          "product": "GEMINI_IN_BIGQUERY"
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings/SETTING_NAME/settingBindings?setting_binding_id=BINDING_NAME"
将
BINDING_NAME替换为设置绑定的名称。我们建议您将binding-PROJECT_ID用作绑定名称。
查看指标
启用可观测性后,系统会收集指标。数据不会回填。 如需查看代理指标,请选择以下选项之一:
BigQuery
在 Google Cloud 控制台中,前往 BigQuery 代理页面。
选择监控标签页。
Cloud Monitoring
在 Google Cloud 控制台中,前往 Cloud Monitoring 信息中心页面。
在我的信息中心窗格中,搜索名为
BigQuery Conversational Analytics的信息中心。如需打开信息中心,请点击其名称。
可选:创建自定义信息中心。
可选:如需单独查看指标,请前往 Metrics Explorer 页面。
智能体指标包括智能体使用情况、模型调用、工具使用情况、健康状况、延迟时间和 token 使用情况。
调试模型调用
您可以直观呈现对话轮次中的操作序列(例如模型调用和工具调用),以帮助您排查错误和延迟问题。
在 Google Cloud 控制台中,前往 Cloud Monitoring Trace 探索器页面。
点击要检查的 span。
查看详细信息窗格中的信息。
可选:创建自定义跟踪信息中心。
保留跟踪记录
您的 Cloud Trace 数据会存储在可观测性数据集中,保留期限为 30 天。如需将跟踪记录数据存储更长时间,请将跟踪记录数据移至 BigQuery 数据集。
所需的角色
如需获得通过创建关联数据集向 BigQuery 公开实时跟踪记录所需的权限,请让管理员向您授予项目的以下 IAM 角色:
- Cloud Trace Admin (
roles/cloudtrace.admin) - Observability Editor (
roles/observability.editor) - BigQuery User (
roles/bigquery.user)
如需详细了解如何授予角色,请参阅管理对项目、文件夹和组织的访问权限。
将跟踪数据移至 BigQuery
如需保留跟踪记录数据,请执行以下操作:
打开 Cloud Shell。
查找
_Trace存储桶的位置:gcloud beta observability buckets list --location=-
请记下
_Trace存储桶的位置,以便在下一步中使用。在 BigQuery 项目中创建一个指向
_Trace存储桶的关联数据集:gcloud beta observability buckets datasets links create \ projects/PROJECT_ID/locations/LOCATION/buckets/_Trace/datasets/Spans/links/LINK_NAME \ --dataset=Spans \ --bucket=_Trace \ --location=LOCATION \ --project=PROJECT_ID
替换以下内容:
PROJECT_ID:您的项目 IDLOCATION:上一步中_Trace存储桶的位置LINK_NAME:关联数据集的名称
创建一个标准数据集,用于存储历史轨迹。以下命令会将默认分区到期时间设置为 90 天(7,776,000 秒):
bq --location=LOCATION mk \
    --dataset \
    --default_partition_expiration=7776000 \
    --description="Archive storage for historical traces" \
    PROJECT_ID:STORAGE_DATASET
将
STORAGE_DATASET替换为数据集的名称。在存储数据集中创建一个空分区表,其架构与关联的数据集相同。按日期分区有助于您管理数据保留和查询费用。如需创建表,请在 SQL 编辑器中运行以下查询:
CREATE TABLE `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
PARTITION BY DATE(start_time)
AS
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE FALSE;
将
TABLE_NAME替换为表的名称。创建计划查询,以将每日跟踪记录数据从关联的数据集复制到归档表。以下查询会复制前一天的数据:
INSERT INTO `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE start_time >=
  TIMESTAMP_SUB(TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY), INTERVAL 1 DAY)
  AND start_time < TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY);
如需了解详情,请参阅如何查找和探索跟踪记录。
关闭可观测性
如需为数据智能体关闭可观测性,请更新可观测性设置:
gcloud gemini gibq-observability-settings update SETTING_NAME \
    --no-conversational-analytics-setting-metrics-enabled \
    --no-conversational-analytics-setting-traces-enabled \
    --project=PROJECT_ID \
    --location=global
替换以下内容:
SETTING_NAME:您为启用可观测性而创建的可观测性设置的名称。如果您使用 Google Cloud 控制台启用了可观测性,则设置名称为default。PROJECT_ID:您的项目 ID。
在 BigQuery 中分析对话日志
除了 Cloud Monitoring 中的项目级可观测性指标和 Cloud Trace 中的 span 之外,您还可以在 BigQuery Studio 中为每个代理启用对话日志记录,以将每个对话轮次(包括用户的问题、代理的回答、延迟时间和模型词元用量)写入代理项目中的 BigQuery 表。然后,您可以使用 GoogleSQL、交互式 Colab 笔记本或 BigQuery Agent Analytics Python SDK 查询和评估记录的事件。如需了解详情,请参阅对话日志记录概览。
后续步骤
- 详细了解 BigQuery 中的对话式分析。
- 详细了解 Conversational Analytics API。
- 通过对话分析数据。
- 详细了解 Gemini 数据分析 Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer) 角色如何授予查看数据智能体的权限。