


Menemukan dan membuat katalog data Cloud Storage
Dokumen ini menjelaskan cara menggunakan penemuan otomatis Knowledge Catalog, sebuah fitur di BigQuery yang memungkinkan Anda memindai data di bucket Cloud Storage untuk mengekstrak dan membuat katalog metadata. Sebagai bagian dari pemindaian penemuan, penemuan otomatis membuat tabel BigLake atau tabel eksternal untuk data terstruktur dan tabel objek untuk data tidak terstruktur. Tabel BigLake dan tabel eksternal memungkinkan Anda membuat kueri data terstruktur di datastore eksternal (lihat Pengantar tabel BigLake dan Pengantar tabel eksternal), sedangkan tabel objek menyediakan indeks metadata atas data tidak terstruktur di Cloud Storage (lihat Pengantar tabel objek). Data tabel terpusat ini memudahkan insight data, keamanan data, dan tata kelola yang didukung AI.
Untuk menggunakan penemuan otomatis data Cloud Storage, Anda harus membuat dan menjalankan pemindaian penemuan.
Penemuan otomatis juga disebut penemuan mandiri.
Ringkasan pemindaian penemuan
Pemindaian penemuan melakukan hal berikut:
- Memindai data di bucket atau jalur Cloud Storage.
- Mengelompokkan data terstruktur dan semi-terstruktur ke dalam tabel.
- Mengumpulkan metadata, seperti nama tabel, skema, dan definisi partisi.
- Membuat dan memperbarui tabel eksternal BigLake, eksternal non-BigLake, atau objek BigLake di BigQuery menggunakan skema dan definisi partisi.
Data terstruktur dan semi-terstruktur
Data terstruktur dan semi-terstruktur mencakup format seperti Avro, Parquet, dan CSV. Pemindaian penemuan mendaftarkan grup file ini sebagai tabel eksternal BigLake. Pemindaian hanya mendeteksi file jika file tersebut berada di folder yang berisi format data yang sama dan skema yang kompatibel.
- Kasus penggunaan: Memusatkan file terstruktur dengan jenis yang kuat ke BigQuery untuk menjalankan kueri SQL analitis tanpa menentukan skema secara manual.
- Alur kerja:
- Atur file terstruktur Anda ke dalam folder. Pastikan file di setiap folder memiliki format data yang sama dan memiliki skema yang kompatibel.
- Buat pemindaian penemuan dan berikan ID koneksi resource Google Cloud Anda.
- Pemindaian akan mengelompokkan data dan mendaftarkannya sebagai tabel eksternal BigLake.
- Membuat kueri tabel yang dipublikasikan langsung di BigQuery menggunakan SQL.
Format yang didukung
- Parquet
- Avro
- ORC
- JSON (hanya format yang dibatasi baris baru)
- CSV (tetapi bukan file CSV yang memiliki baris komentar)
Format kompresi
Untuk data terstruktur dan semi-terstruktur, pemindaian penemuan mendukung format kompresi berikut:
Kompresi internal untuk format berikut:
Kompresi Contoh ekstensi file Format yang didukung gzip .gz.parquetParquet lz4 .lz4.parquetParquet Snappy .snappy.parquetParquet, ORC, Avro lzo .lzo.parquetParquet, ORC Kompresi eksternal untuk file JSON dan CSV:
- gzip
- bzip2
Data tidak terstruktur
Untuk data tidak terstruktur, seperti gambar dan video, pemindaian penemuan mendeteksi dan
mendaftarkan grup file yang memiliki format file data yang sama. File harus berada di folder yang berisi format file yang sama. Misalnya,
gs://images/group1 hanya boleh berisi gambar GIF, dan gs://images/group2 hanya boleh
berisi gambar JPEG agar pemindaian penemuan dapat mendeteksi dan mendaftarkan dua
tabel objek BigLake.
- Kasus penggunaan: Buat katalog file tidak terstruktur seperti gambar atau dokumen untuk melakukan inferensi machine learning menggunakan BigQuery ML atau fungsi jarak jauh.
- Alur kerja:
- Atur file tidak terstruktur Anda ke dalam folder. Pastikan file di setiap folder memiliki format file yang sama.
- Buat pemindaian penemuan.
- Pemindaian akan mengelompokkan data tidak terstruktur dan mendaftarkannya sebagai tabel objek BigLake.
- Lakukan inferensi pada file tidak terstruktur Anda langsung di BigQuery.
Format yang didukung
Pemindaian penemuan mendukung format tidak terstruktur berikut:
- Gambar (seperti JPEG, PNG, dan BMP)
- Dokumen (seperti PDF, presentasi slide, dan laporan teks)
- Audio atau video (seperti WAV, MP3, dan MP4)
Untuk mengetahui informasi selengkapnya, lihat file objek yang didukung.
Format kompresi
Untuk tabel objek, kompresi dikelola terutama melalui metadata objek Cloud Storage, bukan setelan internal BigQuery.
- Kompresi metadata standar: BigQuery otomatis mengenali file yang dikompresi dengan gzip dan bzip2 jika menggunakan ekstensi .gz atau .bz2 standar.
- Content-Encoding: Anda dapat menggunakan metadata Content-Encoding gzip di Cloud Storage untuk menyajikan file yang dikompresi sambil mempertahankan jenis konten aslinya.
- Kompresi internal media: format yang dikompresi secara inheren (seperti JPEG untuk gambar, MP3 untuk audio, MP4 untuk video) didukung secara native.
Pendaftaran dan ketersediaan tabel
Tabel yang ditemukan akan didaftarkan di BigQuery sebagai salah satu jenis tabel berikut, bergantung pada format data dan konfigurasi pemindaian Anda:
- Tabel objek BigLake. Dibuat untuk data tidak terstruktur, seperti gambar dan video.
- Tabel eksternal BigLake. Dibuat untuk data terstruktur dan semi-terstruktur saat Anda memberikan ID koneksi resource Google Cloud selama konfigurasi pemindaian.
- Tabel eksternal (non-BigLake): Dibuat untuk data terstruktur dan semi-terstruktur jika Anda tidak memberikan ID koneksi resource.
Pendaftaran ini membuat data mereka tersedia untuk dianalisis di BigQuery. Caching metadata untuk tabel BigLake dan tabel objek juga diaktifkan. Semua tabel BigLake otomatis diserap ke dalam Knowledge Catalog untuk penelusuran dan penemuan.
Untuk mulai menggunakan tabel yang baru didaftarkan, Anda dapat:
- Jalankan kueri di BigQuery.
- Telusuri resource di Knowledge Catalog.
Batasan dan kuota
Pemindaian penemuan tidak mendukung format tabel Apache Iceberg dan Delta Lake.
Untuk melihat batas jumlah tabel yang didukung pemindaian penemuan, lihat Kuota dan batas.
Sebelum memulai
Aktifkan Dataplex API, jika belum diaktifkan.
Peran yang diperlukan untuk mengaktifkan API
Untuk mengaktifkan API, Anda memerlukan izin serviceusage.services.enable. Jika Anda
membuat project, kemungkinan Anda sudah memiliki izin ini melalui
peran Pemilik (roles/owner). Jika tidak, Anda bisa mendapatkan izin ini melalui
peran Service Usage Admin (roles/serviceusage.serviceUsageAdmin).
Pelajari cara memberikan peran.
Peran yang diperlukan untuk akun layanan Knowledge Catalog
Sebelum memulai, tetapkan izin IAM ke akun layanan Knowledge Catalog di project Anda.
service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com
Ganti PROJECT_NUMBER dengan project tempat
Dataplex API diaktifkan.
Untuk memastikan bahwa akun layanan Knowledge Catalog memiliki izin yang diperlukan untuk membuat dan menjalankan pemindaian penemuan, minta administrator untuk memberikan peran IAM berikut kepada akun layanan Knowledge Catalog:
- Dataplex Discovery Service Agent (
roles/dataplex.discoveryServiceAgent) di bucket penyimpanan - Dataplex Discovery Publishing Service Agent (
roles/dataplex.discoveryPublishingServiceAgent) di project pengguna -
Membuat tabel BigLake:
Dataplex Discovery BigLake Publishing Service Agent (
roles/dataplex.discoveryBigLakePublishingServiceAgent) di koneksi BigQuery
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project, folder, dan organisasi.
Peran bawaan ini berisi izin yang diperlukan untuk membuat dan menjalankan pemindaian penemuan. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk membuat dan menjalankan pemindaian penemuan:
-
bigquery.datasets.createdi project sumber data -
storage.buckets.getdi bucket sumber data -
storage.objects.getdi bucket sumber data -
storage.objects.listdi bucket sumber data -
bigquery.datasets.getdi project sumber data -
Menyediakan koneksi:
-
bigquery.connections.delegatepada koneksi BigQuery -
bigquery.connections.usepada koneksi BigQuery
-
Administrator Anda mungkin juga dapat memberikan izin ini kepada akun layanan Knowledge Catalog dengan peran khusus atau peran bawaan.
Peran yang diperlukan untuk akun layanan koneksi BigQuery
Untuk memastikan akun BigQuery Connection Service memiliki izin yang diperlukan untuk membuat pemindaian penemuan, minta administrator Anda untuk memberikan peran IAM Dataplex Discovery Service Agent (roles/dataplex.discoveryServiceAgent) ke akun BigQuery Connection Service di bucket Cloud Storage.
Peran bawaan ini berisi izin yang diperlukan untuk membuat pemindaian penemuan. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk membuat pemindaian penemuan:
-
bigquery.datasets.createdi project sumber data -
storage.buckets.getdi bucket sumber data -
storage.objects.getdi bucket sumber data -
storage.objects.listdi bucket sumber data -
bigquery.datasets.getdi project sumber data -
Menyediakan koneksi:
-
bigquery.connections.delegatepada koneksi BigQuery -
bigquery.connections.usepada koneksi BigQuery
-
Administrator Anda mungkin juga dapat memberikan izin ini kepada akun BigQuery Connection Service dengan peran khusus atau peran bawaan lainnya.
Peran yang diperlukan untuk pengguna akhir
Untuk mendapatkan izin yang Anda perlukan untuk membuat dan mengelola pemindaian penemuan data, minta administrator untuk memberi Anda peran IAM berikut di bucket Cloud Storage:
-
Akses penuh ke resource DataScan:
Dataplex DataScan Administrator (
roles/dataplex.dataScanAdmin) - project Anda -
Akses tulis ke resource DataScan:
Dataplex DataScan Editor (
roles/dataplex.dataScanEditor) - project Anda -
Akses baca ke resource DataScan, tidak termasuk hasilnya:
Dataplex DataScan Viewer (
roles/dataplex.dataScanViewer) - project Anda -
Akses baca ke resource DataScan, termasuk hasilnya:
Dataplex DataScan DataViewer (
roles/dataplex.dataScanDataViewer) - project Anda
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project, folder, dan organisasi.
Peran yang telah ditetapkan ini berisi izin yang diperlukan untuk membuat dan mengelola pemindaian penemuan data. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk membuat dan mengelola pemindaian penemuan data:
-
Membuat DataScan:
dataplex.datascans.createdi project Anda -
Menghapus DataScan:
dataplex.datascans.deletedi project atau resource DataScan Anda -
Melihat detail DataScan, tidak termasuk hasil:
dataplex.datascans.getdi project Anda atau resource DataScan -
Melihat detail DataScan termasuk hasil:
dataplex.datascans.getDatadi project atau resource DataScan Anda -
Mencantumkan DataScan:
dataplex.datascans.listdi project Anda atau resource DataScan -
Menjalankan DataScan:
dataplex.datascans.rundi project Anda atau resource DataScan -
Memperbarui deskripsi DataScan:
dataplex.datascans.updatedi project Anda atau resource DataScan -
Melihat izin IAM DataScan:
dataplex.datascans.getIamPolicypada project Anda atau resource DataScan -
Menetapkan izin IAM di DataScan:
dataplex.datascans.setIamPolicydi project atau resource DataScan Anda
Anda mungkin juga bisa mendapatkan izin ini dengan peran khusus atau peran bawaan lainnya.
Membuat pemindaian penemuan
Untuk menemukan data, Anda harus membuat dan menjalankan pemindaian penemuan. Anda dapat menetapkan jadwal untuk pemindaian atau menjalankan pemindaian sesuai permintaan.
Saat pemindaian penemuan berjalan, pemindaian ini akan membuat set data baru di BigQuery yang sesuai dengan bucket Cloud Storage yang dipindai. Nama set data BigQuery sama dengan nama bucket Cloud Storage. Karakter yang tidak valid dalam nama bucket
diganti dengan garis bawah. Jika nama set data tidak tersedia, akhiran akan ditambahkan (misalnya, _discovered_001). Set data ini berisi tabel eksternal BigLake atau eksternal non-BigLake yang dibuat oleh pemindaian penemuan untuk analisis lebih lanjut.
Konsol
Di konsol Google Cloud , buka halaman Metadata curation.
Di tab Cloud Storage discovery, klik Create.
Di panel Create discovery scan, konfigurasikan detail tentang data yang akan dipindai.
Masukkan nama untuk pemindaian.
Di kolom Scan ID, masukkan ID unik yang mengikuti konvensi penamaan resource di Google Cloud. Jika Anda tidak memberikan ID, pemindaian penemuan akan menghasilkan ID pemindaian.
Opsional: Berikan deskripsi pemindaian.
Untuk menentukan bucket Cloud Storage yang berisi file yang akan dipindai, di kolom Bucket, cari dan pilih bucket.
Opsional: Tentukan data yang akan disertakan atau dikecualikan dari pemindaian penemuan dengan memberikan daftar pola glob untuk pemfilteran file. Knowledge Catalog mendukung pola glob berikut:
*: Mencocokkan nol karakter atau lebih, tanpa melewati batas direktori. Misalnya,*.csvcocok denganfile.csv, tetapi tidak cocok denganfolder/file.csv.**: Mencocokkan nol atau beberapa karakter, yang melintasi batas direktori. Misalnya,**/*.csvcocok denganfile.csvdanfolder/subfolder/file.csv.?: Cocok dengan tepat satu karakter. Misalnya,file_?.csvcocok denganfile_1.csvdanfile_a.csv, tetapi tidak denganfile_10.csv.[...]: Mencocokkan satu karakter dari kumpulan karakter. Misalnya,[abc]cocok dengana,b, atauc, dan[a-z]cocok dengan huruf kecil apa pun.{...}: Mencocokkan daftar subpola yang dipisahkan koma. Misalnya,{sun,moon,stars}cocok dengansun,moon, ataustars.\: Meng-escape karakter (*,?, atau\). Misalnya,file\*.csvcocok dengan nama file literalfile*.csv.
Anda dapat menentukan jenis pola berikut:
- Sertakan: jika hanya subset data yang harus dipindai, berikan daftar pola glob yang cocok dengan objek yang akan disertakan.
- Exclude: memberikan daftar pola glob yang cocok dengan objek yang akan dikecualikan.
Misalnya, jika Anda ingin mengecualikan
gs://test_bucket/foo/..dari pemindaian penemuan, masukkan**/foo/**sebagai jalur pengecualian. Tanda kutip menyebabkan error. Pastikan untuk memasukkan**/foo/**, bukan"**/foo/**".Jika Anda memberikan pola penyertaan dan pola pengecualian, pola pengecualian akan diterapkan terlebih dahulu.
Untuk Unstructured data options, pilih Enable semantic inference.
Opsi ini diperlukan jika Anda ingin melihat insight data untuk data tidak terstruktur di Knowledge Catalog. Untuk mengetahui informasi selengkapnya, lihat Tentang insight data tidak terstruktur.
Opsional: Di Project, pilih project set data BigQuery yang berisi tabel eksternal BigLake atau tabel eksternal non-BigLake yang dibuat oleh pemindaian penemuan. Jika tidak disediakan, set data akan dibuat di project yang berisi bucket Cloud Storage.
Di Location type, pilih Region atau Multi-region (mana saja yang tersedia) tempat set data publikasi BigQuery dibuat.
Untuk membuat tabel BigLake dari data yang dipindai, di kolom Connection ID, berikan ID koneksi resource Google Cloud Anda. Untuk mengetahui informasi selengkapnya, lihat koneksi resourceGoogle Cloud di BigQuery.
Anda dapat membuat ID koneksi baru di lokasi yang sama dengan lokasi set data BigQuery, yang kompatibel dengan lokasi bucket Cloud Storage.
Jika Anda tidak memberikan ID koneksi resource, pemindaian penemuan akan membuat tabel eksternal non-BigLake. Untuk memahami perbedaan antara jenis tabel eksternal ini dan alasan layanan penemuan mungkin memilih salah satu dari yang lain, lihat perbandingan perbedaan perilaku.
Di bagian Discovery frequency, konfigurasikan kapan Anda ingin pemindaian penemuan dijalankan:
Ulangi: pemindaian berjalan sesuai jadwal yang telah ditentukan. Berikan waktu mulai, hari untuk menjalankan pemindaian, dan frekuensi, seperti per jam.
Sesuai permintaan: pemindaian berjalan sesuai permintaan.
Opsional: Di bagian JSON or CSV specifications, tentukan cara pemindaian memproses file JSON dan CSV. Klik Spesifikasi JSON atau CSV.
- Untuk mengonfigurasi opsi JSON, pilih Enable JSON parsing options.
- Nonaktifkan inferensi jenis: apakah pemindaian penemuan harus menyimpulkan jenis data saat memindai data. Jika Anda menonaktifkan inferensi jenis untuk data JSON, semua kolom akan didaftarkan sebagai jenis primitifnya, seperti string, angka, atau boolean.
- Format encoding: encoding karakter data, seperti UTF-8, US-ASCII, atau ISO-8859-1. Jika Anda tidak menentukan nilai, UTF-8 akan digunakan sebagai default.
- Untuk mengonfigurasi opsi CSV, pilih Enable CSV parsing options.
- Nonaktifkan inferensi jenis: apakah pemindaian penemuan harus menyimpulkan jenis data saat memindai data. Jika Anda menonaktifkan inferensi jenis untuk data CSV, semua kolom akan didaftarkan sebagai string.
- Header rows: jumlah baris header, baik
0maupun1. Jika Anda menentukan nilai0, pemindaian penemuan akan menyimpulkan judul dan mengekstrak nama kolom dari file. Defaultnya adalah0. - Karakter pembatas kolom: karakter yang digunakan untuk memisahkan nilai. Berikan satu karakter,
\r(carriage return), atau\n(newline). Defaultnya adalah koma (,). - Format encoding: encoding karakter data, seperti
UTF-8,US-ASCII, atauISO-8859-1. Jika Anda tidak menentukan nilai, UTF-8 akan digunakan sebagai default.
- Untuk mengonfigurasi opsi JSON, pilih Enable JSON parsing options.
Klik Create (untuk pemindaian terjadwal), Run now (untuk pemindaian on-demand), atau Create and run (untuk pemindaian satu kali).
- Pemindaian terjadwal: dijalankan sesuai dengan jadwal yang Anda tetapkan.
- Pemindaian on-demand: dijalankan sekali di awal saat Anda membuatnya, dan Anda dapat menjalankan pemindaian kapan saja. Diperlukan waktu beberapa menit untuk menjalankan pemindaian penemuan.
- Pemindaian satu kali: dijalankan secara otomatis. Data ini akan otomatis dihapus saat mencapai batas time to live (TTL) yang ditentukan, yaitu nilai yang menentukan durasi pemindaian penemuan tetap aktif setelah eksekusi. Nilai TTL dapat berkisar dari 0 detik (penghapusan langsung) hingga 365 hari. Pemindaian penemuan tanpa TTL yang ditentukan akan otomatis dihapus setelah 24 jam.
gcloud
Untuk membuat pemindaian penemuan, gunakan perintah gcloud dataplex datascans create data-discovery.
gcloud dataplex datascans create data-discovery --location=LOCATION
--data-source-resource=BUCKET_PATH
Ganti kode berikut:
LOCATION: lokasi tempat Anda ingin membuat pemindaian penemuanBUCKET_PATH: jalur Cloud Storage bucket yang ingin Anda pindai
REST
Untuk membuat pemindaian penemuan, gunakan metode dataScans.create.
Membuat kueri tabel BigLake yang dipublikasikan
Setelah Anda menjalankan pemindaian penemuan, tabel BigLake akan dipublikasikan dalam set data baru di BigQuery. Tabel tersebut kemudian tersedia untuk analisis di BigQuery menggunakan SQL, atau di Managed Service untuk Apache Spark menggunakan Apache Spark atau HiveQL.
SQL
Anda dapat melihat atau mengkueri tabel di BigQuery. Untuk mengetahui informasi selengkapnya tentang cara menjalankan kueri di BigQuery, lihat Menjalankan kueri.
Apache Spark
Untuk mengkueri tabel BigLake menggunakan Spark SQL pada tugas serverless Managed Service untuk Apache Spark, ikuti langkah-langkah berikut:
Buat skrip PySpark yang mirip dengan contoh skrip berikut:
from pyspark.sql import SparkSession
session = (
  SparkSession.builder.appName("testing")
    .config("viewsEnabled","true")
    .config("materializationDataset", "DATASET_ID")
    .config("spark.hive.metastore.bigquery.project.id", "PROJECT_ID")
    .config("spark.hive.metastore.client.factory.class", "com.google.cloud.bigquery.metastore.client.BigQueryMetastoreClientFactory")
    .enableHiveSupport()
    .getOrCreate()
)

session.sql("show databases").show()
session.sql("use TABLE_NAME").show()
session.sql("show tables").show()

sql = "SELECT * FROM DATASET_ID.TABLE_ID LIMIT 10"
df = session.read.format("bigquery").option("dataset", "DATASET_ID").load(sql)
df.show()
Ganti kode berikut:
DATASET_ID: ID set data yang izin pembuatannya dimiliki penggunaPROJECT_ID: ID project dengan tabel BigLakeTABLE_NAME: Nama tabel BigLakeTABLE_ID: ID tabel BigLake
Mengelola tabel BigLake yang dipublikasikan
Tabel BigLake yang dipublikasikan dibuat dan dikelola di
BigQuery oleh pemindaian penemuan. Secara default, pemindaian penemuan
menangani penemuan data baru, inferensi skema, dan evolusi skema setiap kali
pemindaian terjadwal atau on-demand dijalankan. Untuk menunjukkan bahwa metadata dikelola
oleh pemindaian, pemindaian akan memublikasikan tabel dengan label metadata-managed-mode
yang ditetapkan ke discovery-managed.
Jika Anda ingin mengelola sendiri skema dan metadata lainnya seperti opsi CSV atau JSON, tetapkan label metadata-managed-mode ke user_managed. Dengan cara ini, skema tidak akan berubah saat pemindaian penemuan berikutnya dijalankan. Pendekatan ini dapat
berguna dalam skenario saat skema yang disimpulkan oleh pemindaian penemuan
salah atau berbeda dari yang diharapkan untuk tabel tertentu. Jika label metadata-managed-mode ditetapkan ke user_managed, biaya dapat dikurangi.
Untuk memperbarui label, Anda dapat mengedit nilai kunci label
metadata-managed-mode menjadi user_managed, bukan discovery-managed. Dalam
hal ini, pemindaian penemuan tidak akan memperbarui skema tabel selama
label user_managed dilampirkan ke tabel.
Mengupdate tabel BigLake yang dipublikasikan
Untuk tabel BigLake yang dipublikasikan menggunakan tugas pemindaian penemuan dengan konfigurasi default, skema dan metadata lainnya akan otomatis diperbarui dengan setiap tugas pemindaian penemuan yang dijalankan pada frekuensi yang dijadwalkan.
Untuk memperbarui tabel BigLake yang dipublikasikan, ikuti langkah-langkah berikut:
Di konsol Google Cloud , buka halaman BigQuery.
Di panel kiri, klik Explorer:
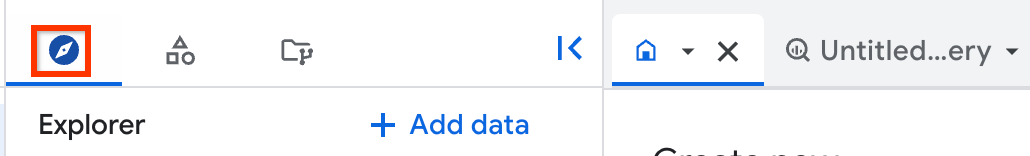
Jika Anda tidak melihat panel kiri, klik Luaskan panel kiri untuk membuka panel.
Di panel Explorer, luaskan project Anda, klik Datasets, lalu pilih set data.
Klik Overview > Tables, lalu pilih tabel.
Di tab Details, di bagian Labels, pastikan label metadata-managed-mode ditetapkan ke user_managed. Jika ditetapkan ke nilai yang berbeda, ikuti langkah-langkah berikut:
Klik Edit detail.
Di samping kunci metadata-managed-mode, di kolom value, masukkan
user_managed.
Menghapus tabel BigLake yang dipublikasikan
Untuk menghapus tabel BigLake yang dipublikasikan, ikuti langkah-langkah berikut:
Di konsol Google Cloud , buka halaman BigQuery.
Di panel kiri, klik Explorer:
Di panel Explorer, luaskan project Anda, klik Datasets, lalu pilih set data.
Klik Overview > Tables, lalu pilih tabel.
Di panel Details, di bagian Labels, pastikan label metadata-managed-mode tidak ditetapkan ke
user_managed. Jika disetel keuser_managed, ikuti langkah-langkah berikut:Klik Edit detail .
Di samping kunci metadata-managed-mode, di kolom value, masukkan
discovery-managed.
Klik Run. Pemindaian penemuan berjalan sesuai permintaan.
Setelah pemindaian penemuan berjalan, tabel BigLake akan dihapus di BigQuery dan tidak tersedia untuk dicantumkan atau dikueri melalui Spark.
Menjalankan pemindaian penemuan sesuai permintaan
Untuk menjalankan pemindaian penemuan sesuai permintaan, pilih salah satu opsi berikut.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, klik pemindaian penemuan yang ingin Anda jalankan.
Klik Jalankan sekarang.
gcloud
Untuk menjalankan pemindaian penemuan, gunakan
perintah gcloud dataplex datascans run:
gcloud dataplex datascans runDATASCAN\ --location=LOCATION
Ganti variabel berikut:
LOCATION: region Google Cloud tempat pemindaian penemuan dibuat.DATASCAN: nama pemindaian penemuan.
REST
Untuk menjalankan pemindaian penemuan sesuai permintaan, gunakan
metode dataScans.run
di Dataplex API.
Mencantumkan pemindaian penemuan
Untuk mencantumkan pemindaian penemuan, pilih salah satu opsi berikut.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, pemindaian penemuan yang dibuat dalam project akan dicantumkan.
gcloud
gcloud dataplex datascans list --location=LOCATION --project=PROJECT_ID
Ganti kode berikut:
LOCATION: lokasi project AndaPROJECT_ID: Project ID Google Cloud Anda
REST
Untuk mengambil daftar pemindaian penemuan di project Anda, gunakan
metode dataScans.list
di Dataplex API.
Melihat pemindaian penemuan
Untuk melihat pemindaian penemuan, pilih salah satu opsi berikut.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, klik pemindaian penemuan yang ingin Anda lihat detailnya.
- Bagian Scan details menampilkan detail tentang pemindaian penemuan.
- Bagian Scan status menampilkan hasil penemuan tugas pemindaian terbaru.
gcloud
gcloud dataplex datascans jobs describe JOB \
    --location=LOCATION \
    --datascan=DATASCAN \
    --view=FULL
Ganti kode berikut:
JOB: ID tugas pemindaian penemuan.LOCATION: region Google Cloud tempat pemindaian penemuan dibuat.DATASCAN: nama pemindaian penemuan yang terkait dengan tugas.
REST
Untuk melihat hasil pemindaian penemuan data, gunakan
metode dataScans.get
di Dataplex API.
Melihat hasil pemindaian penemuan historis
Untuk melihat hasil pemindaian penemuan historis, pilih salah satu opsi berikut.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, klik pemindaian penemuan yang ingin Anda lihat detailnya.
Klik panel Scan history. Panel Scan history memberikan informasi tentang tugas sebelumnya, termasuk jumlah data yang dipindai di setiap tugas, status setiap tugas, dan waktu tugas dijalankan.
Untuk melihat informasi mendetail tentang tugas, klik tugas di kolom ID pekerjaan.
gcloud
gcloud dataplex datascans jobs list \
    --location=LOCATION \
    --datascan=DATASCAN
Ganti kode berikut:
LOCATION: region Google Cloud tempat pemindaian penemuan dibuat.DATASCAN: nama pemindaian penemuan yang terkait dengan tugas.
REST
Untuk melihat semua tugas pemindaian penemuan, gunakan
metode dataScans.jobs.list
di Dataplex API.
Memperbarui pemindaian penemuan
Untuk mengubah jadwal pemindaian penemuan, misalnya, untuk mengubah jadwal dari on-demand menjadi berulang, perbarui pemindaian penemuan.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, untuk pemindaian penemuan yang ingin Anda perbarui, klik Actions > Edit.
Edit the values.
Klik Simpan.
gcloud
Untuk memperbarui pemindaian penemuan, gunakan perintah gcloud dataplex datascans update data-discovery.
gcloud dataplex datascans update data-discovery SCAN_ID --location=LOCATION --description=DESCRIPTION
Ganti kode berikut:
SCAN_ID: ID pemindaian penemuan yang ingin Anda updateLOCATION: region Google Cloud tempat pemindaian penemuan dibuatDESCRIPTION: deskripsi baru untuk pemindaian penemuan
REST
Untuk memperbarui pemindaian penemuan, gunakan
metode dataScans.patch
di Dataplex API.
Menghapus pemindaian penemuan
Untuk menghapus pemindaian penemuan, pilih salah satu opsi berikut.
Konsol
Di konsol Google Cloud , buka halaman BigQuery.
Di menu navigasi, klik Governance > Metadata curation.
Di panel Cloud Storage discovery, untuk pemindaian penemuan yang ingin Anda hapus, klik Actions > Delete.
Klik Hapus.
gcloud
gcloud dataplex datascans delete SCAN_ID --location=LOCATION --async
Ganti kode berikut:
SCAN_ID: ID pemindaian penemuan yang ingin Anda hapus.LOCATION: region Google Cloud tempat pemindaian penemuan dibuat.
REST
Untuk menghapus pemindaian penemuan, gunakan
metode dataScans.delete
di Dataplex API.