


Descubre y cataloga datos de Cloud Storage
En este documento, se explica cómo usar el descubrimiento automático de Knowledge Catalog, una función de BigQuery que te permite analizar datos en buckets de Cloud Storage para extraer y, luego, catalogar metadatos. Como parte del análisis de descubrimiento, el descubrimiento automático crea tablas de BigLake o externas para datos estructurados y tablas de objetos para datos no estructurados. Las tablas de BigLake y las tablas externas te permiten consultar datos estructurados en almacenes de datos externos (consulta Introducción a las tablas de BigLake y Introducción a las tablas externas), mientras que las tablas de objetos proporcionan un índice de metadatos sobre datos no estructurados en Cloud Storage (consulta Introducción a las tablas de objetos). Estos datos de tablas centralizados facilitan las estadísticas de datos, la seguridad de los datos y la administración potenciadas por IA.
Para usar el descubrimiento automático de datos de Cloud Storage, crea y ejecuta un análisis de descubrimiento.
El descubrimiento automático también se denomina descubrimiento independiente.
Descripción general del análisis de descubrimiento
Un análisis de descubrimiento hace lo siguiente:
- Analiza los datos en el bucket o la ruta de Cloud Storage.
- Agrupa datos estructurados y semiestructurados en tablas.
- Recopila metadatos, como el nombre de la tabla, el esquema y la definición de la partición.
- Crea y actualiza tablas externas de BigLake, externas que no son de BigLake u objetos de BigLake en BigQuery con el esquema y la definición de partición.
Datos estructurados y semiestructurados
Los datos estructurados y semiestructurados incluyen formatos como Avro, Parquet y CSV. La exploración de descubrimiento registra grupos de estos archivos como tablas externas de BigLake. El análisis detecta archivos solo si se encuentran en carpetas que contienen el mismo formato de datos y un esquema compatible.
- Caso de uso: Centraliza archivos estructurados con tipos de datos definidos en BigQuery para ejecutar consultas en SQL analíticas sin definir esquemas de forma manual.
- Flujo de trabajo:
- Organiza tus archivos estructurados en carpetas. Asegúrate de que los archivos de cada carpeta compartan el mismo formato de datos y tengan un esquema compatible.
- Crea un análisis de descubrimiento y proporciona el ID de conexión de recursos de Google Cloud .
- La exploración agrupa los datos y los registra como tablas externas de BigLake.
- Consulta las tablas publicadas directamente en BigQuery con SQL.
Formatos admitidos
- Parquet
- Avro
- ORC
- JSON (solo el formato delimitado por saltos de línea)
- CSV (pero no archivos CSV que tengan filas de comentarios)
Formatos de compresión
Para los datos estructurados y semiestructurados, el análisis de descubrimiento admite los siguientes formatos de compresión:
Compresión interna para los siguientes formatos:
Compresión Ejemplo de extensión de archivo Formato compatible: gzip .gz.parquetParquet lz4 .lz4.parquetParquet Snappy .snappy.parquetParquet, ORC, Avro lzo .lzo.parquetParquet, ORC Compresión externa para archivos JSON y CSV:
- gzip
- bzip2
Datos no estructurados
En el caso de los datos no estructurados, como imágenes y videos, el análisis de descubrimiento detecta y
registra grupos de archivos que comparten el mismo formato de archivo de datos. Los archivos deben estar
ubicados en carpetas que contengan el mismo formato de archivo. Por ejemplo,
gs://images/group1 solo debe contener imágenes GIF y gs://images/group2 solo debe
contener imágenes JPEG para que el análisis de descubrimiento detecte y registre dos
tablas de objetos de BigLake.
- Caso de uso: Cataloga archivos no estructurados, como imágenes o documentos, para realizar inferencias de aprendizaje automático con BigQuery ML o funciones remotas.
- Flujo de trabajo:
- Organiza tus archivos no estructurados en carpetas. Asegúrate de que los archivos de cada carpeta tengan el mismo formato de archivo.
- Crear un análisis de descubrimiento
- La exploración agrupa los datos no estructurados y los registra como tablas de objetos de BigLake.
- Realiza inferencias en tus archivos no estructurados directamente en BigQuery.
Formatos admitidos
La exploración de descubrimiento admite los siguientes formatos no estructurados:
- Imagen (como JPEG, PNG y BMP)
- Documentos (como PDF, presentaciones de diapositivas e informes de texto)
- Audio o video (como WAV, MP3 y MP4)
Para obtener más información, consulta Archivos de objetos compatibles.
Formatos de compresión
En el caso de las tablas de objetos, la compresión se administra principalmente a través de los metadatos de objetos de Cloud Storage, en lugar de la configuración interna de BigQuery.
- Compresión de metadatos estándar: BigQuery reconoce automáticamente los archivos comprimidos con gzip y bzip2 si usan las extensiones estándar .gz o .bz2.
- Content-Encoding: Puedes usar los metadatos de Content-Encoding gzip en Cloud Storage para entregar archivos comprimidos y, al mismo tiempo, mantener su tipo de contenido original.
- Compresión interna de contenido multimedia: Se admiten de forma nativa los formatos que se comprimen de forma inherente (como JPEG para imágenes, MP3 para audio y MP4 para video).
Registro y disponibilidad de tablas
Las tablas descubiertas se registran en BigQuery como uno de los siguientes tipos de tablas, según el formato de datos y la configuración de análisis:
- Tablas de objetos de BigLake. Se creó para datos no estructurados, como imágenes y videos.
- Tablas externas de BigLake. Se crea para datos estructurados y semiestructurados cuando proporcionas un ID de conexión de recursos de Google Cloud durante la configuración del análisis.
- Tablas externas (que no son de BigLake): Se crean para datos estructurados y semiestructurados si no proporcionas un ID de conexión de recursos.
Este registro hace que sus datos estén disponibles para su análisis en BigQuery. También se habilita el almacenamiento en caché de metadatos para las tablas de BigLake y de objetos. Todas las tablas de BigLake se transfieren automáticamente a Knowledge Catalog para su búsqueda y descubrimiento.
Para comenzar a trabajar con tus tablas recién registradas, puedes hacer lo siguiente:
- Ejecuta una consulta en BigQuery.
- Busca recursos en Knowledge Catalog.
Limitaciones y cuotas
Un análisis de descubrimiento no admite los formatos de tabla Apache Iceberg ni Delta Lake.
Para ver el límite de tablas que admite un análisis de descubrimiento, consulta Cuotas y límites.
Antes de comenzar
Habilita la API de Dataplex si aún no está habilitada.
Roles necesarios para habilitar las APIs
Para habilitar las APIs, necesitas el permiso serviceusage.services.enable. Si
creaste el proyecto, es probable que ya tengas este permiso a través del
rol de propietario (roles/owner). De lo contrario, puedes obtenerlo a través del
rol de administrador de Service Usage (roles/serviceusage.serviceUsageAdmin).
Obtén más información para otorgar roles.
Roles necesarios para la cuenta de servicio de Knowledge Catalog
Antes de comenzar, asigna los permisos de IAM a la cuenta de servicio de Knowledge Catalog en tu proyecto.
service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com
Reemplaza PROJECT_NUMBER por el proyecto en el que está habilitada la API de Dataplex.
Para garantizar que la cuenta de servicio de Knowledge Catalog tenga los permisos necesarios para crear y ejecutar un análisis de descubrimiento, pídele a tu administrador que otorgue los siguientes roles de IAM a la cuenta de servicio de Knowledge Catalog:
- Agente de servicio de Dataplex Discovery (
roles/dataplex.discoveryServiceAgent) en el bucket de almacenamiento - Agente de servicio de publicación de Dataplex Discovery (
roles/dataplex.discoveryPublishingServiceAgent) en el proyecto del usuario -
Crea tablas de BigLake:
Agente de servicio de publicación de Dataplex Discovery BigLake (
roles/dataplex.discoveryBigLakePublishingServiceAgent) en la conexión de BigQuery
Para obtener más información sobre cómo otorgar roles, consulta Administra el acceso a proyectos, carpetas y organizaciones.
Estos roles predefinidos contienen los permisos necesarios para crear y ejecutar un análisis de descubrimiento. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para crear y ejecutar un análisis de descubrimiento:
-
bigquery.datasets.createen el proyecto de la fuente de datos -
storage.buckets.geten el bucket de la fuente de datos -
storage.objects.geten el bucket de la fuente de datos -
storage.objects.listen el bucket de la fuente de datos -
bigquery.datasets.geten el proyecto de la fuente de datos -
Proporciona una conexión:
-
bigquery.connections.delegateen la conexión de BigQuery -
bigquery.connections.useen la conexión de BigQuery
-
Es posible que tu administrador también pueda otorgar estos permisos a la cuenta de servicio de Knowledge Catalog con roles personalizados o con otros roles predefinidos.
Roles necesarios para la cuenta de servicio de conexión de BigQuery
Para garantizar que la cuenta de servicio de conexión de BigQuery tenga los permisos necesarios
para crear un análisis de descubrimiento,
pídele a tu administrador que otorgue el rol de IAM de
agente de servicio de descubrimiento de Dataplex (roles/dataplex.discoveryServiceAgent) a la cuenta de servicio de conexión de BigQuery en el bucket de Cloud Storage.
Este rol predefinido contiene los permisos necesarios para crear un análisis de descubrimiento. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para crear un análisis de descubrimiento:
-
bigquery.datasets.createen el proyecto de la fuente de datos -
storage.buckets.geten el bucket de la fuente de datos -
storage.objects.geten el bucket de la fuente de datos -
storage.objects.listen el bucket de la fuente de datos -
bigquery.datasets.geten el proyecto de la fuente de datos -
Proporciona una conexión:
-
bigquery.connections.delegateen la conexión de BigQuery -
bigquery.connections.useen la conexión de BigQuery
-
Es posible que tu administrador también pueda otorgar estos permisos a la cuenta de servicio de conexión de BigQuery con roles personalizados o con otros roles predefinidos.
Roles obligatorios para los usuarios finales
Para obtener los permisos que necesitas para crear y administrar análisis de descubrimiento de datos, pídele a tu administrador que te otorgue los siguientes roles de IAM en el bucket de Cloud Storage:
-
Acceso completo a los recursos de DataScan:
Administrador de DataScan de Dataplex (
roles/dataplex.dataScanAdmin): tu proyecto -
Acceso de escritura a los recursos de DataScan:
Editor de DataScan de Dataplex (
roles/dataplex.dataScanEditor): tu proyecto -
Acceso de lectura a los recursos de DataScan, excepto los resultados:
Visualizador de DataScan de Dataplex (
roles/dataplex.dataScanViewer): tu proyecto -
Acceso de lectura a los recursos de DataScan, incluidos los resultados:
Visualizador de datos de DataScan de Dataplex (
roles/dataplex.dataScanDataViewer): tu proyecto
Para obtener más información sobre cómo otorgar roles, consulta Administra el acceso a proyectos, carpetas y organizaciones.
Estos roles predefinidos contienen los permisos necesarios para crear y administrar análisis de descubrimiento de datos. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para crear y administrar análisis de descubrimiento de datos:
-
Crea un DataScan:
dataplex.datascans.createen tu proyecto -
Borra un DataScan:
dataplex.datascans.deleteen tu proyecto o en un recurso de DataScan -
Consulta los detalles de DataScan, excepto los resultados:
dataplex.datascans.geten tu proyecto o un recurso de DataScan -
Consulta los detalles de DataScan, incluidos los resultados:
dataplex.datascans.getDataen tu proyecto o en un recurso de DataScan -
Enumera DataScans:
dataplex.datascans.listen tu proyecto o en un recurso de DataScan -
Ejecuta un DataScan:
dataplex.datascans.runen tu proyecto o en un recurso de DataScan -
Actualiza la descripción de un DataScan:
dataplex.datascans.updateen tu proyecto o un recurso de DataScan -
Consulta los permisos de IAM del DataScan:
dataplex.datascans.getIamPolicyen tu proyecto o en un recurso de DataScan -
Configura los permisos de IAM en el DataScan:
dataplex.datascans.setIamPolicyen tu proyecto o en un recurso de DataScan
También puedes obtener estos permisos con roles personalizados o con otros roles predefinidos.
Crea un análisis de descubrimiento
Para descubrir datos, debes crear y ejecutar un análisis de descubrimiento. Puedes establecer un programa para el análisis o ejecutarlo según demanda.
Cuando se ejecuta el análisis de descubrimiento, se crea un conjunto de datos nuevo en
BigQuery que corresponde al bucket de Cloud Storage
que se analizó. El nombre del conjunto de datos de BigQuery es el mismo que
el nombre del bucket de Cloud Storage. Los caracteres no válidos en el nombre del bucket
se reemplazan por un guion bajo. Si el nombre del conjunto de datos no está disponible, se agrega un sufijo (por ejemplo, _discovered_001). El conjunto de datos contiene las
tablas externas de BigLake o las tablas externas que no son de BigLake
que creó el análisis de descubrimiento para un análisis más detallado.
Console
En la consola de Google Cloud , ve a la página Selección de metadatos.
En la pestaña Detección de Cloud Storage, haz clic en Crear.
En el panel Crear análisis de descubrimiento, configura los detalles de los datos que se analizarán.
Ingresa un nombre para el análisis.
En el campo ID de análisis, ingresa un ID único que siga las convenciones de nombres de recursos en Google Cloud. Si no proporcionas un ID, el análisis de descubrimiento generará el ID de análisis.
Opcional: Proporciona una descripción del análisis.
Para especificar el bucket de Cloud Storage que contiene los archivos que se analizarán, en el campo Bucket, navega al bucket y selecciónalo.
Opcional: Define los datos que se incluirán o excluirán del análisis de descubrimiento proporcionando una lista de patrones glob para el filtrado de archivos. Knowledge Catalog admite los siguientes patrones de glob:
*: Coincide con cero o más caracteres, sin cruzar los límites del directorio. Por ejemplo,*.csvcoincide confile.csv, pero no confolder/file.csv.**: Coincide con cero o más caracteres, cruzando los límites del directorio. Por ejemplo,**/*.csvcoincide confile.csvyfolder/subfolder/file.csv.?: Coincide con exactamente un carácter. Por ejemplo,file_?.csvcoincide confile_1.csvyfile_a.csv, pero no confile_10.csv.[...]: Coincide con un carácter de un conjunto de caracteres. Por ejemplo,[abc]coincide cona,boc, y[a-z]coincide con cualquier letra minúscula.{...}: Coincide con una lista de subpatrones separados por comas. Por ejemplo,{sun,moon,stars}coincide consun,moonostars.\: Escapa un carácter (*,?o\). Por ejemplo,file\*.csvcoincide con el nombre de archivo literalfile*.csv.
Puedes especificar los siguientes tipos de patrones:
- Incluir: Si solo se debe analizar un subconjunto de los datos, proporciona una lista de patrones glob que coincidan con los objetos que se incluirán.
- Excluir: Proporciona una lista de patrones glob que coincidan con los objetos que se excluirán.
Por ejemplo, si deseas excluir
gs://test_bucket/foo/..del análisis de descubrimiento, ingresa**/foo/**como la ruta de exclusión. Las comillas provocan errores. Asegúrate de ingresar**/foo/**en lugar de"**/foo/**".Si proporcionas patrones de inclusión y exclusión, primero se aplican los patrones de exclusión.
En Opciones de datos no estructurados, selecciona Habilitar la inferencia semántica.
Esta opción es obligatoria si quieres ver estadísticas de datos para datos no estructurados en Knowledge Catalog. Para obtener más información, consulta Acerca de las estadísticas de datos no estructurados.
Opcional: En Proyecto, selecciona el proyecto del conjunto de datos de BigQuery que contiene las tablas externas de BigLake o que no son de BigLake creadas por el análisis de descubrimiento. Si no se proporciona, el conjunto de datos se crea en el proyecto que contiene el bucket de Cloud Storage.
En Tipo de ubicación, selecciona Región o Multirregión (lo que esté disponible) donde se crea el conjunto de datos de publicación de BigQuery.
Para crear tablas de BigLake a partir de los datos analizados, en el campo ID de conexión, proporciona el ID de conexión del recurso Google Cloud . Para obtener más información, consulta Conexiones de recursos deGoogle Cloud en BigQuery.
Puedes crear un ID de conexión nuevo en la misma ubicación que la ubicación del conjunto de datos de BigQuery, que es compatible con la ubicación del bucket de Cloud Storage.
Si no proporcionas un ID de conexión de recursos, la exploración de descubrimiento crea tablas externas que no son de BigLake. Para comprender las diferencias entre estos tipos de tablas externas y por qué el servicio de descubrimiento puede elegir una sobre otra, consulta la comparación de diferencias de comportamiento.
En la sección Frecuencia de descubrimiento, configura cuándo quieres que se ejecute el análisis de descubrimiento:
Repetir: El análisis se ejecuta según un programa predefinido. Proporciona la hora de inicio, los días para ejecutar el análisis y la frecuencia, como cada hora.
Según demanda: El análisis se ejecuta según demanda.
Opcional: En la sección Especificaciones de JSON o CSV, especifica cómo debe procesar la inspección los archivos JSON y CSV. Haz clic en Especificaciones de JSON o CSV.
- Para configurar las opciones de JSON, selecciona Habilitar las opciones de análisis de JSON.
- Inhabilitar la inferencia de tipos: Indica si el análisis de descubrimiento debe inferir tipos de datos cuando se analizan datos. Si inhabilitas la inferencia de tipos para los datos JSON, todas las columnas se registran como sus tipos primitivos, como cadena, número o booleano.
- Formato de codificación: Es la codificación de caracteres de los datos, como UTF-8, US-ASCII o ISO-8859-1. Si no especificas un valor, se usa UTF-8 de forma predeterminada.
- Para configurar las opciones de CSV, selecciona Habilitar las opciones de análisis de CSV.
- Inhabilitar la inferencia de tipos: indica si el análisis de descubrimiento debe inferir tipos de datos cuando se analizan datos. Si inhabilitas la inferencia de tipos para los datos de CSV, todas las columnas se registrarán como cadenas.
- Filas de encabezado: Es la cantidad de filas de encabezado, ya sea
0o1. Si especificas el valor0, el análisis de descubrimiento infiere los encabezados y extrae los nombres de las columnas del archivo. La configuración predeterminada es0. - Carácter delimitador de columnas: Es el carácter que se usa para
separar los valores. Proporciona un solo carácter,
\r(retorno de carro) o\n(línea nueva). El valor predeterminado es una coma (,). - Formato de codificación: Es la codificación de caracteres de los datos, como
UTF-8,US-ASCIIoISO-8859-1. Si no especificas un valor, se usa UTF-8 de forma predeterminada.
- Para configurar las opciones de JSON, selecciona Habilitar las opciones de análisis de JSON.
Haz clic en Crear (para un análisis programado), Ejecutar ahora (para un análisis a pedido) o Crear y ejecutar (para un análisis único).
- Análisis programado: Se ejecuta según la programación que establezcas.
- Análisis a pedido: Se ejecuta una vez inicialmente cuando lo creas, y puedes ejecutarlo en cualquier momento. La ejecución de la exploración de descubrimiento puede tardar varios minutos.
- Análisis único: Se ejecuta automáticamente. Se borra automáticamente cuando alcanza su umbral de tiempo de actividad (TTL) definido, un valor que determina la duración que un análisis de descubrimiento permanece activo después de la ejecución. El valor de TTL puede variar de 0 segundos (borrado inmediato) a 365 días. Un análisis de descubrimiento sin un TTL especificado se borra automáticamente después de 24 horas.
gcloud
Para crear un análisis de descubrimiento, usa el comando gcloud dataplex datascans create data-discovery.
gcloud dataplex datascans create data-discovery --location=LOCATION
--data-source-resource=BUCKET_PATH
Reemplaza lo siguiente:
LOCATION: la ubicación en la que deseas crear el análisis de descubrimientoBUCKET_PATH: Es la ruta de acceso de Cloud Storage del bucket que quieres analizar.
REST
Para crear un análisis de descubrimiento, usa el método dataScans.create.
Consulta tablas de BigLake publicadas
Después de ejecutar el análisis de descubrimiento, las tablas de BigLake se publican en un conjunto de datos nuevo en BigQuery. Luego, las tablas están disponibles para su análisis en BigQuery con SQL o en Managed Service para Apache Spark con Apache Spark o HiveQL.
SQL
Puedes ver o consultar tablas en BigQuery. Para obtener más información sobre cómo ejecutar consultas en BigQuery, consulta Ejecuta una consulta.
Apache Spark
Para consultar tablas de BigLake con Spark SQL en un trabajo sin servidores de Managed Service para Apache Spark, sigue estos pasos:
Crea una secuencia de comandos de PySpark similar a la siguiente secuencia de comandos de ejemplo:
from pyspark.sql import SparkSession
session = (
  SparkSession.builder.appName("testing")
    .config("viewsEnabled","true")
    .config("materializationDataset", "DATASET_ID")
    .config("spark.hive.metastore.bigquery.project.id", "PROJECT_ID")
    .config("spark.hive.metastore.client.factory.class", "com.google.cloud.bigquery.metastore.client.BigQueryMetastoreClientFactory")
    .enableHiveSupport()
    .getOrCreate()
)

session.sql("show databases").show()
session.sql("use TABLE_NAME").show()
session.sql("show tables").show()

sql = "SELECT * FROM DATASET_ID.TABLE_ID LIMIT 10"
df = session.read.format("bigquery").option("dataset", "DATASET_ID").load(sql)
df.show()
Reemplaza lo siguiente:
DATASET_ID: Es el ID del conjunto de datos para el que los usuarios tienen permiso de creación.PROJECT_ID: ID del proyecto con la tabla de BigLakeTABLE_NAME: Es el nombre de la tabla de BigLake.TABLE_ID: Es el ID de la tabla de BigLake.
Administra tablas de BigLake publicadas
El análisis de descubrimiento crea y administra las tablas de BigLake publicadas en
BigQuery. De forma predeterminada, el análisis de descubrimiento
controla el descubrimiento de datos nuevos, las inferencias de esquemas y la evolución de esquemas cada vez que
se ejecutan los análisis programados o a pedido. Para indicar que el análisis administra los metadatos, este publica tablas con la etiqueta metadata-managed-mode
establecida en discovery-managed.
Si deseas administrar el esquema y otros metadatos, como las opciones de CSV o JSON,
establece la etiqueta metadata-managed-mode en user_managed. De esta manera, el
esquema no se modifica cuando se ejecuta el siguiente análisis de descubrimiento. Este enfoque puede
ser útil en situaciones en las que el esquema que infiere el análisis de descubrimiento es
incorrecto o diferente de lo que se espera para una tabla determinada. Cuando la etiqueta metadata-managed-mode se establece en user_managed, puede reducir el costo.
Para actualizar la etiqueta, puedes editar el valor de la clave de etiqueta
metadata-managed-mode a user_managed en lugar de discovery-managed. En
este caso, el análisis de descubrimiento no actualiza el esquema de la tabla, siempre y cuando
la etiqueta user_managed esté adjunta a la tabla.
Actualiza las tablas de BigLake publicadas
En el caso de las tablas de BigLake publicadas con los trabajos de análisis de descubrimiento con la configuración predeterminada, el esquema y otros metadatos se actualizan automáticamente con cada ejecución del trabajo de análisis de descubrimiento en la frecuencia programada.
Para actualizar una tabla de BigLake publicada, sigue estos pasos:
En la consola de Google Cloud , ve a la página BigQuery.
En el panel de la izquierda, haz clic en Explorar.
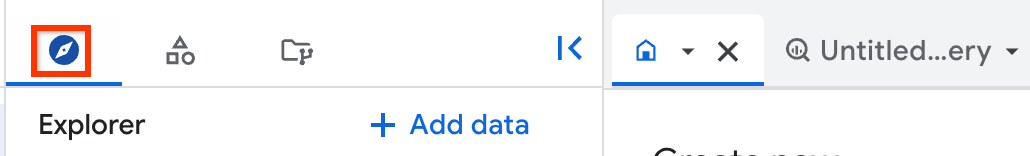
Si no ves el panel izquierdo, haz clic en Expandir panel izquierdo para abrirlo.
En el panel Explorador, expande tu proyecto, haz clic en Conjuntos de datos y, luego, selecciona un conjunto de datos.
Haz clic en Descripción general > Tablas y, luego, selecciona la tabla.
En la pestaña Detalles, en la sección Etiquetas, asegúrate de que la etiqueta metadata-managed-mode esté configurada como user_managed. Si se establece en un valor diferente, sigue estos pasos:
Haz clic en Editar detalles.
Junto a la clave metadata-managed-mode, en el campo valor, ingresa
user_managed.
Borra tablas de BigLake publicadas
Para borrar una tabla de BigLake publicada, sigue estos pasos:
Borra los archivos de datos de la tabla en el bucket de Cloud Storage.
En la consola de Google Cloud , ve a la página BigQuery.
En el panel de la izquierda, haz clic en Explorar.
En el panel Explorador, expande tu proyecto, haz clic en Conjuntos de datos y, luego, selecciona un conjunto de datos.
Haz clic en Descripción general > Tablas y, luego, selecciona la tabla.
En el panel Detalles, en la sección Etiquetas, asegúrate de que la etiqueta metadata-managed-mode no esté configurada como
user_managed. Si está configurado comouser_managed, sigue estos pasos:Haz clic en Editar detalles .
Junto a la clave metadata-managed-mode, en el campo valor, ingresa
discovery-managed.
Haz clic en Ejecutar. La exploración de descubrimiento se ejecuta on demand.
Después de que se ejecuta el análisis de descubrimiento, la tabla de BigLake se borra en BigQuery y no está disponible para enumerar ni consultar a través de Spark.
Ejecuta un análisis de descubrimiento on demand
Para ejecutar un análisis de descubrimiento a pedido, selecciona una de las siguientes opciones.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Descubrimiento de Cloud Storage, haz clic en la exploración de descubrimiento que deseas ejecutar.
Haz clic en Ejecutar ahora.
gcloud
Para ejecutar un análisis de descubrimiento, usa el
comando gcloud dataplex datascans run:
gcloud dataplex datascans runDATASCAN\ --location=LOCATION
Reemplaza las siguientes variables:
LOCATION: Es la región de Google Cloud en la que se creó el análisis de descubrimiento.DATASCAN: Es el nombre del análisis de descubrimiento.
REST
Para ejecutar un análisis de descubrimiento a pedido, usa el
método dataScans.run
en la API de Dataplex.
Enumera los análisis de descubrimiento
Para enumerar tus análisis de descubrimiento, selecciona una de las siguientes opciones.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Descubrimiento de Cloud Storage, se enumeran los análisis de descubrimiento creados en el proyecto.
gcloud
gcloud dataplex datascans list --location=LOCATION --project=PROJECT_ID
Reemplaza lo siguiente:
LOCATION: Es la ubicación de tu proyecto.PROJECT_ID: Es el ID del proyecto de Google Cloud .
REST
Para recuperar la lista de análisis de descubrimiento en tu proyecto, usa el
método dataScans.list
en la API de Dataplex.
Visualiza un análisis de descubrimiento
Para ver un análisis de descubrimiento, selecciona una de las siguientes opciones.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Detección de Cloud Storage, haz clic en el análisis de descubrimiento del que deseas ver los detalles.
- En la sección Detalles del análisis, se muestran detalles sobre el análisis de descubrimiento.
- En la sección Estado del análisis, se muestran los resultados del descubrimiento del trabajo de análisis más reciente.
gcloud
gcloud dataplex datascans jobs describe JOB \
    --location=LOCATION \
    --datascan=DATASCAN \
    --view=FULL
Reemplaza lo siguiente:
JOB: Es el ID del trabajo de análisis de descubrimiento.LOCATION: Es la región de Google Cloud en la que se creó el análisis de descubrimiento.DATASCAN: Es el nombre del análisis de descubrimiento al que pertenece el trabajo.
REST
Para ver los resultados de un análisis de descubrimiento de datos, usa el
método dataScans.get
en la API de Dataplex.
Visualiza los resultados históricos del análisis de descubrimiento
Para ver los resultados históricos de los análisis de descubrimiento, selecciona una de las siguientes opciones.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Detección de Cloud Storage, haz clic en el análisis de descubrimiento del que deseas ver los detalles.
Haz clic en el panel Historial de análisis. En el panel Historial de análisis, se proporciona información sobre los trabajos anteriores, incluida la cantidad de registros analizados en cada trabajo, el estado de cada trabajo y la hora en que se ejecutaron.
Para ver información detallada sobre un trabajo, haz clic en él en la columna ID de trabajo.
gcloud
gcloud dataplex datascans jobs list \
    --location=LOCATION \
    --datascan=DATASCAN
Reemplaza lo siguiente:
LOCATION: Es la región de Google Cloud en la que se creó el análisis de descubrimiento.DATASCAN: Es el nombre del análisis de descubrimiento al que pertenece el trabajo.
REST
Para ver todos los trabajos de un análisis de descubrimiento, usa el
método dataScans.jobs.list
en la API de Dataplex.
Actualiza un análisis de descubrimiento
Para cambiar el programa de un análisis de descubrimiento, por ejemplo, para cambiar el programa de on-demand a recurrente, actualiza el análisis de descubrimiento.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Descubrimiento de Cloud Storage, en el análisis de descubrimiento que deseas actualizar, haz clic en Acciones > Editar.
Edite los valores.
Haz clic en Guardar.
gcloud
Para actualizar un análisis de descubrimiento, usa el comando gcloud dataplex datascans update data-discovery.
gcloud dataplex datascans update data-discovery SCAN_ID --location=LOCATION --description=DESCRIPTION
Reemplaza lo siguiente:
SCAN_ID: Es el ID del análisis de descubrimiento que deseas actualizar.LOCATION: Es la región de Google Cloud en la que se creó el análisis de descubrimiento.DESCRIPTION: Es la descripción nueva del análisis de descubrimiento.
REST
Para actualizar una exploración de descubrimiento, usa el
método dataScans.patch
en la API de Dataplex.
Borra un análisis de descubrimiento
Para borrar un análisis de descubrimiento, elige una de las siguientes opciones.
Console
En la consola de Google Cloud , ve a la página BigQuery.
En el menú de navegación, haz clic en Gobernanza > Selección de metadatos.
En el panel Detección de Cloud Storage, en el análisis de descubrimiento que deseas borrar, haz clic en Acciones > Borrar.
Haz clic en Borrar.
gcloud
gcloud dataplex datascans delete SCAN_ID --location=LOCATION --async
Reemplaza lo siguiente:
SCAN_ID: Es el ID del análisis de descubrimiento que deseas borrar.LOCATION: Es la región de Google Cloud en la que se creó el análisis de descubrimiento.
REST
Para borrar un análisis de descubrimiento, usa el
método dataScans.delete
en la API de Dataplex.