


Découvrir et cataloguer des données Cloud Storage
Ce document explique comment utiliser la découverte automatique de Knowledge Catalog, une fonctionnalité de BigQuery qui vous permet d'analyser les données des buckets Cloud Storage pour extraire, puis cataloguer les métadonnées. Lors de l'analyse de découverte, la découverte automatique crée des tables BigLake ou externes pour les données structurées, et des tables d'objets pour les données non structurées. Les tables BigLake et les tables externes vous permettent d'interroger des données structurées dans des datastores externes (consultez Présentation des tables BigLake et Présentation des tables externes), tandis que les tables d'objets fournissent un index de métadonnées sur les données non structurées dans Cloud Storage (consultez Présentation des tables d'objets). Cette centralisation des données de table facilite les insights sur les données, la sécurité des données et la gouvernance optimisés par l'IA.
Pour utiliser la découverte automatique des données Cloud Storage, vous devez créer et exécuter une analyse de découverte.
La découverte automatique est également appelée découverte autonome.
Présentation de l'analyse de découverte
Une analyse de découverte effectue les opérations suivantes :
- Analyse les données du bucket ou du chemin d'accès Cloud Storage.
- Regroupe les données structurées et semi-structurées dans des tables.
- Collecte des métadonnées, telles que le nom de la table, le schéma et la définition de la partition.
- Crée et met à jour des tables externes BigLake, externes non BigLake ou d'objets BigLake dans BigQuery à l'aide du schéma et de la définition de partition.
Données structurées et semi-structurées
Les données structurées et semi-structurées incluent des formats tels qu'Avro, Parquet et CSV. L'analyse de découverte enregistre des groupes de ces fichiers en tant que tables externes BigLake. L'analyse ne détecte les fichiers que s'ils se trouvent dans des dossiers contenant le même format de données et un schéma compatible.
- Cas d'utilisation : centraliser des fichiers structurés fortement typés dans BigQuery pour exécuter des requêtes SQL analytiques sans définir manuellement de schémas.
- Workflow :
- Organisez vos fichiers structurés dans des dossiers. Assurez-vous que les fichiers de chaque dossier partagent le même format de données et ont un schéma compatible.
- Créez une analyse de découverte et fournissez l'ID de votre connexion de ressource Google Cloud .
- L'analyse regroupe les données et les enregistre en tant que tables externes BigLake.
- Interrogez les tables publiées directement dans BigQuery à l'aide de SQL.
Formats compatibles
- Parquet
- Avro
- ORC
- JSON (uniquement le format délimité par un retour à la ligne)
- CSV (mais pas les fichiers CSV comportant des lignes de commentaires)
Formats de compression
Pour les données structurées et semi-structurées, l'analyse de découverte accepte les formats de compression suivants :
Compression interne pour les formats suivants :
Compression Exemple d'extension de fichier Format accepté gzip .gz.parquetParquet lz4 .lz4.parquetParquet Snappy .snappy.parquetParquet, ORC, Avro lzo .lzo.parquetParquet, ORC Compression externe pour les fichiers JSON et CSV :
- gzip
- bzip2
Données non structurées
Pour les données non structurées, telles que les images et les vidéos, l'analyse de découverte détecte et enregistre les groupes de fichiers qui partagent le même format de fichier de données. Les fichiers doivent se trouver dans des dossiers contenant le même format de fichier. Par exemple, gs://images/group1 ne doit contenir que des images GIF et gs://images/group2 ne doit contenir que des images JPEG pour que l'analyse de découverte détecte et enregistre deux tables d'objets BigLake.
- Cas d'utilisation : cataloguer des fichiers non structurés tels que des images ou des documents pour effectuer une inférence de machine learning à l'aide de BigQuery ML ou de fonctions distantes.
- Workflow :
- Organisez vos fichiers non structurés dans des dossiers. Assurez-vous que les fichiers de chaque dossier partagent le même format de fichier.
- Créer une analyse de découverte.
- L'analyse regroupe les données non structurées et les enregistre en tant que tables d'objets BigLake.
- Effectuez une inférence sur vos fichiers non structurés directement dans BigQuery.
Formats compatibles
L'analyse de découverte est compatible avec les formats non structurés suivants :
- Image (JPEG, PNG et BMP, par exemple)
- Documents (tels que des PDF, des présentations de diapositives et des rapports textuels)
- Audio ou vidéo (par exemple, WAV, MP3 et MP4)
Pour en savoir plus, consultez Fichiers d'objets compatibles.
Formats de compression
Pour les tables d'objets, la compression est gérée principalement via les métadonnées d'objets Cloud Storage, plutôt que par les paramètres internes de BigQuery.
- Compression des métadonnées standards : BigQuery reconnaît automatiquement les fichiers compressés avec gzip et bzip2 s'ils utilisent les extensions standards .gz ou .bz2.
- Content-Encoding : vous pouvez utiliser les métadonnées Content-Encoding: gzip dans Cloud Storage pour diffuser des fichiers compressés tout en conservant leur type de contenu d'origine.
- Compression interne au média : les formats intrinsèquement compressés (tels que JPEG pour les images, MP3 pour l'audio, MP4 pour la vidéo) sont acceptés de manière native.
Enregistrement et disponibilité des tables
Les tables découvertes sont enregistrées dans BigQuery sous l'un des types de tables suivants, en fonction du format de données et de votre configuration d'analyse :
- Tables d'objets BigLake. Créé pour les données non structurées, telles que les images et les vidéos.
- Tables externes BigLake. Créé pour les données structurées et semi-structurées lorsque vous fournissez un ID de connexion de ressource Google Cloud lors de la configuration de l'analyse.
- Tables externes (non BigLake) : créées pour les données structurées et semi-structurées si vous ne fournissez pas d'ID de connexion de ressource.
Cet enregistrement permet d'analyser leurs données dans BigQuery. La mise en cache des métadonnées pour les tables BigLake et les tables d'objets est également activée. Toutes les tables BigLake sont automatiquement ingérées dans Knowledge Catalog pour la recherche et la découverte.
Pour commencer à utiliser vos tables nouvellement enregistrées, vous pouvez :
- Exécutez une requête dans BigQuery.
- Recherchez des ressources dans Knowledge Catalog.
Limites et quotas
Une analyse de découverte n'est pas compatible avec les formats de table Apache Iceberg et Delta Lake.
Pour connaître le nombre maximal de tables qu'une analyse de découverte peut prendre en charge, consultez Quotas et limites.
Avant de commencer
Activez l'API Dataplex si ce n'est pas déjà fait.
Rôles requis pour activer les API
Pour activer des API, vous devez disposer de l'autorisation serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation via le rôle Propriétaire (roles/owner). Sinon, vous pouvez l'obtenir via le rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.
Rôles requis pour le compte de service Knowledge Catalog
Avant de commencer, attribuez les autorisations IAM au compte de service Knowledge Catalog de votre projet.
service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com
Remplacez PROJECT_NUMBER par le projet dans lequel l'API Dataplex est activée.
Pour vous assurer que le compte de service Knowledge Catalog dispose des autorisations nécessaires pour créer et exécuter une analyse de découverte, demandez à votre administrateur d'accorder les rôles IAM suivants au compte de service Knowledge Catalog :
- Agent de service Dataplex Discovery (
roles/dataplex.discoveryServiceAgent) sur le bucket de stockage - Agent de service de publication Dataplex Discovery (
roles/dataplex.discoveryPublishingServiceAgent) sur le projet utilisateur -
Créer des tables BigLake : Agent de service de publication BigLake Dataplex Discovery (
roles/dataplex.discoveryBigLakePublishingServiceAgent) sur la connexion BigQuery
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Ces rôles prédéfinis contiennent les autorisations requises pour créer et exécuter une analyse de découverte. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour créer et exécuter une analyse de découverte :
-
bigquery.datasets.createsur le projet de source de données -
storage.buckets.getsur le bucket de la source de données -
storage.objects.getsur le bucket de la source de données -
storage.objects.listsur le bucket de la source de données -
bigquery.datasets.getsur le projet de source de données -
Fournissez une connexion :
-
bigquery.connections.delegatesur la connexion BigQuery -
bigquery.connections.usesur la connexion BigQuery
-
Votre administrateur peut également attribuer au compte de service Knowledge Catalog ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Rôles requis pour le compte de service de connexion BigQuery
Pour vous assurer que le compte de service de connexion BigQuery dispose des autorisations nécessaires pour créer une analyse de découverte, demandez à votre administrateur d'accorder le rôle IAM Agent de service de découverte Dataplex (roles/dataplex.discoveryServiceAgent) au compte de service de connexion BigQuery sur le bucket Cloud Storage.
Ce rôle prédéfini contient les autorisations requises pour créer une analyse de découverte. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour créer une analyse de découverte :
-
bigquery.datasets.createsur le projet de source de données -
storage.buckets.getsur le bucket de la source de données -
storage.objects.getsur le bucket de la source de données -
storage.objects.listsur le bucket de la source de données -
bigquery.datasets.getsur le projet de source de données -
Fournissez une connexion :
-
bigquery.connections.delegatesur la connexion BigQuery -
bigquery.connections.usesur la connexion BigQuery
-
Votre administrateur peut également attribuer au compte de service de connexion BigQuery ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Rôles requis pour les utilisateurs finaux
Pour obtenir les autorisations nécessaires pour créer et gérer des analyses de découverte de données, demandez à votre administrateur de vous accorder les rôles IAM suivants sur le bucket Cloud Storage :
-
Accès complet aux ressources DataScan : administrateur Dataplex DataScan (
roles/dataplex.dataScanAdmin) - votre projet -
Accès en écriture aux ressources DataScan : éditeur Dataplex DataScan (
roles/dataplex.dataScanEditor) – votre projet -
Accès en lecture aux ressources DataScan, à l'exception des résultats : lecteur Dataplex DataScan (
roles/dataplex.dataScanViewer) - votre projet -
Accès en lecture aux ressources DataScan, y compris aux résultats : lecteur de données Dataplex DataScan (
roles/dataplex.dataScanDataViewer) - votre projet
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Ces rôles prédéfinis contiennent les autorisations requises pour créer et gérer des analyses de découverte de données. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Vous devez disposer des autorisations suivantes pour créer et gérer des analyses de découverte de données :
-
Créer un DataScan :
dataplex.datascans.createsur votre projet -
Supprimer une analyse de données :
dataplex.datascans.deletesur votre projet ou une ressource d'analyse de données -
Afficher les détails de l'analyse de données, à l'exception des résultats :
dataplex.datascans.getsur votre projet ou une ressource d'analyse de données -
Afficher les détails de l'analyse de données, y compris les résultats :
dataplex.datascans.getDatasur votre projet ou une ressource d'analyse de données -
Répertorier les DataScans :
dataplex.datascans.listsur votre projet ou une ressource DataScan -
Exécuter un DataScan :
dataplex.datascans.runsur votre projet ou une ressource DataScan -
Mettre à jour la description d'une analyse de données :
dataplex.datascans.updatesur votre projet ou une ressource d'analyse de données -
Afficher les autorisations IAM de l'analyse de données :
dataplex.datascans.getIamPolicysur votre projet ou une ressource d'analyse de données -
Définissez les autorisations IAM sur l'analyse de données :
dataplex.datascans.setIamPolicysur votre projet ou une ressource d'analyse de données.
Vous pouvez également obtenir ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Créer une analyse de découverte
Pour découvrir des données, vous devez créer et exécuter une analyse de découverte. Vous pouvez définir une planification pour l'analyse ou l'exécuter à la demande.
Lorsque l'analyse de découverte s'exécute, elle crée un ensemble de données dans BigQuery qui correspond au bucket Cloud Storage analysé. Le nom de l'ensemble de données BigQuery est identique à celui du bucket Cloud Storage. Les caractères non valides dans le nom du bucket sont remplacés par un trait de soulignement. Si le nom de l'ensemble de données n'est pas disponible, un suffixe est ajouté (par exemple, _discovered_001). L'ensemble de données contient les tables externes BigLake ou non BigLake créées par l'analyse de découverte pour une analyse plus approfondie.
Console
Dans la console Google Cloud , accédez à la page Sélection de métadonnées.
Dans l'onglet Découverte Cloud Storage, cliquez sur Créer.
Dans le volet Créer une analyse de découverte, configurez les détails des données à analyser.
Attribuez un nom à l'analyse.
Dans le champ ID de l'analyse, saisissez un identifiant unique qui respecte les conventions d'attribution de noms des ressources dans Google Cloud. Si vous ne fournissez pas d'ID, l'analyse de découverte génère l'ID d'analyse.
Facultatif : fournissez une description de l'analyse.
Pour spécifier le bucket Cloud Storage contenant les fichiers à analyser, accédez au champ Bucket, puis sélectionnez le bucket.
Facultatif : définissez les données à inclure ou à exclure de l'analyse de découverte en fournissant une liste de modèles glob pour le filtrage des fichiers. Knowledge Catalog est compatible avec les formats glob suivants :
*: correspond à zéro ou plusieurs caractères, sans franchir les limites du répertoire. Par exemple,*.csvcorrespond àfile.csv, mais pas àfolder/file.csv.**: correspond à zéro ou plusieurs caractères, en traversant les limites des répertoires. Par exemple,**/*.csvcorrespond àfile.csvetfolder/subfolder/file.csv.?: correspond à un seul caractère. Par exemple,file_?.csvcorrespond àfile_1.csvetfile_a.csv, mais pas àfile_10.csv.[...]: correspond à un caractère d'un ensemble de caractères. Par exemple,[abc]correspond àa,bouc, et[a-z]correspond à n'importe quelle lettre minuscule.{...}: correspond à une liste de sous-modèles séparés par une virgule. Par exemple,{sun,moon,stars}correspond àsun,moonoustars.\: échappe un caractère (*,?ou\). Par exemple,file\*.csvcorrespond au nom de fichier littéralfile*.csv.
Vous pouvez spécifier les types de modèles suivants :
- Inclure : si seul un sous-ensemble des données doit être analysé, fournissez une liste de formats glob correspondant aux objets à inclure.
- Exclure : fournissez une liste de modèles glob correspondant aux objets à exclure.
Par exemple, si vous souhaitez exclure
gs://test_bucket/foo/..de l'analyse de découverte, saisissez**/foo/**comme chemin d'exclusion. Les guillemets provoquent des erreurs. Veillez à saisir**/foo/**au lieu de"**/foo/**".Si vous fournissez à la fois des modèles d'inclusion et d'exclusion, les modèles d'exclusion sont appliqués en premier.
Pour Options de données non structurées, sélectionnez Activer l'inférence sémantique.
Cette option est requise si vous souhaitez afficher des insights sur les données non structurées dans Knowledge Catalog. Pour en savoir plus, consultez À propos des insights sur les données non structurées.
Facultatif : Dans Projet, sélectionnez le projet d'ensemble de données BigQuery qui contient les tables externes BigLake ou non BigLake créées par l'analyse de découverte. Si ce paramètre n'est pas fourni, l'ensemble de données est créé dans le projet contenant le bucket Cloud Storage.
Dans Type d'emplacement, sélectionnez Région ou Multirégional (selon la disponibilité) où l'ensemble de données de publication BigQuery est créé.
Pour créer des tables BigLake à partir des données analysées, indiquez l'ID de connexion de votre ressource Google Cloud dans le champ ID de connexion. Pour en savoir plus, consultez Connexions aux ressourcesGoogle Cloud dans BigQuery.
Vous pouvez créer un ID de connexion au même emplacement que l'ensemble de données BigQuery, qui est compatible avec l'emplacement du bucket Cloud Storage.
Si vous ne fournissez pas d'ID de connexion de ressource, l'analyse de découverte crée des tables externes non BigLake. Pour comprendre les différences entre ces types de tables externes et pourquoi le service de découverte peut choisir l'un plutôt que l'autre, consultez la comparaison des différences de comportement.
Dans la section Fréquence de découverte, configurez le moment où vous souhaitez que l'analyse de découverte s'exécute :
Répéter : l'analyse s'exécute selon une planification prédéfinie. Indiquez l'heure de début, les jours d'exécution de l'analyse et la fréquence (par exemple, toutes les heures).
À la demande : l'analyse s'exécute à la demande.
Facultatif : Dans la section Spécifications JSON ou CSV, spécifiez comment l'analyse doit traiter les fichiers JSON et CSV. Cliquez sur Spécifications JSON ou CSV.
- Pour configurer les options JSON, sélectionnez Activer les options d'analyse JSON.
- Désactiver l'inférence de type : indique si l'analyse de découverte doit déduire les types de données lors de l'analyse des données. Si vous désactivez l'inférence de type pour les données JSON, toutes les colonnes sont enregistrées en tant que types primitifs, tels que chaîne, nombre ou booléen.
- Format d'encodage : encodage des caractères des données, tel que UTF-8, US-ASCII ou ISO-8859-1. Si vous ne spécifiez pas de valeur, UTF-8 est utilisé par défaut.
- Pour configurer les options CSV, sélectionnez Activer les options d'analyse CSV.
- Désactiver l'inférence de type : indique si l'analyse de découverte doit déduire les types de données lors de l'analyse des données. Si vous désactivez l'inférence de type pour les données CSV, toutes les colonnes sont enregistrées en tant que chaînes.
- Lignes d'en-tête : nombre de lignes d'en-tête, soit
0, soit1. Si vous spécifiez la valeur0, l'analyse de découverte déduit les en-têtes et extrait les noms de colonnes du fichier. La valeur par défaut est0. - Caractère délimiteur de colonne : caractère utilisé pour séparer les valeurs. Indiquez un seul caractère,
\r(retour chariot) ou\n(saut de ligne). La valeur par défaut est une virgule (,). - Format d'encodage : encodage des caractères des données, par exemple
UTF-8,US-ASCIIouISO-8859-1. Si vous ne spécifiez pas de valeur, UTF-8 est utilisé par défaut.
- Pour configurer les options JSON, sélectionnez Activer les options d'analyse JSON.
Cliquez sur Créer (pour une analyse planifiée), Exécuter maintenant (pour une analyse à la demande) ou Créer et exécuter (pour une analyse ponctuelle).
- Analyse planifiée : s'exécute selon la planification que vous avez définie.
- Analyse à la demande : elle est exécutée une fois initialement lorsque vous la créez, et vous pouvez l'exécuter à tout moment. L'exécution de l'analyse de découverte peut prendre plusieurs minutes.
- Analyse unique : s'exécute automatiquement. Il est automatiquement supprimé lorsqu'il atteint son seuil de valeur TTL (Time To Live) défini, une valeur qui détermine la durée pendant laquelle une analyse de découverte reste active après son exécution. La valeur TTL peut être comprise entre 0 seconde (suppression immédiate) et 365 jours. Une analyse de découverte sans TTL spécifié est automatiquement supprimée au bout de 24 heures.
gcloud
Pour créer une analyse de découverte, utilisez la commande gcloud dataplex datascans create data-discovery.
gcloud dataplex datascans create data-discovery --location=LOCATION
--data-source-resource=BUCKET_PATH
Remplacez les éléments suivants :
LOCATION: emplacement dans lequel vous souhaitez créer votre analyse de découverteBUCKET_PATH: chemin d'accès Cloud Storage du bucket que vous souhaitez analyser
REST
Pour créer une analyse de découverte, utilisez la méthode dataScans.create.
Interroger des tables BigLake publiées
Une fois l'analyse de découverte exécutée, les tables BigLake sont publiées dans un nouvel ensemble de données dans BigQuery. Les tables sont ensuite disponibles pour l'analyse dans BigQuery à l'aide de SQL, ou dans Managed Service pour Apache Spark à l'aide d'Apache Spark ou de HiveQL.
SQL
Vous pouvez afficher ou interroger des tables dans BigQuery. Pour en savoir plus sur l'exécution de requêtes dans BigQuery, consultez Exécuter une requête.
Apache Spark
Pour interroger des tables BigLake à l'aide de Spark SQL sur un job sans serveur Managed Service pour Apache Spark, procédez comme suit :
Créez un script PySpark semblable à l'exemple de script suivant :
from pyspark.sql import SparkSession
session = (
  SparkSession.builder.appName("testing")
    .config("viewsEnabled","true")
    .config("materializationDataset", "DATASET_ID")
    .config("spark.hive.metastore.bigquery.project.id", "PROJECT_ID")
    .config("spark.hive.metastore.client.factory.class", "com.google.cloud.bigquery.metastore.client.BigQueryMetastoreClientFactory")
    .enableHiveSupport()
    .getOrCreate()
)

session.sql("show databases").show()
session.sql("use TABLE_NAME").show()
session.sql("show tables").show()

sql = "SELECT * FROM DATASET_ID.TABLE_ID LIMIT 10"
df = session.read.format("bigquery").option("dataset", "DATASET_ID").load(sql)
df.show()
Remplacez les éléments suivants :
DATASET_ID: ID de l'ensemble de données pour lequel les utilisateurs disposent de l'autorisation de créationPROJECT_ID: ID du projet contenant la table BigLakeTABLE_NAME: nom de la table BigLakeTABLE_ID: ID de la table BigLake
Gérer les tables BigLake publiées
Les tables BigLake publiées sont créées et gérées dans BigQuery par l'analyse de découverte. Par défaut, l'analyse de découverte gère la découverte de nouvelles données, les inférences de schéma et l'évolution du schéma chaque fois que les analyses planifiées ou à la demande sont exécutées. Pour indiquer que les métadonnées sont gérées par l'analyse, celle-ci publie des tables avec l'étiquette metadata-managed-mode définie sur discovery-managed.
Si vous souhaitez gérer vous-même le schéma et d'autres métadonnées telles que les options CSV ou JSON, définissez l'étiquette metadata-managed-mode sur user_managed. De cette façon, le schéma reste inchangé lors de la prochaine analyse de découverte. Cette approche peut être utile dans les scénarios où le schéma déduit par l'analyse de découverte est incorrect ou différent de celui attendu pour une table donnée. Lorsque l'étiquette metadata-managed-mode est définie sur user_managed, cela peut réduire le coût.
Pour mettre à jour l'étiquette, vous pouvez modifier la valeur de la clé d'étiquette
metadata-managed-mode en user_managed au lieu de discovery-managed. Dans ce cas, l'analyse de découverte ne met pas à jour le schéma de la table tant que l'étiquette user_managed est associée à la table.
Mettre à jour des tables BigLake publiées
Pour les tables BigLake publiées à l'aide des jobs d'analyse de découverte avec la configuration par défaut, le schéma et les autres métadonnées sont automatiquement mis à jour à chaque exécution du job d'analyse de découverte à la fréquence planifiée.
Pour mettre à jour une table BigLake publiée, procédez comme suit :
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
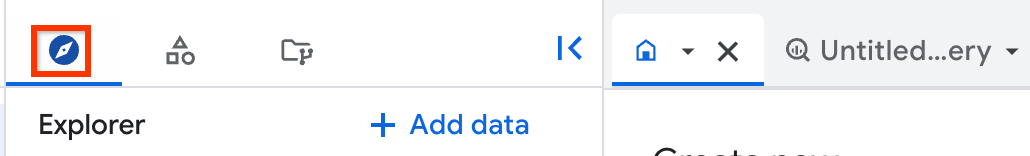
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans le volet Explorateur, développez votre projet, cliquez sur Ensembles de données, puis sélectionnez un ensemble de données.
Cliquez sur Présentation > Tables, puis sélectionnez la table.
Dans l'onglet Détails, dans la section Étiquettes, assurez-vous que l'étiquette metadata-managed-mode est définie sur user_managed. Si elle est définie sur une autre valeur, procédez comme suit :
Cliquez sur Modifier les détails.
À côté de la clé metadata-managed-mode, dans le champ value, saisissez
user_managed.
Supprimer des tables BigLake publiées
Pour supprimer une table BigLake publiée, procédez comme suit :
Supprimez les fichiers de données de la table dans le bucket Cloud Storage.
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
Dans le volet Explorateur, développez votre projet, cliquez sur Ensembles de données, puis sélectionnez un ensemble de données.
Cliquez sur Présentation > Tables, puis sélectionnez la table.
Dans le volet Détails, dans la section Libellés, assurez-vous que le libellé metadata-managed-mode n'est pas défini sur
user_managed. Si elle est définie suruser_managed, procédez comme suit :Cliquez sur Modifier les détails .
À côté de la clé metadata-managed-mode, dans le champ value, saisissez
discovery-managed.
Cliquez sur Exécuter. L'analyse de découverte s'exécute à la demande.
Une fois l'analyse de découverte exécutée, la table BigLake est supprimée dans BigQuery et n'est pas disponible pour être listée ou interrogée via Spark.
Exécuter une analyse de découverte à la demande
Pour exécuter une analyse de découverte à la demande, sélectionnez l'une des options suivantes.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, cliquez sur l'analyse de découverte que vous souhaitez exécuter.
Cliquez sur Exécuter maintenant.
gcloud
Pour exécuter une analyse de découverte, utilisez la commande gcloud dataplex datascans run :
gcloud dataplex datascans runDATASCAN\ --location=LOCATION
Remplacez les variables suivantes :
LOCATION: région Google Cloud dans laquelle l'analyse de découverte a été créée.DATASCAN: nom de l'analyse de découverte.
REST
Pour exécuter une analyse de découverte à la demande, utilisez la méthode dataScans.run dans l'API Dataplex.
Lister les analyses de découverte
Pour lister vos analyses de découverte, sélectionnez l'une des options suivantes.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, les analyses de découverte créées dans le projet sont listées.
gcloud
gcloud dataplex datascans list --location=LOCATION --project=PROJECT_ID
Remplacez les éléments suivants :
LOCATION: emplacement de votre projet.PROJECT_ID: ID de votre projet Google Cloud
REST
Pour récupérer la liste des analyses de découverte de votre projet, utilisez la méthode dataScans.list de l'API Dataplex.
Afficher une analyse de découverte
Pour afficher une analyse de découverte, sélectionnez l'une des options suivantes.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, cliquez sur l'analyse de découverte dont vous souhaitez afficher les détails.
- La section Détails de l'analyse affiche des informations sur l'analyse de découverte.
- La section État de l'analyse affiche les résultats de découverte du dernier job d'analyse.
gcloud
gcloud dataplex datascans jobs describe JOB \
    --location=LOCATION \
    --datascan=DATASCAN \
    --view=FULL
Remplacez les éléments suivants :
JOB: ID du job d'analyse de découverte.LOCATION: région Google Cloud dans laquelle l'analyse de découverte a été créée.DATASCAN: nom de l'analyse de découverte à laquelle appartient le job.
REST
Pour afficher les résultats d'une analyse de découverte de données, utilisez la méthode dataScans.get dans l'API Dataplex.
Afficher l'historique des résultats d'analyse de découverte
Pour afficher l'historique des résultats d'analyse de découverte, sélectionnez l'une des options suivantes.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, cliquez sur l'analyse de découverte dont vous souhaitez afficher les détails.
Cliquez sur le volet Historique des analyses. Le volet Historique des analyses fournit des informations sur les jobs passés, y compris le nombre d'enregistrements analysés dans chaque job, l'état de chaque job et l'heure à laquelle les jobs ont été exécutés.
Pour afficher des informations détaillées sur un job, cliquez sur le job dans la colonne ID de job.
gcloud
gcloud dataplex datascans jobs list \
    --location=LOCATION \
    --datascan=DATASCAN
Remplacez les éléments suivants :
LOCATION: région Google Cloud dans laquelle l'analyse de découverte a été créée.DATASCAN: nom de l'analyse de découverte à laquelle appartient le job.
REST
Pour afficher tous les jobs d'une analyse de découverte, utilisez la méthode dataScans.jobs.list dans l'API Dataplex.
Mettre à jour une analyse de découverte
Pour modifier la programmation d'une analyse de découverte (par exemple, pour passer d'une programmation à la demande à une programmation récurrente), mettez à jour l'analyse de découverte.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, pour l'analyse de découverte que vous souhaitez mettre à jour, cliquez sur Actions > Modifier.
Modifiez les valeurs.
Cliquez sur Enregistrer.
gcloud
Pour mettre à jour une analyse de découverte, utilisez la commande gcloud dataplex datascans update data-discovery.
gcloud dataplex datascans update data-discovery SCAN_ID --location=LOCATION --description=DESCRIPTION
Remplacez les éléments suivants :
SCAN_ID: ID de l'analyse de découverte que vous souhaitez mettre à jourLOCATION: région Google Cloud dans laquelle l'analyse de découverte a été créée.DESCRIPTION: nouvelle description de l'analyse de découverte
REST
Pour mettre à jour une analyse de découverte, utilisez la méthode dataScans.patch dans l'API Dataplex.
Supprimer une analyse de découverte
Pour supprimer une analyse de découverte, sélectionnez l'une des options suivantes.
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le menu de navigation, cliquez sur Gouvernance > Organisation des métadonnées.
Dans le volet Découverte Cloud Storage, pour l'analyse de découverte que vous souhaitez supprimer, cliquez sur Actions > Supprimer.
Cliquez sur Supprimer.
gcloud
gcloud dataplex datascans delete SCAN_ID --location=LOCATION --async
Remplacez les éléments suivants :
SCAN_ID: ID de l'analyse de découverte que vous souhaitez supprimer.LOCATION: région Google Cloud dans laquelle l'analyse de découverte a été créée.
REST
Pour supprimer une analyse de découverte, utilisez la méthode dataScans.delete dans l'API Dataplex.