


Cloud Storage-Daten erkennen und katalogisieren
In diesem Dokument wird erläutert, wie Sie die automatische Erkennung von Knowledge Catalog verwenden, eine Funktion in BigQuery, mit der Sie Daten in Cloud Storage-Buckets scannen können, um Metadaten zu extrahieren und dann zu katalogisieren. Im Rahmen des Erkennungsscans werden bei der automatischen Erkennung BigLake- oder externe Tabellen für strukturierte Daten und Objekttabellen für unstrukturierte Daten erstellt. Mit BigLake-Tabellen und externen Tabellen können Sie strukturierte Daten in externen Datenspeichern abfragen (siehe Einführung in BigLake-Tabellen und Einführung in externe Tabellen). Objekttabellen bieten dagegen einen Metadatenindex für unstrukturierte Daten in Cloud Storage (siehe Einführung in Objekttabellen). Diese zentralisierten Tabellendaten erleichtern KI-gestützte Dateneinblicke, Datensicherheit und Governance.
Wenn Sie die automatische Erkennung von Cloud Storage-Daten verwenden möchten, erstellen Sie einen Erkennungsscan und führen ihn aus.
Die automatische Erkennung wird auch als eigenständige Erkennung bezeichnet.
Übersicht über Discovery-Scans
Ein Erkennungsscan führt Folgendes aus:
- Scannt die Daten im Cloud Storage-Bucket oder -Pfad.
- Gruppiert strukturierte und semistrukturierte Daten in Tabellen.
- Erfasst Metadaten wie den Tabellennamen, das Schema und die Partitionsdefinition.
- Erstellt und aktualisiert externe BigLake-Tabellen, externe Nicht-BigLake-Tabellen oder BigLake-Objekttabellen in BigQuery mithilfe des Schemas und der Partitionsdefinition.
Strukturierte und semistrukturierte Daten
Strukturierte und semistrukturierte Daten umfassen Formate wie Avro, Parquet und CSV. Beim Erkennungsscan werden Gruppen dieser Dateien als externe BigLake-Tabellen registriert. Dateien werden nur erkannt, wenn sie sich in Ordnern mit demselben Datenformat und einem kompatiblen Schema befinden.
- Anwendungsfall: Stark typisierte, strukturierte Dateien in BigQuery zentralisieren, um analytische SQL-Abfragen auszuführen, ohne Schemas manuell definieren zu müssen.
- Workflow:
- Organisieren Sie Ihre strukturierten Dateien in Ordnern. Achten Sie darauf, dass die Dateien in jedem Ordner dasselbe Datenformat und ein kompatibles Schema haben.
- Erstellen Sie einen Erkennungsscan und geben Sie die ID Ihrer Google Cloud -Ressourcenverbindung an.
- Beim Scan werden die Daten gruppiert und als externe BigLake-Tabellen registriert.
- Fragen Sie die veröffentlichten Tabellen direkt in BigQuery mit SQL ab.
Unterstützte Formate
- Parquet
- Avro
- ORC
- JSON (nur das durch Zeilenumbruch getrennte Format)
- CSV (aber keine CSV-Dateien mit Kommentarzeilen)
Komprimierungsformate
Für strukturierte und semistrukturierte Daten unterstützt der Erkennungsscan die folgenden Komprimierungsformate:
Interne Komprimierung für die folgenden Formate:
Komprimierung Beispiel für Dateiendung Unterstütztes Format GZIP .gz.parquetParquet LZ4 .lz4.parquetParquet Snappy .snappy.parquetParquet, ORC, Avro lzo .lzo.parquetParquet, ORC Externe Komprimierung für JSON- und CSV-Dateien:
- GZIP
- bzip2
Unstrukturierte Daten
Bei unstrukturierten Daten wie Bildern und Videos werden beim Erkennungsscan Gruppen von Dateien mit demselben Dateiformat erkannt und registriert. Dateien müssen sich in Ordnern befinden, die dasselbe Dateiformat enthalten. Beispiel: gs://images/group1 darf nur GIF-Bilder und gs://images/group2 nur JPEG-Bilder enthalten, damit der Discovery-Scan zwei BigLake-Objekttabellen erkennt und registriert.
- Anwendungsfall: Unstrukturierte Dateien wie Bilder oder Dokumente katalogisieren, um mit BigQuery ML oder Remote-Funktionen Machine-Learning-Inferenz durchzuführen.
- Workflow:
- Organisieren Sie Ihre unstrukturierten Dateien in Ordnern. Achten Sie darauf, dass die Dateien in jedem Ordner dasselbe Dateiformat haben.
- Erstellen Sie einen Erkennungsscan.
- Beim Scan werden die unstrukturierten Daten gruppiert und als BigLake-Objekttabellen registriert.
- Führen Sie Inferenzen für Ihre unstrukturierten Dateien direkt in BigQuery aus.
Unterstützte Formate
Der Discovery-Scan unterstützt die folgenden unstrukturierten Formate:
- Bild (z. B. JPEG, PNG und BMP)
- Dokumente (z. B. PDFs, Präsentationen und Textberichte)
- Audio oder Video (z. B. WAV, MP3 und MP4)
Weitere Informationen finden Sie unter Unterstützte Objektdateien.
Komprimierungsformate
Bei Objekttabellen wird die Komprimierung hauptsächlich über Cloud Storage-Objektmetadaten und nicht über interne BigQuery-Einstellungen verwaltet.
- Standardmäßige Metadatenkomprimierung: BigQuery erkennt automatisch Dateien, die mit gzip und bzip2 komprimiert wurden, wenn sie die Standarderweiterungen .gz oder .bz2 verwenden.
- Content-Encoding: Sie können die Metadaten Content-Encoding gzip in Cloud Storage verwenden, um komprimierte Dateien bereitzustellen und gleichzeitig ihren ursprünglichen Inhaltstyp beizubehalten.
- Medieninterne Komprimierung: Formate, die von Natur aus komprimiert sind (z. B. JPEG für Bilder, MP3 für Audio, MP4 für Video), werden nativ unterstützt.
Registrierung und Verfügbarkeit von Tabellen
Die erkannten Tabellen werden je nach Datenformat und Scankonfiguration als einer der folgenden Tabellentypen in BigQuery registriert:
- BigLake-Objekttabellen Für unstrukturierte Daten wie Bilder und Videos erstellt.
- Externe BigLake-Tabellen Wird für strukturierte und semistrukturierte Daten erstellt, wenn Sie während der Scankonfiguration eine Google Cloud -Ressourcenverbindungs-ID angeben.
- Externe Tabellen (Nicht-BigLake): Werden für strukturierte und semistrukturierte Daten erstellt, wenn Sie keine Ressourcenverbindungs-ID angeben.
Durch diese Registrierung werden die Daten für die Analyse in BigQuery verfügbar gemacht. Das Metadaten-Caching für BigLake-Tabellen und Objekttabellen ist ebenfalls aktiviert. Alle BigLake-Tabellen werden automatisch in Knowledge Catalog aufgenommen, damit sie gesucht und gefunden werden können.
So können Sie mit Ihren neu registrierten Tabellen arbeiten:
Beschränkungen und Kontingente
Ein Erkennungsscan unterstützt die Tabellenformate Apache Iceberg und Delta Lake nicht.
Informationen zur maximalen Anzahl von Tabellen, die ein Erkennungsscan unterstützt, finden Sie unter Kontingente und Limits.
Hinweis
Aktivieren Sie die Dataplex API, falls sie noch nicht aktiviert ist.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Rollen für das Knowledge Catalog-Dienstkonto
Weisen Sie dem Knowledge Catalog-Dienstkonto in Ihrem Projekt die IAM-Berechtigungen zu, bevor Sie beginnen.
service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com
Ersetzen Sie PROJECT_NUMBER durch das Projekt, in dem die Dataplex API aktiviert ist.
Damit das Knowledge Catalog-Dienstkonto die erforderlichen Berechtigungen zum Erstellen und Ausführen eines Erkennungsscans hat, bitten Sie Ihren Administrator, dem Knowledge Catalog-Dienstkonto die folgenden IAM-Rollen zuzuweisen:
- Dataplex Discovery Service Agent (
roles/dataplex.discoveryServiceAgent) für den Storage-Bucket - Dataplex Discovery Publishing Service Agent (
roles/dataplex.discoveryPublishingServiceAgent) für das Nutzerprojekt -
BigLake-Tabellen erstellen:
Dataplex Discovery BigLake Publishing Service Agent (
roles/dataplex.discoveryBigLakePublishingServiceAgent) für die BigQuery-Verbindung
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erstellen und Ausführen eines Erkennungsscans erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um einen Erkennungsscan zu erstellen und auszuführen:
-
bigquery.datasets.createfür das Datenquellenprojekt -
storage.buckets.getfür den Datenquellen-Bucket -
storage.objects.getfür den Datenquellen-Bucket -
storage.objects.listfür den Datenquellen-Bucket -
bigquery.datasets.getfür das Datenquellenprojekt -
Geben Sie eine Verbindung an:
-
bigquery.connections.delegatefür die BigQuery-Verbindung -
bigquery.connections.usefür die BigQuery-Verbindung
-
Ihr Administrator kann dem Knowledge Catalog-Dienstkonto möglicherweise auch diese Berechtigungen mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erteilen.
Erforderliche Rollen für das BigQuery-Verbindungsdienstkonto
Damit das BigQuery Connection Service-Konto die erforderlichen Berechtigungen zum Erstellen eines Erkennungsscans hat, bitten Sie Ihren Administrator, dem BigQuery Connection Service-Konto die IAM-Rolle Dataplex Discovery Service Agent (roles/dataplex.discoveryServiceAgent) für den Cloud Storage-Bucket zuzuweisen.
Diese vordefinierte Rolle enthält die Berechtigungen, die zum Erstellen eines Erkennungsscans erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind zum Erstellen eines Erkennungsscans erforderlich:
-
bigquery.datasets.createfür das Datenquellenprojekt -
storage.buckets.getfür den Datenquellen-Bucket -
storage.objects.getfür den Datenquellen-Bucket -
storage.objects.listfür den Datenquellen-Bucket -
bigquery.datasets.getfür das Datenquellenprojekt -
Geben Sie eine Verbindung an:
-
bigquery.connections.delegatefür die BigQuery-Verbindung -
bigquery.connections.usefür die BigQuery-Verbindung
-
Ihr Administrator kann dem BigQuery Connection Service-Konto möglicherweise auch diese Berechtigungen mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erteilen.
Erforderliche Rollen für Endnutzer
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für den Cloud Storage-Bucket zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen und Verwalten von Datenerkennungsscans benötigen:
-
Vollständiger Zugriff auf DataScan-Ressourcen:
Dataplex DataScan-Administrator (
roles/dataplex.dataScanAdmin) – Ihr Projekt -
Schreibzugriff auf DataScan-Ressourcen:
Dataplex DataScan-Bearbeiter (
roles/dataplex.dataScanEditor) – Ihr Projekt -
Lesezugriff auf DataScan-Ressourcen, mit Ausnahme der Ergebnisse:
Dataplex DataScan Viewer (
roles/dataplex.dataScanViewer) – Ihr Projekt -
Lesezugriff auf DataScan-Ressourcen, einschließlich der Ergebnisse:
Dataplex DataScan DataViewer (
roles/dataplex.dataScanDataViewer) – Ihr Projekt
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erstellen und Verwalten von Datenerkennungsscans erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Datenerkennungsscans zu erstellen und zu verwalten:
-
DataScan erstellen:
dataplex.datascans.createfür Ihr Projekt -
DataScan löschen:
dataplex.datascans.deletefür Ihr Projekt oder eine DataScan-Ressource -
DataScan-Details ansehen, mit Ausnahme von Ergebnissen:
dataplex.datascans.getfür Ihr Projekt oder eine DataScan-Ressource -
DataScan-Details einschließlich Ergebnissen ansehen:
dataplex.datascans.getDatafür Ihr Projekt oder eine DataScan-Ressource -
DataScans auflisten:
dataplex.datascans.listfür Ihr Projekt oder eine DataScan-Ressource -
DataScan ausführen:
dataplex.datascans.runfür Ihr Projekt oder eine DataScan-Ressource -
Beschreibung eines DataScans aktualisieren:
dataplex.datascans.updatefür Ihr Projekt oder eine DataScan-Ressource -
IAM-Berechtigungen des DataScan ansehen:
dataplex.datascans.getIamPolicyfür Ihr Projekt oder eine DataScan-Ressource -
Legen Sie die IAM-Berechtigungen für den DataScan fest:
dataplex.datascans.setIamPolicyfür Ihr Projekt oder eine DataScan-Ressource.
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Erkennungsscan erstellen
Wenn Sie Daten erkennen möchten, müssen Sie einen Erkennungsscan erstellen und ausführen. Sie können einen Zeitplan für den Scan festlegen oder den Scan bei Bedarf ausführen.
Wenn der Erkennungsscan ausgeführt wird, wird in BigQuery ein neues Dataset erstellt, das dem gescannten Cloud Storage-Bucket entspricht. Der Name des BigQuery-Datasets ist mit dem Namen des Cloud Storage-Bucket identisch. Ungültige Zeichen im Bucket-Namen werden durch einen Unterstrich ersetzt. Wenn der Dataset-Name nicht verfügbar ist, wird ein Suffix angehängt (z. B. _discovered_001). Das Dataset enthält die externen BigLake- oder Nicht-BigLake-Tabellen, die vom Erkennungsscan für die weitere Analyse erstellt wurden.
Console
Rufen Sie in der Google Cloud Console die Seite Metadaten-Kuration auf.
Klicken Sie auf dem Tab Cloud Storage-Erkennung auf Erstellen.
Konfigurieren Sie im Bereich Erkennungsscan erstellen die Details zu den zu scannenden Daten.
Geben Sie einen Namen für den Scan ein.
Geben Sie im Feld Scan-ID eine eindeutige ID ein, die den Namenskonventionen für Ressourcen in Google Cloud entspricht. Wenn Sie keine ID angeben, wird die Scan-ID vom Erkennungsscan generiert.
Optional: Geben Sie eine Beschreibung des Scans ein.
Wenn Sie den Cloud Storage-Bucket angeben möchten, der die zu scannenden Dateien enthält, suchen Sie im Feld Bucket nach dem Bucket und wählen Sie ihn aus.
Optional: Definieren Sie die Daten, die in den Discovery-Scan einbezogen oder davon ausgeschlossen werden sollen, indem Sie eine Liste von Glob-Mustern für die Dateifilterung angeben. Knowledge Catalog unterstützt die folgenden Glob-Muster:
*: Stimmt mit null oder mehr Zeichen überein, ohne Verzeichnisgrenzen zu überschreiten. Beispielsweise führt*.csvzu Übereinstimmungen mitfile.csv, aber nicht mitfolder/file.csv.**: Stimmt mit null oder mehr Zeichen überein, wobei Verzeichnisgrenzen überschritten werden. Beispielsweise führt**/*.csvzu Übereinstimmungen mitfile.csvundfolder/subfolder/file.csv.?: Stimmt mit genau einem Zeichen überein. Beispiel:file_?.csvstimmt mitfile_1.csvundfile_a.csvüberein, aber nicht mitfile_10.csv.[...]: Stimmt mit einem Zeichen aus einer Reihe von Zeichen überein. Beispielsweise führt[abc]zu Übereinstimmungen mita,bodercund[a-z]zu Übereinstimmungen mit einem beliebigen Kleinbuchstaben.{...}: Stimmt mit einer durch Kommas getrennten Liste von Untermustern überein. Beispielsweise führt{sun,moon,stars}zu Übereinstimmungen mitsun,moonoderstars.\: Maskiert ein Zeichen (*,?oder\). Beispielsweise entsprichtfile\*.csvdem literalen Dateinamenfile*.csv.
Sie können die folgenden Arten von Mustern angeben:
- Einschließen: Wenn nur ein Teil der Daten gescannt werden soll, geben Sie eine Liste von Glob-Mustern an, die mit den einzuschließenden Objekten übereinstimmen.
- Ausschließen: Geben Sie eine Liste von Glob-Mustern an, die mit den auszuschließenden Objekten übereinstimmen.
Wenn Sie beispielsweise
gs://test_bucket/foo/..vom Erkennungsscan ausschließen möchten, geben Sie**/foo/**als Ausschlusspfad ein. Anführungszeichen verursachen Fehler. Geben Sie**/foo/**anstelle von"**/foo/**"ein.Wenn Sie sowohl Einschluss- als auch Ausschlussmuster angeben, werden die Ausschlussmuster zuerst angewendet.
Wählen Sie unter Optionen für unstrukturierte Daten die Option Semantische Inferenz aktivieren aus.
Diese Option ist erforderlich, wenn Sie in Knowledge Catalog Dateneinblicke für unstrukturierte Daten aufrufen möchten. Weitere Informationen finden Sie unter Informationen zu Datenerkenntnissen für unstrukturierte Daten.
Optional: Wählen Sie unter Projekt das BigQuery-Dataset-Projekt aus, das die externen BigLake- oder externen Nicht-BigLake-Tabellen enthält, die durch den Erkennungsscan erstellt wurden. Wenn nicht angegeben, wird das Dataset in dem Projekt erstellt, das den Cloud Storage-Bucket enthält.
Wählen Sie unter Standorttyp entweder Region oder Multiregional (je nachdem, was verfügbar ist) aus, wo das BigQuery-Veröffentlichungs-Dataset erstellt wird.
Wenn Sie BigLake-Tabellen aus den gescannten Daten erstellen möchten, geben Sie im Feld Verbindungs-ID die Verbindungs-ID Ihrer Google Cloud -Ressource an. Weitere Informationen finden Sie unter Google Cloud -Ressourcenverbindungen in BigQuery.
Sie können eine neue Verbindungs-ID am selben Standort wie das BigQuery-Dataset erstellen, der mit dem Cloud Storage-Bucket-Standort kompatibel ist.
Wenn Sie keine Ressourcenverbindungs-ID angeben, werden beim Erkennungsscan externe Tabellen erstellt, die nicht von BigLake stammen. Informationen zu den Unterschieden zwischen diesen externen Tabellentypen und dazu, warum der Discovery-Dienst einen Typ gegenüber einem anderen bevorzugen könnte, finden Sie im Vergleich der Verhaltensunterschiede.
Konfigurieren Sie im Abschnitt Erkennungshäufigkeit, wann der Erkennungsscan ausgeführt werden soll:
Wiederholen: Der Scan wird nach einem vordefinierten Zeitplan ausgeführt. Geben Sie die Startzeit, die Tage, an denen der Scan ausgeführt werden soll, und die Häufigkeit an, z. B. stündlich.
On demand: Der Scan wird on demand ausgeführt.
Optional: Geben Sie im Abschnitt JSON- oder CSV-Spezifikationen an, wie der Scan JSON- und CSV-Dateien verarbeiten soll. Klicken Sie auf JSON- oder CSV-Spezifikationen.
- Wenn Sie JSON-Optionen konfigurieren möchten, wählen Sie JSON-Parsing-Optionen aktivieren aus.
- Typinferenz deaktivieren: Gibt an, ob der Erkennungsscan beim Scannen von Daten Datentypen ableiten soll. Wenn Sie die Typinferenz für JSON-Daten deaktivieren, werden alle Spalten als einfache Typen wie String, Zahl oder boolescher Wert registriert.
- Codierungsformat: die Zeichencodierung der Daten, z. B. UTF-8, US-ASCII oder ISO-8859-1. Wenn Sie keinen Wert angeben, wird standardmäßig UTF-8 verwendet.
- Wenn Sie CSV-Optionen konfigurieren möchten, wählen Sie CSV-Parsing-Optionen aktivieren aus.
- Typinferenz deaktivieren: Gibt an, ob der Erkennungsscan beim Scannen von Daten Datentypen ableiten soll. Wenn Sie die Typinferenz für CSV-Daten deaktivieren, werden alle Spalten als Strings registriert.
- Kopfzeilen: die Anzahl der Kopfzeilen, entweder
0oder1. Wenn Sie den Wert0angeben, leitet der Erkennungsscan Überschriften ab und extrahiert die Spaltennamen aus der Datei. Der Standardwert ist0. - Spaltentrennzeichen: das Zeichen, das zum Trennen von Werten verwendet wird. Geben Sie ein einzelnes Zeichen,
\r(Zeilenumbruch) oder\n(Zeilenumbruch) an. Der Standardwert ist ein Komma (,). - Codierungsformat: die Zeichencodierung der Daten, z. B.
UTF-8,US-ASCIIoderISO-8859-1. Wenn Sie keinen Wert angeben, wird standardmäßig UTF-8 verwendet.
- Wenn Sie JSON-Optionen konfigurieren möchten, wählen Sie JSON-Parsing-Optionen aktivieren aus.
Klicken Sie auf Erstellen (für einen geplanten Scan), Jetzt ausführen (für einen On-Demand-Scan) oder Erstellen und ausführen (für einen einmaligen Scan).
- Geplanter Scan: Wird gemäß dem von Ihnen festgelegten Zeitplan ausgeführt.
- On-Demand-Scan: Wird einmalig ausgeführt, wenn Sie ihn erstellen. Sie können den Scan jederzeit ausführen. Es kann einige Minuten dauern, bis der Erkennungsscan ausgeführt wird.
- Einmaliger Scan: Wird automatisch ausgeführt. Er wird automatisch gelöscht, wenn er den definierten TTL-Schwellenwert (Time to Live) erreicht. Dieser Wert bestimmt, wie lange ein Erkennungsscan nach der Ausführung aktiv bleibt. Der TTL-Wert kann zwischen 0 Sekunden (sofortiges Löschen) und 365 Tagen liegen. Ein Discovery-Scan ohne angegebene TTL wird nach 24 Stunden automatisch gelöscht.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans create data-discovery, um einen Erkennungsscan zu erstellen.
gcloud dataplex datascans create data-discovery --location=LOCATION
--data-source-resource=BUCKET_PATH
Ersetzen Sie Folgendes:
LOCATION: der Standort, an dem Sie den Erkennungsscan erstellen möchtenBUCKET_PATH: der Cloud Storage-Pfad des Buckets, den Sie scannen möchten
REST
Verwenden Sie zum Erstellen eines Erkennungsscans die Methode dataScans.create.
Veröffentlichte BigLake-Tabellen abfragen
Nachdem Sie den Erkennungsscan ausgeführt haben, werden BigLake-Tabellen in einem neuen Dataset in BigQuery veröffentlicht. Die Tabellen sind dann für Analysen in BigQuery mit SQL oder in Managed Service for Apache Spark mit Apache Spark oder HiveQL verfügbar.
SQL
Sie können Tabellen in BigQuery ansehen oder abfragen. Weitere Informationen zum Ausführen von Abfragen in BigQuery finden Sie unter Abfrage ausführen.
Apache Spark
So fragen Sie BigLake-Tabellen mit Spark SQL in einem serverlosen Managed Service for Apache Spark-Job ab:
Erstellen Sie ein PySpark-Skript, das dem folgenden Beispielskript ähnelt:
from pyspark.sql import SparkSession
session = (
  SparkSession.builder.appName("testing")
    .config("viewsEnabled","true")
    .config("materializationDataset", "DATASET_ID")
    .config("spark.hive.metastore.bigquery.project.id", "PROJECT_ID")
    .config("spark.hive.metastore.client.factory.class", "com.google.cloud.bigquery.metastore.client.BigQueryMetastoreClientFactory")
    .enableHiveSupport()
    .getOrCreate()
)

session.sql("show databases").show()
session.sql("use TABLE_NAME").show()
session.sql("show tables").show()

sql = "SELECT * FROM DATASET_ID.TABLE_ID LIMIT 10"
df = session.read.format("bigquery").option("dataset", "DATASET_ID").load(sql)
df.show()
Ersetzen Sie Folgendes:
DATASET_ID: ID des Datasets, für das Nutzer die Berechtigung zum Erstellen habenPROJECT_ID: ID des Projekts mit der BigLake-TabelleTABLE_NAME: Name der BigLake-TabelleTABLE_ID: ID der BigLake-Tabelle
Veröffentlichte BigLake-Tabellen verwalten
Veröffentlichte BigLake-Tabellen werden in BigQuery durch den Erkennungsscan erstellt und verwaltet. Standardmäßig werden beim Erkennungsscan jedes Mal, wenn die geplanten oder On-Demand-Scans ausgeführt werden, neue Daten erkannt, Schemas abgeleitet und Schemas weiterentwickelt. Um anzugeben, dass Metadaten vom Scan verwaltet werden, veröffentlicht der Scan Tabellen mit dem Label metadata-managed-mode, das auf discovery-managed gesetzt ist.
Wenn Sie das Schema und andere Metadaten wie CSV- oder JSON-Optionen selbst verwalten möchten, setzen Sie das Label metadata-managed-mode auf user_managed. So bleibt das Schema beim nächsten Erkennungsscan unverändert. Dieser Ansatz kann in Szenarien nützlich sein, in denen das vom Discovery-Scan abgeleitete Schema falsch ist oder sich von dem unterscheidet, was für eine bestimmte Tabelle erwartet wird. Wenn das Label metadata-managed-mode auf user_managed gesetzt ist, können die Kosten gesenkt werden.
Wenn Sie das Label aktualisieren möchten, können Sie den Wert des Labelschlüssels
metadata-managed-mode in user_managed statt discovery-managed ändern. In diesem Fall wird das Schema der Tabelle durch den Erkennungsscan nicht aktualisiert, solange das Label user_managed an die Tabelle angehängt ist.
Veröffentlichte BigLake-Tabellen aktualisieren
Bei BigLake-Tabellen, die mithilfe von Erkennungsscanjobs mit der Standardkonfiguration veröffentlicht wurden, werden das Schema und andere Metadaten automatisch bei jeder Ausführung des Erkennungsscanjobs in der geplanten Häufigkeit aktualisiert.
So aktualisieren Sie eine veröffentlichte BigLake-Tabelle:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
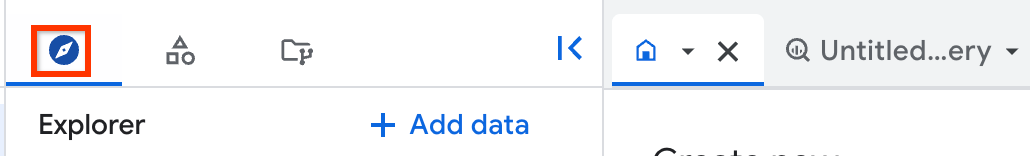
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Maximieren Sie im Bereich Explorer Ihr Projekt, klicken Sie auf Datasets und wählen Sie dann ein Dataset aus.
Klicken Sie auf Übersicht > Tabellen und wählen Sie die Tabelle aus.
Prüfen Sie auf dem Tab Details im Abschnitt Labels, ob das Label metadata-managed-mode auf user_managed festgelegt ist. Wenn ein anderer Wert festgelegt ist, gehen Sie so vor:
Klicken Sie auf Details bearbeiten.
Geben Sie im Feld Wert neben dem Schlüssel metadata-managed-mode den Wert
user_managedein.
Veröffentlichte BigLake-Tabellen löschen
So löschen Sie eine veröffentlichte BigLake-Tabelle:
Löschen Sie die Datendateien für die Tabelle im Cloud Storage-Bucket.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
Maximieren Sie im Bereich Explorer Ihr Projekt, klicken Sie auf Datasets und wählen Sie dann ein Dataset aus.
Klicken Sie auf Übersicht > Tabellen und wählen Sie die Tabelle aus.
Prüfen Sie im Bereich Details im Abschnitt Labels, ob das Label metadata-managed-mode auf
user_managedfestgelegt ist. Wenn er aufuser_managedfestgelegt ist, gehen Sie so vor:Klicken Sie auf Details bearbeiten .
Geben Sie im Feld Wert neben dem Schlüssel metadata-managed-mode den Wert
discovery-managedein.
Klicken Sie auf Ausführen. Der Erkennungsscan wird on demand ausgeführt.
Nach dem Erkennungsscan wird die BigLake-Tabelle in BigQuery gelöscht und kann nicht mehr über Spark aufgelistet oder abgefragt werden.
Erkennungsscan on demand ausführen
Wählen Sie eine der folgenden Optionen aus, um einen Discovery-Scan bei Bedarf auszuführen.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Klicken Sie im Bereich Cloud Storage-Erkennung auf den Erkennungsscan, den Sie ausführen möchten.
Klicken Sie auf Jetzt ausführen.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans run, um einen Erkennungsscan auszuführen:
gcloud dataplex datascans runDATASCAN\ --location=LOCATION
Ersetzen Sie die folgenden Variablen:
LOCATION: die Google Cloud -Region, in der der Erkennungsscan erstellt wurde.DATASCAN: der Name des Erkennungsscans.
REST
Wenn Sie einen On-Demand-Erkennungsscan ausführen möchten, verwenden Sie die Methode dataScans.run in der Dataplex API.
Erkennungsscans auflisten
Wählen Sie eine der folgenden Optionen aus, um Ihre Erkennungsscans aufzulisten.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Im Bereich Cloud Storage-Erkennung werden die im Projekt erstellten Erkennungsscans aufgeführt.
gcloud
gcloud dataplex datascans list --location=LOCATION --project=PROJECT_ID
Ersetzen Sie Folgendes:
LOCATION: Der Standort Ihres Projekts.PROJECT_ID: Ihre Google Cloud -Projekt-ID
REST
Wenn Sie die Liste der Erkennungsscans in Ihrem Projekt abrufen möchten, verwenden Sie die Methode dataScans.list in der Dataplex API.
Erkennungsscan ansehen
Wählen Sie eine der folgenden Optionen aus, um einen Erkennungsscan aufzurufen.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Klicken Sie im Bereich Cloud Storage-Erkennung auf den Erkennungsscan, dessen Details Sie sich ansehen möchten.
- Im Abschnitt Scandetails werden Details zum Erkennungsscan angezeigt.
- Im Abschnitt Scanstatus werden die Erkennungsergebnisse des letzten Scanauftrags angezeigt.
gcloud
gcloud dataplex datascans jobs describe JOB \
    --location=LOCATION \
    --datascan=DATASCAN \
    --view=FULL
Ersetzen Sie Folgendes:
JOB: Die Job-ID des Erkennungsscan-Jobs.LOCATION: die Google Cloud -Region, in der der Erkennungsscan erstellt wurde.DATASCAN: Der Name des Discovery-Scans, zu dem der Job gehört.
REST
Wenn Sie die Ergebnisse eines Datenerkennungsscans aufrufen möchten, verwenden Sie die Methode dataScans.get in der Dataplex API.
Aufrufverlauf von Erkennungsscans ansehen
Wählen Sie eine der folgenden Optionen aus, um die Ergebnisse früherer Erkennungsscans aufzurufen.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Klicken Sie im Bereich Cloud Storage-Erkennung auf den Erkennungsscan, dessen Details Sie sich ansehen möchten.
Klicken Sie auf den Bereich Scanverlauf. Im Bereich Scanverlauf finden Sie Informationen zu früheren Jobs, einschließlich der Anzahl der in jedem Job gescannten Einträge, des Status der einzelnen Jobs und der Zeit, zu der die Jobs ausgeführt wurden.
Wenn Sie die Details zu einem Job aufrufen möchten, klicken Sie in der Spalte Job-ID auf den Job.
gcloud
gcloud dataplex datascans jobs list \
    --location=LOCATION \
    --datascan=DATASCAN
Ersetzen Sie Folgendes:
LOCATION: die Google Cloud -Region, in der der Erkennungsscan erstellt wurde.DATASCAN: Der Name des Erkennungsscans, zu dem der Job gehört.
REST
Wenn Sie alle Jobs eines Erkennungsscans aufrufen möchten, verwenden Sie die Methode dataScans.jobs.list in der Dataplex API.
Erkennungsscan aktualisieren
Wenn Sie den Zeitplan eines Erkennungsscans ändern möchten, z. B. von On-Demand zu wiederkehrend, aktualisieren Sie den Erkennungsscan.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Klicken Sie im Bereich Cloud Storage-Erkennung für den Erkennungsscan, den Sie aktualisieren möchten, auf Aktionen > Bearbeiten.
Bearbeiten Sie die Werte.
Klicken Sie auf Speichern.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans update data-discovery, um einen Erkennungsscan zu aktualisieren.
gcloud dataplex datascans update data-discovery SCAN_ID --location=LOCATION --description=DESCRIPTION
Ersetzen Sie Folgendes:
SCAN_ID: die ID des Erkennungsscans, den Sie aktualisieren möchtenLOCATION: Die Google Cloud -Region, in der der Erkennungsscan erstellt wurdeDESCRIPTION: die neue Beschreibung für den Erkennungsscan
REST
Verwenden Sie zum Aktualisieren eines Erkennungsscans die Methode dataScans.patch in der Dataplex API.
Erkennungsscan löschen
Wählen Sie eine der folgenden Optionen aus, um einen Erkennungsscan zu löschen.
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Navigationsmenü auf Governance > Metadatenkuratierung.
Klicken Sie im Bereich Cloud Storage-Erkennung für den Erkennungsscan, den Sie löschen möchten, auf Aktionen > Löschen.
Klicken Sie auf Löschen.
gcloud
gcloud dataplex datascans delete SCAN_ID --location=LOCATION --async
Ersetzen Sie Folgendes:
SCAN_ID: die ID des Erkennungsscans, den Sie löschen möchten.LOCATION: die Google Cloud -Region, in der der Erkennungsscan erstellt wurde.
REST
Verwenden Sie zum Löschen eines Erkennungsscans die Methode dataScans.delete in der Dataplex API.