


Prévoir des séries temporelles hiérarchiques avec un modèle univarié ARIMA_PLUS
Ce tutoriel explique comment utiliser un
ARIMA_PLUS modèle de série temporelle univarié
pour prévoir des séries temporelles hiérarchiques. Il prévoit la valeur future d'une colonne donnée en fonction des valeurs historiques de cette colonne, et calcule également les valeurs cumulées de cette colonne pour une ou plusieurs dimensions d'intérêt.
Les valeurs prévues sont calculées pour chaque point temporel, pour chaque valeur d'une ou plusieurs colonnes qui spécifient les dimensions d'intérêt. Par exemple, si vous souhaitez prévoir les incidents de circulation quotidiens et que vous spécifiez une colonne de dimension contenant des données d'état, les données prévues contiennent des valeurs pour chaque jour de l'état A, puis des valeurs pour chaque jour de l'état B, et ainsi de suite. Si vous souhaitez prévoir les incidents de circulation quotidiens et que vous spécifiez des colonnes de dimension contenant des données d'état et de ville, les données prévues contiennent des valeurs pour chaque jour de l'état A et de la ville A, puis des valeurs pour chaque jour de l'état A et de la ville B, et ainsi de suite. Dans les modèles de séries temporelles hiérarchiques, la réconciliation hiérarchique est utilisée pour cumuler et réconcilier chaque série temporelle enfant avec son parent. Par exemple, la somme des valeurs prévues pour toutes les villes de l'état A doit être égale à la valeur prévue pour l'état A.
Dans ce tutoriel, vous allez créer deux modèles de séries temporelles sur les mêmes données, l'un utilisant la prévision hiérarchique et l'autre non. Cela vous permet de comparer les résultats renvoyés par les modèles.
Ce tutoriel utilise les données de la table publique
bigquery-public-data.iowa_liquor.sales.sales. Cette table contient des informations sur plus d'un million de produits alcoolisés dans différents magasins à l'aide de données publiques sur les ventes d'alcool de l'Iowa.
Avant de lire ce tutoriel, nous vous recommandons vivement de consulter la page Prévoir plusieurs séries temporelles avec un modèle univarié.
Autorisations requises
Pour créer l'ensemble de données, vous devez disposer de l'autorisation IAM
bigquery.datasets.create.Pour créer le modèle, vous avez besoin des autorisations suivantes :
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateData
Pour exécuter une inférence, vous devez disposer des autorisations suivantes :
bigquery.models.getDatabigquery.jobs.create
Pour plus d'informations sur les rôles et les autorisations IAM dans BigQuery, consultez la page Présentation d'IAM.
Objectifs
Dans ce tutoriel, vous allez utiliser :
- Créer un modèle de séries temporelles multiples et un modèle de séries temporelles hiérarchiques multiples pour prévoir les valeurs des ventes de bouteilles à l'aide de l'instruction
CREATE MODEL. - Récupérer les valeurs prévues des ventes de bouteilles à partir des modèles à l'aide de la
ML.FORECASTfonction.
Coûts
Ce tutoriel fait appel à des composants payants de Google Cloud, y compris les suivants :
- BigQuery
- BigQuery ML
Pour plus d'informations sur les coûts de BigQuery, consultez la page Tarifs de BigQuery.
Pour en savoir plus sur les coûts associés à BigQuery ML, consultez la page Tarifs de BigQuery ML.
- Connectez-vous à votre Google Cloud compte. Si vous n'avez jamais utilisé Google Cloud, créez un compte pour évaluer les performances de nos produits dans des scénarios réels. Les nouveaux clients bénéficient également de 300 $ de crédits sans frais pour exécuter, tester et déployer des charges de travail.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
- BigQuery est automatiquement activé dans les nouveaux projets.
Pour activer BigQuery dans un projet préexistant, accédez à
Activer l'API BigQuery.
Rôles requis pour activer les API
Pour activer les API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation via le rôle Propriétaire (roles/owner). Sinon, vous pouvez obtenir cette autorisation via le rôle Administrateur de l'utilisation des services (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.
Créer un ensemble de données
Pour créer un ensemble de données BigQuery, sélectionnez l'une des options suivantes :
Console
Dans la Google Cloud console, accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorer:
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans Explorer, développez votre projet, puis cliquez sur Ensembles de données.
Sur la page Ensembles de données, cliquez sur Créer un ensemble de données.
Dans le volet Créer un ensemble de données, procédez comme suit :
Dans le champ ID de l'ensemble de données, saisissez
bqml_tutorial.Dans le champ Emplacement des données, sélectionnez États-Unis.
Laissez les autres paramètres par défaut tels quels.
Cliquez sur Créer un ensemble de données.
bq
Pour créer un ensemble de données, utilisez la
bq mk --dataset commande.
Créez un ensemble de données nommé
bqml_tutorialavec l'emplacement des données défini surUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Vérifiez que l'ensemble de données a été créé :
bq ls
API
Appelez la datasets.insert
méthode avec une ressource d'ensemble de données définie :
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Créer un modèle de série temporelle
Créez un modèle de série temporelle à l'aide des données sur les ventes d'alcool de l'Iowa.
La requête GoogleSQL suivante crée un modèle qui prévoit le nombre total quotidien de bouteilles vendues en 2015 dans les comtés de Polk, Linn et Scott.
Dans la requête suivante, la
OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...)
clause indique que vous créez un
modèle de série temporelle basé sur
ARIMA. Vous utilisez l'
TIME_SERIES_ID option
de l'instruction CREATE MODEL pour spécifier une ou plusieurs colonnes dans les données d'entrée
pour lesquelles vous souhaitez obtenir des prévisions. L'
auto_arima_max_order option
de l'instruction CREATE MODEL contrôle l'
espace de recherche pour l'ajustement des hyperparamètres dans l'algorithme auto.ARIMA. L'
decompose_time_series option
de l'instruction CREATE MODEL est définie par défaut sur TRUE, de sorte que les informations sur
les données de séries temporelles sont renvoyées lorsque vous évaluez le modèle à l'étape suivante.
La OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...)
clause indique que vous créez un
ARIMAbasé sur
ARIMA. Par défaut,
auto_arima=TRUE,
l’algorithme auto.ARIMA ajuste donc automatiquement les hyperparamètres des modèles
ARIMA_PLUS. L'algorithme ajuste des dizaines de modèles candidats et choisit
le meilleur modèle, qui est celui avec le
critère d'information d'Akaike (AIC) le plus bas.
Définir l'
holiday_regionoption
sur US permet une modélisation plus précise des points temporels des jours fériés aux États-Unis s'il existe des modèles de jours fériés aux États-Unis dans la série temporelle.
Pour créer le modèle, procédez comme suit :
Dans la Google Cloud console, accédez à la page BigQuery.
Dans l'éditeur de requête, collez la requête suivante, puis cliquez sur Exécuter :
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
L'exécution de la requête prend environ 37 secondes. Vous pouvez ensuite accéder au modèle
liquor_forecast. Étant donné que la requête utilise une instructionCREATE MODELpour créer un modèle, aucun résultat de requête n'est généré.
Utiliser le modèle pour prévoir des données
Prévoyez les valeurs futures des séries temporelles à l'aide de la fonction ML.FORECAST.
Dans la requête suivante, la clause STRUCT(20 AS horizon, 0.8 AS confidence_level) indique que la requête prévoit 20 points temporels futurs et génère un intervalle de prédiction avec un niveau de confiance de 80 %.
Pour prévoir des données avec le modèle, procédez comme suit :
Dans la Google Cloud console, accédez à la page BigQuery.
Dans l'éditeur de requête, collez la requête suivante, puis cliquez sur Exécuter :
SELECT *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast`,
    STRUCT(20 AS horizon, 0.8 AS confidence_level))
ORDER BY store_number, county, city, zip_code, forecast_timestamp;
Le résultat doit ressembler à ce qui suit :
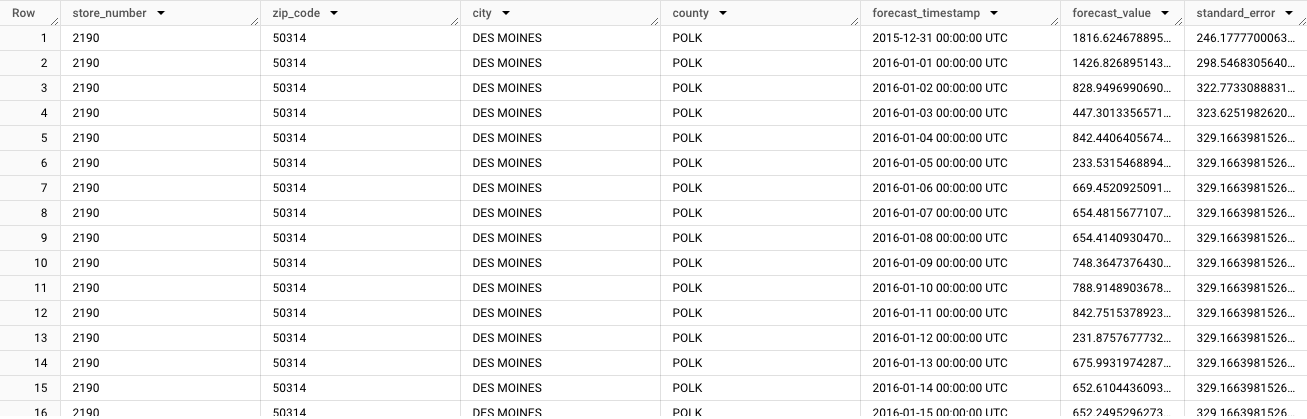
La sortie commence par les données prévues pour la première série temporelle :
store_number=2190,zip_code=50314,city=DES MOINES,county=POLK. Lorsque vous parcourez les données, vous voyez les prévisions pour chaque série temporelle unique suivante. Pour générer des prévisions qui agrègent les totaux pour différentes dimensions, telles que les prévisions pour un comté spécifique, vous devez générer une prévision hiérarchique.
Créer un modèle de série temporelle hiérarchique
Créez une prévision de série temporelle hiérarchique à l'aide des données sur les ventes d'alcool de l'Iowa.
La requête GoogleSQL suivante crée un modèle qui génère des prévisions hiérarchiques pour le nombre total quotidien de bouteilles vendues en 2015 dans les comtés de Polk, Linn et Scott.
Dans la requête suivante, l'option HIERARCHICAL_TIME_SERIES_COLS de l'instruction CREATE MODEL indique que vous créez une prévision hiérarchique basée sur un ensemble de colonnes que vous spécifiez. Chacune de ces colonnes est cumulée et agrégée. Par exemple, à partir de la requête précédente, cela signifie que la valeur de la colonne store_number est cumulée pour afficher les prévisions pour chaque valeur county, city et zip_code. Séparément, les valeurs zip_code et store_number sont également cumulées pour afficher les prévisions pour chaque valeur county et city.
L'ordre des colonnes est important, car il définit la structure de la hiérarchie.
Pour créer le modèle, procédez comme suit :
Dans la Google Cloud console, accédez à la page BigQuery.
Dans l'éditeur de requête, collez la requête suivante, puis cliquez sur Exécuter :
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast_hierarchical`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HIERARCHICAL_TIME_SERIES_COLS = ['zip_code', 'store_number'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
L'exécution de la requête prend environ 45 secondes. Vous pouvez ensuite accéder au modèle
bqml_tutorial.liquor_forecast_hierarchicaldans le volet Explorer. Étant donné que la requête utilise une instructionCREATE MODELpour créer un modèle, aucun résultat de requête n'est généré.
Utiliser le modèle hiérarchique pour prévoir des données
Récupérez les données de prévision hiérarchique à partir du modèle à l'aide de la fonction ML.FORECAST.
Pour prévoir des données avec le modèle, procédez comme suit :
Dans la Google Cloud console, accédez à la page BigQuery.
Dans l'éditeur de requête, collez la requête suivante, puis cliquez sur Exécuter :
SELECT
  *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast_hierarchical`,
    STRUCT(30 AS horizon, 0.8 AS confidence_level))
WHERE city = 'LECLAIRE'
ORDER BY county, city, zip_code, store_number, forecast_timestamp;
Le résultat doit ressembler à ce qui suit :
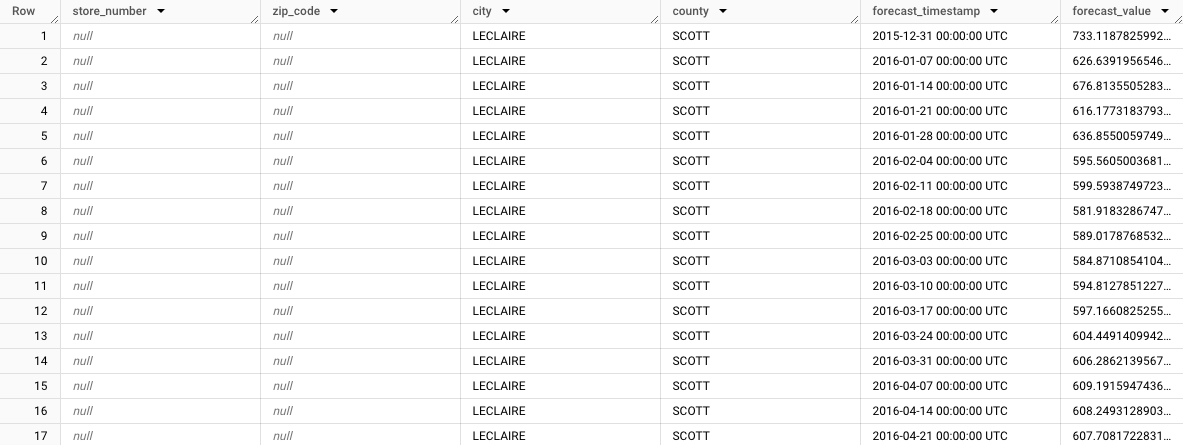
Notez comment la prévision agrégée s'affiche pour la ville de LeClaire,
store_number=NULL,zip_code=NULL,city=LECLAIRE,county=SCOTT. Lorsque vous examinez le reste des lignes, notez les prévisions pour les autres sous-groupes. Par exemple, l'image suivante montre les prévisions agrégées pour le code postal52753,store_number=NULL,zip_code=52753,city=LECLAIRE,county=SCOTT: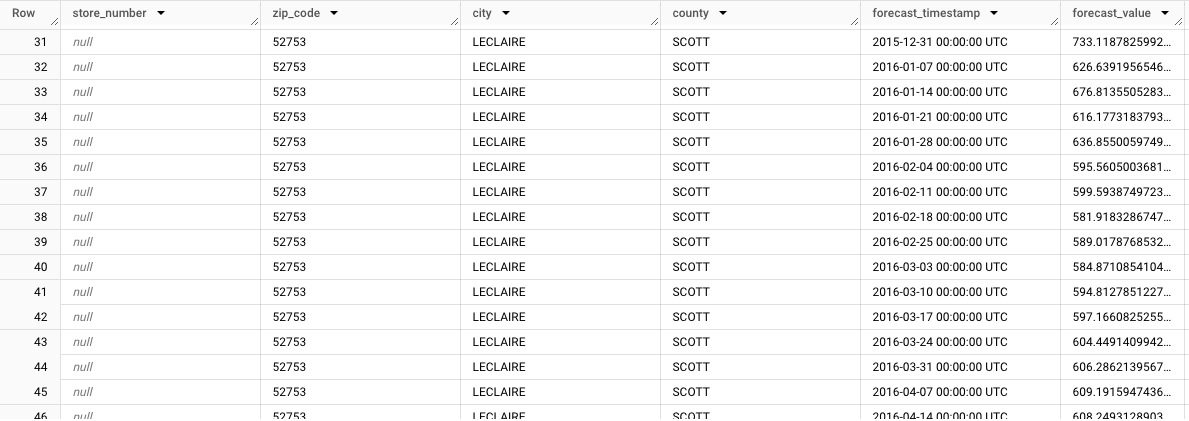
Libérer de l'espace
Pour éviter que les ressources utilisées dans ce tutoriel ne soient facturées sur votre Google Cloud compte, supprimez le projet qui contient les ressources ou conservez le projet et supprimez les ressources individuelles.
- Supprimez le projet que vous avez créé.
- Ou conservez le projet et supprimez l'ensemble de données.
Supprimer l'ensemble de données
Si vous supprimez votre projet, tous les ensembles de données et toutes les tables qui lui sont associés sont également supprimés. Si vous préférez réutiliser le projet, vous pouvez supprimer l'ensemble de données que vous avez créé dans ce tutoriel :
Si nécessaire, ouvrez la page BigQuery dans la Google Cloud console.
Dans le panneau de navigation, cliquez sur l'ensemble de données bqml_tutorial que vous avez créé.
Cliquez sur Delete dataset (Supprimer l'ensemble de données) dans la partie droite de la fenêtre. Cette action supprime l'ensemble de données, la table et toutes les données.
Dans la boîte de dialogue Supprimer l'ensemble de données, confirmez la commande de suppression en saisissant le nom de votre ensemble de données (
bqml_tutorial), puis cliquez sur Supprimer.
Supprimer votre projet
Pour supprimer le projet :
- Dans la Google Cloud console, accédez à la page Gérer les ressources.
- Dans la liste des projets, sélectionnez celui que vous souhaitez supprimer, puis cliquez sur Supprimer.
- Dans la boîte de dialogue, saisissez l'ID du projet, puis cliquez Arrêter pour supprimer le projet.
Étape suivante
- Découvrez comment prévoir une seule série temporelle avec un modèle univarié.
- Découvrez comment prévoir plusieurs séries temporelles avec un modèle univarié.
- Découvrez comment mettre à l'échelle un modèle univarié lors de la prévision de plusieurs séries temporelles sur de nombreuses lignes.
- Découvrez comment prévoir une seule série temporelle avec un modèle multivarié.
- Pour obtenir plus d'informations sur BigQuery ML, consultez la page Présentation de l'IA et du ML dans BigQuery.