


במאמר הזה מוצגת ארכיטקטורה לדוגמה של אפליקציה עם כמה שכבות, שפועלת במכונות וירטואליות של Compute Engine וב-Spanner בטופולוגיה גלובלית ב- Google Cloud. בנוסף, מפורטות הנחיות שיעזרו לכם לבנות ארכיטקטורה שמשתמשת בשירותי תשתית אחרים של Google Cloud . במאמר מתוארים הגורמים העיצוביים שצריך להביא בחשבון כשבונים ארכיטקטורה גלובלית לאפליקציות בענן. המסמך הזה מיועד לאדריכלי ענן.
הארכיטקטורה הזו תואמת לארכיטיפ של פריסה גלובלית. אנחנו ממליצים על האבטיפוס הזה לאפליקציות שמשרתות משתמשים בכל העולם, וצריכות זמינות גבוהה ועמידות בפני הפסקות שירות בכמה אזורים. הארכיטקטורה הזו תומכת בהתאמה גמישה של קנה המידה ברמת הרשת, האפליקציה ומסד הנתונים. כך אפשר להתאים את העלויות לשימוש בלי להתפשר על הביצועים, הזמינות או יכולת ההתאמה לעומס.
ארכיטקטורה
בתרשים הבא מוצגת ארכיטקטורה של אפליקציה שפועלת בתשתית שפרוסה באופן גלובלי בכמה אזורים ב- Google Cloud.
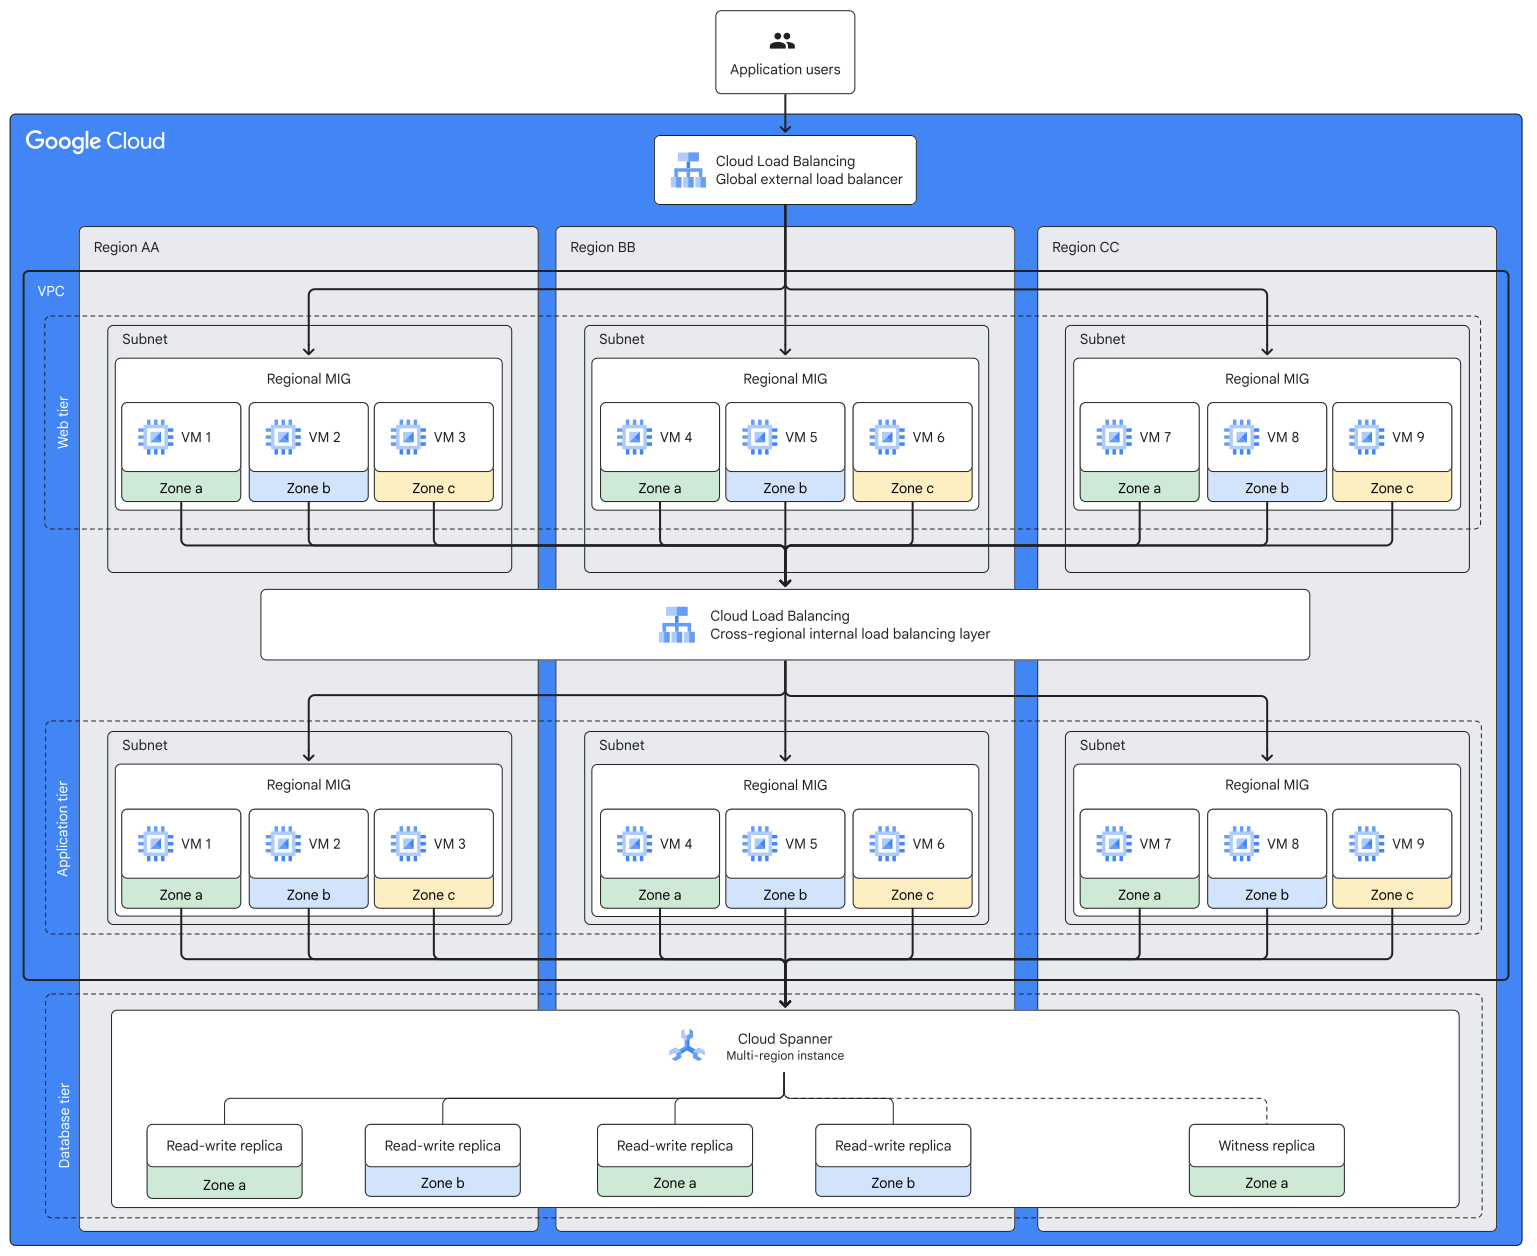
בארכיטקטורה הזו, מאזן עומסים גלובלי מפיץ את הבקשות הנכנסות לשרתי אינטרנט באזורים המתאימים, על סמך הזמינות, הקיבולת והקרבה שלהם למקור התנועה. שכבה פנימית של איזון עומסים בין אזורים מטפלת בהפצת התנועה משרתי האינטרנט לשרתי האפליקציות המתאימים, על סמך הזמינות והקיבולת שלהם. שרתי האפליקציה כותבים נתונים למסד נתונים שמשוכפל באופן סינכרוני וזמין בכל האזורים, וקוראים ממנו נתונים.
הארכיטקטורה כוללת את המשאבים הבאים של Google Cloud :
| רכיב | מטרה |
|---|---|
| מאזן עומסים גלובלי חיצוני |
מאזן העומסים החיצוני הגלובלי מקבל את בקשות המשתמשים ומפיץ אותן לאפליקציה. מאזן העומסים החיצוני הגלובלי מפרסם כתובת IP אחת מסוג anycast, אבל מאזן העומסים מיושם כמספר גדול של שרתי proxy ב- Google Front Ends (GFE). בקשות הלקוח מופנות ל-GFE הקרוב ביותר ללקוח. בהתאם לדרישות שלכם, אתם יכולים להשתמש ב מאזן עומסים גלובלי חיצוני של אפליקציות (ALB) או ב מאזן עומסי רשת גלובלי חיצוני בשרת proxy. מידע נוסף זמין במאמר בחירת מאזן עומסים. כדי להגן על האפליקציה מפני איומים כמו התקפות מניעת שירות מבוזרות (DDoS) ופרצות אבטחה XSS (cross-site scripting), אתם יכולים להשתמש ב מדיניות האבטחה של Google Cloud Armor. |
| קבוצות מופעי מכונה מנוהלים (MIG) אזוריות לשכבת האינטרנט |
שכבת האינטרנט של האפליקציה פרוסה במכונות וירטואליות של Compute Engine, שהן חלק מקבוצות MIG אזוריות. קבוצות ה-MIG האלה הן שרתי ה-back-end של מאזן העומסים הגלובלי. כל קבוצת MIG מכילה מכונות וירטואליות של Compute Engine בשלושה אזורים שונים. כל אחת מהמכונות הווירטואליות האלה מארחת מכונה עצמאית של שכבת האינטרנט של האפליקציה. |
| שכבת איזון עומסים פנימי בין אזורים |
מאזני עומסים פנימיים עם קצוות עורפיים חוצי-אזורים מטפלים בהפצה של תעבורת הנתונים מהמכונות הווירטואליות של שכבת האינטרנט בכל אזור, למכונות הווירטואליות של שכבת האפליקציה בכל האזורים. בהתאם לדרישות שלכם, אתם יכולים להשתמש ב מאזן עומסים פנימי של אפליקציות (ALB) חוצה-אזורים או ב מאזן עומסי רשת פנימי חוצה-אזורים בשרת proxy. מידע נוסף זמין במאמר בחירת מאזן עומסים. |
| קבוצות MIG אזוריות לשכבת האפליקציה |
שכבת האפליקציה נפרסת במכונות וירטואליות של Compute Engine שהן חלק מקבוצות MIG אזוריות. קבוצות ה-MIG האלה הן הקצוות העורפיים של שכבת איזון העומסים הפנימית. כל קבוצת MIG מכילה מכונות וירטואליות של Compute Engine בשלושה אזורים שונים. כל מכונה וירטואלית מארחת מופע עצמאי של שכבת האפליקציה. |
| מכונה של Spanner במספר אזורים |
האפליקציה כותבת נתונים ל מכונה של Spanner במספר אזורים וקוראת ממנה נתונים. ההגדרה במספר אזורים בארכיטקטורה הזו כוללת את הרפליקות הבאות:
|
| רשת ענן וירטואלי פרטי (VPC) ו רשתות משנה |
כל המשאבים בארכיטקטורה משתמשים ברשת VPC אחת. לרשת ה-VPC יש את רשתות המשנה הבאות:
במקום להשתמש ברשת VPC אחת, אתם יכולים ליצור רשת VPC נפרדת בכל אזור ולחבר את הרשתות באמצעות Network Connectivity Center. |
המוצרים שהשתמשו בהם
ארכיטקטורת הייחוס הזו משתמשת במוצרי Google Cloud הבאים:
- Compute Engine: שירות מחשוב מאובטח שניתן להתאמה אישית, שמאפשר ליצור ולהריץ מכונות וירטואליות בתשתית של Google.
- Cloud Load Balancing: מגוון של מאזני עומסים גלובליים ואזוריים, עם ביצועים גבוהים ויכולת התאמה לעומס.
- Spanner: שירות של מסד נתונים רלציוני, עם עקביות גלובלית וסילומיות גבוהה.
שיקולים בתכנון
בקטע הזה מוסבר איך להשתמש בארכיטקטורה לדוגמה כדי לפתח ארכיטקטורה שעונה על הדרישות הספציפיות שלכם בנוגע לתכנון המערכת, אבטחה ותאימות, אמינות, עלות, יעילות תפעולית וביצועים.
עיצוב המערכת
בקטע הזה מוסבר איך לבחור את Google Cloud האזורים לפריסה גלובלית ואת שירותי Google Cloudהמתאימים.
בחירת אזור
כשבוחרים את Google Cloud האזורים שבהם צריך לפרוס את האפליקציות, צריך להביא בחשבון את הגורמים והדרישות הבאים:
- זמינות השירותים של Google Cloud בכל אזור. בטבלה של זמינות המוצרים לפי מיקום תוכלו לקרוא מידע נוסף.
- זמינות של סוגי מכונות ב-Compute Engine בכל אזור. למידע נוסף, קראו את המאמר אזורים ותחומים.
- דרישות זמן אחזור של משתמשי קצה.
- עלות המשאבים של Google Cloud .
- עלויות העברת נתונים בין אזורים.
- דרישות רגולטוריות.
- דרישות בנושא קיימוּת.
חלק מהגורמים והדרישות האלה עשויים להיות כרוכים בפשרות. לדוגמה, יכול להיות שהאזור הכי משתלם מבחינת עלות הוא לא האזור עם טביעת הרגל הפחמנית הכי נמוכה. שיטות מומלצות לבחירת אזורים ב-Compute Engine
תשתית מחשוב
בארכיטקטורה לדוגמה שבמסמך הזה, נעשה שימוש במכונות וירטואליות של Compute Engine בשכבות מסוימות של האפליקציה. בהתאם לדרישות של האפליקציה, אתם יכולים לבחור מבין שירותי המחשוב האחרים של Google Cloud :
- קונטיינרים: אתם יכולים להריץ אפליקציות בקונטיינרים באשכולות של Google Kubernetes Engine (GKE). GKE הוא מנוע לתזמור קונטיינרים, שמאפשר לבצע אוטומציה של פריסה, התאמה לעומס וניהול של אפליקציות בקונטיינרים.
- בלי שרת (serverless): אם אתם מעדיפים להתמקד בנתונים ובאפליקציות במקום להגדיר ולהפעיל משאבי תשתית, אתם יכולים להשתמש בשירותים בלי שרת (serverless) כמו Cloud Run.
ההחלטה אם להשתמש במכונות וירטואליות, בקונטיינרים או בשירותים בלי שרת (serverless) כרוכה בפשרה בין הגמישות בהגדרה לבין מאמצי הניהול. מכונות וירטואליות ומאגרים מספקים גמישות רבה יותר בהגדרות האישיות, אבל אתם אחראים לניהול המשאבים. בארכיטקטורה בלי שרת (serverless), אתם פורסים עומסי עבודה בפלטפורמה שהוגדרה מראש ודורשת מאמץ ניהולי מינימלי. במאמר אירוח אפליקציות ב- Google Cloud מוסבר איך לבחור את שירותי המחשוב המתאימים לעומסי העבודה ב-Google Cloud.
שירותי אחסון
בארכיטקטורה שמוצגת במסמך הזה נעשה שימוש בנפחים אזוריים של Persistent Disk למכונות הווירטואליות. אמצעי אחסון מסוג Regional Persistent Disk מספקים שכפול סינכרוני של נתונים בין שני אזורים בתוך אזור. הנתונים בנפחים של Persistent Disk לא משוכפלים בין אזורים.
Google Cloud Hyperdisk מספק ביצועים, גמישות ויעילות טובים יותר מאשר Persistent Disk. באמצעות Google Cloud Hyperdisk Balanced, אתם יכולים להקצות פעולות קלט/פלט לשנייה (IOPS) ונפח עיבוד נתונים בנפרד ובאופן דינמי, וכך להתאים את הנפח למגוון רחב של עומסי עבודה.
כדי לאחסן בעלות נמוכה עם שכפול במספר מיקומים, אתם יכולים להשתמש בקטגוריות של Cloud Storage באזור אחד, בשני אזורים או במספר אזורים.
- הנתונים בקטגוריות אזוריות משוכפלים באופן סינכרוני בין האזורים באותו אזור.
- נתונים בקטגוריות של שני אזורים או של מספר אזורים מאוחסנים ביתירות בשני מיקומים גיאוגרפיים נפרדים לפחות. המטא-נתונים נכתבים באופן סינכרוני בין אזורים, והנתונים משוכפלים באופן אסינכרוני. בקטגוריות בשני אזורים אפשר להשתמש ברפליקציה בקצב טורבו, כדי לוודא שהאובייקטים משוכפלים בין זוגות של אזורים, עם יעד להתאוששות מאסון (RPO) של 15 דקות. למידע נוסף, ראו זמינות ועמידות של נתונים.
כדי לאחסן נתונים שמשותפים בין כמה מכונות וירטואליות באזור, כמו בכל המכונות הווירטואליות בשכבת האינטרנט או בשכבת האפליקציה, אתם יכולים להשתמש במכונה אזורית של Filestore. הנתונים שאתם מאחסנים במכונה אזורית של Filestore משוכפלים באופן סינכרוני בשלושה אזורים בתוך האזור. הרפליקציה הזו מבטיחה זמינות גבוהה ועמידות בפני הפסקות זמניות בשירות באזורים. אתם יכולים לאחסן קובצי תצורה משותפים, כלים וכלים שירות נפוצים ויומנים מרכזיים במכונה של Filestore, ולטעון את המכונה בכמה מכונות וירטואליות. כדי להגן מפני הפסקות חשמל באזור, אתם יכולים לשכפל מכונה של Filestore לאזור אחר. מידע נוסף זמין במאמר רפליקציה של מכונות.
אם מסד הנתונים שלכם הוא Microsoft SQL Server, מומלץ להשתמש ב-Cloud SQL ל-SQL Server. אם Cloud SQL לא תומך בדרישות ההגדרה שלכם, או אם אתם צריכים גישה למערכת ההפעלה, אתם יכולים לפרוס מכונה של אשכול יתירות כשל (FCI) של Microsoft SQL Server. בתרחיש הזה, אתם יכולים להשתמש ב-Google Cloud NetApp Volumes בניהול מלא כדי לספק למסד הנתונים אחסון SMB בזמינות רציפה (CA).
כשאתם מתכננים את האחסון לעומסי העבודה, כדאי להביא בחשבון את המאפיינים הפונקציונליים, את דרישות העמידות, את הציפיות לגבי הביצועים ואת יעדי העלות. מידע נוסף זמין במאמר תכנון אסטרטגיית אחסון אופטימלית לעומסי העבודה בענן.
שירותי מסדי נתונים
ארכיטקטורת העזר במסמך הזה משתמשת ב-Spanner, מסד נתונים מנוהל באופן מלא, שניתן להתאמה אופקית, מבוזר גלובלית ומשוכפל באופן סינכרוני. מומלץ להגדיר את Spanner במספר אזורים לפריסות קריטיות שדורשות עקביות חזקה בין אזורים. Spanner תומך ברפליקציה סינכרונית בין אזורים בלי זמן השבתה לצורך יתירות כשל, תחזוקה או שינוי גודל.
במאמר מסדי נתונים ב-Google Cloud תוכלו לקרוא על שירותים אחרים של מסדי נתונים מנוהלים, שתוכלו לבחור מביניהם בהתאם לדרישות שלכם. כשבוחרים ומגדירים את מסד הנתונים לפריסה בכמה אזורים, חשוב להביא בחשבון את הדרישות של האפליקציה לעקביות בנתונים בין אזורים, ולהיות מודעים לפשרות בביצועים ובעלויות.
עיצוב הרשת
בוחרים עיצוב רשת שעונה על הדרישות העסקיות והטכניות שלכם. אפשר להשתמש ברשת VPC אחת או בכמה רשתות VPC. מידע נוסף זמין במשאבי העזרה הבאים:
אפשרויות לאיזון עומסים חיצוני
ארכיטקטורה שמשתמשת במאזן עומסים גלובלי חיצוני, כמו הארכיטקטורה שמתוארת במאמר הזה, תומכת בתכונות מסוימות שעוזרות לשפר את האמינות של הפריסות. לדוגמה, אם אתם משתמשים במאזן עומסים גלובלי חיצוני של אפליקציות (ALB), אתם יכולים להטמיע שמירת נתונים במטמון קצה באמצעות Cloud CDN.
אם באפליקציה שלכם נדרש סיום של Transport Layer Security (TLS) באזור ספציפי, או אם אתם צריכים את היכולת להציג תוכן מאזורים ספציפיים, אתם יכולים להשתמש במאזני עומסים אזוריים עם Cloud DNS כדי לנתב את התנועה לאזורים שונים. למידע על ההבדלים בין מאזני עומסים אזוריים וגלובליים, קראו את המאמרים הבאים:
- איזון עומסים גלובלי לעומת אזורי בקטע "בחירת מאזן עומסים"
- מצבי פעולה בסקירה הכללית של מאזן עומסים חיצוני של אפליקציות (ALB)
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות טופולוגיה גלובלית ב-Google Cloud , שעומדת בדרישות האבטחה, הפרטיות והתאימות של עומסי העבודה שלכם.
הגנה מפני איומים חיצוניים
כדי להגן על האפליקציה מפני איומים כמו התקפות מניעת שירות מבוזרות (DDoS) ופרצות אבטחה XSS (cross-site scripting), אתם יכולים להשתמש בכללי מדיניות האבטחה של Google Cloud Armor. כל מדיניות היא קבוצה של כללים שמציינים תנאים מסוימים שצריך להעריך, ופעולות שצריך לבצע כשהתנאים מתקיימים. לדוגמה, כלל יכול לציין שאם כתובת ה-IP של המקור של התנועה הנכנסת תואמת לכתובת IP ספציפית או לטווח CIDR, צריך לדחות את התנועה. אפשר גם להחיל כללים מוגדרים מראש של חומת אש ליישומי אינטרנט (WAF). מידע נוסף זמין במאמר סקירה כללית של מדיניות האבטחה.
גישה חיצונית למכונות וירטואליות
בארכיטקטורה לדוגמה שמתוארת במאמר הזה, המכונות הווירטואליות של Compute Engine לא צריכות גישה נכנסת מהאינטרנט. אל תקצו כתובות IP חיצוניות למכונות הווירטואליות. Google Cloud משאבים שיש להם רק כתובת IP פנימית פרטית עדיין יכולים לגשת לממשקי API ולשירותים מסוימים של Google באמצעות Private Service Connect או גישה פרטית ל-Google. מידע נוסף זמין במאמר אפשרויות גישה פרטיות לשירותים.
כדי לאפשר חיבורים יוצאים מאובטחים ממשאבי Google Cloud שיש להם רק כתובות IP פרטיות, כמו המכונות הווירטואליות של Compute Engine בארכיטקטורה לדוגמה, אתם יכולים להשתמש ב-Secure Web Proxy או ב-Cloud NAT.
הרשאות של חשבון שירות
במכונות הווירטואליות של Compute Engine בארכיטקטורה, במקום להשתמש בחשבונות השירות שמוגדרים כברירת מחדל, מומלץ ליצור חשבונות שירות ייעודיים ולציין את המשאבים שחשבון השירות יכול לגשת אליהם. לחשבון השירות שמוגדר כברירת מחדל יש מגוון רחב של הרשאות, כולל כאלה שלא בהכרח נדרשות. אתם יכולים להתאים אישית חשבונות שירות ייעודיים כך שיהיו להם רק ההרשאות החיוניות. מידע נוסף מופיע במאמר הגבלת ההרשאות של חשבון שירות.
אבטחת SSH
כדי לשפר את האבטחה של חיבורי SSH למכונות הווירטואליות של Compute Engine בארכיטקטורה, צריך להטמיע את Identity-Aware Proxy (IAP) ואת Cloud OS Login API. באמצעות IAP אפשר לשלוט בגישה לרשת על סמך זהות המשתמש וכללי המדיניות של ניהול זהויות והרשאות גישה (IAM). באמצעות Cloud OS Login API אפשר לשלוט בגישת SSH ל-Linux על סמך זהות המשתמש ומדיניות IAM. מידע נוסף על ניהול הגישה לרשת זמין במאמר שיטות מומלצות לשליטה בגישה להתחברות באמצעות SSH.
שיקולי אבטחה נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות וההמלצות לאבטחה ברמת הפלטפורמה שמפורטות בתוכנית לניהול יסודות הארגון ובGoogle Cloud Well-Architected Framework: אבטחה, פרטיות ותאימות.
אמינות
בקטע הזה מתוארים גורמי התכנון שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לבנות ולהפעיל תשתית אמינה לפריסה גלובלית ב- Google Cloud.
התאמה לעומס (autoscaling) ב-MIG
כשמריצים את האפליקציה בכמה קבוצות MIG אזוריות, היא נשארת זמינה גם בזמן הפסקות חשמל באזורים מבודדים או באזורים שלמים. היכולת של קבוצות MIG ללא שמירת מצב לשנות את הגודל באופן אוטומטי מאפשרת לשמור על הזמינות והביצועים של האפליקציה ברמות צפויות.
כדי לשלוט בהתנהגות של ההתאמה האוטומטית לעומס של קבוצות MIG בלי שמירת מצב, אפשר לציין מדדי ניצול יעד, כמו ניצול ממוצע של המעבד (CPU). אפשר גם להגדיר התאמה אוטומטית לעומס לפי לוח זמנים לקבוצות MIG בלי שמירת מצב. אי אפשר לשנות את קנה המידה של קבוצות MIG עם שמירת מצב באופן אוטומטי. מידע נוסף מופיע במאמר התאמה אוטומטית לעומס (autoscaling) של קבוצות מכונות.
מגבלת הגודל של קבוצת MIG
כשמחליטים על הגודל של קבוצות ה-MIG, צריך להביא בחשבון את מגבלות ברירת המחדל והמגבלות המקסימליות על מספר המכונות הווירטואליות שאפשר ליצור בקבוצת MIG. מידע נוסף זמין במאמר הוספה והסרה של מכונות וירטואליות מ-MIG.
תיקון אוטומטי של VM
לפעמים המכונות הווירטואליות שמארחות את האפליקציה פועלות וזמינות, אבל יש בעיות באפליקציה עצמה. האפליקציה עלולה לקפוא, לקרוס או לא לקבל מספיק זיכרון. כדי לוודא שאפליקציה מגיבה כצפוי, אפשר להגדיר בדיקות תקינות שמבוססות על אפליקציות כחלק ממדיניות התיקון האוטומטי של קבוצות ה-MIG. אם האפליקציה במכונה וירטואלית מסוימת לא מגיבה, ה-MIG מתקן את המכונה הווירטואלית באופן אוטומטי. מידע נוסף על הגדרת תיקון אוטומטי זמין במאמר תיקון מכונות וירטואליות לזמינות גבוהה.
מיקום ה-VM
בארכיטקטורה שמתוארת במאמר הזה, שכבת האפליקציה ושכבת האינטרנט פועלות במכונות וירטואליות של Compute Engine שפרוסות בכמה אזורים. ההפצה הזו מבטיחה שהאפליקציה תהיה עמידה בפני הפסקות חשמל באזור.
כדי לשפר את העמידות של הארכיטקטורה, אתם יכולים ליצור מדיניות למיקום מרווח ולהחיל אותה על התבנית של ה-MIG. כשה-MIG יוצר מכונות וירטואליות, הוא ממקם אותן בכל אזור בשרתים פיזיים שונים (שנקראים מארחים), כך שהמכונות הווירטואליות עמידות בפני כשלים של מארחים ספציפיים. מידע נוסף זמין במאמר יצירה והחלה של מדיניות למיקום מרווח במכונות וירטואליות.
תכנון קיבולת של מכונות וירטואליות
כדי לוודא שהקיבולת של המכונות הווירטואליות ב-Compute Engine זמינה כשצריך להקצות אותן, אתם יכולים ליצור מקומות שמורים. הזמנה מספקת קיבולת מובטחת באזור ספציפי למספר מסוים של מכונות וירטואליות מסוג מכונה שאתם בוחרים. אפשר להגדיר מקום שמור לפרויקט ספציפי, או לשתף אותו בין כמה פרויקטים. למידע נוסף על הזמנות, ראו בחירת סוג הזמנה.
אחסון עם שמירת מצב (stateful)
אחת מהשיטות המומלצות בתכנון אפליקציות היא להימנע מהצורך בדיסקים מקומיים עם שמירת מצב (stateful). אבל אם יש דרישה כזו, אתם יכולים להגדיר את הדיסקים הקבועים כ-stateful כדי לוודא שהנתונים יישמרו כשהמכונות הווירטואליות יתוקנו או ייווצרו מחדש. עם זאת, מומלץ להשאיר את דיסקי האתחול בלי שמירת מצב, כדי שתוכלו לעדכן אותם לתמונות העדכניות ביותר עם גרסאות חדשות ותיקוני אבטחה. מידע נוסף זמין במאמר הגדרת דיסקים קבועים עם שמירת מצב בקבוצות MIG.
עמידות הנתונים
אתם יכולים להשתמש בשירות Backup and DR כדי ליצור, לאחסן ולנהל גיבויים של מכונות וירטואליות ב-Compute Engine. Backup and DR מאחסן את נתוני הגיבוי בפורמט המקורי שלהם, שניתן לקריאה על ידי האפליקציה. במקרה הצורך, אתם יכולים לשחזר את עומסי העבודה לסביבת הייצור באמצעות שימוש ישיר בנתונים ממאגר הגיבוי לטווח ארוך, בלי להכין או להעביר את הנתונים.
ב-Compute Engine יש כמה אפשרויות שיעזרו לכם לוודא את עמידות הנתונים שמאוחסנים בנפחים של Persistent Disk:
- אתם יכולים להשתמש בתמונות מצב כדי לתעד את המצב של דיסקים לאחסון מתמיד בנקודת זמן מסוימת. תמונות המצב מאוחסנות באופן יתיר בכמה אזורים, עם סיכומי ביקורת (checksum) אוטומטיים כדי להבטיח את תקינות הנתונים. כברירת מחדל, קובצי snapshot הם מצטברים, ולכן הם תופסים פחות מקום באחסון וחוסכים לכם כסף. תמונות המצב מאוחסנות במיקום ב-Cloud Storage שאפשר להגדיר. המלצות נוספות לשימוש בתמונות מצב ולניהול שלהן זמינות במאמר שיטות מומלצות לתמונות מצב של דיסקים ב-Compute Engine.
- כדי לוודא שהנתונים ב-Persistent Disk יהיו זמינים גם אם תהיה הפסקה זמנית בשירות באזור, אתם יכולים להשתמש ב-Regional Persistent Disk או ב-Google Cloud Hyperdisk Balanced High Availability. הנתונים בסוגי הדיסקים האלה משוכפלים באופן סינכרוני בין שני אזורים באותו מחוז. מידע נוסף זמין במאמר מידע על שכפול דיסקים סינכרוני.
אמינות מסד הנתונים
נתונים שמאוחסנים במכונה של Spanner במספר אזורים משוכפלים באופן סינכרוני בכמה אזורים. ההגדרות של Spanner שמוצגות בדיאגרמת הארכיטקטורה שלמעלה כוללות את הרפליקות הבאות:
- ארבע רפליקות לקריאה ולכתיבה באזורים נפרדים בשני אזורים.
- רפליקת עדות באזור שלישי.
פעולת כתיבה למכונה של Spanner במספר אזורים מאושרת אחרי שלפחות שלוש רפליקות – באזורים נפרדים בשני אזורים – ביצעו את הפעולה. אם יש כשל באזור או בתחום, ל-Spanner יש גישה לכל הנתונים, כולל נתונים מפעולות הכתיבה האחרונות, והוא ממשיך לשרת בקשות קריאה וכתיבה.
ב-Spanner נעשה שימוש באחסון מפורק, שבו משאבי המחשוב והאחסון מופרדים. לא צריך להעביר נתונים כשמוסיפים קיבולת מחשוב לזמינות גבוהה או לשינוי קנה מידה. משאבי המחשוב החדשים מקבלים נתונים כשהם צריכים אותם מצומת Colossus הקרוב ביותר. כך אפשר לבצע יתירות כשל ושינוי קנה מידה מהר יותר ובצורה בטוחה יותר.
Spanner מספק עקביות עם העולם האמיתי, שהיא מאפיין מחמיר יותר מאשר יכולת סריאליזציה למערכות של עיבוד טרנזקציות. למידע נוסף, קראו את המאמרים הבאים:
- Spanner: TrueTime ועקביות עם העולם האמיתי
- הסבר על הגדרות Spanner במספר אזורים
- Inside Spanner and the CAP Theorem
שיקולים נוספים בנושא אמינות
כשאתם בונים את ארכיטקטורת הענן לעומס העבודה, כדאי לעיין בשיטות המומלצות ובהמלצות שקשורות לאמינות, שמפורטות במסמכים הבאים:
- Google Cloud מדריך לאמינות התשתית
- תבניות לאפליקציות עמידות שניתנות להרחבה
- תכנון מערכות חסינות
- Google Cloud Well-Architected Framework: אמינות
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלויות ההגדרה וההפעלה של טופולוגיית Google Cloud גלובלית, שאתם בונים באמצעות ארכיטקטורת העזר הזו.
סוגי מכונות וירטואליות
כדי לעזור לכם לשפר את ניצול המשאבים של המכונות הווירטואליות, Compute Engine מספק המלצות לסוגי מכונות. אתם יכולים להשתמש בהמלצות כדי לבחור סוגי מכונות שמתאימים לדרישות המחשוב של עומס העבודה. אם אתם יכולים לחזות את דרישות המשאבים של עומסי העבודה, אתם יכולים להתאים אישית את סוג המכונה לצרכים שלכם ולחסוך כסף באמצעות סוגי מכונות בהתאמה אישית.
מודל הקצאת המשאבים של המכונה הווירטואלית
אם האפליקציה שלכם עמידה בפני תקלות, מכונות וירטואליות במחיר Spot יכולות לעזור לכם להפחית את העלויות של Compute Engine למכונות הווירטואליות בשכבות האפליקציה והאינטרנט. העלות של VM במודל Spot נמוכה משמעותית מזו של מכונות וירטואליות רגילות. עם זאת, יכול להיות ש-Compute Engine יפסיק או ימחק מכונות VM במודל Spot כדי לפנות קיבולת.
VM במודל Spot מתאימות למשימות באצווה שיכולות לסבול הפסקה זמנית, ואין להן דרישות גבוהות לזמינות גבוהה. VM במודל Spot מציעות את אותם סוגי מכונות, אפשרויות וביצועים כמו מכונות וירטואליות רגילות. עם זאת, כשהקיבולת של המשאבים באזור מסוים מוגבלת, יכול להיות שקבוצות ה-MIG לא יוכלו להתרחב באופן אוטומטי (כלומר, ליצור מכונות וירטואליות) לגודל היעד שצוין עד שהקיבולת הנדרשת תהיה זמינה שוב.
ניצול המשאבים של המכונה הווירטואלית
היכולת של קבוצות MIG ללא שמירת מצב להתאמה אוטומטית לעומס מאפשרת לאפליקציה להתמודד עם עליות בתעבורת נתונים בצורה חלקה, ועוזרת לכם להפחית את העלויות כשהצורך במשאבים נמוך. אי אפשר לשנות את קנה המידה של קבוצות MIG עם שמירת מצב באופן אוטומטי.
עלות מסד הנתונים
Spanner עוזר לוודא שעלויות מסד הנתונים צפויות. קיבולת האחסון נקבעת לפי קיבולת המחשוב שאתם מציינים (מספר הצמתים או יחידות העיבוד). קצב העברת הנתונים לקריאה ולכתיבה משתנה באופן ליניארי בהתאם לקיבולת המחשוב. התשלום הוא רק על השימוש בפועל. כדי להתאים את העלויות לצורכי עומס העבודה, אתם יכולים לשנות את הגודל של המכונה ב-Spanner.
רישוי של צד שלישי
כשמעבירים עומסי עבודה של צד שלישי אל Google Cloud, יכול להיות שאפשר להוזיל את העלויות באמצעות רישיונות קיימים (BYOL). לדוגמה, כדי לפרוס מכונות וירטואליות של Microsoft Windows Server, במקום להשתמש בקובץ אימג' פרימיום שגורר עלות נוספת על הרישיון של הצד השלישי, אתם יכולים ליצור קובץ אימג' בהתאמה אישית של Windows BYOL ולהשתמש בו. אחרי זה, אתם משלמים רק על תשתית ה-VM שבה אתם משתמשים ב- Google Cloud. האסטרטגיה הזו עוזרת לכם להמשיך להפיק ערך מההשקעות הקיימות שלכם ברישיונות של צד שלישי. אם החלטתם להשתמש בגישת BYOL, ההמלצות הבאות יכולות לעזור לכם להוזיל את העלויות:
- להקצות את המספר הנדרש של ליבות מעבד (CPU) לחישוב, בלי קשר לזיכרון, באמצעות סוגי מכונות בהתאמה אישית. כך אתם מגבילים את עלות הרישוי של הצד השלישי למספר ליבות המעבד שאתם צריכים.
- להשבית את הריבוי-תהליכים בו-זמני (SMT) כדי להפחית את מספר המעבדים הווירטואליים לכל ליבה מ-2 ל-1.
אם אתם פורסים מסד נתונים של צד שלישי, כמו Microsoft SQL Server, במכונות וירטואליות של Compute Engine, אתם צריכים להביא בחשבון את עלויות הרישיון של תוכנת הצד השלישי. כשמשתמשים בשירות של מסד נתונים מנוהל כמו Cloud SQL, עלויות הרישיון של מסד הנתונים כלולות בחיובים על השירות.
שיקולי עלות נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי גם להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות שמפורטות במאמר Google Cloud Well-Architected Framework: הוזלת העלויות.
יעילות תפעולית
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות טופולוגיה גלובלית של Google Cloud שאפשר להפעיל ביעילות.
עדכונים בהגדרות של המכונה הווירטואלית
כדי לעדכן את ההגדרות של המכונות הווירטואליות בקבוצת MIG (למשל, סוג המכונה או קובץ האימג' של דיסק האתחול), יוצרים תבנית חדשה של הגדרות מכונה עם ההגדרות הנדרשות, ואז מחילים את התבנית החדשה על קבוצת ה-MIG. ה-MIG מעדכן את המכונות הווירטואליות באמצעות שיטת העדכון שבחרתם: אוטומטית או סלקטיבית. בחרו שיטה מתאימה בהתאם לדרישות שלכם לגבי זמינות ויעילות תפעולית. למידע נוסף על השיטות האלה לעדכון קבוצות MIG, קראו את המאמר החלת הגדרות חדשות של מכונות וירטואליות בקבוצת MIG.
תמונות של מכונות וירטואליות
במקום להשתמש בקובצי אימג' ציבוריים של Google למכונות הווירטואליות, מומלץ ליצור ולהשתמש בקובצי אימג' בהתאמה אישית של מערכת ההפעלה, שמכילים את ההגדרות והתוכנות שהאפליקציות שלכם צריכות. אתם יכולים לקבץ את קובצי האימג' בהתאמה אישית למשפחה של קובצי אימג' בהתאמה אישית. משפחת תמונות תמיד מפנה לתמונה העדכנית ביותר במשפחה, כך שתבניות של הגדרות מכונה וסקריפטים יכולים להשתמש בתמונה הזו בלי שתצטרכו לעדכן הפניות לגרסת תמונה ספציפית. צריך לעדכן באופן קבוע את קובצי האימג' בהתאמה אישית כדי לכלול את עדכוני האבטחה והתיקונים שמספק ספק מערכת ההפעלה.
תבניות דטרמיניסטיות של הגדרות מכונה
אם התבניות של הגדרות המכונה שבהן אתם משתמשים בקבוצות ה-MIG כוללות סקריפטים לטעינה בזמן ההפעלה כדי להתקין תוכנת צד שלישי, ודאו שהסקריפטים מציינים במפורש את הפרמטרים של התקנת התוכנה, כמו גרסת התוכנה. אחרת, כשה-MIG יוצר את המכונות הווירטואליות, יכול להיות שהתוכנה שמותקנת במכונות הווירטואליות לא תהיה עקבית. לדוגמה, אם תבנית של הגדרות מכונה כוללת סקריפט לטעינה בזמן ההפעלה להתקנת Apache HTTP Server 2.4 (החבילה apache2), צריך לוודא שהסקריפט מציין את הגרסה המדויקת של apache2 שצריך להתקין, כמו גרסה 2.4.69. מידע נוסף זמין במאמר תבניות דטרמיניסטיות של הגדרות מכונה.
העברה ל-Spanner
אתם יכולים להעביר את הנתונים ל-Spanner ממסדי נתונים אחרים כמו MySQL, SQL Server ו-Oracle Database. תהליך ההעברה תלוי בגורמים כמו מסד הנתונים של המקור, גודל הנתונים, מגבלות זמן ההשבתה ומורכבות קוד האפליקציה. כדי לעזור לכם לתכנן ולהטמיע את ההעברה ל-Spanner ביעילות, אנחנו מספקים מגוון כלים של Google Cloudושל צד שלישי. מידע נוסף זמין במאמר סקירה כללית על העברה.
ניהול מסדי נתונים
ב-Spanner לא צריך להגדיר או לעקוב אחרי הרפליקציה או יתירות הכשל. רפליקציה סינכרונית ויתירות כשל אוטומטית מובנות. האפליקציה לא חווה זמן השבתה לצורך תחזוקה של מסד הנתונים ויתירות כשל. כדי לצמצם עוד יותר את המורכבות התפעולית, אתם יכולים להגדיר התאמה אוטומטית לעומס. כשההתאמה אוטומטית לעומס מופעלת, לא צריך לעקוב אחרי גודל המכונה ולשנות אותו ידנית.
שיקולים תפעוליים נוספים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות ליעילות תפעולית שמתוארות במאמר Google Cloud Well-Architected Framework: מצוינות תפעולית.
אופטימיזציה של הביצועים
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות טופולוגיה גלובלית ב-Google Cloud שעומדת בדרישות הביצועים של עומסי העבודה שלכם.
ביצועי הרשת
אם יש לכם עומסי עבודה שדורשים זמן אחזור נמוך ברשת בין מכונות וירטואליות בשכבות האפליקציה והאינטרנט, אתם יכולים ליצור מדיניות מיקום קומפקטי ולהחיל אותה על התבנית של קבוצת המכונות המנוהלת שמשמשת לשכבות האלה. כשה-MIG יוצר מכונות וירטואליות, הוא ממקם אותן בשרתים פיזיים שקרובים זה לזה. מדיניות למיקום קומפקטי עוזרת לשפר את ביצועי הרשת בין המכונות הווירטואליות, אבל מדיניות למיקום מרווח יכולה לעזור לשפר את הזמינות של המכונות הווירטואליות, כמו שתיארנו קודם. כדי להשיג איזון אופטימלי בין ביצועי הרשת לבין הזמינות, כשיוצרים מדיניות למיקום קומפקטי אפשר לציין את המרחק המקסימלי בין המכונות הווירטואליות. מידע נוסף מופיע במאמר סקירה כללית על כללי מיקום.
ב-Compute Engine יש מגבלה לכל מכונה וירטואלית על רוחב הפס של הרשת לתעבורת נתונים יוצאת. המגבלה הזו תלויה בסוג המכונה של ה-VM, ובשאלה אם התנועה מנותבת דרך אותה רשת VPC כמו ה-VM המקורי. במכונות וירטואליות עם סוגי מכונות מסוימים, כדי לשפר את ביצועי הרשת, אתם יכולים להפעיל את רשת Tier_1 ולקבל רוחב פס מקסימלי גבוה יותר לתעבורת נתונים יוצאת.
ביצועי המחשוב
ב-Compute Engine יש מגוון רחב של סוגי מכונות מוגדרים מראש ובהתאמה אישית, לעומסי העבודה שאתם מריצים במכונות וירטואליות. בוחרים סוג מכונה שמתאים לדרישות הביצועים שלכם. מידע נוסף זמין במאמר מדריך השוואה ומשאבים של משפחות מכונות.
ריבוי הליכי משנה (multithreading) של VM
כל מעבד וירטואלי (vCPU) שאתם מקצים למכונה וירטואלית ב-Compute Engine מוטמע כריבוי הליכי משנה (multithread) בחומרה אחת. כברירת מחדל, שני מעבדי vCPU משתפים ליבת מעבד פיזית. באפליקציות שכוללות פעולות מקבילות מאוד או שמבצעות חישובים של נקודה צפה (כמו ניתוח רצף גנטי ומודלים של סיכון פיננסי), אפשר לשפר את הביצועים על ידי הפחתת מספר השרשורים שפועלים בכל ליבת מעבד פיזית. מידע נוסף זמין במאמר הגדרת מספר הליכי המשנה לכל ליבה.
לריבוי הליכים (multithreading) במכונות וירטואליות יכולות להיות השלכות על הרישוי של תוכנות מסוימות של צד שלישי, כמו מסדי נתונים. למידע נוסף, קראו את מסמכי התיעוד בנושא רישוי של תוכנת הצד השלישי.
Network Service Tiers
מסלולי שירות הרשת מאפשרים לכם לבצע אופטימיזציה של עלות הרשת והביצועים של עומסי העבודה. אתם יכולים לבחור בין מסלול פרימיום למסלול רגיל. במסלול הפרימיום, תעבורת הנתונים עוברת דרך התשתית הגלובלית של Google כדי להשיג אובדן מנות מינימלי וזמן אחזור קצר. במסלול הרגיל, תעבורת הנתונים מועברת באמצעות קישור בין רשתות שכנות (peering), ספקי אינטרנט (ISP) או רשתות העברה בנקודת קצה (PoP) שהכי קרובה לאזור שבו פועל עומס העבודה ב- Google Cloud . כדי לשפר את הביצועים, מומלץ להשתמש במסלול פרימיום. כדי לבצע אופטימיזציה של העלות, מומלץ להשתמש במסלול הרגיל.
הארכיטקטורה במסמך הזה משתמשת במאזן עומסים חיצוני גלובלי עם כתובת IP חיצונית ובק-אנדים בכמה אזורים. בארכיטקטורה הזו צריך להשתמש במסלול פרימיום, שבו נעשה שימוש בתשתית הגלובלית האמינה של Google כדי לצמצם את אובדן המנות וזמן האחזור.
אם אתם משתמשים במאזני עומסים חיצוניים אזוריים ומנתבים את התנועה לאזורים באמצעות Cloud DNS, אתם יכולים לבחור במסלול הפרימיום או במסלול הרגיל בהתאם לדרישות שלכם. המחיר של המסלול הרגיל נמוך מהמחיר של מסלול הפרימיום. מסלול Standard מתאים לתעבורת נתונים שלא רגישה לאובדן מנות, ושאין לה דרישות לזמן אחזור קצר.
ביצועי Spanner
כשמקצים מכונה של Spanner, מציינים את קיבולת המחשוב של המכונה לפי מספר הצמתים או יחידות העיבוד. עוקבים אחרי ניצול המשאבים של מכונות Spanner, ומשנים את הקיבולת בהתאם לעומס הצפוי ולדרישות הביצועים של האפליקציה. אתם יכולים לשנות את הקיבולת של מכונה ב-Spanner באופן ידני או אוטומטי. מידע נוסף זמין במאמר סקירה כללית על התאמה לעומס (scaling).
בהגדרה של מספר אזורים, Spanner משכפל נתונים באופן סינכרוני בכמה אזורים. הרפליקציה הזו מאפשרת לבצע פעולות קריאה עם זמן אחזור קצר ממספר מיקומים. החיסרון הוא זמן אחזור ארוך יותר לפעולות כתיבה, כי הרפליקות של הקוורום מפוזרות בכמה אזורים. כדי לצמצם את זמן האחזור של עסקאות קריאה-כתיבה בהגדרות במספר אזורים, Spanner משתמש בניתוב מבוסס-מנהיג (מופעל כברירת מחדל).
במאמרים הבאים מפורטות המלצות לאופטימיזציה של הביצועים של המכונה ומסדי הנתונים ב-Spanner:
- שיטות מומלצות לשיפור הביצועים בהגדרות של מספר אזורים
- שיטות מומלצות לעיצוב סכימה
- שיטות מומלצות לטעינה בכמות גדולה
- שיטות מומלצות לשימוש בשפת טיפול בנתונים (DML)
- שיטות מומלצות ל-SQL
שמירה במטמון
אם האפליקציה שלכם מציגה נכסים סטטיים של אתרים, והארכיטקטורה שלכם כוללת מאזן עומסים חיצוני גלובלי של אפליקציות (ALB), אתם יכולים להשתמש ב-Cloud CDN כדי לשמור במטמון תוכן סטטי שהגישה אליו מתבצעת באופן קבוע, בקרבת המשתמשים. בעזרת Cloud CDN אפשר לשפר את הביצועים בשביל המשתמשים, לצמצם את השימוש במשאבי התשתית בקצה העורפי ולהפחית את עלויות ההעברה ברשת. מידע נוסף זמין במאמר ביצועים מהירים יותר באינטרנט והגנה משופרת באינטרנט לאיזון עומסים.
שיקולים נוספים שקשורים לביצועים
כשאתם בונים את הארכיטקטורה של עומס העבודה, כדאי להביא בחשבון את השיטות המומלצות הכלליות ואת ההמלצות שמפורטות במאמר Google Cloud Well-Architected Framework: אופטימיזציה של הביצועים.
המאמרים הבאים
- Google Cloud מידע נוסף על המוצרים שמשמשים בארכיטקטורה לדוגמה:
- מידע על רפליקציה ועקביות ב-Spanner:
- איך מתחילים להעביר את עומסי העבודה ל- Google Cloud.
- בחינה והערכה של ארכיטיפים של פריסה שתוכלו לבחור כדי לבנות ארכיטקטורות לעומסי העבודה שלכם בענן.
- בודקים את אפשרויות הארכיטקטורה כדי לתכנן תשתית אמינה לעומסי העבודה ב- Google Cloud.
- פריסת GFE שניתנים לתכנות באמצעות Cloud Armor, איזון עומסים ו-Cloud CDN.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- קומאר דהנגופאל | מפתח פתרונות חוצי-מוצרים
- סמנתה הי | כותבת טכנית
תורמים אחרים:
- בן גוד | אדריכל פתרונות
- דניאל ליס | ארכיטקט אבטחה בענן
- Gleb Otochkin | Cloud Advocate, Databases
- ג'סטין מייקיג | מנהל מוצר
- מארק שלאגנהאוף | כותב טכני, רשתות
- סקו פייג' | מנהל מוצר יוצא
- סטיב מקגי | מומחה לאמינות
- ויקטור מורנו | מנהל מוצר, Cloud Networking