


כפי שמתואר בזמינות הפלטפורמה, התשתית שלGoogle Cloud מיועדת לתמוך בזמינות יעד של 99.9% לעומס עבודה שנפרס באזור יחיד. זמינות היעד היא 99.99% לפריסה במספר אזורים1 ו-99.999% לפריסה במספר אזורים. החלק הזה של Google Cloud מדריך האמינות של התשתית כולל הנחיות לפריסה, דוגמאות לארכיטקטורות וטכניקות עיצוב שיכולות לעזור לכם להגן על עומסי העבודה מפני כשלים ברמת המשאב, האזור והאזור.
הימנעות מנקודות כשל בודדות
אפליקציות מורכבות בדרך כלל מכמה רכיבים שתלויים זה בזה, וכל אחד מהם נועד לבצע פונקציה ספציפית. המרכיבים האלה בדרך כלל מקובצים לרמות על סמך הפונקציה שהם מבצעים והקשר שלהם למרכיבים האחרים. לדוגמה, לאפליקציה להצגת תוכן יכולים להיות שלושה רבדים: רובד אינטרנט שמכיל מאזן עומסים ושרתי אינטרנט, רובד אפליקציה עם אשכול של שרתי אפליקציה ורובד נתונים להתמדה. אם רכיב כלשהו במערך האפליקציות הזה תלוי במשאב תשתית יחיד, כשל במשאב הזה עלול להשפיע על הזמינות של המערך כולו. לדוגמה, אם שכבת האפליקציה פועלת במכונה וירטואלית אחת, ואם המכונה הווירטואלית קורסת, אז כל הערימה לא זמינה. רכיב כזה הוא נקודת כשל בודדת (SPOF).
יכול להיות שיש יותר מנקודת כשל יחידה אחת במערך אפליקציות. נבחן את ערימת האפליקציות הרב-שכבתית שמוצגת בתרשים הבא:
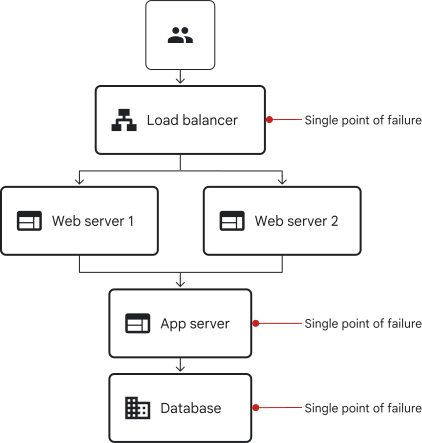
כפי שמוצג בתרשים הקודם, הארכיטקטורה בדוגמה הזו מכילה מאזן עומסים אחד, שני שרתי אינטרנט, שרת אפליקציות אחד ומסד נתונים אחד. מאזן העומסים, שרת האפליקציות ומסד הנתונים בדוגמה הזו הם נקודות כשל יחידות (SPOF). אם אחד מהרכיבים האלה לא פועל, בקשות של משתמשים לאפליקציה ייכשלו.
כדי להסיר את נקודות הכשל היחידות (SPOF) במערך האפליקציות, צריך לפזר את המשאבים בין מיקומים שונים ולפרוס משאבים מיותרים.
הפצת משאבים ויצירת יתירות
בהתאם לדרישות האמינות של האפליקציה, אתם יכולים לבחור מבין ארכיטקטורות הפריסה הבאות:
| ארכיטקטורה | המלצה לעומס עבודה |
|---|---|
| במספר אזורים | עומסי עבודה שהם קריטיים לעסק ושבהם זמינות גבוהה (HA) היא חיונית, כמו יישומי קמעונאות ומדיה חברתית. |
| רב-אזורי | עומסי עבודה שצריכים עמידות בפני הפסקות חשמל באזורים, אבל יכולים לסבול השבתה מסוימת שנגרמת כתוצאה מהפסקות חשמל באזורים. |
| תחום אחד | עומסי עבודה שיכולים לעמוד בהשבתה או שאפשר לפרוס אותם במיקום אחר כשצריך, במינימום מאמץ. |
שיקולים לגבי עלות, זמן אחזור ותפעול
כשמתכננים ארכיטקטורה מבוזרת עם משאבים מיותרים, צריך לקחת בחשבון לא רק את דרישות הזמינות של האפליקציה, אלא גם את ההשפעות על מורכבות התפעול, על זמן האחזור ועל העלות.
בארכיטקטורה מבוזרת, אתם מקצים ומנהלים מספר גדול יותר של משאבים. נפח התנועה ברשת בין מיקומים גבוה יותר. אתם גם יכולים לאחסן ולהעתיק עוד נתונים. כתוצאה מכך, העלות של משאבי הענן בארכיטקטורה מבוזרת גבוהה יותר, והתפעול של פריסות כאלה מורכב יותר. במקרה של אפליקציות קריטיות לעסק, היתרון של זמינות גבוהה יותר בארכיטקטורה מבוזרת עשוי להיות חשוב יותר מהעלות הגבוהה וממורכבות התפעול.
באפליקציות שלא חיוניות לעסק, יכול להיות שהזמינות הגבוהה שארכיטקטורה מבוזרת מספקת לא חיונית. יש אפליקציות מסוימות שבהן יש דרישות אחרות שחשובות יותר מהזמינות. לדוגמה, אפליקציות של עיבוד באצווה דורשות חיבורי רשת עם זמן אחזור נמוך ורוחב פס גבוה בין מכונות ה-VM. ארכיטקטורה של אזור יחיד יכולה להתאים מאוד לאפליקציות כאלה, והיא גם יכולה לעזור לכם להפחית את העלויות של העברת נתונים.
ארכיטקטורות פריסה
בקטע הזה מוצגות האפשרויות הבאות לארכיטקטורה לבניית תשתית לעומסי העבודה ב- Google Cloud:
- פריסה באזור יחיד
- פריסה בכמה אזורים
- פריסה במספר אזורים עם איזון עומסים אזורי
- פריסה במספר אזורים עם איזון עומסים גלובלי
פריסה באזור יחיד
התרשים הבא מציג ארכיטקטורת אפליקציה באזור יחיד עם יתירות בכל רמה, כדי להשיג זמינות גבוהה יותר של הפונקציות שמבוצעות על ידי כל רכיב:
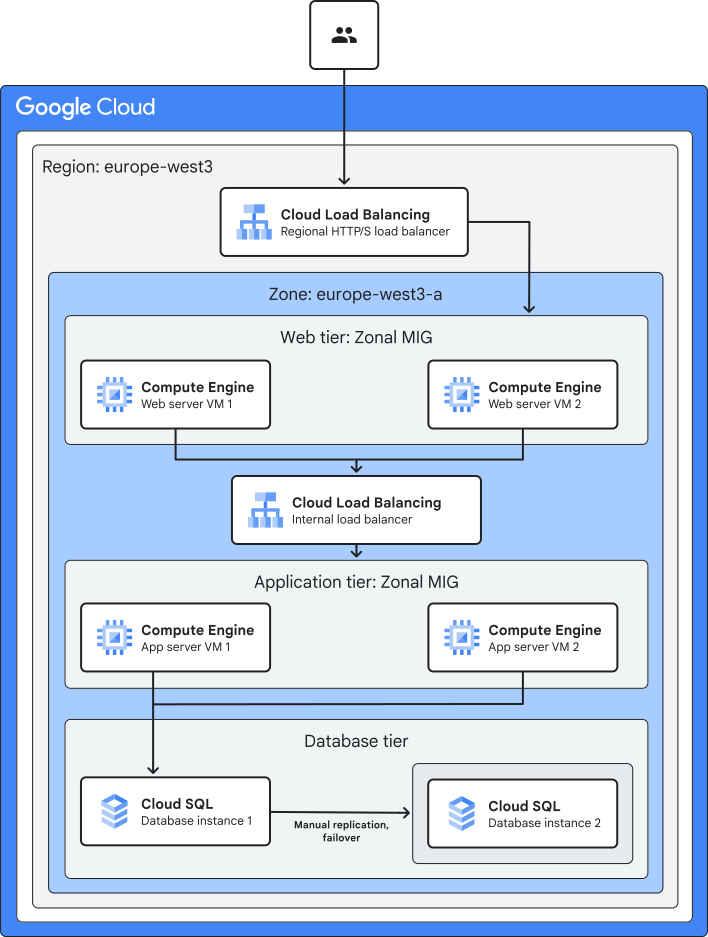
כפי שמוצג בתרשים הקודם, הארכיטקטורה לדוגמה הזו כוללת את הרכיבים הבאים:
- מאזן עומסים חיצוני אזורי של אפליקציות (ALB) כדי לקבל בקשות ממשתמשים ולהגיב להן.
- קבוצת מופעי מכונה מנוהלים (MIG) אזורית כבק-אנד למאזן עומסים חיצוני אזורי של אפליקציות (ALB). קבוצת ה-MIG כוללת שתי מכונות וירטואליות ב-Compute Engine. כל מכונה וירטואלית מארחת מופע של שרת אינטרנט.
- מאזן עומסי רשת פנימי אזורי להעברת סיגנל ללא שינוי, לטיפול בתקשורת בין שרתי האינטרנט לבין שרתי האפליקציות.
- קבוצת MIG אזורית שנייה כבק-אנד למאזן העומסים הפנימי. קבוצת ה-MIG הזו מכילה שתי מכונות וירטואליות ב-Compute Engine. כל מכונה וירטואלית מארחת מופע של שרת אפליקציות.
- מכונת מסד נתונים ב-Cloud SQL (מהדורת Enterprise) שהאפליקציה כותבת נתונים לתוכה וקוראת נתונים ממנה. מסד הנתונים משוכפל באופן ידני למכונת מסד נתונים שנייה ב-Cloud SQL באותו אזור.
זמינות מצטברת: פריסה באזור יחיד
בטבלה הבאה מוצגת הזמינות של כל רמה בדיאגרמת הארכיטקטורה של אזור יחיד שמופיעה למעלה:
| משאב | הסכם רמת שירות (SLA) |
|---|---|
| מאזן עומסים חיצוניים | 99.99% |
| שכבת האינטרנט: מכונות וירטואליות ב-Compute Engine באזור אחד | 99.9% |
| מאזן עומסים פנימיים | 99.99% |
| שכבת האפליקציה: מכונות וירטואליות ב-Compute Engine בתחום אחד | 99.9% |
| מכונת Cloud SQL (מהדורת Enterprise, הגדרת זמינות גבוהה) | 99.95% |
אפשר לצפות שמשאבי Google Cloud התשתית שמפורטים בטבלה הקודמת יספקו את הזמינות המצטברת הבאה ואת זמן ההשבתה החודשי המקסימלי המשוער:
- זמינות מצטברת: 0.9999 x 0.999 x 0.9999 x 0.999 x 0.9995 = 99.73%
- זמן ההשבתה החודשי המקסימלי המשוער: בערך שעה ו-57 דקות
החישוב הזה מתייחס רק למשאבי התשתית שמוצגים בדיאגרמת הארכיטקטורה שלמעלה. כדי להעריך את הזמינות של אפליקציה ב- Google Cloud, צריך להביא בחשבון גם גורמים אחרים, כמו:
- העיצוב הפנימי של האפליקציה
- תהליכי ה-DevOps והכלים שמשמשים לפיתוח, לפריסה ולתחזוקה של האפליקציה, קשרי התלות שלה והתשתית של Google Cloud
מידע נוסף זמין במאמר גורמים שמשפיעים על מהימנות האפליקציה.
ההשפעות של הפסקות זמניות בשירות והנחיות לשחזור
בארכיטקטורת פריסה של אזור יחיד, אם רכיב כלשהו נכשל, האפליקציה יכולה לעבד בקשות אם כל שכבה מכילה לפחות רכיב אחד מתפקד עם קיבולת מספקת. לדוגמה, אם מופע של שרת אינטרנט נכשל, מאזן העומסים מעביר את בקשות המשתמשים למופעים אחרים של שרת האינטרנט. אם מכונה וירטואלית שמארחת שרת אינטרנט או שרת אפליקציות קורסת, קבוצת ה-MIG מוודאת שמכונה וירטואלית חדשה נוצרת באופן אוטומטי. אם מסד הנתונים קורס, צריך להפעיל ידנית את מסד הנתונים השני ולעדכן את המופעים של שרת האפליקציות כדי להתחבר למסד הנתונים.
הפסקת חשמל באזור או בתחום משפיעה על המכונות הווירטואליות ב-Compute Engine ועל מופעי מסדי הנתונים ב-Cloud SQL בפריסה של תחום יחיד. הפסקת זמנית בשירות בתחום לא משפיעה על מאזן העומסים בארכיטקטורה הזו כי הוא משאב אזורי. עם זאת, מאזן העומסים לא יכול להפיץ את התנועה כי אין קצה עורפי זמין. אם מתרחש הפסקת חשמל באזור, צריך להמתין עד ש-Google תפתור את הבעיה, ואז לוודא שהאפליקציה פועלת כמצופה.
בקטע הבא מתואר גישה ארכיטקטונית שבה אפשר להשתמש כדי להפיץ משאבים על פני אזורים רבים, וכך לשפר את חוסן (resilience) האפליקציה להפסקות חשמל באזורים.
פריסה בכמה אזורים
בפריסה של אזור יחיד, אם מתרחש הפסקת חשמל באזור, יכול להיות שהאפליקציה לא תוכל לטפל בבקשות עד שהבעיה תיפתר. כדי לשפר את החוסן (resilience) של האפליקציה שלכם מפני הפסקות חשמל בתחומים (zone), אתם יכולים להקצות כמה מכונות של משאבים של תחום מוגדר (zonal resources) (כמו מכונות וירטואליות ב-Compute Engine) בשני תחומים (zone) או יותר. בשירותים שתומכים במשאבים בהיקף אזורי (כמו קטגוריות של Cloud Storage), אפשר לפרוס משאבים אזוריים.
התרשים הבא מציג ארכיטקטורה עם זמינות גבוהה בין אזורים, שבה הרכיבים בכל שכבה של מחסנית האפליקציות מפוזרים על פני שני אזורים:
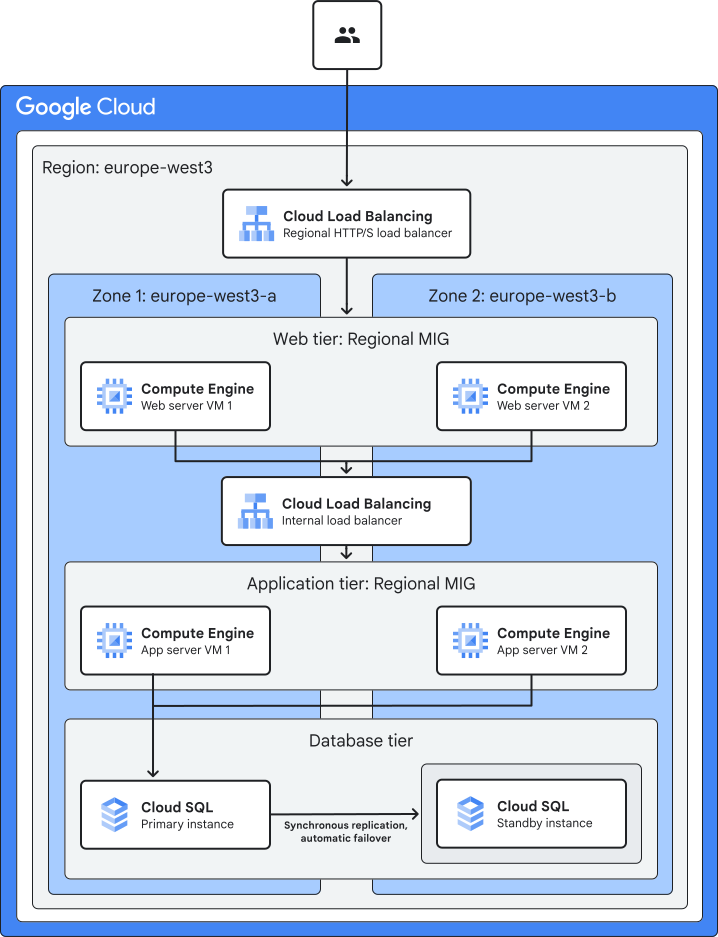
כפי שמוצג בתרשים הקודם, הארכיטקטורה לדוגמה הזו כוללת את הרכיבים הבאים:
- מאזן עומסים חיצוני אזורי של אפליקציות (ALB) מקבל בקשות ממשתמשים ומגיב להן.
- קבוצת ה-MIG האזורית היא הבק-אנד של מאזן העומסים החיצוני האזורי של האפליקציות. ה-MIG מכיל שתי מכונות וירטואליות ב-Compute Engine באזורים שונים. כל מכונה וירטואלית מארחת מופע של שרת אינטרנט.
- מאזן עומסי רשת פנימי אזורי להעברת סיגנל ללא שינוי מטפל בתקשורת בין שרתי האינטרנט לשרתי האפליקציות.
- קבוצת MIG אזורית שנייה היא הבק-אנד של מאזן העומסים הפנימי. קבוצת ה-MIG הזו כוללת שתי מכונות וירטואליות של Compute Engine באזורים שונים. כל מכונה וירטואלית מארחת מופע של שרת אפליקציות.
- מכונת Cloud SQL (מהדור Enterprise) שהוגדרה לזמינות גבוהה היא מסד הנתונים של האפליקציה. מופע מסד הנתונים הראשי משוכפל באופן סינכרוני למופע מסד נתונים במצב המתנה.
זמינות מצטברת: פריסה בכמה אזורים
בטבלה הבאה מוצגת הזמינות של כל רמה בתרשים דיאגרמת הארכיטקטורה הקודם של אזור כפול:
| משאב | הסכם רמת שירות (SLA) |
|---|---|
| מאזן עומסים חיצוניים | 99.99% |
| שכבת האינטרנט: מכונות וירטואליות של Compute Engine בתחומים נפרדים | 99.99% |
| מאזן עומסים פנימיים | 99.99% |
| שכבת האפליקציה: מכונות וירטואליות של Compute Engine בתחומים נפרדים | 99.99% |
| מכונת Cloud SQL (מהדורת Enterprise, הגדרת זמינות גבוהה) | 99.95% |
אפשר לצפות שמשאבי Google Cloud התשתית שמפורטים בטבלה הקודמת יספקו את הזמינות המצטברת הבאה ואת זמן ההשבתה המקסימלי המשוער בחודש:
- זמינות מצטברת: 0.9999 x 0.9999 x 0.9999 x 0.9999 x 0.9995 = 99.91%
- זמן ההשבתה המקסימלי המשוער לחודש: כ-39 דקות
החישוב הזה מתייחס רק למשאבי התשתית שמוצגים בדיאגרמת הארכיטקטורה שלמעלה. כדי להעריך את הזמינות של אפליקציה ב- Google Cloud, צריך להביא בחשבון גם גורמים אחרים, כמו:
- העיצוב הפנימי של האפליקציה
- תהליכי ה-DevOps והכלים שמשמשים לפיתוח, לפריסה ולתחזוקה של האפליקציה, קשרי התלות שלה והתשתית של Google Cloud
מידע נוסף זמין במאמר גורמים שמשפיעים על מהימנות האפליקציה.
ההשפעות של הפסקות זמניות בשירות והנחיות לשחזור
בפריסה דו-אזורית, אם רכיב כלשהו נכשל, האפליקציה יכולה לעבד בקשות אם קיים לפחות רכיב אחד תקין עם קיבולת מספקת בכל רמה. לדוגמה, אם מופע של שרת אינטרנט נכשל, מאזן העומסים מעביר את בקשות המשתמשים למופע של שרת האינטרנט באזור השני. אם מכונה וירטואלית שמארחת שרת אינטרנט או מופע של שרת אפליקציות קורסת, קבוצת המכונות הווירטואליות המנוהלות (MIG) דואגת ליצירה אוטומטית של מכונה וירטואלית חדשה. אם מסד הנתונים הראשי של Cloud SQL קורס, Cloud SQL מבצע אוטומטית מעבר לגיבוי כשל למכונת מסד הנתונים במצב המתנה.
בתרשים הבא מוצגת אותה ארכיטקטורה כמו בתרשים הקודם, וההשפעות של הפסקת חשמל באזור על הזמינות של האפליקציה:
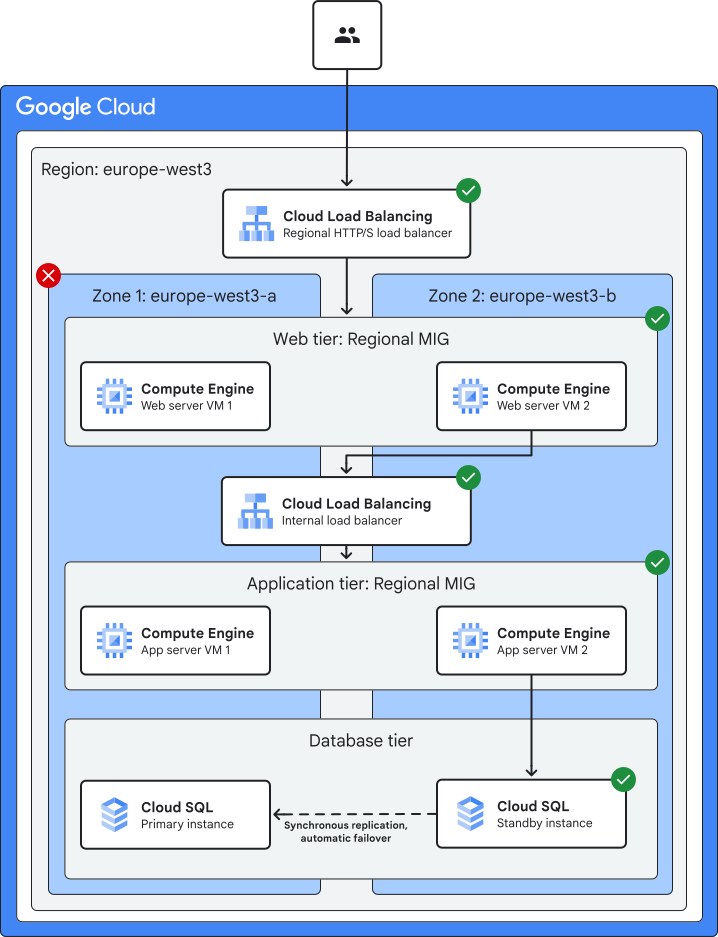
כפי שמוצג בדיאגרמה הקודמת, אם מתרחש שיבוש באחד מהתחומים (zones), הוא לא משפיע על מאזן העומסים (LB) בארכיטקטורה הזו, כי הוא משאב אזורי. הפסקת חשמל באזור מסוים עשויה להשפיע על מכונות וירטואליות ספציפיות ב-Compute Engine ועל אחד ממופעי מסד הנתונים של Cloud SQL. אבל האפליקציה נשארת זמינה ומגיבה, כי המכונות הווירטואליות נמצאות בקבוצות אזוריות של מכונות מנוהלות ומסד הנתונים של Cloud SQL מוגדר לזמינות גבוהה. קבוצות ה-MIG מבטיחות שמכונות וירטואליות חדשות נוצרות באופן אוטומטי כדי לשמור על המספר המינימלי של מכונות וירטואליות שהוגדר. אם מכונת מסד הנתונים הראשית של Cloud SQL מושפעת מהפסקת חשמל באזור, Cloud SQL מבצע מעבר לגיבוי (failover) באופן אוטומטי למכונה במצב המתנה באזור השני. אחרי ש-Google תפתור את הבעיה, תצטרכו לוודא שהאפליקציה פועלת כמצופה בכל האזורים שבהם היא נפרסה.
אם יש הפסקת חשמל בשני האזורים בארכיטקטורה הזו, האפליקציה לא תהיה זמינה. מאזן העומסים ממשיך להיות זמין אלא אם מתרחש שיבוש ברמה האזורית. עם זאת, מאזן העומסים לא יכול להפיץ את התנועה כי אין שרתי בק-אנד זמינים. אם מתרחש הפסקת חשמל בכמה אזורים או באזור מסוים, צריך לחכות ש-Google תפתור את הבעיה, ואז לוודא שהאפליקציה פועלת כצפוי.
בקטעים הבאים מוצגות אפשרויות ארכיטקטוניות להגנה על האפליקציה מפני הפסקות זמניות בשירות בכמה אזורים והפסקות זמניות בשירות באזור מסוים.
פריסה בכמה אזורים עם איזון עומסים אזורי
בפריסה של אזור יחיד או של מספר אזורים, אם מתרחשת הפסקה זמנית בשירות באזור, האפליקציה לא יכולה לטפל בבקשות עד שהבעיה תיפתר. כדי להגן על האפליקציה מפני הפסקות חשמל באזור מסוים, אפשר לפזר את Google Cloudהמשאבים בין שני אזורים או יותר.
התרשים הבא מציג ארכיטקטורה עם זמינות גבוהה בין אזורים, שבה הרכיבים בכל שכבה של מחסנית האפליקציות מפוזרים על פני כמה אזורים:
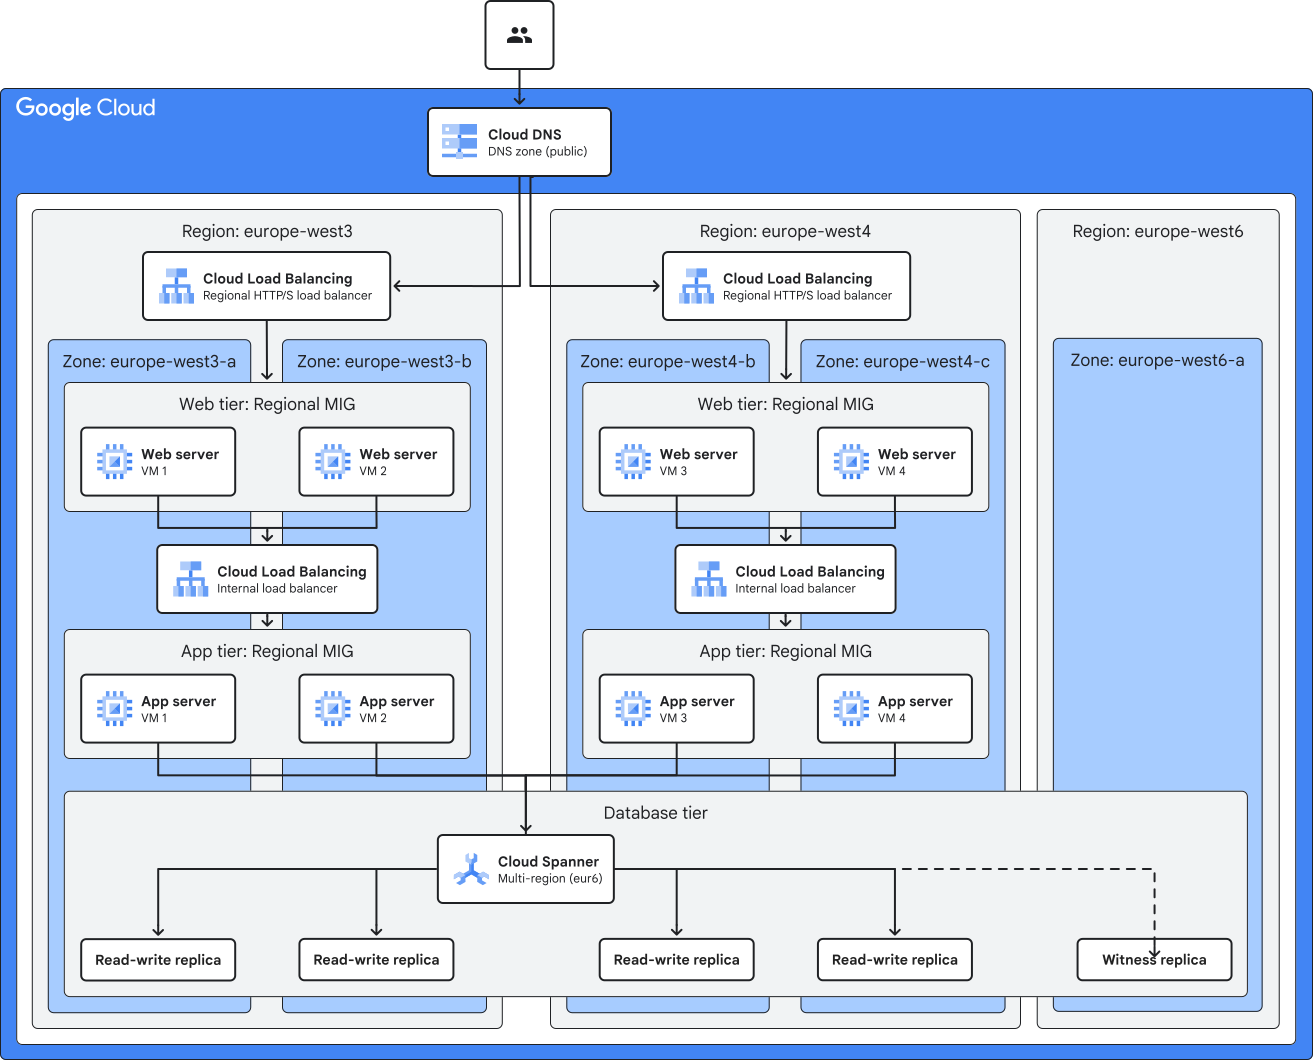
כפי שמוצג בתרשים הקודם, הארכיטקטורה לדוגמה הזו כוללת את הרכיבים הבאים:
- תחום DNS ציבורי ב-Cloud DNS עם מדיניות ניתוב שמפנה תעבורה לשני Google Cloud אזורים.
- מאזן עומסים חיצוני אזורי של אפליקציות (ALB) בכל אזור כדי לקבל בקשות ממשתמשים ולהגיב להן.
- הבק-אנד של כל מאזן עומסים חיצוני אזורי של אפליקציות (ALB) הוא MIG אזורי. כל קבוצת MIG מכילה שתי מכונות וירטואליות של Compute Engine באזורים שונים. כל אחת מהמכונות הווירטואליות האלה מארחת מופע של שרת אינטרנט.
- מאזן עומסי רשת פנימי אזורי להעברת סיגנל ללא שינוי בכל אזור מטפל בתקשורת בין שרתי האינטרנט לבין שרתי האפליקציות.
- זוג שני של קבוצות אזוריות של MIG משמש כקצה עורפי למאזני עומסים פנימיים. כל קבוצת MIG מכילה שתי מכונות וירטואליות של Compute Engine באזורים שונים. כל מכונה וירטואלית מארחת מופע של שרת אפליקציות.
- האפליקציה כותבת נתונים למופע Spanner עם מספר אזורים וקוראת ממנו נתונים. ההגדרה של אזור גיאוגרפי נרחב שמשמשת בארכיטקטורה הזו (
eur6) כוללת ארבעה עותקים משוכפלים לקריאה ולכתיבה. ההעתקים לקריאה ולכתיבה מוקצים באופן שווה בשני אזורים ובאזורים נפרדים. ההגדרה של Spanner במספר אזורים כוללת גם עותק משני של עֵד באזור שלישי.
זמינות מצטברת: פריסה במספר אזורים עם איזון עומסים אזורי
בפריסה במספר אזורים שמוצגת בתרשים הקודם, מאזני העומסים והמכונות הווירטואליות מוקצים באופן מיותר בשני אזורים. אזור ה-DNS הוא משאב גלובלי, ומופע Spanner הוא משאב מרובה אזורים.
כדי לחשב את הזמינות הכוללת של ה Google Cloudתשתית שמוצגת בארכיטקטורה הזו, קודם צריך לחשב את הזמינות הכוללת של המשאבים בכל אזור, ואז להתייחס למשאבים שמשתרעים על פני כמה אזורים. כך עושים זאת:
- חישוב הזמינות הכוללת של משאבי התשתית לכל אזור, כלומר לא כולל משאבי DNS ומסדי נתונים:
משאב והסכם רמת שירות (SLA) הסכם רמת שירות (SLA) מאזן עומסים חיצוניים 99.99% שכבת האינטרנט: מכונות וירטואליות של Compute Engine בתחומים נפרדים 99.99% מאזן עומסים פנימיים 99.99% שכבת האפליקציה: מכונות וירטואליות של Compute Engine בתחומים נפרדים 99.99% זמינות מצטברת לכל אזור: 0.9999 x 0.9999 x 0.9999 x 0.9999 = 99.96%
חישוב הזמינות הכוללת של משאבי התשתית, תוך התחשבות ביתירות הכשל של מאזני העומסים ושל המכונות הווירטואליות ב-Compute Engine באזורים הכפולים.
הזמינות התיאורטית היא 1-(1-0.9996)(1-0.9996) = 99.999984%. עם זאת, הזמינות בפועל שאתם יכולים לצפות לה מוגבלת לזמינות היעד לפריסות מרובות אזורים, שהיא 99.999%.
חישוב הזמינות הכוללת של כל משאבי התשתית, כולל משאבי Cloud DNS ו-Spanner:
- זמינות מצטברת: 0.99999 x 1 x 0.99999 = 99.998%
- זמן ההשבתה החודשי המקסימלי המשוער: כ-52 שניות
החישוב הזה מתייחס רק למשאבי התשתית שמוצגים בדיאגרמת הארכיטקטורה שלמעלה. כדי להעריך את הזמינות של אפליקציה ב- Google Cloud, צריך להביא בחשבון גם גורמים אחרים, כמו:
- העיצוב הפנימי של האפליקציה
- תהליכי ה-DevOps והכלים שמשמשים לפיתוח, לפריסה ולתחזוקה של האפליקציה, קשרי התלות שלה והתשתית של Google Cloud
מידע נוסף זמין במאמר גורמים שמשפיעים על מהימנות האפליקציה.
ההשפעות של הפסקות זמניות בשירות והנחיות לשחזור
אם רכיב כלשהו בפריסה הזו בכמה אזורים נכשל, אבל יש לפחות רכיב אחד מתפקד עם קיבולת מספקת בכל רמה, האפליקציה ממשיכה לפעול. לדוגמה, אם מופע של שרת אינטרנט נכשל, מאזן העומסים החיצוני האזורי של האפליקציות מעביר את בקשות המשתמשים למופעים אחרים של שרת האינטרנט באזור. באופן דומה, אם אחת מהמכונות של שרת האפליקציות קורסת, מאזני העומסים הפנימיים שולחים בקשות למכונות האחרות של שרת האפליקציות. אם אחת מהמכונות הווירטואליות קורסת, קבוצות ה-MIG מוודאות שמכונות וירטואליות חדשות נוצרות באופן אוטומטי כדי לשמור על המספר המינימלי של מכונות וירטואליות שהוגדר.
הפסקת שירות באזור אחד לא משפיעה על מאזני העומסים, כי הם משאבים אזוריים ועמידים להפסקות שירות באזורים. יכול להיות שהפסקת חשמל באזור תשפיע על מכונות וירטואליות ספציפיות ב-Compute Engine. אבל מכונות השרתים של שרת האינטרנט ושרת היישומים ממשיכות להיות זמינות, כי המכונות הווירטואליות הן חלק מקבוצות MIG אזוריות. קבוצות ה-MIG מוודאות שמכונות וירטואליות חדשות נוצרות באופן אוטומטי כדי לשמור על המספר המינימלי של מכונות וירטואליות שהוגדר. מכונת Spanner בארכיטקטורה הזו משתמשת בהגדרה במספר אזורים, ולכן היא עמידה להפסקות חשמל באזורים.
מידע על האופן שבו שכפול במספר אזורים פועל ב-Spanner זמין במאמרים הגדרות אזוריות והגדרות במספר אזורים ו הסבר על הגדרות של Spanner במספר אזורים.
בתרשים הבא מוצגת אותה ארכיטקטורה במספר אזורים כמו בתרשים הקודם, וההשפעות של הפסקת שירות באזור יחיד על הזמינות של האפליקציה:
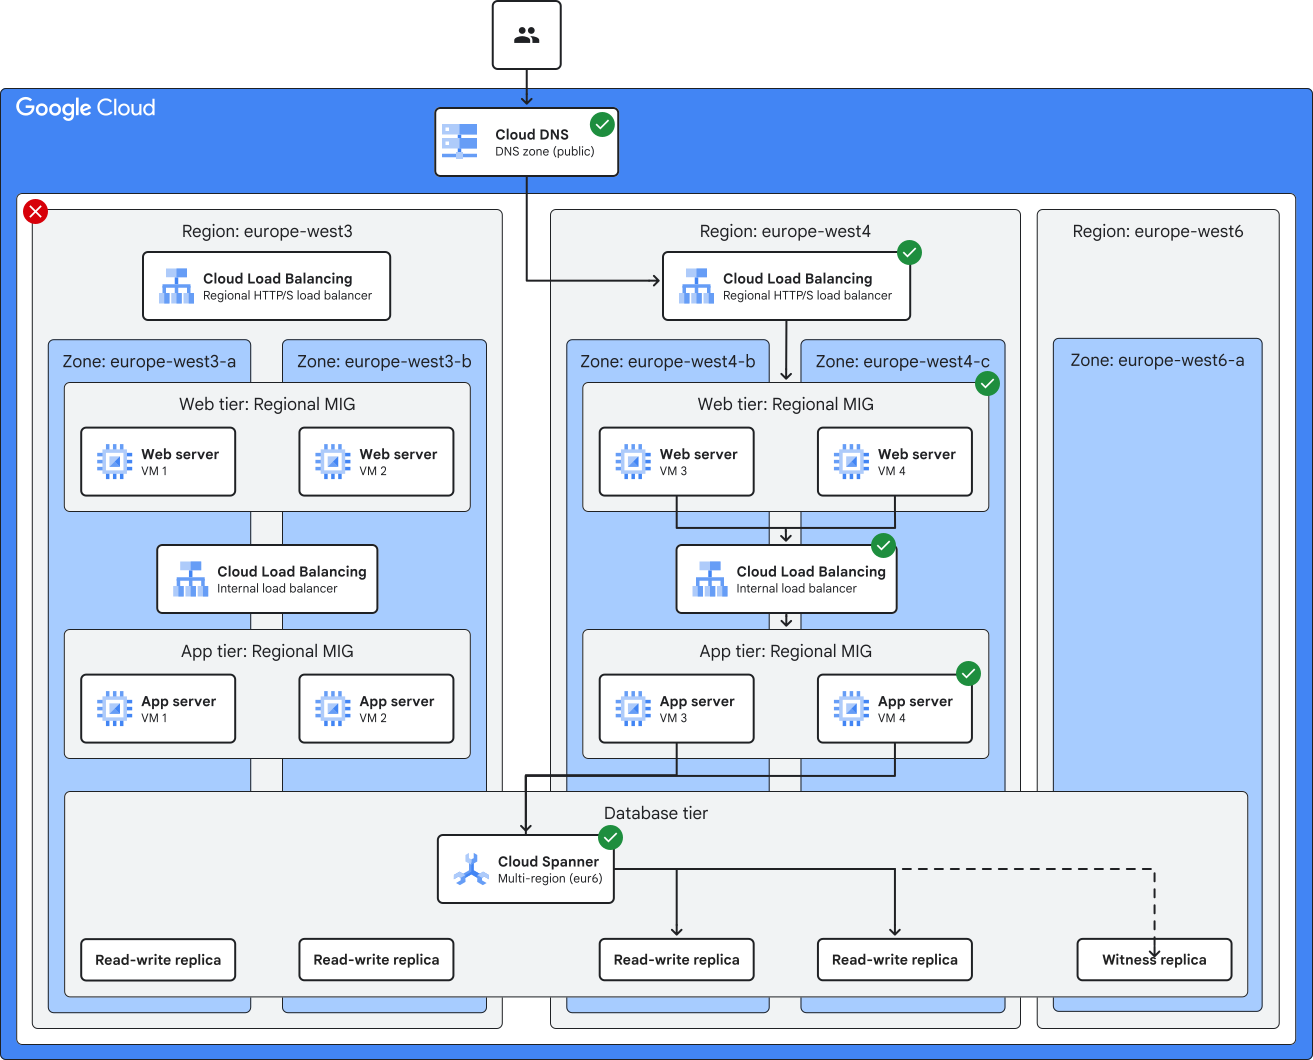
כפי שמוצג בדיאגרמה הקודמת, גם אם מתרחש אירוע הפסקה זמנית בשירות בשני התחומים (zones) בכל אזור, האפליקציה ממשיכה להיות זמינה, כי סטאק אפליקציות עצמאי נפרס בכל אזור. תחום ה-DNS מפנה את בקשות המשתמשים לאזור שלא מושפע מההשבתה. מופע Spanner עם מספר אזורים עמיד בפני הפסקות זמניות בשירות באזור מסוים. אחרי ש-Google תפתור את הבעיה, תצטרכו לוודא שהאפליקציה פועלת כצפוי באזור שבו הייתה הפסקת השירות.
אם יש הפסקות חשמל בשני אזורים בארכיטקטורה הזו, האפליקציה לא זמינה. צריך לחכות ש-Google תפתור את ההפסקות בשירות. לאחר מכן, מוודאים שהאפליקציה פועלת כצפוי בכל האזורים שבהם היא נפרסה.
בפריסות בכמה אזורים, במקום להשתמש במאזני עומסים אזוריים, אפשר להשתמש במאזן עומסים גלובלי. בקטע הבא מוצגת ארכיטקטורת פריסה מרובת אזורים שמשתמשת במאזן עומסים גלובלי, ומתוארים היתרונות והסיכונים של הגישה הזו.
כדי ללמוד איך לתכנן ולהגדיר מדיניות ניתוב של Cloud DNS עם מאזני עומסים אזוריים חיצוניים לשיפור העמידות במספר אזורים, אפשר לעיין במאמר זמינות גבוהה למאזני עומסים אזוריים חיצוניים של אפליקציות.
פריסה בכמה אזורים עם איזון עומסים גלובלי
בתרשים הבא מוצגת פריסה חלופית במספר אזורים שבה נעשה שימוש במאזן עומסים גלובלי במקום במאזני עומסים אזוריים:
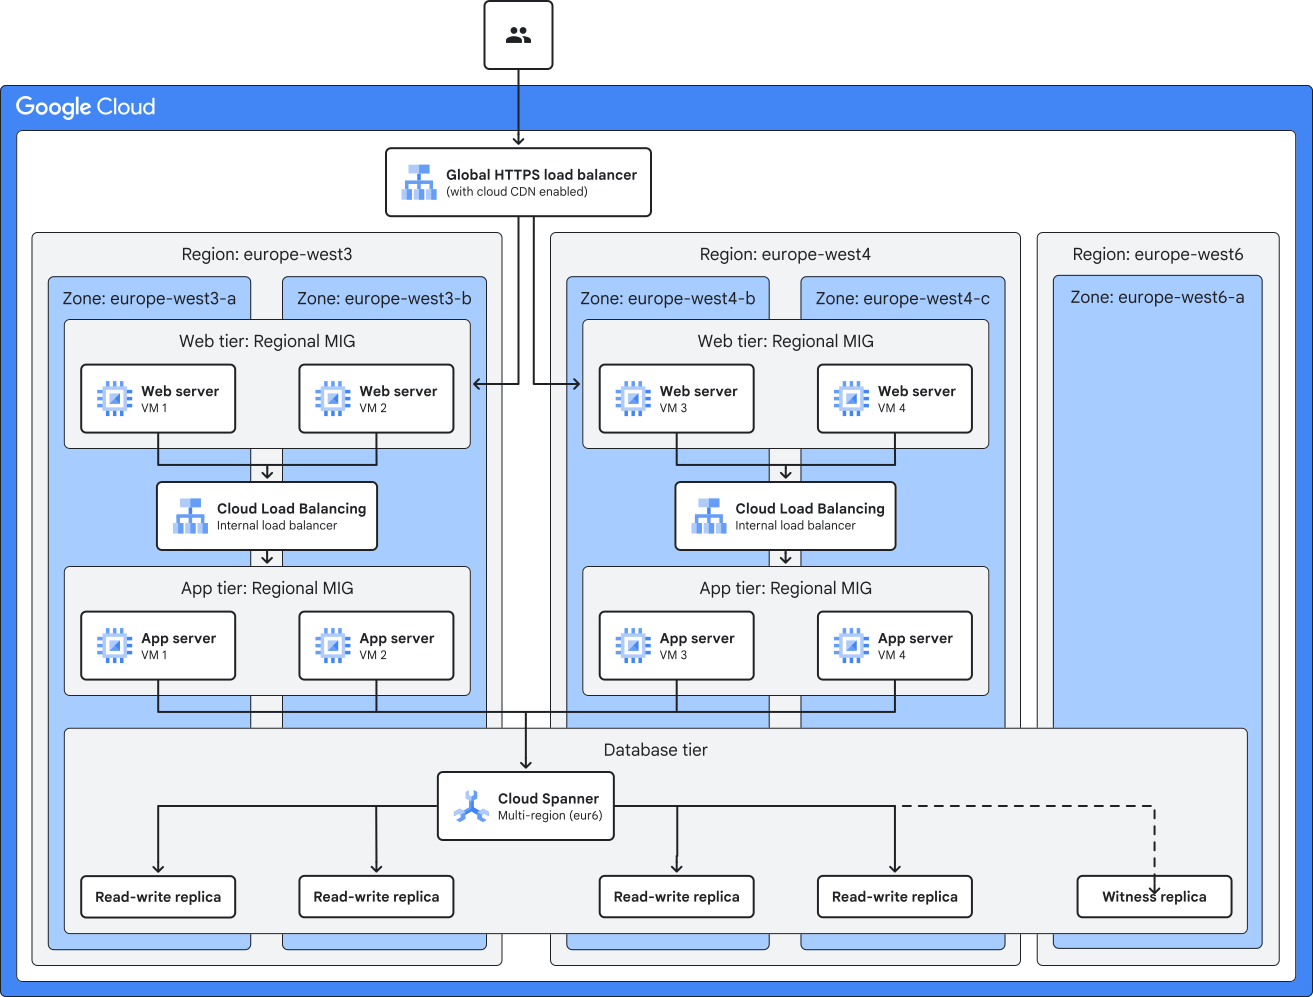
כפי שמוצג בתרשים הקודם, בארכיטקטורה הזו נעשה שימוש במאזן עומסים גלובלי-חיצוני של אפליקציות (עם Cloud CDN מופעל) כדי לקבל בקשות ממשתמשים ולהגיב להן. כל כלל העברה של מאזן העומסים משתמש בכתובת IP חיצונית אחת, ולא צריך להגדיר רשומת DNS נפרדת לכל אזור. הבק-אנד של מאזן העומסים הגלובלי החיצוני של האפליקציות מורכב משתי קבוצות אזוריות של מכונות מנוהלות (MIG). מאזן העומסים מנתב את הבקשות לאזור שהכי קרוב למשתמשים.
כל שאר הרכיבים בארכיטקטורה הזו זהים לארכיטקטורה שמוצגת ב פריסה במספר אזורים עם איזון עומסים אזורי.
יתרונות וסיכונים של איזון עומסים גלובלי לפריסות במספר אזורים
כדי לאזן עומסים של תנועה חיצונית לאפליקציה שמפוזרת על פני כמה אזורים, אפשר להשתמש במאזן עומסים גלובלי או בכמה מאזני עומסים אזוריים.
אלה היתרונות של ארכיטקטורה שמשתמשת במאזן עומסים גלובלי:
- אתם צריכים לנהל רק איזון עומסים אחד.
- מאזני עומסים גלובליים משתמשים בכתובת IP אחת מסוג anycast כדי לספק איזון עומסים בין Google Cloud אזורים.
- מאזני עומסים גלובליים עמידים להפסקות חשמל באזור, ומספקים מעבר אוטומטי לגיבוי בין אזורים.
- מאזני עומסים גלובליים תומכים בתכונות הבאות, שיכולות לעזור לשפר את המהימנות של הפריסות:
- שמירה במטמון קצה באמצעות Cloud CDN
- אפשרות להשתמש בקטגוריות של Cloud Storage עם עמידות גבוהה בתור בק-אנד
- כללי מדיניות האבטחה של Google Cloud Armor
אלה הסיכונים בארכיטקטורה שמשתמשת במאזן עומסים גלובלי:
- שינוי שגוי בהגדרות של מאזן העומסים הגלובלי עלול לגרום לכך שהאפליקציה לא תהיה זמינה למשתמשים. לדוגמה, אם במהלך עדכון של קצה קדמי של מאזן העומסים הגלובלי, מחקתם בטעות כלל העברה, מאזן העומסים יפסיק לקבל בקשות ממשתמשים. ההשפעה של הסיכון הזה נמוכה יותר במקרה של ארכיטקטורה מרובת אזורים שמשתמשת במאזני עומסים אזוריים, כי גם אם מאזן העומסים האזורי באחד האזורים מושפע משגיאת הגדרה, מאזני העומסים באזורים האחרים ממשיכים לפעול.
- הפסקת פעילות בתשתית שמשפיעה על משאבים גלובליים עלולה לגרום לכך שמאזן העומסים הגלובלי לא יהיה זמין.
כדי למזער את הסיכונים האלה, צריך לנהל את השינויים ב-מאזן עומסים גלובלי בזהירות, וכדאי להשתמש בחלופות גיבוי מרובות שכבות כשזה אפשרי. מידע נוסף מופיע במאמר המלצות לניהול הסיכון של הפסקות זמניות בשירותים של משאבים גלובליים.
זמינות מצטברת: פריסה במספר אזורים עם איזון עומסים גלובלי
בפריסה במספר אזורים שמוצגת בתרשים הקודם, המכונות הווירטואליות ומאזני העומסים הפנימיים נפרסים באופן מיותר בשני אזורים. מאזן העומסים החיצוני הוא משאב גלובלי, ומופע Spanner הוא משאב רב-אזורי.
כדי לחשב את הזמינות הכוללת של הפריסה הזו, קודם מחשבים את הזמינות הכוללת של המשאבים בכל אזור, ואז מתייחסים למשאבים שמשתרעים על פני כמה אזורים.
- חישוב הזמינות הכוללת של משאבי התשתית לכל אזור, לא כולל מאזן העומסים החיצוני ומסד הנתונים:
משאב הסכם רמת שירות (SLA) שכבת האינטרנט: מכונות וירטואליות של Compute Engine בתחומים נפרדים 99.99% מאזן עומסים פנימיים 99.99% שכבת האפליקציה: מכונות וירטואליות של Compute Engine בתחומים נפרדים 99.99% זמינות מצטברת לכל אזור: 0.9999 x 0.9999 x 0.9999 = 99.97%
חישוב הזמינות הכוללת של משאבי התשתית, תוך התחשבות ביתירות הכשל של מאזן העומסים הפנימי ושל המכונות הווירטואליות ב-Compute Engine באזורים הכפולים.
הזמינות התיאורטית היא 1-(1-0.9997)(1-0.9997) = 99.999991%. עם זאת, הזמינות בפועל שאתם יכולים לצפות לה מוגבלת לזמינות היעד לפריסות מרובות אזורים, שהיא 99.999%.
חישוב הזמינות הכוללת של כל משאבי התשתית, כולל מאזן העומסים הגלובלי ומשאבי Spanner:
- זמינות מצטברת: 0.99999 x 0.9999 x 0.99999 = 99.988%
- זמן ההשבתה החודשי המקסימלי המשוער: כ-5 דקות ו-11 שניות
החישוב הזה מתייחס רק למשאבי התשתית שמוצגים בדיאגרמת הארכיטקטורה שלמעלה. כדי להעריך את הזמינות של אפליקציה ב- Google Cloud, צריך להביא בחשבון גם גורמים אחרים, כמו:
- העיצוב הפנימי של האפליקציה
- תהליכי ה-DevOps והכלים שמשמשים לפיתוח, לפריסה ולתחזוקה של האפליקציה, קשרי התלות שלה והתשתית של Google Cloud
מידע נוסף זמין במאמר גורמים שמשפיעים על מהימנות האפליקציה.
ההשפעות של הפסקות זמניות בשירות והנחיות לשחזור
אם רכיב כלשהו בארכיטקטורה הזו נכשל, האפליקציה ממשיכה לפעול אם קיים לפחות רכיב אחד בכל שכבה עם קיבולת מספקת. לדוגמה, אם מופעלת מכונת וירטואלית של שרת אינטרנט, מאזן העומסים החיצוני הגלובלי של האפליקציות מעביר את בקשות המשתמשים למכונות וירטואליות אחרות של שרת האינטרנט. אם מופע של שרת אפליקציות קורס, מאזני העומסים הפנימיים שולחים את הבקשות למופעים אחרים של שרת האפליקציות. אם אחת מהמכונות הווירטואליות קורסת, קבוצות ה-MIG מוודאות שמכונות וירטואליות חדשות נוצרות באופן אוטומטי כדי לשמור על המספר המינימלי של מכונות וירטואליות שהוגדר.
אם מתרחשת הפסקה זמנית בשירות באחד מהתחומים באזור כלשהו, מאזן העומסים לא מושפע. מאזן העומסים הגלובלי החיצוני של אפליקציות עמיד להפסקות חשמל באזורים ובאזורי זמינות. מאזני העומסים הפנימיים הם משאבים אזוריים, ולכן הם עמידים להפסקות זמניות בשירות באזור מסוים. הפסקת חשמל באזור מסוים עלולה להשפיע על מכונות וירטואליות ספציפיות ב-Compute Engine. אבל שרתי האינטרנט ושרתי האפליקציות נשארים זמינים, כי המכונות הווירטואליות הן חלק מקבוצות MIG אזוריות. קבוצות ה-MIG מבטיחות שמכונות וירטואליות חדשות נוצרות באופן אוטומטי כדי לשמור על המספר המינימלי של מכונות וירטואליות שהוגדר. מופע Spanner בארכיטקטורה הזו משתמש בהגדרה של מספר אזורים, שמאפשרת עמידות להפסקות חשמל באזורים.
בתרשים הבא מוצגת אותה ארכיטקטורה במספר אזורים כמו בתרשים הקודם, וההשפעות של הפסקת שירות באזור יחיד על הזמינות של האפליקציה:
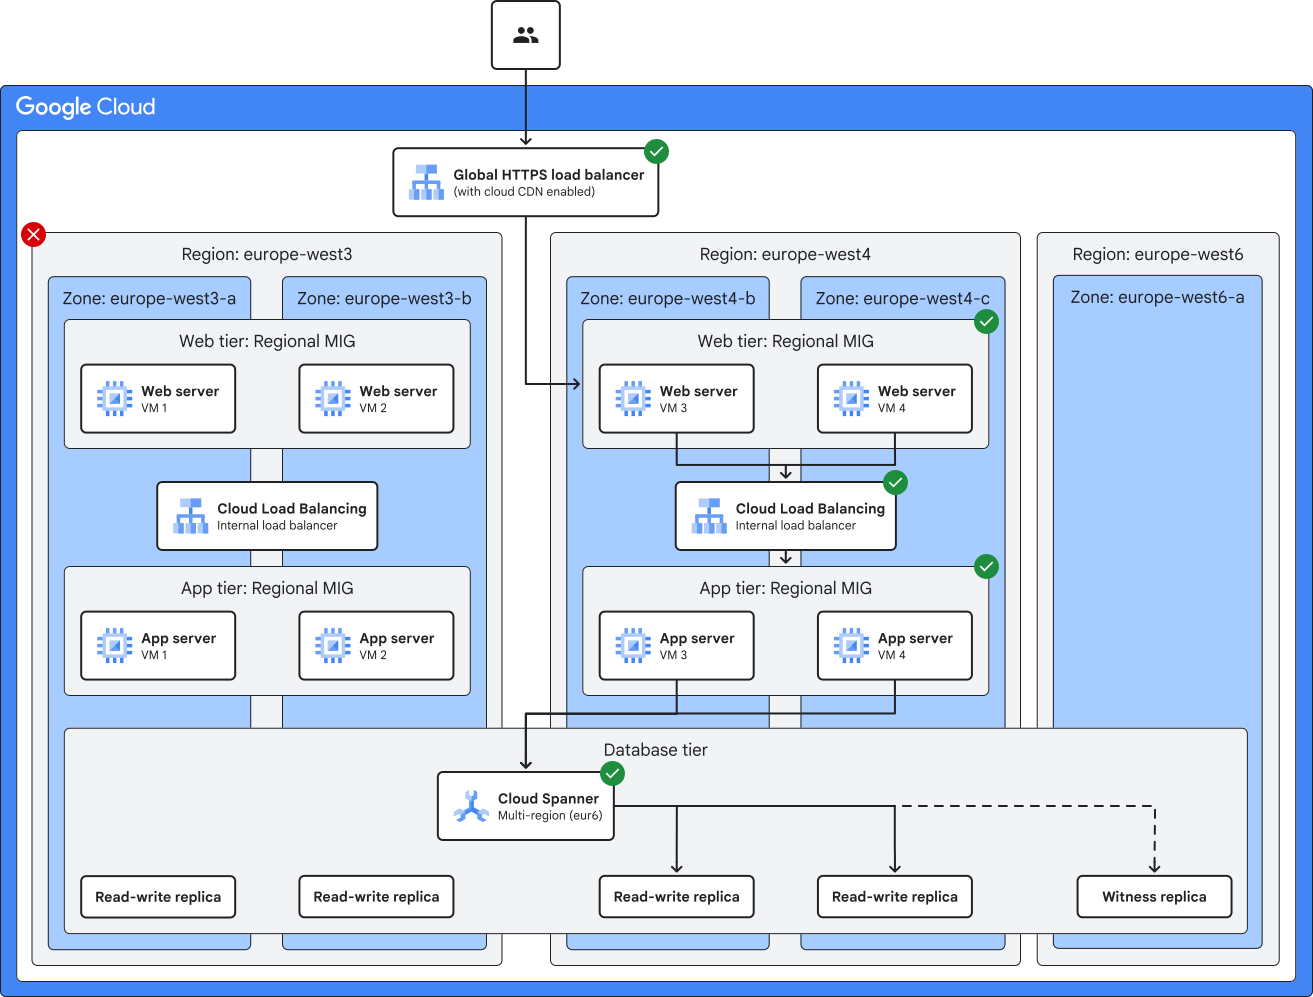
כפי שמוצג בדיאגרמה הקודמת, גם אם מתרחש אירוע הפסקה זמנית בשירות בשני התחומים (zones) בכל אזור, האפליקציה ממשיכה להיות זמינה, כי סטאק אפליקציות עצמאי נפרס בכל אזור. מאזן העומסים הגלובלי החיצוני של האפליקציות (ALB) מנתב את בקשות המשתמשים לאפליקציה באזור שלא הושפע מההשבתה. מופע Spanner במספר אזורים עמיד להפסקות חשמל באזורים. אחרי ש-Google תפתור את ההשבתה, תצטרכו לוודא שהאפליקציה פועלת כצפוי באזור שבו הייתה ההשבתה.
מידע על האופן שבו שכפול במספר אזורים פועל ב-Spanner זמין במאמרים הגדרות אזוריות והגדרות במספר אזורים ו הסבר על הגדרות של Spanner במספר אזורים.
אם יש הפסקות חשמל בשני אזורים בארכיטקטורה הזו, האפליקציה לא זמינה. מאזן העומסים הגלובלי החיצוני של אפליקציות זמין, אבל הוא לא יכול להפיץ תנועה כי אין קצה עורפי זמין. צריך לחכות ש-Google תפתור את ההפסקות בשירות. לאחר מכן, מוודאים שהאפליקציה פועלת כצפוי בכל האזורים שבהם היא נפרסה.
פריסות בכמה אזורים יכולות לעזור להבטיח זמינות גבוהה לאפליקציות העסקיות החשובות ביותר. כדי להבטיח את המשכיות העסקית במהלך אירועי כשל, בנוסף לפריסת האפליקציה בכמה אזורים, צריך לבצע כמה פעולות נוספות. לדוגמה, צריך לבצע תכנון קיבולת כדי לוודא שמוקצה מספיק קיבולת בכל האזורים או שהסיכונים שקשורים להרחבת קנה מידה אוטומטית במקרה חירום מקובלים. בנוסף, אתם צריכים להטמיע שיטות עבודה לתפעול לבדיקות DR, לניהול אירועים, לאימות סטטוס האפליקציה אחרי אירועים ולביצוע רטרוספקטיבות.
כדי להגן מפני הפסקות שירות במאזן עומסים גלובלי ושגיאות בהגדרות, אפשר להטמיע אסטרטגיה אוטומטית של יתירות כשל או עקיפה באמצעות Cloud DNS ומאזני עומסים אזוריים לגיבוי. למידע נוסף, אפשר לעיין במאמר אסטרטגיות למעבר לגיבוי (failover) במאזני עומסים חיצוניים גלובליים של אפליקציות.
-
מידע נוסף על שיקולים ספציפיים לאזור זמין במאמר מיקום גיאוגרפי ואזורים. ↩