


כפי שמתואר במאמר תוכניות לביצוע שאילתות, מהדר SQL הופך הצהרת SQL לתוכנית לביצוע שאילתה, שמשמשת לקבלת תוצאות השאילתה. בדף הזה מתוארות שיטות מומלצות ליצירת הצהרות SQL, כדי לעזור ל-Spanner למצוא תוכניות יעילות להרצה. במדריך [כוונון שאילתות][query_tuning] מוסבר איך לשפר את ביצועי השאילתות.
הצהרות ה-SQL לדוגמה שמוצגות בדף הזה משתמשות בסכימה לדוגמה הבאה:
GoogleSQL
CREATE TABLE Singers (
 SingerId   INT64 NOT NULL,
 FirstName  STRING(1024),
 LastName   STRING(1024),
 SingerInfo BYTES(MAX),
 BirthDate  DATE
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
 SingerId     INT64 NOT NULL,
 AlbumId      INT64 NOT NULL,
 AlbumTitle   STRING(MAX),
 ReleaseDate  DATE
) PRIMARY KEY (SingerId, AlbumId),
INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
למידע נוסף על SQL, קראו את המאמרים תחביר של הצהרות, פונקציות ואופרטורים ומבנה ותחביר לקסיקליים.
PostgreSQL
CREATE TABLE Singers (
 SingerId   BIGINT PRIMARY KEY,
 FirstName  VARCHAR(1024),
 LastName   VARCHAR(1024),
 SingerInfo BYTEA,
 BirthDate  TIMESTAMPTZ
);

CREATE TABLE Albums (
 SingerId        BIGINT NOT NULL,
 AlbumId         BIGINT NOT NULL,
 AlbumTitle      VARCHAR(1024),
 ReleaseDate     DATE,
 PRIMARY KEY(SingerId, AlbumId),
 FOREIGN KEY (SingerId) REFERENCES Singers(SingerId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
מידע נוסף זמין במאמר שפת PostgreSQL ב-Spanner.
שימוש בפרמטרים של שאילתה
Spanner תומך בפרמטרים של שאילתות כדי לשפר את הביצועים ולמנוע הזרקת SQL כששאילתות נוצרות באמצעות קלט של משתמשים. אפשר להשתמש בפרמטרים של שאילתות כתחליפים לביטויים שרירותיים, אבל לא כתחליפים למזהים, לשמות של עמודות, לשמות של טבלאות או לחלקים אחרים של השאילתה.
פרמטרים יכולים להופיע בכל מקום שבו צפוי להופיע ליטרל. אפשר להשתמש באותו שם פרמטר יותר מפעם אחת בהצהרת SQL אחת.
לסיכום, פרמטרים של שאילתות תומכים בהרצת שאילתות בדרכים הבאות:
- תוכניות שעברו אופטימיזציה מראש: שאילתות שמשתמשות בפרמטרים יכולות לפעול מהר יותר בכל הפעלה, כי הפרמטריזציה מקלה על Spanner לשמור במטמון את תוכנית ההפעלה.
- הרכבת שאילתות פשוטה יותר: לא צריך להוסיף תווי בריחה לערכי מחרוזות כשמציינים אותם בפרמטרים של שאילתות. פרמטרים של שאילתות גם מפחיתים את הסיכון לשגיאות תחביר.
- אבטחה: פרמטרים של שאילתות הופכים את השאילתות למאובטחות יותר, ומגנים עליכם מפני מתקפות שונות של הזרקת SQL. ההגנה הזו חשובה במיוחד לשאילתות שאתם יוצרים מקלט של משתמשים.
כדי לשפר את הביצועים, Spanner ממיר ערכים מילוליים שמוגדרים ב-SQL לפרמטרים, אם תוכנית הביצוע האופטימלית של השאילתה לא תלויה בערכים המילוליים הספציפיים. כך Spanner יכול להפחית את זמן האחזור ואת עלויות המעבד (CPU) על ידי שמירה במטמון ושימוש חוזר בתוכנית לביצוע השאילתה. עם זאת, בשיטה הזו לא מקבלים את אותן הגנות מפני הזרקת SQL ואת היתרונות של הרכבת שאילתות פשוטות יותר. השיטה המומלצת היא להשתמש בפרמטרים של שאילתות בקוד האפליקציה.
איך Spanner מריץ שאילתות
ב-Spanner אפשר להריץ שאילתות על מסדי נתונים באמצעות הצהרות SQL הצהרתיות, שמציינות את הנתונים שרוצים לאחזר. כדי להבין איך Spanner משיג את התוצאות, בודקים את תוכנית הביצוע של השאילתה. בתוכנית הרצת השאילתה מוצגת עלות החישוב שמשויכת לכל שלב בשאילתה. בעזרת העלויות האלה, אתם יכולים לנפות באגים בבעיות בביצועי השאילתות ולשפר את השאילתה. מידע נוסף זמין במאמר תוכניות ביצוע של שאילתות.
אפשר לאחזר תוכניות להרצת שאילתות דרך מסוף Google Cloud או דרך ספריות הלקוח.
כדי לקבל תוכנית להרצת שאילתה ספציפית באמצעות מסוףGoogle Cloud , מבצעים את השלבים הבאים:
פותחים את הדף Spanner instances.
בוחרים את השמות של המכונה ומסד הנתונים של Spanner שרוצים לשלוח אליהם שאילתה.
לוחצים על Spanner Studio בחלונית הניווט שמימין.
מקלידים את השאילתה בשדה הטקסט ולוחצים על Run query.
לוחצים על הסבר
. במסוף Google Cloud מוצגת תוכנית הרצה חזותית של השאילתה.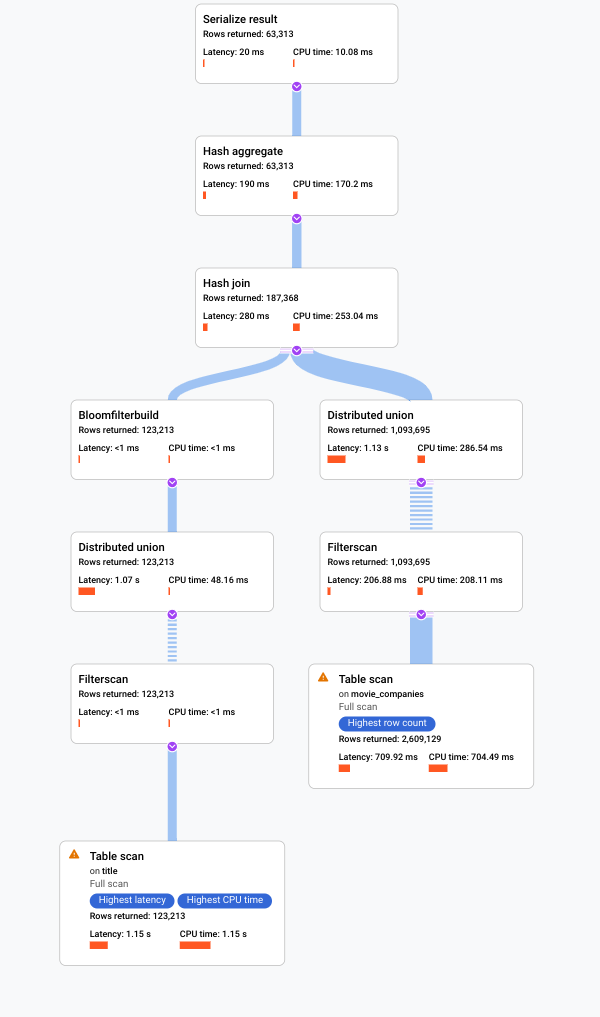
למידע נוסף על האופן שבו אפשר להבין תוכניות לביצוע שאילתה חזותיות ולהשתמש בהן כדי לנפות באגים בשאילתות, ראו כוונון שאילתה באמצעות הכלי להצגה חזותית של תוכנית לביצוע שאילתה.
אתם יכולים גם לראות דוגמאות של תוכניות היסטוריות לביצוע שאילתות, ולהשוות את הביצועים של שאילתות מסוימות לאורך זמן. מידע נוסף זמין במאמר תוכניות דגימה של שאילתות.
שימוש באינדקסים משניים
כמו מסדי נתונים רלציוניים אחרים, Spanner מציע אינדקסים משניים שבהם אפשר להשתמש כדי לאחזר נתונים באמצעות הצהרת SQL או ממשק הקריאה של Spanner. שימוש באינדקס משני בשאילתת SQL מאפשר לכם לציין איך אתם רוצים ש-Spanner יקבל את התוצאות. ציון אינדקס משני יכול לזרז את ביצוע השאילתה.
לדוגמה, נניח שאתם רוצים לאחזר את המזהים של כל הזמרים עם שם משפחה מסוים. אפשר לכתוב שאילתת SQL כזו:
SELECT s.SingerId
FROM Singers AS s
WHERE s.LastName = 'Smith';
השאילתה הזו תחזיר את התוצאות שאתם מצפים להן, אבל יכול להיות שייקח הרבה זמן עד שהתוצאות יוחזרו. התזמון תלוי במספר השורות בטבלה Singers ובמספר השורות שעומדות בתנאי WHERE s.LastName = 'Smith'.
אם אין אינדקס משני שמכיל את העמודה LastName לקריאה, התוכנית לביצוע השאילתה תקרא את כל הטבלה Singers כדי למצוא שורות שתואמות לפרדיקט. קריאת הטבלה כולה נקראת סריקת טבלה מלאה. סריקה מלאה של הטבלה היא דרך יקרה לקבל את התוצאות כשהטבלה מכילה רק אחוז קטן של Singers עם שם המשפחה הזה.
כדי לשפר את הביצועים של השאילתה הזו, אפשר להגדיר אינדקס משני בעמודה של שם המשפחה:
CREATE INDEX SingersByLastName ON Singers (LastName);
מכיוון שהאינדקס המשני SingersByLastName מכיל את עמודת הטבלה שנוסף לה אינדקס LastName ואת עמודת המפתח הראשי SingerId, Spanner יכול לאחזר את כל הנתונים מטבלת האינדקס הקטנה בהרבה, במקום לסרוק את הטבלה המלאה Singers.
בתרחיש הזה, Spanner משתמש באופן אוטומטי באינדקס המשני SingersByLastName בזמן הרצת השאילתה (כל עוד עברו שלושה ימים מאז יצירת מסד הנתונים; ראו הערה לגבי מסדי נתונים חדשים).
עם זאת, מומלץ להורות ל-Spanner באופן מפורש להשתמש באינדקס הזה, על ידי ציון הנחיית אינדקס בסעיף FROM:
GoogleSQL
SELECT s.SingerId
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
אם אתם משתמשים בסכימות עם שם, השתמשו בתחביר הבא לסעיף FROM:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
עכשיו נניח שאתם רוצים לאחזר גם את השם הפרטי של הזמר בנוסף למזהה. למרות שהעמודה FirstName לא כלולה באינדקס, עדיין צריך לציין את הוראת האינדקס כמו קודם:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId, s.FirstName
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
עדיין תיהנו משיפור בביצועים כתוצאה מהשימוש באינדקס, כי Spanner לא צריך לבצע סריקה מלאה של הטבלה כשהוא מריץ את התוכנית לביצוע השאילתה. במקום זאת, היא בוחרת את קבוצת המשנה של השורות שעומדות בתנאי הפרדיקט מהאינדקס SingersByLastName, ואז מבצעת חיפוש במסד הנתונים הטבלאי Singers כדי לאחזר את השם הפרטי רק של קבוצת המשנה הזו של השורות.
אם אתם רוצים ש-Spanner לא יצטרך לאחזר שורות ממסד הנתונים הטבלאי בכלל, אתם יכולים לאחסן עותק של העמודה FirstName באינדקס עצמו:
GoogleSQL
CREATE INDEX SingersByLastName ON Singers (LastName) STORING (FirstName);
PostgreSQL
CREATE INDEX SingersByLastName ON Singers (LastName) INCLUDE (FirstName);
שימוש בסעיף STORING (לניב GoogleSQL) או בסעיף INCLUDE (לניב PostgreSQL) כמו זה כרוך בעלות אחסון נוספת, אבל מספק את היתרונות הבאים:
- שאילתות SQL שמשתמשות באינדקס ובוחרות עמודות שמאוחסנות בסעיף
STORINGאוINCLUDEלא דורשות צירוף נוסף למסד הנתונים הטבלאי. - קריאות שמשתמשות באינדקס יכולות לקרוא עמודות שמאוחסנות בסעיף
STORINGאוINCLUDE.
הדוגמאות הקודמות ממחישות איך אינדקסים משניים יכולים להאיץ שאילתות, כשאפשר לזהות במהירות את השורות שנבחרו על ידי משפט ה-WHERE של שאילתה באמצעות האינדקס המשני.
תרחיש נוסף שבו אינדקסים משניים יכולים לשפר את הביצועים הוא בשאילתות מסוימות שמחזירות תוצאות מסודרות. לדוגמה, נניח שאתם רוצים לאחזר את כל שמות האלבומים ותאריכי ההשקה שלהם בסדר עולה של תאריך ההשקה ובסדר יורד של שם האלבום. אפשר לכתוב שאילתת SQL כזאת:
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
בלי אינדקס משני, השאילתה הזו דורשת שלב מיון שעלול להיות יקר בתוכנית הביצוע. כדי להאיץ את ביצוע השאילתה, אפשר להגדיר את האינדקס המשני הבא:
CREATE INDEX AlbumsByReleaseDateTitleDesc on Albums (ReleaseDate, AlbumTitle DESC);
לאחר מכן, משכתבים את השאילתה כדי להשתמש באינדקס המשני:
GoogleSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums@{FORCE_INDEX=AlbumsByReleaseDateTitleDesc} AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
PostgreSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums /*@ FORCE_INDEX=AlbumsByReleaseDateTitleDesc */ AS s
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
השאילתה והגדרת האינדקס האלה עומדות בשני הקריטריונים הבאים:
- כדי להסיר את שלב המיון, צריך לוודא שרשימת העמודות בסעיף
ORDER BYהיא תחילית של רשימת מפתחות האינדקס. - כדי להימנע מהצטרפות חזרה ממסד הנתונים הטבלאי כדי לאחזר עמודות חסרות, ודאו שהאינדקס מכסה את כל העמודות בטבלה שבהן השאילתה משתמשת.
למרות שאינדקסים משניים יכולים להאיץ שאילתות נפוצות, הוספת אינדקסים משניים יכולה להוסיף זמן אחזור לפעולות ה-commit, כי כל אינדקס משני בדרך כלל דורש מעורבות של צומת נוסף בכל commit. ברוב עומסי העבודה, כמה אינדקסים משניים זה בסדר. עם זאת, כדאי לשקול אם זמן האחזור של הקריאה או הכתיבה חשוב יותר, ולשקול אילו פעולות הן הקריטיות ביותר לעומס העבודה. כדאי לבצע בדיקת ביצועים של עומס העבודה כדי לוודא שהוא פועל כצפוי.
למידע נוסף על אינדקסים משניים, קראו את המאמר אינדקסים משניים.
אופטימיזציה של חיפושי מפתחות טווח
שימוש נפוץ בשאילתת SQL הוא קריאת כמה שורות מ-Spanner על סמך רשימה של מפתחות ידועים.
השיטות המומלצות הבאות יעזרו לכם לכתוב שאילתות יעילות כשאתם מאחזרים נתונים לפי טווח של מפתחות:
אם רשימת המפתחות היא דלילה ולא סמוכה, השתמשו בפרמטרים של שאילתה וב-
UNNESTכדי ליצור את השאילתה.לדוגמה, אם רשימת המפתחות היא
{1, 5, 1000}, כותבים את השאילתה כך:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST (@KeyList)
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST ($1)
הערות:
האופרטור UNNEST של המערך משטח מערך קלט לשורות של רכיבים.
פרמטר השאילתה, שהוא
@KeyListב-GoogleSQL ו-$1ב-PostgreSQL, יכול להאיץ את השאילתה, כפי שמוסבר בשיטה המומלצת הקודמת.עדיף להשתמש ב-UNNEST עם פרמטר אחד, ולא ב-OR עם כמה פרמטרים.
אם רשימת המפתחות סמוכה ונמצאת בטווח, מציינים את הגבולות התחתונים והעליונים של טווח המפתחות בסעיף
WHERE.לדוגמה, אם רשימת המפתחות היא
{1,2,3,4,5}, בונים את השאילתה כך:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN @min AND @max
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN $1 AND $2
השאילתה הזו יעילה יותר רק אם המפתחות בטווח המפתחות סמוכים. במילים אחרות, אם רשימת המפתחות היא
{1, 5, 1000}, אל תציינו את הגבולות התחתונים והעליונים כמו בשאילתה הקודמת, כי השאילתה שתתקבל תסרוק כל ערך בין 1 ל-1,000.
אופטימיזציה של צירופים
פעולות JOIN יכולות להיות יקרות כי הן יכולות להגדיל משמעותית את מספר השורות שהשאילתה צריכה לסרוק, וכתוצאה מכך השאילתות איטיות יותר. בנוסף לשיטות שאתם רגילים להשתמש בהן במסדי נתונים רלציוניים אחרים כדי לבצע אופטימיזציה של שאילתות JOIN, ריכזנו כאן כמה שיטות מומלצות לביצוע יעיל יותר של JOIN כשמשתמשים ב-Spanner SQL:
- אם אפשר, כדאי לאחד נתונים בטבלאות משולבות לפי מפתח ראשי. לדוגמה:
SELECT s.FirstName, a.ReleaseDate
FROM Singers AS s JOIN Albums AS a ON s.SingerId = a.SingerId;
The rows in the interleaved table `Albums` are physically
stored in the same splits as the parent row in `Singers`, as discussed in
[Schema and Data Model](/spanner/docs/schema-and-data-model). Therefore, joins can be
completed locally without sending lots of data across the network.
אם אתם רוצים לאלץ את סדר הצירוף, השתמשו בהוראת הצירוף. לדוגמה:
GoogleSQL
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
PostgreSQL
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
ההוראה
FORCE_JOIN_ORDERאומרת ל-Spanner להשתמש בסדר הצירוף שצוין בשאילתה (כלומרSingers JOIN AlbumsולאAlbums JOIN Singers). התוצאות שמוחזרות זהות, בלי קשר לסדר ש-Spanner בוחר. עם זאת, יכול להיות שתרצו להשתמש בהוראת הצירוף הזו אם תבחינו בתוכנית לביצוע השאילתה ש-Spanner שינה את סדר הצירוף וגרם לתוצאות לא רצויות, כמו תוצאות ביניים גדולות יותר, או החמיץ הזדמנויות לחיפוש שורות.אפשר להשתמש בהוראת הצטרפות כדי לבחור הטמעת הצטרפות. כשמשתמשים ב-SQL כדי לשלוח שאילתות לכמה טבלאות, Spanner משתמש באופן אוטומטי בשיטת איחוד (join) שיכולה לייעל את השאילתה. עם זאת, Google ממליצה לבדוק אלגוריתמים שונים של צירוף. בחירת אלגוריתם הצירוף הנכון יכולה לשפר את זמן האחזור, את צריכת הזיכרון או את שניהם. השאילתה הזו מדגימה את התחביר לשימוש בהוראת JOIN עם ההנחיה
JOIN_METHODכדי לבחורHASH JOIN:GoogleSQL
SELECT *
FROM Singers s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON a.SingerId = a.SingerId
PostgreSQL
SELECT *
FROM Singers s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON a.SingerId = a.SingerId
אם אתם משתמשים ב-
HASH JOINאו ב-APPLY JOINויש לכם משפטWHEREשהוא מאוד סלקטיבי בצד אחד של ה-JOIN, הציבו את הטבלה שמפיקה את המספר הקטן ביותר של שורות כטבלה הראשונה במשפטFROMשל הצירוף. המבנה הזה עוזר כי ב-HASH JOIN, Spanner תמיד בוחר את הטבלה בצד שמאל כ-build ואת הטבלה בצד ימין כ-probe. באופן דומה, עבורAPPLY JOIN, Spanner בוחר את הטבלה בצד שמאל כחיצונית ואת הטבלה בצד ימין כפנימית. מידע נוסף על סוגי הצירופים האלה: [Hash join][hash_join] ו-[Apply join][apply_join].בשאילתות שחשובות לעומס העבודה, ציינו את שיטת הצירוף ואת סדר הצירוף היעילים ביותר בהצהרות ה-SQL כדי לשפר את עקביות הביצועים.
אופטימיזציה של שאילתות באמצעות דחיפת פרדיקט של חותמת זמן
דחיפת פרדיקט של חותמת זמן היא שיטה לאופטימיזציה של שאילתות ב-Spanner, שמשפרת את היעילות של שאילתות שמשתמשות בחותמות זמן ובנתונים עם מדיניות אחסון מדורגת לפי גיל. כשמפעילים את האופטימיזציה הזו, פעולות הסינון בעמודות של חותמות הזמן מתבצעות בשלב מוקדם ככל האפשר בתוכנית הביצוע של השאילתה. כך אפשר לצמצם משמעותית את כמות הנתונים שמעובדים ולשפר את הביצועים הכוללים של השאילתות.
באמצעות דחיפת פרדיקט של חותמת זמן, המנוע של מסד הנתונים מנתח את השאילתה ומזהה את המסנן של חותמת הזמן. לאחר מכן הוא "דוחף למטה" את המסנן הזה לשכבת האחסון, כך שרק הנתונים הרלוונטיים על סמך הקריטריונים של חותמת הזמן נקראים מ-SSD. כך מצמצמים את כמות הנתונים שמעובדים ומועברים, והשאילתה מופעלת מהר יותר.
כדי לבצע אופטימיזציה של שאילתות כך שייגשו רק לנתונים שמאוחסנים ב-SSD, צריך לוודא שהתנאים הבאים מתקיימים:
- בשאילתה צריך להפעיל את דחיפת הפרדיקט של חותמת הזמן. למידע נוסף, ראו הנחיות להצהרות ב-GoogleSQL והנחיות להצהרות ב-PostgreSQL.
השאילתה חייבת להשתמש בהגבלה מבוססת-גיל ששווה לגיל שצוין במדיניות זליגת הנתונים או קטנה ממנו (מוגדרת באמצעות האפשרות
ssd_to_hdd_spill_timespanבהצהרת ה-DDL שלCREATE LOCALITY GROUPאוALTER LOCALITY GROUP). למידע נוסף, קראו את המאמרים הצהרותLOCALITY GROUPב-GoogleSQL והצהרותLOCALITY GROUPב-PostgreSQL.העמודה שמסוננת בשאילתה חייבת להיות עמודה של חותמת זמן שמכילה את חותמת הזמן של ה-commit. במאמרים חותמות זמן של השמירה ב-GoogleSQL וחותמות זמן של השמירה ב-PostgreSQL מוסבר איך יוצרים עמודה של חותמת זמן של השמירה. צריך לעדכן את העמודות האלה לצד העמודה של חותמת הזמן, והן צריכות להיות באותה קבוצת מיקום, שיש לה מדיניות אחסון מדורגת לפי גיל.
אם בשורה מסוימת חלק מהעמודות שמופיעות בשאילתה נמצאות ב-SSD וחלק מהעמודות נמצאות ב-HDD (כי העמודות עודכנו בזמנים שונים והועברו ל-HDD בזמנים שונים), יכול להיות שהביצועים של השאילתה יהיו פחות טובים כשתשתמשו ברמז. הסיבה לכך היא שהשאילתה צריכה למלא נתונים משכבות האחסון השונות. כתוצאה מהשימוש ברמז, Spanner מיישן נתונים ברמת התא הבודד (רמת פירוט של שורה ועמודה) על סמך חותמת הזמן של השמירה של כל תא, מה שמאט את השאילתה. כדי למנוע את הבעיה הזו, חשוב לעדכן באופן קבוע את כל העמודות שמתבצעת בהן שאילתה באמצעות שיטת האופטימיזציה הזו באותה עסקה, כך שכל העמודות ישתפו את אותה חותמת זמן של commit וייהנו מהאופטימיזציה.
כדי להפעיל דחיפת פרדיקט של חותמת זמן ברמת ההצהרה, משתמשים ברמז להצהרה בשאילתה. לדוגמה:
GoogleSQL
@{allow_timestamp_predicate_pushdown=TRUE}
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 12 HOUR);
PostgreSQL
/*@allow_timestamp_predicate_pushdown=TRUE*/
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > CURRENT_TIMESTAMP - INTERVAL '12 hours';
הימנעו מקריאות גדולות בתוך עסקאות קריאה-כתיבה
עסקאות קריאה-כתיבה מאפשרות רצף של אפס או יותר קריאות או שאילתות SQL, ויכולות לכלול קבוצה של מוטציות, לפני קריאה ל-commit. כדי לשמור על עקביות הנתונים, Spanner רוכש נעילות בזמן קריאה וכתיבה של שורות בטבלאות ובאינדקסים. למידע נוסף על נעילה, ראו מחזור החיים של קריאות וכתיבות.
בגלל האופן שבו הנעילה פועלת ב-Spanner, כשמבצעים קריאה או שאילתת SQL שקוראת מספר גדול של שורות (לדוגמה SELECT * FROM
Singers), טרנזקציות אחרות לא יכולות לכתוב בשורות שקראתם עד שהטרנזקציה שלכם תבוצע או תבוטל.
בנוסף, מכיוון שהטרנזקציה מעבדת מספר גדול של שורות, סביר להניח שהיא תימשך זמן רב יותר מטרנזקציה שקוראת טווח קטן בהרבה של שורות (לדוגמה SELECT LastName FROM Singers WHERE SingerId = 7), מה שמחמיר את הבעיה ומפחית את קצב העברת הנתונים במערכת.
לכן, נסו להימנע מקריאות גדולות (לדוגמה, סריקות טבלה מלאות או פעולות איחוד מסיביות) בטרנזקציות, אלא אם אתם מוכנים לקבל תפוקת כתיבה נמוכה יותר.
במקרים מסוימים, התבנית הבאה יכולה להניב תוצאות טובות יותר:
- מבצעים את הקריאות הגדולות בתוך עסקה לקריאה בלבד. עסקאות לקריאה בלבד מאפשרות תפוקה מצטברת גבוהה יותר כי הן לא משתמשות בנעילות.
- אופציונלי: מבצעים את העיבוד הנדרש בנתונים שקראתם.
- מתחילים טרנזקציית קריאה-כתיבה.
- מוודאים שהערכים של השורות הקריטיות לא השתנו מאז שביצעתם את העסקה לקריאה בלבד בשלב 1.
- אם השורות השתנו, מבטלים את העסקה ומתחילים שוב משלב 1.
- אם הכול נראה תקין, מבצעים את השינויים.
אחת הדרכים להימנע מקריאות גדולות בעסקאות קריאה-כתיבה היא לבדוק את תוכניות הביצוע שהשאילתות יוצרות.
שימוש ב-ORDER BY כדי לוודא שהתוצאות של שאילתת ה-SQL מסודרות
אם אתם מצפים לסדר מסוים בתוצאות של שאילתת SELECT, צריך לכלול במפורש את הסעיף ORDER BY. לדוגמה, אם רוצים להציג את כל הזמרים לפי סדר המפתח הראשי, משתמשים בשאילתה הזו:
SELECT * FROM
Singers
ORDER BY SingerId;
Spanner מבטיח את סדר התוצאות רק אם הסעיף ORDER BY מופיע בשאילתה. במילים אחרות, נסו להריץ את השאילתה הזו בלי ORDER
BY:
SELECT * FROM Singers;
Spanner לא מבטיח שתוצאות השאילתה הזו יהיו בסדר של המפתח הראשי. בנוסף, סדר התוצאות יכול להשתנות בכל שלב, ואין הבטחה שהוא יהיה עקבי בין קריאה לקריאה. אם בשאילתה יש משפט ORDER BY, ו-Spanner משתמש באינדקס שמספק את הסדר הנדרש, Spanner לא ממיין את הנתונים באופן מפורש. לכן, אל תדאגו לגבי ההשפעה של הוספת הסעיף הזה על הביצועים. כדי לבדוק אם פעולת מיון מפורשת נכללת בביצוע, אפשר לעיין בתוכנית לביצוע שאילתה.
שימוש ב-STARTS_WITH במקום ב-LIKE
מכיוון ש-Spanner לא מעריך תבניות LIKE עם פרמטרים עד לזמן הביצוע, הוא צריך לקרוא את כל השורות ולהעריך אותן ביחס לביטוי LIKE כדי לסנן שורות שלא תואמות.
כשתבנית LIKE היא מהצורה foo% (לדוגמה, היא מתחילה במחרוזת קבועה ומסתיימת בתו כללי יחיד של אחוז) והעמודה נוספה לאינדקס, צריך להשתמש ב-STARTS_WITH במקום ב-LIKE. האפשרות הזו מאפשרת ל-Spanner לבצע אופטימיזציה יעילה יותר של תוכנית הביצוע של השאילתה.
לא מומלץ:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE @like_clause;
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE $1;
מומלץ:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, @prefix);
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, $2);
שימוש בחותמות זמן של ביצוע שינויים
אם האפליקציה צריכה לשלוח שאילתות לנתונים שנכתבו אחרי זמן מסוים, הוסיפו עמודות של חותמות זמן של ביצוע שינויים לטבלאות הרלוונטיות. חותמות זמן של ביצוע שינויים מאפשרות אופטימיזציה של Spanner, שיכולה להפחית את הקלט/פלט של שאילתות שסעיפי ה-WHERE שלהן מגבילים את התוצאות לשורות שנכתבו אחרי זמן מסוים.
מידע נוסף על האופטימיזציה הזו במסדי נתונים בניב GoogleSQL או במסדי נתונים בניב PostgreSQL.