


這份Google Cloud Well-Architected Framework文件說明原則和建議,協助您在 Google Cloud 設計、建構及管理金融服務 (FS) 應用程式,達成營運、安全性、可靠性、成本和成效目標。
本文的目標對象包括決策者、架構師、管理員、開發人員和操作人員,他們負責在 Google Cloud中設計、建構、部署及維護 FS 工作負載。可能受益於本指南的金融服務機構包括銀行、支付基礎架構業者、保險供應商和資本市場營運商。
金融服務機構有特定的考量,尤其是架構和韌性。這些考量主要受法規、風險和效能要求影響。本文件根據我們在全球各地觀察到的金融服務客戶設計考量,提供高層級指引。無論工作負載是完全在雲端,還是正在轉換至混合雲或多雲端部署,本文件中的指引都能協助您在 Google Cloud 上設計工作負載,以符合法規要求和各種風險觀點。這份指南可能無法解決每個組織獨有的挑戰。這項解決方案提供基礎,可滿足金融服務機構的許多主要法規要求。
設計雲端工作負載時,主要挑戰在於如何讓雲端部署作業與地端部署環境保持一致,尤其是當您希望在安全性、可靠性和韌性方面採取一致的做法時。雲端服務可讓您從根本重新思考架構,以減少管理負擔、最佳化成本、強化安全性,並提高可靠性和韌性。
下列頁面說明架構完善的 Well-Architected Framework 中,各個要素專屬的 FS 工作負載原則和建議:
貢獻者
作者:
- Alex Stepney | 首席架構師
- Phil Bryan | 歐洲、中東和非洲地區金融服務業首席架構師
- Stathis Onasoglou | 歐洲、中東和非洲地區金融服務業首席架構師
- Sam Moss | 歐洲、中東和非洲地區 FinOps 專業服務主管
其他貢獻者:
- Daniel Lees | 雲端安全架構師
- Danielle Fisla | 美國 FS 產品組合負責人,PSO
- Filipe Gracio 博士 | AI/機器學習專家客戶工程師
- Gino Pelliccia | 首席架構師
- Henry Cheng | 首席架構師
- John Bacon | 合作夥伴解決方案架構師
- Jose Andrade | 客戶工程師、SRE 專家
- Kumar Dhanagopal | 跨產品解決方案開發人員
- Laura Hyatt | 金融服務業客戶工程師
- Michael Yang | 產業解決方案 AI 諮詢主管,金融服務業
- Nicolas Pintaux | 客戶工程師,應用程式翻新專家
- Omar Saenz | 歐洲、中東和非洲地區合作夥伴工程師,資安
- Radhika Kanakam | Well-Architected Framework 專案負責人 Google Cloud
- Steve McGhee | 可靠性做法倡議者
- Tarun Sharma | 首席架構師
- Yuriy Babenko | FSI 客戶工程師
金融服務觀點:卓越營運
本文件屬於Google Cloud Well-Architected Framework:金融服務 (FS) 觀點,概略說明在 Google Cloud建構、部署及操作穩健 FS 工作負載的原則和建議。這些建議可協助您設定觀測能力、自動化和擴充性等基本要素。本文中的建議符合 Well-Architected Framework 的卓越營運支柱。
由於 Google Cloud 中的 FS 工作負載受到高度監管且性質敏感,因此卓越營運至關重要。卓越營運可確保雲端解決方案能因應不斷變化的需求,並滿足您對價值、效能、安全性和可靠性的要求。如果這些領域發生問題,可能會導致重大財務損失、監管處罰和商譽受損。
卓越營運可為 FS 工作負載帶來下列好處:
- 維持信任和信譽:金融機構高度仰賴客戶的信任。營運中斷或安全漏洞會嚴重破壞這種信任,並導致客戶流失。卓越營運有助於盡可能降低這些風險。
符合嚴格的法規遵循要求:金融服務必須遵守眾多複雜的法規,例如:
必須具備完善的作業程序、監控和事件管理機制,才能證明符合法規,避免受罰。
確保業務持續運作和復原能力:金融市場和服務通常會持續運作。因此,高可用性和有效的災難復原至關重要。卓越營運原則可指引您設計及實作具韌性的系統。可靠性支柱提供這方面的更多指引。
保護機密資料:金融機構會處理大量高度機密的客戶和財務資料。為防止資料侵害並維護隱私,必須採取強大的作業控管措施、安全監控和快速事件應變。安全性支柱提供這方面的更多指引。
最佳化重要應用程式的效能:許多金融應用程式 (例如交易平台和即時分析) 都需要高效能和低延遲。為滿足這些效能需求,您需要高度最佳化的運算、網路和儲存空間設計。效能最佳化支柱提供這個領域的更多指引。
有效管理成本:除了安全性和可靠性,金融機構也重視成本效益。卓越營運包括最佳化資源使用率和管理雲端支出的做法。成本最佳化支柱提供更多這方面的指引。
本文中的優質營運建議對應至下列核心原則:
定義服務水準協議,以及相應的服務等級目標和服務水準指標
在許多金融服務機構中,應用程式的可用性通常會根據復原時間目標 (RTO) 和復原點目標 (RPO) 指標進行分類。對於為外部客戶提供服務的業務關鍵應用程式,可能也會定義服務水準協議 (SLA)。
SLA 需要一個指標架構,從使用者滿意度的角度呈現系統行為。網站可靠性工程 (SRE) 做法可協助您達到所需的系統可靠性。建立指標架構時,必須定義及監控關鍵數值指標,從使用者的角度瞭解系統健康狀態。舉例來說,延遲時間和錯誤率等指標可量化服務的效能。這些指標稱為服務水準指標 (SLI)。開發有效的 SLI 至關重要,因為這類指標能提供客觀評估可靠性所需的原始資料。
如要定義有意義的 SLA、SLI 和 SLO,請參考下列建議:
- 為每項重要服務制定及定義 SLI。設定目標值,定義可接受的效能等級。
- 制定並定義與 SLI 對應的服務水準目標 (SLO)。舉例來說,SLO 可能會規定 99.9% 的要求延遲時間必須低於 200 毫秒。
- 找出服務不符合服務等級目標時,必須採取的內部補救措施。舉例來說,為了提高平台的韌性,您可能需要將開發資源集中用於修正問題。
- 驗證每項服務的服務水準協議 (SLA) 規定,並將 SLA 視為與服務使用者簽訂的正式合約。
服務水準範例
下表提供付款平台的 SLI、SLO 和 SLA 範例:
| 業務指標 | SLI | SLO | 服務水準協議 |
|---|---|---|---|
| 付款交易成功 | 量化指標,代表所有已啟動的付款交易中,成功處理並確認的百分比。 範例:(成功交易次數 ÷ 有效交易總數) × 100,以 5 分鐘為滾動時間範圍計算。 |
內部目標,在特定期間內維持高比例的成功付款交易。 範例:在 30 天的滾動週期內,維持 99.98% 的付款交易成功率,不含無效要求和預定維護。 |
合約保證付款交易處理的成功率和速度。 範例:服務供應商保證,客戶發起的付款交易中,有 99.0% 會在一秒內成功處理並確認。 |
| 付款處理延遲時間 | 從客戶發起付款交易到最終確認,處理付款交易所需的平均時間。 範例:交易確認的平均回覆時間 (以毫秒為單位),以 5 分鐘為滾動週期測量。 |
付款交易處理速度的內部目標。 範例:確保 99.5% 的付款交易在 30 天滾動期間內,於 400 毫秒內處理完畢。 |
合約承諾在指定時間範圍內解決重大付款處理問題。 範例:針對重大付款處理問題 (定義為影響超過 1% 交易的中斷情形),服務供應商承諾在問題回報或偵測到後的兩小時內解決。 |
| 平台適用情形 | 核心付款處理 API 和使用者介面可供客戶操作及存取的時間百分比。 範例:(總運作時間 - 停機時間) ÷ 總運作時間 × 100,以分鐘為單位。 |
核心付款平台正常運作時間的內部目標。 範例:每個月的平台可用性達到 99.995% (不含排定的維護期間)。 |
對客戶做出的正式、具法律約束力的承諾,保證付款平台的最短正常運作時間,並說明未達標準的後果。 範例:平台每個月至少維持 99.9% 的可用性,不含排定的維護期間。如果可用性低於最低水準,每下降 0.1%,客戶將獲得每月服務費 5% 的服務抵免額。 |
使用 SLI 資料監控系統是否在定義的 SLO 範圍內,並確保符合 SLA。工程師和開發人員可以使用一組定義明確的 SLI,在下列層級監控 FS 應用程式:
- 直接在部署應用程式的服務中,例如 Google Kubernetes Engine 或 Cloud Run。
- 使用基礎架構元件 (例如負載平衡器) 提供的記錄。
OpenTelemetry 提供開放原始碼標準和一組技術,可擷取所有類型的遙測資料,包括指標、追蹤記錄和記錄。Google Cloud Managed Service for Prometheus 提供全代管、高擴充性的指標後端,以及大規模的 Prometheus 作業。
如要進一步瞭解 SLI、SLO 和錯誤預算,請參閱 SRE 手冊。
如要開發有效的快訊和監控資訊主頁和機制,請搭配使用 Google Cloud Observability 工具和 Cloud Monitoring。如要瞭解安全性專屬的監控和偵測功能,請參閱安全性支柱。
定義及測試事件管理程序
定義明確且定期測試的事件管理程序,可直接提升 Google Cloud中 FS 工作負載的價值、效能、安全性和可靠性。這些程序可協助金融機構符合嚴格的法規要求、保護機密資料、維持業務連續性,並贏得客戶信任。
定期測試事件管理程序可帶來下列好處:
- 在尖峰負載下維持效能:定期進行效能和負載測試,有助於金融機構確保雲端式應用程式和基礎架構能處理尖峰交易量、市場波動和其他高需求情境,且效能不會降低。這項功能對於維持流暢的使用者體驗,以及滿足金融市場的需求至關重要。
- 找出潛在瓶頸和限制:壓力測試會將系統推向極限,讓金融機構在潛在瓶頸和效能限制影響重要營運之前,找出這些問題。這種主動做法可讓金融機構調整基礎架構和應用程式,達到最佳效能和擴充性。
- 驗證可靠性和韌性:定期測試 (包括混沌工程或模擬故障) 有助於驗證金融系統的可靠性和韌性。這項測試可確保系統能從故障中順利復原,並維持高可用性,這對業務持續運作至關重要。
- 進行有效的容量規劃:效能測試可提供不同負載條件下資源使用率的寶貴資料,這對準確的容量規劃至關重要。金融機構可運用這項資料,主動預測未來的容量需求,並避免因資源限制而發生效能問題。
- 成功部署新功能和程式碼變更:將自動化測試整合至 CI/CD 管道,有助於確保變更和新部署項目在發布至正式環境前,都經過徹底驗證。這個方法能大幅降低錯誤和迴歸風險,避免作業中斷。
- 符合系統穩定性的法規要求:金融法規通常要求機構採取完善的測試做法,確保重要系統穩定可靠。定期測試有助於證明符合這些要求。
如要定義及測試事件管理程序,請參考下列建議。
制定明確的事件應變程序
一套完善的事件應變程序應包含下列元素:
- 定義事件指揮官、調查人員、通訊人員和技術專家的角色和責任,確保應變措施有效且協調一致。
- 定義通訊協定和提報路徑,確保在事件期間能及時有效地分享資訊。
- 在執行手冊或應對手冊中記錄的程序,概述溝通、分類、調查和解決的步驟。
- 定期培訓和準備,讓團隊具備有效應對的知識和技能。
定期執行效能和負載測試
定期進行效能和負載測試,有助於確保雲端式應用程式和基礎架構能處理尖峰負載,並維持最佳效能。負載測試會模擬實際的流量模式。壓力測試會將系統推向極限,找出潛在瓶頸和效能限制。您可以使用 Cloud Load Balancing 等產品和負載測試服務,模擬實際流量。您可以根據測試結果調整雲端基礎架構和應用程式,以達到最佳效能和擴充性。例如,您可以調整資源分配或應用程式設定。
在 CI/CD 管道中自動執行測試
將自動化測試納入 CI/CD 管道,有助於在部署前驗證變更,確保雲端應用程式的品質和可靠性。這種做法可大幅降低錯誤和迴歸的風險,並協助您建構更穩定、更強大的軟體系統。您可以在 CI/CD 管道中納入不同類型的測試,包括單元測試、整合測試和端對端測試。使用 Cloud Build 和 Cloud Deploy 等產品,建立及管理 CI/CD 管道。
持續改良和創新
對雲端中的金融服務工作負載而言,遷移至雲端只是第一步。持續強化和創新至關重要,原因如下:
- 加速創新:運用 AI 等新技術提升服務品質。
- 降低成本:消除低效率問題,並充分運用資源。
- 提高靈活性:快速因應市場和法規變化。
- 提升決策品質:使用 BigQuery 和 Looker 等資料分析產品,做出明智決策。
為確保持續改善和創新,請參考下列建議。
定期回顧
回顧對於持續改善事件應變程序,以及根據定期效能和負載測試結果最佳化測試策略至關重要。為確保回顧會議有效,請採取下列做法:
- 讓團隊有機會反思經驗、找出成效良好的部分,並找出待改進之處。
- 在專案里程碑、重大事件或重要測試週期後,舉行回顧會議。團隊可以從成功和失敗中學習,持續改善流程和做法。
- 採用開始-停止-繼續模型等結構化方法,確保回顧會議能發揮成效,並產生可行的步驟。
- 透過回顧會議,找出可進一步強化變更管理自動化的領域,以提高可靠性並降低風險。
培養學習文化
學習文化有助於在Google Cloud中安全探索新技術,例如運用 AI 和機器學習功能,強化詐欺偵測和個人化財務建議等服務。如要推廣學習文化,請採取下列做法:
- 鼓勵團隊實驗、分享知識及持續學習。
- 建立不究責的文化,將失敗視為成長和改進的機會。
- 營造心理安全感,讓團隊敢於冒險並考慮創新解決方案。團隊能從成功和失敗中學習,進而打造出更具韌性和適應力的組織。
- 培養一種文化,促進分享從事件管理流程和測試演練中獲得的知識。
掌握最新雲端技術
持續學習對於瞭解及實施新的安全措施、運用進階資料分析取得更深入的洞察,以及採用與金融服務相關的創新解決方案至關重要。
- 隨時掌握最新進展、功能和最佳做法,充分發揮 Google Cloud 服務的潛力。
- 推出新的 Google Cloud 功能和服務時,請找出機會進一步自動化程序、強化安全性,以及提升應用程式的效能和擴充性。
- 參加相關會議、網路研討會和訓練課程,拓展知識並瞭解新功能。
- 鼓勵團隊成員取得Google Cloud 認證,確保組織具備在雲端環境中取得成功所需的技能。
金融服務觀點:安全性、隱私權和法規遵循
本文件屬於Google Cloud Well-Architected Framework:金融服務 (FS) 觀點,概述了相關原則和建議,協助您因應 Google Cloud中金融服務 (FS) 工作負載的安全性、隱私權和法規遵循需求。這些建議可協助您建構彈性且符合法規的基礎架構、保護機密資料、維持客戶信任、因應複雜的法規要求,以及有效管理網路威脅。本文中的建議符合 Well-Architected Framework 的安全性支柱。
雲端運算安全性是金融服務機構的重要考量,因為他們管理大量機密資料 (包括客戶詳細資料和財務記錄),因此很容易成為網路犯罪者的目標。安全漏洞的後果極為嚴重,包括重大財務損失、長期信譽受損和巨額監管罰款。因此,金融服務工作負載需要嚴格的安全控管機制。
為確保全面安全性和法規遵循,您需要瞭解您 (金融服務機構) 與 Google Cloud之間的共同責任。 Google Cloud 負責保護基礎架構,包括實體安全性和網路安全。您必須負責保護資料和應用程式、設定存取控管,以及設定和管理安全性服務。為協助您維護安全性,Google Cloud 合作夥伴生態系統提供安全性整合和代管服務。
本文件中的安全性建議對應至下列核心原則:
採用融入安全考量的設計
金融法規 (例如付款卡產業資料安全標準 (PCI DSS)、美國的《格蘭姆-里奇-布利里法案》(GLBA),以及各國金融資料保護法) 規定,系統必須從一開始就整合安全性。安全設計原則強調在整個開發生命週期中整合安全性,確保從一開始就盡可能減少安全漏洞。
如要在Google Cloud中為 FS 工作負載套用安全設計原則,請參考下列建議:
- 在 Identity and Access Management (IAM) 中,透過精細的角色式存取控管 (RBAC) 套用最小權限原則,確保只授予必要權限。許多金融法規都要求使用 RBAC。
- 使用 VPC Service Controls,在 Google Cloud 中為機密服務和資料強制執行安全 perimeter。安全 perimeter 有助於區隔及保護機密資料和資源,並依據法規要求,防止資料竊取和未經授權的存取行為。
- 使用 Terraform 等基礎架構即程式碼 (IaC) 工具,將安全性設定定義為程式碼。這種做法從初始部署階段就嵌入安全控管機制,有助於確保一致性和可稽核性。
- 使用 Cloud Build 將靜態應用程式安全防護測試 (SAST) 整合至 CI/CD 管道,掃描應用程式程式碼。建立自動化安全閘道,防止部署不符合規定的程式碼。
- 使用 Security Command Center,提供統一的安全性洞察介面。Security Command Center 可持續監控並及早偵測可能導致違反法規的設定錯誤或威脅。如要符合 ISO 27001 和 NIST 800-53 等標準的要求,您可以使用防護機制管理範本。
- 追蹤正式環境部署作業中發現的安全漏洞減少情況,以及符合安全性最佳做法的 IaC 部署作業百分比。您可以使用 Security Command Center,偵測及查看安全漏洞和安全標準法規遵循相關資訊。詳情請參閱「安全漏洞發現項目」。
實踐零信任做法
現代金融法規越來越強調嚴格存取控管和持續驗證的必要性。這些要求反映了零信任原則,旨在保護工作負載免受內外部威脅和惡意人士的侵害。零信任原則主張持續驗證每位使用者和裝置,消除隱含信任,並減少橫向移動。
如要實施零信任機制,請參考下列建議:
- 結合 IAM 控制項與 Chrome Enterprise 進階版,根據使用者身分、裝置安全性、位置和其他因素,啟用情境感知存取權。這種做法可確保在授予財務資料和系統存取權前,持續進行驗證。
- 設定 Identity Platform (如果您使用員工身分聯盟,則為外部身分識別資訊提供者),提供安全且可擴充的身分與存取權管理。設定多重驗證 (MFA) 和其他控制項,這對實作零信任機制和確保法規遵循至關重要。
- 為所有使用者帳戶實施 MFA,尤其是可存取機密資料或系統的帳戶。
- 建立全面的使用者存取權和網路活動記錄與監控機制,支援法規遵循相關的稽核和調查。
- 使用 Private Service Connect,在Google Cloud 和地端部署環境中的服務之間,建立私密安全的通訊,不將流量公開至網際網路。
- 使用 Identity-Aware Proxy (IAP) 實作精細的身分控管機制,並在應用程式層級授權存取權,而非依賴 VPN 通道等網路型安全機制。這種做法有助於減少環境中的橫向移動。
導入提前測試安全性
金融監管機構鼓勵採取主動式安全措施。在開發生命週期初期找出並解決安全漏洞,有助於降低資安事件風險,以及因不符合法規而受罰的可能性。左移安全性原則提倡早期安全性測試和整合,有助於降低修復成本和複雜度。
如要實施左移安全性,請參考下列建議:
使用 Cloud Build 將安全掃描工具 (例如容器安全漏洞掃描和靜態程式碼分析) 整合至 CI/CD 管道,確保在開發流程早期自動執行安全檢查。
使用 Artifact Registry,為軟體套件和容器映像檔提供安全的中央存放區,並整合安全漏洞掃描功能,確保只部署安全的構件。使用虛擬存放區,優先處理私人構件,而非遠端存放區,藉此防範依附元件混淆攻擊。
將 Security Command Center 的 Web Security Scanner 整合至開發管道,自動掃描網頁應用程式,找出常見的安全漏洞。
使用軟體構件供應鏈級別 (SLSA) 架構,對原始碼、建構程序和程式碼來源進行安全性檢查。使用二進位授權等解決方案,強制執行環境中執行的工作負載來源。使用 Assured Open Source Software,確保工作負載只使用經過驗證的開放原始碼軟體程式庫。
追蹤開發生命週期中發現及修復的安全漏洞數量、通過安全掃描的程式碼部署作業百分比,以及軟體安全漏洞導致的安全事件減少數量。 Google Cloud 提供工具,協助您追蹤不同類型的工作負載。舉例來說,如果是容器化工作負載,請使用 Artifact Registry 的容器掃描功能。
實作預先防範網路防禦
金融機構是複雜網路攻擊的主要目標。法規通常要求組織具備強大的威脅情報和主動防禦機制。先發制人的網路防禦著重於運用進階數據分析和自動化技術,主動偵測及應對威脅。
請參考下列建議:
- 使用 Mandiant 的威脅情報、事件應變和安全驗證服務,主動找出並緩解潛在威脅。
- 使用 Google Cloud Armor,在網路邊緣保護網頁應用程式和 API,防範網路攻擊和 DDoS 攻擊。
- 使用 Security Command Center 彙整安全性發現項目和建議,並排定優先順序,讓資安團隊主動因應潛在風險。
- 定期進行安全模擬和滲透測試,驗證預防性防禦和事件應變計畫。
- 評估偵測及因應資安事件所需的時間、DDoS 緩解措施的成效,以及防範的網路攻擊數量。您可以從 Google Security Operations SOAR 資訊主頁取得所需指標和資料。
以安全且負責任的方式使用 AI,並運用 AI 強化安全防護
AI 和機器學習技術越來越常用於金融服務,例如詐欺偵測和演算法交易。法規要求這些技術必須以符合倫理、透明且安全的方式使用。AI 也能強化安全防護能力。使用 AI 時,請參考下列建議:
- 使用 Gemini Enterprise Agent Platform,在安全且受控管的環境中開發及部署機器學習模型。模型可解釋性和公平性指標等功能,有助於解決負責任 AI 的疑慮。
- 運用 Google Security Operations 的安全性分析與相關作業功能,透過 AI 和機器學習技術分析大量安全性資料、偵測異常狀況,並自動應對威脅。這些功能有助於強化整體資安態勢,並協助監控法規遵循情形。
- 針對 AI 和機器學習的開發與部署作業,制定明確的管理政策,包括安全性和倫理相關考量。
- 遵循安全 AI 架構 (SAIF) 的要素,以實際做法解決 AI 系統的安全性和風險問題。
- 追蹤 AI 輔助詐欺偵測系統的準確率和成效、安全性警示的偽陽性降幅,以及 AI 輔助安全性自動化作業帶來的效率提升。
滿足法規遵循和隱私權需求
金融服務必須遵守多項法規,包括資料落地要求、特定稽核追蹤記錄和資料保護標準。為確保機密資料能妥善識別、保護及管理,金融服務機構需要完善的資料治理政策和資料分類架構。請參考下列建議,協助您符合法規要求:
- 使用 Assured Workloads,在 Google Cloud 中為機密和受監管的工作負載設定資料邊界。這有助於您符合政府和特定產業的法規遵循要求,例如 FedRAMP 和 CJIS。
- 導入 Sensitive Data Protection,識別、分類及保護財務資訊等機密資料。這樣做有助於遵守 GDPR 和 CCPA 等資料隱私權法規。
- 使用 Cloud 稽核記錄,追蹤管理活動和資源存取權的詳細資料。這些記錄對於滿足許多金融法規規定的稽核要求至關重要。
- 為工作負載和資料選擇Google Cloud 區域時,請考量與資料落地相關的當地法規。 Google Cloud 全球基礎架構可讓您選擇符合資料落地要求的區域。
- 使用 Cloud Key Management Service,管理用於加密靜態和傳輸中機密財務資料的金鑰。這類加密是許多安全性和隱私權法規的基本要求。
- 實作必要控管措施,滿足法規要求。確認控管機制運作正常。請外部稽核人員再次驗證控管措施,向監管機構證明工作負載符合法規。
優先執行安全性計畫
考量到安全需求範圍廣泛,金融機構必須根據風險評估和法規要求,優先處理相關計畫。建議您採取下列分階段做法:
- 建立穩固的安全基礎:著重於安全性的核心領域,包括身分與存取權管理、網路安全和資料保護。這有助於建立強大的資安態勢,並確保能全面防禦不斷演變的威脅。
- 遵守重要法規:優先遵守 PCI DSS、GDPR 和相關國家/地區法律等重要法規。這麼做有助於確保資料保護、降低法律風險,並建立客戶信任。
- 實施進階安全措施:逐步採用進階安全措施,例如零信任、AI 導向安全解決方案,以及主動威脅搜尋。
金融服務觀點:可靠性
這份文件屬於Google Cloud Well-Architected Framework:金融服務 (FS) 觀點,概略說明在 Google Cloud設計、部署及操作可靠 FS 工作負載的原則和建議。這份文件探討如何將進階可靠性做法和觀測能力整合至架構藍圖。本文中的建議符合 Well-Architected Framework 的可靠性支柱。
對金融機構而言,可靠且具備韌性的基礎架構不僅是業務需求,也是法規要求。為確保Google Cloud 中的 FS 工作負載穩定可靠,您必須瞭解並降低潛在故障點、部署備援資源,並規劃復原作業。營運韌性是可靠性的結果。也就是承受、適應及從中斷情況中復原的能力。營運韌性可協助金融服務機構遵守嚴格的法規要求。並避免對客戶造成無法承受的傷害。
Google Cloud 中可靠性的重要建構模塊是區域、可用區和雲端資源的各種位置範圍:可用區、區域、多區域、全球。您可以透過下列方式提高可用性:使用代管服務、分配資源、實作高可用性模式,以及自動化程序。
法規要求
金融服務機構必須遵守監管機構嚴格的可靠性規定,例如美國聯邦準備系統、歐盟歐洲銀行監理機關和英國審慎監理局。全球監管機構都強調營運韌性,這對金融穩定和消費者保護至關重要。營運韌性是指抵禦中斷、有效復原及維持關鍵服務的能力。這需要採取協調一致的方法,管理技術風險和對第三方的依賴。
大多數管轄區的法規要求都有以下共同主題:
- 網路安全和技術韌性:強化網路威脅防禦能力,確保 IT 系統韌性。
- 第三方風險管理:管理將服務外包給資訊和通訊技術 (ICT) 供應商的相關風險。
- 營運持續性和事件應變:制定完善計畫,確保在服務中斷期間維持重要營運,並有效復原。
- 維護金融穩定:確保整體金融體系健全穩定。
本文件中的可靠性建議對應至下列核心原則:
優先採用多可用區和多區域部署
對於重要的金融服務應用程式,建議您使用多區域拓撲,分散在至少兩個區域,以及每個區域內的三個可用區。這種做法對於防範可用區和區域性服務中斷相當重要。法規通常會規定這種做法,因為如果某個可用區或區域發生故障,大多數管轄區都會認為第二個可用區發生嚴重中斷是可能發生的後果。這是因為當某個位置發生故障時,另一個位置可能會收到異常大量的額外流量。
建議您參考下列做法,提升對可用區和區域服務中斷的復原能力:
- 建議優先選用位置範圍較廣的資源。請盡可能使用區域性資源,而非可用區資源,並使用多區域或全域資源,而非區域性資源。這種做法有助於避免使用備份還原作業。
- 在每個區域中,請使用三個可用區,而非兩個。為處理容錯移轉,請將容量超額佈建至預估值的三分之一以上。
- 實作主動-主動部署,盡量減少手動復原步驟,例如:
- Spanner 等分散式資料庫提供內建備援機制,並可跨區域同步處理。
- Cloud SQL 的高可用性功能提供接近主動-主動的拓撲,並在各可用區中提供唯讀副本。區域之間的復原點目標 (RPO) 接近 0。
- 使用 Cloud DNS 將使用者流量分配到不同區域,並在各區域部署區域性負載平衡器。您也可以根據需求和重要性,考慮使用全域負載平衡器。詳情請參閱「多區域部署項目全域負載平衡的優點和風險」。
- 如要儲存資料,請使用 Spanner 和 Cloud Storage 等多區域服務。
消除單點故障
將資源分散到不同位置,並使用備援資源,避免任何單點故障 (SPOF) 影響整個應用程式堆疊。
請參考下列建議,避免單點故障:
- 避免只部署單一應用程式伺服器或資料庫。
- 使用代管執行個體群組 (MIG),確保自動重新建立失敗的 VM。
- 實作負載平衡,將流量平均分配到可用資源。
- 為 Cloud SQL 等資料庫採用高可用性設定。
- 使用區域性永久磁碟和同步複製功能,提高資料可用性。
詳情請參閱「在 Google Cloud中為工作負載設計可靠的基礎架構」。
瞭解及管理匯總可用性
請注意,系統的整體或匯總可用性會受到系統各層或元件的可用性影響。應用程式堆疊中的層級數量與堆疊的匯總可用性成反比。請參考下列建議,管理匯總可用性:
使用公式 tier1_availability × tier2_availability × tierN_availability 計算多層級堆疊的匯總可用性。
下圖顯示由四項服務組成的多層級系統,其匯總可用性的計算方式:
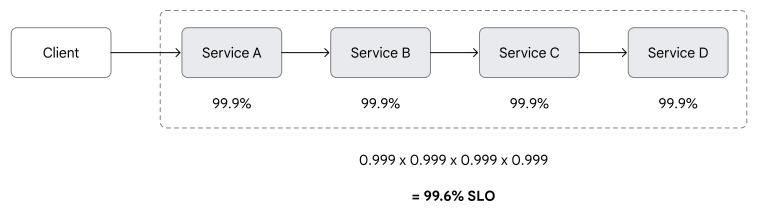
在上圖中,每個層級的服務都提供 99.9% 的可用性,但系統的匯總可用性較低,為 99.6% (0.999 × 0.999 × 0.999 × 0.999)。一般來說,多層級堆疊的匯總可用性低於提供最低可用性的層級。
在可行的情況下,請選擇平行處理,而非鏈結。如果服務平行化,端對端可用性會高於個別服務的可用性。
下圖顯示使用鏈結和平行處理方法部署的兩項服務 A 和 B:
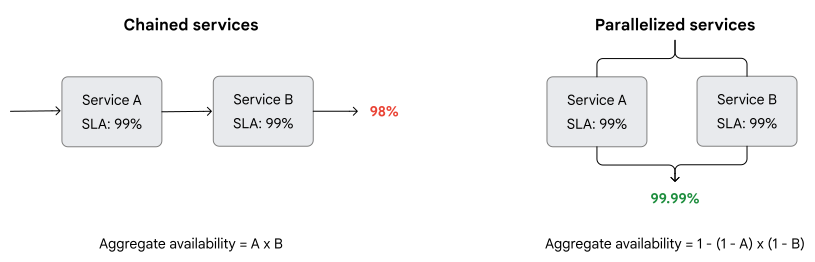
在上述範例中,兩項服務的服務水準協議均為 99%,因此匯總可用性會因實作方法而異:
- 鏈結服務的匯總可用性僅為 98% (.99 × .99)。
- 平行化服務的匯總可用性較高,達到 99.99%,因為每項服務都獨立運作,個別服務不會受到其他服務的可用性影響。匯總平行服務的公式為 1 − (1 − A) × (1 − B)。
選擇 Google Cloud 服務時,請考量其正常運作時間服務水準協議 (SLA),確保應用程式堆疊的整體正常運作時間符合要求。
設計架構時,請權衡可用性、作業複雜度、延遲時間和成本。提高可用性通常會增加成本,但有助於滿足法規要求。
舉例來說,99.9% 的可用性 (三個九) 代表 24 小時內可能會有 86 秒的停機時間。相較之下,99% (兩個 9) 代表在相同期間內有 864 秒的停機時間,比三個 9 的可用性多出 10 倍。
如果是重要的金融服務,架構選項可能會受到限制。不過,請務必找出可用性需求,並準確計算可用性。進行這類評估,有助於您評估設計決策對架構和預算的影響。
實施完善的災難復原策略
針對不同的災難情境 (包括可用區和區域性中斷) 制定明確的計畫。明確的災難復原 (DR) 策略可讓您從中斷中復原,並在影響最小的情況下恢復正常營運。
災難復原和高可用性 (HA) 是不同的概念。一般來說,在雲端部署中,DR 適用於多區域部署,HA 則適用於區域部署。這些部署原型支援不同的複製機制。
- HA:許多代管服務預設會在單一區域內的可用區之間同步複製資料。這類服務支援零或接近零的復原時間目標 (RTO) 和復原點目標 (RPO)。這項支援可讓您建立主動-主動部署拓撲,不會有任何單一故障點。
- 災難復原:如果工作負載部署在兩個以上的區域,且您未使用多區域或全域服務,則必須定義複製策略。複製策略通常是非同步。請仔細評估這類複製作業對重要應用程式的 RTO 和 RPO 有何影響。找出容錯移轉所需的手動或半自動作業。
如果是金融機構,選擇容錯移轉區域時,可能會受到資料主權和資料落地相關法規的限制。如果您需要在兩個區域之間建立主動-主動拓撲,建議您選擇代管的多區域服務,例如 Spanner 和 Cloud Storage,尤其是在資料複製至關重要時。
請參考下列建議:
- 使用代管的多區域儲存服務來儲存資料。
- 建立永久磁碟中資料的快照,並將快照儲存在多區域位置。
- 使用區域或可用區資源時,請設定將資料複製到其他區域。
- 定期測試災難復原計畫,驗證計畫是否有效。
- 請留意 RTO 和 RPO,以及兩者與您所在管轄區金融法規規定的影響容忍度之間的關聯。
詳情請參閱「為雲端基礎架構服務中斷建立災難復原架構」。
使用代管服務
請盡可能使用代管服務,充分運用備份、高可用性和擴充性等內建功能。使用代管服務時,請參考下列建議:
- 使用 Google Cloud中的代管服務。提供服務水準協議支援的高可用性。此外,這些服務也提供內建備份機制和復原功能。
- 如需資料管理,請考慮使用 Cloud SQL、Cloud Storage 和 Spanner 等服務。
- 如需運算和應用程式託管服務,請考慮使用 Compute Engine 代管執行個體群組 (MIG) 和 Google Kubernetes Engine (GKE) 叢集。區域性 MIG 和 GKE 區域叢集可抵禦可用區中斷。
- 如要提高對區域服務中斷的復原能力,請使用代管多區域服務。
- 針對具有獨特特性的服務,判斷是否需要退場計畫,並定義所需計畫。FCA、PRA 和 EBA 等金融監管機構要求,如果與雲端服務供應商的關係結束,企業必須制定資料擷取和營運持續性的策略和應變計畫。公司必須在簽訂雲端合約前評估退出的可行性,且必須保有更換供應商的能力,同時不中斷營運。
- 確認您選擇的服務支援將資料匯出為 CSV、Parquet 和 Avro 等開放格式。確認服務是否採用開放式技術,例如 GKE 支援開放容器計畫 (OCI) 格式,或 Managed Service for Apache Airflow。
自動佈建基礎架構和復原程序
自動化有助於盡可能減少人為錯誤,並減少應對事件所需的時間和資源。使用自動化功能有助於確保更快從故障中復原,並獲得更一致的結果。請參考下列建議,自動佈建及復原資源:
- 使用 Terraform 等基礎架構即程式碼 (IaC) 工具,盡可能減少人為錯誤。
- 自動執行容錯移轉程序,減少手動介入。自動化回應也有助於降低故障的影響。例如,您可以使用 Eventarc 或 Workflows,自動觸發補救措施,因應稽核記錄中觀察到的問題。
- 使用自動調度資源功能,在容錯移轉期間增加雲端資源容量。
- 採用平台工程,在服務部署期間,自動在雲端拓撲中套用政策和防護措施,以符合法規要求。
金融服務觀點:成本最佳化
本文屬於Google Cloud Well-Architected Framework:金融服務 (FS) 觀點,概略說明在 Google Cloud中最佳化 FS 工作負載成本的原則和建議。本文中的建議符合 Well-Architected Framework 的成本最佳化支柱。
如要有效提高金融服務工作負載的成本效益,必須具備下列基本要素:
- 能夠區分資源使用率是浪費還是能創造價值。
- 建立財務可靠度文化。
如要最佳化成本,您必須全面瞭解貴組織的成本動因和資源需求。在某些大型組織中,尤其是剛開始使用雲端的組織,通常會由單一團隊負責最佳化大量網域的支出。這種做法假設中央團隊最適合找出高價值機會,提升效率。
在雲端採用的初期階段或非關鍵工作負載,集中式方法可能會取得一些成功。不過,單一團隊無法推動整個組織的成本最佳化。當資源用量或法規審查程度增加時,集中式方法就無法持續。集中式團隊在處理大量金融產品和服務時,特別容易面臨擴充性挑戰。擁有產品和服務的專案團隊可能會抗拒外部團隊所做的變更。
為了有效最佳化成本,支出相關資料必須高度公開,且與工作負載密切相關的工程師和其他雲端使用者必須有動力採取行動,最佳化成本。從組織的角度來看,成本最佳化的挑戰在於找出應最佳化的領域、找出負責這些領域的工程師,然後說服他們採取必要的最佳化行動。本文件提供建議,協助您解決這項難題。
本文件中的成本最佳化建議對應至下列核心原則:
使用 Google Cloud 工具找出浪費
Google Cloud 提供多項產品、工具和功能,協助您找出浪費之處。請參考下列建議。
運用自動化和 AI 技術,有系統地找出需要最佳化的項目
Active Assist 針對各項服務提供智慧型建議,例如微服務適用的 Cloud Run、資料分析適用的 BigQuery、核心應用程式適用的 Compute Engine,以及關聯式資料庫適用的 Cloud SQL。Active Assist 建議不需付費,也不必進行任何設定。建議可協助您找出閒置資源和未充分運用的承諾使用合約。
透過整合式介面集中監控及控管 FinOps
Cloud Billing 帳單報表和 FinOps 中心可讓您全面監控成本。財務稽核人員和內部財務團隊必須掌握這項全面資訊,才能追蹤雲端支出、評估財務狀況、評估各業務單位或成本中心的 FinOps 成熟度,並提供一致的財務說明。
分析及充實支出資料,找出價值
Active Assist 可有效找出明顯的浪費情形。不過,要找出價值可能更具挑戰性,尤其是當工作負載位於不合適的產品上,或工作負載與業務價值缺乏明確關聯時。對金融服務工作負載而言,業務價值不只是降低成本。價值包括風險控管、法規遵循和取得競爭優勢。
如要全面瞭解雲端支出和價值,您必須從多個層面完整瞭解:支出來源、支出推動的業務功能,以及重構或最佳化相關工作負載的技術可行性。
下圖說明如何運用資料-資訊-知識-智慧 (DIKW) 金字塔和 Google Cloud 工具,全面瞭解雲端成本和價值。

上圖顯示如何使用 DIKW 方法,將原始雲端支出資料精煉為可做為行動依據的洞察資料和決策,進而提升業務價值。
- 資料:在這個層級,您會收集雲端資源使用情形和費用資料的原始、未處理串流。中央 FinOps 團隊會使用 Cloud Billing 月結單、帳單匯出和 Cloud Monitoring 等工具,取得精細的詳細資料。舉例來說,資料點可能是名為
app1-test-vmA的 VM 在us-central1區域執行 730 小時,費用為 $70 美元。 - 資訊:在這個層級,您的中央 FinOps 團隊會使用 Cloud Billing 帳單報表和 FinOps 中心等工具,將原始資料結構化,協助回答「使用者在哪些類別的資源上花費資金?」等問題。舉例來說,您可能會發現,在美國兩個區域中,n4-standard-2 機型的 VM 總共花費 $1,050 美元。
- 知識:在這個層級,中央 FinOps 團隊會根據適當的業務情境,補充誰花費資金和用途等資訊。您會使用標記、標籤、資源階層、帳單帳戶和自訂 Looker 資訊主頁等機制。舉例來說,您可能會發現美國的
app1測試團隊在 7 月第二週進行壓力測試時,花費了 $650 美元。 - 智慧:在這個層級,產品和應用程式團隊會運用情境化知識,評估雲端支出的業務價值,並做出明智的策略決策。團隊可能會回答下列問題:
- 花費 5,000 美元建構的資料分析管道,是否能產生業務價值?
- 我們能否重新架構管道,在不降低效能的情況下提高效率?
分析雲端支出資料時,請參考下列建議。
分析 Google Cloud提供的支出資料
首先,請使用匯出至 BigQuery 的詳細 Cloud Billing 資料,以及 Monitoring 記錄檔中的資料。如要取得可做為行動依據的洞察資料並做出決策,您必須建構這項資料,並加入業務背景資訊。
透過可用工具以圖表呈現資料
使用 數據分析 等工具,在 BigQuery Export 上建立自訂報表,強化內建的 Google Cloud 資訊主頁。財務團隊可以建立自訂資訊主頁,根據財務指標、依法呈報要求和業務單位獲利能力,提供雲端支出的背景資訊。接著,他們可以提供清楚的財務敘述,供高階主管利害關係人分析和決策。
分配支出以落實問責制度
瞭解雲端支出的原因後,您需要找出支出者和原因。如要達到這種瞭解程度,必須採取完善的成本分配做法,包括將業務相關中繼資料附加至雲端資源。舉例來說,如果 Banking-AppDev 團隊使用特定資源,您可以將 team=banking_appdev 等標記附加至該資源,追蹤團隊在該資源上產生的費用。理想情況下,您應將 100% 的雲端費用分配給支出來源。在實務上,您一開始可以設定較低的目標,因為建構中繼資料結構來支援 100% 成本分配是一項複雜的工作。
建議您參考下列做法,制定中繼資料策略,以利成本分配:
- 有效性:確保標記有助於識別業務相關的主要成效指標 (KPI) 和法規要求。這項關聯對於內部交易退單、依法呈報,以及根據業務單位目標調整雲端支出至關重要。舉例來說,下列標記可清楚識別支出團隊、所在區域和負責的產品:
team=banking_appdev、region=emea、product=frontend。 - 自動化:如要達到高水準的標記法規遵循,請透過自動化強制執行標記。手動標記容易出錯且不一致,這在重視可稽核性和財務準確性的金融服務環境中是不可接受的。自動標記功能可確保資源在建立時正確分類。
- 簡單:評估簡單、不相關的因素。金融服務環境相當複雜,為確保這類環境中的成本分配規則易於理解和執行,規則必須盡可能簡單。避免為高度特定的 (邊緣) 案例過度設計規則。複雜的規則可能會導致營運團隊混淆和抗拒。
使用標記定義分配策略後,您需要決定策略的實施精細程度。所需的精細程度取決於您的業務需求。舉例來說,有些組織可能需要追蹤產品層級的費用,有些組織可能需要每個成本中心的費用資料,有些組織則可能需要每個環境 (開發、測試和正式環境) 的費用資料。
請考慮採用下列方法,為貴組織設定適當的成本分配精細程度:
- 使用 Google Cloud 中的專案階層結構,做為成本分配的自然起點。專案代表 Google Cloud中政策強制執行的點。根據預設,Identity and Access Management (IAM) 權限、安全性政策和費用會歸因於專案和資料夾。查看從 Cloud Billing 匯出的費用資料時,您可以查看資料夾階層和與費用資料相關聯的專案。如果Google Cloud 資源階層反映了貴組織的支出責任結構,那麼這是實施成本分配最簡單的方法。
- 使用標記和標籤,進一步細分。可讓您靈活分類帳單匯出作業中的資源。標記和標籤可協助您依應用程式和環境,查看詳細的費用明細。
通常,您可能需要搭配使用專案階層結構與標記和標籤,才能有效分配成本。無論選擇哪種成本分配方法,請遵循前述建議,制定穩健的中繼資料策略:有效性、自動化和簡單性。
推動責任制並激勵工程師採取行動
雲端 FinOps 團隊負責推動組織重視成本和價值。個別產品團隊和工程團隊必須採取必要行動,才能達到成本最佳化。這些團隊也必須負責金融服務工作負載的成本行為,並確保工作負載提供必要的業務價值。
請參考下列建議,推動責任歸屬並激勵團隊最佳化成本。
建立集中式 FinOps 團隊,負責管理
雲端 FinOps 做法不會自然發展。專屬的 FinOps 團隊必須採取下列行動,定義及建立 FinOps 做法:
- 建立必要的程序、工具和指引。
- 建立、傳達及強制執行必要政策,例如強制標記、預算審查和最佳化程序。
- 鼓勵工程團隊為成本負責。
- 在工程團隊不承擔成本責任時介入。
取得高階主管支持和授權
高階主管 (包括技術長、財務長和資訊長) 必須積極推動全組織轉向 FinOps 文化。他們的支持對於優先考量成本責任、為 FinOps 計畫分配資源、確保跨部門參與,以及推動遵守 FinOps 規定至關重要。
鼓勵團隊提高成本效益
工程師和工程團隊可能不會主動專注於成本最佳化。請務必實施下列獎勵措施,讓團隊和個人目標與成本效益保持一致:
- 將成本最佳化省下的部分資金,重新投資在達成最佳化目標的團隊。
- 公開表揚並慶祝成本最佳化成果。
- 運用遊戲化技巧,獎勵有效最佳化成本的團隊。
- 將效率指標納入成效目標。
實作顯示和收費技術
確保團隊清楚掌握他們擁有的雲端資源和成本。將財務責任指派給團隊中的適當人員。使用正式機制強制執行嚴格的標記,並實施透明的規則來分配共用費用。
著重價值和 TCO,而非成本
評估雲端解決方案時,請考量長期總持有成本 (TCO)。舉例來說,自行託管應用程式的資料庫,可能比使用 Cloud SQL 等代管資料庫服務便宜。不過,如要評估長期價值和 TCO,您必須考量與自行託管資料庫相關的隱藏成本。這類成本包括修補、資源調度、安全性強化和災難復原等專屬工程工作,這些都是金融服務工作負載的重要需求。代管服務可提供顯著更高的長期價值,抵銷基礎架構成本。代管服務提供強大的法規遵循功能、內建可靠性功能,並可協助減少營運負擔。
建議您參考下列做法,著重於價值和 TCO。
使用產品專屬技術和工具,充分運用資源
善用 Google Cloud產品提供的成本最佳化工具和功能,例如:
- Compute Engine: 自動調度資源、 自訂機型和 Spot VM
- Google Kubernetes Engine: 叢集自動配置器和自動佈建節點
- Cloud Storage: 物件生命週期管理和自動調整級別
- BigQuery: 依運算資源計價 和 成本最佳化技術
- Google Cloud VMware Engine:承諾使用折扣 (CUD)、最佳化儲存空間和其他成本最佳化策略
可享折扣優惠
使用 Google 提供的折扣,確保雲端資源的計費費率盡可能降低。個別產品和工程團隊通常會管理資源最佳化。中央 FinOps 團隊負責最佳化帳單費率,因為他們能掌握整個組織的資源需求。因此,他們可以彙整需求,並盡可能提高承諾使用折扣。
Google Cloud 資源可享下列類型的折扣:
- 企業折扣是根據貴組織承諾在 Google Cloud 的最低總支出,以較低的帳單費率協商而得。
- 依資源計算的 CUD:只要承諾在一年或三年內使用最低數量的 Compute Engine 資源,即可享有這類折扣。依資源計算的 CUD 適用於特定區域中的資源。對大多數 Cloud Billing 帳戶而言, Google Cloud 會啟用依資源計算的 CUD 共用功能,並與該帳戶相關聯的所有專案共用 CUD。
- 依支出計算的 CUD:您只要承諾在一年或三年內,在特定產品上達到最低支出金額,即可享有這類折扣。依支出計算的折扣適用於帳單帳戶層級。折扣會依產品套用於區域或全球。
除了企業折扣外,您還能使用 CUD 大幅節省費用。
除了 CUD 之外,您也可以採用下列方法降低計費費率:
- 使用 Spot VM 處理容錯和彈性工作負載。Spot VM 的價格比一般 VM 便宜 80% 以上。
- BigQuery 提供多種定價模式,包括隨選定價和版本計價,後者依據承諾使用合約和自動調度資源需求計費。如果您使用大量 BigQuery 資源,請選擇合適的版本,降低數據分析工作負載的每個運算單元費用。
- 請仔細評估所需服務的可用 Google Cloud 區域。選擇符合成本目標的區域,並考量延遲時間和法規遵循要求等因素。如要瞭解成本、永續性和延遲時間之間的權衡,請使用 Google Cloud 區域挑選器。
金融服務觀點:效能最佳化
這份文件屬於Google Cloud Well-Architected Framework:金融服務 (FS) 觀點,概略說明在 Google Cloud中最佳化 FS 工作負載效能的原則和建議。本文中的建議符合 Well-Architected Framework 的效能最佳化支柱。
金融服務業長期以來都致力於提升成效。這項技術協助金融服務機構克服技術挑戰,且幾乎總是能促成或加速新商業模式的建立。舉例來說,ATM (1967 年推出) 自動化現金提領流程,協助銀行降低核心業務的成本。繞過 OS 核心和將應用程式執行緒固定至運算核心等技術,有助於實現交易應用程式的確定性和低延遲。延遲時間縮短後,金融市場的流動性更高、更穩定,價差也更小。
雲端技術為效能最佳化帶來新契機。此外,這項技術也挑戰了過去廣為接受的部分最佳化模式。具體來說,在雲端中,下列權衡取捨更透明且可控:
- 推出速度與成本。
- 系統層級的端對端效能與節點層級的效能。
- 人才可用性與技術相關決策的靈活度。
舉例來說,在雲端中,根據特定技能需求調整硬體和 IT 資源是一項簡單的工作。如要支援 GPU 程式設計,您可以建立以 GPU 為基礎的 VM。您可以擴充雲端容量,因應需求激增的情況,不必過度佈建資源。這項功能可確保工作負載能處理尖峰負載,例如非農就業人口資料公布日,以及交易量明顯高於歷來水準時。您不必花費時間在個別伺服器層級編寫高度最佳化的程式碼 (例如以 C 語言編寫的高度微調程式碼),或為傳統高效能運算 (HPC) 環境編寫程式碼,而是可以使用架構完善、以 Kubernetes 為基礎的分散式系統,以最佳方式水平擴展。
本文件中的效能最佳化建議對應至下列核心原則:
根據主要業務指標調整技術成效指標
您可以透過多種方式,將成效最佳化對應至業務價值成果。舉例來說,在買方研究部門,業務目標可能是最佳化每小時研究產出,或優先處理過往成效良好團隊的實驗,例如夏普比率較高的團隊。在賣方方面,您可以使用數據分析追蹤客戶興趣,並據此優先處理支援最有趣研究的 AI 模型。
將成效目標與業務主要成效指標 (KPI) 連結,對於資助成效改善也相當重要。與日常業務 (BAU) 或銀行營運作業相比,業務創新和轉型計畫 (有時稱為銀行變革工作) 的預算不同,且資源存取權限可能也不同。舉例來說, Google Cloud 協助 G-SIFI 的風險管理和技術團隊與前台量化分析師合作,在幾分鐘內 (而非數小時或數天) 執行風險分析計算 (例如 XVA)。這項解決方案協助該機構符合相關法規遵循要求。此外,交易員也能與客戶進行更高品質的對話,進而提供更小的價差、更穩定的流動性,以及更具成本效益的避險。
將成效指標與業務指標對齊時,請考慮下列建議:
- 將每項技術計畫與相關的業務目標和關鍵成果 (OKR) 連結,例如提高收益或利潤、降低成本,以及更有效率或更全面地降低風險。
- 著重於最佳化系統層級的效能。不要侷限於傳統的「改變銀行」與「經營銀行」區分,以及「前台」與「後台」的孤島。
優先考量安全性,不因未經證實的風險而犧牲效能
金融服務機構必須明確遵守高標準的安全性和法規遵循。維持高標準是避免流失客戶,以及防止組織品牌受到不可回復損害的關鍵。通常,最高價值來自生成式 AI 等技術創新,以及 Spanner 等獨特的代管服務。請勿因對營運風險或法規遵循情形不足的全面誤解,而自動捨棄這類技術選項。
Google Cloud 與 G-SIFI 密切合作,確保在機構服務客戶的所有管轄區,都能使用以 AI 為基礎的反洗錢 (AML) 方法。舉例來說,HSBC大幅提升金融犯罪 (Fincrime) 單位的績效,並取得以下成果:
- 確實可疑活動的偵測量提升近 2 至 4 倍。
- 減少超過 60% 的誤判情形,並將調查時間集中在有參考價值的高風險快訊,降低營運成本。
- 可稽核且可理解的輸出內容,有助於遵守法規遵循。
請參考下列建議:
- 確認您打算使用的產品,有助於滿足營運所在管轄區的安全、韌性和法規遵循要求。為達成這個目標,請與 Google Cloud帳戶團隊、風險團隊和產品團隊合作。
- 運用 AI 可解釋性,建立更強大的模型,並向客戶提供透明資訊。
如果可解釋性不足,請將價值流中的決策步驟分開,並僅使用 AI 自動化非決策步驟。在某些情況下,可解釋 AI 可能不夠充分,或基於法規考量 (例如 GDPR 第 22 條),程序可能需要人工介入。在這種情況下,請在單一控制窗格中,提供真人服務專員決策所需的所有資訊,但自動執行資料收集、擷取、操控和摘要工作。
重新思考架構,因應新商機和需求
運用雲端式功能強化現有架構,可帶來極大價值。如要取得更具變革性的成果,您需要定期採用雲端優先方法,重新思考架構。
請參考下列建議,定期重新思考工作負載的架構,進一步提升效能。
使用雲端式替代方案,取代地端部署 HPC 系統和排程器
如要充分運用更高的彈性、更完善的資安態勢,以及廣泛的監控和管理功能,您可以在雲端執行 HPC 工作負載,或將地端部署工作負載burst至雲端。不過,對於某些數值建模用途 (例如模擬投資策略或 XVA 建模),結合 Kubernetes 與 Kueue 可能會是更強大的解決方案。
切換至圖表式程式設計,進行模擬
在 Dataflow 等圖表式執行系統中,蒙地卡羅模擬的效能可能更佳。舉例來說,HSBC使用 Dataflow 執行風險計算,速度比先前的方法快 16 倍。
執行雲端式交易所和交易平台
與 Google Cloud 客戶對話後,我們發現80/20 帕雷托法則適用於市場和交易應用程式的效能需求。
- 超過 80% 的交易應用程式不需要極低延遲。不過,雲端的彈性、安全性和彈性功能可帶來顯著效益。舉例來說,外匯多交易商平台 BidFX 使用雲端快速推出新產品,並在不增加資源的情況下,大幅提高可用性和足跡。
- 其餘應用程式 (不到 20%) 則需要低延遲 (不到一毫秒)、確定性和公平性,才能傳送訊息。傳統上,這些系統會在僵化且昂貴的主機代管機房中運作。不過,這類應用程式也越來越常在雲端重新平台化,無論是在邊緣或做為雲端優先應用程式。
採用與時俱進的技術,滿足目前和未來的業務需求
過去,許多金融服務機構會建構專有技術,以取得競爭優勢。舉例來說,在 2000 年代初期,成功的投資銀行和交易公司會自行實作基礎技術,例如發布/訂閱系統和訊息代理程式。隨著開放原始碼技術和雲端的演進,這類技術已成為商品,無法提供額外的商業價值。
請參考下列建議,確保技術與時俱進。
採用資料即服務 (DaaS) 做法,加快上市速度並提高成本透明度
金融服務機構通常會透過有機成長和併購 (M&A) 雙管齊下,因此,組織需要整合不同的技術。此外,他們也需要管理重複的資源,例如資料供應商、資料授權和整合點。 Google Cloud 提供機會,在合併後整合中創造差異化價值。
舉例來說,您可以使用 BigQuery 共用等服務,建構可立即分析的資料即服務 (DaaS) 平台。平台可提供市場資料和替代來源的輸入內容。這種做法可避免建構多餘的資料管道,讓您專注於更有價值的工作。此外,合併或收購的公司可以快速有效地合理化合併後的資料授權和基礎架構需求。合併後的企業可以專注於新的商機,而不必花費心力調整及合併舊版資料資產和作業。
建立抽象層,隔離現有系統並因應新興商業模式
銀行的競爭優勢越來越不取決於核心銀行系統,而是客戶體驗層。不過,傳統銀行系統通常使用以 Cobol 等語言開發的單體式應用程式,並整合至整個銀行價值鏈。這種整合方式使得價值鏈的各層難以分離,因此幾乎不可能升級和翻新這類系統。
解決這項挑戰的方法之一,是使用隔離層 (例如 API 管理系統),或使用 Spanner 等暫存層,複製記錄簿,並透過進階數據分析和 AI 促進服務現代化。舉例來說,德意志銀行使用 Spanner 隔離舊有的核心銀行資產,並展開創新之旅。