


Google Cloud 基礎架構服務在全球各地運作。這些位置分為故障域,稱為「區域」和「可用區」,是為雲端工作負載設計可靠基礎架構的基本構成要素。
故障域是指資源或資源群組,其故障不會影響其他資源。獨立的 Compute Engine VM 就是故障域資源。 Google Cloud 區域或可用區就是由一組資源組成的故障域。如果應用程式備援分布在多個故障域,則可達到比各個故障域更高的匯總可用性。
Google Cloud 基礎架構可靠性指南的這個部分說明 Google Cloud 可靠性的建構模塊,以及這些模塊如何影響雲端資源的可用性。
區域和可用區
「區域」是獨立的地理區域,由多個「可用區」組成。可用區和區域都是底層實體資源的邏輯抽象化概念。如要進一步瞭解特定區域的注意事項,請參閱「地理位置與區域」一文。
平台適用情形
Google Cloud 基礎架構在設計上可容許故障並從中復原。Google 持續投入創新方法,以維護及提升 Google Cloud的可靠性。Google Cloud 基礎架構具備下列功能,可為雲端工作負載提供可靠的平台:
- 將資料儲存在多個各自獨立的地理區域,降低天災和區域性服務中斷對全球性服務的影響。
- 硬體備援和複製功能,避免單點故障。
- 在維護事件期間即時遷移資源。舉例來說,在預定的基礎架構維護期間,Compute Engine VM 可以透過即時遷移功能,移至相同可用區的其他主機。
- Google Cloud 採用的實體基礎架構和軟體,從設計之初就融入安全考量,並提供作業安全控管機制,保護您的資料和工作負載。詳情請參閱「Google 基礎架構安全性設計總覽」。
- 高效能骨幹網路,採用先進的 軟體定義網路 (SDN) 網路管理方法,並提供邊緣快取服務,可提供一致且可擴充的效能。
- 持續監控及回報。您可以使用Google Cloud Service Health 資訊主頁,查看各位置的Google Cloud 服務狀態。
- 每年以整個公司為範圍,進行災難復原測試 (DiRT) 活動,確保 Google Cloud 服務和內部業務營運在災難發生時,也能繼續正常運作。
- 變更管理方法:強調在軟體開發生命週期的所有階段,對 Google Cloud 平台和服務進行任何變更時,都必須確保可靠性。
Google Cloud 基礎架構的設計旨在支援下列目標可用性等級,適用於大多數客戶工作負載:
| 部署位置 | 可用性 (正常運作時間) % | 預估停機時間上限 |
|---|---|---|
| 單一可用區 | 3 個 9:99.9% | 在 30 天的月份中為 43.2 分鐘 |
| 區域中的多個可用區 | 4 個 9:99.99% | 4.3 分鐘 (以 30 天為一個月計算) |
| 多個區域 | 5 個 9:99.999% | 26 秒 (以 30 天為一個月計算) |
上表中的可用性百分比為目標值。特定 Google Cloud 服務的正常運作時間服務水準協議 (SLA) 可能與這些可用性目標不同。舉例來說,Bigtable 執行個體的運作時間服務水準協議取決於叢集數量、叢集在各位置的分佈情形,以及您設定的路由政策。
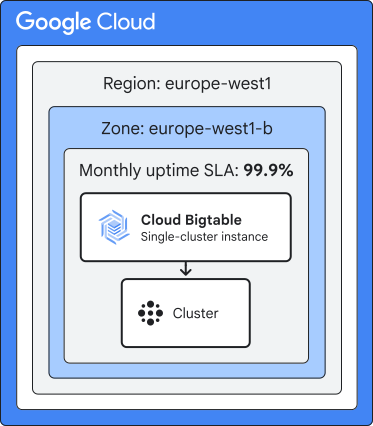
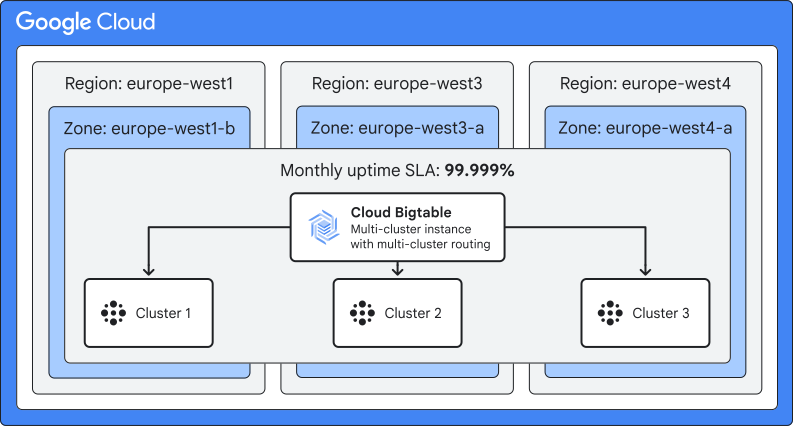
如果設定多叢集路由政策,則在三個以上區域中具有叢集的 Bigtable 執行個體,其最低運作時間服務水準協議為 99.999%。不過,如果設定單一叢集路由政策,則無論叢集數量和分布情況為何,最低運作時間服務水準協議均為 99.9%。
本節的圖表顯示不同叢集大小的 Bigtable 執行個體,以及其運作時間服務水準協議的差異。
單一叢集
下圖顯示單一叢集 Bigtable 執行個體,其最低運作時間服務水準協議為 99.9%:
多個叢集
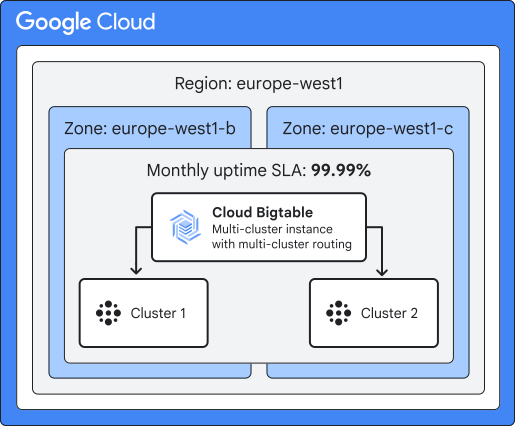
下圖顯示單一區域內多個可用區中的多叢集 Bigtable 執行個體,並具備多叢集轉送功能 (最低運作時間服務水準協議:99.99%):
多個叢集
下圖顯示三個區域中的多叢集 Bigtable 執行個體,並採用多叢集轉送 (最低運作時間服務水準協議:99.999%):
匯總基礎架構可用性
本節說明如何計算 Google Cloud中基礎架構堆疊的匯總可用性。說明影響匯總可用性的因素,並提供計算範例。
如要在 Google Cloud中執行應用程式,您需要使用 VM 和資料庫等基礎架構資源。這些基礎架構資源共同構成應用程式的基礎架構堆疊。下圖顯示 Google Cloud 中的基礎架構堆疊範例,以及堆疊中各項資源的可用性服務水準協議:
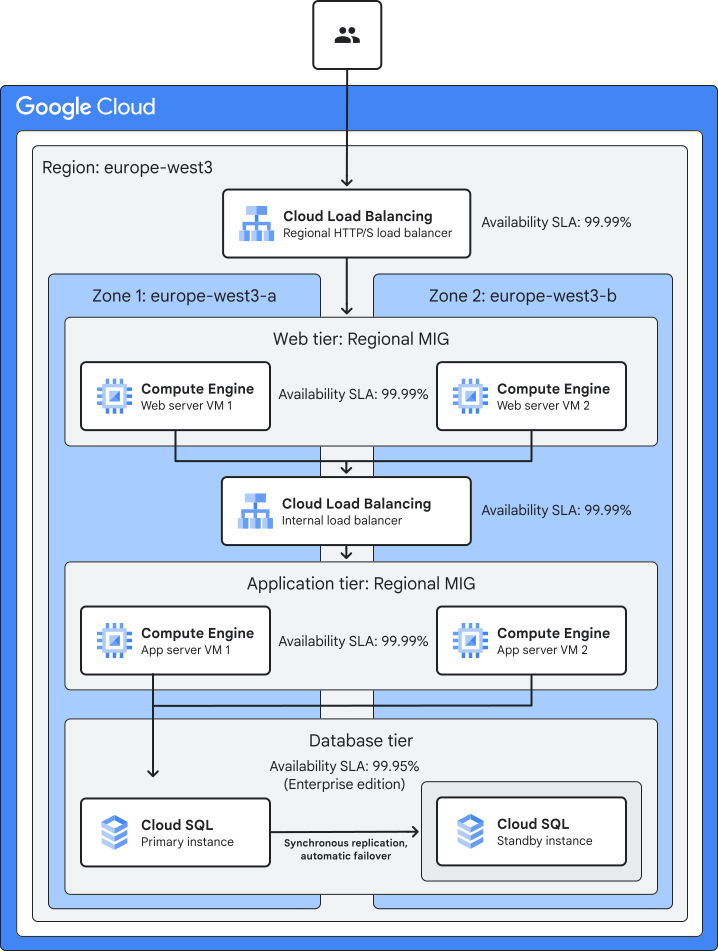
這個範例基礎架構堆疊包含下列 Google Cloud資源:
- 區域性外部應用程式負載平衡器會接收及回應使用者要求。
- 區域性代管執行個體群組 (MIG) 是區域性外部應用程式負載平衡器的後端。MIG 包含兩個位於不同可用區的 Compute Engine VM。每個 VM 都會託管網路伺服器的執行個體。
- 內部負載平衡器會處理網路伺服器和應用程式伺服器之間的通訊。
- 第二個區域性 MIG 是內部負載平衡器的後端。這個 MIG 有兩個 Compute Engine VM,位於不同可用區。每個 VM 都會託管應用程式伺服器的執行個體。
- 設定為高可用性的 Cloud SQL 執行個體是應用程式的資料庫。主要資料庫執行個體會同步複製到待命資料庫執行個體。
如上例所示,基礎架構堆疊的預期匯總可用性取決於下列因素:
Google Cloud 服務水準協議
您在基礎架構堆疊中使用的 Google Cloud 服務正常運作時間服務水準協議,會影響您可預期的堆疊最低匯總可用性。
下表比較部分服務的運作時間服務水準協議:
| 運算服務 | 每月運作時間服務水準協議 | 30 天內預估最長停機時間 |
|---|---|---|
| Compute Engine VM | 99.9% | 43.2 分鐘 |
| 多個可用區中的 Google Kubernetes Engine (GKE) Autopilot Pod | 99.9% | 43.2 分鐘 |
| Cloud Run 服務 | 99.95% | 21.6 分鐘 |
| 資料庫服務 | 每月正常運作時間服務水準協議 | 30 天內預估最長停機時間 |
|---|---|---|
| PostgreSQL 適用的 Cloud SQL 執行個體 (Enterprise 版本,高可用性設定) | 99.95% | 21.6 分鐘 |
| AlloyDB for PostgreSQL 執行個體 (高可用性設定) | 99.99% | 4.3 分鐘 |
| Spanner 多區域執行個體 | 99.999% | 26 秒 |
如要瞭解其他 Google Cloud 服務的服務水準協議,請參閱「Google Cloud 服務水準協議」。
如上表所示,您為基礎架構堆疊各層選擇的 Google Cloud 服務,會直接影響基礎架構堆疊的預期整體運作時間。如要提高部署在 Google Cloud 資源上的工作負載預期可用性,您可以佈建資源的備援執行個體,詳情請參閱下一節。
資源備援
資源備援是指佈建兩個以上相同的資源執行個體,並在群組中的所有資源上部署相同的工作負載。舉例來說,如要託管應用程式的網路層,您可以佈建包含多個相同 Compute Engine VM 的 MIG。
如果您將一組資源備援分配到多個故障域 (例如兩個 Google Cloud 可用區),則該群組的預期資源可用性會高於群組中每個資源的運作時間服務水準協議。之所以能提高可用性,是因為群組中「所有」資源同時故障的機率,低於單一故障域中資源協調故障的機率。
舉例來說,如果資源的可用性服務水準協議為 99.9%,則資源失敗的機率為 0.001 (1 減去服務水準協議)。如果您將工作負載分配到兩個在不同故障域佈建的資源執行個體,則兩個資源同時故障的機率為 0.000001 (即 0.001 x 0.001)。這個故障機率換算成兩個資源群組的「理論」可用性為 99.9999%。不過,實際可用性會受限於部署位置的目標可用性:如果資源位於單一Google Cloud 可用區,則為 99.9%;多可用區部署為 99.99%;如果備援資源分布在多個區域,則為 99.999%。
堆疊深度
基礎架構堆疊的深度是指堆疊中不重複層級 (或層) 的數量。基礎架構堆疊中的每個層級都包含資源,可為應用程式提供不同的功能。舉例來說,三層式堆疊的中間層可能會使用 Compute Engine VM 或 GKE 叢集來託管應用程式伺服器。基礎架構堆疊中的每個層級,通常與相鄰層級有緊密的相互依賴關係。也就是說,如果堆疊的任何層級無法使用,整個堆疊就會無法使用。
您可以使用下列公式,計算 N 層基礎架構堆疊的預期匯總可用性:
舉例來說,如果三層式堆疊中的每一層都設計為提供 99.9% 的可用性,則堆疊的匯總可用性約為 99.7% (0.999 x 0.999 x 0.999)。也就是說,多層級堆疊的匯總可用性,低於可用性最低的層級。
隨著堆疊中相互依賴的層級數量增加,堆疊的匯總可用性會降低,如下表所示。表格中的每個範例堆疊都有不同數量的層級,且每個層級都假設提供 99.9% 的可用性。
| 級別 | 堆疊 A | 堆疊 B | 堆疊 C |
|---|---|---|---|
| 前端 | 99.9% | 99.9% | 99.9% |
| 應用程式層級 | 99.9% | 99.9% | 99.9% |
| 中級 | - | 99.9% | 99.9% |
| 資料級別 | - | - | 99.9% |
| 堆疊的匯總可用性 | 99.8% | 99.7% | 99.6% |
| 在 30 天內,堆疊預估最長停機時間 | 86 分鐘 | 130 分鐘 | 173 分鐘 |
設計須知摘要
設計應用程式時,請考量Google Cloud 基礎架構堆疊的匯總可用性。
- 基礎架構堆疊中各項 Google Cloud 資源的可用性,會影響堆疊的匯總可用性。選擇 Google Cloud 服務來建構基礎架構堆疊時,請考量服務的可用性服務水準協議。
- 如要提高資源提供的功能 (例如運算或資料庫) 可用性,您可以佈建資源的備援執行個體。設計具有備援資源的架構時,除了可用性優勢外,您也必須考量對作業複雜度、延遲時間和成本的潛在影響。
- 基礎架構堆疊中的層數 (即堆疊深度) 與堆疊的匯總可用性成反比。設計或修改堆疊時,請考量這項關係。
如需更多匯總可用性計算範例,請參閱下列各節:
位置範圍
Google Cloud 資源的位置範圍決定了基礎架構故障對資源的影響程度。在 Google Cloud 中佈建的大多數資源,都屬於下列其中一種位置範圍:可用區、區域、多區域或全球。
某些資源類型的位置範圍是固定的,也就是說,您無法選擇或變更位置範圍。舉例來說,虛擬私有雲 (VPC) 網路是全域資源,而 Compute Engine 虛擬機器 (VM) 是可用區資源。佈建特定資源時,您可以選擇位置範圍。舉例來說,建立 GKE 叢集時,您可以選擇建立可用區或區域性 GKE 叢集。
以下各節將詳細說明位置範圍。
可用區資源
可用區資源會部署在 Google Cloud區域中的單一可用區。以下是可用區資源的範例。這份清單僅列出部分示例。
- Compute Engine VM
- 可用區 MIG
- Google Cloud Hyperdisk 磁碟區
- 單一可用區 GKE 叢集
- Filestore Basic 和 Zonal 執行個體
- Dataflow 工作
- Cloud SQL 執行個體
- Compute Engine 上的 Managed Service for Apache Spark 叢集
可用區故障可能會影響在該可用區內佈建的可用區資源。可用區的設計旨在盡可能降低與區域內其他可用區發生相關故障的風險。一個可用區故障,通常不會影響該區域其他可用區的資源。此外,可用區故障不一定會導致該可用區中的「所有」基礎架構都無法使用。可用區只是定義故障影響的預期邊界。
如要保護使用可用區資源的應用程式,避免受到可用區事件影響,您可以將資源分散或複製到多個可用區或區域。詳情請參閱「在 Google Cloud中為工作負載設計可靠的基礎架構」。
地區資源
區域性資源會以備援方式,部署在區域內的多個可用區。以下是區域資源的範例。這份清單僅列出部分示例。
- 地區性 MIG
- 區域 Cloud Storage bucket
- Google Cloud Hyperdisk Balanced High Availability 磁碟區
- 採用預設 (多可用區) 設定的區域性 GKE 叢集
- 虛擬私人雲端子網路
- 區域性外部應用程式負載平衡器
- 區域性 Spanner 執行個體
- Filestore Enterprise 執行個體
- Cloud Run 服務
區域性資源可抵禦特定可用區中的事件。區域中斷可能會影響在該區域內佈建的部分或所有區域資源。這類服務中斷可能是由自然災害或大規模基礎架構故障所造成。
多區域資源
多區域資源分布於特定區域。以下是多區域資源的範例。請注意,這份清單僅列出部分示例。
- 雙區域和多區域 Cloud Storage bucket
- 多區域 Spanner 執行個體
- 多叢集 (多區域) Bigtable 執行個體
- Cloud Key Management Service 中的多區域金鑰環
如需多區域設定中可用的 Google 服務完整清單,請參閱「依位置列出的可用產品」。
多區域資源可彈性因應特定區域和可用區的事件。如果多個區域發生基礎架構中斷,可能會影響在受影響區域中佈建的部分或所有多區域資源可用性。
全球性資源
全域資源適用於所有 Google Cloud 位置。以下是全域資源的範例。請注意,這份清單僅列出部分示例。
專案。如需將Google Cloud 資源整理至資料夾和專案的指南和最佳做法,請參閱「決定 Google Cloud 到達區的資源階層」。
虛擬私有雲網路,包括相關聯的路徑和防火牆規則
Cloud DNS 區域
全域外部應用程式負載平衡器
Cloud KMS 中的全域金鑰環
Pub/Sub 主題
Secret Manager 中的 Secret
如需全球適用的 Google 服務完整清單,請參閱「全球產品」。
全域資源可抵禦可用區和區域事件。這些資源不依賴任何特定區域的基礎架構。 Google Cloud 具備系統和程序,有助於盡可能降低全球基礎架構中斷的風險。Google 也會持續監控基礎架構,並迅速解決任何全球性服務中斷問題。
下表摘要說明可用區、區域、多區域和全域資源,在應用程式和基礎架構問題方面的相對韌性。此外,也會說明設定這些資源所需的工作,以及減輕服務中斷影響的建議。
| 資源範圍 | 營運韌性 | 降低基礎架構中斷影響的建議 |
|---|---|---|
| 可用區 | 低 | 在多個可用區或區域中備援部署資源。 |
| 區域 | 中 | 以備援的形式將資源部署至多個區域。 |
| 多區域或全域 | 高 | 請謹慎管理變更,並盡可能使用縱深防禦備用方案。詳情請參閱「管理全球資源中斷風險的建議」。 |
管理全域資源中斷風險的建議
如要利用全域資源的彈性,因應可用區和區域中斷,建議您在架構中使用特定全域資源。Google 建議採用下列方法,管理全域資源中斷的風險:
謹慎管理全域資源變更
全域資源可抵禦實體故障。這類資源的設定範圍為全域。因此,設定單一全域資源比操作多個區域性資源更簡單。不過,如果全域資源的設定發生重大錯誤,可能會導致單點故障 (SPOF)。舉例來說,您可以使用全域負載平衡器,做為地理位置分散應用程式的前端。全域負載平衡器通常是這類應用程式的理想選擇。不過,如果負載平衡器的設定有誤,可能會導致所有地理區域都無法使用。為避免這種風險,您必須謹慎管理全域資源的設定變更。詳情請參閱「控管全域資源的變更」。
使用區域資源做為縱深防禦備用方案
如果應用程式對高可用性的要求極高,區域縱深防禦備用機制可盡量降低全域性資源中斷的影響。以地理位置分散的應用程式為例,該應用程式的前端是全域負載平衡器。為確保應用程式在全域負載平衡器受到全域中斷影響時仍可存取,您可以部署區域性負載平衡器。您可以將用戶端設為優先使用全域負載平衡器,但如果全域負載平衡器無法使用,則容錯移轉至最近的區域性負載平衡器。
為防範全域負載平衡器服務中斷和設定錯誤,您可以使用 Cloud DNS 和區域性備份負載平衡器,實作自動容錯移轉或略過策略。詳情請參閱「全域外部應用程式負載平衡器的容錯移轉策略」。
包含可用區、區域和全域資源的架構範例
雲端拓撲可以包含可用區、區域和全域資源的組合,如下圖所示。下圖顯示在Google Cloud中部署的多層式應用程式架構範例。
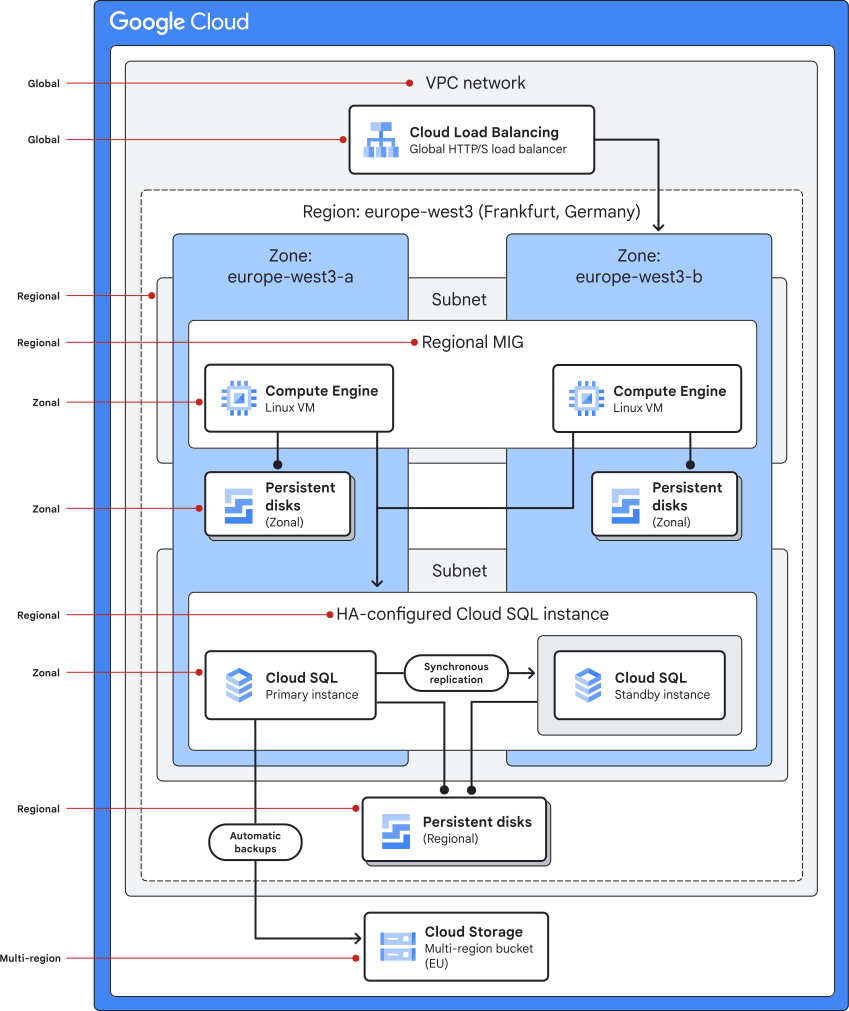
如上圖所示,全域外部應用程式負載平衡器會接收用戶端要求。負載平衡器會將要求分配至後端,也就是具有兩個 Compute Engine VM 的區域性 MIG。在 VM 上執行的應用程式會對 Cloud SQL 資料庫寫入及讀取資料。資料庫已設為高可用性。資料庫的主要和待命執行個體會佈建在不同的可用區,主要資料庫會同步複製到待命資料庫。此外,資料庫會自動備份到 Cloud Storage 的多區域 bucket。
下表摘要說明上述架構中的 Google Cloud 資源,以及各項資源對可用區和區域中斷的復原能力:
| 資源 | 服務中斷時的復原能力 |
|---|---|
| 虛擬私有雲網路 | 虛擬私有雲網路 (包括相關聯的路由和防火牆規則) 屬於全域性資源,可抵禦可用區和區域中斷。 |
| 子網路 | 虛擬私有雲子網路屬於區域性資源,可因應可用區中斷。 |
| 全域外部應用程式負載平衡器 | 全域外部應用程式負載平衡器可彈性因應可用區和區域中斷。 |
| 區域性 MIG | 區域性 MIG 可因應可用區中斷情形。 |
| Compute Engine VM | Compute Engine VM 是可用區資源。如果可用區發生中斷,個別 Compute Engine VM 可能會受到影響。不過,由於負載平衡器的後端是區域性 MIG,而非獨立 VM,因此應用程式可以繼續提供要求。 |
| Cloud SQL 執行個體 | 這個架構中的 Cloud SQL 部署作業已設定為高可用性,也就是說,部署作業包含一組主要/待命資料庫執行個體。主要資料庫會使用 Hyperdisk Balanced High Availability 磁碟區,同步複製到待命資料庫。
|
| 多區域 Cloud Storage bucket | 儲存在多區域 Cloud Storage bucket 中的資料,可抵禦單一區域服務中斷。 |
| Hyperdisk 磁碟區 | Hyperdisk 磁碟區是可用區資源。如要確保高可用性,可以使用 Hyperdisk Balanced High Availability 磁碟區。資料會在同一區域的兩個可用區之間同步複製。為因應區域服務中斷,您可以安排 Hyperdisk 磁碟區快照,並將快照儲存在多區域 Cloud Storage bucket。 |