


במאמר הזה מתוארות שתי ארכיטקטורות לדוגמה שיעזרו לכם ליצור פלטפורמת למידה מאוחדת ב- Google Cloud באמצעות Google Kubernetes Engine (GKE). ארכיטקטורות העזר והמשאבים המשויכים שמתוארים במסמך הזה תומכים באפשרויות הבאות:
- למידה משותפת (Federated) בין מאגרי מידע נפרדים
- למידה משותפת (Federated) בין מכשירים, שמבוססת על ארכיטקטורה של למידה משותפת בין מאגרי מידע
המסמך הזה מיועד לאדריכלי ענן ולמהנדסי AI ו-ML שרוצים להטמיע תרחישים לדוגמה של למידה מאוחדת ב-Google Cloud. הוא מיועד גם למקבלי החלטות ששוקלים אם להטמיע למידה מאוחדת ב- Google Cloud.
ארכיטקטורה
התרשימים בקטע הזה מציגים ארכיטקטורה של למידה משולבת בין מאגרי מידע ובין מכשירים. בקטע תרחישים לדוגמה מוסבר על האפליקציות השונות של הארכיטקטורות האלה.
ארכיטקטורה חוצת-מאגרים
התרשים הבא מציג ארכיטקטורה שתומכת בלמידה מאוחדת בין מאגרי מידע:
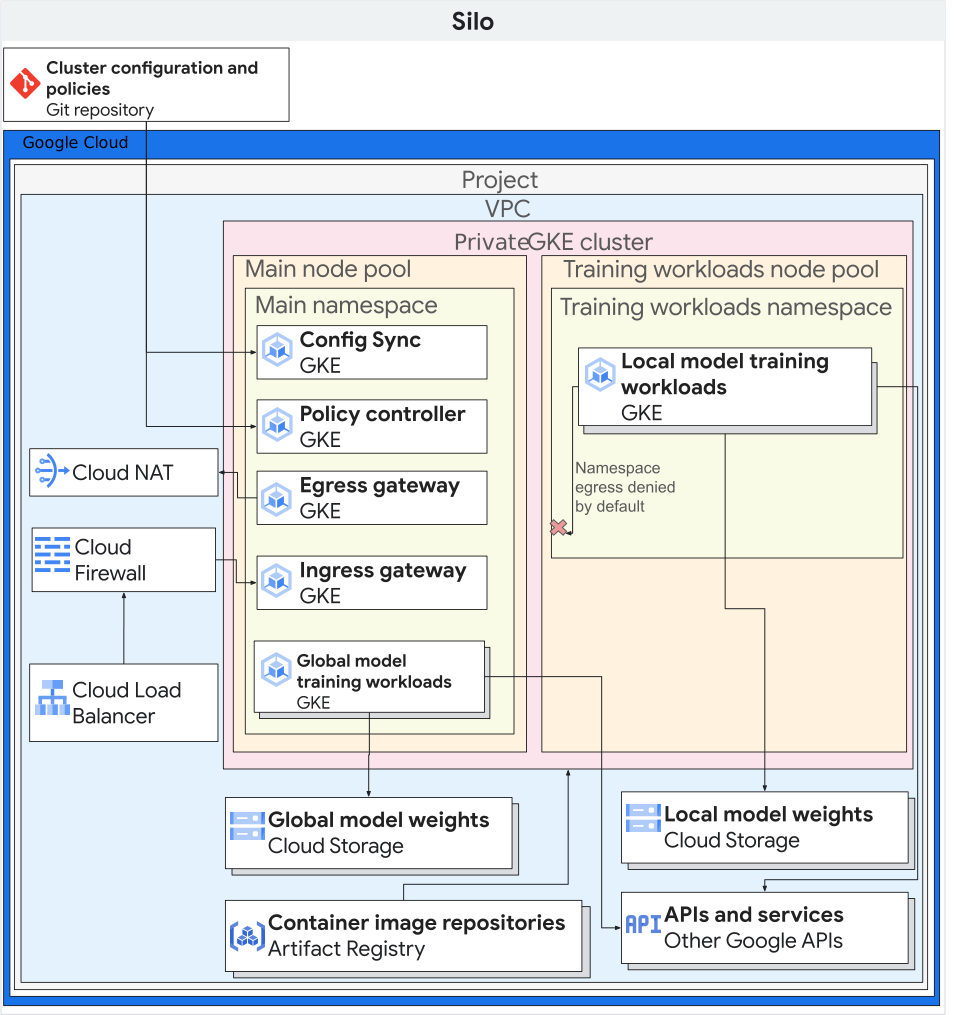
התרשים הקודם מציג דוגמה פשוטה לארכיטקטורה של מאגרים נפרדים. בתרשים, כל המשאבים נמצאים באותו פרויקט בארגון ב- Google Cloud. המשאבים האלה כוללים את מודל הלקוח המקומי, את מודל הלקוח הגלובלי ואת עומסי העבודה המשויכים אליהם של למידה מאוחדת.
אפשר לשנות את ארכיטקטורת העזר הזו כדי לתמוך בכמה הגדרות אישיות של סילו נתונים. חברי הקונסורציום יכולים לארח את סילו הנתונים שלהם בדרכים הבאות:
- ב- Google Cloud, באותו ארגון ( Google Cloud ) ובאותו פרויקט ( Google Cloud).
- ב- Google Cloud, באותו ארגון Google Cloud , בפרויקטים שונים שלGoogle Cloud .
- ב- Google Cloud, בארגונים שונים של Google Cloud .
- בסביבות פרטיות, מקומיות או בעננים ציבוריים אחרים.
כדי שהחברים המשתתפים יוכלו לשתף פעולה, הם צריכים ליצור ערוצי תקשורת מאובטחים בין הסביבות שלהם. בקטע תרחישים לדוגמה מוסבר בהרחבה על התפקיד של החברים המשתתפים במאמץ הלמידה המשותפת, על האופן שבו הם משתפים פעולה ועל מה שהם משתפים זה עם זה.
הארכיטקטורה כוללת את הרכיבים הבאים:
- רשת ותת-רשת של ענן וירטואלי פרטי (VPC).
- אשכול GKE פרטי שמאפשר לכם:
- בידוד צומתי אשכול מהאינטרנט.
- כדי להגביל את החשיפה של צומתי האשכול ומישור הבקרה לאינטרנט, אפשר ליצור אשכול GKE פרטי עם רשתות מורשות.
- להשתמש בצומתי אשכולות מוגנים שמשתמשים בתמונת מערכת הפעלה מוקשחת.
- מפעילים את Dataplane V2 כדי לבצע אופטימיזציה של רשתות Kubernetes.
- מאגרי צמתים ייעודיים של GKE: אתם יוצרים מאגר צמתים ייעודי לאירוח בלעדי של אפליקציות ומשאבים של דיירים. לצמתים יש taints כדי לוודא שרק עומסי העבודה של הדייר מתוזמנים לצמתים של הדייר. משאבי אשכול אחרים מתארחים במאגר הצמתים הראשי.
הצפנת נתונים (מופעלת כברירת מחדל):
- נתונים באחסון.
- נתונים במעבר.
- סודות של אשכולות בשכבת האפליקציה.
הצפנת נתונים בשימוש, על ידי הפעלה אופציונלית של צמתים חסויים של Google Kubernetes Engine.
כללי חומת אש של VPC שכוללים את הדברים הבאים:
- כללי בסיס שחלים על כל הצמתים באשכול.
- כללים נוספים שחלים רק על צמתים במאגר הצמתים של הדייר. כללי חומת האש האלה מגבילים את תעבורת הנתונים הנכנסת והיוצאת מצומתי הדיירים.
Cloud NAT כדי לאפשר תעבורת נתונים יוצאת (egress) לאינטרנט.
רשומות Cloud DNS כדי להפעיל גישה פרטית ל-Google, כך שאפליקציות באשכול יוכלו לגשת לממשקי Google API בלי לעבור דרך האינטרנט.
חשבונות שירות, שהם:
- חשבון שירות ייעודי לצמתים במאגר הצמתים של הדייר.
- חשבון שירות ייעודי לאפליקציות של דיירים לשימוש עם איחוד שירותי אימות הזהות של עומסי עבודה.
תמיכה בשימוש בקבוצות Google לבקרת גישה מבוססת-תפקידים (RBAC) ב-Kubernetes.
מאגר Git לאחסון מתארי הגדרות אישיות.
מאגר ב-Artifact Registry לאחסון קובצי אימג' של קונטיינרים.
סנכרון תצורות ו-Policy Controller לפריסת הגדרות וכללי מדיניות.
שערים של Cloud Service Mesh כדי לאפשר באופן סלקטיבי תעבורת נתונים נכנסת ויוצאת באשכול.
קטגוריות של Cloud Storage לאחסון משקולות של מודלים גלובליים ומקומיים.
גישה לממשקי API אחרים של Google ושל Google Cloud . לדוגמה, יכול להיות שעומס עבודה של אימון צריך לגשת לנתוני אימון שמאוחסנים ב-Cloud Storage, ב-BigQuery או ב-Cloud SQL.
ארכיטקטורה של כמה מכשירים
התרשים הבא מציג ארכיטקטורה שתומכת בלמידה מאוחדת בכמה מכשירים:

הארכיטקטורה הקודמת של כמה מכשירים מבוססת על הארכיטקטורה של כמה מאגרים, בתוספת הרכיבים הבאים:
- שירות Cloud Run שמדמה מכשירים שמתחברים לשרת
- שירות Certificate Authority Service שיוצר אישורים פרטיים לשרת וללקוחות כדי להפעיל את
- Vertex AI TensorBoard כדי להמחיש את תוצאת האימון
- קטגוריה של Cloud Storage לאחסון המודל המאוחד
- אשכול GKE פרטי שמשתמש בצמתים חסויים כמאגר הראשי שלו, כדי לאבטח את הנתונים שבשימוש
הארכיטקטורה של המכשירים השונים משתמשת ברכיבים מפרויקט Federated Compute Platform (FCP) בקוד פתוח. הפרויקט הזה כולל את הפריטים הבאים:
- קוד לקוח לתקשורת עם שרת ולביצוע משימות במכשירים
- פרוטוקול לתקשורת בין לקוח לשרת
- נקודות חיבור עם TensorFlow Federated כדי להקל על הגדרת החישובים המאוגדים
אפשר לפרוס את רכיבי ה-FCP שמוצגים בתרשים שלמעלה כקבוצה של מיקרו-שירותים. הרכיבים האלה מבצעים את הפעולות הבאות:
- מצרף: המשימה הזו קוראת את הגרדיאנטים של המכשיר ומחשבת את התוצאה המצטברת באמצעות פרטיות דיפרנציאלית.
- אוסף: המשימה הזו פועלת מדי פעם כדי לשלוח שאילתות לגבי משימות פעילות וגרדיאנטים מוצפנים. המידע הזה קובע מתי מתחיל הצבירה.
- מעלה המודלים: המשימה הזו מאזינה לאירועים ומפרסמת תוצאות כדי שהמכשירים יוכלו להוריד מודלים מעודכנים.
- הקצאת משימות: שירות החזית הזה מחלק את משימות האימון למכשירים.
- ניהול משימות: המשרה הזו מנהלת משימות.
- מתזמן משימות: המשימה הזו פועלת מדי פעם או מופעלת על ידי אירועים ספציפיים.
המוצרים שהשתמשו בהם
הארכיטקטורות לדוגמה של שני תרחישי השימוש של למידה מאוחדת משתמשות ברכיבים הבאים של Google Cloud :
- Google Cloud Kubernetes Engine (GKE): הפלטפורמה הבסיסית ללמידה משותפת.
- TensorFlow Federated (TFF): TFF מספקת מסגרת בקוד פתוח ללמידת מכונה ולחישובים אחרים על נתונים מבוזרים.
בנוסף, GKE מספק את היכולות הבאות לפלטפורמת הלמידה המשותפת:
- אירוח של רכז הלמידה המשותפת: רכז הלמידה המשותפת אחראי לניהול תהליך הלמידה המשותפת. הניהול הזה כולל משימות כמו הפצת המודל הגלובלי למשתתפים, צבירת עדכונים מהמשתתפים ועדכון המודל הגלובלי. אפשר להשתמש ב-GKE כדי לארח את רכז הלמידה המשותפת באופן שמאפשר זמינות גבוהה וסקיילביליות.
- אירוח משתתפים בלמידה מאוחדת (Federated): המשתתפים בלמידה מאוחדת (Federated) אחראים לאמן את המודל הגלובלי על הנתונים מחנויות מקומיות שלהם. אפשר להשתמש ב-GKE כדי לארח משתתפים בלמידה משותפת (Federated) בצורה מאובטחת ומבודדת. הגישה הזו יכולה לעזור להבטיח שהנתונים של המשתתפים יישמרו באופן מקומי.
- ערוץ תקשורת מאובטח וניתן להרחבה: המשתתפים בלמידה המבוזרת צריכים להיות מסוגלים לתקשר עם רכז הלמידה המבוזרת בצורה מאובטחת וניתנת להרחבה. אפשר להשתמש ב-GKE כדי לספק ערוץ תקשורת מאובטח וניתן להתאמה בין המשתתפים לבין המתאם.
- ניהול מחזור החיים של פריסות למידה משותפת: אפשר להשתמש ב-GKE כדי לנהל את מחזור החיים של פריסות למידה משותפת. הניהול הזה כולל משימות כמו הקצאת משאבים, פריסת פלטפורמת הלמידה המבוזרת ומעקב אחרי הביצועים של פלטפורמת הלמידה המבוזרת.
בנוסף ליתרונות האלה, GKE מספק גם כמה תכונות שיכולות להיות שימושיות לפריסות של למידה מאוחדת, כמו:
- אשכולות אזוריים: ב-GKE אפשר ליצור אשכולות אזוריים, וכך לשפר את הביצועים של פריסות למידה מאוחדת על ידי צמצום זמן האחזור בין המשתתפים לבין המתאם.
- מדיניות רשת ב-Kubernetes: ב-GKE אפשר ליצור מדיניות רשת ב-Kubernetes, כדי לשפר את האבטחה של פריסות למידה מאוחדת באמצעות שליטה בתעבורת הנתונים בין המשתתפים לבין המתאם.
- איזון עומסים: ב-GKE יש כמה אפשרויות לאיזון עומסים, שעוזרות לשפר את יכולת ההתאמה לעומס (scalability) של פריסות הלמידה המשותפת על ידי חלוקת התנועה בין המשתתפים לבין המתאם.
TFF מספק את התכונות הבאות כדי להקל על ההטמעה של תרחישי שימוש בלמידה מאוחדת:
- היכולת לבטא באופן הצהרתי חישובים מאוחדים, שהם קבוצה של שלבי עיבוד שפועלים בשרת ובקבוצה של לקוחות. אפשר לפרוס את החישובים האלה בסביבות זמן ריצה שונות.
- אפשר ליצור אגרגטורים מותאמים אישית באמצעות קוד פתוח של TFF.
- תמיכה במגוון אלגוריתמים של למידה משותפת, כולל האלגוריתמים הבאים:
- מיצוע מאוחד: אלגוריתם שמחשב את הממוצע של הפרמטרים במודל של הלקוחות המשתתפים. הוא מתאים במיוחד לתרחישים שבהם הנתונים הומוגניים יחסית והמודל לא מורכב מדי. תרחישים נפוצים לדוגמה:
- המלצות בהתאמה אישית: חברה יכולה להשתמש בממוצע מאוחד כדי לאמן מודל שממליץ על מוצרים למשתמשים על סמך היסטוריית הרכישות שלהם.
- זיהוי הונאות: קבוצת בנקים יכולה להשתמש בממוצע מאוחד כדי לאמן מודל שמזהה עסקאות שמקורן בתרמית.
- אבחון רפואי: קבוצה של בתי חולים יכולה להשתמש בממוצע מאוחד כדי לאמן מודל לאבחון סרטן.
- Federated stochastic gradient descent (FedSGD): אלגוריתם שמשתמש ב-stochastic gradient descent כדי לעדכן את הפרמטרים של המודל. הוא מתאים לתרחישים שבהם הנתונים הטרוגניים והמודל מורכב. תרחישי שימוש נפוצים:
- עיבוד שפה טבעית: חברה יכולה להשתמש ב-FedSGD כדי לאמן מודל שמשפר את הדיוק של זיהוי הדיבור.
- זיהוי תמונות: חברה יכולה להשתמש ב-FedSGD כדי לאמן מודל שמזהה אובייקטים בתמונות.
- תחזוקה חזויה: חברה יכולה להשתמש ב-FedSGD כדי לאמן מודל שחוזה מתי מכונה עלולה להתקלקל.
- Federated Adam:
אלגוריתם שמשתמש באופטימיזציה של Adam כדי לעדכן את הפרמטרים של המודל.
תרחישי שימוש נפוצים:
- מערכות המלצות: חברה יכולה להשתמש ב-Federated Adam כדי לאמן מודל שממליץ על מוצרים למשתמשים על סמך היסטוריית הרכישות שלהם.
- דירוג: חברה יכולה להשתמש ב-Adam מאוחד כדי לאמן מודל שמדרג תוצאות חיפוש.
- חיזוי שיעור קליקים: חברה יכולה להשתמש ב-Adam מאוחד כדי לאמן מודל שחוזה את הסבירות שמשתמש ילחץ על מודעה.
- מיצוע מאוחד: אלגוריתם שמחשב את הממוצע של הפרמטרים במודל של הלקוחות המשתתפים. הוא מתאים במיוחד לתרחישים שבהם הנתונים הומוגניים יחסית והמודל לא מורכב מדי. תרחישים נפוצים לדוגמה:
תרחישים לדוגמה
בקטע הזה מתוארים תרחישים לדוגמה שבהם הארכיטקטורות "בין מאגרי מידע" ו"בין מכשירים" מתאימות לפלטפורמת הלמידה המשותפת שלכם.
למידה משותפת היא הגדרה של למידת מכונה שבה לקוחות רבים מאמנים מודל ביחד. התהליך הזה מנוהל על ידי רכז מרכזי, ונתוני האימון נשארים מבוזרים.
בפרדיגמה של למידה משותפת, הלקוחות מורידים מודל גלובלי ומשפרים אותו על ידי אימון מקומי על הנתונים שלהם. לאחר מכן, כל לקוח שולח את עדכוני המודל המחושבים שלו בחזרה לשרת המרכזי, שבו עדכוני המודל נצברים ונוצרת איטרציה חדשה של המודל הגלובלי. בארכיטקטורות לדוגמה האלה, עומסי העבודה של אימון המודלים פועלים ב-GKE.
למידה משותפת מממשת את עקרון הפרטיות של הגבלה על איסוף המידע, על ידי הגבלת הנתונים שנאספים בכל שלב של החישוב, הגבלת הגישה לנתונים, עיבוד הנתונים ואז מחיקתם בשלב מוקדם ככל האפשר. בנוסף, הגדרת הבעיה של למידה משותפת תואמת לשיטות נוספות לשמירה על הפרטיות, כמו שימוש בפרטיות דיפרנציאלית (DP) כדי לשפר את האנונימיזציה של המודל, כדי להבטיח שהמודל הסופי לא ישמור את הנתונים של המשתמשים הספציפיים.
בהתאם לתרחיש לדוגמה, לאימון מודלים באמצעות למידה מאוחדת יכולים להיות יתרונות נוספים:
- תאימות: במקרים מסוימים, התקנות עשויות להגביל את אופן השימוש בנתונים או את השיתוף שלהם. יכול להיות שנשתמש בלמידה משותפת כדי לעמוד בתקנות האלה.
- יעילות התקשורת: במקרים מסוימים, יעיל יותר לאמן מודל על נתונים מבוזרים מאשר לרכז את הנתונים. לדוגמה, מערכי הנתונים שנדרשים לאימון המודל גדולים מדי ואי אפשר להעביר אותם למקום מרכזי.
- הנגשת נתונים: למידה מאוחדת מאפשרת לארגונים לשמור את נתוני האימון מבוזרים במאגרי נתונים נפרדים לכל משתמש או לכל ארגון.
- מודל מדויק יותר: אימון המודל על נתונים אמיתיים של משתמשים (תוך שמירה על הפרטיות) ולא על נתונים סינתטיים (שנקראים לפעמים נתוני שרת proxy) מוביל בדרך כלל למודל מדויק יותר.
יש סוגים שונים של למידה מאוחדת, שמאופיינים לפי מקור הנתונים והמקום שבו מתבצעים החישובים המקומיים. הארכיטקטורות במסמך הזה מתמקדות בשני סוגים של למידה מאוחדת: למידה מאוחדת בין מאגרי מידע ולמידה מאוחדת בין מכשירים. סוגים אחרים של למידה מאוחדת לא נכללים במסמך הזה.
למידה מאוחדת מסווגת גם לפי אופן החלוקה של מערכי הנתונים, שיכול להיות:
- למידה מאוחדת אופקית (HFL): קבוצות נתונים עם אותן תכונות (עמודות) אבל דגימות שונות (שורות). לדוגמה, יכול להיות שבכמה בתי חולים יש רשומות של מטופלים עם אותם פרמטרים רפואיים, אבל אוכלוסיות המטופלים שונות.
- למידה מאוחדת אנכית (VFL): קבוצות נתונים עם אותן דגימות (שורות) אבל עם מאפיינים שונים (עמודות). לדוגמה, לבנק ולחברת מסחר אלקטרוני יכולים להיות נתוני לקוחות עם אנשים חופפים, אבל מידע פיננסי ומידע על רכישות שונה.
- Federated Transfer Learning (FTL): חפיפה חלקית בדגימות ובתכונות בין מערכי הנתונים. לדוגמה, לשני בתי חולים יכולים להיות תיקי מטופלים עם חפיפה מסוימת בין אנשים ופרמטרים רפואיים משותפים, אבל גם מאפיינים ייחודיים בכל מערך נתונים.
בחישוב מאוחד בין מאגרים, המשתתפים הם ארגונים או חברות. בפועל, מספר החברים בדרך כלל קטן (לדוגמה, עד מאה חברים). בדרך כלל משתמשים בחישוב בין מאגרים בתרחישים שבהם לארגונים המשתתפים יש קבוצות נתונים שונות, אבל הם רוצים לאמן מודל משותף או לנתח תוצאות נצברות בלי לשתף את הנתונים הגולמיים שלהם זה עם זה. לדוגמה, הסביבות של החברים המשתתפים יכולות להיות בארגונים שונים ב- Google Cloud , כמו במקרה שהם מייצגים ישויות משפטיות שונות, או באותו ארגון ב-Google Cloud , כמו במקרה שהם מייצגים מחלקות שונות של אותה ישות משפטית.
יכול להיות שהחברים המשתתפים לא יוכלו להתייחס לעומסי העבודה של חברים אחרים כישויות מהימנות. לדוגמה, יכול להיות שלחבר שמשתתף אין גישה לקוד המקור של עומס עבודה לאימון שהוא מקבל מצד שלישי, כמו המתאם. בגלל שאין להם גישה לקוד המקור, הם לא יכולים לוודא שאפשר לסמוך על עומס העבודה באופן מלא.
כדי למנוע מעומס עבודה לא מהימן לגשת לנתונים או למשאבים שלכם ללא הרשאה, מומלץ:
- פריסת עומסי עבודה לא מהימנים בסביבה מבודדת.
- לעומסי עבודה לא מהימנים, תנו רק את זכויות הגישה וההרשאות שנדרשות כדי להשלים את סבבי האימון שהוקצו לעומס העבודה.
כדי לעזור לכם לבודד עומסי עבודה שעלולים להיות לא מהימנים, הארכיטקטורות לדוגמה האלה מטמיעות אמצעי אבטחה, כמו הגדרת מרחבי שמות מבודדים של Kubernetes, שבהם לכל מרחב שמות יש מאגר ייעודי של צומתי GKE. כברירת מחדל, אסור לבצע תקשורת בין מרחבי שמות ותנועה נכנסת ויוצאת באשכול, אלא אם משנים את ההגדרה הזו באופן מפורש.
דוגמאות לתרחישים לדוגמה של למידה מאוחדת בין מאגרי מידע:
- זיהוי הונאות: אפשר להשתמש בלמידה משותפת כדי לאמן מודל לזיהוי הונאות על סמך נתונים שמופצים בין כמה ארגונים. לדוגמה, קונסורציום של בנקים יכול להשתמש בלמידה מאוחדת כדי לאמן מודל שמזהה עסקאות שמקורן בתרמית.
- אבחון רפואי: אפשר להשתמש בלמידה מאוחדת כדי לאמן מודל לאבחון רפואי על סמך נתונים שמופצים בין כמה בתי חולים. לדוגמה, קבוצה של בתי חולים יכולה להשתמש בלמידה מאוחדת כדי לאמן מודל לאבחון סרטן.
למידה משותפת בין מכשירים היא סוג של חישוב משותף שבו המשתתפים הם מכשירים של משתמשי קצה, כמו טלפונים ניידים, כלי רכב או מכשירי IoT. מספר החברים יכול להגיע למיליונים או אפילו לעשרות מיליונים.
תהליך הלמידה המשותפת בין מכשירים דומה לתהליך הלמידה המשותפת בין מאגרי מידע. עם זאת, צריך גם להתאים את ארכיטקטורת העזר כדי להביא בחשבון חלק מהגורמים הנוספים שצריך להתייחס אליהם כשמדובר באלפי עד מיליוני מכשירים. כדי לטפל בתרחישים שנתקלים בהם במקרים של למידה מאוחדת בין מכשירים, צריך לפרוס עומסי עבודה ניהוליים. לדוגמה, הצורך לתאם קבוצת משנה של לקוחות שתשתתף בסבב ההדרכה. הארכיטקטורה של התכונה "שירותים מרכזיים למכשירים שלך" מאפשרת לכם לפרוס את שירותי ה-FCP. בשירותים האלה יש עומסי עבודה עם נקודות חיבור ל-TFF. TFF משמש לכתיבת הקוד שמנהל את התיאום הזה.
דוגמאות לתרחישים לדוגמה של למידה מאוחדת בכמה מכשירים:
- המלצות אישיות: אתם יכולים להשתמש בלמידה מאוחדת (Federated) בכמה מכשירים כדי לאמן מודל של המלצות אישיות על נתונים שמופצים בכמה מכשירים. לדוגמה, חברה יכולה להשתמש בלמידה מאוחדת כדי לאמן מודל שממליץ למשתמשים על מוצרים על סמך היסטוריית הרכישות שלהם.
- עיבוד שפה טבעית (NLP): אפשר להשתמש בלמידה מאוחדת כדי לאמן מודל של עיבוד שפה טבעית על נתונים שמופצים בין כמה מכשירים. לדוגמה, חברה יכולה להשתמש בלמידה משותפת כדי לאמן מודל שמשפר את הדיוק של זיהוי הדיבור.
- חיזוי צורכי התחזוקה של הרכב: אפשר להשתמש בלמידה משותפת כדי לאמן מודל שחוזה מתי הרכב צפוי להזדקק לתחזוקה. המודל הזה יכול לעבור אימון על נתונים שנאספים מכמה כלי רכב. הגישה הזו מאפשרת למודל ללמוד מהחוויות של כל הרכבים, בלי לפגוע בפרטיות של רכב ספציפי.
בטבלה הבאה מפורטות התכונות של ארכיטקטורות חוצות-ממגורות וחוצות-מכשירים, ומוסבר איך לסווג את סוג התרחיש של למידה מאוחדת שרלוונטי לתרחיש לדוגמה שלכם.
| תכונה | חישובים מאוחדים בין מאגרי מידע שונים | חישובים מאוחדים חוצי-מכשירים |
|---|---|---|
| גודל האוכלוסייה | בדרך כלל קטן (לדוגמה, עד מאה מכשירים) | אפשרות להרחבה לאלפי, מיליוני או מאות מיליוני מכשירים |
| המשתתפים | ארגונים או חברות | מכשירים ניידים, מכשירי קצה, כלי רכב |
| חלוקת הנתונים הנפוצה ביותר | HFL, VFL, FTL | HFL |
| רגישות הנתונים | מידע רגיש שהמשתתפים לא רוצים לשתף אחד עם השני בפורמט גולמי | נתונים רגישים מדי לשיתוף עם שרת מרכזי |
| זמינות הנתונים | המשתתפים כמעט תמיד זמינים | רק חלק קטן מהמשתתפים זמינים בכל זמן נתון |
| תרחישים לדוגמה | זיהוי הונאות, אבחון רפואי, תחזית פיננסית | מעקב אחרי אימוני כושר, זיהוי דיבור, סיווג תמונות |
שיקולים שקשורים לעיצוב
בקטע הזה מוסבר איך להשתמש בארכיטקטורה לדוגמה כדי לפתח ארכיטקטורה אחת או יותר, בהתאם לדרישות הספציפיות שלכם בנושאי אבטחה, אמינות, יעילות תפעולית, עלות וביצועים.
שיקולים בתכנון ארכיטקטורה חוצת-מאגרים
כדי להטמיע ארכיטקטורה של למידה משותפת בין מאגרים ב-Google Cloud, צריך לעמוד בדרישות המוקדמות המינימליות הבאות, שמוסברות בפירוט בקטעים הבאים:
- הקמת קונסורציום ללמידה משותפת.
- קובעים את מודל שיתוף הפעולה שקונסורציום הלמידה המשותפת צריך להטמיע.
- הגדרת תחומי האחריות של הארגונים המשתתפים.
בנוסף לדרישות המוקדמות האלה, יש פעולות אחרות שבעלי האיחוד צריכים לבצע, שלא נכללות במסמך הזה, כמו:
- לנהל את קונסורציום הלמידה המשותפת.
- תכנון והטמעה של מודל שיתוף פעולה.
- להכין, לנהל ולהפעיל את נתוני האימון של המודל ואת המודל שבעלי האיחוד מתכוונים לאמן.
- ליצור, להכיל בקונטיינרים ולתזמר תהליכי עבודה של למידה משותפת.
- פריסה וניהול של עומסי עבודה של למידה משותפת (Federated).
- מגדירים את ערוצי התקשורת של הארגונים המשתתפים כדי להעביר נתונים באופן מאובטח.
הקמת קונסורציום ללמידה משותפת (Federated)
קונסורציום של למידה משותפת הוא קבוצת הארגונים שמשתתפים במאמץ של למידה משותפת בין מאגרים. הארגונים בקונסורציום משתפים רק את הפרמטרים של מודלי ה-ML, ואפשר להצפין את הפרמטרים האלה כדי להגביר את הפרטיות. אם קונסורציום הלמידה המשותפת מאפשר זאת, ארגונים יכולים גם לצבור נתונים שלא מכילים פרטים אישיים מזהים (PII).
קביעת מודל שיתוף פעולה לקונסורציום של הלמידה המשותפת (Federated)
קונסורציום של למידה מאוחדת יכול ליישם מודלים שונים של שיתוף פעולה, כמו:
- מודל ריכוזי שמורכב מארגון מתאם אחד, שנקרא בעלי האיחוד או מתזמר, ומקבוצה של ארגונים משתתפים או בעלי נתונים.
- מודל מבוזר שמורכב מארגונים שמתאמים ביניהם כקבוצה.
- מודל הטרוגני שמורכב מקונסורציום של ארגונים שונים, שכל אחד מהם מביא משאבים שונים לקונסורציום.
המסמך הזה מבוסס על ההנחה שמודל שיתוף הפעולה הוא מודל ריכוזי.
הגדרת תחומי האחריות של הארגונים המשתתפים
אחרי שבוחרים מודל שיתוף פעולה לקונסורציום של הלמידה המשותפת, הבעלים של האיחוד צריך לקבוע את תחומי האחריות של הארגונים המשתתפים.
הבעלים של האיחוד צריך גם לבצע את הפעולות הבאות כשהוא מתחיל לבנות קונסורציום של למידה מאוחדת:
- תיאום מאמצי הלמידה המשותפת.
- מתכננים ומטמיעים את המודל הגלובלי של ML ואת המודלים של למידת מכונה שרוצים לשתף עם הארגונים המשתתפים.
- מגדירים את סבבי הלמידה המאוחדת – הגישה לאיטרציה של תהליך האימון של ML.
- בוחרים את הארגונים המשתתפים שתורמים לכל סבב נתון של למידה מאוחדת. הקבוצה הזו נקראת קבוצה בעלת מאפיינים משותפים.
- תכנון והטמעה של הליך לאימות החברות בקונסורציום של הארגונים המשתתפים.
- מעדכנים את המודל הגלובלי של למידת המכונה ואת המודלים של למידת המכונה שרוצים לשתף עם הארגונים המשתתפים.
- לספק לארגונים המשתתפים את הכלים לאמת שקונסורציום הלמידה המשותפת עומד בדרישות הפרטיות, האבטחה והרגולציה שלהם.
- לספק לארגונים המשתתפים ערוצי תקשורת מאובטחים ומוצפנים.
- לספק לארגונים המשתתפים את כל הנתונים המצטברים הלא סודיים שהם צריכים כדי להשלים כל סבב של למידה מאוחדת.
הארגונים המשתתפים אחראים על:
- לספק ולתחזק סביבה מאובטחת ומבודדת (מאגר). המאגר הוא המקום שבו הארגונים המשתתפים מאחסנים את הנתונים שלהם, ושבו מתבצע אימון מודל ה-ML. הארגונים המשתתפים לא משתפים את הנתונים שלהם עם ארגונים אחרים.
- לאמן את המודלים שסופקו על ידי בעלי האיחוד באמצעות תשתית המחשוב שלהם והנתונים מחנויות מקומיות שלהם.
- לשתף את תוצאות אימון המודל עם בעלי הפדרציה בצורה של נתונים נצברים, אחרי הסרת כל הפרטים האישיים המזהים.
הבעלים של האיחוד והארגונים המשתתפים יכולים להשתמש ב-Cloud Storage כדי לשתף מודלים מעודכנים ותוצאות אימון.
הבעלים של האיחוד והארגונים המשתתפים משפרים את אימון המודל ל-ML עד שהמודל עומד בדרישות שלהם.
הטמעת למידה משותפת (Federated) ב- Google Cloud
אחרי שמקימים את קונסורציום הלמידה המשותפת ומחליטים איך הוא יפעל, מומלץ שהארגונים המשתתפים יבצעו את הפעולות הבאות:
- הקצאה והגדרה של התשתית הנדרשת לקונסורציום של הלמידה המשותפת.
- מטמיעים את מודל שיתוף הפעולה.
- התחלת תהליך הלמידה המשותפת.
הקצאה והגדרה של התשתית לקונסורציום של הלמידה המשותפת (Federated)
כשמקצים ומגדירים את התשתית לקונסורציום של הלמידה המשותפת, הבעלים של האיחוד אחראי ליצור ולהפיץ לארגונים המשתתפים את עומסי העבודה שמאמנים את המודלים של למידת המכונה המשותפת. מכיוון שצד שלישי (הבעלים של האיחוד) יצר וסיפק את עומסי העבודה, הארגונים המשתתפים צריכים לנקוט אמצעי זהירות כשהם פורסים את עומסי העבודה האלה בסביבות זמן הריצה שלהם.
הארגונים המשתתפים צריכים להגדיר את הסביבות שלהם בהתאם לשיטות המומלצות לאבטחה, ולהחיל אמצעי בקרה שמגבילים את ההיקף ואת ההרשאות שניתנות לכל עומס עבודה. בנוסף לשיטות המומלצות לאבטחה של כל אחד מהארגונים, מומלץ שבעלי האיחוד והארגונים המשתתפים יביאו בחשבון וקטורים של איומים שספציפיים ללמידה מאוחדת.
הטמעת מודל שיתוף הפעולה
אחרי שהתשתית של קונסורציום הלמידה המשותפת מוכנה, בעלי הקונסורציום מתכננים ומטמיעים את המנגנונים שמאפשרים לארגונים המשתתפים לקיים אינטראקציה זה עם זה. הגישה הזו פועלת לפי מודל שיתוף הפעולה שבחר הבעלים של האיחוד עבור קונסורציום הלמידה המשותפת.
התחלת תהליך הלמידה המשותפת (Federated)
אחרי הטמעת מודל שיתוף הפעולה, בעלי האיגוד מטמיעים את מודל ה-ML הגלובלי לאימון, ואת מודלי ה-ML לשיתוף עם הארגון המשתתף. אחרי שהמודלים האלה מוכנים, הבעלים של האיחוד מתחיל את הסבב הראשון של תהליך הלמידה המשותפת.
בכל סבב של תהליך הלמידה המשותפת, בעלי האיחוד מבצעים את הפעולות הבאות:
- מפיץ את המודלים של למידת המכונה כדי לשתף אותם עם הארגונים המשתתפים.
- ממתין לארגונים המשתתפים שיספקו את תוצאות האימון של מודלי ה-ML שבעלי האיחוד שיתפו.
- אוסף ומעבד את תוצאות האימון שהופקו על ידי הארגונים המשתתפים.
- מעדכן את המודל הגלובלי של למידת המכונה כשהוא מקבל תוצאות אימון מתאימות מהארגונים המשתתפים.
- מעדכן את המודלים של למידת המכונה כדי לשתף אותם עם החברים האחרים בקונסורציום, אם רלוונטי.
- מכין את נתוני האימון לסבב הבא של הלמידה המשותפת.
- מתחיל את הסבב הבא של הלמידה המשותפת.
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כשמשתמשים בארכיטקטורה לדוגמה הזו כדי לתכנן ולבנות פלטפורמה ללמידה מאוחדת ב-Google Cloud. ההנחיות האלה רלוונטיות לשתי הארכיטקטורות שמתוארות במסמך הזה.
עומסי העבודה של הלמידה המשותפת שאתם פורסים בסביבות שלכם עלולים לחשוף אתכם, את הנתונים שלכם, את המודלים של הלמידה המשותפת ואת התשתית שלכם לאיומים שיכולים להשפיע על העסק.
כדי לעזור לכם לשפר את האבטחה של סביבות למידה מאוחדת (Federated), ארכיטקטורות העזר האלה מגדירות אמצעי בקרה לאבטחה ב-GKE שמתמקדים בתשתית של הסביבות שלכם. יכול להיות שאמצעי הבקרה האלה לא יספיקו כדי להגן עליכם מפני איומים שספציפיים לעומסי העבודה ולתרחישי השימוש שלכם בלמידה מאוחדת. בגלל הספציפיות של כל עומס עבודה ותרחיש לדוגמה של למידה מאוחדת, אמצעי הבקרה לאבטחת ההטמעה של הלמידה המאוחדת לא נכללים במסמך הזה. מידע נוסף ודוגמאות לאיומים האלה זמינים במאמר שיקולי אבטחה של למידה מאוחדת.
אמצעי בקרה לאבטחה ב-GKE
בקטע הזה נסביר על אמצעי הבקרה שאתם יכולים להפעיל בארכיטקטורות האלה כדי לאבטח את אשכול GKE.
אבטחה משופרת של אשכולות GKE
הארכיטקטורות האלה לדוגמה עוזרות ליצור אשכול GKE שמיישם את הגדרות האבטחה הבאות:
- כדי להגביל את החשיפה של צומתי האשכול ומישור הבקרה לאינטרנט, אפשר ליצור אשכול GKE פרטי עם רשתות מורשות.
- להשתמש בצמתים מוגנים שמשתמשים בתמונת צומת מוקשחת עם סביבת זמן הריצה
containerd. - בידוד מוגבר של עומסי עבודה של דיירים באמצעות GKE Sandbox.
- הצפנה של נתונים במנוחה כברירת מחדל.
- הצפנה של נתונים במעבר כברירת מחדל.
- הצפנת סודות של אשכולות בשכבת האפליקציה.
- אפשר להצפין נתונים בשימוש על ידי הפעלת צומתי Google Kubernetes Engine סודיים.
למידע נוסף על הגדרות האבטחה של GKE, קראו את המאמרים הקשחת האבטחה באשכול ומידע על מרכז הבקרה של מצב האבטחה.
כללי חומת אש של VPC
כללי חומת האש של הענן הווירטואלי הפרטי (VPC) קובעים איזו תעבורת נתונים מותרת למכונות הווירטואליות של Compute Engine וממנה. הכללים מאפשרים לסנן תנועה ברמת פירוט של מכונה וירטואלית, בהתאם למאפיינים של שכבה 4.
אתם יוצרים אשכול GKE עם כללי ברירת המחדל של חומת האש של אשכול GKE. כללי חומת האש האלה מאפשרים תקשורת בין הצמתים באשכול לבין מישור הבקרה של GKE, ובין הצמתים ל-Pods באשכול.
אתם מחילים כללים נוספים של חומת האש על הצמתים במאגר הצמתים של הדייר. כללי חומת האש האלה מגבילים את תעבורת הנתונים היוצאת מהצמתים של הדייר. הגישה הזו יכולה להגביר את הבידוד של צומתי הדיירים. כברירת מחדל, כל תעבורת הנתונים היוצאת מהצמתים של הדייר נדחית. צריך להגדיר במפורש כל תעבורת נתונים יוצאת שנדרשת. לדוגמה, אתם יוצרים כללים של חומת אש כדי לאפשר תעבורת נתונים יוצאת (egress) מהצמתים של הדייר למישור הבקרה של GKE, ול-Google APIs באמצעות גישה פרטית ל-Google. כללי חומת האש מטרגטים את צומתי הדייר באמצעות חשבון השירות של מאגר צומתי הדייר.
מרחבי שמות
מרחבי שמות מאפשרים לכם לספק היקף למשאבים קשורים בתוך אשכול, למשל Pods, שירותים ובקרי שכפול. באמצעות מרחבי שמות, אתם יכולים להאציל את האחריות לניהול מקורות מידע שקשורים לנושא כיחידה אחת. לכן, מרחבי שמות הם חלק בלתי נפרד מרוב דפוסי האבטחה.
מרחבי שמות הם תכונה חשובה לבידוד של מישור הבקרה. עם זאת, הם לא מספקים בידוד של צמתים, בידוד של מישור הנתונים או בידוד של הרשת.
גישה נפוצה היא ליצור מרחבי שמות לאפליקציות ספציפיות. לדוגמה, אפשר ליצור את מרחב השמות myapp-frontend לרכיב ממשק המשתמש של אפליקציה.
הארכיטקטורות לדוגמה האלה עוזרות ליצור מרחב שמות ייעודי לאירוח של אפליקציות צד שלישי. מרחב השמות והמשאבים שלו נחשבים לדייר (tenant) בתוך האשכול. אתם מחילים כללי מדיניות ואמצעי בקרה על מרחב השמות כדי להגביל את היקף המשאבים במרחב השמות.
כללי מדיניות רשת ב-Kubernetes
כללי מדיניות רשת ב-Kubernetes אוכפים את זרימת התנועה ברשת בשכבה 4 באמצעות כללי חומת אש ברמת ה-Pod. מדיניות הרשת ב-Kubernetes מוגדרת ברמת מרחב השמות.
בארכיטקטורות לדוגמה שמתוארות במסמך הזה, אתם מחילים את מדיניות הרשת על מרחב השמות של הדייר שמארח את האפליקציות של הצד השלישי. כברירת מחדל, מדיניות הרשת ב-Kubernetes חוסמת את כל התנועה אל הפודים במרחב השמות וממנו. צריך להוסיף באופן מפורש לרשימת ההיתרים את כל התנועה הנדרשת. לדוגמה, כללי מדיניות הרשת בארכיטקטורות לדוגמה האלה מאפשרים באופן מפורש תעבורת נתונים לשירותי אשכול נדרשים, כמו ה-DNS הפנימי של האשכול ומישור הבקרה של Cloud Service Mesh.
סנכרון תצורות
סנכרון תצורות שומר על סנכרון של אשכולות GKE עם תצורות שמאוחסנות במקור מידע מהימן. מאגר Git משמש כמקור האמת היחיד (SSOT) להגדרות ולכללי המדיניות של האשכול. סנכרון ההגדרות הוא הצהרתי. הוא בודק באופן רציף את מצב האשכול ומחיל את המצב שהוגדר בקובץ התצורה כדי לאכוף את כללי המדיניות, וכך עוזר למנוע שינויים בתצורה.
מתקינים את סנכרון תצורות באשכול GKE. אתם מגדירים את סנכרון תצורות כך שיסנכרן את ההגדרות והמדיניות של האשכולות ממקור האמת. המשאבים המסונכרנים כוללים את:
- הגדרת Cloud Service Mesh ברמת האשכול
- כללי מדיניות אבטחה ברמת האשכול
- הגדרות ומדיניות ברמת מרחב השמות של הדייר, כולל מדיניות רשת ב-Kubernetes, חשבונות שירות, כללי RBAC והגדרות של Cloud Service Mesh
Policy Controller
Policy Controller הוא בקר הרשאות דינמי ל-Kubernetes, שאוכף כללי מדיניות מבוססי CustomResourceDefinition (CRD) שמופעלים על ידי Open Policy Agent (OPA).
בקרי אישור בקשות הם פלאגינים של Kubernetes שמיירטים בקשות לשרת ה-API של Kubernetes לפני שהאובייקט נשמר, אבל אחרי שהבקשה מאומתת ומאושרת. אתם יכולים להשתמש בבקרי הרשאות כדי להגביל את השימוש באשכול.
אתם מתקינים את Policy Controller באשכול GKE. הארכיטקטורות האלה כוללות דוגמאות למדיניות שיכולה לעזור לכם לאבטח את האשכול. אתם מחילים את כללי המדיניות באופן אוטומטי על האשכול באמצעות סנכרון תצורות. אתם מחילים את כללי המדיניות הבאים:
- כללי מדיניות נבחרים שעוזרים לאכוף את האבטחה של Pod. לדוגמה, אתם מחילים כללי מדיניות שמונעים מה-pods להריץ קונטיינרים עם הרשאות, ודורשים מערכת קובצי שורש לקריאה בלבד.
- כללי מדיניות מספריית התבניות של Policy Controller. לדוגמה, אתם מחילים מדיניות שלא מאפשרת שירותים מסוג NodePort.
Cloud Service Mesh
Cloud Service Mesh היא רשת שירותים (service mesh) שעוזרת לכם לנהל בקלות תקשורת מאובטחת בין שירותים. תרשימי העזר האלה לארכיטקטורות מגדירים את Cloud Service Mesh כך שיבצע את הפעולות הבאות:
- הזרקה אוטומטית של קובצי עזר חיצוניים.
- אכיפת תקשורת mTLS בין שירותים ברשת.
- מגבילה את תנועת הרשת היוצאת למארחים מוכרים בלבד.
- מגבילה את התנועה הנכנסת רק מלקוחות מסוימים.
- מאפשר להגדיר כללי מדיניות לאבטחת הרשת על סמך זהות השירות, במקום על סמך כתובת ה-IP של עמיתים ברשת.
- מגבילה את התקשורת המורשית בין השירותים ברשת. לדוגמה, אפליקציות במרחב השמות של הדייר יכולות לתקשר רק עם אפליקציות באותו מרחב שמות, או עם קבוצה של מארחים חיצוניים ידועים.
- מנתב את כל התנועה הנכנסת והיוצאת דרך שערי רשת, שבהם אפשר להחיל אמצעי בקרה נוספים על התנועה.
- תמיכה בתקשורת מאובטחת בין אשכולות.
דחיות (taints) וזיקות של צמתים
Node taints ו-node affinity הם מנגנונים של Kubernetes שמאפשרים לכם להשפיע על האופן שבו פודים מתוזמנים לצמתים של אשכולות.
צמתים עם טיינט דוחים פודים. Kubernetes לא יתזמן Pod לצומת עם taint, אלא אם ל-Pod יש toleration ל-taint. אפשר להשתמש ב-taints של צמתים כדי להקצות צמתים לשימוש רק על ידי עומסי עבודה או דיירים מסוימים. לרוב משתמשים ב-taints וב-tolerations באשכולות עם כמה דיירים. למידע נוסף, קראו את המאמר צמתים ייעודיים עם taints ו-tolerations.
הגדרת הזיקה של צומת מאפשרת להגביל Pods לצמתים עם תוויות מסוימות. אם לפוד יש דרישה לקרבה לצומת, Kubernetes לא יתזמן את הפוד לצומת אלא אם לצומת יש תווית שתואמת לדרישת הקרבה. אתם יכולים להשתמש בקרבה של צומת כדי לוודא שהפודים מתוזמנים לצמתים המתאימים.
אפשר להשתמש ב-taints וב-affinity של צמתים ביחד כדי לוודא שהפודים של עומסי העבודה של הדייר מתוזמנים רק לצמתים ששמורים לדייר.
הארכיטקטורות לדוגמה האלה עוזרות לכם לשלוט בתזמון של אפליקציות הדיירים בדרכים הבאות:
- יצירת מאגר צמתים ב-GKE שמוקדש לדייר. לכל צומת במאגר יש טיינט שקשור לשם הדייר.
- החלה אוטומטית של הסבילות (toleration) וזיקת הצומת (node affinity) המתאימות על כל Pod שמטרגט את מרחב השמות של הדייר. מחילים את הסובלנות והקרבה באמצעות מוטציות של PolicyController.
הרשאות מינימליות
כדי לשמור על אבטחה, מומלץ להשתמש בעיקרון של הרשאות מינימליות בפרויקטים ובמשאבים ב-Google Cloud , כמו אשכולות GKE. בגישה הזו, לאפליקציות שפועלות בתוך האשכול, ולמפתחים ולמפעילים שמשתמשים באשכול, יש רק את קבוצת ההרשאות המינימלית הנדרשת.
הארכיטקטורות האלה לדוגמה עוזרות לכם להשתמש בחשבונות שירות עם הרשאות מינימליות בדרכים הבאות:
- כל מאגר צמתים ב-GKE מקבל חשבון שירות משלו. לדוגמה, הצמתים במאגר הצמתים של הדייר משתמשים בחשבון שירות שמיועד לצמתים האלה. חשבונות השירות של הצמתים מוגדרים עם ההרשאות המינימליות הנדרשות.
- האשכול משתמש באיחוד זהויות של עומסי עבודה ל-GKE כדי לשייך חשבונות שירות של Kubernetes לחשבונות שירות של Google. כך אפשר לתת לאפליקציות של הדייר גישה מוגבלת לכל ממשקי ה-API הנדרשים של Google, בלי להוריד ולאחסן מפתח של חשבון שירות. לדוגמה, אתם יכולים לתת לחשבון השירות הרשאות לקרוא נתונים מקטגוריה של Cloud Storage.
הארכיטקטורות האלה לדוגמה עוזרות להגביל את הגישה למשאבי האשכול בדרכים הבאות:
- אתם יוצרים תפקיד RBAC לדוגמה ב-Kubernetes עם הרשאות מוגבלות לניהול אפליקציות. אתם יכולים להקצות את התפקיד הזה למשתמשים ולקבוצות שמפעילים את האפליקציות במרחב השמות של הדייר. כשמקצים את התפקיד המוגבל הזה למשתמשים ולקבוצות, הם יכולים לשנות רק את משאבי האפליקציה במרחב השמות של הדייר. אין להם הרשאות לשנות משאבים ברמת האשכול או הגדרות אבטחה רגישות, כמו כללי מדיניות של Cloud Service Mesh.
Binary Authorization
בעזרת Binary Authorization אתם יכולים לאכוף כללי מדיניות שאתם מגדירים לגבי קובצי האימג' של הקונטיינרים שאתם פורסים בסביבת GKE. Binary Authorization מאפשר לפרוס רק קובצי אימג' של קונטיינרים שתואמים למדיניות שהגדרתם. היא לא מאפשרת פריסה של קובצי אימג' אחרים של קונטיינרים.
בארכיטקטורה לדוגמה הזו, Binary Authorization מופעלת עם הגדרת ברירת המחדל שלה. כדי לבדוק את הגדרת ברירת המחדל של Binary Authorization, עיינו במאמר ייצוא קובץ ה-YAML של המדיניות.
למידע נוסף על הגדרת כללי מדיניות, עיינו בהנחיות הספציפיות הבאות:
- Google Cloud CLI
- Google Cloud console
- API בארכיטקטורת REST
- המשאב
google_binary_authorization_policyב-Terraform
אימות אישורים בין ארגונים שונים
אתם יכולים להשתמש ב-Binary Authorization כדי לאמת אישורים שנוצרו על ידי חותם מצד שלישי. לדוגמה, בתרחיש לדוגמה של למידה מאוחדת בין מאגרים, אתם יכולים לאמת אישורים שנוצרו על ידי ארגון משתתף אחר.
כדי לאמת את האישורים שנוצרו על ידי צד שלישי:
- מקבלים את המפתחות הציבוריים שבהם הצד השלישי השתמש כדי ליצור את האישורים שצריך לאמת.
- יוצרים את הגורמים המאשרים כדי לאמת את האישורים.
- מוסיפים את המפתחות הציבוריים שקיבלתם מהצד השלישי לגורמים המאמתים שיצרתם.
למידע נוסף על יצירת גורמים מאשרים, קראו את ההנחיות הספציפיות הבאות:
- Google Cloud CLI
- Google Cloud console
- API בארכיטקטורת REST
- המשאב
google_binary_authorization_attestorשל Terraform
שיקולי אבטחה בלמידה משותפת (Federated)
למרות מודל שיתוף הנתונים המחמיר, למידה מאוחדת לא מאובטחת באופן מובנה מפני כל המתקפות הממוקדות, וצריך להביא בחשבון את הסיכונים האלה כשפורסים את אחת מהארכיטקטורות שמתוארות במסמך הזה. יש גם סיכון לדליפות מידע לא מכוונות לגבי מודלים של למידת מכונה או נתוני אימון של מודלים. לדוגמה, תוקף יכול לפגוע בכוונה במודל ה-ML הגלובלי או בסבבים של מאמץ הלמידה המשותפת, או לבצע מתקפת תזמון (סוג של התקפת ערוץ צדדי) כדי לאסוף מידע על הגודל של מערכי הנתונים לאימון.
אלה האיומים הנפוצים ביותר על הטמעה של למידה מאוחדת:
- שינון מכוון או לא מכוון של נתוני אימון. יכול להיות שההטמעה של הלמידה המשותפת או תוקף יאחסנו נתונים בכוונה או בטעות בדרכים שעלולות להקשות על העבודה איתם. תוקף יכול לאסוף מידע על המודל הגלובלי של למידת המכונה או על סבבים קודמים של תהליך הלמידה המשותפת, באמצעות הנדסה הפוכה של הנתונים השמורים.
- לחלץ מידע מעדכונים למודל ה-ML הגלובלי. במהלך הלמידה המשותפת, תוקף יכול לבצע הנדסה הפוכה של העדכונים למודל ה-ML הגלובלי, שאוסף בעלי האיחוד מארגונים וממכשירים שמשתתפים בתהליך.
- בעלי הפדרציה עלולים לפגוע בסבבים. בעלים של מאגר נתונים שנפרץ יכול לשלוט במאגר או במכשיר זדוני ולהתחיל סבב של למידה משותפת. בסוף הסבב, יכול להיות שהבעלים של המערכת המאוחדת שנפגעה יוכל לאסוף מידע על העדכונים שהוא מקבל מהארגונים ומהמכשירים של המשתתפים הלגיטימיים, על ידי השוואה בין העדכונים האלה לבין העדכון שהופק במאגר המידע הזדוני.
- הארגונים והמכשירים שמשתתפים בתהליך עלולים לפגוע במודל ה-ML הגלובלי. במהלך תהליך הלמידה המבוזרת, תוקף עלול לנסות להשפיע באופן זדוני על הביצועים, האיכות או התקינות של מודל ה-ML הגלובלי, על ידי יצירת עדכונים לא תקינים או לא משמעותיים.
כדי לצמצם את ההשפעה של האיומים שמתוארים בקטע הזה, מומלץ לפעול לפי השיטות הבאות:
- לכוונן את המודל כדי לצמצם למינימום את הזיכרון של נתוני האימון.
- להטמיע מנגנונים לשמירה על הפרטיות.
- חשוב לבדוק באופן קבוע את המודל הגלובלי של למידת המכונה, את המודלים של למידת המכונה שאתם מתכוונים לשתף, את נתוני האימון ואת התשתית שהטמעתם כדי להשיג את היעדים של הלמידה המאוחדת.
- להטמיע אלגוריתם של צבירה מאובטחת כדי לעבד את תוצאות האימון שהארגונים המשתתפים מפיקים.
- ליצור ולהפיץ באופן מאובטח מפתחות להצפנת נתונים באמצעות תשתית של מפתח ציבורי.
- פריסת תשתית בפלטפורמת Confidential Computing.
בעלי פדרציות צריכים גם לבצע את הפעולות הבאות:
- לאמת את הזהות של כל ארגון שמשתתף ואת התקינות של כל מאגר במקרה של ארכיטקטורות חוצות-מאגרים, ואת הזהות והתקינות של כל מכשיר במקרה של ארכיטקטורות חוצות-מכשירים.
- להגביל את היקף העדכונים למודל ה-ML הגלובלי שארגונים ומכשירים משתתפים יכולים להפיק.
אמינות
בקטע הזה מתוארים גורמי התכנון שצריך להביא בחשבון כשמשתמשים באחת מהארכיטקטורות לדוגמה שבמסמך הזה כדי לתכנן ולבנות פלטפורמת למידה מאוחדת ב- Google Cloud.
כשאתם מתכננים את ארכיטקטורת הלמידה המשותפת ב- Google Cloud, מומלץ לפעול לפי ההנחיות שבקטע הזה כדי לשפר את הזמינות ואת יכולת ההתאמה לעומס (scaling) של עומס העבודה, וכדי שהארכיטקטורה תהיה עמידה בפני הפסקות חשמל ואסונות.
GKE: ב-GKE יש תמיכה בכמה סוגים שונים של אשכולות, שאפשר להתאים לדרישות הזמינות של עומסי העבודה ולתקציב שלכם. לדוגמה, אתם יכולים ליצור אשכולות אזוריים שמפיצים את מישור הבקרה והצמתים בין כמה אזורים, או אשכולות של אזור ספציפי שבהם מישור הבקרה והצמתים נמצאים באזור אחד. גם ארכיטקטורת הייחוס של מאגרים שונים וגם ארכיטקטורת הייחוס של מכשירים שונים מסתמכות על אשכולות GKE אזוריים. במאמר אפשרויות להגדרת אשכולות תוכלו לקרוא מידע נוסף על ההיבטים שצריך להביא בחשבון כשיוצרים אשכולות GKE.
בהתאם לסוג האשכול ולאופן שבו מישור הבקרה והצמתים של האשכול מפוזרים באזורים ובתחומים, GKE מציע יכולות שונות של תוכנית התאוששות מאסון (DR) כדי להגן על עומסי העבודה מפני הפסקות זמניות בשירות בתחום ובאזור. מידע נוסף על יכולות ההתאוששות מאסון של GKE מופיע במאמר תכנון התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן: Google Kubernetes Engine.
Cloud Load Balancing: ב-GKE יש כמה דרכים לאיזון עומסי תעבורת נתונים בעומסי העבודה. ההטמעות של GKE בממשקי ה-API של Kubernetes Gateway ו-Kubernetes Service מאפשרות להקצות ולהגדיר באופן אוטומטי את Cloud Load Balancing, כדי לחשוף באופן מאובטח ואמין את עומסי העבודה שפועלים באשכולות GKE.
בארכיטקטורות לדוגמה האלה, כל תעבורת הנתונים הנכנסת והיוצאת עוברת דרך שערי Cloud Service Mesh. שערי הכניסה האלה מאפשרים לכם לשלוט באופן הדוק בזרימת התנועה בתוך אשכולות GKE ומחוצה להם.
אתגרים שקשורים לאמינות בלמידה משותפת (Federated) בין מכשירים
למידה מאוחדת בין מכשירים שונים כוללת כמה אתגרי אמינות שלא קיימים בתרחישים של למידה מאוחדת בין מאגרי מידע שונים. למשל:
- קישוריות לא אמינה או לסירוגין של המכשיר
- נפח האחסון במכשיר מוגבל
- משאבי מחשוב וזיכרון מוגבלים
קישוריות לא יציבה עלולה לגרום לבעיות כמו:
- עדכונים לא עדכניים והתפצלות מודלים: כשהמכשירים חווים קישוריות לסירוגין, עדכוני המודלים המקומיים שלהם עלולים להיות לא עדכניים, ולייצג מידע מיושן בהשוואה למצב הנוכחי של המודל הגלובלי. צבירת עדכונים לא עדכניים עלולה להוביל לסטייה של המודל, שבה המודל הגלובלי סוטה מהפתרון האופטימלי בגלל חוסר עקביות בתהליך האימון.
- תרומות לא מאוזנות ומודלים מוטים: תקשורת לסירוגין עלולה לגרום לחלוקה לא אחידה של התרומות מהמכשירים המשתתפים. מכשירים עם קישוריות חלשה עשויים לתרום פחות עדכונים, מה שמוביל לייצוג לא מאוזן של התפלגות הנתונים הבסיסיים. חוסר האיזון הזה יכול להטות את המודל הגלובלי לכיוון הנתונים ממכשירים עם חיבורים אמינים יותר.
- תקורה מוגברת של תקשורת וצריכת אנרגיה: תקשורת לסירוגין עלולה להוביל לתקורה מוגברת של תקשורת, כי יכול להיות שהמכשירים יצטרכו לשלוח מחדש עדכונים שאבדו או נפגמו. הבעיה הזו יכולה גם להגדיל את צריכת האנרגיה במכשירים, במיוחד במכשירים עם חיי סוללה מוגבלים, כי יכול להיות שהם יצטרכו לשמור על חיבורים פעילים למשך זמן ארוך יותר כדי להבטיח שהעדכונים יועברו בהצלחה.
כדי לצמצם חלק מההשפעות של תקשורת לסירוגין, אפשר להשתמש בארכיטקטורות לדוגמה שבמסמך הזה עם FCP.
אפשר לתכנן ארכיטקטורת מערכת שמפעילה את פרוטוקול FCP כך שתעמוד בדרישות הבאות:
- טיפול בסבבים ארוכים.
- הפעלת ביצוע ספקולטיבי (סבבים יכולים להתחיל לפני שמספר הלקוחות הנדרש נאסף, מתוך ציפייה שיותר לקוחות יתחברו בקרוב).
- לאפשר למכשירים לבחור באילו משימות הם רוצים להשתתף. הגישה הזו מאפשרת להשתמש בתכונות כמו דגימה ללא החזרה, אסטרטגיית דגימה שבה לכל יחידת דגימה באוכלוסייה יש רק הזדמנות אחת להיבחר. הגישה הזו עוזרת לצמצם את ההשפעה של תרומות לא מאוזנות ומודלים מוטים.
- ניתן להרחיב את המערכת כדי להשתמש בטכניקות אנונימיזציה כמו פרטיות דיפרנציאלית (DP) וצבירה מהימנה (TAG).
כדי להתמודד עם מגבלות האחסון ויכולות המחשוב של המכשיר, אפשר להשתמש בשיטות הבאות:
- להבין מהי הקיבולת המקסימלית הזמינה להפעלת החישוב של הלמידה המשותפת
- להבין כמה נתונים אפשר לשמור בכל זמן נתון
- תכנון קוד הלמידה המשותפת בצד הלקוח כך שיפעל במסגרת משאבי המחשוב וה-RAM שזמינים אצל הלקוחות
- להבין את ההשלכות של ניצול כל נפח האחסון ולהטמיע תהליך לניהול המצב הזה
הוזלת עלויות
בקטע הזה מוסבר איך להוזיל את העלויות של יצירת פלטפורמת הלמידה המשותפת ב- Google Cloud והפעלתה, באמצעות ארכיטקטורת העזר הזו. ההנחיות האלה רלוונטיות לשתי הארכיטקטורות שמתוארות במסמך הזה.
הפעלת עומסי עבודה ב-GKE יכולה לעזור לכם לבצע אופטימיזציה של עלויות הסביבה, על ידי הקצאה והגדרה של האשכולות בהתאם לדרישות המשאבים של עומסי העבודה. היא גם מאפשרת תכונות שמגדירות מחדש באופן דינמי את האשכולות ואת צומתי האשכולות, כמו התאמה אוטומטית לעומס של צומתי אשכולות ו-Pods, והתאמה של גודל האשכולות.
מידע נוסף על אופטימיזציה של העלויות בסביבות GKE זמין במאמר שיטות מומלצות להרצת אפליקציות Kubernetes עם אופטימיזציה של עלויות ב-GKE.
יעילות תפעולית
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כדי לבצע אופטימיזציה של היעילות כשמשתמשים בארכיטקטורה לדוגמה הזו כדי ליצור ולהפעיל פלטפורמת למידה מאוחדת ב- Google Cloud. ההנחיות האלה רלוונטיות לשתי הארכיטקטורות שמתוארות במסמך הזה.
כדי לשפר את האוטומציה והמעקב אחרי ארכיטקטורת הלמידה המשותפת, מומלץ לאמץ את עקרונות ה-MLOps, שהם עקרונות DevOps בהקשר של מערכות למידת מכונה. המשמעות של תרגול MLOps היא שאתם תומכים באוטומציה ובמעקב בכל השלבים של בניית מערכת למידת המכונה, כולל שילוב, בדיקה, הפצה, פריסה וניהול תשתית. למידע נוסף על MLOps, קראו את המאמר MLOps: צינורות עיבוד נתונים של פיתוח רציף (continuous delivery) ואוטומציה בלמידת מכונה.
אופטימיזציה של הביצועים
בקטע הזה מתוארים הגורמים שצריך להביא בחשבון כדי לשפר את הביצועים של עומסי העבודה, כשמשתמשים בארכיטקטורה לדוגמה הזו כדי ליצור ולהריץ פלטפורמה ללמידה מאוחדת ב- Google Cloud. ההנחיות האלה רלוונטיות לשתי הארכיטקטורות שמתוארות במסמך הזה.
ב-GKE יש כמה תכונות שמאפשרות להתאים את הגודל וההתאמה לעומס של סביבת GKE באופן אוטומטי וידני, כדי לעמוד בדרישות של עומסי העבודה ולמנוע הקצאת יתר של משאבים. לדוגמה, אתם יכולים להשתמש בשירות ההמלצות כדי ליצור תובנות שנוצרו על ידי AI והמלצות לאופטימיזציה של השימוש במשאבים של GKE.
כשאתם חושבים איך להרחיב את סביבת GKE, מומלץ לתכנן תוכניות לטווח קצר, בינוני וארוך להרחבת הסביבות ועומסי העבודה. לדוגמה, איך אתם מתכוונים להגדיל את טביעת הרגל של GKE בעוד כמה שבועות, חודשים ושנים? אם תכינו תוכנית מראש, תוכלו לנצל בצורה הטובה ביותר את תכונות המדרגיות של GKE, לבצע אופטימיזציה של סביבות GKE ולהוזיל עלויות. מידע נוסף על תכנון יכולת ההתאמה לעומס (scalability) של אשכולות ועומסי עבודה זמין במאמר מידע על יכולת ההתאמה לעומס של GKE.
כדי לשפר את הביצועים של עומסי העבודה של למידת המכונה, אתם יכולים להשתמש ב-Cloud Tensor Processing Units (Cloud TPUs) – מאיצי AI ש-Google פיתחה, שמותאמים לאימון ולהסקת מסקנות של מודלים גדולים של AI.
פריסה
כדי לפרוס את ארכיטקטורות העזר של למידה משולבת בין מאגרי מידע ובין מכשירים שמתוארות במסמך הזה, עיינו במאגר Federated Learning on Google Cloud ב-GitHub.
המאמרים הבאים
- בפלטפורמת TensorFlow Federated תוכלו לראות איך מטמיעים אלגוריתמים של למידה משותפת.
- מידע נוסף על Advances and Open Problems in Federated Learning
- מידע נוסף על למידה משותפת בבלוג של Google AI
- איך Google שומרת על הפרטיות כשהיא משתמשת בלמידה משותפת (Federated) עם מידע מצטבר ללא פרטים מזהים כדי לשפר מודלים של למידת מכונה.
- לקראת למידה משותפת (Federated) בקנה מידה רחב
- איך מטמיעים צינור עיבוד נתונים של MLOps כדי לנהל את מחזור החיים של המודלים של למידת המכונה.
- לסקירה כללית של עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud, קראו את המאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- גרייס מוליסון | ראש צוות פתרונות
- מרקו פרארי | ארכיטקט פתרונות ענן
תורמים אחרים:
- קלואי קידון | מנהלת ומהנדסת תוכנה בכירה
- Laurent Grangeau | Solutions Architect
- ליליאן פליקס | מהנדסת ענן
- כריסטיאן פיטרס | ארכיטקטית אבטחה בענן