


הרבה ארגונים פורסים מחסני נתונים שמאחסנים בהם מידע אישי רגיש כדי לנתח את הנתונים למגוון מטרות עסקיות. המסמך הזה מיועד למהנדסי נתונים ולאדמינים של אבטחה שפורסים ומאבטחים מחסני נתונים באמצעות BigQuery. היא חלק מתוכנית שכוללת את הפריטים הבאים:
- שני מאגרי GitHub (
terraform-google-secured-data-warehouseו-terraform-google-secured-data-warehouse-onprem-ingest) שמכילים הגדרות וסקריפטים של Terraform. ההגדרה של Terraform יוצרת סביבה ב- Google Cloud בשביל מחסן נתונים שמאחסן נתונים סודיים. Google Cloud - מדריך לארכיטקטורה, לעיצוב ולאמצעי האבטחה של תוכנית הפעולה הזו (המסמך הזה).
- הסבר מפורט על פריסת סביבת בדיקה לדוגמה.
במסמך הזה נדון בנושאים הבאים:
- הארכיטקטורה והשירותים שבהם אפשר להשתמש כדי לאבטח מחסן נתונים בסביבת ייצור. Google Cloud
- שיטות מומלצות לייבוא נתונים ל-BigQuery מרשת חיצונית, כמו סביבה מקומית.
שיטות מומלצות לניהול נתונים כשיוצרים, פורסים ומפעילים מחסן נתונים ב-Google Cloud, כולל:
נתונים הסרת פרטי הזיהוי
טיפול דיפרנציאלי בנתונים סודיים
הצפנה ברמת העמודה
אמצעי בקרה על הגישה ברמת העמודה
המסמך הזה מניח שכבר הגדרתם קבוצה בסיסית של אמצעי בקרה לאבטחה, כפי שמתואר בתוכנית הבסיס לארגונים. הוא עוזר לכם להוסיף אמצעי בקרה נוספים לאמצעי הבקרה הקיימים כדי להגן על נתונים סודיים במחסן נתונים.
תרחישי שימוש במחסן נתונים
התוכנית תומכת בתרחישי השימוש הבאים:
- שימוש במאגר
terraform-google-secured-data-warehouseכדי לייבא נתונים מ- Google Cloud למחסן נתונים ב-BigQuery - שימוש במאגר
terraform-google-secured-data-warehouse-onprem-ingestכדי לייבא נתונים מסביבה מקומית או מענן אחר למחסן נתונים ב-BigQuery
סקירה כללית
מחסני נתונים כמו BigQuery מאפשרים לעסקים לנתח את הנתונים העסקיים שלהם כדי להפיק תובנות. אנליסטים ניגשים לנתונים העסקיים שמאוחסנים במחסני נתונים כדי ליצור תובנות. אם מחסן הנתונים כולל נתונים סודיים, אתם צריכים לנקוט אמצעים כדי לשמור על האבטחה, הסודיות, התקינות והזמינות של הנתונים העסקיים בזמן שהם מאוחסנים, בזמן שהם מועברים או בזמן שהם מנותחים. בתוכנית הזו תלמדו:
- כשמייבאים נתונים ממקורות נתונים חיצוניים, צריך להצפין את הנתונים שנמצאים מחוץ ל- Google Cloud (לדוגמה, בסביבה מקומית) ולייבא אותם ל- Google Cloud.
- הגדרת אמצעי בקרה שיעזרו לאבטח את הגישה לנתונים סודיים.
- הגדרת אמצעי בקרה שיעזרו לאבטח את צינור עיבוד הנתונים.
- הגדרת הפרדת תפקידים מתאימה לפרסונות שונות.
- כשמייבאים נתונים ממקורות אחרים שנמצאים ב Google Cloud (נקראים גם מקורות נתונים פנימיים), צריך להגדיר תבניות כדי למצוא נתונים סודיים ולבטל את הזיהוי שלהם.
- הגדירו אמצעי בקרה מתאימים לאבטחה ולרישום ביומן כדי להגן על נתונים סודיים.
- כדי להגביל את הגישה לעמודות ספציפיות במחסן הנתונים, אפשר להשתמש בסיווג נתונים, בתגי מדיניות, באנונימיזציה דינמית של נתונים ובהצפנה ברמת העמודה.
ארכיטקטורה
כדי ליצור מחסן נתונים (data warehouse) של מידע סודי, צריך לייבא נתונים בצורה מאובטחת ואז לאחסן את הנתונים בגבולות גזרה של VPC Service Controls.
ארכיטקטורה כשמייבאים נתונים מ- Google Cloud
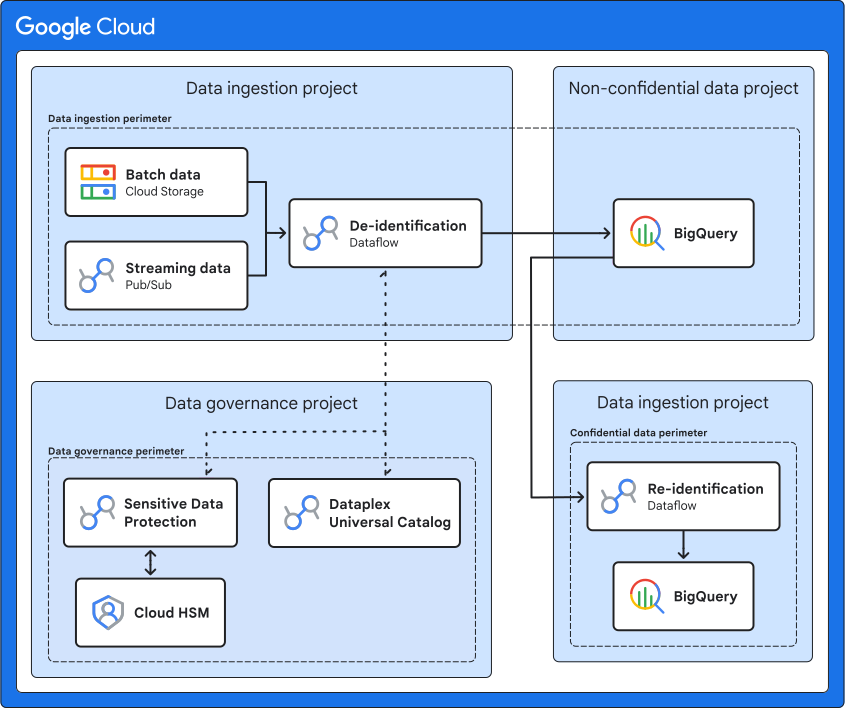
בתמונה הבאה מוצגות הקטגוריות של הנתונים שמוטמעים, איך הם עוברים הסרת פרטי הזיהוי ואיך הם מאוחסנים כשמייבאים נתוני מקור מ- Google Cloud באמצעות מאגר terraform-google-secured-data-warehouse. בנוסף, מוצג בתמונה איך אפשר לשחזר פרטי זיהוי של נתונים סודיים על פי דרישה לצורך ניתוח נתונים.
ארכיטקטורה כשמייבאים נתונים ממקורות חיצוניים
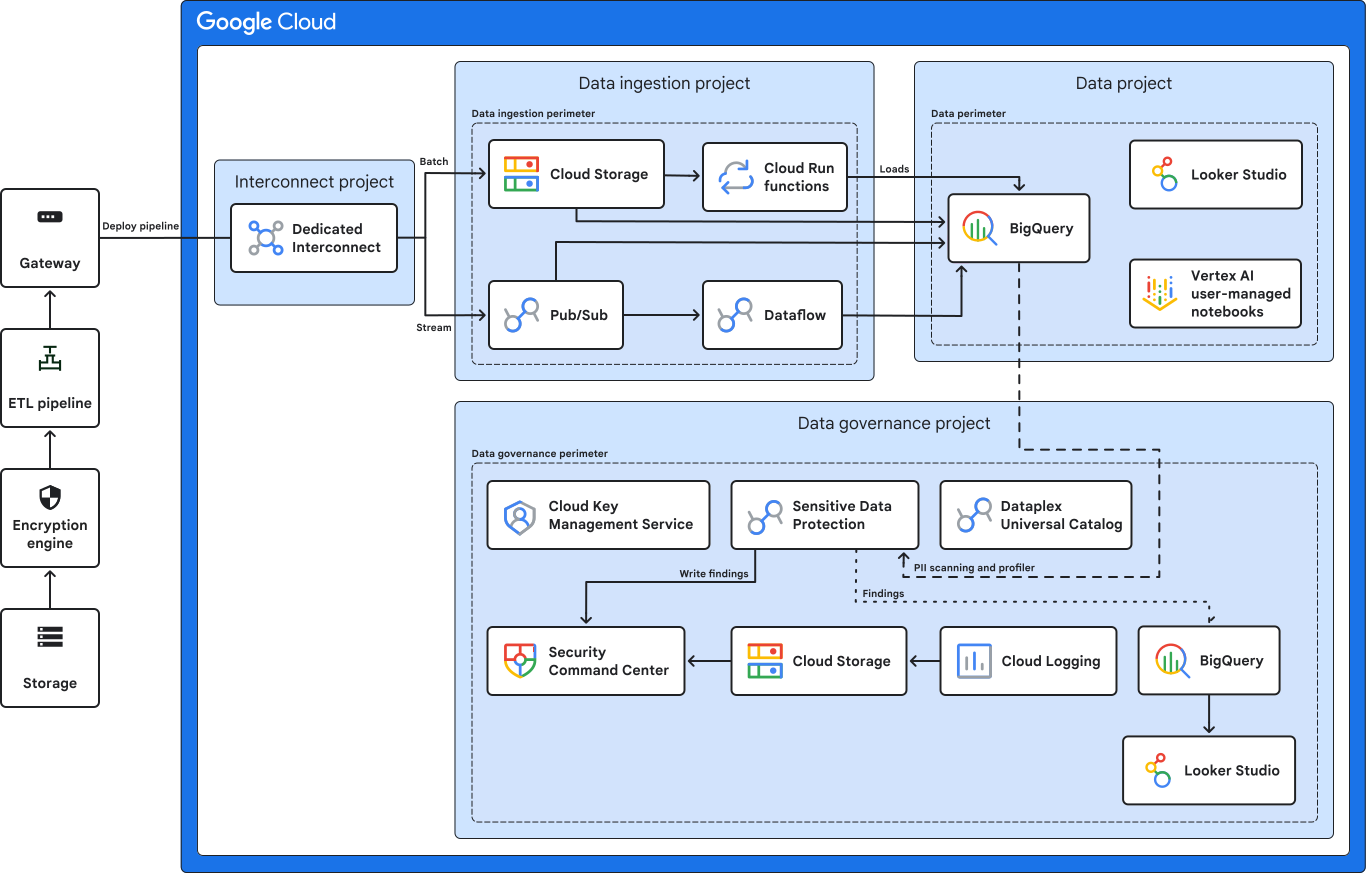
בתמונה הבאה אפשר לראות איך נתונים מוזנים ונשמרים כשמייבאים נתונים מסביבה מקומית או מענן אחר למחסן נתונים ב-BigQuery באמצעות מאגר terraform-google-secured-data-warehouse-onprem-ingest.
Google Cloud שירותים ותכונות
הארכיטקטורות משתמשות בשילוב של Google Cloud השירותים והתכונות הבאים:
| שירות או תכונה | תיאור |
|---|---|
רלוונטי למקורות נתונים פנימיים וחיצוניים. עם זאת, יש אפשרויות אחסון שונות:
ב-BigQuery נעשה שימוש באמצעי אבטחה שונים כדי להגן על התוכן, כולל בקרת גישה, אבטחה ברמת העמודה לנתונים סודיים והצפנת נתונים. |
|
Cloud Key Management Service (Cloud KMS) עם Cloud HSM |
ההגדרה חלה על מקורות פנימיים וחיצוניים. עם זאת, יש תרחיש שימוש נוסף למקורות נתונים חיצוניים. Cloud HSM הוא שירות של מודול אבטחה לחומרה (HSM) מבוסס-ענן שמארח את המפתח להצפנת מפתחות הצפנה (KEK). כשמייבאים נתונים ממקור חיצוני, משתמשים ב-Cloud HSM כדי ליצור את מפתח ההצפנה שמשמש להצפנת הנתונים ברשת לפני ששולחים אותם אל Google Cloud. |
ההגדרה חלה על מקורות פנימיים וחיצוניים. Cloud Logging אוסף את כל היומנים משירותי Google Cloud לאחסון ולאחזור על ידי כלי הניתוח והחקירה שלכם. |
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. Cloud Monitoring אוסף ושומר מידע על הביצועים ומדדים לגבי שירותים. Google Cloud |
|
רלוונטי רק למקורות נתונים חיצוניים. פונקציות Cloud Run מופעלות על ידי Cloud Storage וכותבות את הנתונים ש-Cloud Storage מעלה לקטגוריית ההטמעה ב-BigQuery. |
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. הנתונים מתקבלים ב-Cloud Storage וב-Pub/Sub באופן הבא:
|
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. הכלי Data Profiler ל-BigQuery סורק באופן אוטומטי את כל הטבלאות והעמודות ב-BigQuery בכל הארגון, כולל כל התיקיות והפרויקטים, כדי למצוא מידע אישי רגיש. |
|
צינורות עיבוד נתונים של Dataflow |
ההגדרה הזו רלוונטית למקורות פנימיים וחיצוניים, אבל יש צינורות שונים. צינורות עיבוד נתונים של Dataflow מייבאים נתונים באופן הבא:
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. במהלך ההטמעה, Knowledge Catalog מסווג באופן אוטומטי נתונים סודיים באמצעות מטא-נתונים, שנקראים גם תגי מדיניות. בנוסף, Knowledge Catalog משתמש במטא-נתונים כדי לנהל את הגישה לנתונים סודיים. כדי לשלוט בגישה לנתונים במחסן הנתונים, צריך להחיל תגי מדיניות על עמודות שכוללות נתונים סודיים. |
|
רלוונטי רק למקורות נתונים חיצוניים. Dedicated Interconnect מאפשר לכם להעביר נתונים בין הרשת שלכם לבין Google Cloud. אפשר להשתמש באפשרות חיבור אחרת, כמו שמתואר במאמר בחירת מוצרים של Network Connectivity. |
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. מנהל הזהויות והרשאות הגישה (IAM) ומנהל המשאבים מגבילים את הגישה ומפלחים את המשאבים. אמצעי בקרת הגישה והיררכיית המשאבים מבוססים על העיקרון של הרשאות מינימליות. |
|
ההגדרה חלה על מקורות פנימיים וחיצוניים. ב-Security Command Center אפשר לעקוב אחרי ממצאי אבטחה מכל סביבת Google Cloudולבדוק אותם במקום מרכזי. |
|
ההגדרה הזו חלה על מקורות פנימיים וחיצוניים, אבל מתבצעים סוגים שונים של סריקות. הכלי Sensitive Data Protection סורק נתונים באופן הבא:
|
|
ההגדרה רלוונטית למקורות פנימיים וחיצוניים, אבל יש הבדלים בין ההיקפים. VPC Service Controls יוצרת גבולות גזרה לאבטחה שמבודדים שירותים ומשאבים על ידי הגדרת הרשאה, אמצעי בקרה לגישה והחלפת נתונים מאובטחת. הגבולות הם:
ההיקפים האלה נועדו להגן על תוכן נכנס, לבודד נתונים סודיים על ידי הגדרת אמצעי בקרה נוספים על הגישה ומעקב, ולהפריד בין הממשל שלכם לבין הנתונים בפועל במחסן. המשילות שלכם כוללת ניהול מפתחות, ניהול קטלוג נתונים ורישום ביומן. |
מבנה ארגוני
אתם מקבצים את המשאבים של הארגון כדי שתוכלו לנהל אותם ולהפריד בין סביבות הבדיקה לבין סביבת הייצור. מנהל המשאבים מאפשר לקבץ משאבים באופן לוגי לפי פרויקט, תיקייה וארגון.
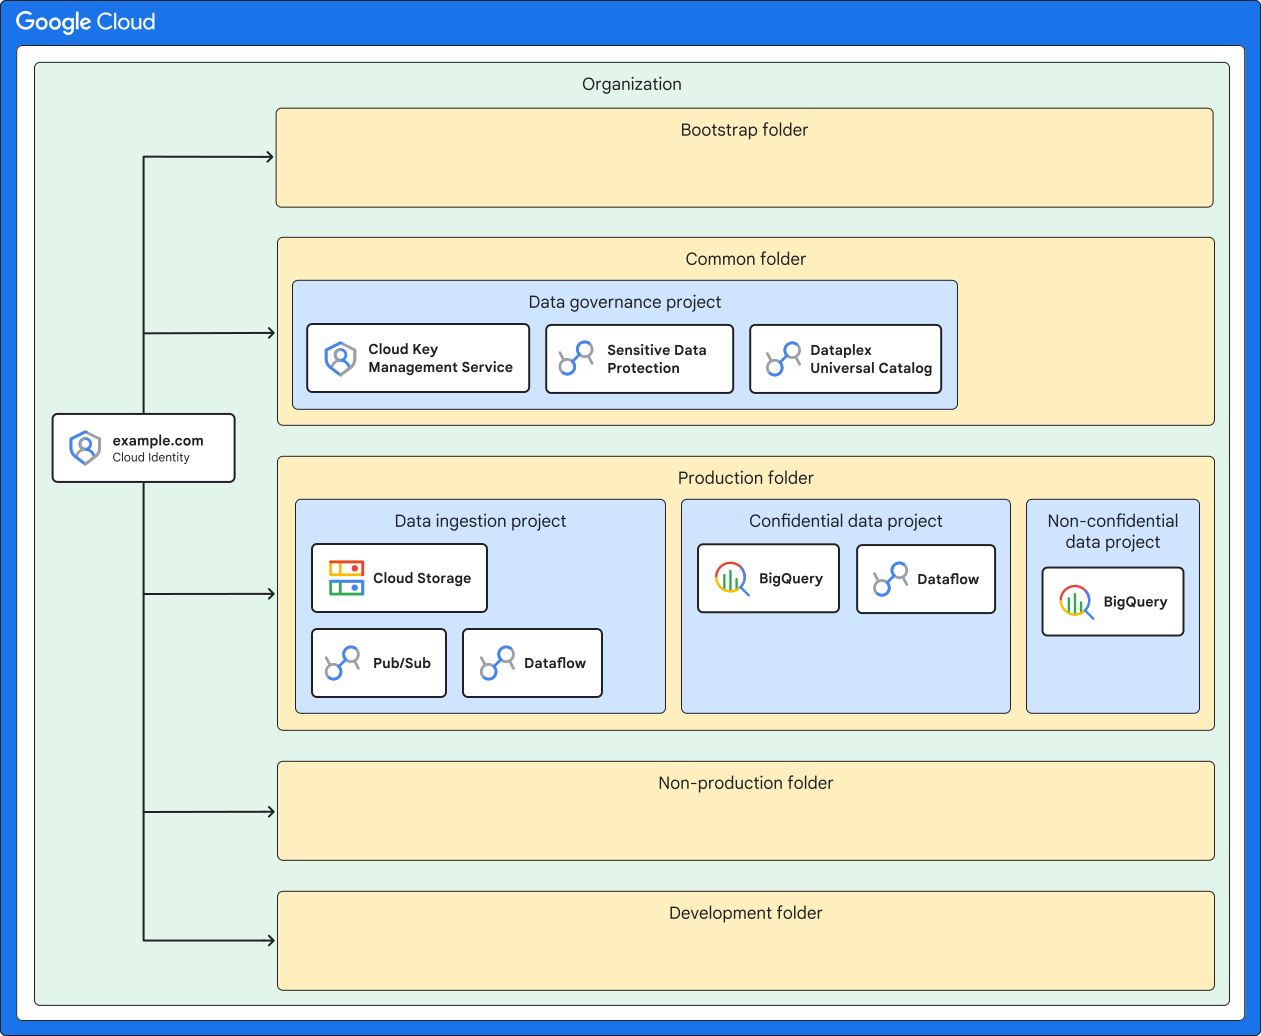
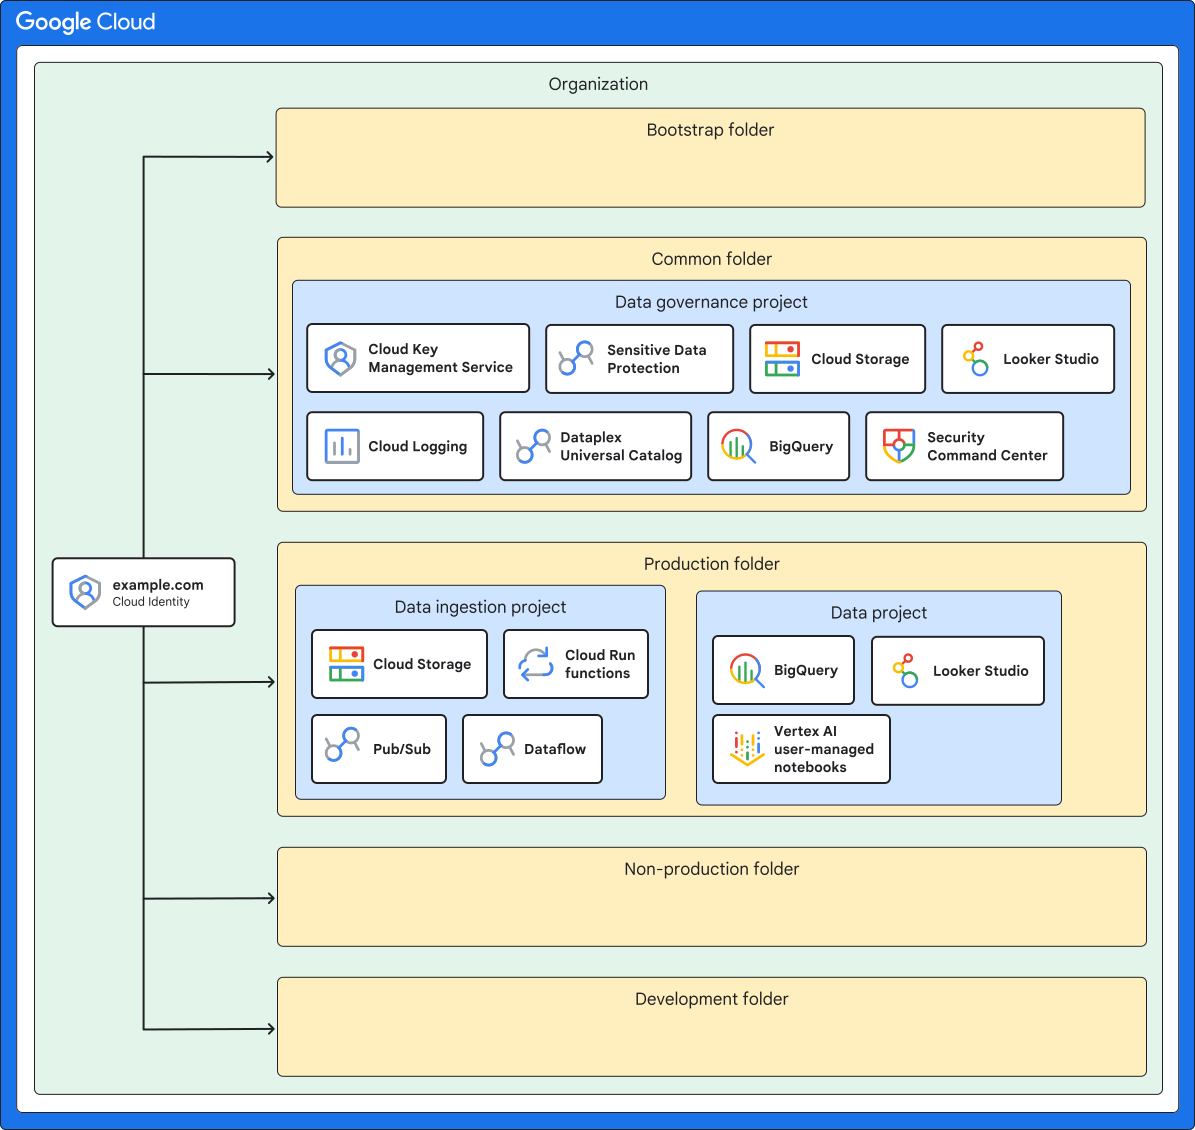
בתרשימים הבאים מוצגת היררכיית משאבים עם תיקיות שמייצגות סביבות שונות, כמו bootstrap, common, production, non-production (או staging) ו-development. את רוב הפרויקטים בארכיטקטורה פורסים בתיקייה production, ואת פרויקט ניהול הנתונים בתיקייה common, שמשמשת לניהול.
מבנה הארגון כשמייבאים נתונים מ- Google Cloud
בתרשים הבא מוצג מבנה הארגון כשמייבאים נתונים מ-Google Cloud באמצעות מאגר terraform-google-secured-data-warehouse.
מבנה הארגון כשמייבאים נתונים ממקורות חיצוניים
בתרשים הבא מוצג מבנה הארגון כשמייבאים נתונים ממקור חיצוני באמצעות מאגר terraform-google-secured-data-warehouse-onprem-ingest.
תיקיות
משתמשים בתיקיות כדי לבודד את סביבת הייצור ואת שירותי הניהול מסביבות הבדיקה והסביבות שאינן סביבות ייצור. בטבלה הבאה מתוארות התיקיות מתוכנית הבסיס הארגוני שבהן נעשה שימוש בארכיטקטורה הזו.
| תיקייה | תיאור |
|---|---|
Bootstrap |
מכיל משאבים שנדרשים לפריסת תוכנית הבסיס לארגונים. |
נפוץ |
מכיל שירותים מרכזיים לארגון, כמו פרויקט ניהול הנתונים. |
ייצור |
מכילה פרויקטים עם משאבי ענן שנבדקו ומוכנים לשימוש. בארכיטקטורה הזו, התיקייה Production מכילה את הפרויקט Data ingestion ואת הפרויקטים שקשורים לנתונים. |
לא בסביבת ייצור |
מכיל פרויקטים עם משאבי ענן שנבדקים ומוכנים להפצה. בארכיטקטורה הזו, התיקייה Non-production מכילה את הפרויקט Data ingestion ואת הפרויקטים שקשורים לנתונים. |
פיתוח |
מכילה פרויקטים עם משאבי ענן שנמצאים בפיתוח. בארכיטקטורה הזו, התיקייה Development מכילה את הפרויקט Data ingestion ואת הפרויקטים שקשורים לנתונים. |
אתם יכולים לשנות את השמות של התיקיות האלה כך שיתאימו למבנה התיקיות של הארגון, אבל מומלץ לשמור על מבנה דומה. מידע נוסף זמין בתוכנית הבסיסית לארגונים.
פרויקטים
אתם מבודדים חלקים מהסביבה באמצעות פרויקטים. בטבלה הבאה מתוארים הפרויקטים שנדרשים בארגון. הפרויקטים האלה נוצרים כשמריצים את הקוד של Terraform. אפשר לשנות את השמות של הפרויקטים האלה, אבל מומלץ לשמור על מבנה פרויקט דומה.
| פרויקט | תיאור |
|---|---|
הטמעת נתונים |
פרויקט משותף למקורות פנימיים וחיצוניים. השירותים האלה נדרשים כדי לקבל נתונים ולבטל את הזיהוי של נתונים סודיים. |
משילות מידע (data governance) |
פרויקט משותף למקורות פנימיים וחיצוניים. השירותים האלה כוללים יכולות של ניהול מפתחות, רישום ביומן וקטלוג נתונים. |
מידע לא סודי |
פרויקט למקורות פנימיים בלבד. הקטגוריה הזו כוללת שירותים שנדרשים כדי לאחסן נתונים שעברו דה-אינדנטיפיקציה. |
מידע סודי |
פרויקט למקורות פנימיים בלבד. כולל שירותים שנדרשים כדי לאחסן נתונים סודיים ולזהות אותם מחדש. |
נתונים |
פרויקט למקורות חיצוניים בלבד. כולל שירותים שנדרשים לאחסון נתונים. |
בנוסף לפרויקטים האלה, הסביבה שלכם צריכה לכלול גם פרויקט שמארח עבודת Flex Template של Dataflow. נדרשת משימת Flex Template לצינור עיבוד הנתונים של הסטרימינג.
מיפוי תפקידים וקבוצות לפרויקטים
צריך לתת לקבוצות משתמשים שונות בארגון גישה לפרויקטים שמרכיבים את מחסן הנתונים הסודי. בקטעים הבאים מפורטות המלצות לגבי הארכיטקטורה של קבוצות משתמשים והקצאות תפקידים בפרויקטים שיוצרים. אפשר להתאים אישית את הקבוצות כך שיתאימו למבנה הקיים בארגון, אבל מומלץ לשמור על הפרדה דומה בין התפקידים והקצאת התפקידים.
קבוצת מנתחי נתונים
מנתחי נתונים מנתחים את הנתונים במחסן הנתונים. במאגר terraform-google-secured-data-warehouse-onprem-ingest, הקבוצה הזו יכולה לצפות בנתונים אחרי שהם נטענים למחסן הנתונים, ולבצע את אותן פעולות כמו הקבוצה Encrypted data viewer.
בטבלה הבאה מתוארים התפקידים של הקבוצה בפרויקטים שונים במאגר terraform-google-secured-data-warehouse (מקורות נתונים פנימיים בלבד).
| מיפוי פרויקטים | תפקידים |
|---|---|
הטמעת נתונים |
תפקיד נוסף לניתוח נתונים שדורש גישה לנתונים סודיים: |
מידע סודי |
|
מידע לא סודי |
בטבלה הבאה מתוארים התפקידים של הקבוצה בפרויקטים שונים במאגר terraform-google-secured-data-warehouse-onprem-ingest (מקורות נתונים חיצוניים בלבד).
| היקף ההקצאה | תפקידים |
|---|---|
פרויקט הטמעת נתונים |
|
פרויקט נתונים |
|
רמת המדיניות בנושא נתונים |
קבוצה עם גישה לצפייה בנתונים מוצפנים (מקורות חיצוניים בלבד)
הקבוצה Encrypted data viewer (צפייה בנתונים מוצפנים) במאגר terraform-google-secured-data-warehouse-onprem-ingest יכולה לצפות בנתונים מוצפנים מטבלאות דיווח ב-BigQuery באמצעות Data Studio וכלי דיווח אחרים, כמו SAP Business Objects.
הקבוצה עם הרשאת צפייה בנתונים מוצפנים לא יכולה לראות נתונים בטקסט גלוי מעמודות מוצפנות.
לקבוצה הזו נדרש התפקיד משתמש ב-BigQuery (roles/bigquery.jobUser) בפרויקט הנתונים. לקבוצה הזו נדרש גם התפקיד Masked Reader (roles/bigquerydatapolicy.maskedReader) ברמת מדיניות הנתונים.
הקבוצה עם הרשאת קריאה לטקסט פשוט (מקורות חיצוניים בלבד)
לקבוצת Plaintext reader במאגר terraform-google-secured-data-warehouse-onprem-ingest יש את ההרשאה הנדרשת לקריאה של נתונים לא מוצפנים, וגם את ההרשאה הנוספת לקריאה של נתונים לא מוסווים. כדי לקרוא נתונים לא מוצפנים, צריך להפעיל את פונקציית הפענוח המוגדרת על ידי המשתמש (UDF).
בקבוצה הזו נדרשים התפקידים הבאים בפרויקט הנתונים:
- BigQuery User (
roles/bigquery.user) - BigQuery User (
roles/bigquery.jobUser) - Cloud KMS Viewer (
roles/cloudkms.viewer)
בנוסף, לקבוצה הזו נדרשת ההרשאה Fine-Grained Reader
(roles/datacatalog.categoryFineGrainedReader) ברמת Knowledge Catalog.
קבוצת מהנדסי מערכות מידע
מהנדסי נתונים מגדירים ומתחזקים את צינור עיבוד הנתונים ואת מחסן הנתונים.
בטבלה הבאה מתוארים התפקידים של הקבוצה בפרויקטים שונים במאגר terraform-google-secured-data-warehouse.
| היקף ההקצאה | תפקידים |
|---|---|
פרויקט הטמעת נתונים |
|
פרויקט עם נתונים סודיים |
|
פרויקט נתונים לא סודי |
בטבלה הבאה מתוארים התפקידים של הקבוצה בפרויקטים שונים במאגר terraform-google-secured-data-warehouse-onprem-ingest.
קבוצת אדמינים של הרשת
מנהלי רשתות מגדירים את הרשת. בדרך כלל הם חברים בצוות הרשת.
אדמינים של רשתות צריכים את התפקידים הבאים ברמת הארגון:
קבוצת אדמינים לענייני אבטחה
אדמינים של אבטחה מנהלים אמצעי בקרה לאבטחה כמו גישה, מפתחות, כללי חומת אש, VPC Service Controls ו-Security Command Center.
אדמינים של אבטחה צריכים את התפקידים הבאים ברמת הארגון:
- אדמין ב-Access Context Manager (
roles/accesscontextmanager.policyAdmin) - Cloud Asset Viewer (
roles/cloudasset.viewer) - אדמין של Cloud KMS (
roles/cloudkms.admin) - אדמין אבטחת מחשוב (
roles/compute.securityAdmin) - אדמין של קטלוג הנתונים (
roles/datacatalog.admin) - אדמין DLP (
roles/dlp.admin) - אדמין של רישום ביומן (
roles/logging.admin) - אדמין של הארגון (
roles/orgpolicy.policyAdmin) - אדמין אבטחה (
roles/iam.securityAdmin)
קבוצת אנליסטים של אבטחה
אנליסטים של אבטחה מנטרים אירועי אבטחה ומגיבים להם, וגם לממצאים של Sensitive Data Protection.
אנליסטים של אבטחה צריכים את התפקידים הבאים ברמת הארגון:
- משתמש עם הרשאת קריאה ב-Access Context Manager (
roles/accesscontextmanager.policyReader) - צפייה ברשת Compute (
roles/compute.networkViewer) - צפייה ב-Data Catalog (
roles/datacatalog.viewer) - Cloud KMS Viewer (
roles/cloudkms.viewer) - כלי הצפייה ביומנים (
roles/logging.viewer) - צפייה במדיניות הארגון (
roles/orgpolicy.policyViewer) - אדמין עם הרשאת צפייה במרכז האבטחה (
roles/securitycenter.adminViewer) - עורך הממצאים של מרכז האבטחה (
roles/securitycenter.findingsEditor) - אחד מהתפקידים הבאים ב-Security Command Center:
דוגמאות לרצפי פעולות לגישה לקבוצות ממקורות חיצוניים
בקטעים הבאים מתוארים תהליכי הגישה לשתי קבוצות כשמייבאים נתונים ממקורות חיצוניים באמצעות מאגר terraform-google-secured-data-warehouse-onprem-ingest.
תהליך הגישה לקבוצת הצופים בנתונים מוצפנים
בתרשים הבא מוצג מה קורה כשמשתמש מקבוצת הצופים בנתונים מוצפנים מנסה לגשת לנתונים מוצפנים ב-BigQuery.
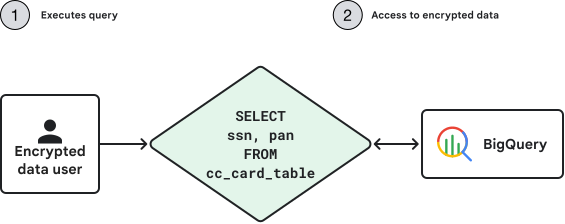
כדי לגשת לנתונים ב-BigQuery, צריך לבצע את השלבים הבאים:
כדי לגשת לנתונים סודיים, הכלי Encrypted data viewer מריץ את השאילתה הבאה ב-BigQuery:
SELECT ssn, pan FROM cc_card_tableכך מתבצעת בדיקת הגישה ב-BigQuery:
- המשתמש עובר אימות באמצעות פרטי כניסה תקפים שלא פג תוקפם. Google Cloud
- זהות המשתמש וכתובת ה-IP שממנה נשלחה הבקשה הם חלק מרשימת ההיתרים ברמת הגישה או בכלל התעבורה הנכנסת (ingress) בהיקף ה-VPC Service Controls.
- מערכת IAM מוודאת שלמשתמש יש את התפקידים המתאימים ושהוא מורשה לגשת לעמודות המוצפנות שנבחרו בטבלה ב-BigQuery.
מערכת BigQuery מחזירה את הנתונים הסודיים בפורמט מוצפן.
תהליך הגישה לקבוצת הקוראים Plaintext
בתרשים הבא מוצג מה קורה כשמשתמש מקבוצת הקוראים של טקסט רגיל מנסה לגשת לנתונים מוצפנים ב-BigQuery.
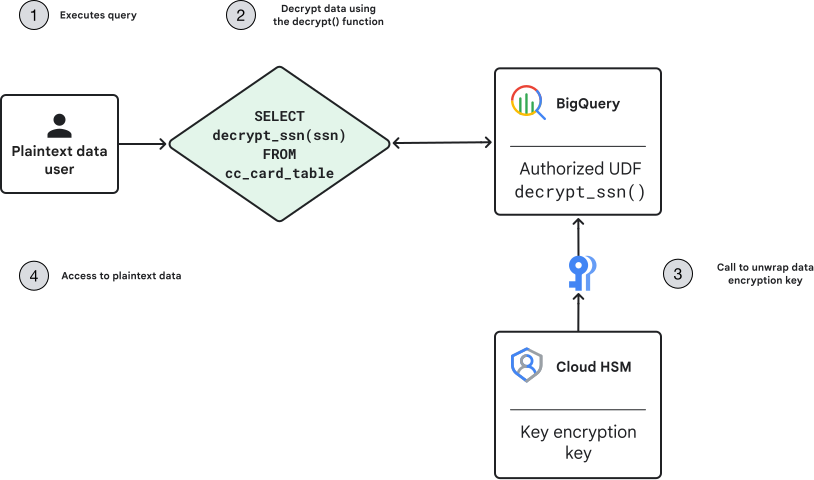
כדי לגשת לנתונים ב-BigQuery, צריך לבצע את השלבים הבאים:
הקורא Plaintext מריץ את השאילתה הבאה ב-BigQuery כדי לגשת לנתונים סודיים בפורמט מפוענח:
SELECT decrypt_ssn(ssn) FROM cc_card_tableBigQuery קורא לפונקציית UDF (פונקציה מוגדרת על ידי המשתמש) לפענוח בתוך השאילתה כדי לגשת לעמודות מוגנות.
כך מתבצע אימות הגישה:
- מערכת IAM מוודאת שלמשתמש יש תפקידים מתאימים ושהוא מורשה לגשת ל-UDF של פענוח ב-BigQuery.
- ה-UDF מאחזר את המפתח להצפנת נתונים (DEK) שעבר הצפנה ועטיפה, ושימש להגנה על עמודות של מידע אישי רגיש.
הפונקציה המוגדרת על ידי המשתמש (UDF) decrypt קוראת למפתח להצפנת מפתחות הצפנה (KEK) ב-Cloud HSM כדי לבטל את העטיפה של המפתח להצפנת נתונים (DEK). הפונקציה המוגדרת על ידי המשתמש (UDF) decrypt משתמשת בפונקציית הביטול של הצפנת AEAD ב-BigQuery כדי לבטל את ההצפנה של העמודות עם מידע אישי רגיש.
למשתמש ניתנת גישה לנתונים בטקסט לא מוצפן בעמודות של המידע האישי הרגיש.
אמצעי בקרה נפוצים לאבטחה
בקטעים הבאים מתוארים אמצעי הבקרה שחלים על מקורות פנימיים וחיצוניים.
אמצעי בקרה להטמעת נתונים
כדי ליצור את מחסן הנתונים, צריך להעביר נתונים מGoogle Cloud מקור אחר (למשל, מאגר נתונים), מהסביבה המקומית או מענן אחר. אפשר להשתמש באחת מהאפשרויות הבאות כדי להעביר את הנתונים למחסן הנתונים ב-BigQuery:
- משימה באצווה שמשתמשת ב-Cloud Storage.
- משימת סטרימינג שמשתמשת ב-Pub/Sub.
כדי להגן על הנתונים במהלך ההטמעה, אפשר להשתמש בהצפנה מצד הלקוח, בכללי חומת אש ובמדיניות של רמות גישה. תהליך ההטמעה נקרא לפעמים תהליך חילוץ, טרנספורמציה וטעינה (ETL).
כללי רשת וחומת אש
כללי חומת האש של ענן וירטואלי פרטי (VPC) שולטים בזרימת הנתונים אל המתחמים ההיקפיים. יוצרים כללי חומת אש שחוסמים את כל תעבורת הנתונים היוצאת (egress), למעט חיבורים ספציפיים ביציאת TCP 443 משמות הדומיין המיוחדים restricted.googleapis.com. היתרונות של דומיין restricted.googleapis.com:
- הוא עוזר לצמצם את שטח המתקפה של הרשת באמצעות גישה פרטית ל-Google, כשעומסי עבודה מתקשרים עם Google APIs ושירותים של Google.
- הוא מוודא שאתם משתמשים רק בשירותים שתומכים ב-VPC Service Controls.
מידע נוסף זמין במאמר הגדרת גישה פרטית ל-Google.
כשמשתמשים במאגר terraform-google-secured-data-warehouse, צריך להגדיר רשתות משנה נפרדות לכל עבודת Dataflow. רשתות משנה נפרדות מבטיחות שהנתונים שעוברים דה-אינדנטיפיקציה מופרדים בצורה נכונה מהנתונים שעוברים אינדנטיפיקציה מחדש.
כדי להשתמש בצינור הנתונים, צריך לפתוח יציאות TCP בחומת האש, כפי שמוגדר בקובץ dataflow_firewall.tf במאגרים המתאימים. מידע נוסף זמין במאמר הגדרת גישה לאינטרנט וכללים לחומת אש.
כדי למנוע ממשאבים להשתמש בכתובות IP חיצוניות, מדיניות הארגון Define allowed external IPs for VM instances (compute.vmExternalIpAccess) מוגדרת למניעת גישה לכולם.
אמצעי בקרה להיקף ההרשאות
כפי שמוצג בתרשים הארכיטקטורה, את המשאבים של מחסן הנתונים צריך למקם בהיקפים נפרדים. כדי לאפשר לשירותים בגבולות גזרה שונים לשתף נתונים, יוצרים גשרים בין גבולות גזרה.
גשרים בין גבולות גזרה מאפשרים לשירותים מוגנים לשלוח בקשות למשאבים מחוץ לגבולות הגזרה שלהם. הגשרים האלה יוצרים את החיבורים הבאים למאגר terraform-google-secured-data-warehouse:
- הם מקשרים את פרויקט הטמעת הנתונים לפרויקט הפיקוח, כדי שהסרת הפרטים המזהים תוכל להתבצע במהלך ההטמעה.
- הם מקשרים בין פרויקט של נתונים לא סודיים לבין פרויקט של נתונים סודיים, כך שניתן לזהות מחדש נתונים סודיים כשמנתח נתונים מבקש זאת.
- הם מקשרים את הפרויקט החסוי לפרויקט משילות המידע כדי שניתן יהיה לבצע זיהוי מחדש כשמנתח נתונים יבקש זאת.
הגשרים האלה יוצרים את החיבורים הבאים למאגר terraform-google-secured-data-warehouse-onprem-ingest:
- הם מקשרים את הפרויקט של הכנסת הנתונים לפרויקט הנתונים, כדי שאפשר יהיה להכניס נתונים ל-BigQuery.
- הם מקשרים את פרויקט הנתונים לפרויקט משילות מידע, כדי ש-Sensitive Data Protection יוכל לסרוק את BigQuery ולחפש נתונים סודיים לא מוגנים.
- הם מקשרים את פרויקט הטמעת הנתונים לפרויקט משילות המידע כדי לקבל גישה לרישום ביומן, למעקב ולמפתחות הצפנה.
בנוסף לגשרים בין גבולות גזרה, משתמשים בכללי יציאה כדי לאפשר למשאבים שמוגנים על ידי גבולות גזרה לשירות לגשת למשאבים שנמצאים מחוץ לגבולות הגזרה. בפתרון הזה, מגדירים כללי יציאה כדי לקבל את המשימות החיצוניות של Dataflow Flex Template שנמצאות ב-Cloud Storage בפרויקט חיצוני. למידע נוסף, ראו גישה למשאב Google Cloud מחוץ לגבולות הגזרה.
מדיניות גישה
כדי להבטיח שרק זהויות ספציפיות (משתמש או שירות) יוכלו לגשת למשאבים ולנתונים, מפעילים קבוצות ותפקידים ב-IAM.
כדי לוודא שרק מקורות ספציפיים יוכלו לגשת לפרויקטים שלכם, אתם צריכים להפעיל מדיניות גישה בארגון שלכם ב-Google. מומלץ ליצור מדיניות גישה שמציינת את טווח כתובות ה-IP המותרות לבקשות, ומתירה רק בקשות ממשתמשים ספציפיים או מחשבונות שירות. למידע נוסף, אפשר לעיין במאמר בנושא מאפיינים של רמות גישה.
חשבונות שירות ואמצעי בקרה לגישה
חשבונות שירות הם זהויות ש Google Cloud יכולות לשמש להרצת בקשות API בשמכם. חשבונות שירות מוודאים שלמשתמשים אין גישה ישירה לשירותים. כדי לאפשר הפרדת תפקידים, יוצרים חשבונות שירות עם תפקידים שונים למטרות ספציפיות. חשבונות השירות האלה מוגדרים במודול data-ingestion ובמודול confidential-data בכל ארכיטקטורה.
עבור מאגר terraform-google-secured-data-warehouse, חשבונות השירות הם:
- חשבון שירות של בקר Dataflow לצינור Dataflow שמבטל את הזיהוי של נתונים סודיים.
- חשבון שירות של בקר Dataflow עבור צינור עיבוד הנתונים ב-Dataflow שמזהה מחדש נתונים סודיים.
- חשבון שירות ב-Cloud Storage להטמעת נתונים מקובץ אצווה.
- חשבון שירות של Pub/Sub להעברת נתונים משירות סטרימינג.
- חשבון שירות של Cloud Scheduler להרצת משימת Dataflow באצווה שיוצרת את צינור עיבוד הנתונים של Dataflow.
בטבלה הבאה מפורטים התפקידים שמוקצים לכל חשבון שירות:
במאגר terraform-google-secured-data-warehouse-onprem-ingest, חשבונות השירות הם:
- חשבון השירות של Cloud Storage מריץ את תהליך ההעלאה האוטומטי של נתונים בכמות גדולה לקטגוריית האחסון של נתוני ההטמעה.
- חשבון השירות של Pub/Sub מאפשר סטרימינג של נתונים לשירות Pub/Sub.
- חשבון השירות של בקר Dataflow משמש את צינור Dataflow כדי לשנות ולכתוב נתונים מ-Pub/Sub ל-BigQuery.
- חשבון השירות של פונקציות Cloud Run כותב נתונים של קבוצות עוקבות שהועלו מ-Cloud Storage ל-BigQuery.
- חשבון השירות של העלאה לאחסון מאפשר לצינור ה-ETL ליצור אובייקטים.
- חשבון השירות Pub/Sub Write מאפשר לצינור ה-ETL לכתוב נתונים ב-Pub/Sub.
בטבלה הבאה מפורטים התפקידים שמוקצים לכל חשבון שירות:
| שם | תפקידים | היקף המטלה |
|---|---|---|
חשבון שירות של בקר Dataflow |
|
פרויקט הטמעת נתונים |
פרויקט נתונים |
||
משילות מידע (data governance) |
||
חשבון שירות של פונקציות Cloud Run |
פרויקט הטמעת נתונים |
|
פרויקט נתונים |
||
חשבון שירות להעלאה ל-Storage |
פרויקט הטמעת נתונים |
|
חשבון שירות עם הרשאת כתיבה ב-Pub/Sub |
פרויקט הטמעת נתונים |
מדיניות הארגון
הארכיטקטורה הזו כוללת את האילוצים של מדיניות הארגון שמשמשים בתוכנית ה-Enterprise Foundations, ומוסיפה אילוצים נוספים. למידע נוסף על האילוצים שמשמשים בתוכנית הבסיסית של הארגון, ראו אילוצים של מדיניות הארגון.
בטבלה הבאה מתוארים האילוצים הנוספים של מדיניות הארגון שמוגדרים במודול org_policies עבור המאגרים המתאימים:
| מדיניות | שם המגבלה | הערך המומלץ |
|---|---|---|
הגבלת פריסת משאבים למיקומים פיזיים ספציפיים. לערכים נוספים, אפשר לעיין בקבוצות ערכים. |
|
אחת מהאפשרויות הבאות:
|
|
|
|
|
|
|
הגבלת כללי העברה חדשים כך שיהיו פנימיים בלבד, על סמך כתובת ה-IP. |
|
|
הגדרת קבוצת תת-רשתות של VPC משותף שמשאבי Compute Engine יכולים להשתמש בהן. |
|
מחליפים את הערך במזהה המקום של רשת המשנה הפרטית שרוצים שהארכיטקטורה תשתמש בה. |
השבתה של רישום הפלט של היציאה הטורית ב-Cloud Logging. |
|
|
דרישה להגנה באמצעות CMEK ( |
|
|
השבתת יצירת מפתחות לחשבון שירות
( |
|
TRUE |
הפעלת OS Login במכונות וירטואליות שנוצרו בפרויקט
( |
|
TRUE |
השבתה של מתן תפקידים אוטומטי לחשבון שירות שהוגדר כברירת מחדל
( |
|
TRUE |
הגדרות כניסה מותרות (פונקציות Cloud Run)
( |
|
|
אמצעי בקרה לאבטחה של מקורות נתונים חיצוניים
בקטעים הבאים מפורטים אמצעי הבקרה שחלים על הטמעת נתונים ממקורות חיצוניים.
חיבור מוצפן אל Google Cloud
כשמייבאים נתונים ממקורות חיצוניים, אפשר להשתמש ב-Cloud VPN או ב-Cloud Interconnect כדי להגן על כל הנתונים שזורמים בין Google Cloudלסביבה שלכם. בארכיטקטורה הזו מומלץ להשתמש ב-Dedicated Interconnect, כי הוא מספק חיבור ישיר וקצב העברת נתונים גבוה, שחשובים אם אתם מזרימים הרבה נתונים.
כדי לאפשר גישה אל Google Cloud מהסביבה שלכם, אתם צריכים להגדיר כתובות IP ברשימת ההיתרים בכללי המדיניות של רמות הגישה.
הצפנה מצד הלקוח
לפני שמעבירים את הנתונים הרגישים אל Google Cloud, כדאי להצפין אותם באופן מקומי כדי להגן עליהם במנוחה ובמעבר. אפשר להשתמש בספריית ההצפנה Tink או בספריות הצפנה אחרות. ספריית ההצפנה Tink תואמת להצפנת AEAD ב-BigQuery, שמשמשת את הארכיטקטורה לפענוח נתונים מוצפנים ברמת העמודה אחרי שהנתונים מיובאים.
ספריית ההצפנה של Tink משתמשת במפתחות DEK שאפשר ליצור באופן מקומי או מ-Cloud HSM. כדי לעטוף או להגן על מפתח ה-DEK, אפשר להשתמש במפתח KEK שנוצר ב-Cloud HSM. מפתח ה-KEK הוא מפתח סימטרי להצפנה מסוג CMEK שמאוחסן בצורה מאובטחת ב-Cloud HSM ומנוהל באמצעות תפקידים והרשאות IAM.
במהלך ההטמעה, גם מפתח ההצפנה העטוף וגם הנתונים מאוחסנים ב-BigQuery. BigQuery כולל שתי טבלאות: אחת לנתונים ואחת למפתח DEK המוצפן. כשמנתחים צריכים להציג נתונים סודיים, מערכת BigQuery יכולה להשתמש בפענוח AEAD כדי לבטל את האריזה של ה-DEK באמצעות ה-KEK ולפענח את העמודה המוגנת.
בנוסף, הצפנה מצד הלקוח באמצעות Tink מגנה על הנתונים על ידי הצפנה של עמודות עם מידע אישי רגיש ב-BigQuery. הארכיטקטורה משתמשת במפתחות ההצפנה הבאים של Cloud HSM:
- מפתח CMEK לתהליך ההטמעה, שמשמש גם את Pub/Sub, צינור Dataflow להעברה בסטרימינג, העלאה באצווה ב-Cloud Storage וארטיפקטים של פונקציות Cloud Run להעלאות באצווה בהמשך.
- המפתח הקריפטוגרפי שעטוף על ידי Cloud HSM עבור הנתונים המוצפנים ברשת באמצעות Tink.
- מפתח CMEK למחסן BigQuery בפרויקט הנתונים.
אתם מציינים את המיקום של ה-CMEK, שקובע את המיקום הגיאוגרפי שבו המפתח מאוחסן וזמין לגישה. אתם צריכים לוודא שה-CMEK נמצא באותו מיקום כמו המשאבים שלכם. כברירת מחדל, ה-CMEK מתחלף כל 30 יום.
אם דרישות התאימות של הארגון מחייבות אתכם לנהל את המפתחות שלכם באופן חיצוני מ- Google Cloud, אתם יכולים להפעיל את Cloud External Key Manager. אם אתם משתמשים במפתחות חיצוניים, אתם אחראים לפעולות ניהול המפתחות, כולל רוטציית מפתחות.
הסתרת נתונים דינמית
כדי לשתף ולהחיל מדיניות גישה לנתונים בקנה מידה גדול, אפשר להגדיר הסתרה דינמית של נתונים. אנונימיזציה דינמית של נתונים מאפשרת לשאילתות קיימות להסתיר באופן אוטומטי נתונים בעמודות לפי הקריטריונים הבאים:
- כללי המיסוך שמוחלים על העמודה בזמן הריצה של השאילתה.
- התפקידים שמוקצים למשתמש שמריץ את השאילתה. כדי לגשת לנתונים בעמודה שלא הוסתרו, לנתח הנתונים צריך להיות התפקיד Fine-Grained Reader.
כדי להגדיר גישה לעמודות ב-BigQuery, יוצרים תגי מדיניות. לדוגמה, הטקסונומיה שנוצרה בדוגמה העצמאית יוצרת את תג המדיניות 1_Sensitive לעמודות שכוללות נתונים שלא ניתן לפרסם, כמו מסגרת האשראי. כלל ברירת המחדל להסתרת נתונים חל על העמודות האלה כדי להסתיר את הערך של העמודה.
כל מה שלא מתויג זמין לכל המשתמשים שיש להם גישה למחסן הנתונים. אמצעי בקרת הגישה האלה מבטיחים שגם אחרי שהנתונים נכתבים ב-BigQuery, אי אפשר לקרוא את הנתונים בשדות רגישים עד שמעניקים למשתמש גישה בצורה מפורשת.
הצפנה ופענוח ברמת העמודה
הצפנה ברמת העמודה מאפשרת להצפין נתונים ב-BigQuery ברמה מפורטת יותר. במקום להצפין טבלה שלמה, בוחרים את העמודות שמכילות מידע אישי רגיש ב-BigQuery, ורק העמודות האלה מוצפנות. ב-BigQuery נעשה שימוש בפונקציות של הצפנה ופענוח מסוג AEAD שיוצרות את ערכות המפתחות שמכילות את המפתחות להצפנה ולפענוח. המפתחות האלה משמשים להצפנה ולפענוח של ערכים נפרדים בטבלה, ולהחלפת מפתחות בתוך קבוצת מפתחות. הצפנה ברמת העמודה מספקת בקרת גישה כפולה לנתונים מוצפנים ב-BigQuery, כי למשתמש צריכות להיות הרשאות לטבלה ולמפתח ההצפנה כדי לקרוא נתונים בטקסט גלוי.
כלי ליצירת פרופיל נתונים ב-BigQuery עם Sensitive Data Protection
כלי פרופיל הנתונים מאפשר לכם לזהות את המיקומים של נתונים רגישים ונתונים בסיכון גבוה בטבלאות של BigQuery. כלי פרופיל הנתונים סורק ומנתח באופן אוטומטי את כל הטבלאות והעמודות ב-BigQuery בכל הארגון, כולל כל התיקיות והפרויקטים. לאחר מכן, כלי פרופיל הנתונים מפיק מדדים כמו infoTypes החזויים, רמות הסיכון והרגישות של הנתונים שנבדקו ומטא-נתונים לגבי הטבלאות. בעזרת התובנות האלה, אתם יכולים לקבל החלטות מושכלות לגבי האופן שבו אתם מגנים על הנתונים, משתפים אותם ומשתמשים בהם.
אמצעי בקרה לאבטחה של מקורות נתונים פנימיים
בקטעים הבאים מתוארים אמצעי הבקרה שחלים על הטמעת נתונים ממקורותGoogle Cloud .
ניהול מפתחות והצפנה להעברה
שתי האפשרויות להעברת נתונים (Cloud Storage או Pub/Sub) משתמשות ב-Cloud HSM כדי לנהל את מפתחות ה-CMEK. אתם משתמשים במפתחות ה-CMEK כדי להגן על הנתונים במהלך ההעברה. בנוסף, Sensitive Data Protection מגן על הנתונים באמצעות הצפנה של מידע סודי, תוך שימוש באמצעי הזיהוי שאתם מגדירים.
כדי להטמיע נתונים, משתמשים במפתחות ההצפנה הבאים:
- מפתח CMEK לתהליך ההטמעה, שמשמש גם את צינור הנתונים של Dataflow ואת שירות Pub/Sub.
- המפתח הקריפטוגרפי עטוף על ידי Cloud HSM לתהליך הסרת הפרטים המזהים של הנתונים באמצעות Sensitive Data Protection.
- שני מפתחות CMEK, אחד למחסן BigQuery בפרויקט של נתונים לא סודיים, והשני למחסן בפרויקט של נתונים סודיים. מידע נוסף זמין במאמר בנושא ניהול מפתחות.
אתם מציינים את המיקום של מפתח ה-CMEK, שקובע את המיקום הגיאוגרפי שבו המפתח מאוחסן וזמין לגישה. אתם צריכים לוודא שמפתח ה-CMEK נמצא באותו מיקום כמו המשאבים שלכם. כברירת מחדל, מפתח ה-CMEK מתחלף כל 30 יום.
אם חובות התאימות של הארגון מחייבות אתכם לנהל את המפתחות שלכם מחוץ ל- Google Cloud, אתם יכולים להפעיל את Cloud EKM. אם אתם משתמשים במפתחות חיצוניים, אתם אחראים לפעולות ניהול המפתחות, כולל רוטציית מפתחות.
הסרת פרטי הזיהוי מהנתונים
אתם משתמשים ב-Sensitive Data Protection כדי להסיר את הפרטים המזהים מהנתונים המובְנים והלא מובְנים שלכם במהלך שלב ההטמעה. בנתונים מובְנים, משתמשים בטרנספורמציות של רשומות שמבוססות על שדות כדי להסיר את פרטי הזיהוי מהנתונים. דוגמה לגישה הזו מופיעה בתיקייה /examples/de_identification_template/. בדוגמה הזו נבדקים נתונים מובנים כדי לחפש מספרי כרטיסי אשראי וקודי אימות של כרטיסים. כדי להסיר פרטי זיהוי מנתונים לא מובְנים, משתמשים בסוגי מידע.
כדי להסיר את הפרטים המזהים מנתונים שתויגו כסודיים, משתמשים ב-Sensitive Data Protection ובצינור עיבוד נתונים כדי לבצע טוקניזציה. בצינור הזה, הנתונים נלקחים מ-Cloud Storage, עוברים עיבוד ואז נשלחים למחסן הנתונים ב-BigQuery.
מידע נוסף על תהליך הסרת פרטי הזיהוי מהנתונים זמין במאמר בנושא ניהול נתונים.
אמצעי בקרה על הגישה ברמת העמודה
כדי להגן על נתונים סודיים, משתמשים בבקרת גישה לעמודות ספציפיות במחסן הנתונים של BigQuery. כדי לגשת לנתונים בעמודות האלה, לנתח נתונים צריך להיות תפקיד Fine-Grained Reader (קריאה פרטנית).
כדי להגדיר גישה לעמודות ב-BigQuery, יוצרים תגי מדיניות. לדוגמה, הקובץ taxonomy.tf במודול bigquery-confidential-data יוצר את התגים הבאים:
3_Confidentialתג מדיניות לעמודות שכוללות מידע רגיש מאוד, כמו מספרים של כרטיסי אשראי. למשתמשים שיש להם גישה לתג הזה יש גם גישה לעמודות שתויגו בתגי המדיניות2_Privateאו1_Sensitive.- תג מדיניות
2_Privateלעמודות שכוללות פרטים אישיים מזהים (PII) רגישים, כמו שם פרטי של אדם. למשתמשים שיש להם גישה לתג הזה יש גם גישה לעמודות שתויגו בתג המדיניות1_Sensitive. למשתמשים אין גישה לעמודות שתויגו בתג המדיניות3_Confidential. 1_Sensitiveתג מדיניות לעמודות שכוללות נתונים שלא ניתן לפרסם, כמו מסגרת האשראי. למשתמשים שיש להם גישה לתג הזה אין גישה לעמודות שתויגו בתגי המדיניות2_Privateאו3_Confidential.
כל מה שלא מתויג זמין לכל המשתמשים שיש להם גישה למחסן הנתונים.
אמצעי הבקרה האלה מבטיחים שגם אחרי שהנתונים מזוהים מחדש, אי אפשר לקרוא אותם עד שניתנת למשתמש גישה מפורשת.
הערה: אפשר להשתמש בהגדרות ברירת המחדל כדי להריץ את הדוגמאות. שיטות מומלצות נוספות זמינות במאמר שיטות מומלצות לשימוש בתגי מדיניות ב-BigQuery.
חשבונות שירות עם תפקידים מוגבלים
צריך להגביל את הגישה לפרויקט של המידע הסודי כך שרק משתמשים מורשים יוכלו לראות את המידע הסודי. כדי לעשות זאת, יוצרים חשבון שירות עם התפקיד Service Account User (משתמש בחשבון שירות) (roles/iam.serviceAccountUser) שמשתמשים מורשים צריכים להתחזות אליו. התחזות לחשבון שירות עוזרת למשתמשים להשתמש בחשבונות שירות בלי להוריד את המפתחות של חשבונות השירות, וכך משפרת את האבטחה הכוללת של הפרויקט. התחזות יוצרת אסימון לטווח קצר שמשתמשים מורשים עם התפקיד יצירת אסימונים בחשבון שירות (roles/iam.serviceAccountTokenCreator) יכולים להוריד.
ניהול מפתחות והצפנה לאחסון ולזיהוי מחדש
אתם מנהלים מפתחות CMEK נפרדים לנתונים הסודיים כדי שתוכלו לשחזר פרטי זיהוי של הנתונים. אתם משתמשים ב-Cloud HSM כדי להגן על המפתחות. כדי לשחזר פרטי זיהוי של הנתונים, אתם משתמשים במפתחות הבאים:
- מפתח CMEK שצינור עיבוד הנתונים ב-Dataflow משתמש בו בתהליך של זיהוי מחדש.
- המפתח הקריפטוגרפי המקורי שבו Sensitive Data Protection משתמש כדי להסיר פרטי זיהוי מהנתונים.
- מפתח CMEK למחסן BigQuery בפרויקט של הנתונים הסודיים.
כמו שצוין במאמר ניהול מפתחות והצפנה להעלאת נתונים, אתם יכולים לציין את המיקום של CMEK ואת תקופות הרוטציה. אתם יכולים להשתמש ב-Cloud EKM אם הארגון שלכם דורש זאת.
תפעול
אתם יכולים להפעיל רישום ביומן ותכונות של Security Command Center Premium או Enterprise, כמו Security Health Analytics ו-Event Threat Detection. אמצעי הבקרה האלה מאפשרים לכם:
- מעקב אחרי מי ניגש לנתונים שלכם.
- חשוב לוודא שהגדרתם ביקורת מתאימה.
- יצירת ממצאים לגבי משאבי ענן שההגדרה שלהם שגויה
- תמיכה ביכולת של צוותי ניהול האירועים והתפעול להגיב לבעיות שעלולות לקרות.
Access Transparency
Access Transparency מספקת לכם התראה בזמן אמת כשאנשי צוות של Google צריכים גישה לנתונים שלכם. היומנים של Access Transparency נוצרים בכל פעם שאדם ניגש לתוכן, ורק לצוות של Google שיש לו הצדקות עסקיות תקפות (לדוגמה, פנייה לתמיכה) יכולה להיות גישה.
רישום ביומן
כדי לעזור לכם לעמוד בדרישות הביקורת ולקבל תובנות לגבי הפרויקטים שלכם, אתם יכולים להגדיר את Google Cloud Observability עם יומני נתונים של השירותים שאתם רוצים לעקוב אחריהם. מודול centralized-logging בהגדרות המאגרים מגדיר את השיטות המומלצות הבאות:
- יצירת aggregated log sink בכל הפרויקטים.
- שמירת היומנים באזור המתאים.
- הוספת מפתחות CMEK ליעד של היומן.
עבור כל השירותים בפרויקטים, היומנים צריכים לכלול מידע על קריאות וכתיבות של נתונים, ומידע על מה שאדמינים קוראים. שיטות מומלצות נוספות לרישום ביומן מפורטות במאמר בנושא אמצעי בקרה לגילוי.
התראות ומעקב
אחרי שמבצעים פריסה של הארכיטקטורה, אפשר להגדיר התראות כדי להודיע למרכז האבטחה (SOC) על אירוע אבטחה שמתרחש. לדוגמה, אפשר להשתמש בהתראות כדי לעדכן את אנליסט האבטחה כשמשתנה הרשאת IAM. מידע נוסף על הגדרת התראות ב-Security Command Center זמין במאמר הגדרת התראות על ממצאים. כדי להגדיר התראות באמצעות Cloud Monitoring לגבי התראות נוספות שלא מתפרסמות על ידי Security Command Center.
שיקולי אבטחה נוספים
בנוסף לאמצעי האבטחה שמתוארים במסמך הזה, מומלץ לבדוק ולנהל את האבטחה והסיכונים בתחומים מרכזיים שחופפים לשימוש שלכם בפתרון הזה ומשפיעים עליו. למשל:
- האבטחה של הקוד שבו משתמשים כדי להגדיר, לפרוס ולהריץ משימות Dataflow ופונקציות Cloud Run.
- טקסונומיית סיווג הנתונים שבה אתם משתמשים עם הפתרון הזה.
- יצירה וניהול של מפתחות הצפנה.
- התוכן, האיכות והאבטחה של מערכי הנתונים שאתם מאחסנים ומנתחים במחסן הנתונים.
- הסביבה הכוללת שבה אתם פורסים את הפתרון, כולל:
- העיצוב, הפילוח והאבטחה של רשתות שמתחברים לפתרון הזה.
- האבטחה והניהול של אמצעי הבקרה של ניהול הזהויות והרשאות הגישה בארגון.
- הגדרות האימות וההרשאה של הגורמים שאתם מעניקים להם גישה לתשתית שמהווה חלק מהפתרון הזה, ושלהם יש גישה לנתונים שמאוחסנים ומנוהלים בתשתית הזו.
מסכם הכול
כדי להטמיע את הארכיטקטורה שמתוארת במאמר הזה:
- קובעים אם לפרוס את הארכיטקטורה באמצעות תוכנית הבסיס לארגונים או בנפרד. אם בוחרים שלא לפרוס את תוכנית הבסיס לארגונים, צריך לוודא שבסביבה מוגדר בסיס אבטחה דומה.
- כדי לייבא נתונים ממקורות חיצוניים, צריך להגדיר חיבור Dedicated Interconnect לרשת.
- עליך לעיין בקובץ
terraform-google-secured-data-warehouseREADME או בקובץterraform-google-secured-data-warehouse-onprem-ingestREADME ולוודא שאתה עומד בכל הדרישות המוקדמות. מוודאים שלזהות המשתמש שלכם יש את התפקידים משתמש בחשבון שירות (
roles/iam.serviceAccountUser) ויצירת אסימונים בחשבון שירות (roles/iam.serviceAccountTokenCreator) בתיקיית הפיתוח של הארגון, כמו שמתואר במאמר מבנה הארגון. אם אין לכם תיקייה שבה אתם משתמשים לבדיקות, צריך ליצור תיקייה ולהגדיר גישה.כדאי לרשום את המזהה של החשבון לחיוב, את השם לתצוגה של הארגון, את מזהה התיקייה של תיקיית הבדיקה או ההדגמה ואת כתובות האימייל של קבוצות המשתמשים הבאות:
- מנתחי נתונים
- כלי לצפייה בנתונים מוצפנים
- קורא טקסט פשוט
- מהנדסי מערכות מידע
- אדמינים של רשתות
- אדמינים של אבטחה
- אנליסטים של אבטחה
יוצרים את הפרויקטים. רשימת ממשקי ה-API שצריך להפעיל מופיעה בקובץ ה-README.
יוצרים את חשבון השירות עבור Terraform ומקצים את התפקידים המתאימים לכל הפרויקטים.
הגדרת מדיניות בקרת הגישה.
במקורות נתונים שמשתמשים במאגר Google Cloud , פורסים את ההדרכה בסביבת הבדיקה כדי לראות את הפתרון בפעולה.
terraform-google-secured-data-warehouseבמסגרת תהליך הבדיקה, כדאי לשים לב לנקודות הבאות:- מוסיפים נתונים לדוגמה למחסן הנתונים של BigQuery.
- כדאי לעבוד עם אנליסט נתונים בארגון כדי לבדוק את הגישה שלו לנתונים הסודיים ואם הוא יכול לקיים אינטראקציה עם הנתונים מ-BigQuery באופן שהוא מצפה לו.
למקורות נתונים חיצוניים שמשתמשים במאגר
terraform-google-secured-data-warehouse-onprem-ingest, בסביבת הבדיקה, פורסים את הפתרון:- משכפלים ומריצים את סקריפטים של Terraform כדי להגדיר סביבה ב-Google Cloud.
מגדירים Application Default Credentials כדי להפעיל את ספריית Tink ברשת.
יוצרים מפתחות הצפנה באמצעות Cloud KMS.
יצירת קבוצות מפתחות מוצפנות באמצעות Tink.
כדי להצפין נתונים באמצעות Tink, אפשר להשתמש באחת מהשיטות הבאות:
- שימוש בהצפנה דטרמיניסטית.
- שימוש בסקריפט עזר עם נתונים לדוגמה.
העלאת נתונים מוצפנים ל-BigQuery באמצעות העלאות באצווה או העלאות של נתונים בזמן אמת.
לגבי מקורות נתונים חיצוניים, צריך לוודא שמשתמשים מורשים יכולים לקרוא נתונים לא מוצפנים מ-BigQuery באמצעות פונקציית הפענוח BigQuery AEAD. לדוגמה, מריצים את פונקציית הפענוח הבאה:
מריצים את השאילתה ליצירת התצוגה:
CREATE OR REPLACE VIEW `{project_id}.{bigquery_dataset}.decryption_view` AS

SELECT
 Card_Type_Code,
 Issuing_Bank,
 Card_Number,
 `bigquery_dataset.decrypt`(Card_Number) AS Card_Number_Decrypted
FROM `project_id.dataset.table_name`
מריצים את שאילתת הבחירה מהתצוגה:
SELECT
  Card_Type_Code,
  Issuing_Bank,
  Card_Number,
  Card_Number_Decrypted
FROM
`{project_id}.{bigquery_dataset}.decrypted_view`
לשאילתות נוספות ולתרחישי שימוש, ראו הצפנה ברמת העמודה באמצעות Cloud KMS.
אפשר להשתמש ב-Security Command Center כדי לסרוק את הפרויקטים החדשים בהשוואה לדרישות התאימות שלכם.
פורסים את הארכיטקטורה בסביבת הייצור.
המאמרים הבאים
- כדאי לעיין בתוכנית לניהול יסודות האבטחה בארגון כדי ליצור סביבה מאובטחת בסיסית.
- כדי לראות את פרטי הארכיטקטורה, אפשר לקרוא את קובץ ה-README של הגדרות Terraform למקורות נתונים פנימיים (מאגר
terraform-google-secured-data-warehouse) או את קובץ ה-README של הגדרות Terraform למקורות נתונים חיצוניים (מאגרterraform-google-secured-data-warehouse-onprem-ingest).