


En este documento, se proporciona una arquitectura de alto nivel para un sistema de IA multiagente que consolida datos multimodales fragmentados en un gráfico de conocimiento que se puede buscar. El sistema permite que los usuarios suban datos y, luego, usen el gráfico de conocimiento para identificar posibles problemas o riesgos sistémicos. La arquitectura permite que los agentes naveguen por redes de datos complejas y mantengan la personalización a largo plazo. Garantiza que los recursos distribuidos coincidan con los requisitos de búsqueda con continuidad.
GraphRAG es un enfoque basado en grafos para la generación aumentada por recuperación (RAG). La RAG ayuda a fundamentar las respuestas generadas por IA aumentando las instrucciones con datos contextualmente relevantes que se recuperan con la búsqueda de vectores. GraphRAG combina Vector Search con una consulta de gráfico de conocimiento para recuperar datos contextuales que reflejen mejor la interconexión de los datos de diversas fuentes. Las instrucciones que se aumentan con GraphRAG pueden generar respuestas de IA más detalladas y pertinentes.
El público objetivo de este documento incluye arquitectos, desarrolladores y administradores que compilan y administran infraestructura y aplicaciones de IA en la nube. En este documento, se supone que tienes conocimientos básicos de los agentes y modelos de IA. En el documento, no se proporciona orientación específica para diseñar y programar agentes de IA.
En la sección Implementación de este documento, se proporciona una muestra de código que indica cómo definir un esquema de Spanner Graph y vincular entidades multimodales para la recuperación agéntica.
Arquitectura
A continuación, se muestra una vista de alto nivel de la arquitectura de un sistema de IA de varios agentes que habilita la organización de recursos de GraphRAG multimodal:
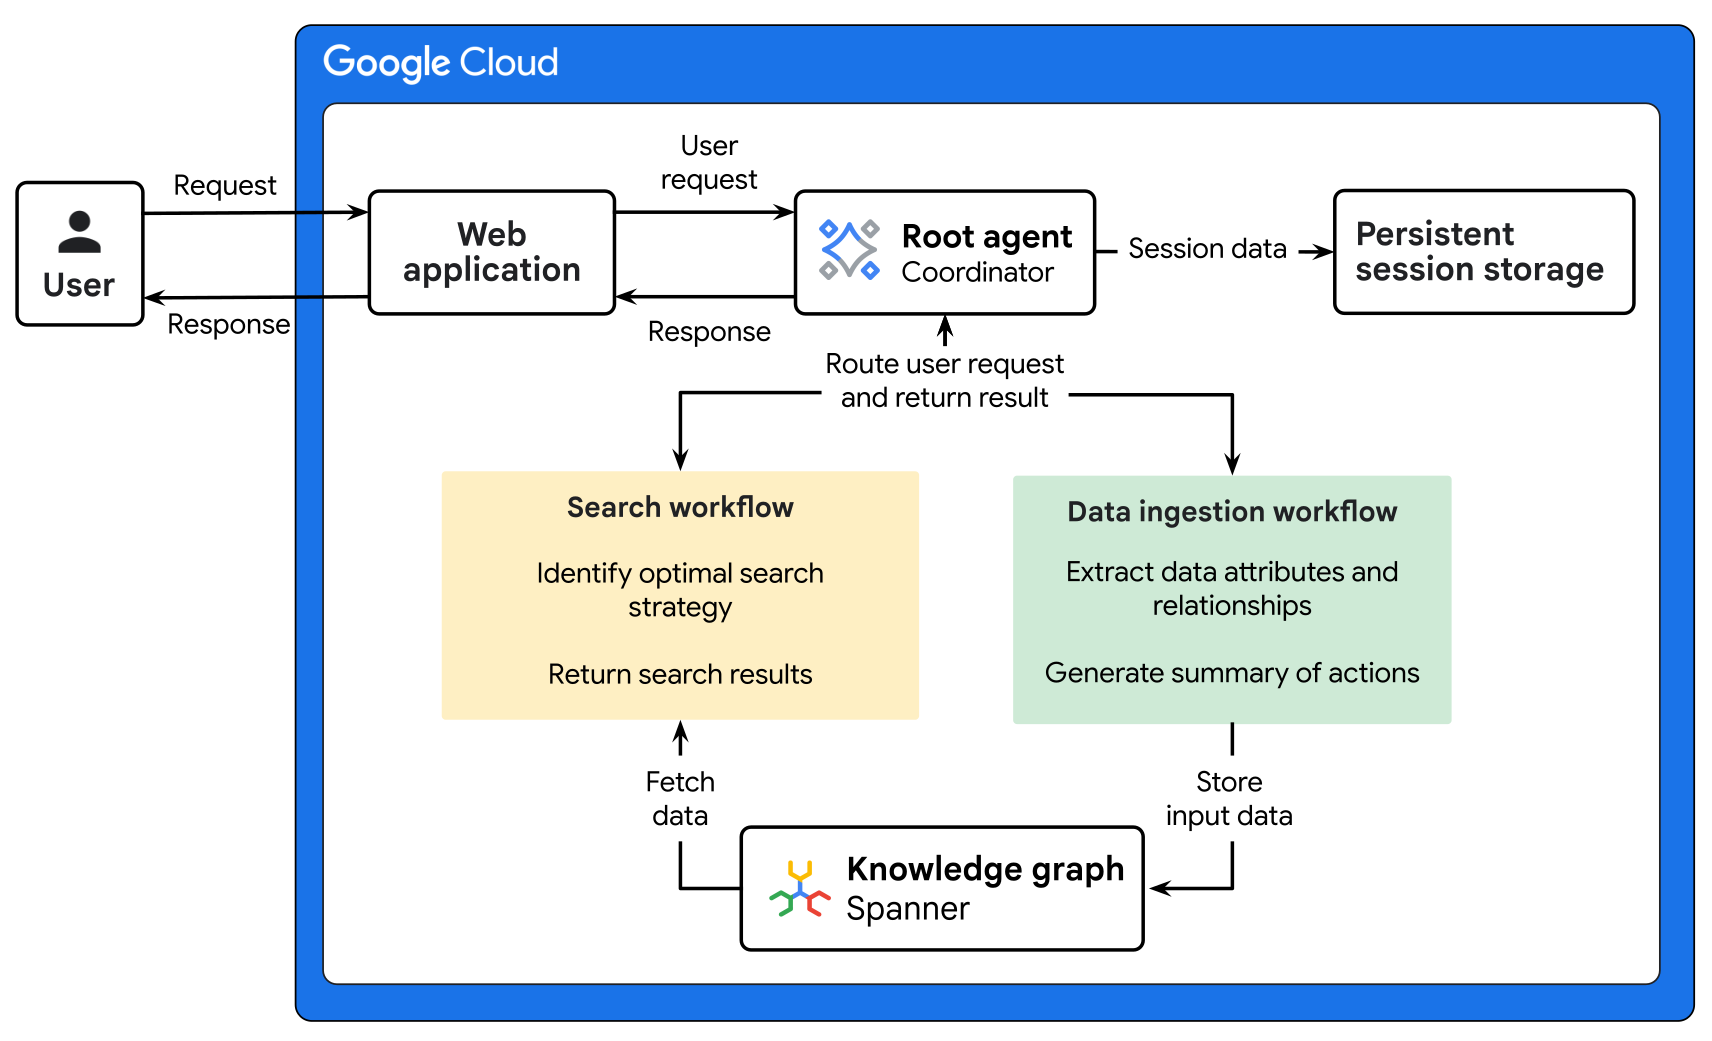
La arquitectura del diagrama anterior tiene dos flujos de trabajo: ingesta de datos y búsqueda.
- El flujo de trabajo de ingesta de datos consolida los registros multimodales fragmentados en el gráfico de conocimiento unificado. Este flujo de trabajo usa un patrón secuencial de varios agentes para subir datos sin procesar a Cloud Storage, extraer relaciones complejas con Gemini y actualizar el gráfico de conocimiento de Spanner Graph para garantizar que los datos estén disponibles para su recuperación.
- El flujo de trabajo de búsqueda te permite recuperar información y fundamentar respuestas a través de un proceso de GraphRAG. Este flujo de trabajo usa Gemini y subagentes especializados para navegar por el gráfico de conocimiento y consolidar los hallazgos en función de los datos de sesiones anteriores.
En las siguientes pestañas, se proporcionan diagramas de arquitectura que muestran los flujos de trabajo de ingesta de datos y búsqueda:
Flujo de trabajo de ingesta de datos
En el siguiente diagrama, se muestra una arquitectura detallada para un flujo de trabajo de ingesta de datos.
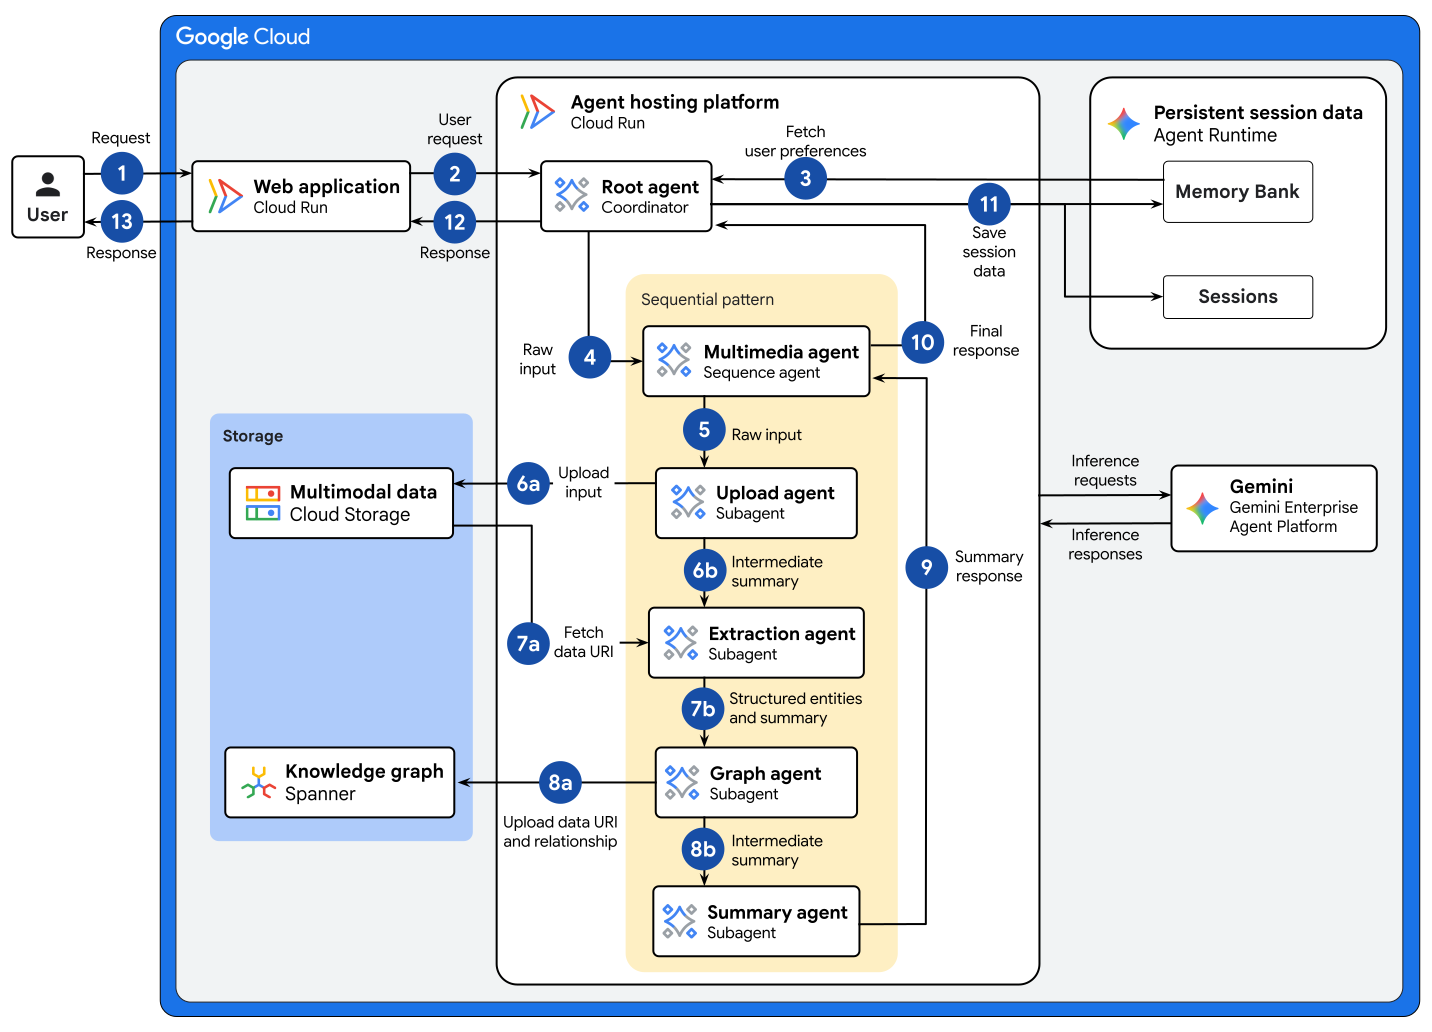
En el diagrama anterior, se muestra el siguiente flujo de datos:
- El usuario interactúa con la aplicación web para subir datos nuevos. Por ejemplo, un analista financiero puede subir un PDF de ganancias, una grabación de una reunión de accionistas o un gráfico de rendimiento del mercado.
- La aplicación web reenvía la solicitud al agente raíz. El agente raíz es un agente coordinador que recibe solicitudes y se implementa en un servicio de Cloud Run.
- El agente raíz recupera datos de sesión persistentes de Memory Bank para personalizar los resultados de la búsqueda según las preferencias del usuario de sesiones anteriores.
- El agente raíz usa Gemini en Gemini Enterprise Agent Platform para interpretar la solicitud y delega la tarea al agente multimedia para ejecutar la canalización de transferencia de datos.
- El agente multimedia inicia el patrón secuencial y reenvía la entrada sin procesar al agente de carga.
- El agente de carga realiza las siguientes tareas:
- Almacena el archivo sin procesar en un bucket de Cloud Storage y detecta el tipo de contenido multimedia.
- Reenvía un resumen intermedio de las acciones que realizó al agente de extracción.
- El agente de extracción realiza las siguientes tareas:
- Recupera el URI de datos del bucket de almacenamiento y usa Gemini para analizar los datos y, luego, identificar las entidades estructuradas. Por ejemplo, las entidades de datos financieros pueden incluir subsidiarias corporativas, trimestres fiscales y opiniones sobre los ingresos.
- Reenvía las entidades estructuradas y el resumen intermedio de las acciones que realizó al agente de grafos.
- El agente de grafo realiza las siguientes tareas:
- Recibe las entidades estructuradas y sube los datos al gráfico de conocimiento. Spanner Graph crea o vincula nodos que representan emisores, partes interesadas e instrumentos de mercado.
- Reenvía un resumen intermedio de las acciones que realizó al agente de resumen.
- El agente de resumen produce una respuesta que contiene un resumen de texto de los resultados de la transferencia y las acciones que realizaron todos los agentes secundarios. El agente de resumen envía la respuesta al agente multimedia.
- El agente multimedia reenvía la respuesta de resumen al agente raíz.
- El agente raíz activa una función de devolución de llamada para guardar los datos de la sesión en Gemini Enterprise Agent Platform Sessions . El agente raíz extrae temas de memoria personalizados de la sesión para guardar información sobre áreas de enfoque críticas. Por ejemplo, un analista financiero podría crear un tema de memoria para hacer un seguimiento de las marcas regulatorias o las tendencias sectoriales.
- El agente raíz reenvía la respuesta de resumen a la aplicación web.
- La aplicación web reenvía la respuesta al usuario.
Flujo de trabajo de búsqueda
En el siguiente diagrama, se muestra una arquitectura detallada para un flujo de trabajo de búsqueda.
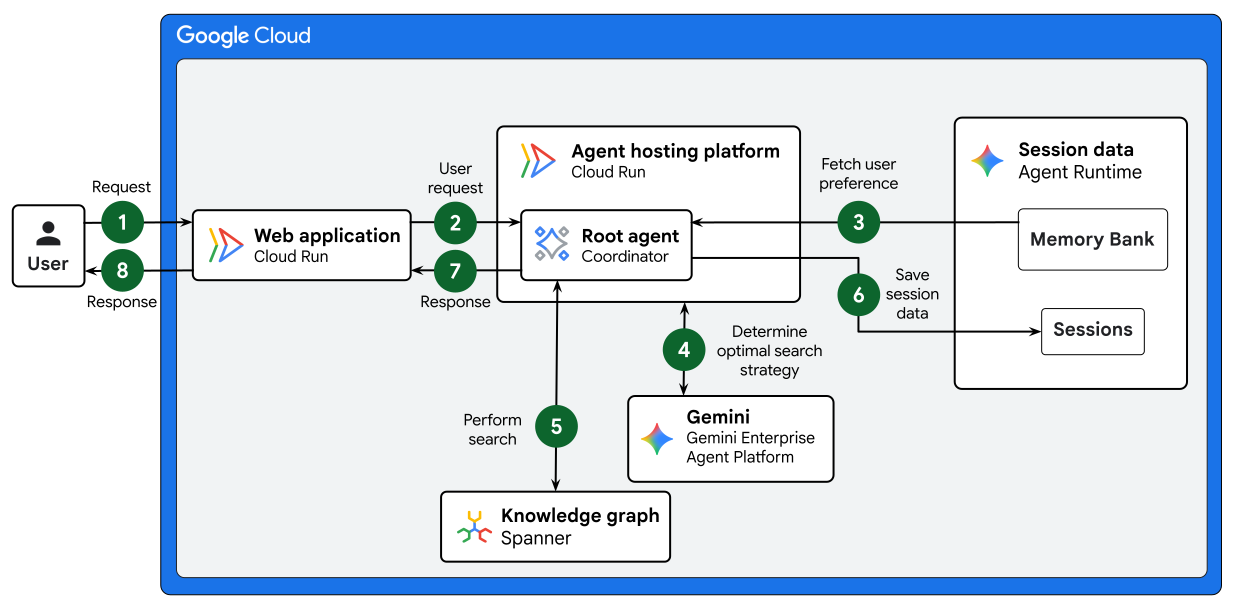
En el diagrama anterior, se muestra el siguiente flujo de datos:
- Un usuario inicia una solicitud de búsqueda en la aplicación web. Por ejemplo, un administrador de cartera envía una solicitud para detectar cualquier patrón de transacción circular que involucre a más de tres entidades en las que el volumen total supere el millón de dólares en un período de 24 horas.
- La aplicación web reenvía la solicitud al agente raíz. El agente raíz es un agente coordinador que recibe solicitudes y se implementa en un servicio de Cloud Run .
- El agente raíz recupera datos de sesión persistentes de Memory Bank para personalizar los resultados de la búsqueda según las preferencias y el contexto históricos del administrador de cartera.
- El agente raíz usa Gemini en Agent Platform para
determinar la estrategia de búsqueda óptima:
- Búsqueda por palabra clave: Usa cláusulas
LIKEde SQL para que coincidan con categorías o ubicaciones exactas. - Búsqueda semántica de RAG: Usa el modelo de embedding y la distancia coseno para encontrar entradas de datos semánticamente similares.
- Búsqueda híbrida: Ejecuta la búsqueda de palabras clave y la búsqueda semántica de RAG, y combina los resultados con la fusión por clasificación recíproca (RRF) para garantizar una alta relevancia y cobertura.
- Búsqueda por palabra clave: Usa cláusulas
- El agente raíz realiza la estrategia de búsqueda adecuada en el gráfico de conocimiento, que se almacena en Spanner Graph, y recupera los resultados de la búsqueda.
- El agente raíz activa una función de devolución de llamada para guardar los datos de la sesión en Agent Platform Sessions. El agente raíz extrae temas de memoria personalizados de la sesión. Por ejemplo, un administrador de cartera puede crear un tema de memoria para hacer un seguimiento de las marcas regulatorias o las tendencias emergentes del sector.
- El agente raíz reenvía la respuesta de resumen a la aplicación web.
- La aplicación web reenvía la respuesta al usuario.
Productos usados
En esta arquitectura de referencia, se usan los siguientes productos y funciones de Google Cloud:
- Cloud Run: Es una plataforma de computación sin servidores que te permite ejecutar contenedores directamente sobre la infraestructura escalable de Google.
- Gemini: Es una familia de modelos de IA multimodales desarrollados por Google.
- Gemini Enterprise Agent Platform: Es una plataforma integral que te permite crear, escalar, administrar y optimizar agentes de IA de nivel empresarial.
- Cloud Storage: Es un almacén de objetos de bajo costo y sin límites para varios tipos de datos. Se puede acceder a los datos desde y hacia Google Cloud, y estos se replican en las ubicaciones para aumentar la redundancia.
- Spanner Graph: Es una base de datos de grafos que proporciona las funciones de escalabilidad, disponibilidad y coherencia de Spanner.
- Gemini Enterprise Agent Platform Sessions: Es un servicio de almacenamiento persistente que guarda y recupera el historial de interacciones entre un usuario y los agentes.
- Memory Bank: Es un servicio de almacenamiento persistente que genera, define mejor, administra y recupera memorias a largo plazo basadas en las conversaciones de un usuario con un agente.
Para obtener información sobre cómo seleccionar componentes alternativos para tu sistema de IA agéntica, incluidos el framework, el entorno de ejecución del agente, las herramientas, la memoria y los patrones de diseño, consulta Elige los componentes de tu arquitectura de IA agéntica.
Caso de uso
La arquitectura está diseñada para casos de uso que consolidan y analizan datos multimodales fragmentados para optimizar la asignación de recursos y la recuperación de información. Con el mantenimiento de agentes secundarios independientes, el sistema admite actualizaciones modulares y garantiza que los recursos distribuidos coincidan con los requisitos de búsqueda con una alta continuidad. La integración de Spanner Graph como un gráfico de conocimiento permite que el sistema de IA agéntica modele datos complejos e interconectados. Esta integración facilita una comprensión contextual completa y capacidades de consulta sofisticadas que pueden ser difíciles o ineficientes con bases de datos relacionales o NoSQL.
Para los siguientes casos de uso, una base de datos de grafos se destaca en la representación de las conexiones arbitrarias y en evolución que se derivan de los datos multimodales. De lo contrario, estas conexiones requerirían una administración de esquemas compleja y rígida en una base de datos relacional.
A continuación, se muestran ejemplos de casos de uso para la arquitectura que se describe en este documento:
- Movilidad de talentos de RR.HH. empresariales: Mejora la búsqueda de palabras clave para la búsqueda de reclutamiento a gran escala identificando candidatos internos calificados a través de la expansión semántica. La arquitectura extrae evaluaciones de habilidades técnicas y habilidades interpersonales de carteras multimodales y presentaciones de video para crear un grafo de talentos integral. El gráfico de conocimiento de Spanner rastrea las relaciones entre los empleados, las competencias y el historial de proyectos. Los resultados del seguimiento identifican a los expertos según la profundidad conceptual y marcan los proyectos con falta de personal.
- Análisis de contenido de redes sociales: Identifica recuerdos o tendencias específicos realizando un descubrimiento de contenido avanzado y un análisis de red en plataformas de redes sociales. El sistema procesa las cargas, como videos, notas de voz y vlogs, y, luego, extrae entidades, temas, opiniones y menciones. El gráfico de conocimiento de Spanner rastrea las relaciones entre los usuarios, sus conexiones (amigos y seguidores), publicaciones, me gusta, comentarios, temas compartidos y tendencias.
Consideraciones del diseño
En las siguientes secciones, se proporcionan recomendaciones generales para diseñar los agentes de IA y, también, implementar esta arquitectura para la producción.
La guía de esta sección no está completa. Para obtener más información sobre los factores de diseño y las prácticas recomendadas, y para obtener recomendaciones sobre cómo compilar e implementar un sistema de IA multiagente, consulta Sistema de IA multiagente en Google Cloud.
Diseño de agentes de IA
Para mejorar el costo y el rendimiento de tus agentes, ten en cuenta las siguientes recomendaciones:
- Diseño del sistema de agentes: Desglosa los flujos de trabajo complejos en varios agentes especializados con responsabilidades bien definidas en lugar de un agente monolítico. Esta separación de responsabilidades simplifica la ingeniería de instrucciones, minimiza la desviación de instrucciones y permite el escalamiento detallado del modelo. La arquitectura enruta las tareas bien definidas y de gran volumen a modelos más pequeños y rápidos, mientras que reserva el razonamiento complejo para los modelos de alta capacidad.
- Diseño de herramientas: Separa las herramientas en varios métodos enfocados en lugar de usar un solo método monolítico. Este enfoque garantiza la coherencia en toda la base de código, reduce la ramificación lógica y habilita rutas de optimización específicas, como omitir el análisis de consultas cuando se invoca un método de búsqueda directa.
- Contexto del agente: Para evitar que los agentes downstream repitan consultas en los datos upstream en una canalización secuencial, pasa suficiente contexto a través del estado del agente. Usa estructuras JSON bien definidas para el estado compartido, de modo que cada agente pueda analizar los datos de forma confiable.
- Almacenamiento del estado de la sesión: Usa el estado de la sesión para el historial de conversaciones inmediato y Memory Bank para los hechos resumidos en todas las sesiones. Inserta el contexto de la memoria al comienzo de una sesión para que el agente pueda hacer referencia a las preferencias sin volver a procesar historiales de conversaciones largos.
- Calidad de la memoria: Permite que los usuarios borren o actualicen los recuerdos obsoletos si sus preferencias o roles cambian con el tiempo.
Security, privacy, and compliance
Para ayudar a abordar los riesgos de seguridad únicos de los agentes de IA, Google recomienda un enfoque que combina controles de seguridad determinísticos con defensas dinámicas basadas en el razonamiento:
- Supervisión humana: Incorpora un flujo con intervención humana en los sistemas críticos para la empresa, de modo que los supervisores humanos puedan revisar los resultados y aprobar, anular o pausar las acciones de los agentes.
- Identidad del agente: Asigna a cada agente una identidad vinculada a la carga de trabajo para aplicar el control de acceso con privilegios mínimos y administrar de forma centralizada las credenciales de las herramientas externas.
- Agent Gateway: Aplica la administración del tráfico de entrada y salida, las políticas de acceso de denegación predeterminada y la inspección de instrucciones y herramientas intercaladas con Model Armor.
Agent Registry: Verifica que los agentes solo se conecten a subagentes y herramientas de MCP aprobados.
Implementa el control de acceso detallado: Usa el control de acceso detallado para autorizar el acceso a nivel de tabla y columna. Restringe la política del bucket de Cloud Storage para que solo la cuenta de servicio de Cloud Run tenga acceso.
Limpia la inferencia y las respuestas: Usa Model Armor para inspeccionar y limpiar las solicitudes de inferencia y las respuestas del modelo. Esta limpieza mitiga los riesgos de inyección de instrucciones del contenido multimodal que suben los usuarios. También ayuda a evitar el robo accidental de información de identificación personal (IIP) o datos sensibles en los resultados de los agentes.
Confiabilidad
Para asegurarte de que la configuración de tu agente cumpla con tus requisitos de confiabilidad, ten en cuenta las siguientes recomendaciones:
- Implementa la lógica de reintento del agente: Para controlar los errores transitorios, como los límites de cuota, implementa la lógica de reintento con retirada exponencial para las llamadas a los extremos de Agent Platform y Spanner.
- Establece límites de archivos: Para evitar tiempos de espera de la API por archivos grandes, establece límites de tamaño de carga explícitos y separa los videos grandes en fragmentos antes de que se extraigan las entidades de datos. Para obtener más información, consulta Personaliza el procesamiento de videos.
Eficiencia operativa
Para asegurarte de que la configuración de tus agentes cumpla con tus requisitos de eficiencia operativa, ten en cuenta las siguientes recomendaciones:
- Usa el registro estructurado: Registra todas las invocaciones de herramientas de agentes y los resultados de la canalización con metadatos estructurados. Los registros estructurados te permiten consultar registros y paneles en Cloud Monitoring.
- Implementa el seguimiento: Para diagnosticar los puntos de acceso de latencia, usa Cloud Trace para capturar seguimientos de solicitudes de extremo a extremo en el ejecutor de agentes y la ejecución de herramientas.
- Evalúa la calidad del agente: Evalúa periódicamente la calidad de los resultados del agente con el Gen AI Evaluation Service para verificar las trayectorias de selección de herramientas y la calidad de las respuestas.
Optimización de costos
Para asegurarte de que la configuración de tu agente cumpla con tus requisitos de costo, ten en cuenta las siguientes recomendaciones:
- Costos de almacenamiento: Para reducir los costos de almacenamiento, usa la Administración del ciclo de vida de los objetos para mover archivos a las clases de almacenamiento Nearline o Coldline después de un período de retención definido.
- Análisis y administración de costos: Para analizar y administrar los costos de Agent Platform, te recomendamos que crees métricas de referencia para las consultas por segundo (QPS) y los tokens por segundo (TPS). Luego, supervisa estas métricas después de la implementación. La referencia que creas como parte de la administración de costos puede ayudarte a determinar la planificación de la capacidad. Por ejemplo, el modelo de referencia te ayuda a determinar cuándo podría ser necesaria la capacidad de procesamiento aprovisionada.
Optimización del rendimiento
Para garantizar que la configuración de tu agente cumpla con tus requisitos de rendimiento, ten en cuenta las siguientes recomendaciones:
- Enrutamiento del agente raíz: Para minimizar la latencia y evitar invocaciones innecesarias de agentes secundarios, define claramente la lógica de enrutamiento en las instrucciones del agente. Asegúrate de que el propósito, los parámetros de entrada y los resultados esperados de cada herramienta estén documentados en literales de cadena para ayudar al modelo a seleccionar la herramienta correcta.
- Modelos de IA en la base de datos: Para reducir la latencia, usa la función
ML.PREDICTde Spanner para llamar a modelos intercalados en consultas en SQL. Supervisa el uso de la cuota de Agent Platform, ya que las cargas de trabajo de búsqueda híbrida pueden activar varias llamadas de modelo por consulta. - Asignación de recursos: Según tus requisitos de rendimiento, configura los límites de memoria y los límites de CPU que se asignarán al servicio de Cloud Run.
Implementación
Para implementar una implementación de muestra de esta arquitectura, prueba el codelab Way Back Home Level 2.
¿Qué sigue?
- Obtén más información para alojar agentes de IA en Cloud Run.
- Aprende a compilar una infraestructura de GraphRAG para la IA generativa con Agent Platform y Spanner Graph.
- Conoce las prácticas recomendadas para diseñar el esquema de Spanner Graph.
- Obtén más información para obtener embeddings multimodales.
- Aprende a crear un sistema de IA de varios agentes en Google Cloud.
- Explora recursos de aprendizaje para crear e implementar agentes de nivel empresarial con Gemini Enterprise Agent Ready (GEAR).
- Para obtener una descripción general de los principios y las recomendaciones de arquitectura específicos de las cargas de trabajo de IA y AA en Google Cloud, consulta la perspectiva de IA y AA en el Well-Architected Framework.
- Para obtener más información sobre las arquitecturas de referencia, los diagramas y las prácticas recomendadas, explora Cloud Architecture Center.
Colaboradores
Autores:
- Annie Wang | Ingeniera de software
- Samantha He | Escritora técnica
Otros colaboradores:
- Christina Lin | Gerente de ingeniería de relaciones con desarrolladores
- Autor: Kumar Dhanagopal | Desarrollador de soluciones entre productos
- Olivier Bourgeois | Ingeniero de relaciones con desarrolladores